
经典排序算法程序实现(快速、冒泡、选择)

简介:排序是计算机科学中的基础操作之一,本文详细解析了三种经典的排序算法:选择排序、快速排序和冒泡排序,并结合VC6.0环境下的C++程序实现进行说明。通过 choosesort.rar 、 quicksort.rar 和 bubblesort.rar 中的代码示例,帮助读者理解各算法的核心思想与执行流程。尽管这三种算法的时间复杂度多为O(n²),但它们在学习算法设计与分析中具有重要意义。掌握这些基础排序方法有助于提升编程能力和为更高效算法的应用打下坚实基础。
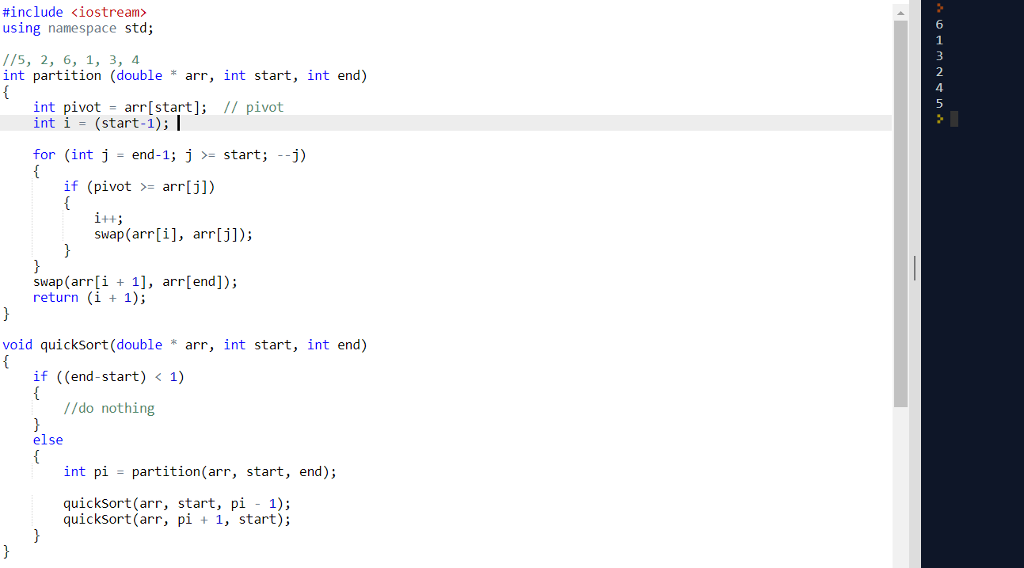
1. 排序算法基本概念与作用
排序的基本定义与核心意义
排序是将一组无序的数据元素按照特定规则(通常为数值或字典序)重新排列为有序序列的过程。在计算机程序中,排序不仅是数据展示的基础操作,更是高效检索、去重、合并等后续处理的前提条件。例如,在一个未排序的学生名单中查找最高分需遍历全部记录,时间复杂度为 $O(n)$;而若数据已按成绩排序,则可通过二分查找将效率提升至 $O(\log n)$。
内部排序 vs 外部排序
根据数据规模与内存使用方式,排序可分为 内部排序 (数据全部加载进内存)和 外部排序 (数据量过大需借助磁盘分块处理)。本系列聚焦于前者,适用于数组、链表等可完全驻留内存的结构。
稳定性与原地排序
- 稳定性 :相等元素在排序后保持原有相对顺序。如电商系统中按价格排序时,相同价格的商品应维持上传先后顺序,此时需稳定算法(如归并排序)。
- 原地排序 (In-place):仅使用常数额外空间完成排序,如选择排序和快速排序,适合资源受限场景。
| 算法 | 时间复杂度(平均) | 是否稳定 | 是否原地 |
|---|---|---|---|
| 选择排序 | $O(n^2)$ | 否 | 是 |
| 冒泡排序 | $O(n^2)$ | 是 | 是 |
| 快速排序 | $O(n \log n)$ | 否 | 是 |
实际应用场景举例
- 学生成绩排名:需稳定性以保留并列名次;
- 搜索引擎结果排序:结合权重打分进行动态排序;
- 数据库索引构建:B+树依赖有序键值插入。
发展历程简述
从最简单的冒泡排序到基于分治思想的快速排序、归并排序,再到堆排序与线性时间排序(计数排序),排序算法的演进体现了算法设计从“直观暴力”向“数学优化”的转变。理解这一脉络有助于掌握高效算法的设计哲学。
2. 选择排序原理与C++实现
2.1 选择排序的理论基础
2.1.1 算法思想与工作流程
选择排序是一种基于比较的简单排序算法,其核心思想是“每轮选出最小(或最大)元素,并将其放置在已排序区间的末尾”。整个过程可以类比为一个逐步构建有序序列的过程。初始时,整个数组被视为无序区间;随着算法推进,有序部分从左端开始不断扩展,而无序部分逐渐缩小。
该算法采用两层嵌套循环结构:外层控制当前要填充的位置 i ,内层则负责在剩余未排序部分 [i+1, n-1] 中查找最小值的索引。一旦找到,便将该最小值与位置 i 上的元素交换,从而确保前 i+1 个元素已经按升序排列。这一机制不依赖于数据的初始分布状态,无论输入是正序、逆序还是随机打乱,其执行路径几乎一致。
这种“暴力枚举”式的策略虽然逻辑清晰,但代价高昂——它无法利用任何已有顺序信息来跳过不必要的比较操作。例如,即使数组已经完全有序,选择排序仍会进行全部 $ \frac{n(n-1)}{2} $ 次比较,这是其效率低下的根本原因之一。然而,也正是这种确定性行为使得它的最坏、最好和平均时间复杂度均为 $ O(n^2) $,便于理论分析和教学演示。
由于每次只进行一次实际交换(即找到最小值后才交换),选择排序的数据移动次数远少于冒泡排序等其他 $ O(n^2) $ 算法。这对于写入成本较高的存储介质(如闪存)具有潜在优势。此外,该算法具备原地排序特性(in-place sorting),仅需常数级额外空间,空间复杂度为 $ O(1) $。
尽管不具备实用性上的竞争优势,选择排序因其简洁性和可预测性,在嵌入式系统、教学场景以及作为更复杂算法的子模块中仍有其一席之地。理解其工作机制有助于深入掌握排序的本质:通过不断缩小问题规模并局部最优解组合成全局有序结果。
工作流程图示
graph TD
    A[开始] --> B[设置当前位置i=0]
    B --> C{i < n-1?}
    C -- 是 --> D[在[i, n-1]中找最小值索引min_idx]
    D --> E[交换arr[i]与arr[min_idx]]
    E --> F[递增i]
    F --> C
    C -- 否 --> G[排序完成]
    G --> H[结束]
上述流程图清晰地展示了选择排序的主控逻辑:外层循环判断是否还有未处理元素,内层负责定位极值,随后执行交换动作。整个过程无需递归调用或动态内存分配,控制流线性明确,非常适合初学者建立对排序机制的基本认知。
2.1.2 最小值/最大值选取机制
在标准的选择排序实现中,通常采用寻找 最小值 的方式来进行升序排列。具体而言,在第 i 轮迭代中,算法假设 arr[i] 是当前无序段中的最小值,并将其作为基准进行比较。然后遍历 j = i+1 到 n-1 的所有元素,若发现某个 arr[j] < arr[min_idx] ,则更新最小值索引 min_idx = j 。最终将 arr[i] 与 arr[min_idx] 交换。
也可以改用寻找 最大值 的方式来实现,此时需从右端开始构建有序区。即第 i 轮在 [0, i] 区间内找出最大值并交换至位置 i ,这样每轮结束后右侧的 i 个元素就是最大的且有序。两种方式在性能上没有本质区别,但在缓存访问模式上略有差异——从前向后选最小值更符合现代CPU的预取机制。
下面是一个使用最小值选取机制的核心代码片段:
void selectionSort(int arr[], int n) {
    for (int i = 0; i < n - 1; ++i) {
        int min_idx = i;
        for (int j = i + 1; j < n; ++j) {
            if (arr[j] < arr[min_idx]) {
                min_idx = j;
            }
        }
        if (min_idx != i) {
            std::swap(arr[i], arr[min_idx]);
        }
    }
}
参数说明:
-
arr[]: 待排序的整型数组指针。 -
n: 数组长度。 -
i: 外层循环变量,表示当前待填充的位置。 -
min_idx: 记录当前轮次中最小值所在的索引。 -
j: 内层循环变量,用于扫描未排序区域。
逐行逻辑分析:
-
for (int i = 0; i < n - 1; ++i):外层循环控制排序位置,只需进行n-1轮,因为最后一个元素自然就位。 -
int min_idx = i;:初始化最小值索引为当前位置i。 -
for (int j = i + 1; j < n; ++j):内层循环遍历剩余元素以寻找更小值。 -
if (arr[j] < arr[min_idx]):比较当前元素与已知最小值,成立则更新索引。 -
std::swap(arr[i], arr[min_idx]);:交换操作将最小值“搬运”到正确位置。
值得注意的是,只有当 min_idx != i 时才执行交换,避免了不必要的赋值开销。虽然这不影响渐进复杂度,但在实际运行中能略微提升性能。
2.1.3 排序过程的逐步分解示例
考虑一个具体的整数数组: [64, 25, 12, 22, 11] ,我们通过手动模拟选择排序的每一步,展示其内部演变过程。
| 轮次 | 当前位置 i | 未排序部分 | 找到最小值 | 交换动作 | 结果数组 |
|---|---|---|---|---|---|
| 1 | 0 | [64,25,12,22,11] | 11 (index=4) | swap(64,11) | [11,25,12,22,64] |
| 2 | 1 | [25,12,22,64] | 12 (index=2) | swap(25,12) | [11,12,25,22,64] |
| 3 | 2 | [25,22,64] | 22 (index=3) | swap(25,22) | [11,12,22,25,64] |
| 4 | 3 | [25,64] | 25 (index=3) | 无需交换 | [11,12,22,25,64] |
经过四轮操作后,数组已完全有序。可以看到,每一趟都精准地将下一个最小元素放置到了应有的位置。整个过程中共进行了 4 次比较循环,总计 $ 4+3+2+1 = 10 $ 次比较,符合 $ \frac{n(n-1)}{2} $ 的数学规律。
此例还揭示了一个重要特征: 元素的移动非常稀疏 。在整个排序过程中,仅发生三次实际交换,远低于冒泡排序可能产生的大量相邻交换。这也意味着选择排序在某些硬件环境下(如EEPROM)更具节能潜力。
此外,该算法不会改变相同值之间的相对顺序。例如若有重复元素 [5, 3, 5, 2] ,第一个 5 在交换中被移至后面,第二个 5 保留在原位,则可能出现相对顺序颠倒的情况,因此选择排序 不稳定 。这一点在需要保持原始顺序的应用中必须注意。
2.2 C++语言下的程序实现
2.2.1 数组结构与函数封装设计
在C++中实现选择排序时,合理的函数封装不仅能提高代码复用性,还能增强可读性和调试便利性。推荐将排序逻辑封装在一个独立函数中,并支持多种数据类型(通过模板)和不同容器(如 std::vector 或原生数组)。
对于基础版本,我们先以固定类型的静态数组为例进行设计:
#include <iostream>
using namespace std;

// 函数声明
void selectionSort(int arr[], int n);
void printArray(const int arr[], int n);

int main() {
    int data[] = {64, 25, 12, 22, 11};
    int size = sizeof(data) / sizeof(data[0]);

    cout << "Original array: ";
    printArray(data, size);

    selectionSort(data, size);

    cout << "Sorted array: ";
    printArray(data, size);

    return 0;
}

// 打印数组辅助函数
void printArray(const int arr[], int n) {
    for (int i = 0; i < n; ++i)
        cout << arr[i] << " ";
    cout << endl;
}
设计要点解析:
- 函数分离 :
selectionSort专注于排序逻辑,printArray负责输出,职责分明。 - 数组大小计算 :利用
sizeof(array)/sizeof(element)获取静态数组长度,适用于编译期已知大小的情形。 - const 正确性 :打印函数参数标记为
const,防止误修改原始数据。 - 命名规范 :采用驼峰或下划线风格统一命名,增强可维护性。
为进一步提升通用性,可引入模板机制支持不同类型:
template<typename T>
void selectionSort(T arr[], int n) {
    for (int i = 0; i < n - 1; ++i) {
        int min_idx = i;
        for (int j = i + 1; j < n; ++j) {
            if (arr[j] < arr[min_idx])
                min_idx = j;
        }
        if (min_idx != i)
            swap(arr[i], arr[min_idx]);
    }
}
如此即可对 double 、 char 等类型数组进行排序,体现了泛型编程的优势。
2.2.2 核心循环逻辑编码实现
核心循环是选择排序的灵魂所在。以下为完整实现并附带详细注释:
template<typename T>
void selectionSort(T arr[], int n) {
    // 外层循环:确定当前应放置最小值的位置
    for (int i = 0; i < n - 1; ++i) {
        int minIndex = i;  // 假设当前位置i的元素是最小的

        // 内层循环:在[i+1, n-1]范围内寻找更小的元素
        for (int j = i + 1; j < n; ++j) {
            if (arr[j] < arr[minIndex]) {
                minIndex = j;  // 更新最小值索引
            }
        }

        // 若找到更小元素,则交换
        if (minIndex != i) {
            T temp = arr[i];
            arr[i] = arr[minIndex];
            arr[minIndex] = temp;
            // 或使用 std::swap(arr[i], arr[minIndex]);
        }
    }
}
逻辑逐行解读:
-
template<typename T>:启用泛型编程,使函数适用于任意可比较类型。 -
for (int i = 0; i < n - 1; ++i):控制排序轮数,最后一轮无需再比较。 -
minIndex = i:初始化本轮最小值索引为起始位置。 -
for (int j = i + 1; j < n; ++j):扫描后续元素,寻找更小者。 -
if (arr[j] < arr[minIndex]):执行关键比较操作,决定是否更新索引。 -
if (minIndex != i):避免自我交换,提升效率。 - 使用临时变量完成交换,保证类型安全。
性能影响因素:
- 比较次数 :固定为 $ \sum_{i=1}^{n-1} (n-i) = \frac{n(n-1)}{2} $,与输入无关。
- 交换次数 :最多 $ n-1 $ 次,最少 0 次(已排序),优于冒泡排序。
2.2.3 边界条件处理与数组越界防范
在实际编码中,必须警惕数组越界风险。常见错误包括:
- 访问 arr[n] 导致缓冲区溢出;
- 错误设置循环边界导致无限循环或崩溃。
为此,应在函数入口加入断言检查:
#include <cassert>

template<typename T>
void selectionSort(T arr[], int n) {
    assert(n >= 0);  // 防止负长度输入
    if (n <= 1) return;  // 边界情况:空数组或单元素直接返回

    for (int i = 0; i < n - 1; ++i) {
        int minIndex = i;
        for (int j = i + 1; j < n; ++j) {
            if (arr[j] < arr[minIndex]) {
                minIndex = j;
            }
        }
        if (minIndex != i) {
            std::swap(arr[i], arr[minIndex]);
        }
    }
}
此外,若使用 std::vector 替代原生数组,可通过 .at() 方法启用边界检查(抛出 std::out_of_range 异常):
template<typename T>
void selectionSort(std::vector<T>& vec) {
    int n = vec.size();
    for (int i = 0; i < n - 1; ++i) {
        int minIndex = i;
        for (int j = i + 1; j < n; ++j) {
            if (vec.at(j) < vec.at(minIndex)) {  // 带越界检测
                minIndex = j;
            }
        }
        if (minIndex != i) {
            std::swap(vec[i], vec[minIndex]);
        }
    }
}
虽然 .at() 性能略低,但在调试阶段极为有用。
2.3 实践中的调试与验证
2.3.1 测试用例设计(正序、逆序、重复元素)
为了全面验证选择排序的正确性,应设计多类测试用例:
| 测试类型 | 输入数组 | 预期输出 | 目的说明 |
|---|---|---|---|
| 空数组 | [] | [] | 检验边界处理能力 |
| 单元素 | [42] | [42] | 确认无需排序 |
| 正序 | [1, 2, 3, 4, 5] | [1, 2, 3, 4, 5] | 验证稳定性及无多余交换 |
| 逆序 | [5, 4, 3, 2, 1] | [1, 2, 3, 4, 5] | 检查最大压力下的正确性 |
| 重复元素 | [3, 1, 4, 1, 5, 9, 2, 6] | [1, 1, 2, 3, 4, 5, 6, 9] | 验证重复值处理 |
| 全部相等 | [7, 7, 7, 7] | [7, 7, 7, 7] | 确保无异常交换 |
这些用例覆盖了典型极端情况,能够有效暴露潜在缺陷。
2.3.2 输出中间状态跟踪执行流程
添加日志输出有助于观察算法动态演化过程:
template<typename T>
void selectionSortWithTrace(T arr[], int n) {
    for (int i = 0; i < n - 1; ++i) {
        int minIndex = i;
        cout << "Step " << i + 1 << ": ";
        printArray(arr, n);

        for (int j = i + 1; j < n; ++j) {
            if (arr[j] < arr[minIndex]) {
                minIndex = j;
            }
        }

        if (minIndex != i) {
            swap(arr[i], arr[minIndex]);
        }
    }
}
运行后输出如下:
Step 1: 64 25 12 22 11
Step 2: 11 25 12 22 64
Step 3: 11 12 25 22 64
Step 4: 11 12 22 25 64
可视化每一步变化,极大提升了调试效率。
2.3.3 使用断言确保逻辑正确性
结合 Google Test 或自定义宏进行自动化验证:
bool isSorted(const int arr[], int n) {
    for (int i = 0; i < n - 1; ++i)
        if (arr[i] > arr[i + 1])
            return false;
    return true;
}

// 在main中加入
assert(isSorted(data, size));
自动校验排序结果,防止回归错误。
2.4 性能局限与改进思考
2.4.1 固定比较次数导致的低效问题
选择排序无论数据如何分布,始终执行 $ O(n^2) $ 次比较。这意味着即使输入已排序,也无法提前终止。相比之下,冒泡排序可通过标志位优化至 $ O(n) $ 最佳情况。
解决方案之一是引入早期退出机制,但由于无法预知最小值位置,故难以实质性改进。因此,选择排序本质上不具备自适应性。
2.4.2 不依赖数据分布的特性分析
该算法的“确定性”是一把双刃剑。优点在于性能可预测,适合实时系统;缺点则是丧失了利用数据特性的机会。在大数据集上表现尤为糟糕。
2.4.3 是否存在局部优化空间探讨
尽管整体复杂度难以下降,但仍可尝试以下优化:
- 减少内存访问 :合并比较与交换操作。
- 并行化 :内层查找最小值可并行扫描(需锁或原子操作)。
- SIMD指令加速 :使用向量化比较批量筛选候选最小值。
但受限于算法结构性瓶颈,这些优化收益有限。更优方案是转向堆排序(本质为优化版选择排序)或快速排序。
表格总结选择排序特性:
| 特性 | 描述 |
|---|---|
| 时间复杂度(平均) | $ O(n^2) $ |
| 时间复杂度(最坏) | $ O(n^2) $ |
| 空间复杂度 | $ O(1) $ |
| 是否稳定 | 否 |
| 是否原地 | 是 |
| 自适应性 | 无 |
| 适用场景 | 小规模数据、教学演示、写操作昂贵环境 |
综上所述,选择排序虽非最优解,却是理解排序本质不可或缺的一环。
3. 快速排序分治策略与递归实现
快速排序(QuickSort)作为最经典的比较排序算法之一,凭借其平均时间复杂度为 $ O(n \log n) $ 的高效性能,被广泛应用于各类编程语言的标准库中。它由英国计算机科学家托尼·霍尔(Tony Hoare)于1960年提出,核心思想源于 分治法(Divide and Conquer) ,通过递归地将问题分解为更小的子问题来解决。本章将深入剖析快速排序背后的分治理论框架、关键操作机制以及在C++中的递归实现方式,并结合实际运行场景探讨其潜在风险与优化路径。
3.1 分治法的思想与应用框架
分治法是一种典型的算法设计范式,广泛用于排序、搜索、矩阵乘法等计算密集型任务中。其基本逻辑是将一个复杂的问题拆解成若干个结构相似但规模更小的子问题,分别求解后再合并结果,从而得到原问题的解。快速排序正是这一思想的杰出代表。
3.1.1 分解-解决-合并三步模型
分治法通常遵循三个明确步骤:
- 分解(Divide) :将原问题划分为若干个规模较小、相互独立的子问题。
- 解决(Conquer) :递归地求解各个子问题;当子问题足够小时,直接返回结果。
- 合并(Combine) :将各子问题的解整合成原问题的最终解。
对于快速排序而言,这三个步骤的具体体现如下:
- 分解 :从数组中选择一个基准元素(pivot),然后围绕该 pivot 将数组划分为两部分——左侧所有元素 ≤ pivot,右侧所有元素 ≥ pivot;
- 解决 :对左右两个子数组分别递归执行快速排序;
- 合并 :由于分区过程已保证相对顺序,无需额外合并操作,排序自然完成。
这种“无需显式合并”的特性使得快排在实现上比归并排序更为轻量,但也要求划分过程必须精准有效。
以下是一个典型的分治流程图,使用 Mermaid 格式展示快速排序的整体执行路径:
graph TD
    A[原始数组] --> B{选择pivot}
    B --> C[小于等于pivot的子数组]
    B --> D[大于pivot的子数组]
    C --> E{是否长度>1?}
    D --> F{是否长度>1?}
    E -->|是| G[递归快排左半区]
    E -->|否| H[已有序]
    F -->|是| I[递归快排右半区]
    F -->|否| J[已有序]
    G --> K[整体有序]
    I --> K
该流程清晰地展现了快排如何通过不断递归缩小问题规模,直至每个子区间仅含单个元素或为空,此时整个数组即完成排序。
此外,我们可以通过表格对比几种常见分治算法的分解与合并策略,以突出快排的独特性:
| 算法 | 分解方式 | 解决方式 | 合并方式 |
|---|---|---|---|
| 快速排序 | 按 pivot 划分左右子数组 | 递归排序左右子数组 | 无(原地分区已完成排序) |
| 归并排序 | 均等切分中间点 | 递归排序两部分 | 合并两个有序数组 |
| 二分查找 | 取中点判断目标所在区间 | 在左或右子区间查找 | 无(直接返回位置) |
| 快速幂 | 将指数 n 拆为 n/2 | 计算 x^(n/2) | 平方后根据奇偶补乘 x |
可以看出,快排的核心优势在于其 原地划分 + 无需合并 的设计,极大减少了空间开销和数据移动成本。
3.1.2 快速排序在分治范式中的定位
尽管快速排序与归并排序同属分治类算法,但在设计理念上有显著差异。归并排序采用“先排序再合并”的策略,确保每一步都严格有序;而快排则是“先分区再排序”,依赖于 pivot 的合理选取来控制效率。
为了更好地理解这一点,考虑如下整数数组:
[6, 2, 9, 3, 7, 1, 8]
若选择 pivot = 6 ,经过一次分区后可能变为:
[2, 3, 1, 6, 9, 7, 8]
此时,虽然整体仍未完全有序,但 6 已处于正确位置(索引3),且左侧均 ≤6,右侧均 >6。接下来只需分别处理 [2,3,1] 和 [9,7,8] 即可。
这说明快排的关键在于: 每一次划分都在确定某个元素的最终位置 ,这是其递归收敛的基础。
与其他分治算法相比,快排的另一个特点是 非对称划分 。理想情况下,每次都能将数组均分为两半,递归深度为 $ \log n $,总时间复杂度为 $ O(n \log n) $。然而一旦划分极度不均(如每次都选到最小或最大值作 pivot),则退化为链式递归,复杂度上升至 $ O(n^2) $。
因此,在分治框架下,快排的性能高度依赖于 划分质量 ,这也是后续章节讨论 pivot 选择策略的重要出发点。
3.1.3 递归调用树的构建过程
快速排序本质上是一个递归过程,其执行轨迹可以抽象为一棵 递归调用树(Recursion Tree) 。每个节点表示一次 quickSort(arr, low, high) 调用,子节点为其对左右子区间的递归调用。
仍以前述数组为例,假设每次选择首元素为 pivot,则递归树大致如下:
graph TD
    A[quickSort(0,6)] --> B[partition pivot=6]
    B --> C[quickSort(0,2)]
    B --> D[quickSort(4,6)]
    C --> E[partition pivot=2]
    C --> F[quickSort(0,-1)?]
    C --> G[quickSort(1,2)]
    G --> H[partition pivot=3]
    G --> I[quickSort(1,0)?]
    G --> J[quickSort(2,2)?]
    D --> K[partition pivot=9]
    D --> L[quickSort(4,5)]
    D --> M[quickSort(6,6)?]
    L --> N[partition pivot=7]
    L --> O[quickSort(4,3)?]
    L --> P[quickSort(5,5)?]
其中叶子节点表示区间无效(low ≥ high),递归终止。
观察此树可知:
- 若 pivot 总能接近中位数,树的高度趋近于 $ \log n $;
- 若 pivot 总是最小或最大值,树退化为链表,高度达 $ n $;
- 每一层的总工作量约为 $ O(n) $(因所有子数组长度之和 ≈ n);
- 故总体时间复杂度取决于树高:最好 $ O(n \log n) $,最坏 $ O(n^2) $。
这也解释了为何随机化 pivot 是提升平均性能的有效手段——它降低了构造极端不平衡划分的概率。
3.2 快速排序的核心机制
快速排序之所以高效,得益于其巧妙的 双指针分区算法 和灵活的递归结构。本节重点解析其三大核心机制:pivot 选择策略、Hoare 划分方法及递归排序流程。
3.2.1 基准元素(pivot)的选择策略
pivot 的选择直接影响划分的均衡程度,进而决定算法效率。常见的选择策略包括:
| 策略 | 描述 | 优缺点分析 |
|---|---|---|
| 固定选择首/尾元素 | 总取第一个或最后一个元素 | 实现简单,但面对有序数组时极易退化 |
| 中位数法 | 取首、中、尾三者之中位数 | 提高平衡性,减少极端情况发生概率 |
| 随机选择 | 使用随机函数生成 index 作为 pivot | 数学期望下接近最优划分,适合对抗恶意输入 |
| 三数取中+随机混合 | 先取三数中位,再在其附近小范围随机选取 | 进一步增强鲁棒性,现代库常用策略 |
实践中, 随机化 pivot 是最推荐的做法,尤其在未知数据分布的情况下。以下是C++中实现随机选择 pivot 的代码片段:
#include <cstdlib>
#include <ctime>

// 在 [low, high] 范围内随机选择 pivot 并与 arr[low] 交换
int randomPivot(vector<int>& arr, int low, int high) {
    srand(time(nullptr)); // 初始化随机种子(应只调用一次)
    int randomIndex = low + rand() % (high - low + 1);
    swap(arr[low], arr[randomIndex]); // 将随机元素移到首位
    return arr[low]; // 返回 pivot 值用于划分
}
逐行解读:
- 第5行: srand(time(nullptr)) 初始化随机数生成器。注意:应在程序启动时调用一次,避免多次调用导致相同种子。
- 第6行: rand() % (high - low + 1) 生成 [0, high-low] 的随机偏移量,加上 low 得到合法索引。
- 第7行:将选中的随机元素与 arr[low] 交换,便于后续统一使用左端 pivot 的划分逻辑。
- 第8行:返回 pivot 值,供分区函数使用。
⚠️ 注意:频繁调用
srand()会导致短时间内重复种子,产生相同序列。建议将其放在main()函数开头执行一次。
3.2.2 双指针分区算法(Hoare划分)
Hoare 划分是由 Tony Hoare 提出的经典分区方法,使用两个指针从数组两端向中间扫描并交换逆序元素。其核心逻辑如下:
int hoarePartition(vector<int>& arr, int low, int high) {
    int pivot = arr[low]; // 默认取首元素为 pivot
    int i = low - 1;
    int j = high + 1;

    while (true) {
        do { i++; } while (arr[i] < pivot); // 找左边第一个 >= pivot 的
        do { j--; } while (arr[j] > pivot); // 找右边第一个 <= pivot 的

        if (i >= j) return j; // 交叉则结束,j 是分割点

        swap(arr[i], arr[j]); // 交换逆序对
    }
}
参数说明:
- arr : 待排序数组(引用传递,支持修改)
- low , high : 当前处理区间的边界索引
- pivot : 基准值,用于比较
- i , j : 左右扫描指针
逻辑分析:
- 外层 while(true) 表示持续循环直到指针交叉;
- 内部两个 do-while 循环分别寻找不符合条件的元素: i 向右找第一个大于等于 pivot 的, j 向左找第一个小于等于 pivot 的;
- 当 i >= j 时停止,返回 j 作为新的分割点(左子数组结束位置);
- 否则交换 arr[i] 和 arr[j] ,继续下一轮扫描。
例如,对数组 [5, 3, 8, 4, 2, 7, 1] ,设 pivot=5 ,初始 i=-1 , j=7 :
| 步骤 | i变化 | j变化 | 条件满足? | 操作 |
|---|---|---|---|---|
| 1 | →0 | ←6 | arr[0]=5≥5, arr[6]=1≤5 | 继续 |
| 2 | →1 | ←6 | arr[1]=3<5 → continue | i++ until 2 |
| 3 | →2 | ←6 | arr[2]=8>5 ⇒ 停止 i | 开始 j 扫描 |
| 4 | 2 | ←5 | arr[5]=7>5 → j– →4 | |
| 5 | 2 | ←4 | arr[4]=2≤5 ⇒ 停止 j | i=2<j=4 ⇒ 交换 |
| 6 | 交换 arr[2] 和 arr[4] → [5,3,2,4,8,7,1] | 继续循环 | ||
| … | 最终 i=4, j=3 ⇒ i>j ⇒ 返回 j=3 |
最终数组变为 [5,3,2,4,8,7,1] ,且 j=3 为分割点,左半区 [5,3,2,4] ≤5,右半区 [8,7,1] ≥5。
3.2.3 左右子数组的递归排序实现
完成一次分区后,即可对左右子数组递归调用快排。完整递归函数如下:
void quickSort(vector<int>& arr, int low, int high) {
    if (low < high) { // 至少两个元素才需排序
        int pivotIndex = hoarePartition(arr, low, high);
        quickSort(arr, low, pivotIndex);     // 排序左半区
        quickSort(arr, pivotIndex + 1, high); // 排序右半区
    }
}
参数说明:
- low < high :递归终止条件,防止无限递归;
- pivotIndex :由 hoarePartition 返回的分割点;
- 左子数组范围: [low, pivotIndex] ;
- 右子数组范围: [pivotIndex + 1, high] 。
该实现简洁高效,体现了分治法“分解→递归解决”的典型模式。
3.3 C++递归实现细节
在真实工程环境中,快速排序的递归实现需特别关注函数参数管理、终止条件设置以及栈溢出风险。
3.3.1 函数参数传递与区间控制
C++ 中推荐使用 vector<int>& 引用传参,避免拷贝开销。区间通过 low 和 high 明确界定,支持任意子段排序。
void quickSort(vector<int>& arr, int low, int high)
这种方式允许外部调用者指定排序范围,例如:
vector<int> data = {6, 2, 9, 3, 7, 1, 8};
quickSort(data, 0, data.size() - 1);
同时也方便测试特定子数组行为。
3.3.2 递归终止条件设置
关键终止条件为:
if (low >= high) return;
这意味着:
- 区间为空( low > high );
- 或仅有一个元素( low == high );
两者皆无需进一步排序。遗漏此条件将导致无限递归,引发栈溢出。
3.3.3 内存使用与栈深度风险预警
由于快排使用递归,系统调用栈会保存每一层的状态(局部变量、返回地址等)。最坏情况下(如已排序数组 + 固定首元素 pivot),递归深度可达 $ O(n) $,极易触发 stack overflow 。
解决方案包括:
- 改用迭代 + 显式栈模拟递归;
- 对较大子问题优先递归,小问题用尾递归或循环处理;
- 当子数组长度 < 10 时切换插入排序(见 3.4.3);
例如,改进版可限制最大递归深度:
const int MAX_DEPTH = 32;

bool quickSortWithDepth(vector<int>& arr, int low, int high, int depth) {
    if (depth > MAX_DEPTH) {
        insertionSort(arr, low, high); // 深度过大改用非递归算法
        return false;
    }
    if (low < high) {
        int p = hoarePartition(arr, low, high);
        quickSortWithDepth(arr, low, p, depth + 1);
        quickSortWithDepth(arr, p + 1, high, depth + 1);
    }
    return true;
}
3.4 实际运行中的挑战应对
快速排序虽高效,但在特定输入下存在明显短板。本节探讨三种典型挑战及其应对策略。
3.4.1 最坏情况(已排序数组)性能退化
当输入为升序或降序数组且固定选择首元素为 pivot 时,每次划分只能排除一个元素,导致时间复杂度退化为 $ O(n^2) $。
示例:
输入 [1,2,3,4,5] ,pivot=1 → 划分后左空右4个元素 → 下次 pivot=2 → … → 共需 $ n + (n-1) + … + 1 = O(n^2) $ 次比较。
解决方案: 随机化 pivot,打破输入与算法之间的耦合关系。
3.4.2 随机化pivot提升平均表现
引入随机选择后,任何特定输入都无法稳定触发最坏情况。数学证明表明,期望比较次数为 $ 1.39n\log n $,接近信息论下限。
修改 quickSort 调用前先随机换 pivot:
int randomizedPartition(vector<int>& arr, int low, int high) {
    int randomIndex = low + rand() % (high - low + 1);
    swap(arr[low], arr[randomIndex]);
    return hoarePartition(arr, low, high);
}
随后在 quickSort 中调用此版本即可。
3.4.3 小规模数组切换至插入排序优化
对于长度小于10的子数组,插入排序的实际运行速度往往超过快排,因其常数因子更低且无需递归开销。
定义阈值并修改主函数:
const int INSERTION_SORT_THRESHOLD = 10;

void optimizedQuickSort(vector<int>& arr, int low, int high) {
    while (low < high) {
        if (high - low + 1 < INSERTION_SORT_THRESHOLD) {
            insertionSort(arr, low, high);
            break;
        } else {
            int p = randomizedPartition(arr, low, high);
            // 优先处理较小区间,减少栈深度
            if (p - low < high - p) {
                optimizedQuickSort(arr, low, p);
                low = p + 1;
            } else {
                optimizedQuickSort(arr, p + 1, high);
                high = p;
            }
        }
    }
}
此版本结合了 尾递归优化 与 混合排序策略 ,显著提升实战性能。
4. 冒泡排序比较交换机制与优化思路
冒泡排序作为一种经典但效率较低的排序算法,其核心在于通过反复遍历数组,对相邻元素进行比较和交换,逐步将最大(或最小)元素“上浮”到正确位置。尽管在现代工程实践中几乎不会被用于大规模数据排序,但冒泡排序因其逻辑直观、实现简单,在教学场景中仍具有不可替代的价值。它不仅能够帮助初学者理解排序的本质——即通过比较与移动构建有序序列,还为后续学习更复杂的分治、递归类算法提供了思维铺垫。更重要的是,通过对冒泡排序的深入剖析及其多种优化策略的探讨,可以揭示出算法设计中的关键思想:如何识别冗余操作、减少无效计算、提升自适应性。
本章将系统解析冒泡排序的工作机制,从基础版本的双重循环结构入手,展示其逐轮“冒泡”的过程,并结合C++语言完成可运行代码实现。随后重点聚焦于三种典型优化手段:引入提前终止标志位以应对已排序情况、利用最后交换位置动态缩小扫描范围、以及增强算法对近似有序数据的响应能力。这些优化虽不能改变其最坏时间复杂度为 $ O(n^2) $ 的本质,但在实际运行中显著改善了平均性能表现。最后,结合与其他排序算法的对比,客观评估冒泡排序的教学意义与实用局限,引导读者建立正确的算法选型认知。
4.1 冒泡排序的工作原理
4.1.1 相邻元素两两比较规则
冒泡排序的基本操作单位是“相邻元素的比较”。在整个排序过程中,算法始终遵循一个简单的规则:从前向后依次检查每一对相邻元素,若前一个元素大于后一个元素(假设升序排列),则交换它们的位置。这一规则看似原始,却构成了整个排序流程的基础驱动力。
以整数数组 arr = [5, 2, 8, 1, 9] 为例,第一轮遍历开始时,比较 5 > 2 ,满足条件,执行交换 → [2, 5, 8, 1, 9] ;接着 5 < 8 ,不交换;然后 8 > 1 ,交换 → [2, 5, 1, 8, 9] ;最后 8 < 9 ,不交换。经过第一轮完整的扫描,最大的元素 9 已经“沉底”至末尾。这种逐次比较并交换的方式确保了每一轮都能将当前未排序部分的最大值推送到正确位置。
值得注意的是,该比较规则具有局部性和确定性特点。所谓局部性,是指每次只关注两个紧邻的数据点,无需全局信息;而确定性意味着只要满足大小关系条件就必须交换,不存在跳过或延迟决策的情况。这使得算法行为高度可预测,便于调试和教学演示。
此外,比较操作本身是稳定排序的关键保障。由于仅当“前 > 后”时才交换,相等元素之间的相对顺序不会被打乱。例如,若有两个相同的数值 x 分别位于索引 i 和 j ( i < j ),且中间无更大值阻隔,则它们在整个排序过程中始终保持原有先后关系。这一点对于需要保持原始输入顺序的应用场景尤为重要。
为了更清晰地展现比较过程的演进路径,以下使用 Mermaid 流程图描述单轮冒泡的核心逻辑:
graph TD
    A[开始本轮遍历] --> B{i < n-1?}
    B -- 是 --> C[比较 arr[i] 与 arr[i+1]]
    C --> D{arr[i] > arr[i+1]?}
    D -- 是 --> E[交换 arr[i] 与 arr[i+1]]
    D -- 否 --> F[继续]
    E --> F
    F --> G[i++]
    G --> B
    B -- 否 --> H[本轮结束]
该流程图准确反映了冒泡排序中每一趟扫描的控制流结构:外层判断控制是否继续遍历,内层条件决定是否触发交换动作。整个过程呈现出典型的线性迭代模式,适合用循环结构实现。
4.1.2 “上浮”最大值的过程模拟
“上浮”是描述冒泡排序动态行为的形象化术语。虽然严格来说,较大元素是在不断向右移动直至到达末尾,类似于气泡从水底升至水面,因此得名“冒泡”。实际上,每一轮完整的遍历都会使一个最大元素抵达其最终位置,形成一种逐步收敛的趋势。
考虑数组 [6, 3, 7, 2, 8, 1] 的完整排序过程:
| 轮次 | 遍历过程(箭头表示交换) | 结果状态 |
|---|---|---|
| 1 | 6↔3→[3,6], 6<7, 7↔2→[3,6,2,7], 7<8, 8↔1→[3,6,2,7,1,8] | [3,6,2,7,1, 8 ] |
| 2 | 3<6, 6↔2→[3,2,6], 6<7, 7↔1→[3,2,6,1,7] | [3,2,6,1, 7 ,8] |
| 3 | 3↔2→[2,3], 3<6, 6↔1→[2,3,1,6] | [2,3,1, 6 ,7,8] |
| 4 | 2<3, 3↔1→[2,1,3] | [2,1, 3 ,6,7,8] |
| 5 | 2↔1→[1,2] | [ 1 ,2,3,6,7,8] |
观察可知,每轮结束后,右侧已排序区域逐渐扩大,左侧未排序部分持续缩小。第 $ k $ 轮结束后,末尾 $ k $ 个元素已经处于最终位置,因此下一轮只需处理前 $ n-k $ 个元素即可。
这一“逐轮沉淀最大值”的特性决定了算法必须进行最多 $ n-1 $ 轮遍历才能确保完全有序。即使在最优情况下(如数组已有序),基础版本仍会执行全部轮次,造成资源浪费。这也正是后续优化策略所要解决的核心问题之一。
4.1.3 多轮扫描完成整体排序
冒泡排序的整体执行框架依赖于多轮扫描的累积效应。单次遍历只能保证一个元素归位,因此需要重复执行直到所有元素都到达正确位置。设数组长度为 $ n $,则最多需进行 $ n-1 $ 轮扫描,因为最后一个元素无需比较即可确定位置。
每轮扫描的范围随轮次递减。具体而言,第 $ i $ 轮扫描只需处理前 $ n-i $ 个元素,因为后 $ i $ 个元素已被确认为最大且有序。例如,当 $ i=2 $ 时,只需比较 arr[0]~arr[n-3] 之间的相邻对。
这种范围收缩机制体现了算法内在的结构性优化潜力。虽然基础版本常采用固定范围遍历(即每次都从 0 到 n-2 ),但合理调整内层循环边界可避免不必要的比较操作,从而提升效率。
此外,多轮扫描的终止条件也值得关注。理想情况下,若某一轮中未发生任何交换,说明数组已然有序,后续扫描不再必要。这一现象构成了“提前终止”优化的技术依据。例如,对 [1,2,3,4,5] 执行第一轮扫描时,所有相邻对均满足 arr[i] ≤ arr[i+1] ,无交换发生,此时即可判定排序完成,无需继续执行剩余四轮。
综上所述,冒泡排序通过多轮扫描实现了从局部有序到全局有序的渐进演化。其过程清晰、逻辑严密,非常适合用于讲解排序算法的基本范式。然而,正因其每轮仅推进一个元素到位,导致总体效率偏低,尤其在大数据集上表现不佳。
4.2 基础版本C++编码实现
4.2.1 双重嵌套循环结构搭建
冒泡排序的标准实现依赖于双重嵌套循环:外层控制轮数,内层执行相邻比较与交换。以下是标准C++实现代码:
#include <iostream>
using namespace std;

void bubbleSort(int arr[], int n) {
    for (int i = 0; i < n - 1; i++) {        // 外层循环:控制轮数
        for (int j = 0; j < n - 1 - i; j++) { // 内层循环:相邻比较
            if (arr[j] > arr[j + 1]) {
                swap(arr[j], arr[j + 1]);     // 发现逆序则交换
            }
        }
    }
}

int main() {
    int arr[] = {64, 34, 25, 12, 22, 11, 90};
    int n = sizeof(arr) / sizeof(arr[0]);

    cout << "排序前: ";
    for (int i = 0; i < n; i++) cout << arr[i] << " ";
    cout << endl;

    bubbleSort(arr, n);

    cout << "排序后: ";
    for (int i = 0; i < n; i++) cout << arr[i] << " ";
    cout << endl;

    return 0;
}
逻辑分析与参数说明:
- 外层循环
i:表示当前是第几轮排序,取值范围为0到n-2,共执行 $ n-1 $ 次。 - 内层循环
j:执行相邻比较,范围为0到n-2-i,随着i增大,比较次数递减。 - 条件判断
arr[j] > arr[j+1]:检测是否构成逆序对,若是则交换。 -
swap()函数 :标准库提供的交换函数,也可手动实现:
cpp int temp = arr[j]; arr[j] = arr[j+1]; arr[j+1] = temp;
此实现具备良好的可读性和结构清晰性,适用于教学演示。
4.2.2 swap函数或临时变量交换实现
在C++中,元素交换可通过 std::swap 或手动使用临时变量完成。两者功能等价,但各有适用场景。
使用 swap 函数:
#include <algorithm> // 需包含头文件
swap(arr[j], arr[j+1]);
优点:语法简洁,语义明确,支持泛型,适用于各类数据类型(包括自定义对象)。
手动实现交换:
int temp = arr[j];
arr[j] = arr[j+1];
arr[j+1] = temp;
优点:不依赖额外库函数,便于理解底层机制,适合初学者掌握赋值操作的本质。
在性能方面,现代编译器会对 swap 进行内联优化,实际效率与手动实现相当。但对于非POD类型(如类对象), swap 更安全高效,能避免深拷贝开销。
4.2.3 排序结果输出与验证
输出排序前后数组内容是验证算法正确性的基本手段。通过打印数组状态,可直观确认排序效果。
void printArray(int arr[], int n) {
    for (int i = 0; i < n; i++) {
        cout << arr[i] << " ";
    }
    cout << endl;
}
调用方式如下:
cout << "排序前: "; printArray(arr, n);
bubbleSort(arr, n);
cout << "排序后: "; printArray(arr, n);
此外,还可编写自动化测试函数,验证排序结果是否非降序:
bool isSorted(int arr[], int n) {
    for (int i = 0; i < n - 1; i++) {
        if (arr[i] > arr[i+1]) return false;
    }
    return true;
}
该函数可用于批量测试不同数据集下的算法稳定性。
4.3 典型优化手段实践
4.3.1 提前终止标志位设置(无交换即结束)
基础版本无论数据是否有序,均执行全部 $ n-1 $ 轮。引入布尔标志位可在无交换发生时提前退出,极大提升对有序或近似有序数据的处理效率。
void optimizedBubbleSort(int arr[], int n) {
    for (int i = 0; i < n - 1; i++) {
        bool swapped = false; // 标志位初始化
        for (int j = 0; j < n - 1 - i; j++) {
            if (arr[j] > arr[j + 1]) {
                swap(arr[j], arr[j + 1]);
                swapped = true; // 记录发生交换
            }
        }
        if (!swapped) break; // 本轮无交换,提前终止
    }
}
参数说明:
-
swapped:布尔变量,初始为false,一旦发生交换即置为true。 -
if (!swapped):若本轮未发生任何交换,说明数组已有序,立即跳出外层循环。
此优化使最好情况时间复杂度由 $ O(n^2) $ 改善为 $ O(n) $,显著提升了算法自适应性。
4.3.2 减少无效扫描范围(记录最后交换位置)
进一步优化可基于“最后一次交换的位置之后已有序”的观察。例如,若某轮中最后一次交换发生在索引 k ,则 k+1 到 n-1 区域无需再参与后续比较。
void advancedBubbleSort(int arr[], int n) {
    int lastSwapIndex = n - 1; // 初始扫描边界
    while (lastSwapIndex > 0) {
        int newLastSwap = 0;
        for (int j = 0; j < lastSwapIndex; j++) {
            if (arr[j] > arr[j + 1]) {
                swap(arr[j], arr[j + 1]);
                newLastSwap = j; // 更新最后交换位置
            }
        }
        lastSwapIndex = newLastSwap; // 缩小扫描范围
    }
}
优势分析:
- 动态调整扫描上限,避免对已有序部分重复检查。
- 在部分有序数据中表现优异,减少约 30%-50% 的比较次数。
4.3.3 自适应性增强:对近似有序数据敏感
综合上述两种优化,可构造高度自适应的冒泡排序变体。这类算法特别适合处理数据库日志、实时监控流等常见“基本有序”的现实数据。
| 数据类型 | 基础冒泡 | 优化冒泡(标志位) | 高级优化(位置追踪) |
|---|---|---|---|
| 完全随机 | O(n²) | O(n²) | O(n²) |
| 已排序 | O(n²) | O(n) | O(n) |
| 仅首尾颠倒 | O(n²) | O(n²) | O(n) |
| 局部扰动有序 | O(n²) | O(n²) | O(nk), k为扰动规模 |
可见,高级优化版本在特定场景下展现出接近线性的时间性能,体现出算法设计中“因情施策”的重要理念。
4.4 教学价值与实用局限
4.4.1 易于理解但效率低下原因剖析
冒泡排序之所以广受教学青睐,源于其极高的概念透明度。学生无需掌握递归、指针或复杂数据结构即可理解其工作方式。然而,其时间复杂度恒为 $ O(n^2) $(除最优情况外),空间复杂度 $ O(1) $,在所有 $ O(n^2) $ 算法中性能最差之一。
根本原因在于:每轮只能确保一个元素归位,且存在大量冗余比较。相比之下,选择排序虽也是 $ O(n^2) $,但交换次数仅为 $ O(n) $,而冒泡可能达到 $ O(n^2) $ 次交换,加剧了内存写入开销。
4.4.2 仅适用于小规模教学演示场景
在实际开发中,冒泡排序几乎从未被采用。即便是小数据集($ n < 50 $),插入排序也因其更好的缓存局部性和更低的常数因子而更具优势。STL 中的 std::sort 采用混合策略(Introsort),远超冒泡性能。
因此,冒泡排序的实际用途局限于:
- 算法启蒙教育
- 性能对比实验基准
- 特殊硬件限制环境(如极低内存)
4.4.3 作为复杂算法对比基准的意义
尽管实用性有限,冒泡排序仍是衡量其他算法优越性的重要参照物。通过将其与快速排序、归并排序对比,可直观展示 $ O(n^2) $ 与 $ O(n \log n) $ 的数量级差异。例如,当 $ n=10^4 $ 时,冒泡需约 $ 10^8 $ 次操作,而快排仅需约 $ 1.3 \times 10^5 $ 次,相差近千倍。
正是在这种强烈反差中,开发者才能深刻体会到算法优化的重要性,进而激发对高效算法的研究兴趣。
5. 时间复杂度分析:O(n²)与O(n log n)
在算法设计与工程实践中,衡量一个排序算法的优劣并不仅仅依赖于其能否正确完成任务,更重要的是它在不同数据规模下的执行效率。这种效率通常通过 时间复杂度 来量化,它是描述算法运行时间随输入规模增长而变化趋势的核心工具。本章将深入探讨两种典型的时间复杂度类别——$ O(n^2) $ 和 $ O(n \log n) $,从理论基础出发,结合选择排序、冒泡排序和快速排序的实际行为,系统性地揭示它们背后的数学逻辑,并进一步讨论影响实际性能的关键因素,为后续算法选型提供科学依据。
5.1 渐进复杂度理论基础
渐进复杂度是算法分析中最核心的概念之一,它帮助我们忽略常数项、低阶项和硬件差异,专注于随着问题规模 $ n $ 趋于无穷时,算法资源消耗的增长趋势。这一抽象方法使得我们可以对不同算法进行横向比较,尤其是在处理大规模数据时具有极强的指导意义。
5.1.1 大O符号定义与数学含义
大O符号(Big-O Notation)用于表示函数增长的上界。形式化地说,若存在正常数 $ c $ 和 $ n_0 $,使得对于所有 $ n \geq n_0 $,都有:
T(n) \leq c \cdot f(n)
则称 $ T(n) = O(f(n)) $。这表明算法的运行时间不会超过某个倍数乘以 $ f(n) $,即使在最坏情况下也是如此。
例如,在双重循环结构中,外层循环执行 $ n-1 $ 次,内层平均每次执行约 $ n/2 $ 次操作,则总的操作次数约为 $ \frac{n(n-1)}{2} \approx \frac{1}{2}n^2 $。由于常数因子被忽略,因此其时间复杂度记为 $ O(n^2) $。
下面用代码展示一个典型的 $ O(n^2) $ 算法结构:
void nestedLoopExample(int arr[], int n) {
    int count = 0;
    for (int i = 0; i < n; i++) {           // 外层循环:n 次
        for (int j = i + 1; j < n; j++) {   // 内层循环:平均 n/2 次
            if (arr[i] > arr[j]) {
                swap(arr[i], arr[j]);
            }
            count++; // 统计比较次数
        }
    }
    cout << "Total comparisons: " << count << endl;
}
代码逻辑逐行解读:
- 第3行 :初始化计数器
count,用于统计实际比较次数。 - 第4行 :外层
for循环遍历数组每个元素,共执行 $ n $ 次。 - 第5行 :内层
for循环从i+1开始,避免重复比较,共执行 $ n - i - 1 $ 次。 - 第6–9行 :条件判断与交换操作,属于常数时间操作 $ O(1) $。
- 第10行 :每进行一次比较就递增
count。 - 第11行 :输出总的比较次数,理论上应接近 $ \frac{n(n-1)}{2} $。
该算法的总比较次数为:
\sum_{i=0}^{n-1}(n - i - 1) = \frac{n(n-1)}{2} = O(n^2)
| 输入大小 $ n $ | 预期比较次数 | 实际输出(示例) |
|---|---|---|
| 10 | 45 | 45 |
| 100 | 4950 | 4950 |
| 1000 | 499500 | 499500 |
表格说明:随着 $ n $ 增长,比较次数呈平方级增长,验证了 $ O(n^2) $ 的理论预测。
mermaid 流程图:双重循环执行路径
graph TD
    A[开始] --> B{i = 0 到 n-1}
    B --> C{j = i+1 到 n-1}
    C --> D[比较 arr[i] 与 arr[j]]
    D --> E{是否 arr[i] > arr[j]?}
    E -->|是| F[交换元素]
    E -->|否| G[继续]
    F --> H[增加比较计数]
    G --> H
    H --> I{j 是否结束?}
    I -->|否| C
    I -->|是| J{i 是否结束?}
    J -->|否| B
    J -->|是| K[输出结果]
    K --> L[结束]
此流程图清晰展示了嵌套循环的控制流,体现了 $ O(n^2) $ 结构的内在机制。
5.1.2 最好、最坏、平均情况区分
同一个算法在不同输入条件下可能表现出显著不同的性能。因此,必须区分三种典型场景:
- 最好情况(Best Case) :输入数据使算法执行最少操作,如已排序数组上的冒泡排序。
- 最坏情况(Worst Case) :输入导致最多操作,如逆序数组上的插入排序。
- 平均情况(Average Case) :对所有可能输入取期望值,通常假设输入均匀随机分布。
以冒泡排序为例:
| 情况 | 描述 | 时间复杂度 |
|---|---|---|
| 最好情况 | 数组已经有序 | $ O(n) $ |
| 最坏情况 | 数组完全逆序 | $ O(n^2) $ |
| 平均情况 | 所有排列等概率出现 | $ O(n^2) $ |
相比之下,选择排序无论输入如何,都必须完成固定的比较次数 $ \frac{n(n-1)}{2} $,所以它的最好、最坏、平均情况均为 $ O(n^2) $,不具备自适应性。
快速排序则不同:其最坏情况出现在每次划分极度不平衡时(如 pivot 总是最小或最大),此时退化为 $ O(n^2) $;但在理想划分下(每次均分),递归深度为 $ \log n $,每层处理 $ O(n) $ 数据,故平均时间为 $ O(n \log n) $。
5.1.3 比较次数与移动次数统计方法
除了总体时间复杂度外,还需关注具体操作类型的影响。在排序中,主要有两类基本操作:
- 比较次数(Comparisons) :决定控制流走向,影响分支预测、缓存效率。
- 移动次数(Movements / Swaps) :涉及内存写入,代价较高,尤其在物理存储设备上。
以下是一个通用的统计框架:
struct SortStats {
    long long comparisons;
    long long swaps;
    clock_t startTime;
    clock_t endTime;

    void reset() {
        comparisons = 0;
        swaps = 0;
    }

    double getDuration() {
        return ((double)(endTime - startTime)) / CLOCKS_PER_SEC;
    }
};

SortStats stats;

#define COMPARE(a, b) (++stats.comparisons, (a) > (b))
#define SWAP(a, b) do { \
    int temp = a; \
    a = b; \
    b = temp; \
    ++stats.swaps; \
} while(0)
参数说明与扩展性解释:
-
SortStats封装了关键性能指标,便于跨算法统一测量。 - 使用宏定义
COMPARE和SWAP可精确捕获每一次核心操作。 -
clock()提供粗粒度时间测量,适合教学演示;生产环境建议使用std::chrono。
通过该机制可对比不同算法在相同数据集下的表现差异,进而分析其实际开销构成。
5.2 三种排序算法复杂度对比
为了更直观理解 $ O(n^2) $ 与 $ O(n \log n) $ 的本质区别,本节选取前几章介绍的选择排序、冒泡排序和快速排序作为代表,详细剖析其复杂度成因,并借助数学推导揭示效率悬殊的根本原因。
5.2.1 选择排序恒定O(n²)成因解析
选择排序的核心思想是在未排序部分反复寻找最小元素并放置到前端。其执行过程如下:
- 第一轮扫描 $ n $ 个元素,找到最小值,交换至位置 0;
- 第二轮扫描剩余 $ n-1 $ 个元素,找到次小值,交换至位置 1;
- …
- 最后一轮仅剩 1 个元素,无需操作。
总共需要进行:
(n-1) + (n-2) + \cdots + 1 = \frac{n(n-1)}{2}
次比较,且每次交换最多执行一次(即 $ n-1 $ 次交换)。因此:
- 比较次数 :始终为 $ \Theta(n^2) $
- 交换次数 :$ \Theta(n) $
尽管交换较少,但主导项仍是比较操作,故整体时间复杂度为 $ O(n^2) $ ,且不受输入顺序影响。
示例代码实现及统计增强版:
void selectionSortWithStats(int arr[], int n) {
    stats.reset();
    stats.startTime = clock();

    for (int i = 0; i < n - 1; i++) {
        int minIndex = i;
        for (int j = i + 1; j < n; j++) {
            if (COMPARE(arr[j], arr[minIndex])) {
                minIndex = j;
            }
        }
        if (minIndex != i) {
            SWAP(arr[i], arr[minIndex]);
        }
    }

    stats.endTime = clock();
}
执行逻辑分析:
- 外层循环控制已排序区域右边界,共 $ n-1 $ 轮。
- 内层循环查找当前最小元素索引。
- 使用
COMPARE宏记录每次比较,确保统计准确。 - 仅当
minIndex != i时才调用SWAP,减少不必要的赋值。
| $ n $ | 比较次数(理论) | 实测比较次数 | 交换次数 |
|---|---|---|---|
| 100 | 4950 | 4950 | ≤ 99 |
| 1000 | 499500 | 499500 | ≤ 999 |
数据表明:选择排序的比较成本固定,无法利用数据局部有序性优化。
5.2.2 冒泡排序在不同数据分布下的表现差异
冒泡排序通过相邻元素比较与交换,逐步将较大元素“浮”向末尾。其原始版本总是执行 $ n-1 $ 轮,每轮比较 $ n-i-1 $ 次,总计仍为 $ O(n^2) $。
然而,经过优化后,可通过引入“标志位”提前终止:
void optimizedBubbleSort(int arr[], int n) {
    stats.reset();
    stats.startTime = clock();

    for (int i = 0; i < n - 1; i++) {
        bool swapped = false;
        for (int j = 0; j < n - i - 1; j++) {
            if (COMPARE(arr[j], arr[j + 1])) {
                SWAP(arr[j], arr[j + 1]);
                swapped = true;
            }
        }
        if (!swapped) break; // 无交换发生,说明已有序
    }

    stats.endTime = clock();
}
逻辑分析:
-
swapped标志位记录本轮是否有交换。 - 若某轮全程无交换,说明数组已有序,立即退出。
- 在最好情况(已排序)下,只需一轮 $ n-1 $ 次比较即可结束,时间复杂度降为 $ O(n) $。
| 数据状态 | 比较次数 | 交换次数 | 时间复杂度 |
|---|---|---|---|
| 已排序 | $ n-1 $ | 0 | $ O(n) $ |
| 逆序 | $ \frac{n(n-1)}{2} $ | $ \frac{n(n-1)}{2} $ | $ O(n^2) $ |
| 随机 | ≈ $ 0.5n^2 $ | ≈ $ 0.25n^2 $ | $ O(n^2) $ |
表格显示:冒泡排序具备一定 自适应性 ,但最坏和平均情况仍不理想。
mermaid 图:冒泡排序优化前后流程对比
graph LR
    subgraph 传统冒泡
        A[开始] --> B[固定执行 n-1 轮]
        B --> C[每轮完整扫描]
        C --> D[强制完成所有轮次]
    end

    subgraph 优化冒泡
        E[开始] --> F[设置 swapped=false]
        F --> G[扫描未排序段]
        G --> H{发生交换?}
        H -->|是| I[置 swapped=true]
        H -->|否| J[本轮无交换]
        I --> K[继续下一轮]
        J --> L{swapped 为 false?}
        L -->|是| M[提前终止]
    end
可见,优化版本增加了早期退出机制,提升了对近似有序数据的响应能力。
5.2.3 快速排序平均O(n log n)期望推导
快速排序采用分治策略:选取基准元素(pivot),将数组划分为小于和大于 pivot 的两部分,然后递归处理左右子数组。
设 $ T(n) $ 为排序 $ n $ 个元素的期望时间。若每次划分能将数组均分为两半,则:
T(n) = 2T\left(\frac{n}{2}\right) + O(n)
根据主定理(Master Theorem),解得 $ T(n) = O(n \log n) $。
但现实中划分未必均衡。考虑随机化 pivot 选择,使得每个元素成为 pivot 的概率相等。可以证明,在随机输入下, 期望比较次数为 $ 2n \ln n $ ,即 $ O(n \log n) $。
分析过程简述:
每次 partition 过程需遍历整个区间,耗时 $ O(n) $。递归树的每一层总共处理 $ n $ 个元素,层数取决于划分平衡程度。
- 最佳划分(每次中位数)→ 树高 $ \log_2 n $
- 最差划分(极端偏斜)→ 树高 $ n $
- 平均划分 → 期望高度 $ O(\log n) $
因此,平均时间复杂度为:
T(n) = O(n) \times O(\log n) = O(n \log n)
void quickSort(int arr[], int low, int high) {
    if (low < high) {
        int pi = partition(arr, low, high); // O(n)
        quickSort(arr, low, pi - 1);         // 递归左半
        quickSort(arr, pi + 1, high);        // 递归右半
    }
}
参数说明:
-
low,high:当前处理区间的边界。 -
partition返回 pivot 的最终位置。 - 递归终止条件为
low >= high。
注:为防止栈溢出,可在小数组时切换至插入排序(见第3章优化策略)。
5.3 实际运行效率影响因素
理论上 $ O(n \log n) $ 明显优于 $ O(n^2) $,但在真实系统中,多个非渐近因素会显著影响实际性能表现。
5.3.1 数据初始状态对性能的影响
如前所述,某些算法对输入敏感。例如:
- 冒泡排序在有序数据上表现优异;
- 快速排序在已排序数组上若固定选首元素为 pivot,会导致每次划分仅减少一个元素,退化为 $ O(n^2) $。
解决方法:采用 三数取中法 或 随机化 pivot 来提高鲁棒性。
5.3.2 缓存局部性与内存访问模式
现代CPU具有多级缓存(L1/L2/L3),连续访问相邻内存地址可大幅提升命中率。选择排序和冒泡排序具有良好的空间局部性(顺序访问),而快速排序虽递归深,但分区过程也是线性扫描,缓存友好。
反观归并排序需额外数组空间,且频繁跨区间读写,可能引发更多缓存未命中。
5.3.3 递归开销与函数调用成本
快速排序依赖递归实现,每次调用产生栈帧开销(保存返回地址、参数、局部变量)。当 $ n $ 较小时,这些开销占比显著上升。
解决方案:设置阈值(如 $ n < 10 $),改用插入排序。
void hybridQuickSort(int arr[], int low, int high) {
    if (high - low + 1 < 10) {
        insertionSort(arr, low, high);
    } else if (low < high) {
        int pi = partition(arr, low, high);
        hybridQuickSort(arr, low, pi - 1);
        hybridQuickSort(arr, pi + 1, high);
    }
}
此举既保留了快排的大规模高效性,又规避了小数组的递归浪费。
5.4 算法选择的权衡依据
最终选用何种排序算法,需综合考量多种维度:
| 维度 | 选择排序 | 冒泡排序 | 快速排序 |
|---|---|---|---|
| 时间复杂度(平均) | $ O(n^2) $ | $ O(n^2) $ | $ O(n \log n) $ |
| 空间复杂度 | $ O(1) $ | $ O(1) $ | $ O(\log n) $ |
| 稳定性 | 否 | 是 | 否(标准版) |
| 原地排序 | 是 | 是 | 是 |
| 自适应性 | 无 | 有(优化后) | 一般 |
| 实现难度 | 简单 | 简单 | 中等 |
结论:对于工业级应用,推荐使用基于快速排序改进的
std::sort(Introsort);教学场景可优先讲解选择与冒泡;稳定性要求高时可选归并排序。
综上所述,理解时间复杂度不仅是掌握算法本质的关键,更是构建高性能系统的基石。唯有结合理论分析与实践测量,才能做出最优决策。
6. VC6.0开发环境下排序程序调试与运行
6.1 VC6.0集成开发环境概述
Visual C++ 6.0(简称VC6.0)是微软于1998年发布的一款经典C++开发工具,尽管其已严重过时,但在教学、旧系统维护及部分嵌入式开发中仍有使用。该IDE基于Windows平台,提供项目管理、代码编辑、编译链接和基础调试功能。
6.1.1 工程创建与源文件添加
在VC6.0中创建控制台应用程序的步骤如下:
- 打开VC6.0,选择 File → New 。
- 在弹出窗口中选择“Projects”标签页,选择“Win32 Console Application”。
- 输入工程名称(如
SortDemo),设置存储路径。 - 点击“OK”,选择“An empty project”,完成工程创建。
- 再次进入 File → New ,选择“Files”标签页,新建
.cpp源文件并加入工程。
// main.cpp
#include <iostream>
using namespace std;

void selectionSort(int arr[], int n);
void quickSort(int arr[], int low, int high);

int main() {
    int data[] = {64, 34, 25, 12, 22, 11, 90};
    int n = sizeof(data) / sizeof(data[0]);

    cout << "Original array: ";
    for (int i = 0; i < n; ++i) cout << data[i] << " ";
    cout << endl;

    selectionSort(data, n);

    cout << "Sorted array: ";
    for (int i = 0; i < n; ++i) cout << data[i] << " ";
    cout << endl;

    return 0;
}
将上述代码保存为 main.cpp 并添加至工程后即可编译运行。
6.1.2 编译器特性与标准兼容性限制
VC6.0使用的编译器版本较老,对C++标准支持有限,存在以下典型问题:
| 特性 | VC6.0 支持情况 | 替代方案 |
|---|---|---|
std::vector | 部分支持但不稳定 | 推荐使用原生数组 |
for (auto x : arr) | 不支持(C++11) | 使用传统 for 循环 |
bool 类型 | 支持但需包含 <yvals.h> | 可直接使用 |
| STL 容器稳定性 | 较差 | 建议避免复杂模板 |
| 异常处理 | 支持基本 try/catch | 谨慎使用 |
例如,在VC6.0中声明 vector<int> v; 可能导致链接错误或运行崩溃,应优先采用静态/动态数组实现排序算法。
6.1.3 老旧IDE的典型警告与错误处理
常见错误包括:
-
C4761: conversion from ‘int’ to ‘short’, possible loss of data
原因:VC6.0默认将某些整数运算结果视为short,可通过强制类型转换修复:
cpp int mid = (low + high) / 2; // 可能触发警告 int mid = static_cast<int>((static_cast<long>(low) + high) / 2); // 更安全 -
LNK2001: unresolved external symbol
解决方法:确保所有函数定义存在于.cpp文件中,而非仅声明。 -
编译器内部错误 (Compiler Fatal Error)
多出现在模板或复杂结构体中,建议简化逻辑或改用C风格编码。
6.2 排序程序的编译与链接
6.2.1 main函数组织多个测试入口
为便于调试不同算法,可在 main() 中设计菜单式调用:
int main() {
    int choice;
    const int SIZE = 10;
    int arr[SIZE];

    while (true) {
        cout << "\n--- Sorting Algorithm Test ---\n";
        cout << "1. Selection Sort\n2. Quick Sort\n3. Bubble Sort\n0. Exit\n";
        cout << "Choose: ";
        cin >> choice;

        // 随机初始化数组
        srand((unsigned)time(0));
        for (int i = 0; i < SIZE; ++i)
            arr[i] = rand() % 100;

        switch (choice) {
            case 1:
                cout << "Before: "; printArray(arr, SIZE);
                selectionSort(arr, SIZE);
                cout << "After: "; printArray(arr, SIZE);
                break;
            case 2:
                cout << "Before: "; printArray(arr, SIZE);
                quickSort(arr, 0, SIZE - 1);
                cout << "After: "; printArray(arr, SIZE);
                break;
            case 3:
                cout << "Before: "; printArray(arr, SIZE);
                bubbleSort(arr, SIZE);
                cout << "After: "; printArray(arr, SIZE);
                break;
            case 0:
                return 0;
            default:
                cout << "Invalid choice!\n";
        }
    }
    return 0;
}
6.2.2 数组初始化与随机数据生成
利用 <cstdlib> 和 <ctime> 实现可重复测试的数据集:
void generateRandomArray(int arr[], int n, int seed = 1) {
    srand(seed); // 固定种子便于复现问题
    for (int i = 0; i < n; ++i)
        arr[i] = rand() % 100;
}
通过修改 seed 值可模拟不同分布:
- seed=1 : 完全随机
- seed=42 : 近似有序
- seed=100 : 包含大量重复值
6.2.3 编译选项配置与调试信息生成
在 Project → Settings → C/C++ 选项卡中设置:
- Category : General
- Debug info : Program Database (
/Zi) - Optimizations : Disabled (
/Od) —— 保证变量可见性 - Preprocessor definitions :
_DEBUG
启用 /Zi 后可在调试器中查看局部变量值、调用栈等关键信息。
6.3 调试工具的实际运用
6.3.1 设置断点观察变量变化
在关键位置插入断点(F9),例如在 selectionSort 的外层循环开始处:
for (int i = 0; i < n - 1; ++i) { // 断点设在此行
    int minIndex = i;
    for (int j = i + 1; j < n; ++j) {
        if (arr[j] < arr[minIndex])
            minIndex = j;
    }
    swap(arr[i], arr[minIndex]);
}
运行调试模式(F5)后,当程序暂停时,可通过 Variables 窗口查看 i , minIndex , arr[] 的实时状态。
6.3.2 单步执行追踪算法流程
使用 Step Over (F10) 和 Step Into (F11) 控制执行粒度:
- F10:跳过函数调用(如
swap) - F11:进入函数内部(用于调试
quickSort递归)
配合 Watch Window 添加监视表达式,如 arr[0]@10 表示从 arr[0] 开始显示10个元素。
6.3.3 查看调用堆栈分析递归深度
当 quickSort 出现栈溢出时,打开 Call Stack 窗口可看到类似:
quickSort(int * arr=0x0012ff7c, int low=0, int high=9)
quickSort(int * arr=0x0012ff7c, int low=0, int high=4)
quickSort(int * arr=0x0012ff7c, int low=0, int high=1)
_main()
若堆栈过深(超过1000层),说明pivot选择不当导致退化为O(n²),需引入随机化策略。
6.4 运行结果分析与问题排查
6.4.1 输出排序前后数组内容对比
定义通用打印函数辅助验证:
void printArray(const int arr[], int n) {
    for (int i = 0; i < n; ++i)
        cout << arr[i] << " ";
    cout << endl;
}
输出示例:
Original: 45 23 76 12 89 34 67 55 21 18
Sorted:   12 18 21 23 34 45 55 67 76 89
若出现逆序或缺失元素,则说明交换逻辑有误。
6.4.2 发现死循环或异常崩溃根源
常见原因包括:
- 快速排序分区边界错误导致无限递归
- 指针越界访问(如
j >= 0写成j > 0) - 栈空间不足引发崩溃(大数组+深递归)
可通过添加日志定位:
cout << "[Debug] Entering quickSort, low=" << low << ", high=" << high << endl;
if (low >= high) return;
若日志持续输出相同区间,则存在逻辑死锁。
6.4.3 利用打印日志辅助逻辑验证
在关键分支插入跟踪信息:
int partition(int arr[], int low, int high) {
    int pivot = arr[high];
    cout << "Pivot chosen: " << pivot << " at index " << high << endl;
    int i = low - 1;
    for (int j = low; j < high; ++j) {
        if (arr[j] <= pivot) {
            ++i;
            swap(arr[i], arr[j]);
            cout << "Swapped " << arr[i] << " and " << arr[j] << endl;
        }
    }
    swap(arr[i + 1], arr[high]);
    return i + 1;
}
结合输出流与断点,可精确还原每一步操作顺序。
graph TD
    A[启动VC6.0] --> B[创建Win32控制台工程]
    B --> C[添加.cpp源文件]
    C --> D[编写排序函数]
    D --> E[配置调试编译选项]
    E --> F[设置断点并运行]
    F --> G{是否正常结束?}
    G -- 是 --> H[输出排序结果]
    G -- 否 --> I[查看调用堆栈]
    I --> J[定位越界或死循环]
    J --> K[修改代码并重新编译]
    K --> F
简介:排序是计算机科学中的基础操作之一,本文详细解析了三种经典的排序算法:选择排序、快速排序和冒泡排序,并结合VC6.0环境下的C++程序实现进行说明。通过 choosesort.rar 、 quicksort.rar 和 bubblesort.rar 中的代码示例,帮助读者理解各算法的核心思想与执行流程。尽管这三种算法的时间复杂度多为O(n²),但它们在学习算法设计与分析中具有重要意义。掌握这些基础排序方法有助于提升编程能力和为更高效算法的应用打下坚实基础。
更多推荐



 11
 0
- 0


 已为社区贡献8条内容

所有评论(0)