
算法 --- BFS 解决拓扑排序
BFS 解决拓扑排序
BFS(Kahn算法)解决拓扑排序,适用于那些任务、项目或事件之间存在明确的先后依赖关系,你需要找到一个合法的执行顺序,或者判断依赖关系是否合理(即是否存在循环依赖)的题目。
预备知识
有向无环图(DAG)是边有方向、且从任意节点出发都找不到能回到自身的环路的图。
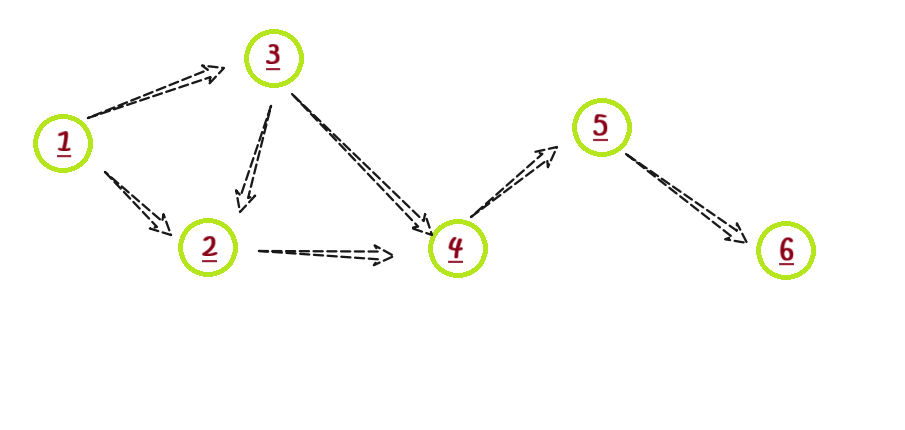
其中补充两个概念入度出度:入度和出度是描述有向图中节点与边关系的两个核心概念,核心区别在于 “边的方向是否指向或离开节点”:
1. 入度(In-degree)
指指向该节点的边的数量,也就是有多少条边的 “终点” 是当前节点。
2. 出度(Out-degree)
指从该节点出发的边的数量,也就是有多少条边的 “起点” 是当前节点。
节点 1 --- 入度:没有边指向节点 1,所以入度为 0。--- 出度:有两条边从节点 1 出发(分别指向节点 2、节点 3),所以出度为 2。
节点 4 --- 入度:有两条边指向节点 4(分别来自节点 2、节点 3),所以入度为 2。--- 出度:有一条边从节点 4 出发(指向节点 5),所以出度为 1。
节点 6 --- 入度:有一条边从节点 5 指向节点 6,所以入度为 1。--- 出度:没有边从节点 6 出发,所以出度为 0。
AOV 网(顶点活动图 )是以有向无环图中的顶点表示活动,有向边表示活动之间先后约束关系的图 ,比如在课程学习中,顶点代表每门课程,边表示课程学习的先后顺序 ,只有先完成前驱课程,才能开始后继课程的学习。
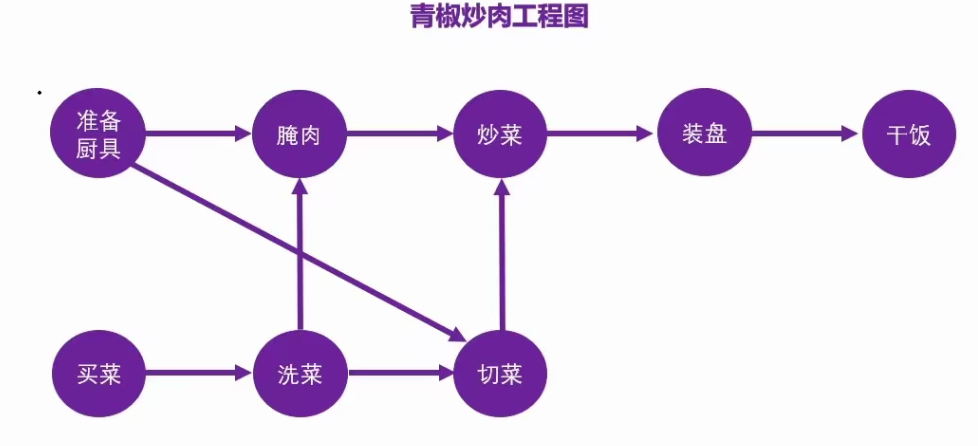
在这张 “青椒炒肉工程图” 里,AOV 网就是用每个紫色圆圈代表 “准备厨具”“腌肉” 等做菜相关活动,箭头代表活动间的先后顺序约束(比如得先 “准备厨具”,才能开展 “腌肉”“切菜” 等后续活动)的有向无环图。
所以 AOV 网特别有实际意义的!
拓扑排序是对一个有向无环图(DAG)的顶点进行排序的算法,它将图中的所有顶点排成一个线性序列,使得对于图中的任意一条有向边 (u, v) ,在这个线性序列中顶点 u 都排在顶点 v 的前面。
简单来说,就是在由任务和任务依赖关系组成的有向无环图中,找到一个合理的任务执行顺序, 让所有有依赖关系的任务,被依赖的任务都排在前面 。
以之前的 “青椒炒肉工程图” 为例,“买菜”“准备厨具” 没有前置依赖,可以先进行,而 “腌肉” 依赖 “准备厨具”,“切菜” 依赖 “洗菜” 和 “准备厨具”,拓扑排序就能给出一个如 “买菜 -> 准备厨具 -> 洗菜 -> 腌肉 -> 切菜 -> 炒菜 -> 装盘 -> 干饭 ” 这样的线性顺序,保证在执行某个活动时,它所依赖的前置活动都已经完成 。
我们模拟一下拓扑排序:
针对青椒炒肉流程图,我们可以先准备厨具或者买菜,因为并没有一条边指向准备厨具或者买菜,他们两者其实是独立的(没有限制)(可以看出拓扑排序的结果不是唯一的)当我买完菜之后,就解锁洗菜这个操作了:
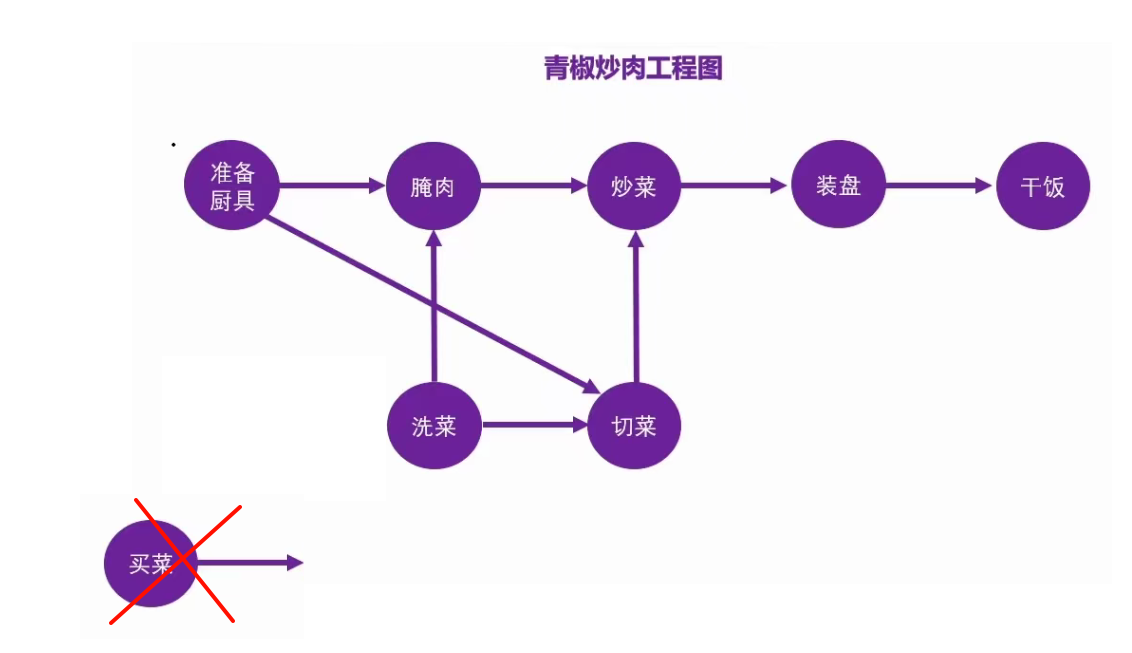
那么接下来我就可以准备厨具或者洗菜了,因为没有条件限制了,我们就可以准备厨具了,这时候,我们就消去两个边了:
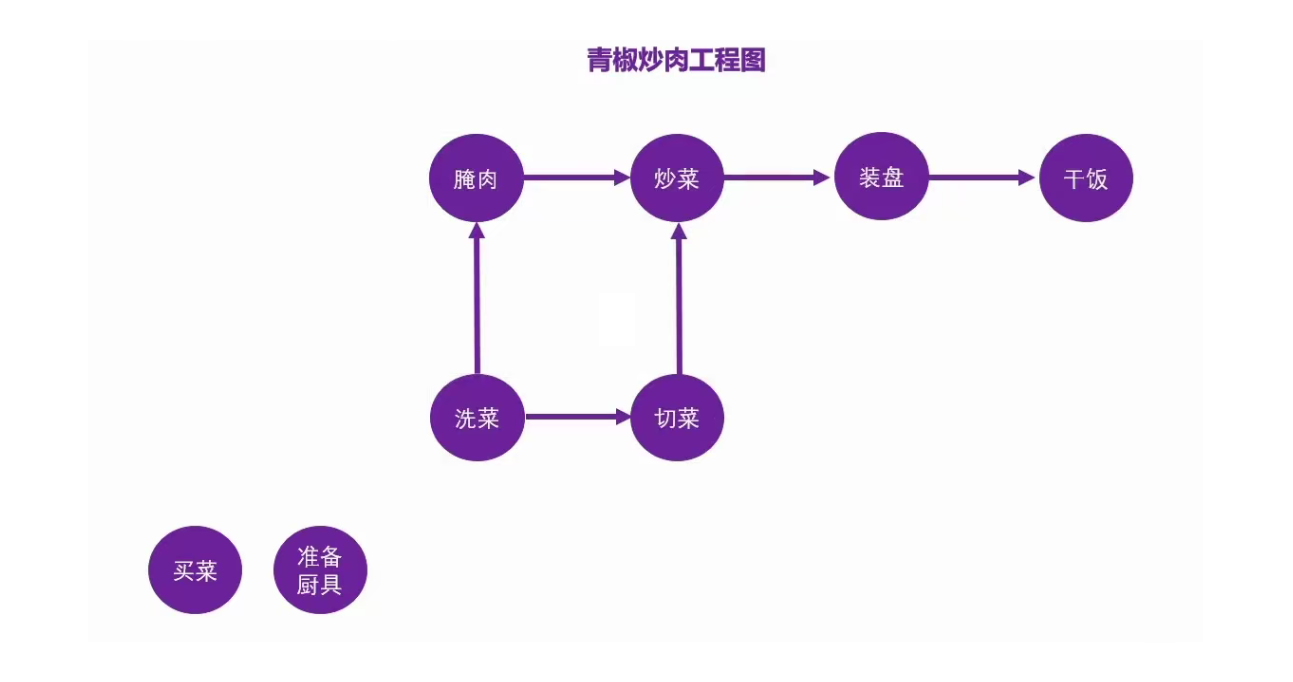
然后,接下来也只能去洗菜了~~~~依次类推,我相信你们能理解!(这就使拓扑排序的序列,也称为拓扑序列)
我们每一次选择的一个活动,其实都是入度为0的节点,因为当入度为0的点,其实该活动是被解放的!然后选择入度为0的点,将其取出,删除边,接下来一直执行相同的逻辑!
所以排序的过程就是:
- 找出图中入度为0的点,然后输出
- 删除与该店连接的边
- 重复1,2操作,知道图中没有点或者没有入度为0的点
没有入度为0的点:在拓扑排序中是因为可能所面对的不是有向无环图,可能这个途中有环形结构
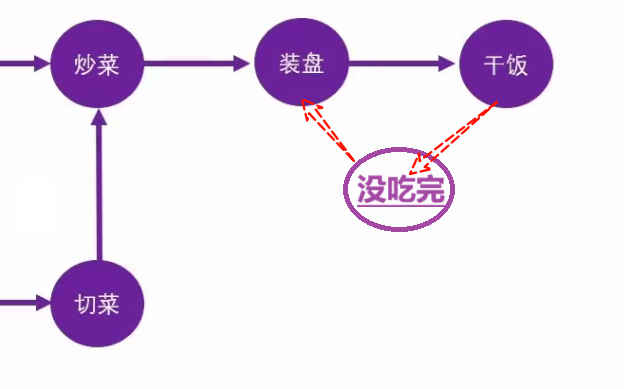
因此,我们可以利用这一点,可以用来判断有向图中是否有成环(也就是构不成拓扑排序),这是很重要的一个知识点!
详细说明适用的题目类型和特征:
当你看到题目具有以下一个或多个特征时,就应该考虑使用BFS拓扑排序:
明确的依赖关系:题目中直接给出“前置条件”、“必须先修”、“依赖于”等关键词。
-
例如:“课程
A是课程B的先修课”、“任务B必须在任务A完成后才能开始”。
需要“排序”或“序列”:问题要求你输出一个满足所有依赖关系的顺序。
-
例如:“请安排一个学生修完所有课程的学习顺序”、“请给出一个任务调度方案”。
需要检测循环依赖:问题本质是判断依赖图是否是有向无环图(DAG)。如果存在循环(比如A依赖B,B依赖C,C又依赖A),则没有解。
-
例如:“判断是否可能完成所有课程”(力扣第207题:课程表)。
图论背景:问题可以自然地建模成有向图,其中节点代表任务,有向边 A -> B 代表 A 是 B 的前置条件(完成A才能做B)。
BFS拓扑排序(Kahn算法)的解题框架:
建图:根据依赖关系建立有向图(通常使用邻接表)。(问题一我们来说说如何建图!很重要哦!!!)
统计入度:记录每个节点的入度(即有多少条边指向它)。
初始化队列:将所有入度为0的节点加入队列。这些节点是当前没有前置条件的,可以立即执行。
BFS循环:(当队列不为空的时候)
-
从队列中取出一个节点,将其加入结果序列。
-
遍历该节点的所有邻居(即它指向的节点),将这些邻居的入度减1(相当于移除了当前节点与它们之间的依赖,也就是删除与该元素相连的边)。
-
判断如果某个邻居的入度减为0,则将其加入队列。
判断结果:
-
如果结果序列的长度等于节点总数,说明拓扑排序成功,该序列就是一个合法解。
-
如果结果序列的长度小于节点总数,说明图中存在环,无法进行拓扑排序。
典型例题:
-
课程表系列(力扣 207, 210):最经典的拓扑排序问题。
-
项目管理中的任务调度:安排有依赖关系的任务执行顺序。
-
编译顺序:确定源代码文件(或模块)的编译顺序。
-
软件包依赖解析:如安装一个软件包时,需要先安装它所依赖的所有包。
总结:当你遇到 “有向依赖” 和 “顺序安排” 这两个关键词时,BFS拓扑排序就是你首选的利器。
题目练习
207. 课程表 - 力扣(LeetCode)
算法思路:
原问题可以转换成一个拓扑排序问题。 用 BFS 解决拓扑排序即可。
拓扑排序流程:
a. 将所有入度为 0 的点加入到队列中;
b. 当队列不空的时候,一直循环:
- 取出队头元素;
- 将于队头元素相连的顶点的入度 -1;
- 然后判断是否减成 0。如果减成 0,就加入到队列中。
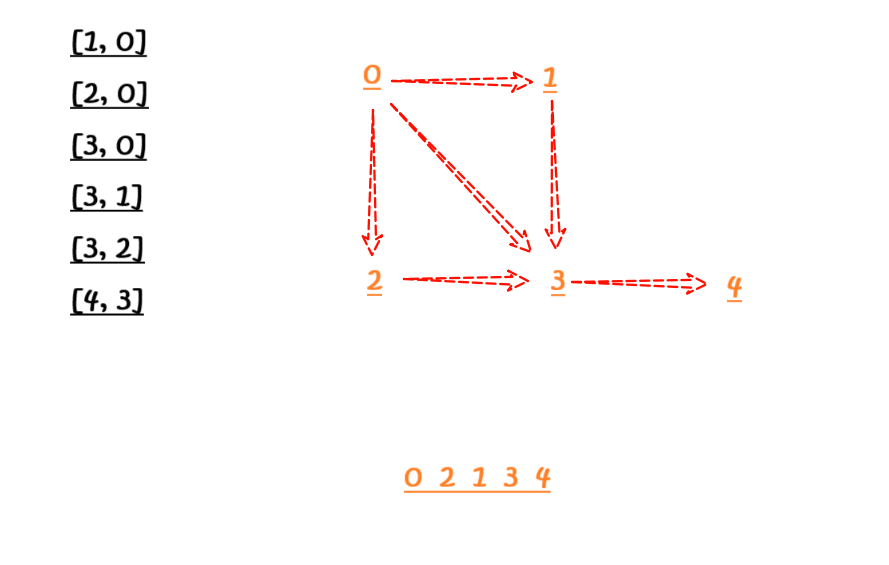
建模:用 “邻接表” 表示有向图(针对建图,看稠密度,邻接矩阵/邻接表....这些具体的在图论中讨论,这里邻接表就够了!)
图中节点是课程(0、1、2、3、4),有向边表示 “先修课 → 后续课” 的依赖关系(比如0->1表示 “课程 0 是课程 1 的先修课”)。
在代码中,通常用邻接表存储图(适合稀疏图,避免邻接矩阵的空间浪费),有两种常见实现:
vector<vector<int>> edges:索引代表 “起点课程”,edges[u]存储所有从 u 出发能到达的 “终点课程”。例如图中 0->1、0->2、0->3,则edges[0] = {1, 2, 3};1->3,则edges[1] = {3};以此类推。unordered_map<int, vector<int>> edges:键是 “起点课程”,值是该起点能到达的 “终点课程列表”。适合节点编号不连续的场景,图中节点连续,用vector更高效。(这个更加万能!)
我们还需要统计一个信息 --- 每个节点的入度,我们直接搞一个数组就可以了,其中的点就表示入度数了!vector<int> in
class Solution {
public:
    bool canFinish(int n, vector<vector<int>>& prerequisites) {
        unordered_map<int, vector<int>> edges;//邻接表存图
        vector<int> in(n);//标记每一个节点的入度

        //建图
        for(auto& e : prerequisites)
        {
            int a = e[0], b = e[1];//b->a的一条边
            edges[b].push_back(a);
            in[a]++;
        }
        //拓扑排序
        queue<int> q;
        for(int i = 0; i < n; ++i)
        {
            if(in[i] == 0) q.push(i);
        }
        while(q.size())
        {
            int t = q.front(); q.pop();
            for(int a : edges[t])
            {
                in[a]--;
                if(in[a] == 0) q.push(a);
            }
        }
        for(int x : in)
        {
            if(x) return false;
        }
        return true;
    }
};
210. 课程表 II - 力扣(LeetCode)
算法思路:
和上题一样!
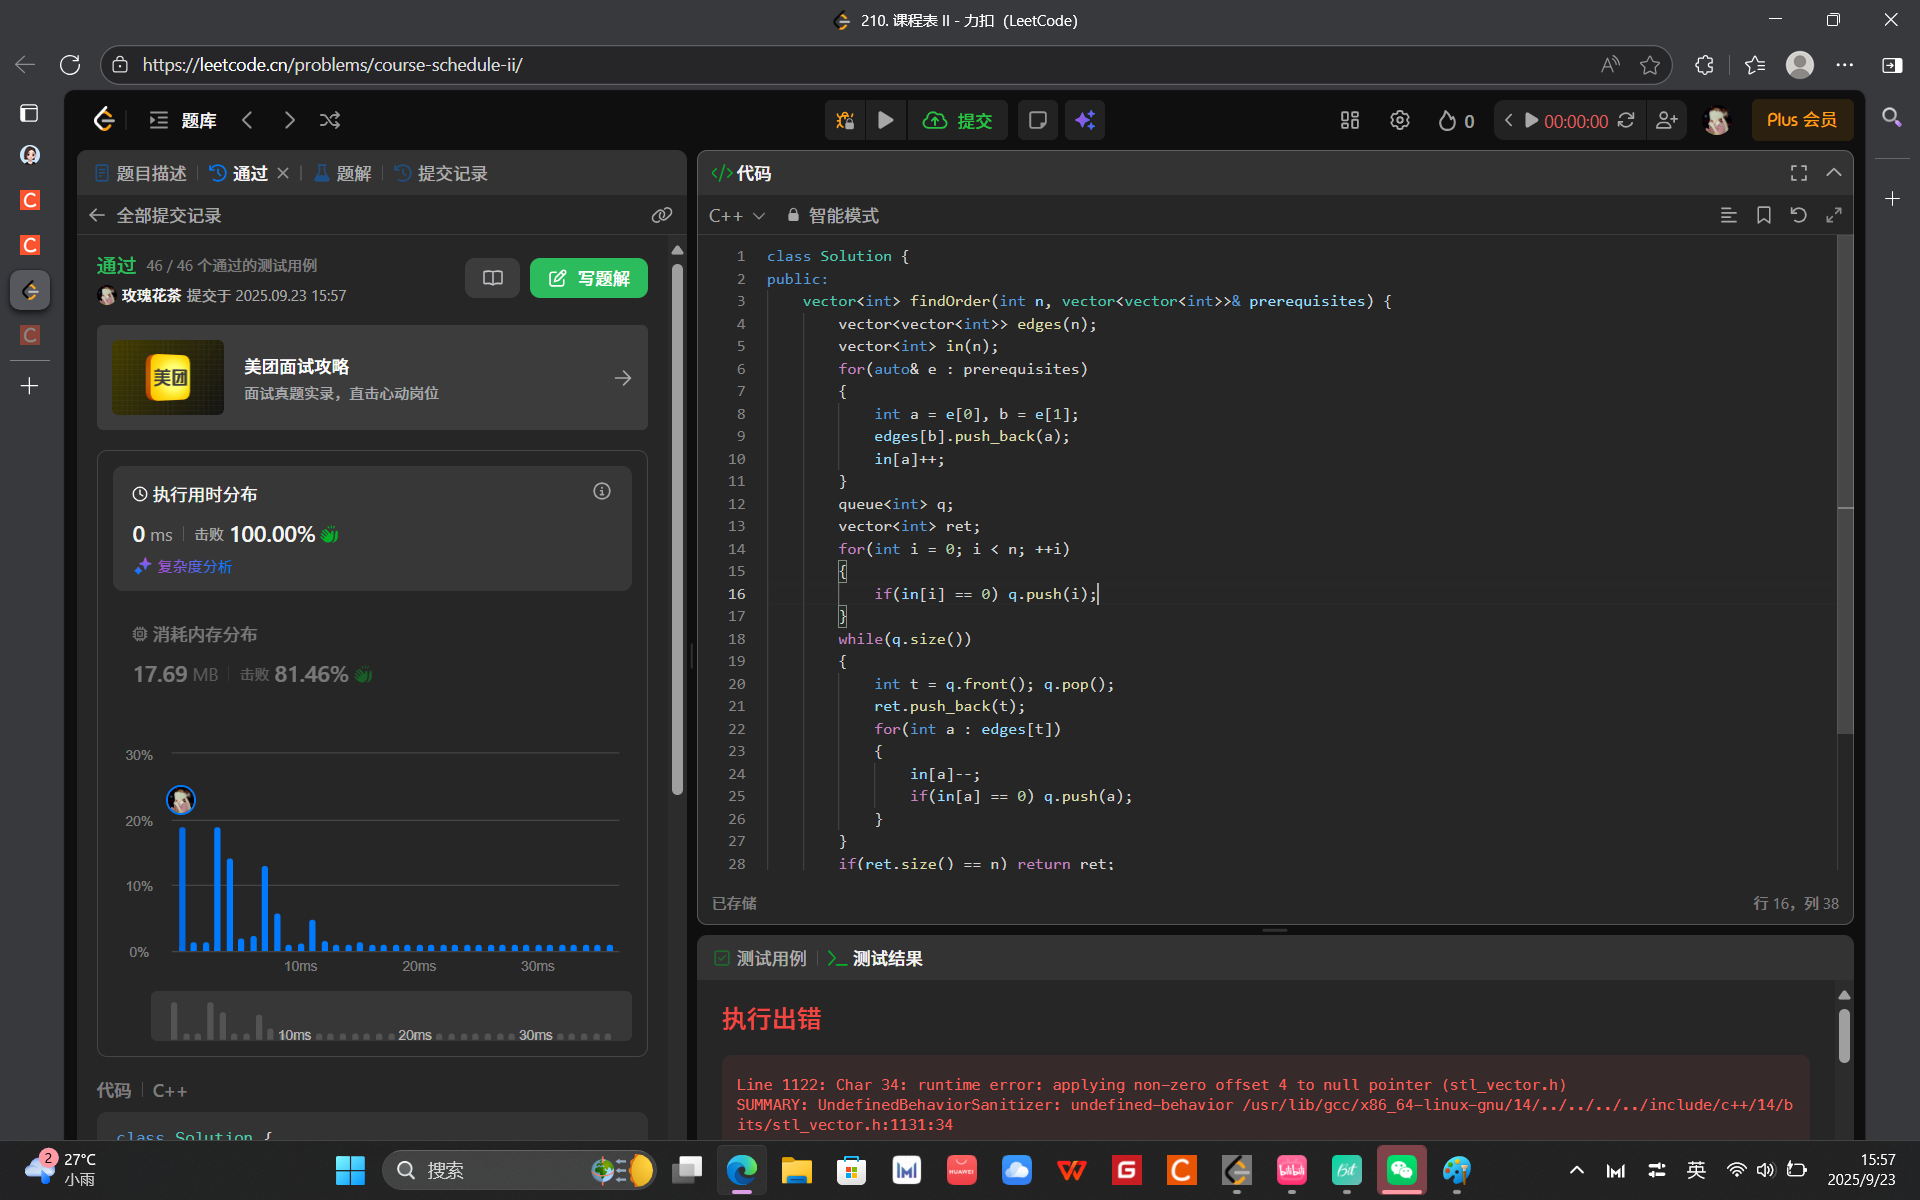
class Solution {
public:
    vector<int> findOrder(int n, vector<vector<int>>& prerequisites) {
        vector<vector<int>> edges(n);
        vector<int> in(n);
        for(auto& e : prerequisites)
        {
            int a = e[0], b = e[1];
            edges[b].push_back(a);
            in[a]++;
        }
        queue<int> q;
        vector<int> ret;
        for(int i = 0; i < n; ++i)
        {
            if(in[i] == 0) q.push(i);
        }
        while(q.size())
        {
            int t = q.front(); q.pop();
            ret.push_back(t);
            for(int a : edges[t])
            {
                in[a]--;
                if(in[a] == 0) q.push(a);
            }
        }
        if(ret.size() == n) return ret;
        return {};
    }
};
LCR 114. 火星词典 - 力扣(LeetCode)
算法思路:
将题意搞清楚之后,这道题就变成了判断有向图时候有环,可以用拓扑排序解决。
如何搜集信息(如何建图):
a. 两层 for 循环枚举出所有的两个字符串的组合;(收集信息)
b. 然后利用指针,根据字典序规则找出信息。
(细节很多,自己尝试,不行再看我的代码啦)
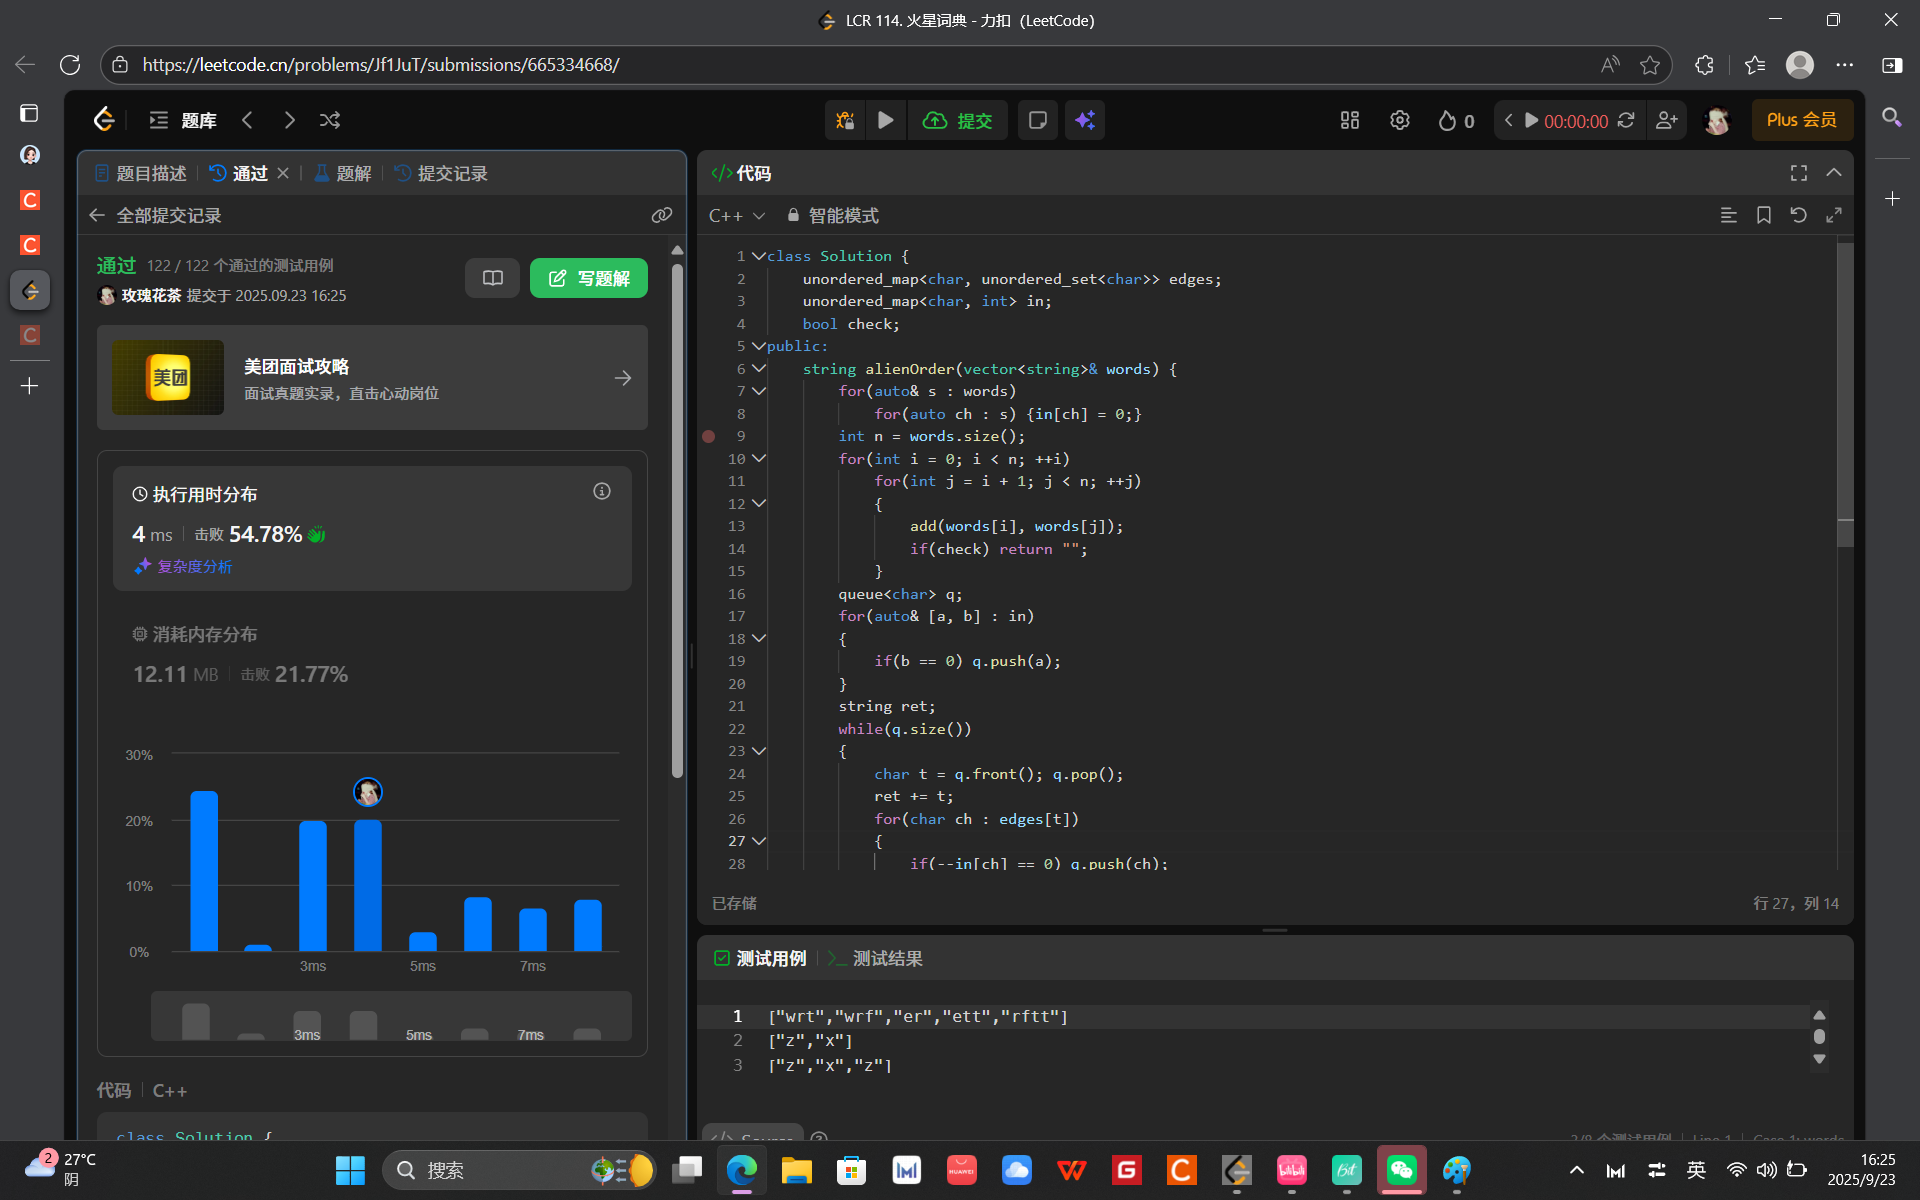
class Solution {
    unordered_map<char, unordered_set<char>> edges;
    unordered_map<char, int> in;
    bool check;
public:
    string alienOrder(vector<string>& words) {
        for(auto& s : words)
            for(auto ch : s) {in[ch] = 0;}
        int n = words.size();
        for(int i = 0; i < n; ++i)
            for(int j = i + 1; j < n; ++j)
            {
                add(words[i], words[j]);
                if(check) return "";
            }
        queue<char> q;
        for(auto& [a, b] : in)
        {
            if(b == 0) q.push(a);
        }
        string ret;
        while(q.size())
        {
            char t = q.front(); q.pop();
            ret += t;
            for(char ch : edges[t])
            {
                if(--in[ch] == 0) q.push(ch);
            }
        }
        for(auto& [a, b] : in)
            if(b != 0) return "";
        return ret;
    }
    void add(string& s1, string& s2)
    {
        int n = min(s1.size(), s2.size());
        int i = 0;
        for( ; i < n; ++i)
        {
            if(s1[i] != s2[i])
            {
                char a = s1[i], b = s2[i];
                if(!edges.count(a) || !edges[a].count(b))
                {
                    edges[a].insert(b);
                    in[b]++;
                }
                break;
            }
        }
        if(i == s2.size() && i < s1.size()) check = true;
    }
};
更多推荐



 47
 0
- 0


 已为社区贡献1条内容

所有评论(0)