
数据结构:树及二叉树--堆(上)
 https://gitee.com/jxxx404/c-language-learning/commit/220251dc27b4611a581850d561688661e554333a
1.树
1.1树的概念和结构
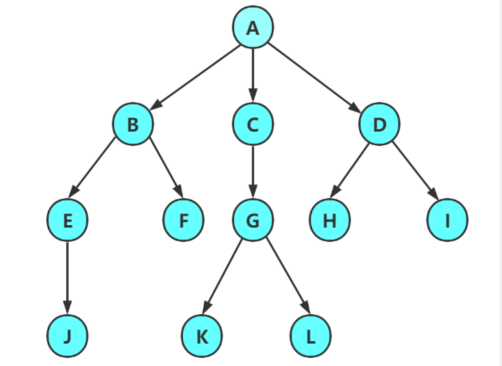
树是一种非线性的数据结构,它是由n(n>=0)个有限结点组成一个具有层次关系的集合。把它叫做树是因为它看起来像一棵倒挂的树,也就是说它是根朝上,而叶朝下的。
1.有一个特殊的结点,称为根结点,根结点没有前驱结点。
2.除根结点外,其余结点被分成M(M>θ)个互不相交的集合T1、T2、……、Tm,其中每一个集合Ti(1〈= i <= m)又是一棵结构与树类似的子树。每棵子树的根结点有且只有一个前驱,可以
有零个或多个后继。因此,树是递归定义的。
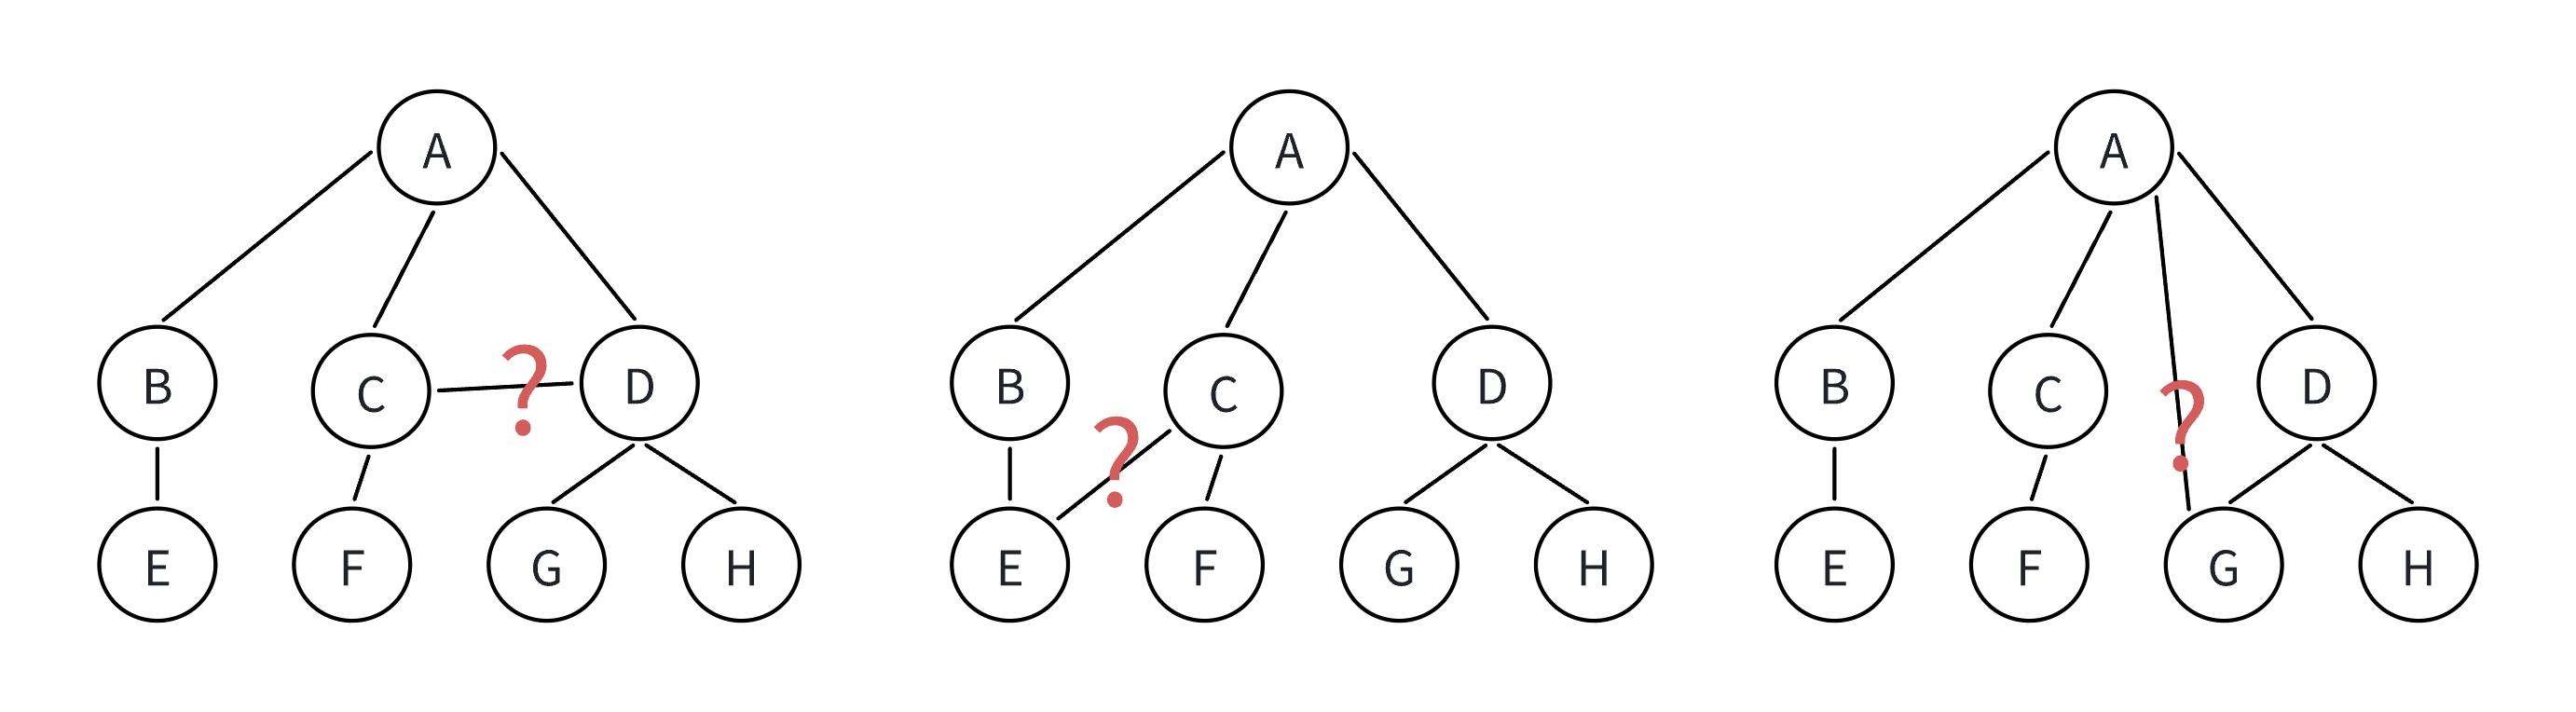
注意:树形结构中,子树之间不能有交集,否则就不是树形结构。
非树形结构:
知识点:
1.子树是不相交的 。
2.除了根结点外,每个结点有且仅有一个父节点。
3.一棵N个结点的树有N-1条边。(两个结点一条边相连)
1.2树的相关术语
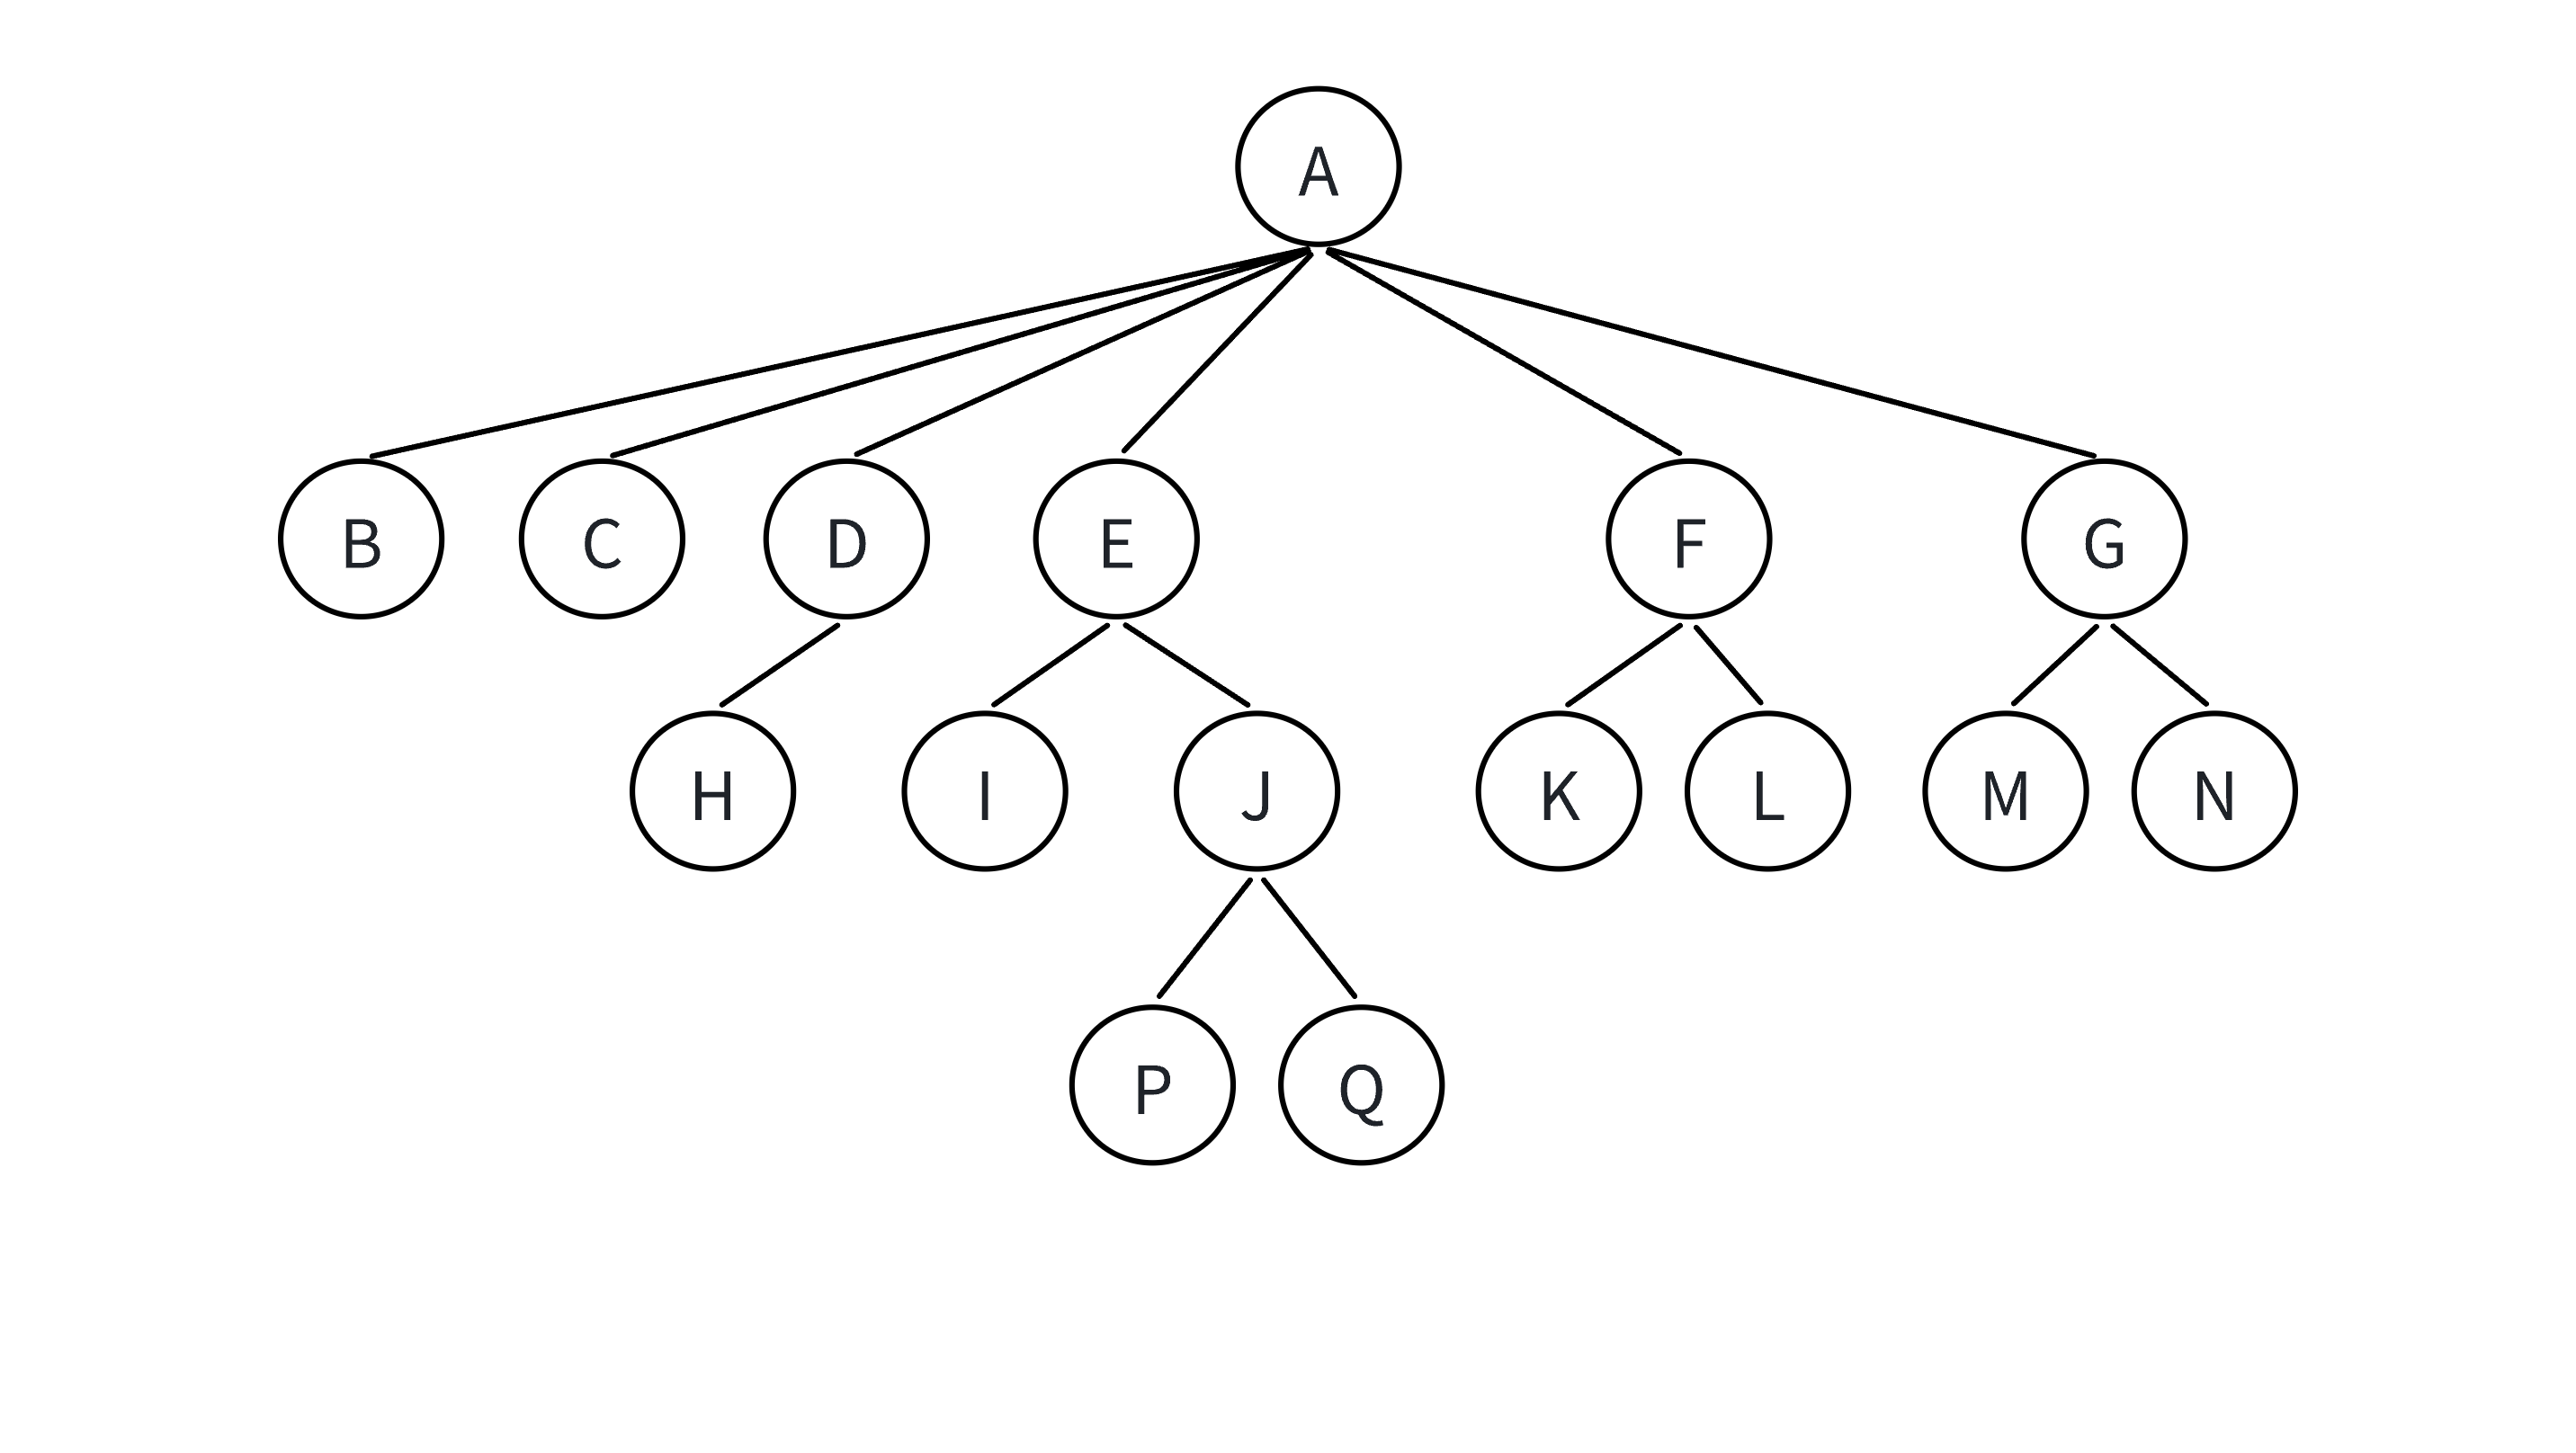
父结点/双亲结点:若一个结点含有子结点,则这个结点称为其子结点的父结点;如上图:A是B的父结点。
子结点/孩子结点:一个结点含有的子树的根结点称为该结点的子结点;如上图:B是A的孩子结点。
结点的度:一个结点有几个孩子,他的度就是多少;比如A的度为6,F的度为2,K的度为0
树的度:一棵树中,最大的结点的度称为树的度;如上图:树的度为6
叶子结点/终端结点:度为0的结点称为叶结点;如上图:B、C、H、I……等结点为叶结点。
分支结点/非终端结点:度不为0的结点;如上图:D、E、F、G……等结点为分支结点。
兄弟结点:具有相同父结点的结点互称为兄弟结点(亲兄弟);如上图:B、C是兄弟结点
结点的层次:从根开始定义起,根为第1层,根的子结点为第2层,以此类推;
树的高度或深度:树中结点的最大层次;如上图:树的高度为4
结点的祖先:从根到该结点所经分支上的所有结点;如上图:A是所有结点的祖先。
路径:一条从树中任意节点出发,沿父节点-子节点连接,达到任意节点的序列;比如A到Q的路径为:A-E-J-Q;H到Q的路径H-D-A-E-J-Q
子孙:以某结点为根的子树中任一结点都称为该结点的子孙。如上图:所有结点都是A的子孙。
森林:由m(m>0)棵互不相交的树的集合称为森林。
1.3树的表示
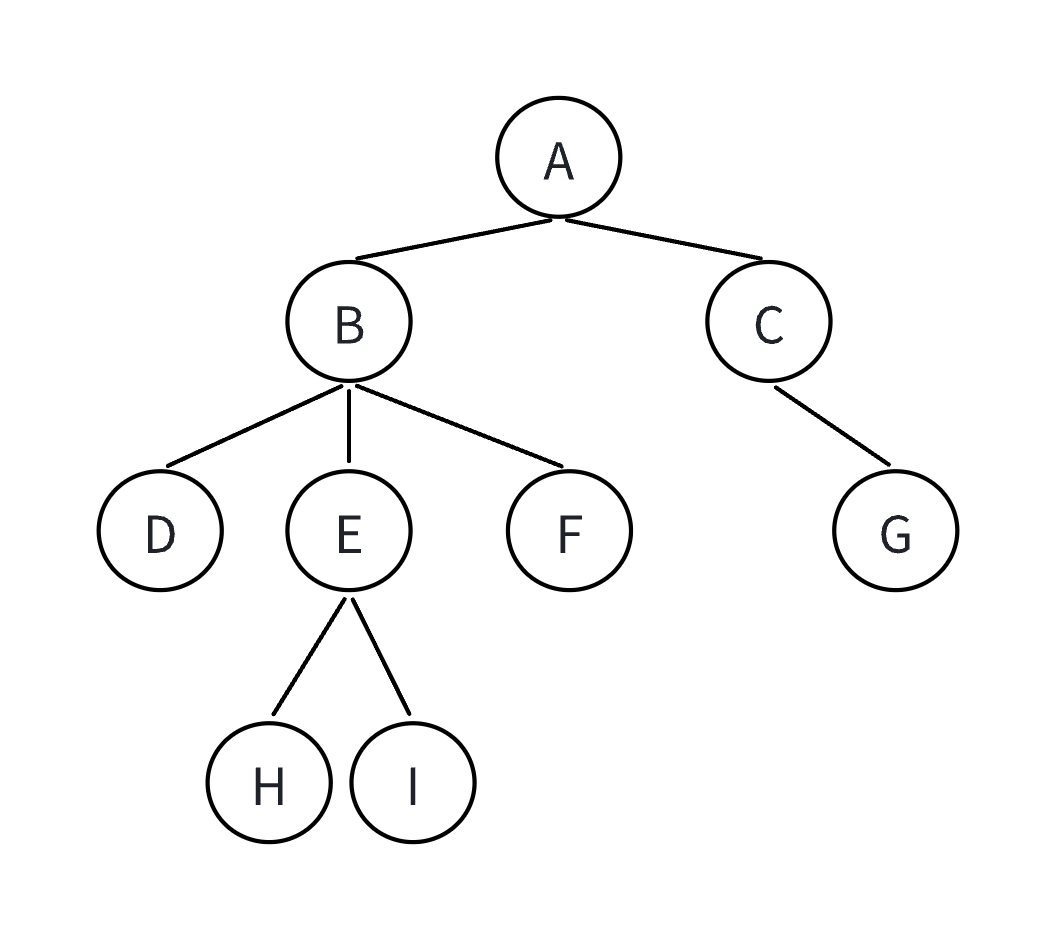
孩子兄弟表示法:
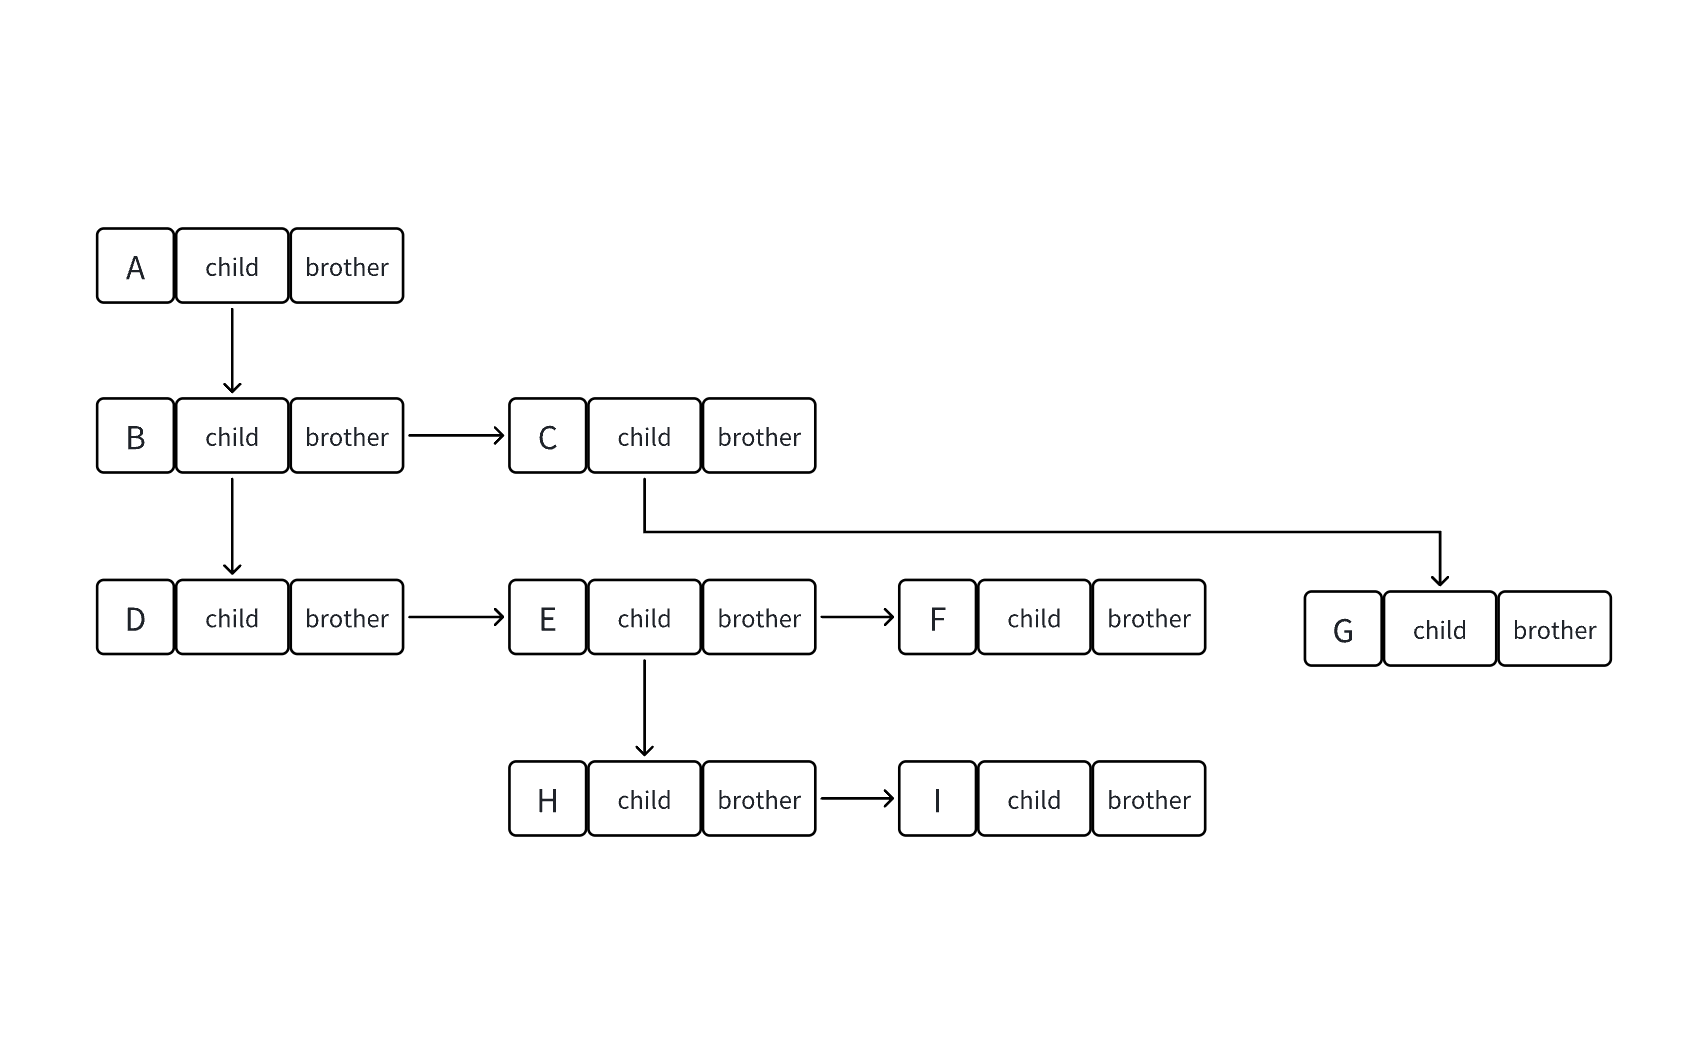
树结构相对线性表就比较复杂了,要存储表示起来就比较麻烦,需要保存值域,也要保存结点和结点之间的关系,实际中树有很多种表示方式如:双亲表示法,孩子表示法、孩子双亲表示法以及孩子兄弟表示法等。我们这里就简单的了解其中最常用的孩子兄弟表示法。
结构定义:
struct TreeNode
{
 struct Node* child; // 左边开始的第⼀个孩⼦结点
 struct Node* brother; // 指向其右边的下⼀个兄弟结点
 int data; // 结点中的数据域
};
1.4树形结构实际运用场景
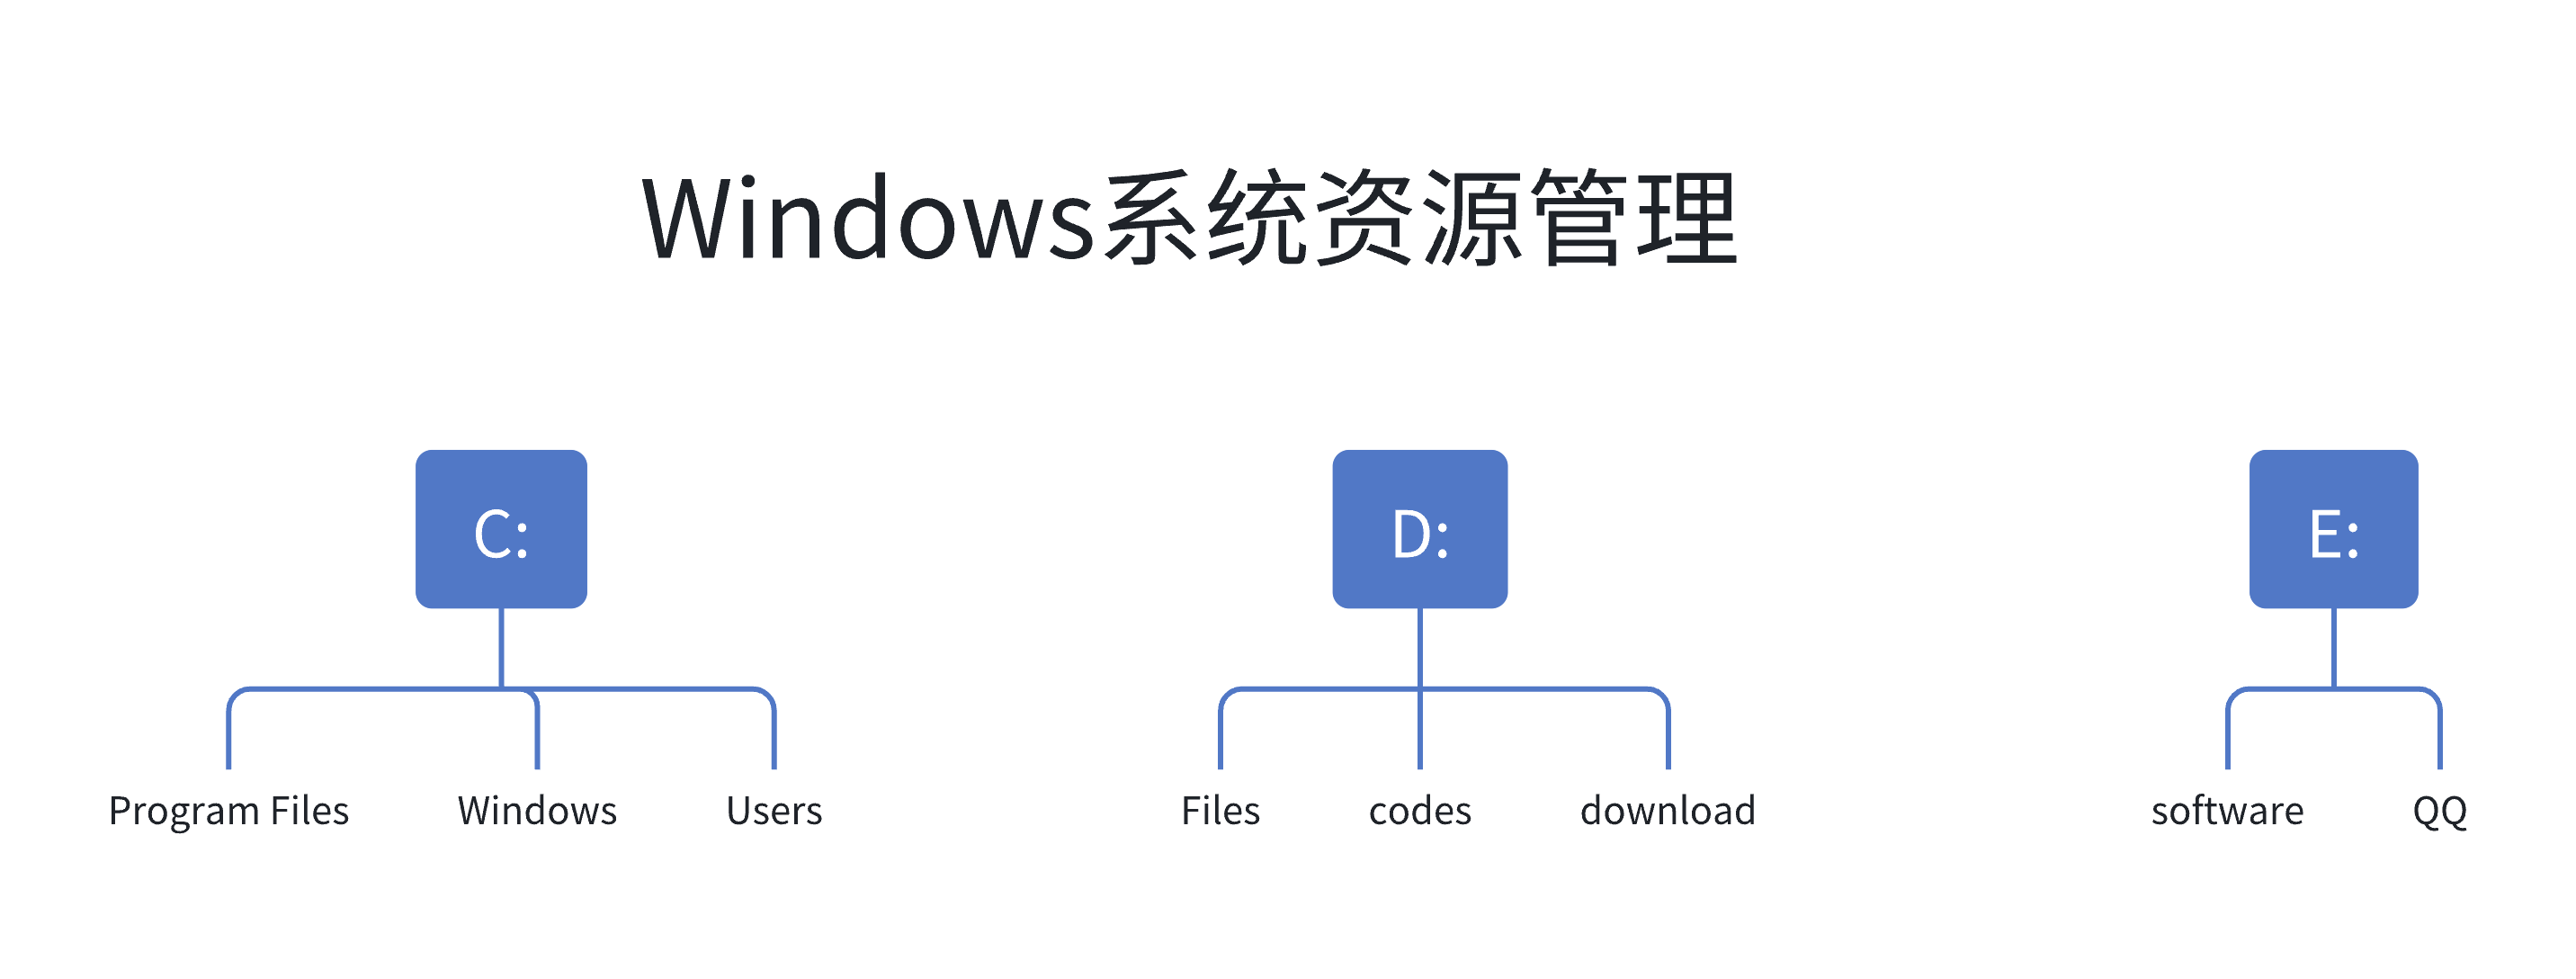
文件系统是计算机存储和管理文件的一种方式,它利用树形结构来组织和管理文件和文件夹。在文件系统中,树结构被广泛应用,它通过父结点和子结点之间的关系来表示不同层级的文件和文件夹之间的关联。
2.二叉树
2.1概念与结构
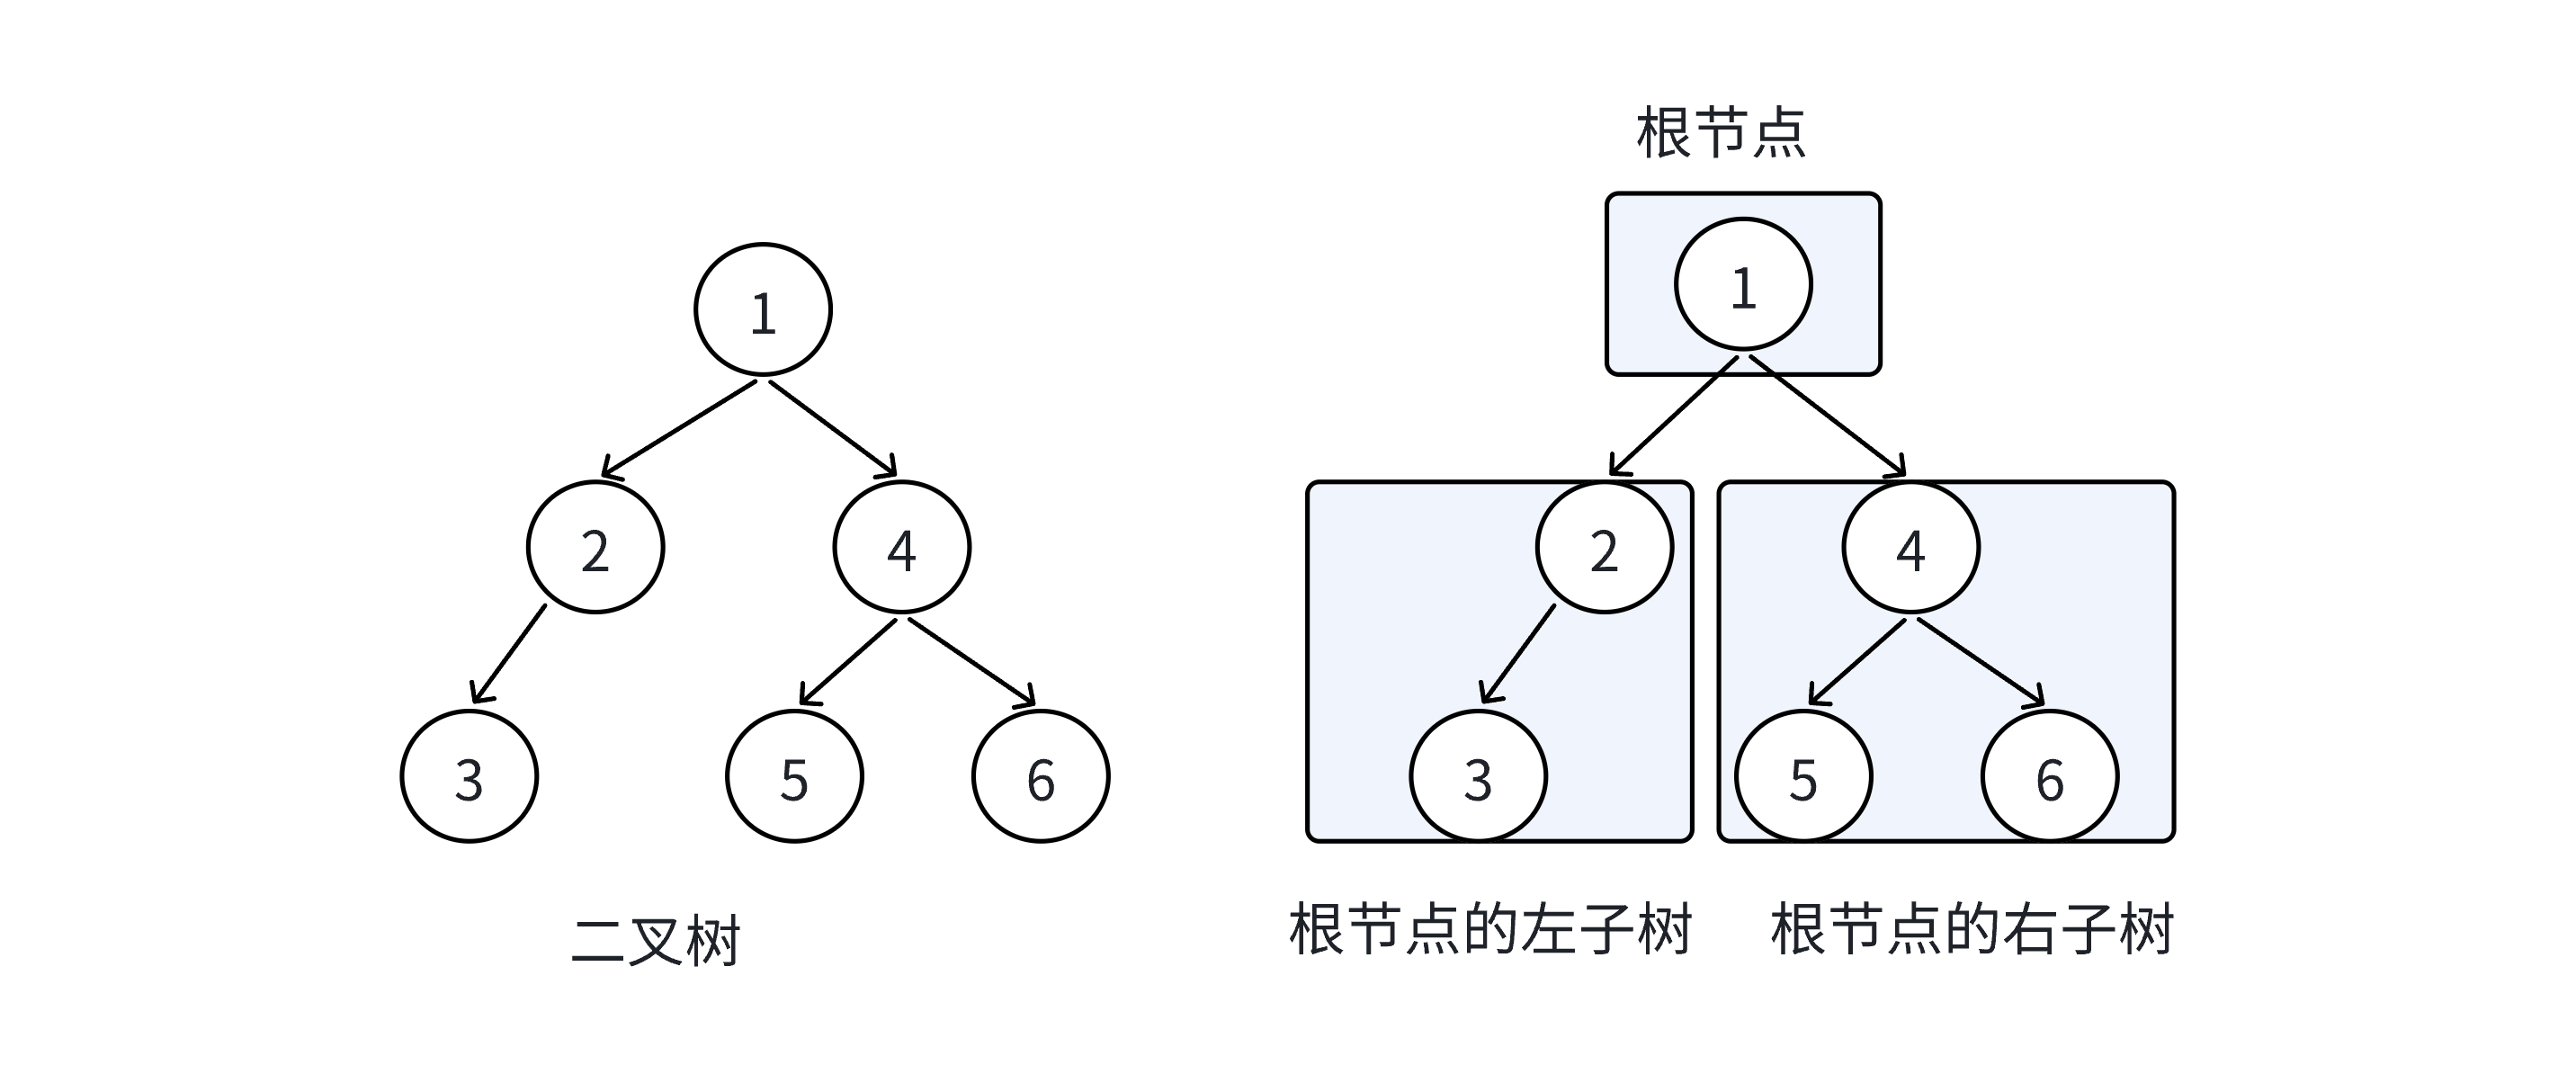
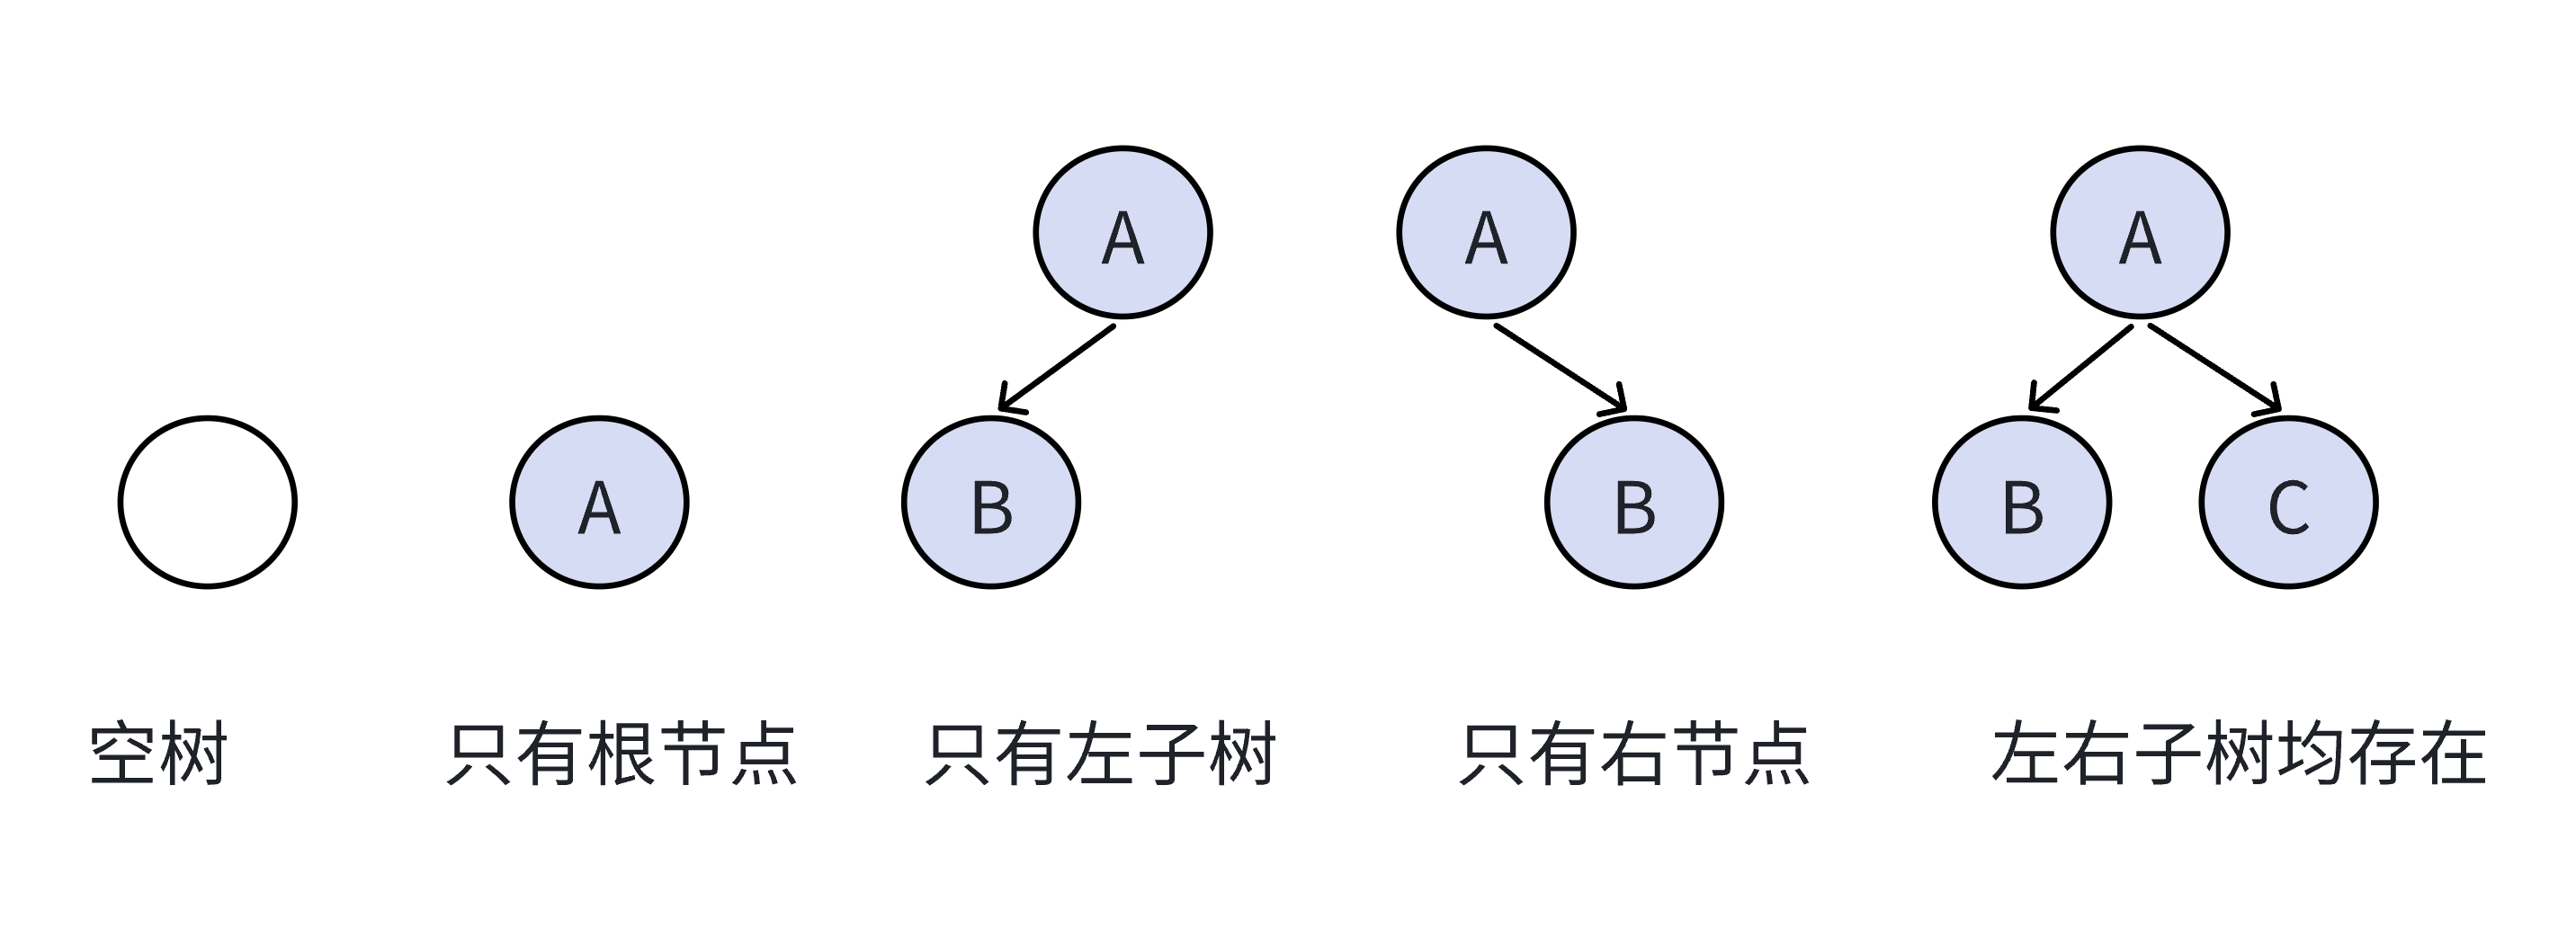
在树形结构中,我们最常用的就是二叉树,一棵二叉树是结点的一个有限集合,该集合由一个根结点加上两棵别称为左子树和右子树的二叉树组成或者为空。
特点:
1.二叉树不存在度大于2的点。
2.二叉树的子树有左右之分,次序不能颠倒,因此二叉树是有序树。
2.2特殊的二叉树
2.2.1满二叉树
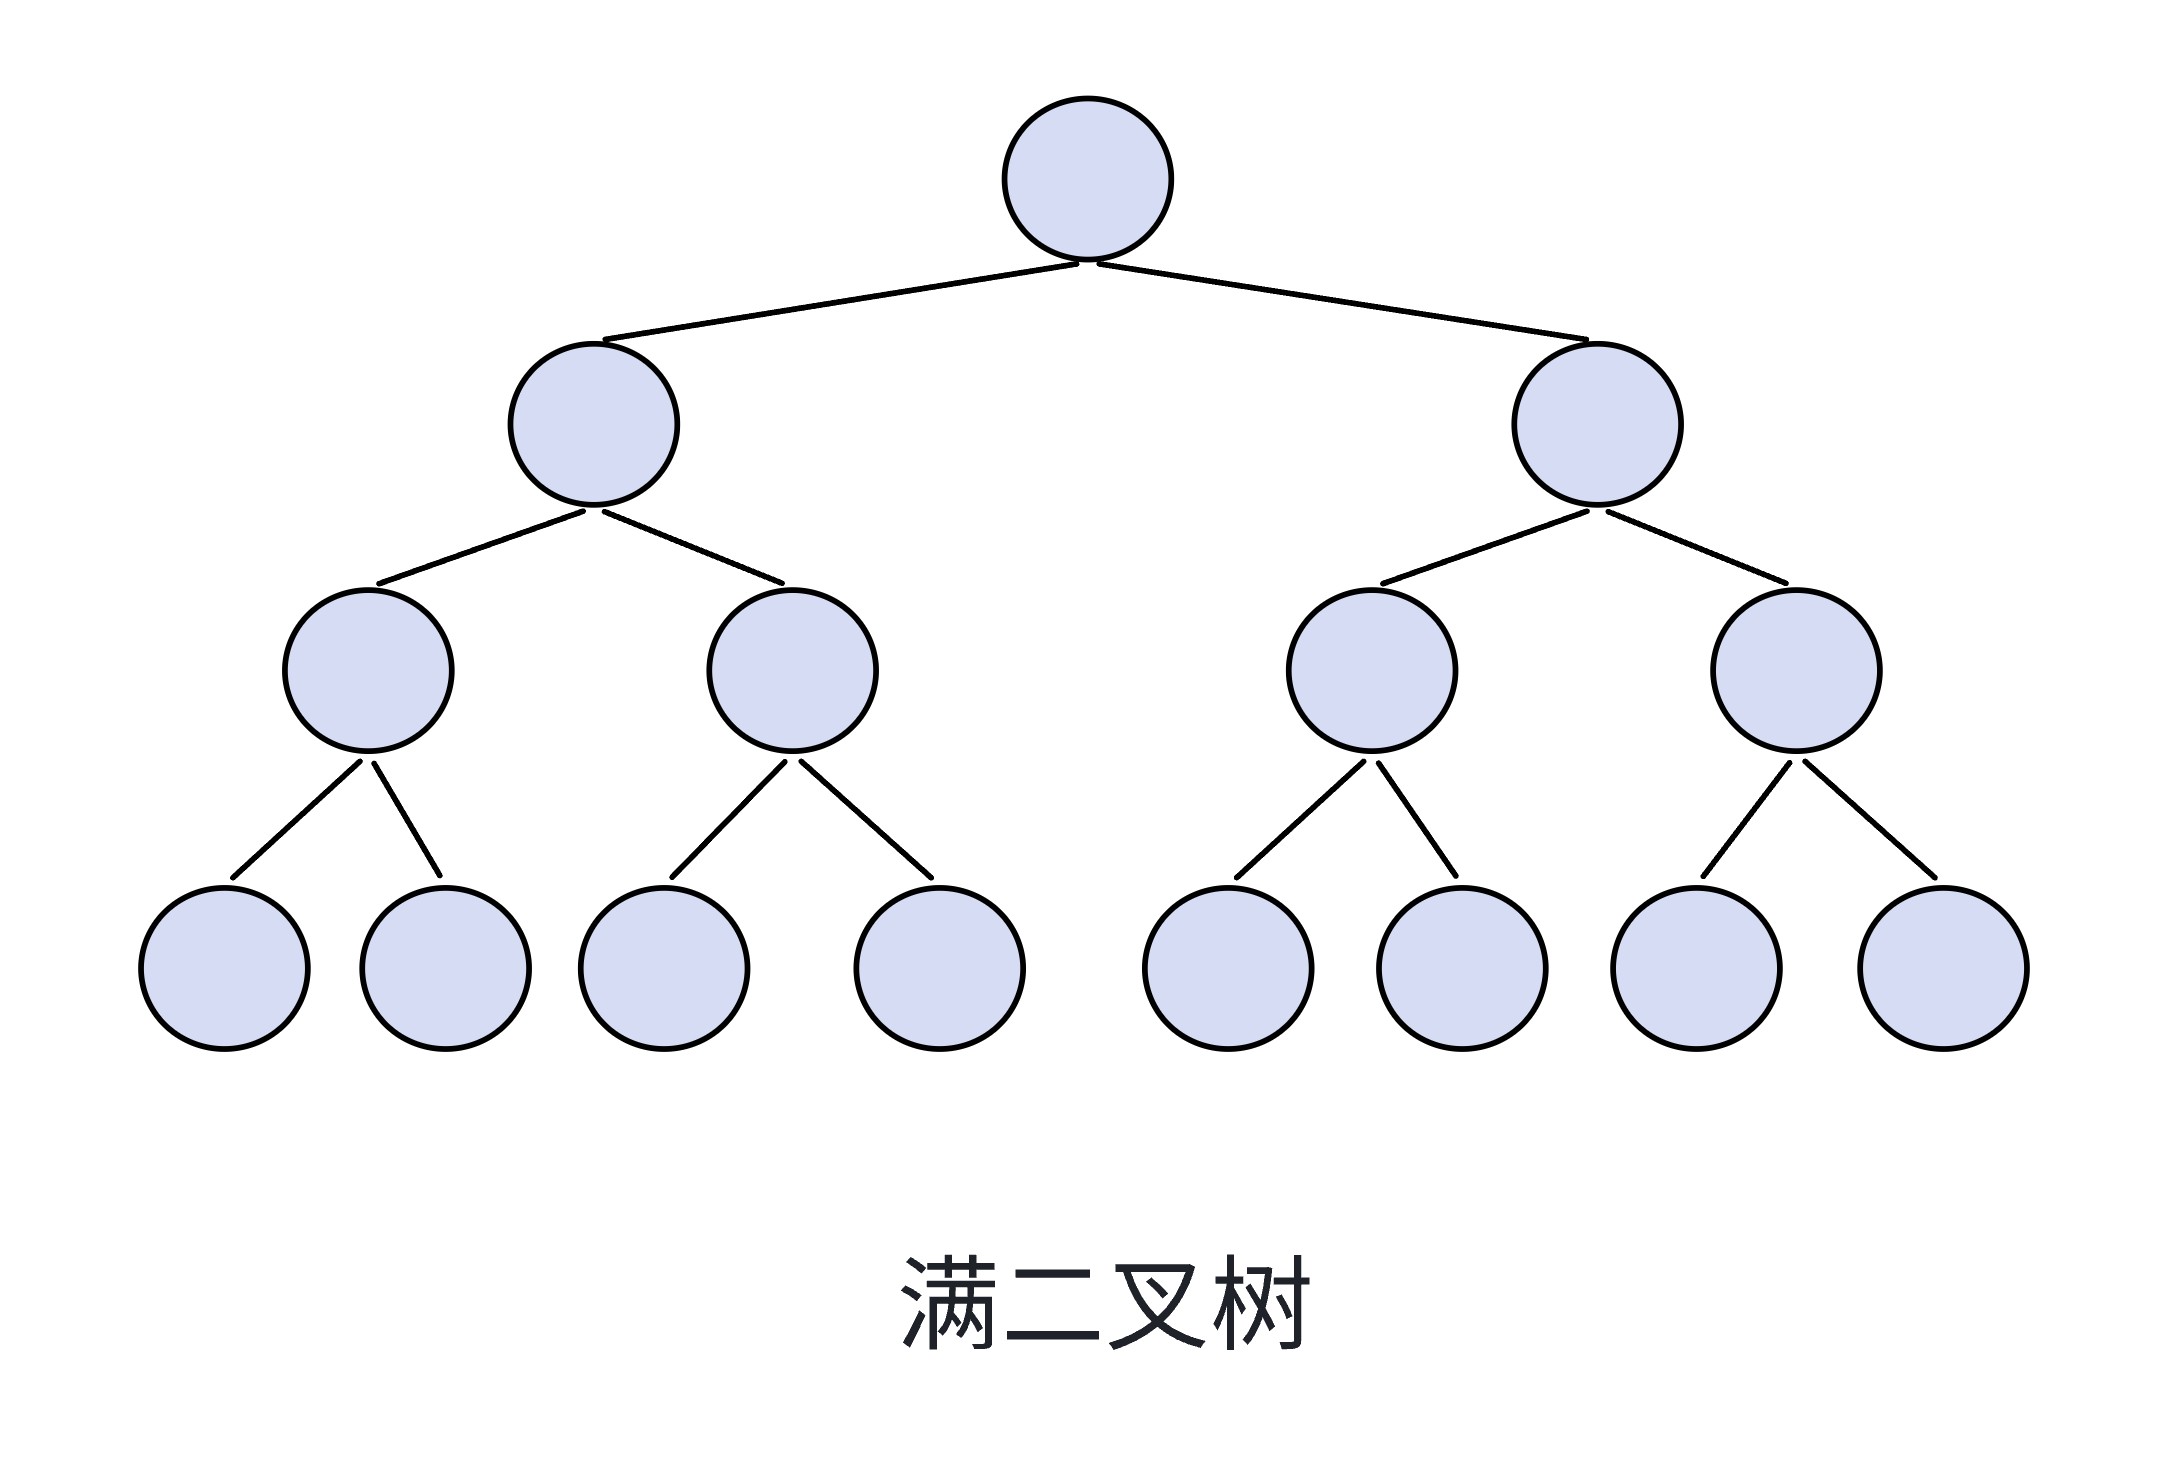
一个二叉树,如果每一个层的结点数都达到最大值,则这个二叉树就是满二叉树。也就是说,如果一个二叉树的层数为K,且结点总数是2^k-1,则它就是满二叉树。
2.2.2完全二叉树
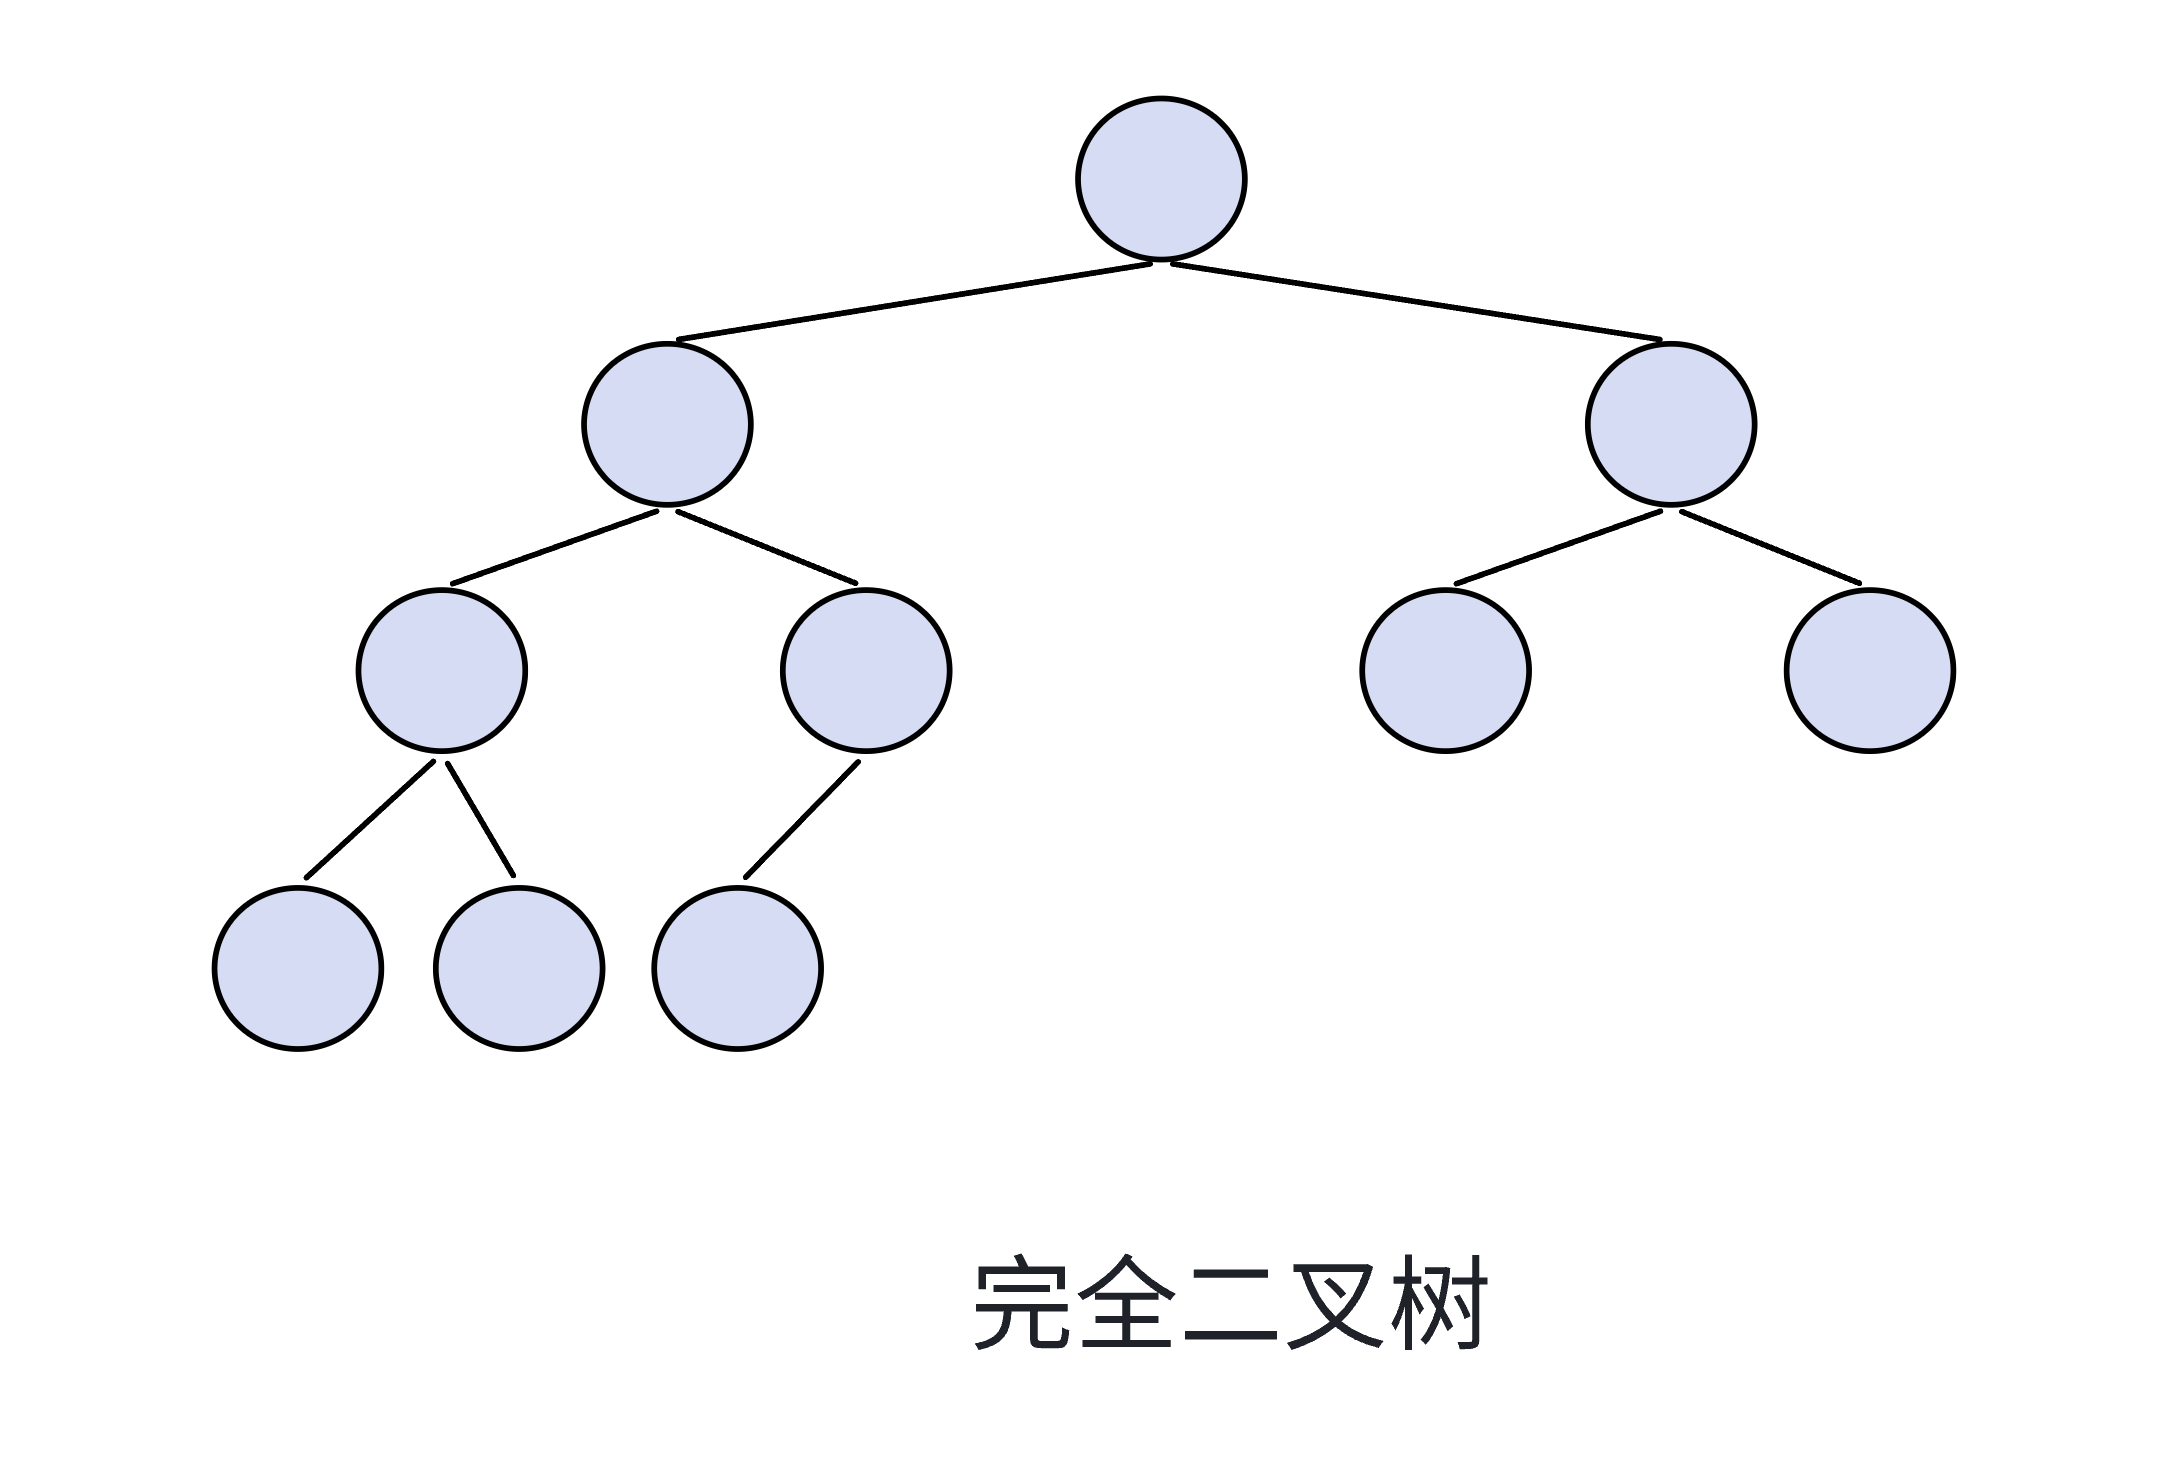
完全二叉树是效率很高的数据结构,完全二叉树是由满二叉树而引出来的。对于深度为K的,有n个结点的二叉树,当且仅当其每一个结点都与深度为K的满二叉树中编号从1至n的结点一一对应时称之为完全二叉树。要注意的是满二叉树是一种特殊的完全二叉树。
二叉树的性质:
1.若规定根结点的层数为 1,则一棵非空二叉树的第i层上最多有 2^(i - 1)个结点。
2.若规定根结点的层数为 1,则深度为 h 的二叉树的最大结点数是 2^h- 1
3.若规定根结点的层数为 1,具有 n 个结点的满二叉树的深度h =log(n +1)(log以2为底,n+1 为对数)。
2.3二叉树存储结构
二叉树一般可以使用两种结构存储:顺序结构和链式结构。
2.3.1顺序结构
顺序结构存储就是使用数组来存储,一般使用数组只适合表示完全二叉树,因为不是完全二叉树会有空间的浪费,完全二叉树更适合使用顺序结构存储。
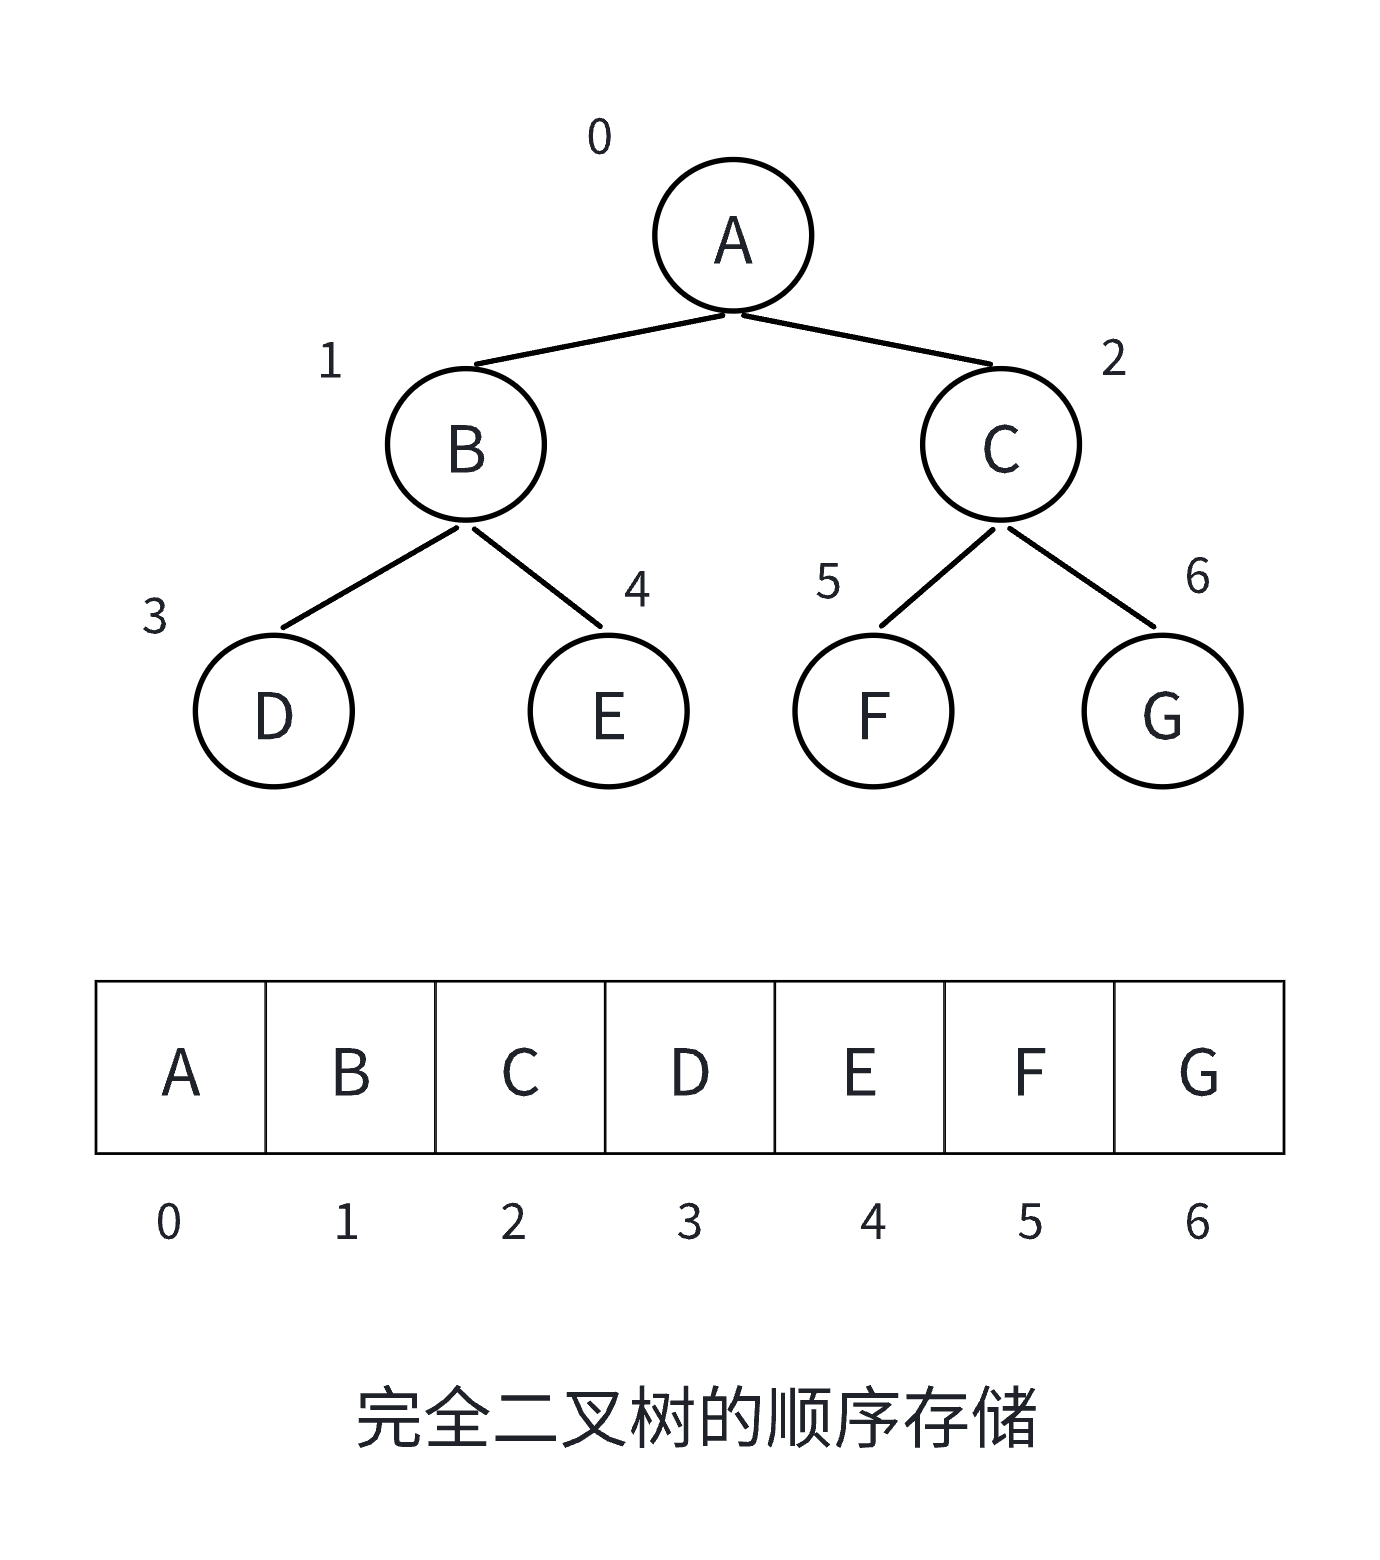
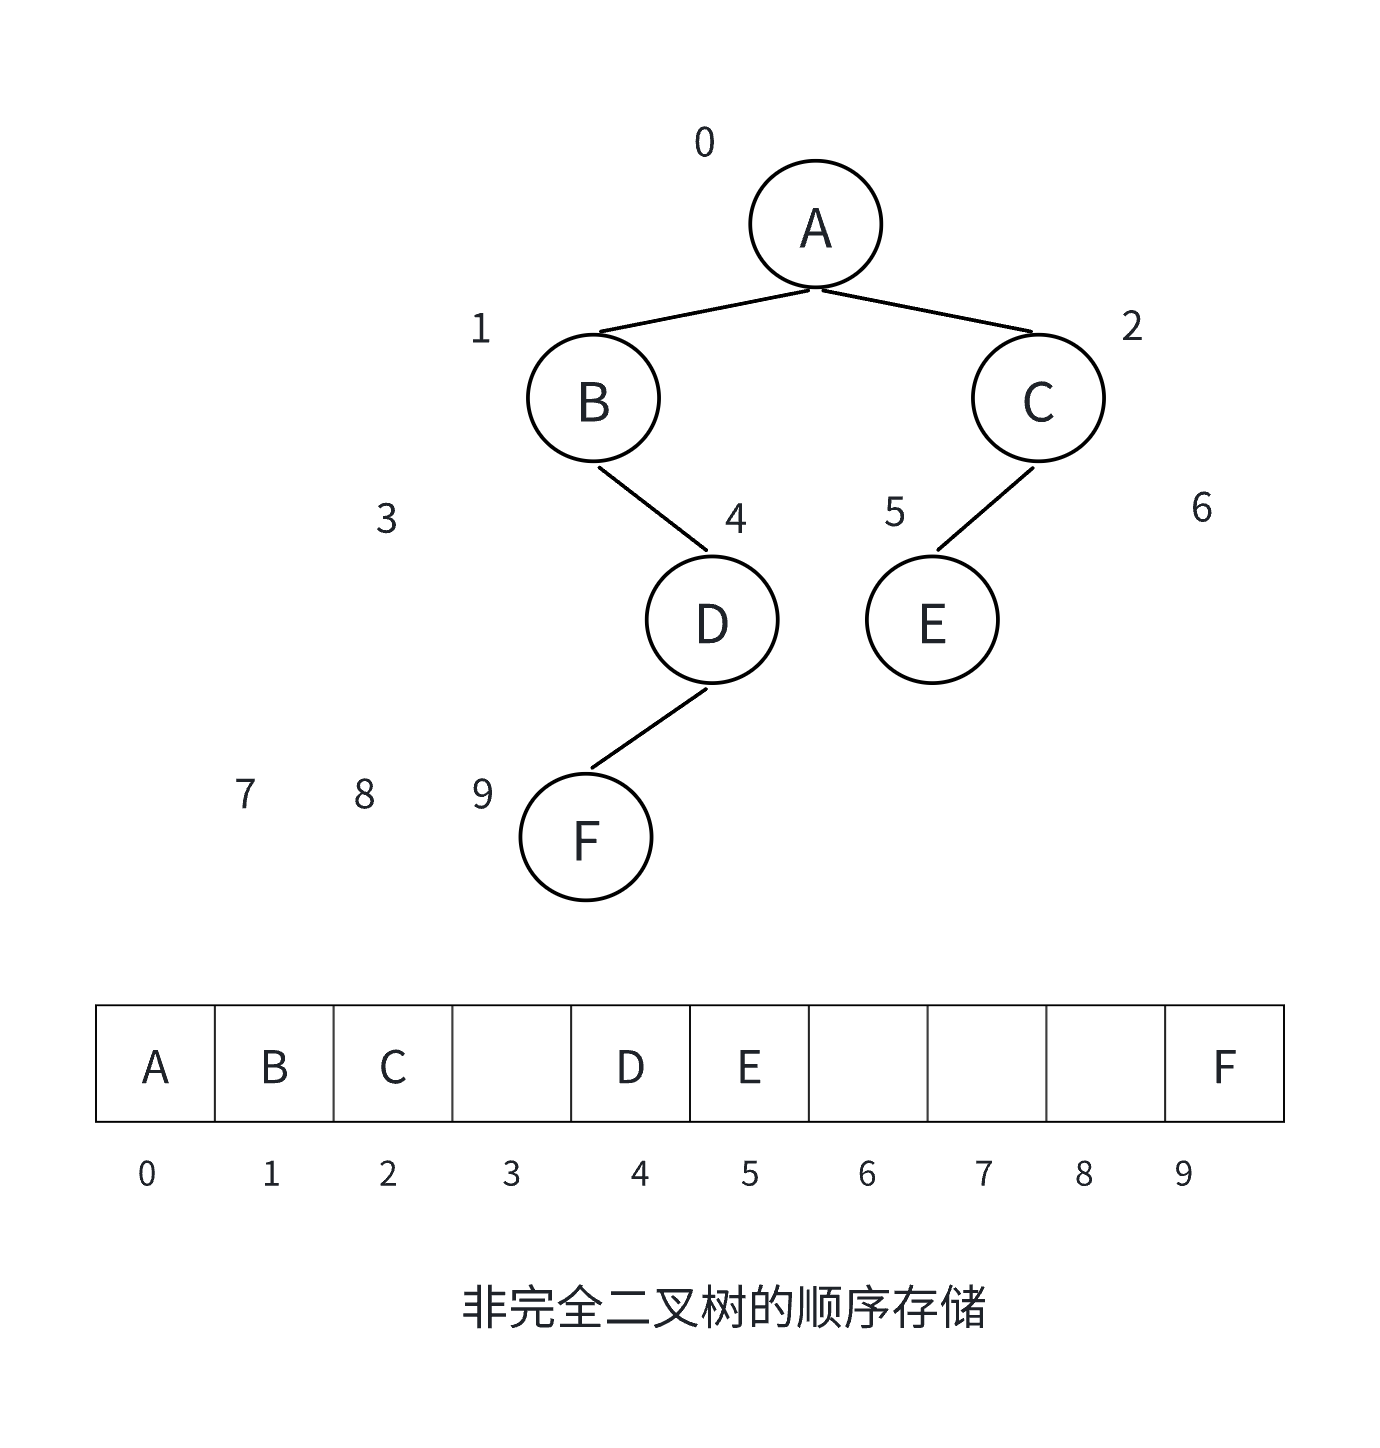
现实中我们通常把堆(一种二叉树)使用顺序结构的数组来存储,需要注意的是这里的堆和操作系统虚拟进程地址空间中的堆是两回事,一个是数据结构,一个是操作系统中管理内存的一块区域分段。
2.3.2链式结构
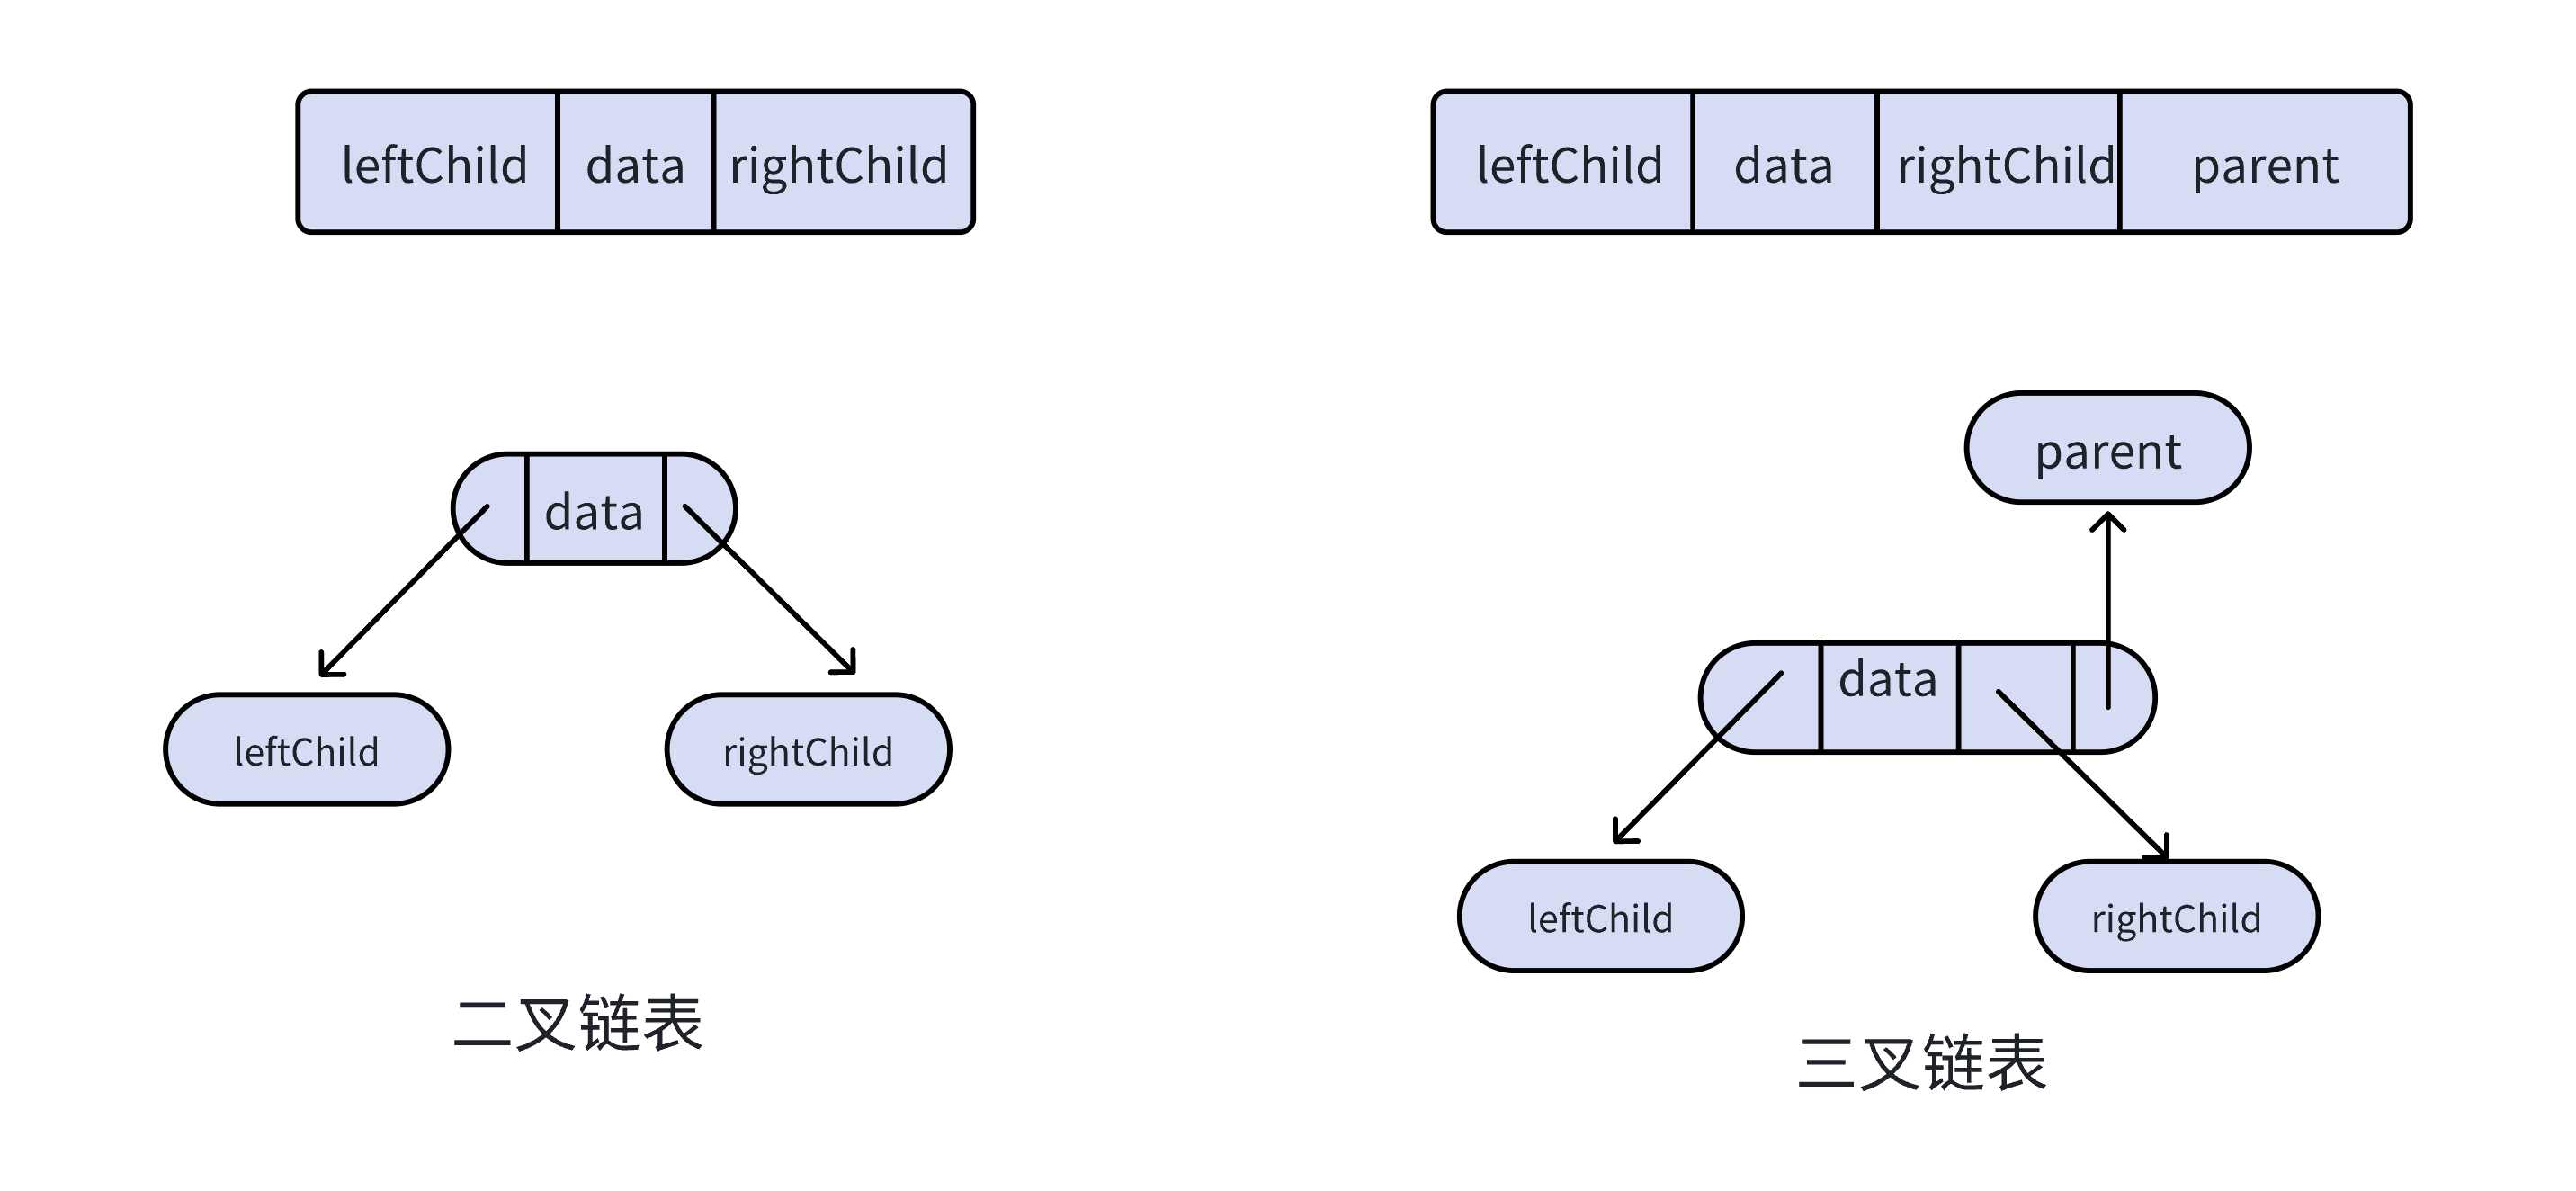
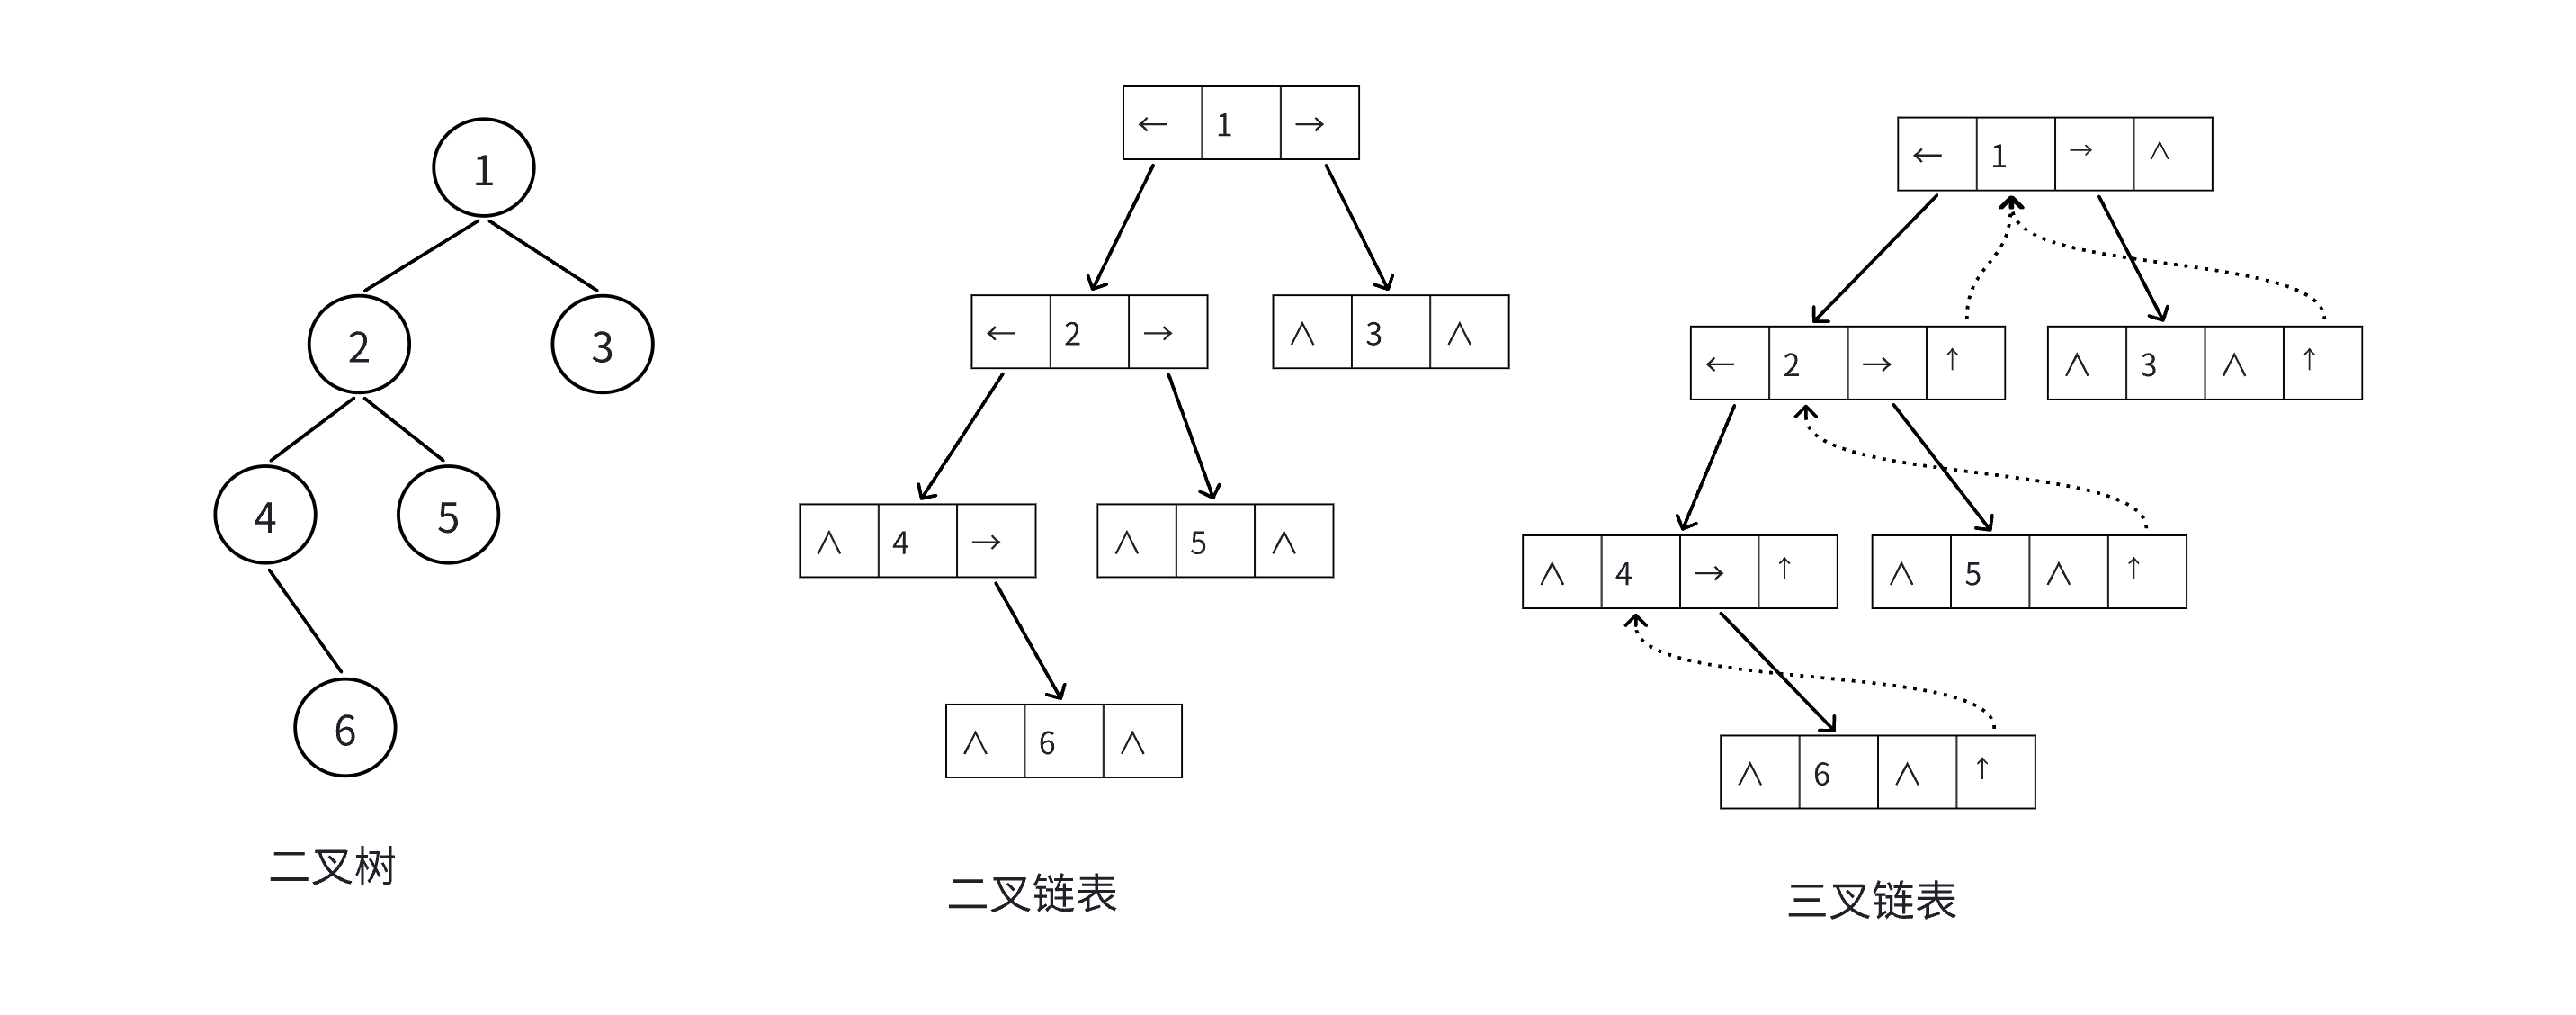
二叉树的链式存储结构是指,用链表来表示一棵二叉树,即用链来指示元素的逻辑关系。通常的方法是链表中每个结点由三个域组成,数据域和左右指针域,左右指针分别用来给出该结点左孩子和右孩子所在的链结点的存储地址。链式结构又分为二叉链和三叉链,当前我们学习中一般都是二叉链。后面课程学到高阶数据结构如红黑树等会用到三叉链。
3.实现顺序结构二叉树
一般堆使用顺序结构的数组来存储数据,堆是一种特殊的二叉树,具有二叉树的特性的同时,还具备其他的特性。
3.1堆的概念与结构
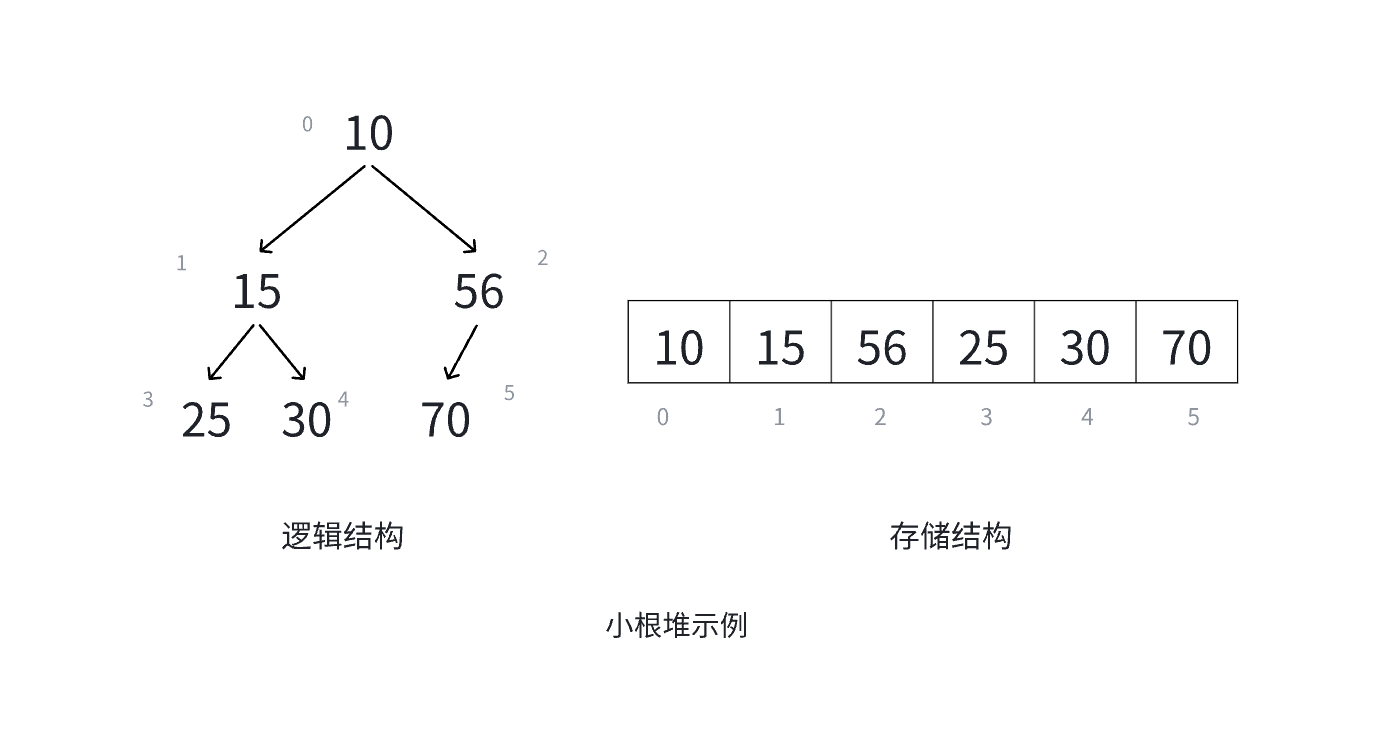
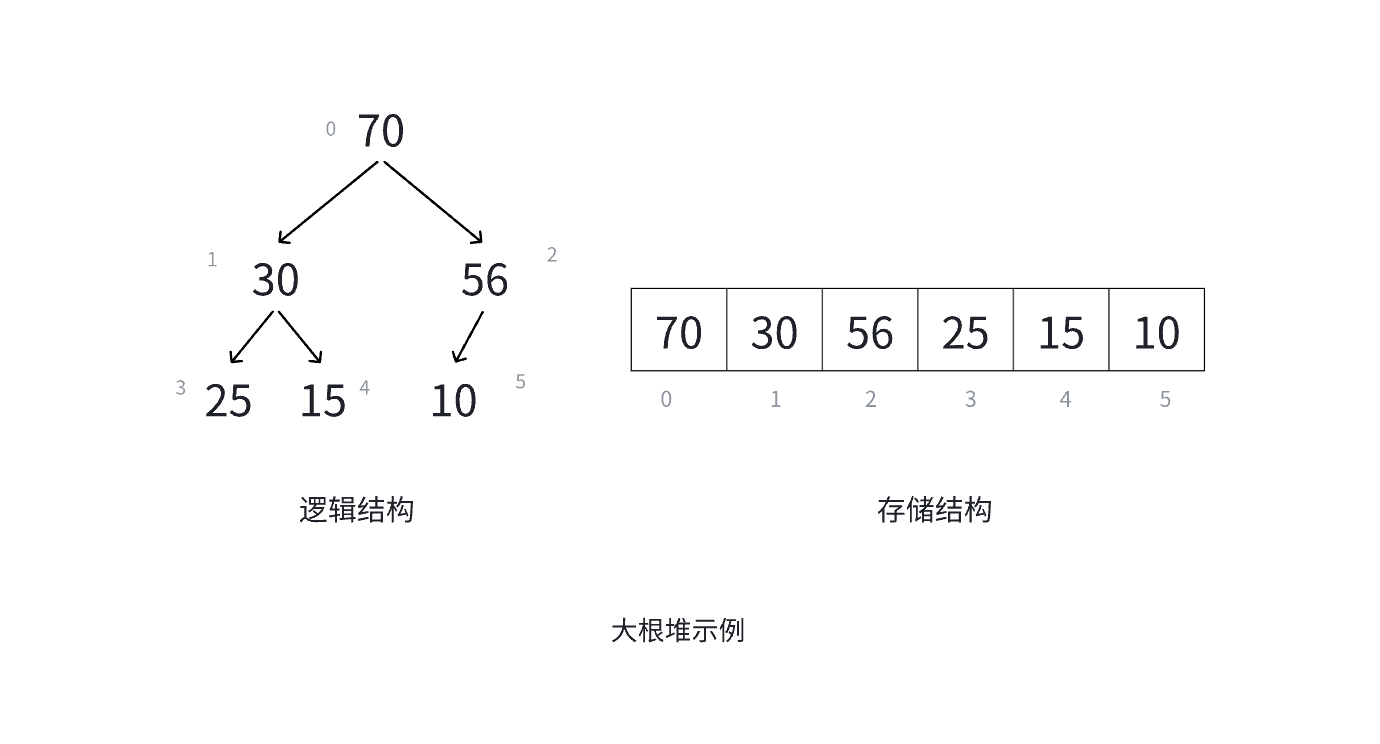
如果有一个关键码的集合K={k0,k1,k2,…,kn-1},把它的所有元素按完全二叉树的顺序存储方
式存储,将根结点最大的堆叫做最大堆或大根堆,根结点最小的堆叫做最小堆或小根堆。
堆的性质
1.堆中某个结点的值总是不大于或不小于其父结点的值;
2.堆总是一棵完全二叉树。
二叉树性质
对于具有n个结点的完全二叉树,如果按照从上至下,从左至右的数组顺序对所有结点从0开始编号,则对于序号为i的结点有:
1.若i>θ,i位置结点的双亲序号:(i-1)/2;i=0,i为根结点编号,无双亲结点。
2.若 2i+1<n,左孩子序号:2i+1,2i+1>=n 否则无左孩子。
3.若 2i+2<n,右孩子序号:2i+2,2i+2>=n 否则无右孩子。
3.2堆的实现
堆底层结构为数组,定义堆的结构:
//定义堆结构
typedef int HPDataType;
typedef struct Heap {
	HPDataType* arr;
	int size;    //有效数据个数
	int capaicty;//空间大小
}HP;
3.2.1初始化
//初始化
void HPInit(HP* php)
{
	assert(php);
	php->arr = NULL;
	php->capaicty = php->size = 0;
}
3.2.2堆的销毁
//堆的销毁
void HPDesTroy(HP* php)
{
	assert(php);
	if (php->arr)
		free(php->arr);
	php->arr = NULL;
	php->capaicty = php->size = 0;
}
3.2.3交换
//交换
void Swap(int* x, int* y)
{
	int tmp = *x;
	*x = *y;
	*y = tmp;
}
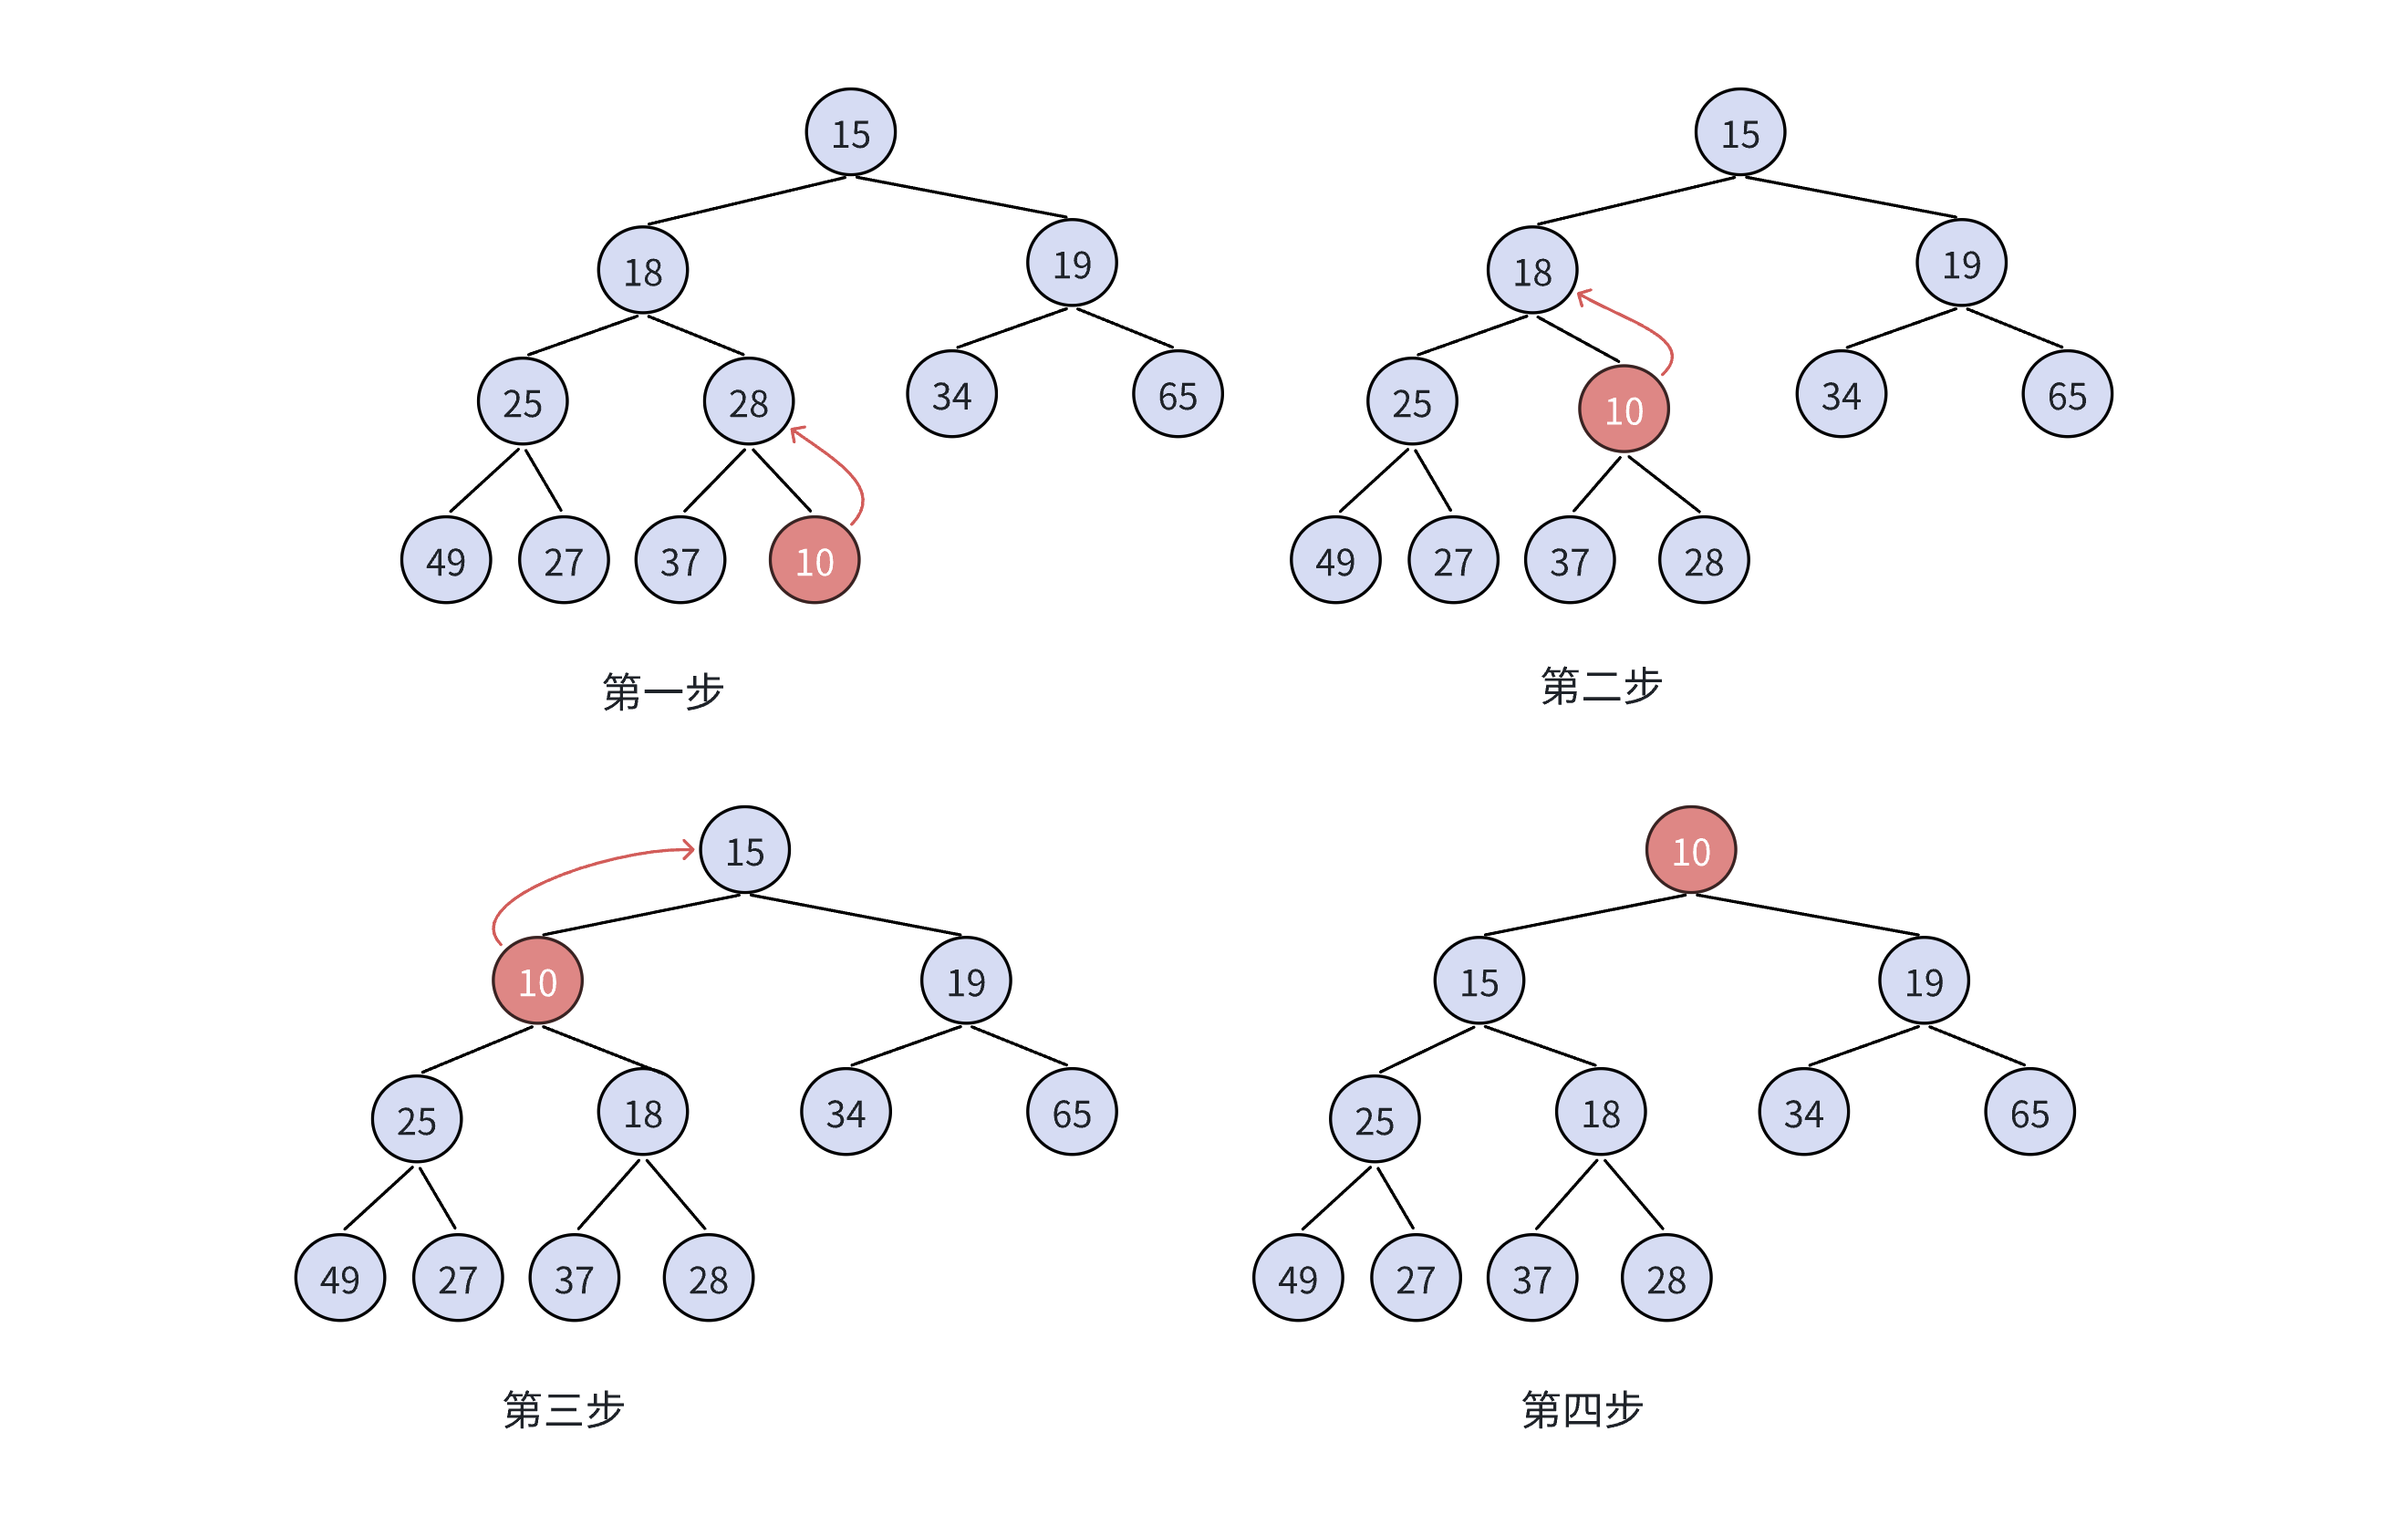
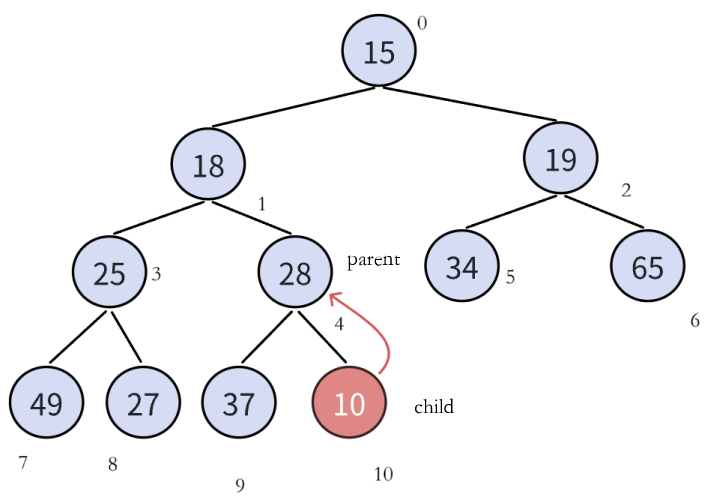
3.2.4向上调整算法
方法:
1.先将元素插入到堆的末尾,即最后一个孩子之后。
2.插入后若堆的性质被破坏,将新插入结点顺着其双亲向上调整到合适位置。
//向上调整算法
void AdjustUp(HPDataType* arr, int child)
{
	int parent = (child - 1) / 2;
	while (child > 0)
	{
		//建大堆:>
		//建小堆:<
		if (arr[child] > arr[parent])
		{
			Swap(&arr[child], &arr[parent]);
			child = parent;
			parent = (child - 1) / 2;
		}
		else {
			break;
		}
	}
}
3.2.5入堆(堆的插入)
//堆的插入
void HPPush(HP* php, HPDataType x)
{
	assert(php);
	//空间不够要增容
	if (php->size == php->capaicty)
	{
		//增容
		int newCapaicty = php->capaicty == 0 ? 4 : 2 * php->capaicty;
		HPDataType* tmp = (HPDataType*)realloc(php->arr, newCapaicty * sizeof(HPDataType));
		if (tmp == NULL)
		{
			perror("realloc fail1");
			exit(1);
		}
		php->arr = tmp;
		php->capaicty = newCapaicty;
	}
	//空间足够
	php->arr[php->size] = x;
	//向上调整
	AdjustUp(php->arr, php->size);
	++php->size;
}
3.2.6打印
//打印
void HPPrint(HP* php)
{
	for (int i = 0; i < php->size; i++)
	{
		printf("%d ", php->arr[i]);
	}
	printf("\n");
}
测试代码:
HP hp;
HPInit(&hp);

HPPush(&hp, 70);
HPPush(&hp, 30);
HPPush(&hp, 56);
HPPush(&hp, 25);
HPPush(&hp, 15);
HPPush(&hp, 10);
HPPush(&hp, 80);
HPPrint(&hp);
3.2.7判空
//判空
bool HPEmpty(HP* php)
{
	assert(php);
	return php->size == 0;
}
3.2.8出堆(删除堆顶数据)
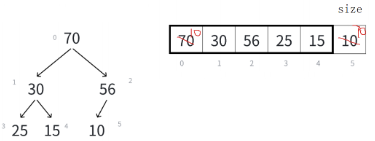
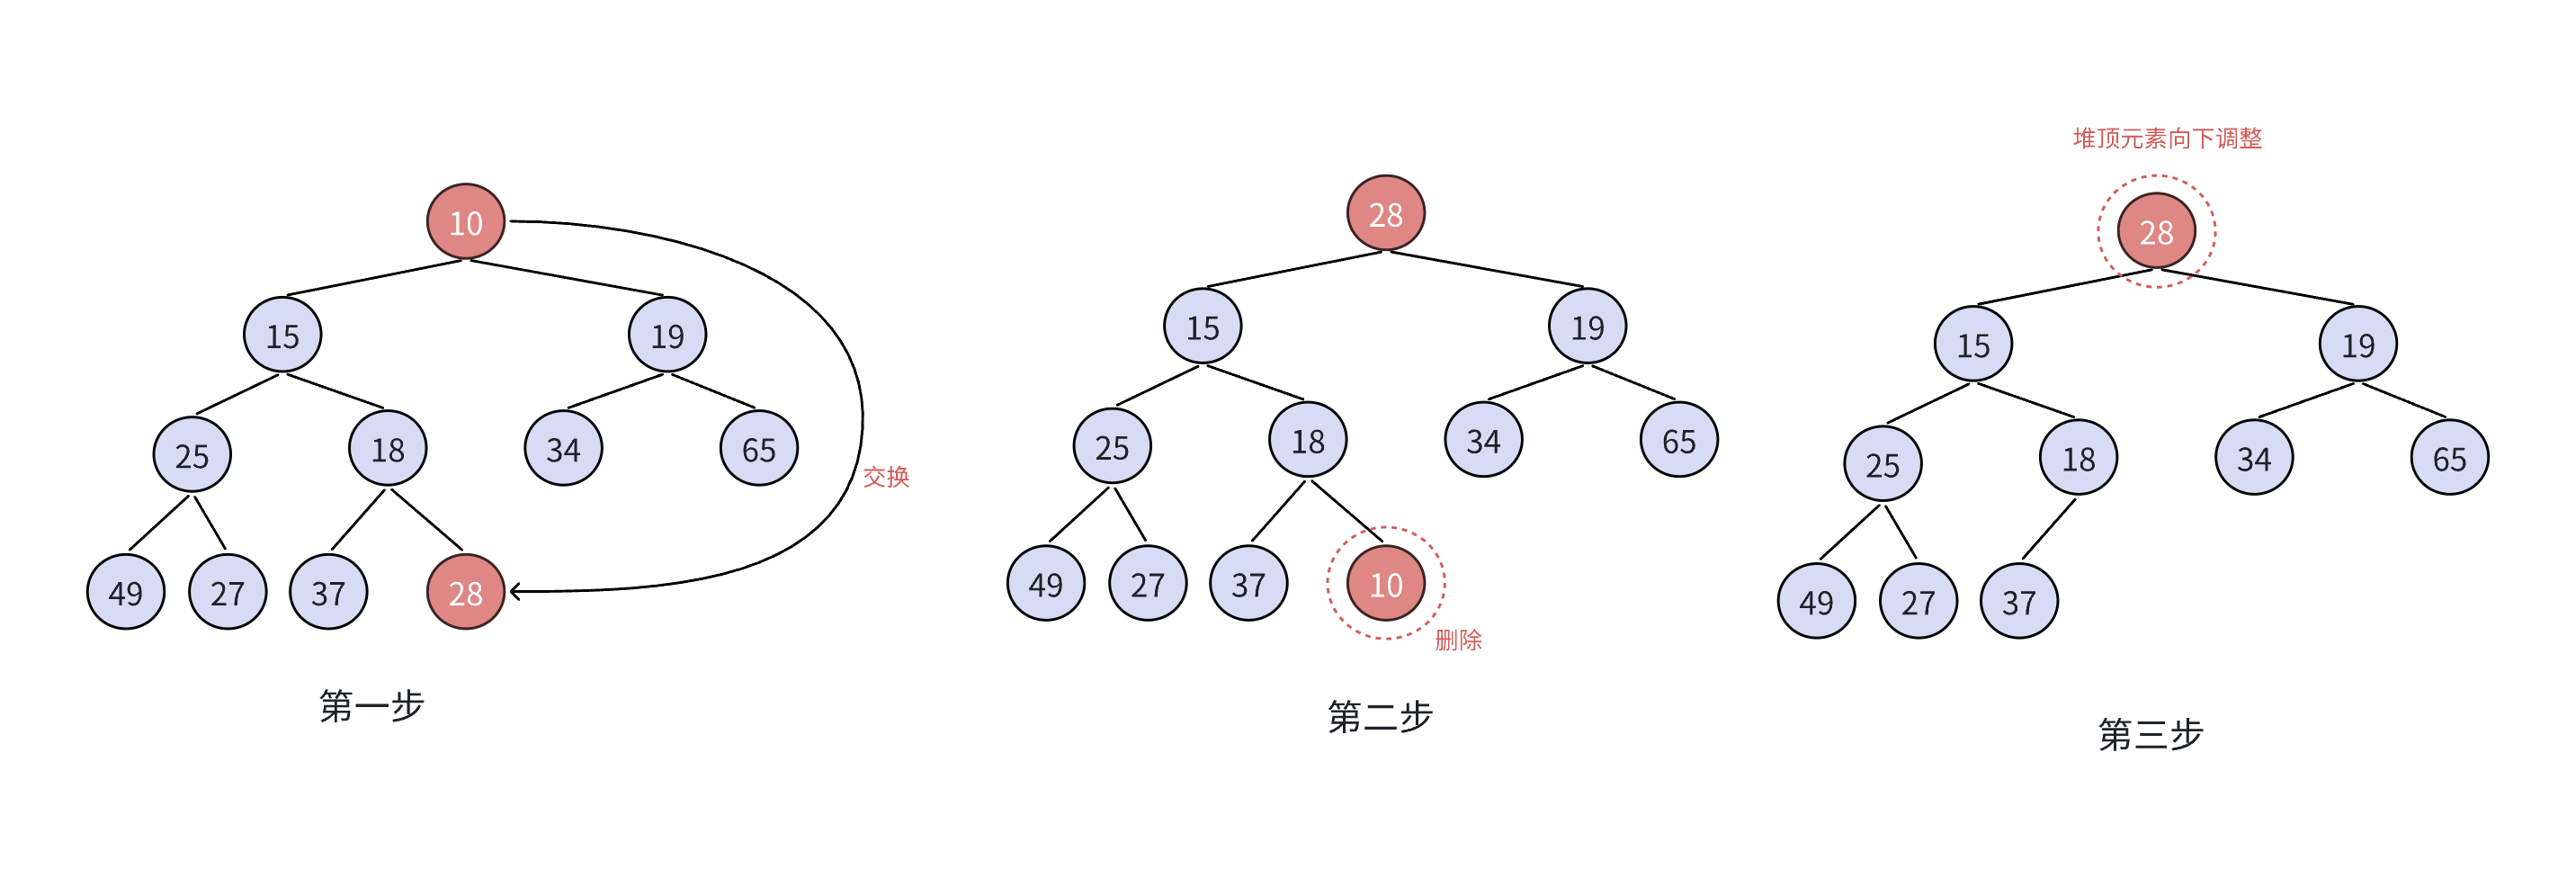
删除堆是删除堆顶的数据,将堆顶的数据根最后一个数据一换,然后删除数组最后一个数据,再进行向下调整算法。
//删除堆顶的数据
void HPPop(HP* php)
{
	assert(!HPEmpty(php));
	Swap(&php->arr[0], &php->arr[php->size - 1]);
	--php->size;
	//此时堆顶数据需要向下调整
	AdjustDown(php->arr, 0, php->size);
}
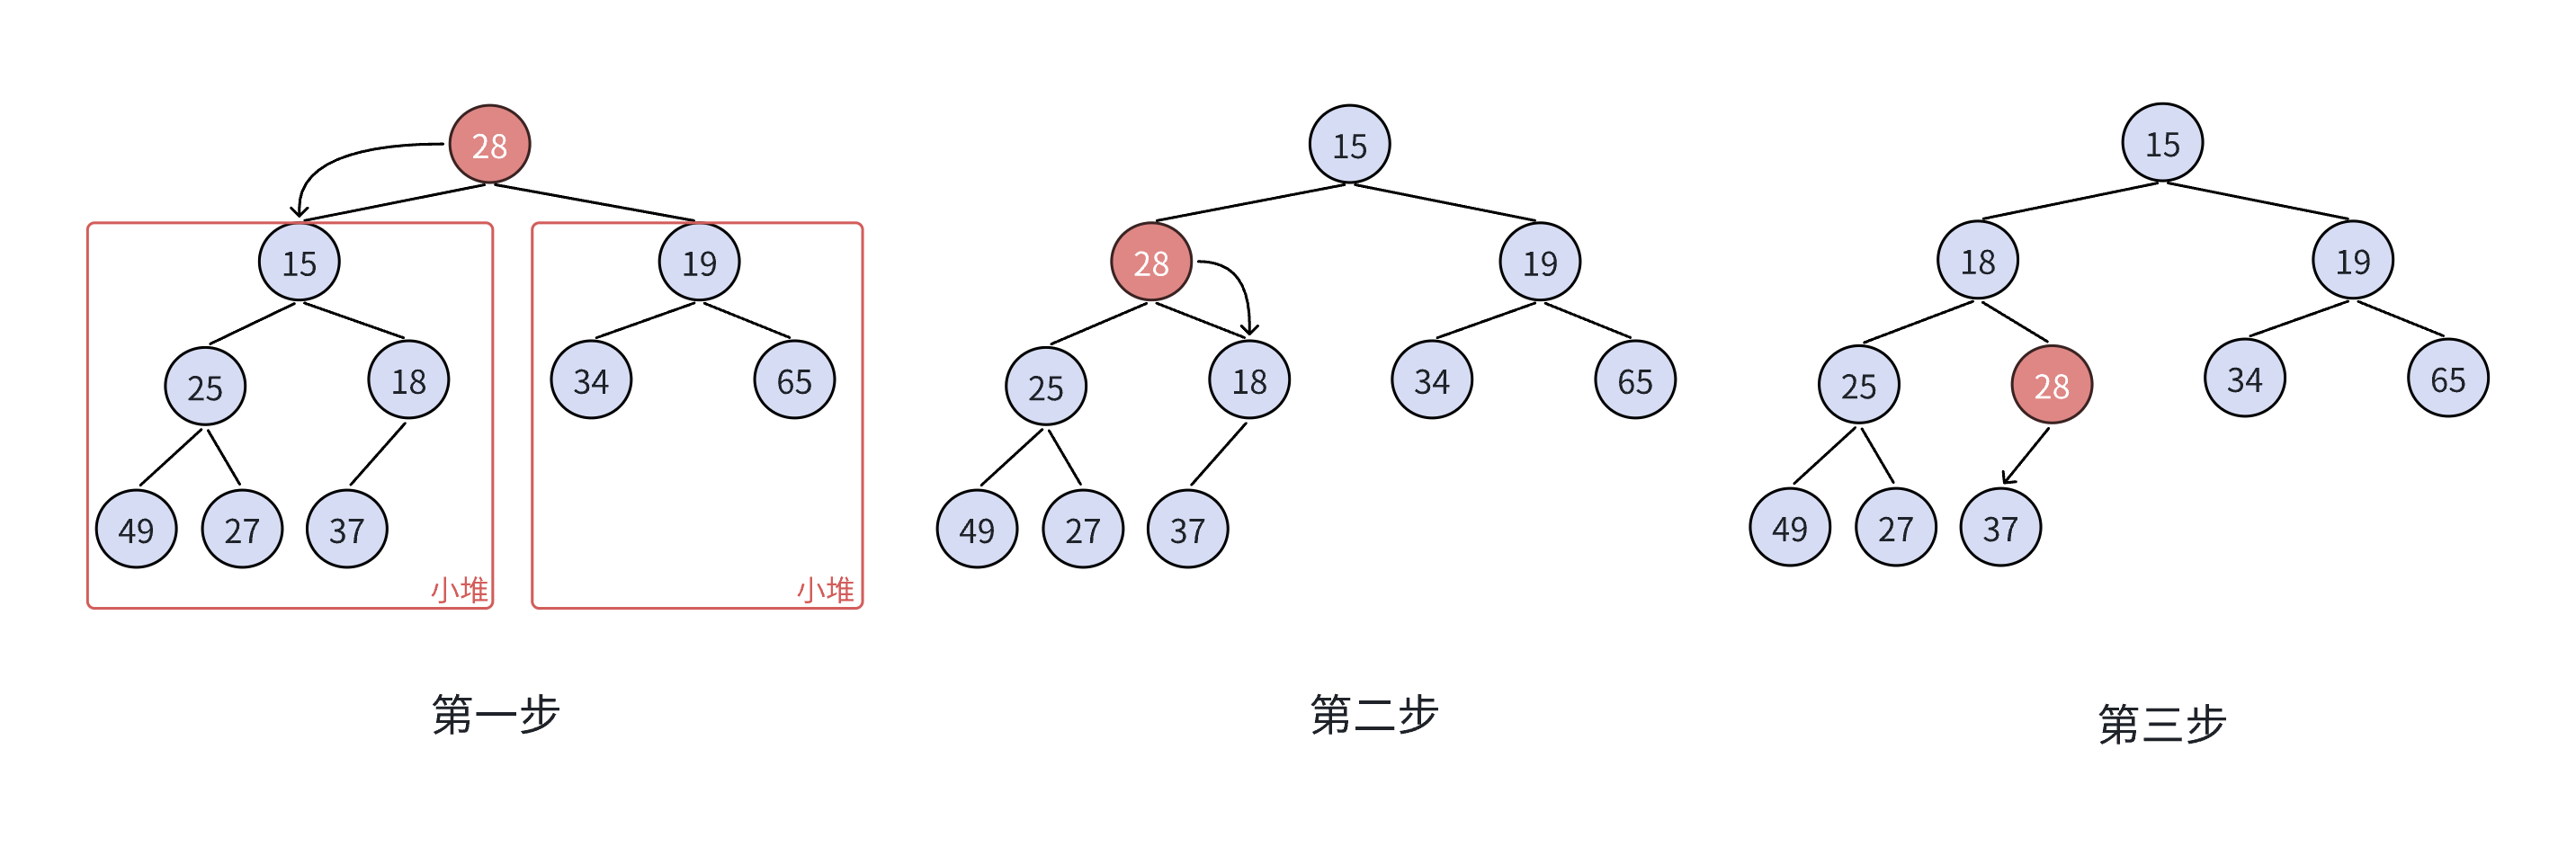
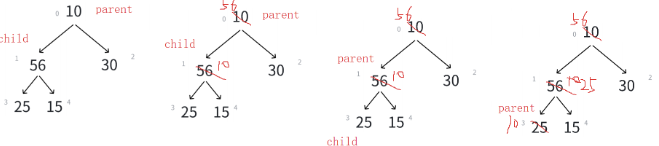
3.2.9向下调整算法
前提条件:左右子树必须是一个堆,才能调整。
//向下调整算法
void AdjustDown(HPDataType* arr, int parent, int n)
{
	int child = parent * 2 + 1;
	while (child < n)
	{
		//建大堆:<
		//建小堆:>
		//找值最大的孩子
		if (child + 1 < n && arr[child] < arr[child + 1])
		{
			child++;
		}
		//孩子和父亲比较
		//建大堆:>
		//建小堆:<
		if (arr[child] > arr[parent])
		{
			Swap(&arr[child], &arr[parent]);
			parent = child;
			child = parent * 2 + 1;
		}
		else {
			break;
		}
	}
}
3.2.10取堆顶
//取堆顶
HPDataType HPTop(HP* php)
{
	assert(!HPEmpty(php));
	return php->arr[0];
}
测试:
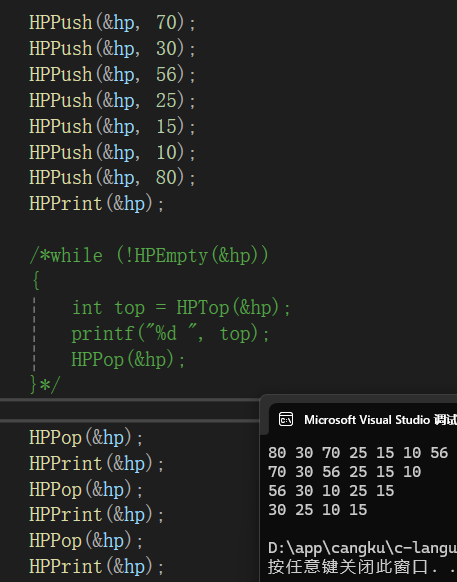
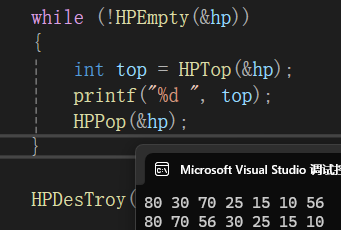
此时我们发现,通过删除堆顶数据,向下调整堆以及取堆顶的操作,得到了降序数组。那我们可以使用堆结构的思想进行堆的排序。
4.堆的应用--堆排序
4.1通过现有的数据结构堆完成
void HeapSort(int* arr, int n)
{
	HP hp;//-----使用数据结构-堆
	HPInit(&hp);
	//调用push将数组中的数据放入到堆中
	for (int i = 0; i < n; i++)
	{
		HPPush(&hp, arr[i]);
	}
	int i = 0;
	while (!HPEmpty(&hp))
	{
		int top = HPTop(&hp);
		arr[i++] = top;
		HPPop(&hp);
	}
	HPDesTroy(&hp);
}

int main()
{
	//test01();
	int arr[6] = { 30,56,25,15,70,10 };

	printf("排序之前:\n");
	for (int i = 0; i < 6; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");

	HeapSort(arr, 6);

	printf("排序之后:\n");
	for (int i = 0; i < 6; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
	return 0;
}
4.2使用堆结构的思想
先从最小的一棵子树开始:
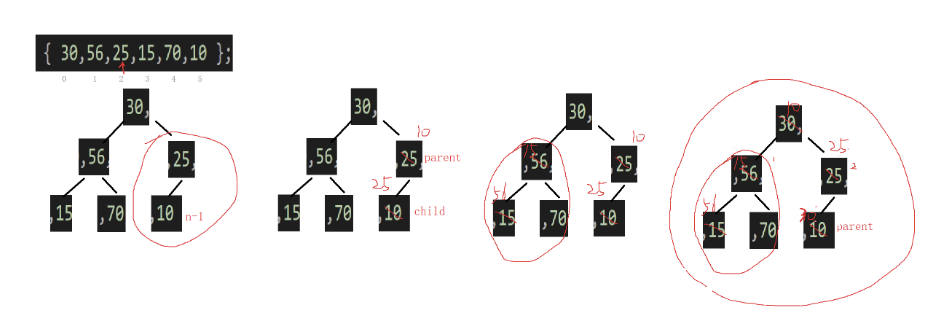
void HeapSort(int* arr, int n)
{
	//乱序数组--建堆
	for (int i = (n - 1 - 1) / 2; i >= 0; i--)
	{
		AdjustDown(arr, i, n);
	}
	int end = n - 1;
	while (end > 0)
	{
		Swap(&arr[0], &arr[end]);
		AdjustDown(arr, 0, end);
		end--;
	}
}
本章完。
更多推荐


 28
 0
- 0


 已为社区贡献1条内容

所有评论(0)