
Universal Scene Graph Generation(通用场景图生成)
1、介绍
目前的研究分别研究不同模式的SG,而且还不存在涵盖所有模式的通用表示。本文提出了一种通用SG(USG)表示法,能够刻画任意组合的模态。USG可以结合单个SGS的所有特征,从任何给定的输入通道组合中捕获全面的语义场景。
ISG:提供具体的视觉细节,使SG能够精确地描述对象的位置、大小和视觉属性,但通常不能直接传达时间序列或动态变化。
TSG:灵活地描述抽象的实体、动作、事件以及对象和实体之间的抽象关系,这些关系在视觉上不是明确的,但通常缺乏特定的视觉和空间细节。
VSG:视频建立在静态图像的基础上,更善于表达动态事件、动作和时间变化。
3DSG:进一步模拟对象及其空间关系、大小、方向和其他3维空间属性。
现有研究多聚焦 “单模态场景图(SG)生成”,若通过 “流水线范式”(先分模态解析 SG、再合并为 USG)实现 USG,核心难点是 “跨模态合并相同对象的同时保留各模态特有场景信息”。但由于不同模态的 SG 解析器 “孤立运行”,会引发两大问题:
- 跨模态的 “互补语义信息”(不同模态能相互补充的语义内容)被忽略;
- 不同模态的 “特征空间” 存在差异,导致跨模态的相同对象难以精准对齐,最终生成的 USG 既不简洁、效果也不佳。
缺乏带标注的 USG 数据,是主要障碍(手动标注成本极高)。虽可通过 “联合训练多个单模态 SG 数据集” 来间接学习 USG,但不同模态数据存在 “领域差异”(如 3DSG 聚焦静态室内、VSG 偏向动作类场景、仅 TSG 适用于通用领域),这使得训练出的 USG 解析器会 “继承场景偏差”,最终限制了其有效性。
2、通用场景图
2.1、基础
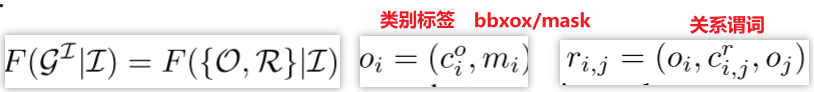
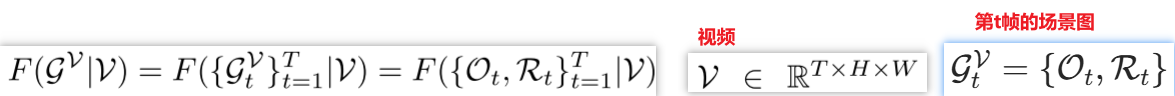
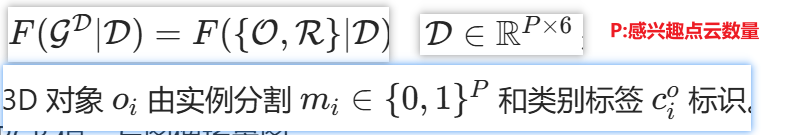
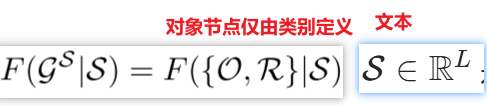
2.2、USG定义
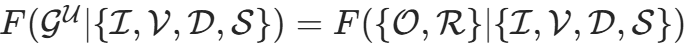
其中, 表示所有跨模态的对象集合。每个节点都包含类别标签
和分割掩码
.(文本提取对象,构造一个二进制掩码指示位置),
,既包含模态内的关系
,也包含模态间的关联
3、方法
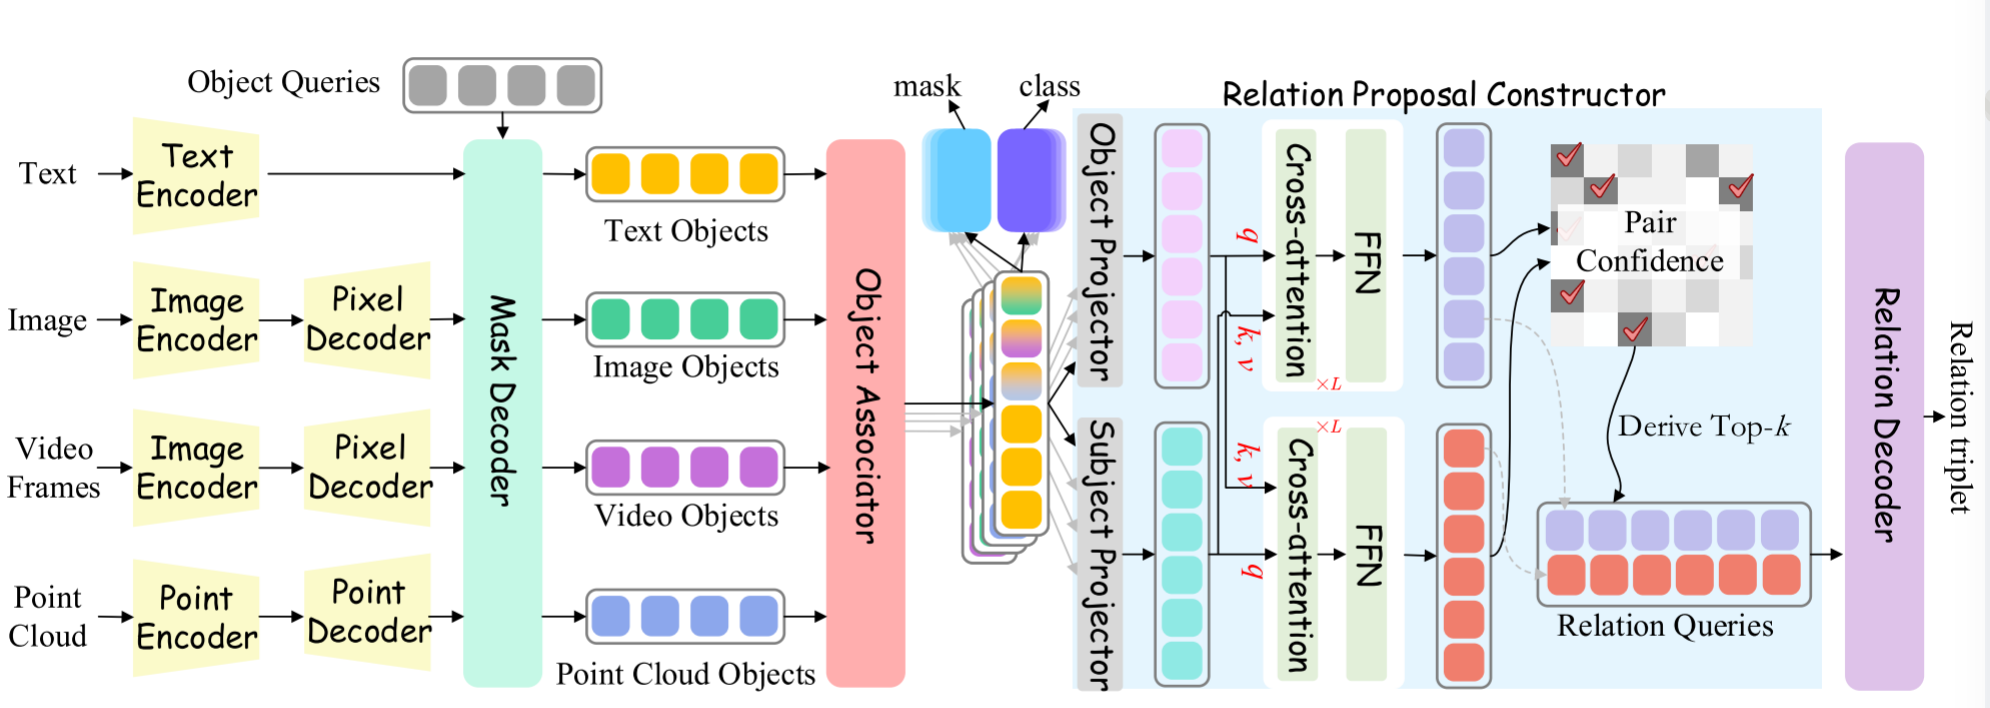
3.1、特定于模态的编码器
文本编码器:OPEN-CLIP -->
Image编码器+像素解码器:CLIP-ConvNeXt作为编码器冻结:;Mask2Former解码器:多阶段可变形注意力层组成,得到
Point编码器解码器:编码器Point-BERT -->
;解码器分层的将超点特征传播到每一个点,产生多尺度点特征
3.2、共享掩码解码器
采用共享掩码解码器框架隐式整合跨模态互补特征,在特定模态特征与相应对象之间执行掩码交叉注意力操作。
查询对象 第l层的对象查询特征,N表示*模态的查询数量,d表示维度
:QKV矩阵,由前一层查询对象
和模态特异特征
通过线性变化
生成
、
、
:前一阶段掩码预测经调整大小后的二值化输出,用于过滤无关区域特征
是从多尺度特征输出
中采样得到的,文本
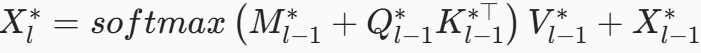
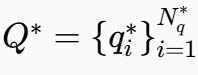
经过L层掩码交叉注意力操作后,解码器最终输出精细化的对象查询
3.3、对象关联器
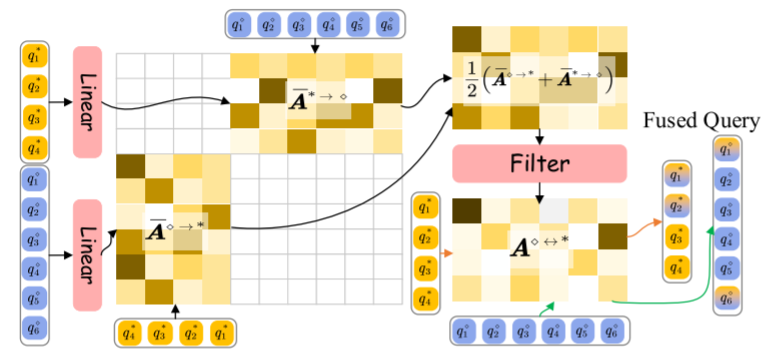
挑战:准确融合跨多模态的相同对象(3层CNN)
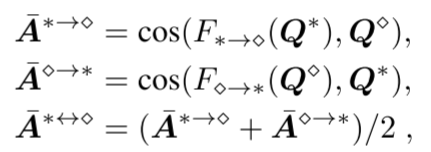
对不同模态下的对象查询特征进行线性变换,计算与之目标模态下的余弦相似度,取平均。之后进行基于卷积神经网络CNN的过滤Filter,利用局部细节信息+去除冗余噪声,输出关联矩阵。
3.4、特定模态对象检测头
对当前模态的目标查询进行融合,将其他模态的互补信息整合到当前模态的目标嵌入中。
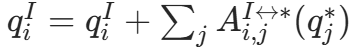
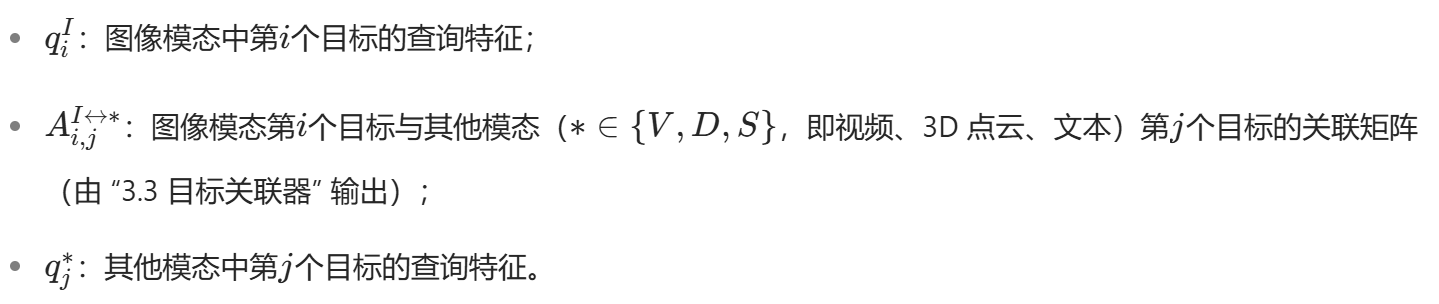
图像为例:图像模态的目标查询特征 = 原始模态特征 + 其他模态所有关联目标的查询特征*3.3节的关联矩阵的和。
类别预测:目标查询特征与类别名称的文本嵌入计算内积,Sigmoid交叉熵损失与GT监督训练。
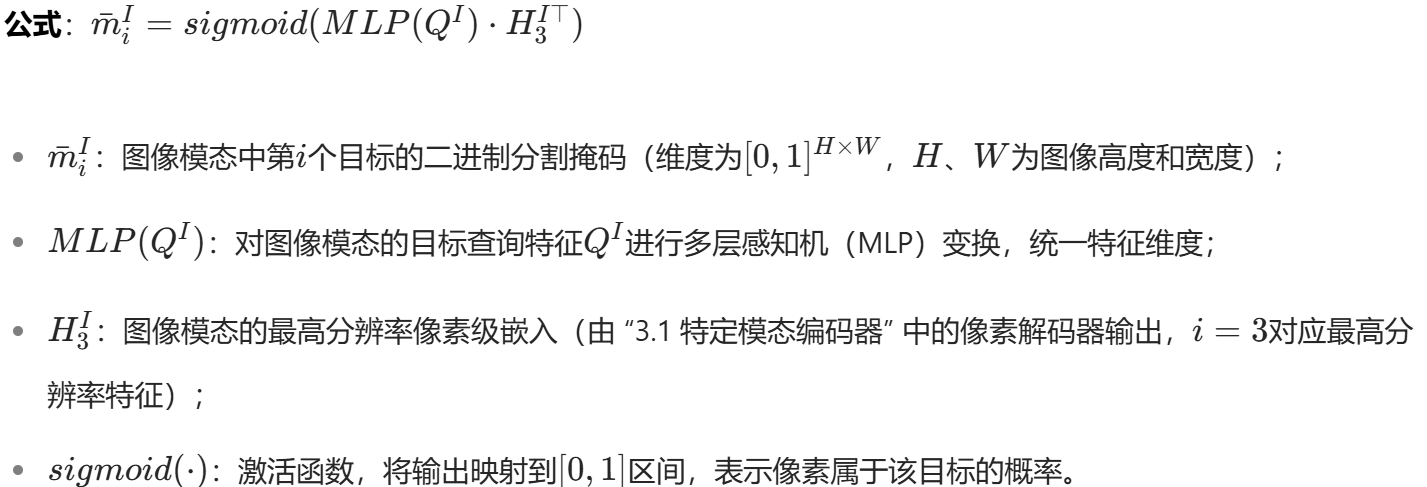
分割掩码预测:图像模态目标的分割掩码,是通过对 “目标查询经 MLP 变换后的特征” 与 “最高分辨率像素嵌入” 的转置进行点积运算,再经过 sigmoid 激活得到的概率矩阵。
3.5、关系提议构造器
对3.4节的目标查询特征经过MLP转变为主体嵌入和客体嵌入
,双向交叉注意力对主客体特征进行关联多层迭代优化。
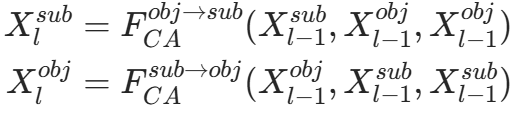
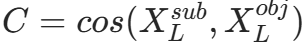
经过L层的双向注意力迭代优化,计算最终的主客体嵌入的余弦相似度,得到置信度矩阵C,选择前K个置信度得分的目标作为关系候选对。并提取对应主客体的查询,传递后面
3.6. 关系检测器
关系查询由两部分拼接而成,第一部分是 “优化后的主体查询与初始主体嵌入的和”,第二部分是 “优化后的客体查询与初始客体嵌入的和”。
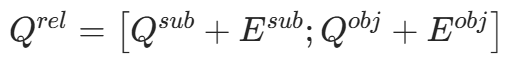
Q:3.5节筛选后的主体、客体查询特征
E:3.5节的初始主体、客体嵌入;相加,然后进行拼接。得到关系解码器的关系查询,融合了 “优化后的候选对特征” 与 “初始目标角色特征”,为关系预测提供完整的语义信息。
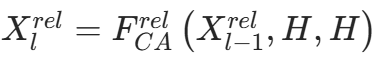
X:上一步的Q关系查询;6层交叉注意力机制;H:表示模态编码器部分的特征。之后进行关系分类头输出概率。
3.7、基于领域平衡策略的训练
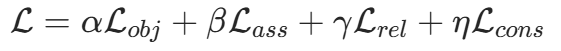
3.7.1、目标检测损失(对应3.4)
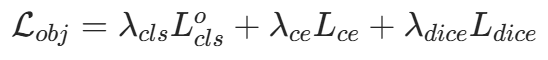
目标查询和GT目标进行匈牙利匹配,匹配结果进行标签分类,计算交叉熵损失(计算GT类别与 “Query和类别名称文本嵌入的内积得到的对数概率” 之间的损失)
掩码二元交叉熵损失Lce:分割掩码的像素级预测是否准确
Dice 损失:监督分割掩码,但侧重 “预测掩码与真实掩码的重叠度”,弥补交叉熵损失的不足。
3.7.2、目标关联损失(3.3节)
Lass
目标关联器的核心是输出关联矩阵A(模态*的第i个目标” 与 “模态□的第j个目标” 是同一实体的概率)
构建一个稀疏的二进制关联GT矩阵(根据类别匹配和语义一致性判断,匹配为1,不匹配没有匹配为0)
关联损失采用加权二进制交叉熵损失,核心是给 “正样本(关联对)” 赋予远大于 “负样本(非关联对)” 的权重
3.7.3 关系分类损失(3.5、3.6)
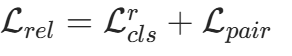
第一项:直接监督谓词分类精度,预测关系与真值的一致性
第二项:监督生成的置信度矩阵C(矩阵元素表示目标对的关联置信度),使高置信度矩阵元素对应真实有关系的目标对,避免 RPC 筛选出无关目标对(如 “植物 - 手机”),减少后续关系分类的噪声。
3.7.4、文本中心场景对比学习
目标、关系均像文本空间对齐
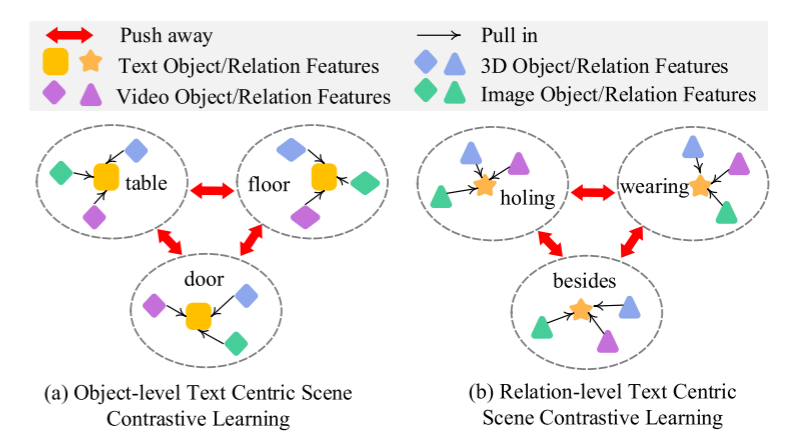
将其他模态与文本数据对齐,1)文本场景图(TSG)数据覆盖最广泛的通用领域,无场景偏向性;2)将其他模态信息与文本绑定,可有效缓解特定模态组合数据缺失的问题
计算文本查询和其他模态查询
的相似度(其他模态也存在文本对应的类别时为正样本,否则为负)
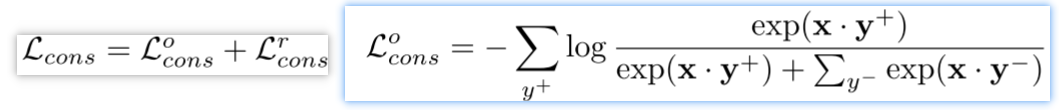
更多推荐


 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)