
C++实现B+树数据结构与算法

简介:在计算机科学中,数据结构和算法是提高编程效率的基础。B+树作为自平衡查找树,在数据库和文件系统中广泛应用。本话题集中于在C++中实现B+树,强调其优化磁盘访问效率的设计特点,如高分支因子、非叶节点不存储数据、叶子节点链接以及平衡性。实现过程包括定义节点结构、内存初始化、插入、遍历、删除等关键步骤,并涉及内存管理、动态内存分配和可视化调试。掌握B+树的实现有助于理解数据库查询优化,提升程序员在数据结构和算法方面的技能。
1. 数据结构和算法基础
1.1 数据结构简介
数据结构是组织和存储数据的方式,它决定着数据如何被使用和操作。良好的数据结构能够提高算法的执行效率,降低系统开销。常见的数据结构有线性结构、树形结构、图结构等。
1.2 算法基础概念
算法是解决问题的一系列步骤。在计算机科学中,算法是数据结构的灵魂,它决定数据结构操作的效率。算法设计需要考虑时间复杂度和空间复杂度,它们是衡量算法性能的两个主要指标。
1.3 数据结构与算法的关系
数据结构和算法是相辅相成的。一种好的数据结构能够使得算法更加高效,而高效的算法往往需要合适的数据结构来支持。理解这两者之间的关系对于编写优秀的软件至关重要。
graph LR
A[数据结构] --> B[算法]
B --> A
在本章中,我们将首先了解数据结构和算法的基本概念和重要性,为进一步深入学习本系列文章的主题 - B+树打下坚实的理论基础。
2. B+树在数据库和文件系统中的应用
2.1 B+树的起源和理论基础
2.1.1 数据库索引的基本概念
在深入探讨B+树在数据库和文件系统中的应用之前,首先要了解数据库索引的基本概念。数据库索引是数据库系统中用来提高数据检索速度的数据结构。它可以看作是图书目录,当需要快速查找某个特定的信息时,不需要逐行扫描整个数据表,而是可以直接通过索引来定位到数据所在的页或行。
索引的类型分为聚集索引和非聚集索引。聚集索引决定了表中数据的物理存储顺序,而非聚集索引则是逻辑上与数据表分离的索引结构。B+树作为一种平衡树结构,非常适合实现非聚集索引。
2.1.2 B+树与B树的比较分析
B+树与B树都是平衡树,用于数据库索引和文件系统管理,但它们在结构上有显著差异。B树每个节点都存储数据,而B+树只有叶子节点存储数据,非叶子节点仅用来索引。这种设计使得B+树在数据读取时更为高效,因为它使得在顺序访问数据时不需要回溯到父节点。
另一个显著优势是,B+树的叶子节点形成了一个链表结构,这对于范围查询非常有利。因为范围查询要求连续访问数据,B+树的链表结构允许按顺序高效地遍历所有相关数据项。
2.2 B+树在数据库中的作用和优势
2.2.1 数据库索引优化的实践
B+树在数据库索引优化的实践中发挥了巨大作用。B+树的结构使得索引项均匀分布在索引中,避免了在数据插入、删除时产生大量的树重排操作。此外,B+树在处理大量数据和频繁的范围查询时,优势更为明显。
在创建索引时,数据表的列会被定义为索引键,索引键的值决定了数据存储的顺序。B+树索引的实现使得数据库可以快速定位到数据行,大幅度提高查询速度。对经常用于查询和排序操作的列创建B+树索引,可以有效减少查询所需时间。
2.2.2 B+树在SQL查询优化中的应用
在SQL查询优化中,B+树主要用于加速单列和多列的查询操作。由于B+树的叶子节点存储了所有实际数据(或指向实际数据的指针),查询时可以直接访问到数据项,提高了查询效率。
此外,使用B+树索引可以优化连接操作。在多表连接查询中,通过合理利用索引,可以显著降低需要进行实际比较的数据量,减少I/O操作,从而提高整体查询效率。
2.3 B+树在文件系统中的应用
2.3.1 文件系统的基本原理
文件系统的基本原理涉及到如何将数据存储在物理设备上,以及如何组织、检索这些数据。B+树在这里的作用,是为文件系统提供一种快速查找文件的方法。由于B+树具有良好的平衡性,即使在数据量不断变化的情况下,也能保证快速访问任何特定文件。
在文件系统中,每个文件通常由文件名和文件属性(如大小、创建时间、权限等)组成。B+树可以用来构建目录项的索引结构,其中每个索引项包含文件名和指向文件数据的指针。
2.3.2 B+树在文件存储和检索中的应用
在文件存储和检索中,B+树用于文件名的快速查找和定位。由于B+树的所有数据都存储在叶子节点,并且叶子节点之间是有序链接的,因此可以在有序的文件名列表中进行快速的线性查找和遍历。
通过使用B+树,文件系统能快速地对文件进行创建、读取、更新、删除等操作。这些操作的性能提升对于用户体验和系统效率都是至关重要的。B+树的应用,使得文件系统能够处理大量文件而不牺牲性能。
在下一章节中,我们将详细探讨B+树的关键属性和特点,包括它的数据结构特性、性能特点以及优化方法。
3. B+树的关键属性和特点
3.1 B+树的数据结构特性
3.1.1 节点结构和数据分布规律
B+树是一种平衡树,常用于数据库和文件系统的索引管理。它的节点结构设计上使得数据尽可能均匀地分布在整棵树上,以优化树的深度和磁盘I/O操作。B+树的节点可以是内部节点也可以是叶子节点,内部节点不包含实际的数据记录,而是存储指向子节点的指针和键值,而叶子节点包含实际的数据记录和指向下一个叶子节点的指针(仅限于非根节点)。
在内部节点中,每个节点可以包含多个键值和指向子节点的指针。假设一个内部节点有n个指针,则它会有n-1个键值。键值用于在子节点之间划分范围,指针指向其子树的根节点。在叶子节点,键值后通常会跟随一个指针,指向下一个叶子节点形成一个有序链表,这在进行范围查询时尤为有用。
3.1.2 B+树的平衡性质和高度计算
B+树维护平衡的特性是其重要优势。B+树的平衡特性意味着任何两个叶子节点间的高度差不会超过一层,这保证了查询操作的时间复杂度为O(log n)。在B+树中插入和删除节点可能需要树的重新平衡,通常通过分裂或合并节点来完成。
计算B+树的高度,我们可以通过树的最大容量来近似估算。假设一个B+树的阶(即节点的指针数)是m,则该树的高度h大致满足:
m^(h-1) ≤ N ≤ m^h - 1
其中N是树中可以存储的键值对的数量。上述不等式左边表示一个完全满的B+树,而右边表示一个只有顶层一个节点的树。通过解这个不等式,可以估算出B+树的高度。
3.2 B+树的性能特点
3.2.1 磁盘读写效率分析
B+树的性能优势在磁盘读写方面十分明显。由于其设计,使得树的高度相对较低,因此在进行树遍历时,需要读取的磁盘页较少,大大减少了磁盘I/O操作次数。尤其在现代磁盘系统中,读写大量数据时,B+树的表现要优于其他平衡树结构。
在B+树中,所有实际的数据存储在叶子节点上,且叶子节点是通过指针顺序链接的。这样可以有效地利用顺序I/O优势,例如在进行范围查询时,可以快速地进行连续数据块的读取。这种特性是B+树在数据库系统中被广泛应用的原因之一。
3.2.2 B+树的时间复杂度讨论
B+树的时间复杂度是衡量其性能的一个重要指标。最坏情况下的查找、插入和删除操作的时间复杂度都是O(log n)。这里n是B+树中存储的键值对的数量。
- 查找操作:在B+树中查找一个元素首先从根节点开始,根据元素的值判断应向哪个子节点移动,然后移动到下一个节点继续判断,这个过程持续直到找到目标值或到达叶子节点。由于树的高度相对较低,所以查找效率很高。
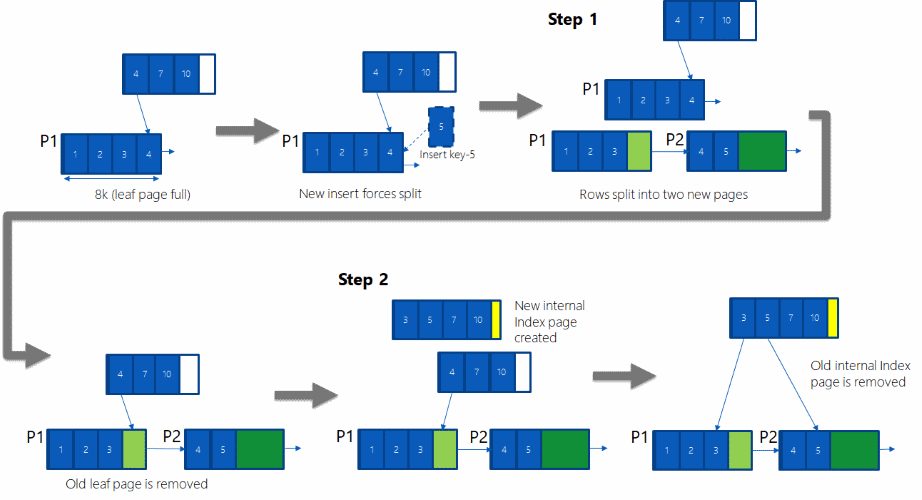
- 插入操作:插入一个元素时,通常是从叶子节点开始,与查找操作类似,但是可能会遇到叶子节点已满的情况,这时需要进行分裂操作,将节点拆分成两个,并更新父节点以适应这种变化。这种分裂操作可能在树中逐层上升,直到根节点。
- 删除操作:删除元素时,如果被删除的是叶子节点的键值,则直接删除即可。但如果导致叶子节点下溢,则可能需要节点之间的合并或借用操作来维持树的平衡性。
3.3 B+树的优化方法
3.3.1 B+树的分裂与合并策略
为了维持B+树的平衡特性,当节点的键值数量达到最大值时,需要进行分裂操作。分裂操作将一个节点分成两个节点,并将中间的键值提升到父节点,这样可以保证B+树的平衡性。具体的分裂策略根据实现的不同可能有所区别,但基本思路是一致的。
- 分裂节点:当一个节点已满时,创建一个新的节点,将原节点中的数据平分到两个新节点,中间的一个键值复制到父节点。
- 调整父节点:如果父节点也因此满而无法接纳新键值,则需要递归地对父节点进行分裂。
- 递归处理:在极端情况下,这种分裂操作可能需要逐层向上进行,直到根节点。
合并节点发生在删除键值后导致某个节点下溢的情况。当一个节点的键值数量小于设定的最小值时,需要采取措施来维持B+树的平衡。合并通常涉及到以下几个步骤:
- 寻找合适邻居:查找一个兄弟节点(通常是右侧的邻居节点),如果有足够的键值可以共享,则将两者合并。
- 调整父节点:合并后,父节点中指向被合并节点的指针需要更新,指向合并后的节点。
- 删除节点:如果无法找到合适的邻居节点进行合并,需要从父节点删除对应的指针和键值,这可能导致父节点也需要合并。
3.3.2 B+树的平衡调整算法
平衡调整是B+树实现中的关键部分,它确保树始终保持良好的性能。在数据的插入和删除过程中,为了维持平衡,B+树采用了一种预定义的分裂和合并策略。这些策略通过一系列的规则和条件判断来保证树的平衡性。
分裂操作保证了节点内部键值的均匀分布,但可能会导致父节点变得不平衡,如果父节点在分裂后也不满足平衡要求,则需要继续分裂,直至根节点。对于合并操作,当删除操作导致一个节点的键值数量少于最小值时,需要从邻居节点中借用或者将邻居节点合并到自身来维持平衡。
一个常见的平衡调整算法是2-3-4树的调整算法的扩展,B+树可以在节点内部存储2到4个键值。在调整过程中,B+树需要考虑如何通过分裂和合并来重新平衡树结构。例如:
- 当一个内部节点的键值数量超过4时,需要分裂。
- 当一个叶子节点的键值数量少于2时,需要合并或借用。
- 当一个节点分裂或合并后,需要更新父节点中与之相关的指针。
下面是一个简单的B+树分裂算法的伪代码示例:
function splitNode(node):
    # 创建两个新节点,新节点1包含原节点的前两个键值,新节点2包含剩余的键值
    node1 = createNode()
    node2 = createNode()
    copy first two keys from node to node1
    copy rest keys from node to node2
    # 如果原节点是内部节点,还需要复制指针
    if node is internal:
        copy first two pointers from node to node1
        copy next two pointers from node to node2
    # 分裂可能需要在父节点中添加一个新的键值和指针
    if node has parent:
        insert node1's max key into parent with a pointer to node1
        insert node2's min key into parent with a pointer to node2
    return node1, node2
请注意,在真实的B+树实现中,会有更详细的逻辑来处理键值、指针、节点之间的关系以及平衡性的维护。以上只是提供一个概念性的理解和描述。在实际应用中,开发者需要考虑更多的边界情况和细节实现。
4. C++实现B+树的基本步骤和结构
4.1 B+树节点的C++表示
4.1.1 节点类的设计与实现
在C++中,实现B+树首先需要定义树的节点。B+树节点分为内部节点和叶子节点,它们都包含一系列的关键字和指向子节点的指针。内部节点的关键字通常用于分割子树,而叶子节点则存储实际的数据项或指向数据的指针。
struct BTreeNode {
    int degree; // 节点的度数,即子节点数或关键字数加一
    int count;  // 节点中关键字的实际数量
    int* keys;  // 关键字数组,用于存储数据或指针
    BTreeNode** children; // 指向子节点的指针数组
    bool leaf;  // 是否为叶子节点

    BTreeNode(int d, bool isLeaf = true) {
        degree = d;
        leaf = isLeaf;
        count = 0;
        keys = new int[2 * degree - 1];
        children = new BTreeNode*[2 * degree];
    }

    ~BTreeNode() {
        delete[] keys;
        delete[] children;
    }
};
在上述代码中,我们定义了 BTreeNode 结构体,包含了节点度数 degree 、关键字计数 count 、关键字数组 keys 和子节点指针数组 children 。构造函数初始化这些属性,并在析构函数中释放分配的内存资源。构造函数还接受一个 isLeaf 参数来决定创建的是内部节点还是叶子节点。
4.1.2 链式结构与指针操作
B+树节点之间需要形成一个层次结构,使用指针将节点串联起来。为了简化实现,通常把所有节点的类型统一定义为一个类,并在类内部区分不同类型的节点。对于叶子节点,我们还需要存储指向兄弟节点的指针以支持高效的顺序遍历。
class BPlusTree {
public:
    BTreeNode* root;
    int t; // B+树的最小度数

    BPlusTree(int minDegree) {
        root = nullptr;
        t = minDegree;
    }

    ~BPlusTree() {
        // 析构函数将递归地释放所有节点
    }

    // ... 其他B+树操作 ...
};
在此基础上,我们可以创建一个B+树类 BPlusTree ,其中包含指向根节点的指针和树的最小度数 t 。该类将封装B+树的构建、插入、删除等操作。递归地释放所有节点的内存是B+树析构函数中的重要任务,以防止内存泄漏。
4.2 B+树的基本操作流程
4.2.1 构建B+树的步骤
构建B+树是一个逐步递增的过程,初始时树为空,随后逐个插入关键字直至树达到平衡状态。在C++中,构建B+树涉及到频繁的节点分裂操作。
void BPlusTree::Insert(int key) {
    if (root == nullptr) {
        root = new BTreeNode(t, true);
        root->keys[0] = key;
        root->count = 1;
        return;
    }
    BTreeNode* node = root;
    BTreeNode* leaf = nullptr;

    while (true) {
        int i = node->count - 1;
        while (i >= 0 && node->keys[i] > key) {
            node->keys[i + 1] = node->keys[i];
            i--;
        }
        node->keys[i + 1] = key;
        node->count++;

        if (node->count < 2 * t - 1) break; // 节点未满,结束插入

        // 节点满,分裂节点
        leaf = Split(node);
        if (node == root) {
            root = new BTreeNode(t, false);
            root->children[0] = node;
            root->children[1] = leaf;
            root->count = 1;
        }

        node = GetParent(node, leaf);
    }
    // ... 其他插入相关代码 ...
}

BTreeNode* BPlusTree::Split(BTreeNode* oldNode) {
    // 实现节点分裂的代码,返回新创建的节点
}

BTreeNode* BPlusTree::GetParent(BTreeNode* oldNode, BTreeNode* newNode) {
    // 实现获取父节点的代码,考虑特殊情况
}
在构建B+树的过程中,首先检查根节点是否为空,如果为空则创建一个新的叶子节点作为根节点。若不为空,则开始在树中搜索插入位置,并在必要时进行节点分裂,以保持树的平衡性。节点分裂逻辑需要特别注意新创建节点的父节点指针的正确设置。
4.2.2 B+树的关键操作方法
除了插入操作外,B+树的关键操作还包括查找和删除。查找操作相对简单,而删除操作则需要处理更复杂的情况,比如节点合并和重新分配关键字。
BTreeNode* BPlusTree::Search(int key) {
    // 实现B+树的查找操作
}

void BPlusTree::Delete(int key) {
    // 实现B+树的删除操作,可能包括节点合并和关键字重新分配
}
这些操作方法需要对树的结构有深入理解,以确保操作的正确性和性能。例如,查找操作应该在达到叶子节点后,从叶子节点的关键字数组中检索出所求的关键字。删除操作中,如果删除导致节点关键字数目少于最小度数,可能需要与兄弟节点进行关键字的重新分配或节点合并。
4.3 C++代码实现B+树
4.3.1 插入操作的实现
B+树插入操作的实现涉及许多细节,包括节点的创建、分裂以及平衡调整。节点分裂是B+树插入中最具挑战性的部分,需要确保分裂后父节点和子节点的关系保持一致。
BTreeNode* BPlusTree::Split(BTreeNode* oldNode) {
    // 创建新节点,节点关键字和子节点指针复制一半
    // 在父节点中添加新节点的关键字和指向新节点的指针
    // 返回新节点
}
节点分裂逻辑应保证分裂后的节点满足B+树的性质。通常,我们将旧节点的关键字和子节点指针平分给新节点,并将新节点的中间关键字提升到父节点中。父节点也可能因分裂而溢出,这时需要递归地进行分裂,直到根节点。
4.3.2 查找与删除操作的实现
查找操作在B+树中通常比较直接,从根节点开始,根据关键字比较结果决定向下移动到哪一个子节点,直到叶子节点为止。
BTreeNode* BPlusTree::Search(int key) {
    BTreeNode* node = root;
    while (!node->leaf) {
        int i = 0;
        while (i < node->count && node->keys[i] <= key) {
            i++;
        }
        node = node->children[i];
    }
    // 在叶子节点中线性查找关键字
    for (int i = 0; i < node->count; i++) {
        if (node->keys[i] == key) {
            return node;
        }
    }
    return nullptr; // 未找到关键字
}
而删除操作比插入更复杂,可能需要处理节点合并的情况。当一个节点的关键字数量少于最小度数时,我们可以从相邻的兄弟节点中重新分配关键字,或者将节点与兄弟节点合并。
void BPlusTree::Delete(int key) {
    // 实现删除操作,包括节点合并和关键字重新分配
}
由于涉及到树结构调整,删除操作的实现通常较为复杂。需要遍历树直到找到包含目标关键字的叶子节点,然后从该叶子节点中删除关键字。之后,可能需要递归地调整树结构,以保持树的平衡性。
通过上述内容,我们对B+树的节点表示、操作流程和C++代码实现有了一个全面的理解。在后续章节中,我们将详细探讨B+树的内存管理、调试与可视化等其他方面。
5. B+树的插入、遍历、删除操作
5.1 B+树插入操作详解
在介绍B+树插入操作之前,需要了解B+树的结构特点,即它是多路平衡查找树,所有实际数据都存储在叶子节点上,并且叶子节点之间通过指针连接形成一个有序链表。B+树维护了关键字的有序性和树的平衡性,以优化数据查找效率。
5.1.1 插入过程的详细步骤
在实际的插入操作中,通常需要遵循以下步骤:
- 从根节点开始,根据要插入关键字的值,找到对应的叶子节点。查找过程类似于二叉查找树,只不过是在B+树的多路节点中进行。
- 检查该叶子节点是否还有空间(即,是否达到了该节点的最大关键字容量)。如果是,则执行分裂操作,将节点一分为二,并更新父节点。
- 插入新的关键字到叶子节点中,并保持叶子节点内关键字的有序性。
- 若是因为插入导致叶子节点关键字数量超过上限,则更新父节点中的指向这个叶子节点的指针,可能会牵涉到父节点的分裂。
- 重复上述步骤,直到树的根节点。
5.1.2 插入操作的边界条件处理
在进行插入操作时,还需特别注意以下边界条件的处理:
- 如果在查找插入位置的过程中发现某个节点已经满了(即关键字数量达到了最大值),那么需要对这个节点执行分裂操作,如果该节点是根节点,意味着需要创建新的根节点,从而增加树的高度。
- 在执行分裂操作时,除了将节点一分为二之外,还需要更新分裂产生的新节点在父节点中的指针信息。
- 在更新父节点时,如果父节点也是满的,还需要对父节点进行分裂,这个过程可能需要递归上溯至根节点,直至找到一个非满的父节点或者创建新的根节点。
- 分裂操作需要保证树的平衡性不被破坏,即使树的所有节点都尽可能地满,也要保持树高尽可能低。
在C++实现B+树的插入操作中,通常需要定义一个递归函数来处理这些逻辑。下面是一个简化了的插入操作的伪代码示例:
void BPlusTree::insert(const KeyType& key) {
    if (root == nullptr) {
        // 树为空,创建新的根节点
        root = new LeafNode();
    } else {
        // 找到插入位置的叶子节点
        LeafNode* leaf = findLeaf(key);
        // 执行插入并递归分裂,直到树的平衡恢复
        splitAndInsert(leaf, key);
    }
}

void BPlusTree::splitAndInsert(LeafNode* leaf, const KeyType& key) {
    // ...
    // 插入关键字
    // 如果叶子节点已满,则进行分裂,创建新的节点,更新父节点指向
    // ...
}
5.1.3 插入操作的代码逻辑分析
在实际代码实现中,插入逻辑涉及递归和节点分裂等复杂操作,需要仔细分析每一步的目的和效果。例如,在节点分裂时,需要新创建一个节点,然后将原节点的一部分数据移动到新节点,并在父节点中添加一个指向新节点的指针。需要注意的是,在插入过程中,任何节点分裂都必须保证父节点及时更新,以维护树的有序性和平衡性。
5.2 B+树的遍历方法
5.2.1 顺序遍历与中序遍历实现
B+树的遍历方法通常指的是顺序遍历,因为所有实际数据都存储在叶子节点上,而且叶子节点之间通过指针连接,形成一个有序链表。这样,B+树就可以像链表一样进行顺序遍历。
顺序遍历的实现非常直接,只需从第一个叶子节点开始,沿着叶子节点之间的指针遍历即可,代码实现也比较简单:
void BPlusTree::sequentialTraverse() {
    LeafNode* current = firstLeaf();
    while (current != nullptr) {
        for (int i = 0; i < current->size(); ++i) {
            std::cout << current->getKey(i) << " ";
        }
        current = current->next();
    }
}
5.2.2 遍历操作的效率分析
遍历操作的效率分析主要是时间复杂度的考量。在B+树中,由于所有的数据都存储在叶子节点,并且叶子节点通过指针连接,顺序遍历B+树只需要O(n)的时间复杂度,其中n是B+树中元素的数量。这是因为顺序遍历不需要回溯或者递归操作,只按顺序访问每个节点中的数据,直到遍历完所有叶子节点。
5.2.3 代码逻辑分析
在遍历操作中,关键在于正确地从一个叶子节点移动到下一个叶子节点。代码中的 firstLeaf() 方法用于获取树的第一个叶子节点, current->next() 用于获取当前叶子节点的下一个叶子节点,这两个方法是实现顺序遍历的核心。
5.3 B+树删除操作的实现
5.3.1 删除算法的基本原理
B+树的删除操作相对比较复杂,因为它不仅需要找到要删除的关键字,还需要处理因为删除导致的节点不满足最小关键字数要求的情况。
删除操作的基本原理如下:
- 查找并删除指定的关键字,这可能发生在非叶子节点或叶子节点。
- 如果删除的是叶子节点中的关键字,需要检查该叶子节点的关键字数量是否低于最小值。如果是,则需要从相邻兄弟节点中借关键字,或者合并节点。
- 如果删除的是非叶子节点中的关键字,也需要保证该节点的关键字数量不小于最小值。同时需要递归地调整树结构,可能涉及到节点的合并或分裂。
- 在调整树结构的过程中,需要保证树的平衡性和有序性不受影响。
5.3.2 删除操作的特殊情况处理
在删除操作过程中,有几种特殊情况需要特别处理:
- 当一个非叶子节点的关键字被删除后,如果导致其关键字数量少于最小值,则需要从其相邻兄弟节点中借用关键字,或者与兄弟节点合并。
- 当叶子节点的关键字被删除后,如果导致其关键字数量少于最小值,且没有相邻兄弟节点可以借关键字,那么需要和兄弟节点进行合并。
- 在合并节点的过程中,如果父节点因为合并而变得不满足最小关键字数的要求,那么需要递归地向上合并,直到根节点。
删除操作的代码实现通常涉及递归调用和大量的边界条件判断。下面是一个简化的B+树删除操作的伪代码示例:
void BPlusTree::deleteKey(const KeyType& key) {
    if (root == nullptr) {
        return; // 树为空,无需删除
    }
    LeafNode* leaf = findLeaf(key); // 查找到含有该关键字的叶子节点
    if (leaf == nullptr) {
        return; // 没有找到,无需删除
    }
    deleteKeyFromLeaf(leaf, key); // 删除叶子节点中的关键字
    // 检查并处理因为删除导致的节点不平衡
    rebalanceTree(leaf);
}

void BPlusTree::deleteKeyFromLeaf(LeafNode* leaf, const KeyType& key) {
    // ...
    // 执行删除操作,处理节点不平衡情况
    // ...
}

void BPlusTree::rebalanceTree(LeafNode* leaf) {
    // ...
    // 递归地调整树结构,处理节点合并或分裂
    // ...
}
5.3.3 代码逻辑分析
在删除操作的代码实现中,需要特别注意从叶子节点到根节点的每一层节点的平衡性调整。 deleteKeyFromLeaf 方法负责删除指定的叶子节点中的关键字,并处理可能因为删除而导致的不平衡情况。 rebalanceTree 方法则负责递归地调整树结构,以恢复树的平衡性。
在处理节点合并或分裂的过程中,需要保证父节点中的指针正确更新,并且需要处理树高度减少的情况,比如当根节点成为叶子节点且关键字数量低于最小值时,需要将根节点删除,并直接让其子节点成为新的根节点,从而降低树的高度。
5.3.4 删除操作的代码逻辑分析
删除操作是B+树中最复杂的操作之一,涉及到许多特殊情况的处理。因此,在实现删除操作时,代码逻辑必须包含对所有可能情况的充分考虑,并提供适当解决方案。
总体来说,B+树的插入、遍历和删除操作是其核心操作,也是数据结构设计的精华所在。理解并实现这些操作,需要对B+树的结构特点及其平衡性质有深刻的理解,以及对算法和数据结构的熟练运用。在实际的应用中,这些操作将直接影响到数据检索的效率,以及数据更新的性能。
6. 内存管理与动态内存分配
6.1 C++内存管理机制
在计算机系统中,内存管理是至关重要的一个环节。它涉及到如何有效地使用有限的内存资源,使得程序运行时能够高效地分配和回收内存。C++作为一门高级语言,提供了丰富的内存管理机制来帮助程序员更好地控制内存的使用。
6.1.1 内存分配与回收原理
在C++中,内存分配主要是通过 new 和 delete 操作符来完成的。当使用 new 关键字申请内存时,系统会在堆(heap)上找到一块足够大的内存区域来满足需求,并返回该内存区域的指针。相反地, delete 操作符用于释放通过 new 申请的内存,其作用是将内存返回给操作系统,以便重新分配给其他程序或变量。
6.1.2 C++中的动态内存分配技术
除了 new 和 delete 外,C++还提供了 malloc 和 free 这两个C语言风格的内存分配和释放函数,它们允许更底层的内存操作。在C++中,更推荐使用 new 和 delete ,因为它们能够执行构造函数和析构函数,同时能够进行类型安全检查。
动态内存分配对于创建复杂的数据结构(如B+树)是必不可少的,因为它允许数据结构的大小在运行时动态变化。
6.2 动态内存分配在B+树中的应用
在实现B+树这样的数据结构时,动态内存分配扮演了重要的角色。在构建树节点时,我们需要根据实际的数据数量动态地申请和释放内存。
6.2.1 节点内存的动态分配
在构建B+树的过程中,每个节点可能存储不同数量的数据项,因此每个节点的内存大小可能不同。使用动态内存分配,可以在创建节点时根据需要分配合适的内存大小,并在节点不再使用时释放其内存。
6.2.2 动态内存分配对性能的影响
虽然动态内存分配提供了灵活性,但其使用不当也可能导致性能下降。例如,频繁的分配和释放内存可能导致内存碎片化,降低内存使用效率。为了减轻这种影响,可以采取预先分配内存和复用节点的策略。
6.3 内存泄漏的预防与诊断
内存泄漏是C++程序中常见的问题之一,指的是程序中分配的内存没有被正确地释放,导致内存资源逐渐耗尽。
6.3.1 内存泄漏的原因和危害
内存泄漏的原因通常包括:指针丢失、指针悬挂、未匹配的内存分配和释放等。如果不及时处理,内存泄漏可能导致程序变慢,甚至造成程序崩溃。
6.3.2 C++中内存泄漏的检测工具和方法
为了诊断和预防内存泄漏,C++开发者通常使用各种工具和方法,如Valgrind、AddressSanitizer等。这些工具能够在程序运行时监控内存分配和释放的行为,帮助开发者发现潜在的内存泄漏问题。
在实现B+树等复杂数据结构时,合理的内存管理策略和有效的内存泄漏检测手段是保证程序稳定性和性能的关键。通过良好的编程习惯和使用辅助工具,可以显著减少内存管理错误,提高程序质量。
简介:在计算机科学中,数据结构和算法是提高编程效率的基础。B+树作为自平衡查找树,在数据库和文件系统中广泛应用。本话题集中于在C++中实现B+树,强调其优化磁盘访问效率的设计特点,如高分支因子、非叶节点不存储数据、叶子节点链接以及平衡性。实现过程包括定义节点结构、内存初始化、插入、遍历、删除等关键步骤,并涉及内存管理、动态内存分配和可视化调试。掌握B+树的实现有助于理解数据库查询优化,提升程序员在数据结构和算法方面的技能。
更多推荐



 23
 0
- 0


 已为社区贡献8条内容

所有评论(0)