
java八股文全集
目录
Arraylist list = new ArrayLit(10)中的list扩容几次:
Array.asList转List后,如果修改了数组内容,list受影响吗
为应对面试,特此开始总结java八股文,此篇长期更新,目标在九月之前刷完黑马八股文
redis篇:
缓存穿透:
缓存穿透是指有人恶意攻击数据库,大量访问不存在的数据,数据库查询不到数据也不会直接写入缓存,就会导致每次都查数据库。
有两种实现方案:
第一种的话是在缓存中缓存空数据,这样当访问打过来的时候可以直接返回null,就不用再走数据库
第二种的话是在缓存之前添加一个布隆过滤器,布隆过滤器主要是判断一个元素在不在集合当中,当时用的是redisson实现的布隆过滤器,他是首先会初始化一个大数组,将数组都置为0,然后将缓存的数据根据3次哈希值的计算,对数组取模然后找到数组的下标,将数组的0变为1,然后你要查询的话就可以根据三次哈希值计算计算出数组的下标然后查找出存不存在这个元素,但是也是有缺点的,就是会有误判率,但是一般我们的误判率不会超过百分之一,这样项目也能承受这种并发
缓存击穿:
给一个热点key设置了过期时间,当key过期时刚好有大量并发请求过来,这样的请求就会压垮数据库
有两种解决方案:
第一种就是分布式锁,当一个线程进来之后会获取这个分布式锁,获取到锁之后在数据库重建缓存数据,然后写入缓存,最后释放锁,然后这时候如果有别的请求进来的话首先会获取锁,但是由于另一个线程已经获取到锁了,这个线程就会获取锁失败。然后这个线程会一直尝试获取锁,当缓存写入完成并且释放锁之后,这个线程才会命中数据
第二种的话是逻辑过期,就是给数据维护一个过期时间的字段,然后线程进来会判断这个字段是不是会过期,如果过期的话会获取一个分布式锁,然后在本线程新开一个线程并且在本线程直接返回旧数据,让新线程重建缓存数据然后同步到缓存,然后释放锁,在这个线程获取锁到释放锁之前别的线程会直接返回旧数据,等到缓存重建完成并且释放锁后会返回新数据
分布式锁的解决方案一致性比较强,逻辑过期解决方案对性能要求高
缓存雪崩:
缓存雪崩是同一时间大量key过期或者Redis服务宕机,导致大量请求压垮数据库
有四种解决方案:
第一种是给不同的key设置不同的过期时间
第二种是降级限流策略
第三种是给Redis设置集群模式,哨兵模式
第四种是给业务添加多级缓存
缓存三兄弟可以都可以用限流作为保底策略
缓存一致性:
当修改了数据库的数据同时也要更新缓存的数据,缓存和数据库的数据要保持一致
读数据:缓存命中直接返回,缓存没有命中查询数据库,如果有查询数据库并写入缓存
无论是先修改数据库还是先删除缓存都会让数据库,有脏数据的风险
所以有三种解决放案
第一种是分布式锁,在读的时候添加共享锁(readlock),加锁之后其他线程可以共享读操作,但是不允许写操作,然后在写数据的时候添加排他锁(writelock),会阻塞其他线程读写操作
第二种是通过mq当写入数据库数据的时候通过mq在两个服务之间去发布消息然后监听消息去更新缓存(需要保证mq的可靠性),对于业务代码有侵入
第三种是通过阿里的Canal进行异步通知,是通过mysql的主从同步来实现的,canal可以监听mysql的binlog日志,当数据库写入数据的时候canal可以通知数据变更情况然后更新缓存,这种对业务代码零侵入
以上是redis和mysql的数据进行同步的方案,强一致性的的方案就是加共享锁(读的时候禁止写)和排他锁(写的时候禁止读和写),异步的方式就是通过mq去监听数据库然后推送消息更新缓存,但是这种对业务代码有侵入,还有一种是通过canal的方式进行监听mysql的binlog(二进制日志),然后通知数据变更情况更新缓存
Redis持久化:
在Redis中提供了两种数据持久化的方式:1.RDB 2.AOF
RDB也被叫做Redis数据备份文件。简单来说就是把内存中的所有数据都记录到磁盘中。当Redis实例故障重启后,从磁盘读取快照文件,恢复数据。
有两个命令是手动执行RDB的:
save命令:由Redis主进程来执行RDB,会阻塞所有命令
bgsave命令:开启子进程执行RDB,避免主进程受到影响
Redis内部也有触发RDB的机制,可以在redis.conf文件中找到,格式如下:
//900秒内,如果至少有一个key被修改,则执行bgsave
save 900 1
RDB的执行原理:
bgsave开始会fork(复制主进程的内存空间和执行状态)主进程得到子进程,把页表也copy给了子进程,完成fork后读取内存数据并且写入RDB文件,然后子进程根据copy的页表就在磁盘中写新的RDB文件替换旧的RDB文件
页表:记录虚拟地址和物理地址的映射关系
主进程操作页表,根据页表的映射关系操作真正的物理内存
当主进程修改数据的同时子进程在读写就会产生冲突:
解决方案就是fork采用的是copy-on-write技术:
当主进程执行读操作的时候,访问共享内存,但是当主进程写操作的时候就会拷贝一份数据,执行写操作
AOF:
Redis处理的每一个写命令都会记录在AOF文件,可以看作是命令日志文件,AOF默认是关闭的,也是修改redis.conf配置文件来开启AOF,AOF的命令记录的频率也可以配置,也叫做刷盘策略,由于AOF是记录命令,文件比RDB大得多,通过bgrewritaof命令,可以让AOF执行自动去重,只记录最后一次命令。
刷盘策略:
appendfsync always 同步刷盘几乎不丢数据性能影响大
appendfsync everysec 每秒刷盘最多丢失1秒数据性能适中
appendfsync 操作系统控制 性能最好但是可能会丢失大量数据
总结:RDB是二进制文件,在保存的时候数据体积小,宕机恢复快,但是可能会丢数据(redis宕机),在项目中一般用AOF,虽然慢一点但是丢数据的风险小得多,设置合理的刷盘策略即可,RDB系统资源占用高,大量cpu内存消耗,AOF主要是磁盘io资源,系统资源占用低,但是重写的时候占大量cpu和内存资源
Redis数据删除策略:
Redis对数据设置了数据的有效时间,数据过期后,就需要将数据从内存中删除,按照不同的规则删除,这种删除规则就被称为数据的删除策略(数据过期策略)
惰性删除:
设置key过期时间后,只有使用到key的时候才会过期检查,对内存不友好,如果一个key已经过期,但是一直没有使用,那么该key就会一直在内存中。
定期检查:
每隔一段时间就对一些key检查,从一定数量的数据库中取出一定数量的随机key进行检查,并删除其中的过期key
定期清理有两种模式:
SLOW模式是定时任务,执行频率默认为10hz,每次不超过25ms,可以在redis.conf配置
FAST模式执行频率不固定,但是每次间隔不超过2ms,每次耗时不超过1ms
Redis的过期删除策略:惰性删除+定期删除两种策略进行配合使用
Redis的数据淘汰策略:
当Redis的内存不够时,此时再向Redis中添加新的key,那么Redis就会按照某一种规则将内存的数据删除掉,这种删除规则就是内存的淘汰策略
Redis支持8种不同策略:
noeviction(默认):不淘汰任何key,但是内存满了不允许写入数据如果再写会报错
volatile-ttl:对于设置了TTL的key,比较key的剩余TTL值,TTL越小越先被淘汰
allkeys-random:对全体key,随机进行淘汰
volatile-random:对设置了TTL的key,随机进行淘汰
allkeys-lru:对全体key,基于lru算法(最近最少使用)进行淘汰
volatile-lru:对于设置了TTL的key,基于lru算法进行淘汰
allkey-lfu:对全体key,基于LFU(频率最少使用)算法进行淘汰
volatile-lfu:对设置了TTL,基于lfu算法进行淘汰
1.优先使用allkeys-lru.把最近长访问的数据留在缓存中,如果业务有明显的冷热数据区分,建议使用
2.如果业务中数据访问频率差别不大,没有明显冷热数据区分,建议使用allkey-random,随机选择淘汰
3.如果业务有置顶的需求,可以选择volatile-lru策略,同时置顶数据不过期时间,这些数据就一直不被删除,删除有过期时间的数据
4.如果业务中有短时高频访问的数据,可以使用allkeys-lfu或者volatile-lfu策略
问题:数据库中1000万条数据,Redis只能存储20w数据,如何保证Redis中的数据都是热点数据?
使用allkeys-lru(挑选最近最少未使用的数据淘汰)淘汰策略,留下的都是经常访问的热点数据
Redis分布式锁:
Lua为什么保证原子性:redis是单线程的并且把Lua脚本当作一个执行单元
Redis实现分布式锁的底层是基于setnx和Lua脚本(保证原子性)实现的,redisson进行了封装,提供了一个WatchDog(看门狗),一个线程获取锁成功之后,WatchDog会给持有锁的线程续期(默认10秒一次)
Redisson的锁可以重入,多个锁重入需要判断是否为当前线程,在redis中存储的时候使用的hash结构,用来保存线程信息和重入的次数
Redisson不能解决主从数据一致(redis主节点获取锁后宕机,看门狗也挂了,但是数据没有同步过来,导致新节点也获取了锁)的问题,但是可以使用redisson的红锁来解决,但是这样性能很低,如果非要保证数据的一致性,建议采用zookeeper实现的分布式锁
Redis主从集群:
单节点Redis的并发能力是有上限的,要进一步提高Redis的并发能力,就需要搭建主从集群,实现读写分离,一般都是一主多从,主节点负责写数据,从节点负责读数据
主从同步流程:
1.从节点请求主节点同步数据
2.主节点判断是否第一次请求,是第一次就与从节点同步版本信息
3.主节点执行bgsave,生成rdb文件,发送给从节点去执行
4.在rdb生成执行期间,主节点会记录命令记录到日志文件
5.把生成后的命令日志文件发送给从节点进行同步
增量同步:
1.从节点请求主节点同步数据,主节点判断不是第一次请求,获取从节点的offset
2.主节点从命令日志中获取offset值后的数据,发给从节点进行增量同步
哨兵模式:
Redis提高了哨兵机制来实现主从集群的自动故障恢复。
哨兵的结构和作用:
监控:哨兵会不断检查master和slave是否按预期工作
自动故障恢复:如果master故障,Sentinel会将一个slave提升为master。当故障恢复后也以新的master为主
通知:哨兵充当Redis客户端的服务发现来源,当集群发生故障转移时,会将最新信息推送给Redis 的客户端
哨兵基于心跳机制每秒向集群的每个实例发送ping命令
主观下线:如果某哨兵发现某个实例未在规定时间响应,则认为实例主观下线
客观下线:若超过指定数量(quorum)的哨兵都认为该实例主观下线,则认为该实例客观下线。quorum的值最好超过Sentineil实例数量的一半
哨兵选主规则:
1.首先判断主从断开时间长短,如果超过指定时间就排除节点
2.如何可以配置优先级(slave-priority),越小优先级越高
3.如果s优先级一样,判断节点的offset,越大优先级越高
4.最后判断slave节点id大小,越小节点优先级越高
保证redis的高并发高可用:
哨兵模式实现集群的自动故障恢复(监控,自动故障恢复,通知)
redis集群脑裂:
集群脑裂是主节点和从节点和哨兵处于不同的网络分区,使得集群没有能够心跳感知到主节点,所以选举了新节点,这样产生了两个master,就像大脑分裂了一样,这样就会导致客户端还在老节点那里写入数据,新节点无法同步数据,当网络故障恢复后,哨兵就会把老的主节点降为从节点,这时候再从新主节点同步数据就会数据丢失
解决方案:可以修改redis的配置,可以设置最少的从节点数量以及缩短主从数据同步的延迟时间,达不到要求就拒绝请求,就避免了大量的数据丢失
分片集群:
主从和哨兵可以解决高可用,高并发读的问题,但是海量数据存储和高并发写的问题没有解决
使用分片集群可以解决,分片集群特征:
1.集群中有多个master,每个master保存不同数据
2.每个master都可以有多个slave节点
3.master之间通过ping来检测彼此的健康状态
4.客户端请求可以访问集群任意节点,最终都会被转发到正确节点
Redis分片集群引入了哈希槽的概念,Redis集群中一共有16384个哈希槽,每个key通过CRC16校验后对16384取模来决定放置在哪个槽,集群的每一个节点负责一部分hash槽
Redis为什么快:
1.Redis是纯内存操作,执行速度非常快
2.采用单线程,避免不必要的上下文切换可竞争条件,多线程还要考虑线程安全的问题
3.使用I/O多路复用模型,非阻塞IO
I/O多路复用模型:
I/O多路复用是利用单个线程同时监听多个socket,并且在某个socket可读,可写时通知,,从而避免无效的等待,充分利用cpu资源。目前的I/O多路复用都是采用的epoll模式实现,它会通知用户进程socket就绪的同时,把已就绪的socket写入用户空间,不需要遍历socket来判断是否就绪
Redis的网络模型就是使用I/O多路复用结合事件的处理器来应对多个socket请求,比如提供了应答处理器,命令回复处理器,命令请求处理器
为了提升更好的性能,在命令回复处理器使用了多线程来处理回复事件,在命令请求处理器中,将命令的转换使用了多线程,增加命令转换速度,但是当命令执行的时候还是单线程
用户空间和内核空间:
Linux系统中一个进程使用的内存情况分两部分:内核空间和用户空间
用户空间只能执行受限的命令,不能直接调用系统资源,必须通过内核提供的接口来访问
内核空间可以执行特权命令,调用一切系统资源
Linux系统为了提高IO效率,会在用户空间和内核空间都加入缓冲区
写数据时,要把用户缓冲数据拷贝到内核缓冲区,然后写入设备
读数据时,要把设备读取数据到内核缓冲区,然后拷贝到用户缓冲区
MySQL篇:
如何定位慢查询:
方案一:开源工具
调试工具:Arthas
运维工具:Prometheus,Skywalking
方案二:MySQL自带慢查询日志,设置超时事件,如果一条sql执行超过两秒就会被记录到日志中(调试阶段才用)
一个SQL语句执行很慢,如何分析:
可以通过explain或者DESC命令获取MySQL如何执行语句的信息
tpye字段有八种扫描模式,可以看type看看是否有优化空间
possible_key 当前可能会命中的索引
key 当前sql实际命中的索引
key_len 索引占用的大小
Extra 额外的优化建议
索引:
Mysql的InnoDB引擎采用的b+树的数据结构来存储索引
阶数更多,路径更短
磁盘读写代价b+树更低,非叶子节点只存储指针,叶子节点存储数据
b+树便于扫库和区间查询,叶子节点是一个双向链表
聚簇索引和非聚簇索引:
聚簇索引选举规则:
1.如果存在主键,主键索引就是聚簇索引
2.如果不存在主键,将使用第一个唯一索引作为聚簇索引
3.如果表没有主键或者没有合适的唯一索引,InnoDB会自动生成一个作为隐藏的聚簇索引
聚簇索引:数据和索引放在一起,b+树的叶子节点保存了整行数据,有且只有一个
非聚簇索引:数据和索引分开存储,b+树的叶子节点保存对应的主键,可以有多个
回表查询:
通过二级索引找到对应的主键值,到聚簇索引中找到对应的数据
覆盖索引:
覆盖索引就是查询使用了索引,并且查询字段都是聚簇索引,
MySQL超大分页处理:
比如有一个语句:
select *from tb limit 9000000,10;
因为进行分页查询的时候,如果执行这条语句,会排序前9000010的数据,但是只返回两个,其他数据丢弃就会让排序的代价非常大
优化思路:一般分页查询时,通过创建覆盖索引能够提升性能,可以通过覆盖索引+子查询的方式
select * from tb,(select id from tb order by id limit 9000000,10)a where tb.id =a.id;
索引创建的原则:
1.数据量较大,且查询比较频繁的表
2.常作为查询条件,排序,分组的字段
3.尽量使用联合索引
4.要控制索引的数量
5.前缀索引
索引失效的场景:
1.违反最左前缀法则(比如说你建立了一个联合索引name,age。你的条件必须先走name,不然会失效)
2.范围查询之后右边的索引不能命中
3.在索引列上进行运算操作
4.字符串不加引号
5.以%开头的Like模糊查询
sql优化:
一.表的设计优化
1.设置合适的数值(tinyint int bigint)
2.比如设置合适的字符串类型(char和varchar)char定长效率高,varchar可变长度,效率低
二.sql语句优化
1.避免使用select *,因为会导致回表查询
2.sql语句避免造成索引失效的写法
3.尽量使用union all代替union union会多进行一次过滤,效率低
4.避免在where子句中对字段进行表达式操作(防止索引失效)
5.join优化能用内连接就不用左右连接,如果必须使用一定要小表驱动大表,内连接会对两个表优化,优先把小表放到外边,把小表放到里面,但是左连接和右连接不会重新调整顺序
三.主从复制,读写分离
如果数据库的使用场景是读的操作比较多,为了避免写的操作所造成的性能影响,可以采用主从节点然后读写分离
sql优化答案:
1.设置合适的字段
2.尽量使用覆盖索引,避免使用select *
3.避免索引失效的情况
4.建立索引
5.主从复制,读写分离,也就是分片集群
6.分库分表
7.左连接和右连接要小表驱动大表
事务的特性:
事务是一组操作的集合,它是一个不可分割的工作单位,事务会把所有的操作作为一个整体一起向系统提交或撤销操作,即这些操作要么同时成功,要么同时失败
Atomicity:原子性,事务是不可分割的最小操作单元,要么同时成功要么同时失败
Consistency:一致性,事务完成时,必须使所有的数据保持一致性质
Isolation:隔离性,数据库系统提交的隔离机制,保证事务在不受外部并发操作影响的独立环境下运行
Durability:持久性,事务一旦提交或回滚,它对数据库中的数据改变就是永久的
并发事务问题:
1.脏读:一个事务读到另一个事务还没有提交的数据
2.不可重复读:一个事务先后读取同一条记录,但是两次读取的数据不同,称之为不可重复读
3.幻读:一个事务按照条件查询数据时,没有对应的数据,但是在插入的时候又发现这行数据已经存在,好像出现了幻影
脏读 不可重复读 幻读
Read uncommitted(Ru) 未提交读 什么都不能解决
Read committed(Rc) 读已提交 第一个可以解决
Repeatable Read(默认) 可重复读 前两个可以解决
Serializble 串行化 都可以解决
MySQL默认隔离级别是RR(可重复读)
数据隔离性级别越高,数据越安全,但是性能越低
undo log和redo logo的区别:
缓冲池(buffer pool):主内存的一个区域,里面可以缓存磁盘上经常操作的真实数据,在执行crud的时候,先操作缓冲池中的数据(如果缓冲池没有数据,先从磁盘加载并缓存),以一定的频率刷新到磁盘,从而减少磁盘IO,加快处理速度
数据页(page):是InnoDB引擎磁盘管理的最小单元,每个页的大小默认为16kb,页存储的是行数据
redo log:
重做日志,记录的是事务提交时数据页的物理修改,是用来实现事务的持久性。
该日志文件由两部分组成:重做日志缓冲(redo log buffer)以及重做日志文件(redo log file).前者是在内存中,后者是在磁盘中。当事务提交之后会把所有修改信息都存在该日志文件中。用于刷新脏页到磁盘时,进行数据恢复
undo log:
回滚日志:用于记录数据被修改前的信息,作用包括两个:提供回滚和MVCC(多版本并发控制)。undo log和redo log记录物理日志不一样。它是逻辑日志
当delete一条记录时,undo log中就会记录一条对应的insert记录,当执行rollback时,就可以读取到内容回滚
undo log可以实现事务的一致性和原子性
事务的隔离性如何保证:
1.排他锁(比如一个事务获取了一个数据行的排他锁),其他事务就不能再获取该行的其他锁
2.MVCC
解释一下MVCC:
多版本并发控制。指维护一个数据的多个版本。使得读写之间没有冲突
MVCC的具体体现。主要依赖于数据库记录的隐式字段,undo log日志,readView
记录的隐藏字段:
DB_TRX_ID:最近修改事务ID
DB_ ROLL_PTR:回滚指针,指向这条记录的上一个版本,用于配合undo log,指向上一个版本
DB_ROW_ID:隐藏主键,如果表结构没有指定主键,将会生成这个隐式字段
undo log:
回滚日志,在除了查的时候会产生便于数据回滚的日志
当insert的时候,产生的undo log日志只在回滚的时候需要,在事务提交后,可被立即删除
而update,delete的时候,产生的undo log日志不仅在回滚时需要,mvcc版本访问也需要,不会被立即删除
不同事务或者相同事务对同一条记录进行修改,会导致该记录的undolog生成一条记录版本链,链表的头部是新纪录,链表尾部是旧纪录
readview(读视图):
readView(读视图):是快照读SQL执行时MVCC提取数据的依据,记录并维护系统当前活跃的事务(未提交的)id
当前读:
记录的是记录的最新版本,读取时还要保证其他并发事务不能修改当前记录,会对读取的记录进行加锁,对于我们平时的操作比如:select ...lock in share mode(共享锁),select ...for update,update,insert,detele(排他锁)都是一种当前读
快照读:
简单的select(不加锁)就是快照读,快照读读取的是记录数据的可见版本,有可能是历史数据,不加锁,非阻塞读
Read Committed:每次select,都生成一个快照读
Repeatable Read:开启事务后第一个select语句才是快照读的地方
ReadView中包含了四个核心字段:
m_ids:当前活跃的事务id结合
min_trx_id:最小活跃事务id
max_trx_id:预分配事务id,当前最大事务id+1(因为事务id是自增的)
creator_trx_id:ReadView创建者的事务id
总结:readView解决的是一个事务查询选择版本的问题
根据readView的匹配规则和当前的一些事务id判断应该访问哪个版本的数据
不同隔离级别快照读是不一样的,最终访问的结果不一样
RC:每一次执行快照读时生成ReadView
RR:仅在事务第一次执行快照读的时候生成ReadView,后续复用
MySQL主从同步原理:
Mysql主从复制的核心就是二进制文件(binlog)
1.主库在事务提交时,会把数据变更记录在二进制文件binlog中
2.从库读取主库的二进制文件binlog中,写入从库的中继日志Relay log
3.从库重做中继日志的事件,将改变反映它自己的数据
分库分表:
分库分表的时机:
1.前提是项目业务数据量大
2.优化已经解决不了性能问题(读写分离,索引。。。)
3.IO瓶颈,cpu瓶颈
分库分表后的问题可以用MyCat解决
具体拆分策略:
1.水平分库,将一个库的数据拆分到多个库中,解决海量数据存储和高并发的问题,路由规则是根据id取模
2.水平分表,解决单张表存储和性能的问题,
3.垂直分库,根据业务进行拆分,高并发下提高磁盘IO和网络连接数(比如订单模块和用户模块)
4.垂直分表,冷热数据分离,多表互不影响(把不常用的字段单独放一张表)
框架篇:
Spring框架中的单例bean是否安全:
不是线程安全的。
单例bean:容器中唯一实例,默认在容器启动时就会创建实例,可以通过@lazy来懒加载到第一次调用创建
多例bean:每次请求时创建不同实例
Spring框架中有一个@Scope注解,默认的就是singleton,单例的
因为一般在spring的bean中的注入无状态的对象,没有安全问题,都是如果bean中定义了可修改的成员变量,也就是有状态的bean了,那么是需要考虑线程安全问题的,可以通过多例或者加锁来解决
AOP相关面试题:
面向切面编程,用于那些和业务相关,但是对多个对象产生影响的公共行为和逻辑,抽取公共逻辑复用,降低耦合。
AOP可以用来记录操作日志,缓存,spring实现的事务
核心是:使用aop中的环绕通知+切点表达式(找到要记录日志的方法),通过环绕通知的参数获取请求方法的参数(类,方法,注解,请求方式等),获取到这些参数后,保存到数据库
Spring中的事务是通过AOP功能,对方法前后进行拦截,在执行方法之前开启事务,执行完目标方法之后根据执行情况提交或者回滚事务
Spring中事务失效的场景:
1.异常捕获处理,自己处理了异常,没有抛出,自己进行了try-catch解决:手动抛出,在catch块添加throw new RuntimeException(e)
2.抛出检查异常:配置rollbackFor配置为Exception,@Transactional默认只对RuntimeException和Error类型的异常回滚。检查异常有IOException,sqlException
3.非public方法导致的事务失效,改为public
Spring的bean的生命周期:
1.通过BeanDefinition获取bean的定义信息
2.通过构造函数实例化bean
3.bean的依赖注入
4.处理Aware接口
5.Bean的后置处理器BeanPostProcessor-前置
6.初始化方法
7.Bean的后置处理器BeanPostProcessor-后置
8.销毁bean
Spring的循环引用:
循环依赖:循环依赖其实就是循环引用,也就是两个或者两个以上的bean互相持有对方,最终形成闭环,比如A依赖于B,B依赖于A
循环依赖在spring中允许存在,spring框架依据三级缓存已经解决了大部分的循环依赖
1.一级缓存:单例池,缓存已经经历了完整的生命周期,已经初始化完成的bean对象
2.二级缓存:缓存早期的bean对象(生命周期还没走完)
3.三级缓存:缓存的是ObjectFactory,表示对象工厂,用来创建某个对象的
构造方法出现了循环依赖解决:
由于bean的生命周期中构造函数是第一个执行的,spring框架并不能解决构造函数的依赖注入
解决方案:使用@lazy进行懒加载,什么时候需要对象再进行bean对象的创建
SpringMVC的执行流程:
1.用户发送出请求到前端控制器
2.前端控制器收到请求调用处理器映射器
3.处理器映射器找到具体的处理器,生成处理器对象及处理器拦截器(如果有),再返回给前端控制器
4.前端控制器调用处理器适配器
5.处理器适配器经过适配调用具体的处理器
6.方法上添加了@ResponseBody
7.返回结果转换成JSON响应
Spring自动配置原理:
在Spring Boot项目中的引导类上有一个注解@SpringBootApplication,这个注解是对三个注解进行了封装,分别是:
1.@SpringBootConfiguration
2.@EnableAutoConfiguration
3.@ComponentScan
1.其实@EnableAutoConfiguration是实现自动化配置的核心注解。该注解通过@Import注解导入对应的配置选择器
2.内部就是读取了该项目和该项目引用的jar包的classpath路径下META/spring.factories文件中的所配置的类的全类名。在这些配置类中所定义的Bean会根据条件注解所指定的条件是否需要将其导入到Spring容器中
3.条件判断会有像@ConditionOnClass这样的注解,来判断是否有对应的class文件,如果有则加载该类,把这个配置类的所有的Bean放入spring容器中使用
MyBatis执行流程:
1.读取MyBatis配置文件,mybatis-config.xml加载运行环境和映射文件
2.构造会话工厂SqlSessionFactory
3.会话工厂创建SqlSession对象(包含了执行SQL语句的所有方法)
4.操作数据库的接口,Executor执行器,同时负责查询缓存的维护
5.Executor接口的执行方法有一个MappedStatement类型的参数,封装了映射信息
6.输入参数映射
7.输出结果映射
Mybatis是否支持延迟加载:
延迟加载:就是在需要数据时才会进行加载,不用到数据就不加载数据
Mybatis支持一对一关联对象和一对多关联对象集合的延迟加载
在Mybatis配置文件中,可以配置是否启用延迟加载lazyLodingEnabled=true,默认关闭
延迟加载的底层原理:
1.使用CGLIB创建目标对象的代理对象
2.当调用目标方法时,进入拦截器invoke方法,发现目标是null值,执行sql查询
3.获取数据以后,调用set方法设置属性值,再继续查询目标方法,就有值了
Mybatis的一级,二级缓存:
一级缓存:基于PerpetualCache的HashMap本地缓存,其存储作用域为Session,当Session进行flush或close之后,该Session中的所有Cache就将清空,默认打开一级缓存
二级缓存是基于namespace和mapper的作用域起作用的,不是依赖于sql session,默认也是采用PerpetualCache。HashMap存储。需要单独开启,一个是核心配置,一个是mapper映射文件
Mybatis的二级缓存什么时候清理缓存中的数据:
当某一个作用域(一级缓存Session/二级缓存Namespaces)的进行了新增,修改,删除,默认该作用于下所有的select中的缓存将被clear
微服务篇:
Spring Cloud的五大组件:
注册中心/配置中心 Nacos
负载均衡 Ribbon
服务调用 Feign
服务保护 sentinel
服务网关 Gateway
Nacos和eureka的区别和特点和区别:
Nacos和eureka的共同点(注册中心)
1.都支持服务注册和服务发现
2.都支持服务提供者心跳方式做健康检测
Nacos和Eureka的区别(注册中心):
1.Nacos支持服务端主动检测提供者状态,临时实例采用心跳模式,非实例采用主动检测模式
2.临时实例心跳不正常会被剔除,非临时实例不会被剔除
3.Nacos支持服务列表变更的消息推送方式,服务列表更新更及时
4.Nacos集群默认采用AP方式,当集群存在非实例时,采用CP模式;Eureka采用AP方式
Nacos还支持了配置中心,eureka只有注册中心,也是选择使用nacos的一个重要原因
负载均衡:
微服务的负载均衡主要使用了一个组件Ribbon,比如在使用feign远程调用的过程中,底层的负载均衡就是使用了ribbon
Ribbon负载均衡策略有哪些:
1.轮询
2.按照权重来选择服务器,响应时间越长,权重越小
3.随机选择
4.区域敏感策略,就是比如我离北京近就会优先选择北京为区域的服务器,然后再对这个区域轮询
自定义负载均衡:
1.创建类实现IRule接口(全局)
2.在客户端的配置文件,可以配置某一个服务调用的负载均衡策略(局部)
微服务雪崩解决:
服务雪崩:一个服务失败,导致整条链路的服务都失败的场景
服务降级:服务自我保护的一种方式,或者保护下游服务的一种方式,用于确保服务不会受请求突增影响变得不可用,确保服务不会崩溃,一般在实际开发中与feign接口整合,编写降级逻辑
服务熔断:默认关闭,需要手动打开,如果检测到10秒以内失败率超过一半就会触发,之后每隔5秒重新尝试请求,如果还是不响应继续走熔断机制,如果微服务可达,关闭熔断机制
微服务监控:
1.skywalking主要可以监控接口,物理实例的一些状态,特别是在压测的时候可以看到众多服务中哪些服务和接口比较慢,我们可以针对性的分析和优化
2.我们还在skywalking设置了告警规则,特别是在项目上线之后,如果报错,我们分别设置了给相关人发邮件。
微服务限流:
1.nginx限流:
漏桶算法,控制速率,让请求以固定的速率处理请求
控制并发数,限制单个ip的链接数和并发链接的总数
2.网管限流
在spring cloud gateway中支持局部过滤器来限流,令牌桶算法
可以根据ip或路径来限流,可以设置每秒填充平均速率和令牌桶总容量
CAP和BASE:
先来解释CAP:
Consistency(一致性)
Availability(可用性)
Partition(分区)
BASE:
Basically Available(基本可用)
Soft State(软状态):在一定时间内,允许出现临时的不一致
Eventually Consistent(最终一致性)
分布式事务解决方案:
1.seata的XA模式,需要等待各个分支事务提交,可以保证强一致性,性能差
2.seata的AT模式,底层使用undo log实现,性能好
3.seata的TCC模式,性能好,不过需要人工编码
4.MQ模式实现分布式事务,在A服务写数据的时候,需要在同一个事务内发送消息到另一个事务,异步,性能最好
分布式服务的接口幂等性如何保证:
1.如果是新增数据,可以使用数据库的唯一索引
2.如果是新增或修改数据
分布式锁,性能低
使用token+redis来实现,性能较好
第一次请求,生成一个唯一的token存入redis,返回给前端
第二次请求,业务处理,携带之前的token到redis中验证,如果存在,可以执行业务,删除token
如果不存在,则直接返回,不处理业务
分布式任务调度-xxljob:
xxl-job解决的问题:
1.解决集群任务的重复执行问题
2.cron表达式定义灵活
3.定时任务失败了,重试和统计
4.任务大,分片执行
xxl-job路由策略:
1.第一个机器
2.第二个机器
3.轮询
4.故障转移:按照顺序依次进行心跳检测,第一个心跳检测成功的机器选定为目标
5.分片广播:广播触发对应集群所有机器执行依次任务,同时系统自动传递分片参数,可以根据分片参数开发分片任务
6.lfu
7.lru
8.随机
xxl-job任务执行失败怎么解决:
1.路由策略选择故障转移,选择健康的实例来进行任务
2.设置重试次数
3.查看日志+邮件告警
如果有大数据量的任务同时都需要执行,怎么解决:
让多个实例一块去执行(部署集群),路由策略分片广播
在任务执行的代码中可以获取分片总数和当前分片,按照取模的方式分布到各个实例去执行
消息中间件篇:
RabbitMQ如何保证消息不丢失:
1.开启生产者重试机制,确保生产者的消息能到达队列
2.开启持久化功能,确保消息未消费前在队列中不会丢失
3.开启消费者确认机制,多次失败后交给人工处理
RabbitMQ消息的重复消费问题如何解决:
1.每条消息加一个唯一id
2.分布式锁,数据库锁
RabbitMQ中死信交换机:
声明一个交换机,添加delayed属性位true
发送消息时,添加x-delay头,值为超时时间
RabbitMQ如果有100万消息堆积在mq,如何解决:
1.增加更多的消费者,提高消费速度
2.在消费者内开启线程池加快消息处理速度
3.扩大队列容积,提高堆积上限,采用惰性队列
在声明队列的时候可以设置属性x-queue-mode为lazy
基于磁盘存储,消息上限高
性能稳定,但基于磁盘存储,受限于磁盘IO,时效性会降低
RabbitMQ的高可用机制:
在生产环境下,我们当时采用的时镜像集群,共有三个节点
镜像队列结构是一主多从(从就是镜像),所有的操作都是主节点完成,然后同步给镜像节点
主节点宕机后,镜像节点会替代为新的主(如果在主从同步完成,主就宕机,可能会数据丢失)
如果出现丢失数据可以用仲裁队列,与镜像节点一样,都是主从模式,支持主从数据同步,主从同步基于Raft协议,强一致。
并且使用起来不需要额外配置,只要声明队列指定这个队列是仲裁队列
Kafka如何保证消息不丢失,重复消费问题如何解决:
生产者发送消息到Brocker丢失:
设置异步发送,发送失败使用回调进行记录或重发
失败重试,参数配置,可以设置重试次数
消息在Brocker中存储丢失:
发送确认acks,选择all,让所有的副本都参与保存数据后确认
消费者从Brocker接收数据丢失:
关闭自动提交偏移量,开启手动提交偏移量
提交方式设置为同步+异步
重复消费解决:
关闭自动提交偏移量,开启手动提交偏移量
提交方式,最好是同步+异步提交
幂等方案(看rabbitmq解决方案)
Kafka如何保证消费的顺序性:
问题原因:一个topic的数据可能存储在不同的分区中,每个分区都有一个按照顺序的存储的偏移量,如果消费者关联了多个分区不能保证顺序性
解决方案:
发送消息时指定分区号
发送消息时按照相同的业务设置相同的key
Kafka的高可用机制:
两个层面回答,一个是集群,一个是复制机制
集群:
一个kafka集群由多个broker实例组成,即使一台宕机,也不耽误其他broker继续对外提供服务
复制机制:
一个topic有多个分区,每个分区有多个副本,有一个leader,其余的是follower,副本存储在不同的broker中
所有的分区副本的内容都是相同的,如果leader发生故障时,会自动将其中一个follower提升为leader,保证了系统的容错性,高可用性
复制机制中的ISR:
ISR需要同步复制保存的follower
分区副本分两类,一个是ISR,与leader副本同步保存数据,另一个是普通副本,是异步同步数据,当leader挂掉之后,会优先从ISR副本列表中选择一个作为leader
kafka数据清理机制:
kafka存储结构:
1.kafka中topic的数据存储在分区上,分区如果文件过大会分段存储segment
2.每个分段都在磁盘上以索引和日志文件形式存储
3.分段的好处是,第一能够减少单个文件内容的大小,查找数据方便,第二方便kafka进行日志清理
日志的清理策略有两个:
根据消息的保留时间,当消息保存的时间超过了指定的时间,就会触发清理,默认是七天
根据topic存储的数据大小,当topic所占的日志文件大小大于一定的数量,则开始删除最久的信息(默认关闭)
Kafka中实现高性能的设计:
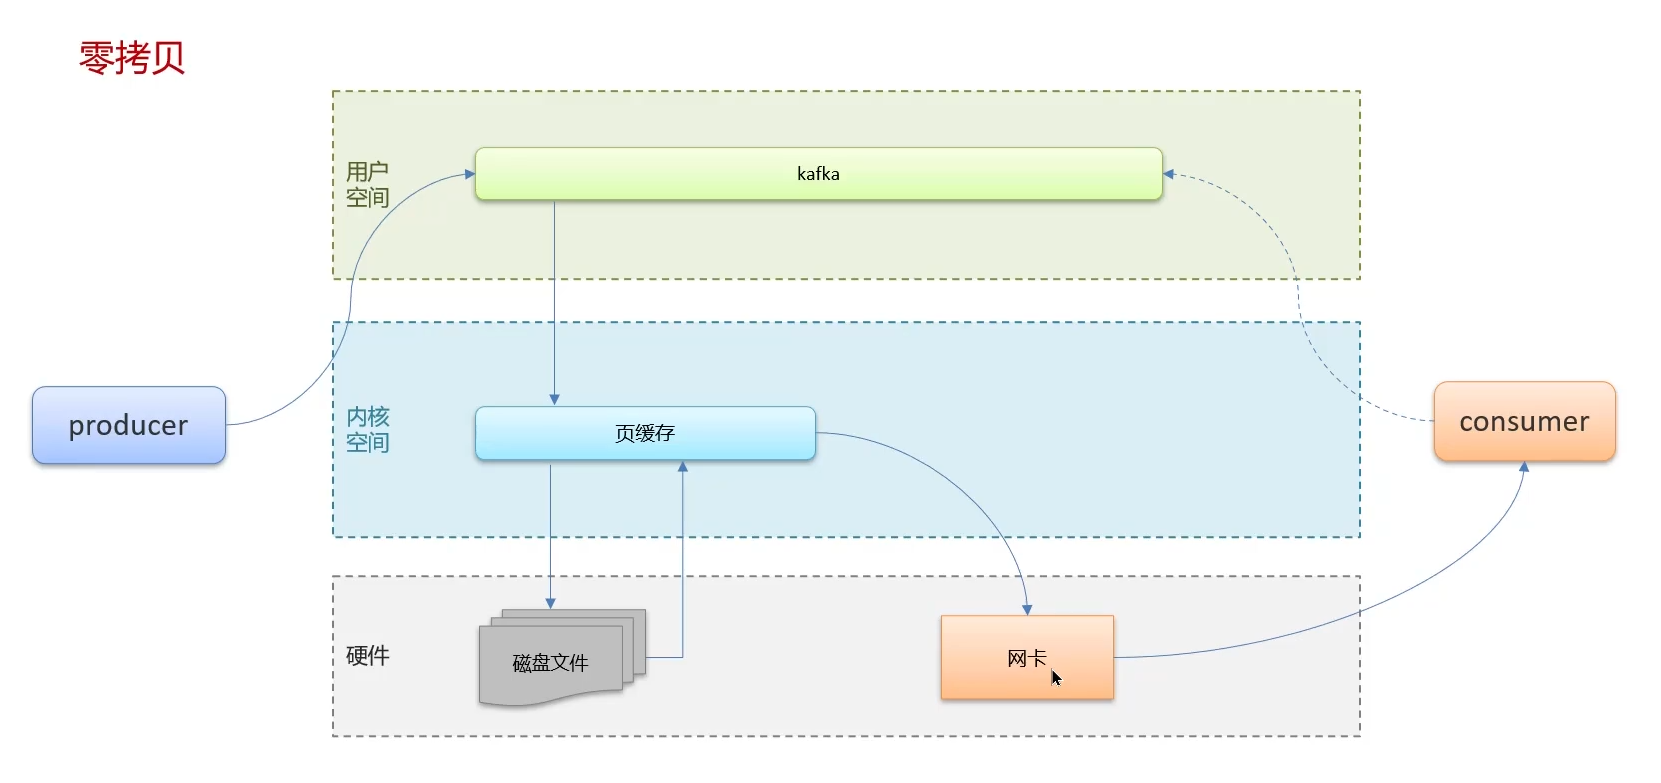
1.消息分区:不受单台服务器的限制,可以不受限的处理更多的数据
2.顺序读写:磁盘顺序读写,提升读写效率
3.页缓存:把磁盘中的数据缓存到页缓存中,把对磁盘的访问变为对内存的访问
4.零拷贝:减少上下文切换和数据拷贝
5.消息压缩:减少磁盘IO和网络IO
6.分批发送:将消息打包批量发送,减少网络开销
常见集合篇:
数组下标为什么从0开始:
寻址公式是:baseAddress+i*dataTypeSize,如果不从0开始要多做一次减法指令
ArrayList底层的实现原理:
1.ArrayList底层是动态的数组实现的
2.ArrayList初始化容量为0,当第一次添加数据的时候才会初始化容量为10
3.ArrayList在进行扩容的时候是原来的1.5倍,每次扩容都需要拷贝数组
ArrayList在添加数据的时候:
1.确保已使用长度(size)加1之后足够存下下一个数组
2.计算数组的容量,如果当前数组已使用长度+1后的长度大于当前的数组长度,则使用grow方法扩容(原来的1.5倍)
3.确保新增的数据有地方存储后,则将新元素加到位于size的位置上
4.返回添加成功布尔值
Arraylist list = new ArrayLit(10)中的list扩容几次:
该语句只是声明和实例了一个ArrayList,指定容量为10,并没有扩容
如何实现数组和list的转换:
数组转List,使用JDK中java.util.Arrays工具类的asList方法
List转数组,使用List的toArray,无参toArray方法返回Object数组,传入初始化长度的数组对象,返回该对象数组
Array.asList转List后,如果修改了数组内容,list受影响吗
Array.asList转换list之后,如果修改了数组的内容,list会受影响,因为他的底层使用的Arrays类中的一个内部类ArrayList来构造的集合,在这个集合的构造中,把我们传入的这个集合进行了包装而已,最终指向的都是同一个内存地址
list用了toArray转为数组后,如果修改了list内容,数组不会受影响,当调用了toArray以后,在底层它是进行了数组的拷贝,跟原来的元素就没啥关系了,所以即使list修改了以后,数组也不受影响
ArrayList和LinkedList的区别是什么
1.底层数据结构:
ArrayList是动态数组
LinkedList是双向链表
2.操作数据效率
ArrayList按照下标查询的时间复杂度O(1),LinkedList不支持下标查询
查询(未知索引):ArrayList需要遍历,链表也需要链表,时间复杂度都是O(n)
3.内存空间占用
ArrayList底层是数组,内存连续,节省内存
LinekedList是双向链表需要存储数据,和两个指针,更占用内存
4.线程安全
ArrayList和LinkedList都不是线程安全的
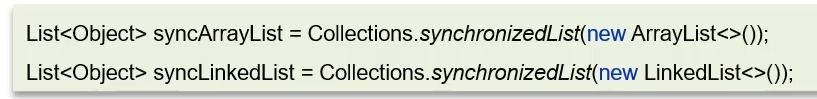
如果需要保证线程安全,有两种方法:
1.在方法内使用,局部变量是线程安全的
2.使用线程安全的ArrayList和LinkedList
二叉树:
1.每个节点最多有两个叉,分别是左子节点和右子节点
2.不要求每个节点都有两个子节点,有的节点只有左子节点,有的节点只有右子节点
二叉搜索树:
1.二叉搜索树又叫二叉查找树,有序二叉树
2.在树的任意一个节点,其左子树中的每一个节点的值,都要小于这个节点的值而右子树节点的值都大于这个节点的值
3.没有键值相等的节点
4.通常情况下二叉搜索树的时间复杂度为O(logn)
红黑树:
一种自平衡的二叉搜索树,之前叫做平衡二叉b树
特质:
1.节点要么是红色要么是黑色
2.根节点是黑色
3.叶子节点都是黑色的空节点
4.红黑树中红色节点的子节点都是黑色
5.从任意节点到叶子节点的所有路径都包含相同数目的黑色节点
在添加或删除节点的时候,如果达不到这些性质会发生旋转,以达到所有性质
红黑树的时间复杂度:查找,添加,删除都是O(logn)liannb
散列表(Hash Table):
在HashMap中最重要的一个数据结构就是散列表,在散列表中又使用了红黑树和链表
散列表(Hash Table)又名哈希表/Hash表,是根据键(Key)直接访问在内存存储位置值(Value)的数据结构,它是由数组演化而成,利用了数组支持按照下标进行随机访问数据的特性
将键(key)映射为数组下标的函数叫做散列函数,可以表示为:hashValue=hash(key)
散列函数的基本要求:
散列函数计算得到的散列值必须是大于等于0的正整数,因为hashValue需要作为数组的下标
如果key1==key2,那么经过hash后得到的哈希值也必须相同:hash(key1)==hash(key2)
如果key1!=key2,那么经过hash后得到的哈希值也必不相同:hash(key1)!=hash(key2)
哈希冲突:
实际的情况想找一个散列函数能够做到对于不同的key计算得到的散列值都不同是不可能的,即使像著名的MD5,SHA等哈希算法都无法避免,这就是散列冲突(也叫哈希冲突),哈希碰撞,就是指多个key映射到同一个数组下标位置
解决方案:拉链法
在散列表中,数组的每个下标我们都可以称之为桶或者槽,每个桶(槽)对应一条链表,所有散列值相同的元素我们都放到相同槽位对应的链表中或红黑树中
HashMap的实现原理:
1.底层使用hash表数据结构,即数组+链表+红黑树
2.添加数据时,计算key的值确定元素在数组的下标
key相同则替换,不同则放入链表或者红黑树
获取数据通过key的hash计算数组下标获取元素
HashMap的jdk1.7和1.8有什么区别:
jdk1.8之前采用的拉链法,数组+链表
jdk1.8之后采用数组+链表+红黑树,链表长度大于等于8且数组长度大于等于64则会从链表转化为红黑树
HashMap的put方法的具体流程:
1.判断键值对数组table是否为空或null,否则执行resize()进行扩容(初始化长度16的数组)
2.根据键值key计算hash得到数组索引
3.判断table[i]==null,条件成立,直接新建节点添加
4.如果table[i]=null不成立
4.1判断table[i]的首个元素是否和key一样,如果相同直接覆盖value
4.2判断table[i]是否为红黑树,如果是红黑树,则直接在树中插入键值对
4.3遍历table[i],链表的尾部插入数据,然后判断链表长度是否大于等于8,大于8的话把链表转换为红黑树,在红黑树中执行插入操作,遍历过程中如果发现key一级存在则直接覆盖value
5.插入成功后,判断实际存在的键值对数量size是否超过了最大容量threshold(数组长度*0.75),如果超过则进行扩容
HashMap的扩容机制:
1.在添加元素或初始化时需要调用resize方法进行扩容,第一次添加数据初始化数组长度为16,以后每次扩容扩容都是达到了扩容阈值(0.75*数组长度)
2.每次扩容都是扩容之前容量的两倍
3.扩容之后,会新建一个数组,需要把老数组的数据挪动到新的数组中
3.1没有hash冲突的节点,则需要使用e.hash&(newCap-1)计算新数组的索引位置
3.2如果是红黑树,走红黑树的添加
3.3如果是链表,则需要遍历链表,可能需要拆分链表,判断(e.hash&oldCap)是否为0,该元素的位置要么停留在原始位置,要么移动到原始位置+增加的数组大小这个位置上
HashMap的寻址算法:
1.计算对象的hashCode()
2.再进行调用hash()方法进行二次哈希,hashcode值右移16位再异或运算,让哈希分布更均匀
3.最后(capacity-1)&hash得到索引,代替了取模效率更高,capacity是数组长度
为什么HanshMap的数组长度一定是2的次幂:
1.计算索引时效率更高,如果是2的n次幂可以使用位于运算代替取模
2.扩容时重新计算索引效率更高:hash&oldCap==0的元素留在原来位置,否则新位置=旧位置+oldCap
hashmap在1.7情况下的多线程死循环问题:
在jdk1.7的hashmap中在数组进行扩容的时候,因为链表是头插法,在数据迁移的过程中,有可能导致死循环
比如说现在有两个线程
线程一:读取到当前的hashmap数据,数据中一个链表,在准备扩容时,线程二介入
线程二:也读取到hashmap,直接进行扩容,因为是头插法,链表的顺序会颠倒过来,比如原来的顺序是AB,扩容后的顺序是BA,线程二执行结束
线程一:继续执行的时候就会出现死循环的问题
线程一先将A移入新的链表,再将B插到链表头,由于另一个线程的原因,B的next指向了A所以B->A->B,出现了循环
JDK8将扩容算法做了调整,不再将元素加入链表头(而是保持和扩容前一样的顺序),尾插法,就避免了死循环问题
多线程相关面试题:
线程和进程的区别:
二者对比:
1.进程是正在运行程序的实例,进程中包含了线程,每个线程执行不同的任务
2.不同的进程使用不同的内存空间,在当前进程下的所有线程可以共享内存空间
3.线程更轻量,线程上下文切换成本一般上要比进程上下文切换低(上下文切换指的是从一个线程切换到另一个线程)
并行和并发的区别:
并发是同一时间应对多件事情的能力,多个线程轮流使用一个或多个cpu
并行是同一时间动手做多件事的能力,4核cpu同时执行4个线程
创建线程的方式:
1.继承Thread类,实现run方法,调用start方法启动线程,只能单继承,多个线程间共享资源需要额外处理
2.实现runnable接口,实现run方法,调用start方法启动线程,天然支持多线程共享同一资源
3.实现Callable接口,实现call方法,可以用FutureTask获取结果
4.线程池创建线程
runnable和callable区别:
1.Runnable接口run方法没有返回值
2.Callable接口call方法有返回值,需要FutureTask获取结果
3.Callable接口的call()方法允许抛出异常,而Runnable接口的run()方法异常只能内部消化不能抛出
run()和start()区别:
1.start():用来启动线程,通过该线程调用run方法执行run方法中所定义的逻辑代码,start方法只能被调用一次
2.run():封装了要被线程执行的代码,可以被调用多次
线程包括哪些状态,状态之间如何变化:
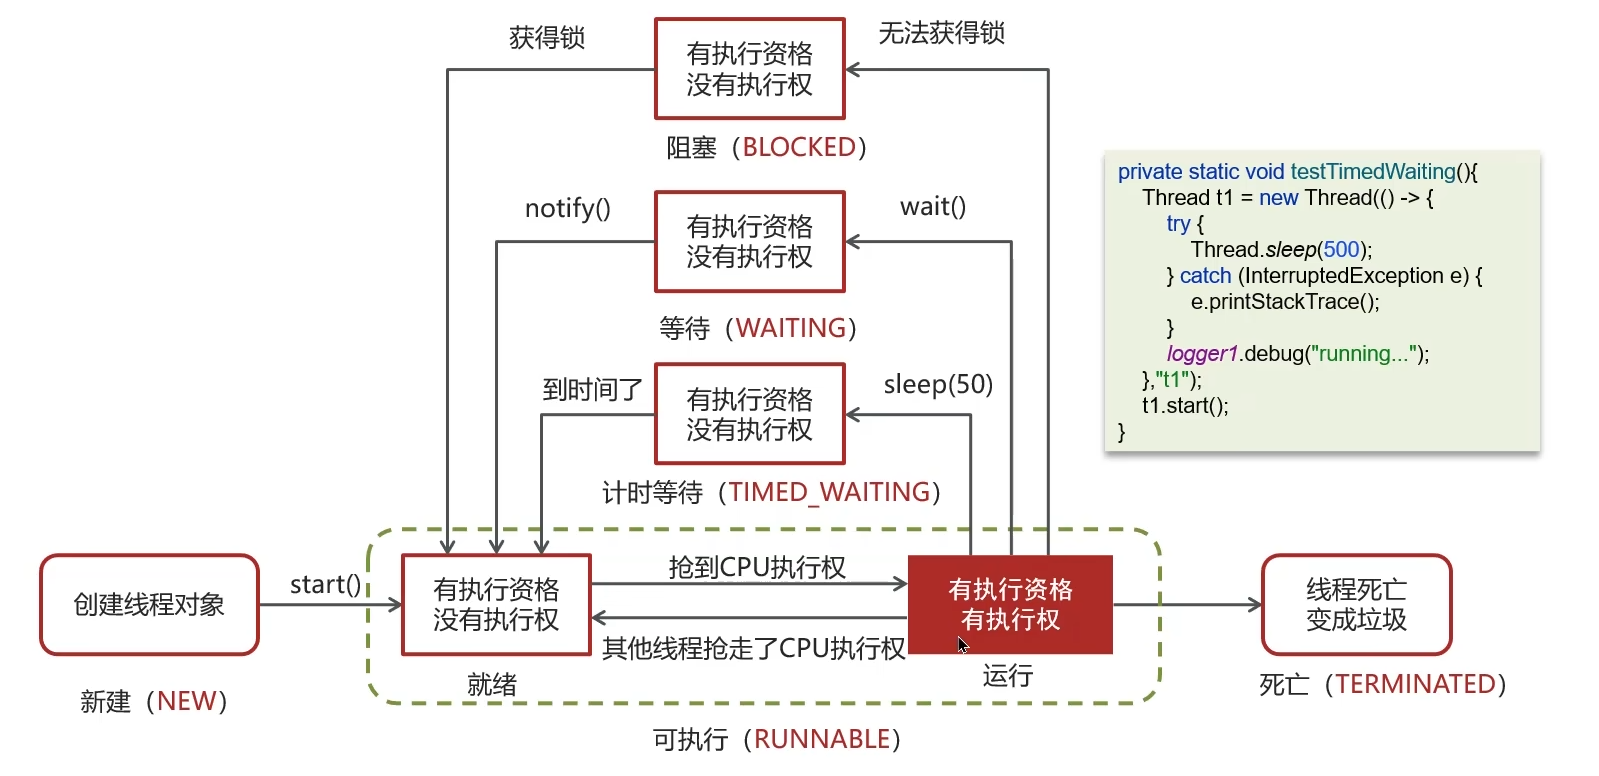
新建,就绪,运行,阻塞,等待,计时等待,终止。
就绪和运行可说为可执行状态。
线程之间如何变化:
1.创建线程对象是新建状态
2.调用了start()方法转变为可执行状态
3.线程获取到了cpu的执行权,执行结束是终止状态
4.在可执行状态的过程中,如果没有获取到cpu的执行权,可能切换其他状态
4.1如果没有获取到锁(synchronized或lock)进入阻塞状态,获得锁切换为可执行状态
4.2如果线程调用了wait()方法进入等待状态,其他线程调用notify()唤醒后可切换位可执行状态
4.3如果线程调用了sleep(50)方法,进入计时等待状态,到时间后可切换为可执行状态
新建T1、T2、T3线程,如何保证他们顺序执行:
可以用线程中的join方法解决
比如在T2线程调用t1.join就可以在线程1之后执行
t.join():阻塞调用此方法的线程进入timed_waiting直到线程t执行完后,此线程再继续执行
notify()和notifyAll()有什么区别:
notify:只随机唤醒一个线程
notifyAll:唤醒所有wait的线程
在java中wait和sleep方法的不同:
共同点:
wait(),wait(long)和sleep(long)的效果都是让当前线程暂时放弃cpu的执行权,进入阻塞状态
不同点:
1.方法归属不同
1.sleep(long)是Thread的静态方法
2.wait(),wait(long)都是Object的成员方法,每个对象都有
2.醒来时机不同
1.执行sleep(long)和wait(long)的线程都会在等待相应毫秒醒来
2.wait(long)和wait()还可以被notify唤醒,wait()如果不唤醒就一直等下去
3.他们都可以被打断唤醒
3.锁特性不同(重点)
1.wait方法的调用必须先获取wait对象的锁,而sleep无限制
2.wait方法执行后会释放对象锁,允许其他线程获取该对象锁(我放弃cpu,你们还可以用)
3.而sleep如果在synchronized代码块中执行,并不会释放对象锁(我放弃cpu,你们也用不了)
如何停止一个正在运行的线程:
有三种方式可以停止线程:
1.使用退出标志,也就是当run方法完成后线程终止
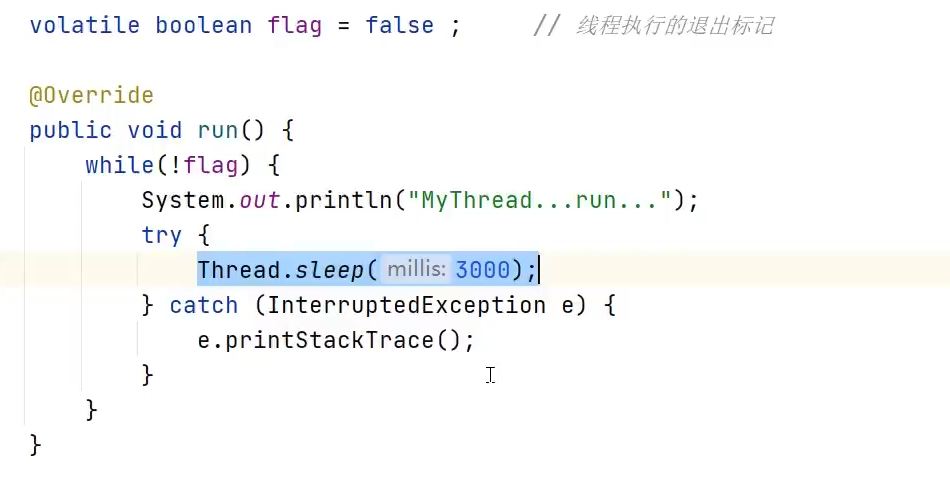
当把flag改为true,线程退出,自动退出循环
2.使用stop方法强制终止(不推荐,方法已作废)
3.使用interrupt方法中断线程
3.1打断阻塞的线程(sleep,wait,join)的线程,线程会抛出InterruptedRxception异常
3.2打断正常的线程,可以根据打断状态来标记是否退出线程
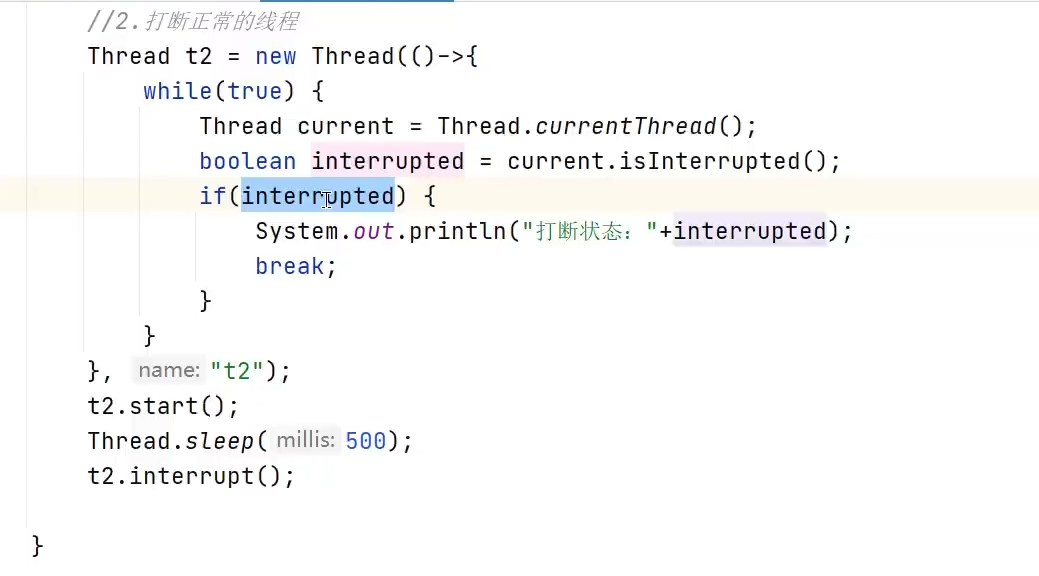
interrupted默认是false,当调用interrupted的时候会改变为true
synchronized关键字的底层原理:
Synchronized(对象锁)采用互斥的方式让同一时间至多只有一个线程能够持有(对象锁),其他线程想要在获取这个对象锁就会被阻塞住
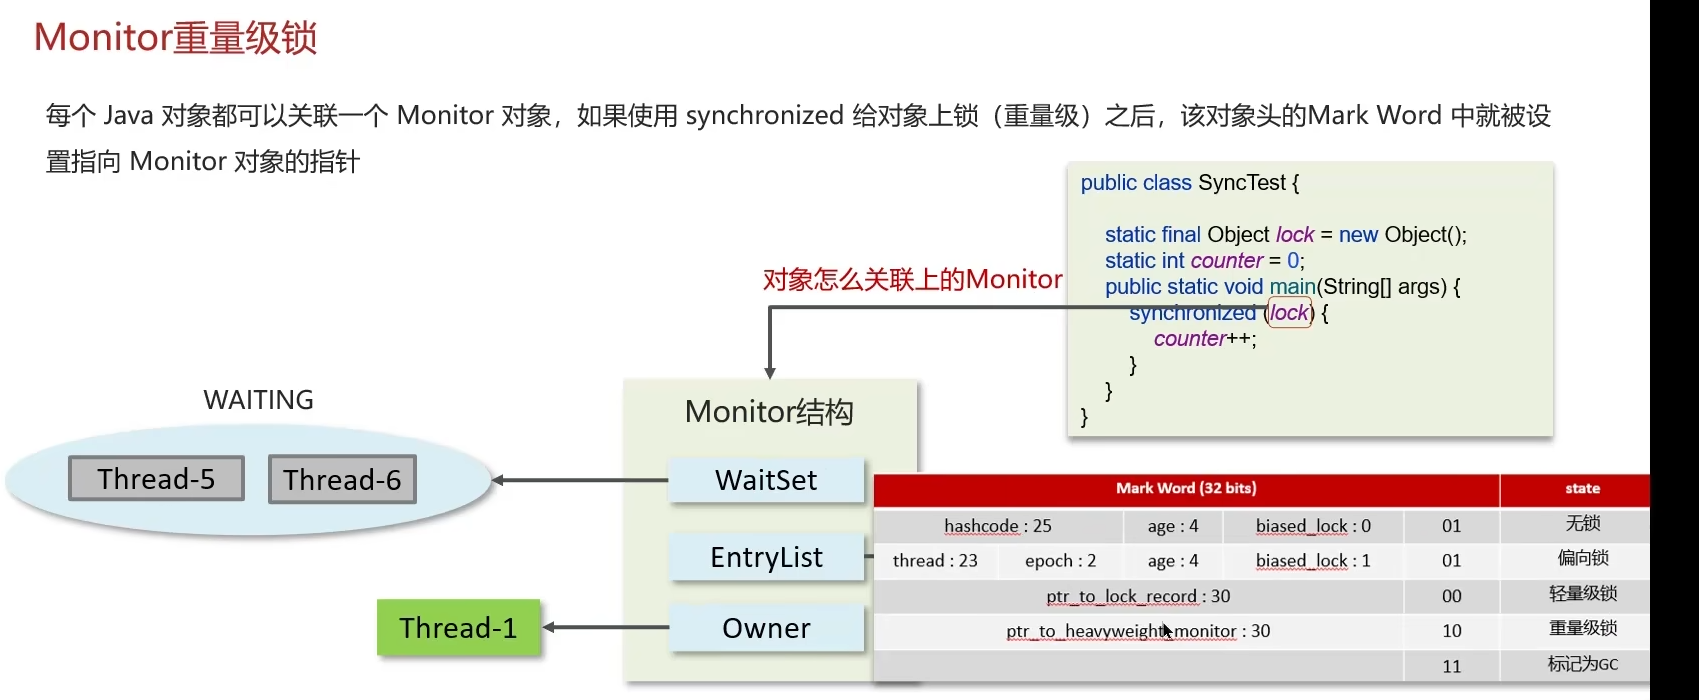
它的底层是由monitor(监视器)实现的,monitor是jvm级别的对象(c++实现),线程获得锁需要使用对象锁关联monitor
在monitor内部有三个属性,分别是owner,entrylist,waitset
其中owner是关联的获取锁的线程,并且只能关联一个线程;entrylist关联的是阻塞状态的线程;waitset关联的是处于Waiting状态的线程
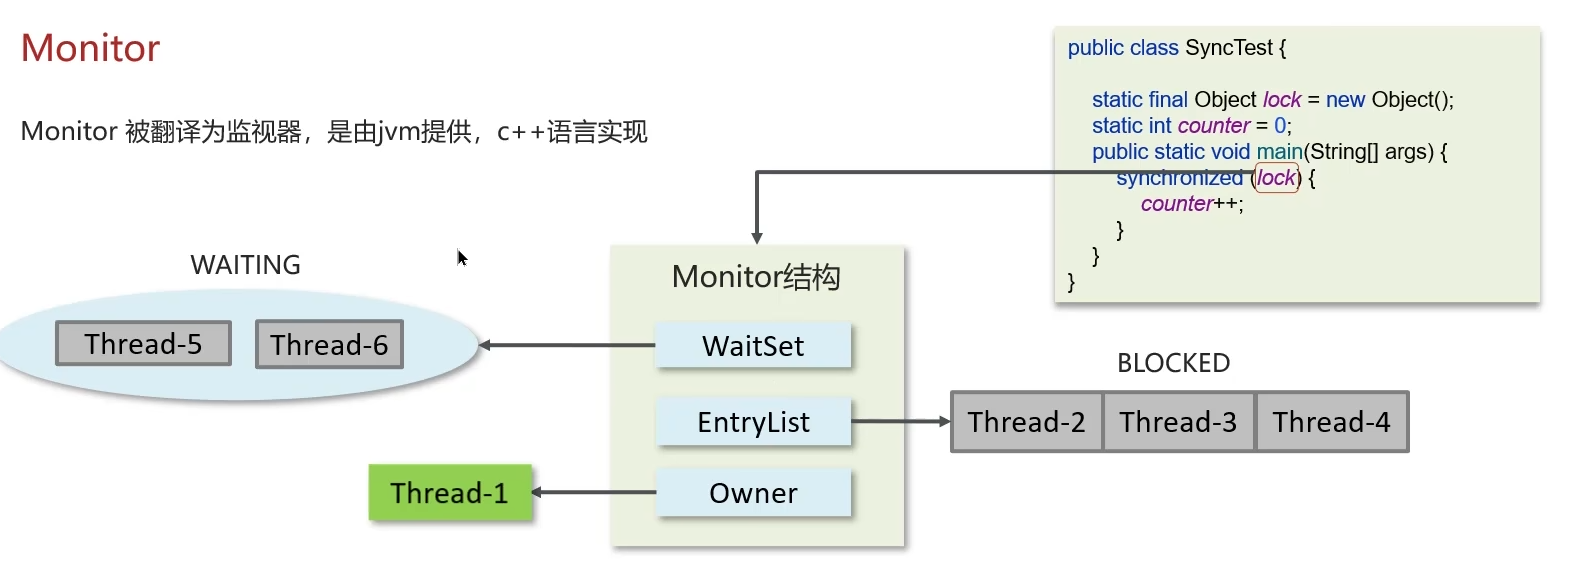
lock是对象锁,会判断owner是否为null,如果为null那当前对象就拥有了对象锁,当owner不为null都会在Entrylist中等待,也就是阻塞线程,当owner的线程执行完了,blocked的线程就去争抢执行权(无先来后到),当一个线程调用了wait方法就会进入WaitSet
synchronized关键字的底层原理-进阶:
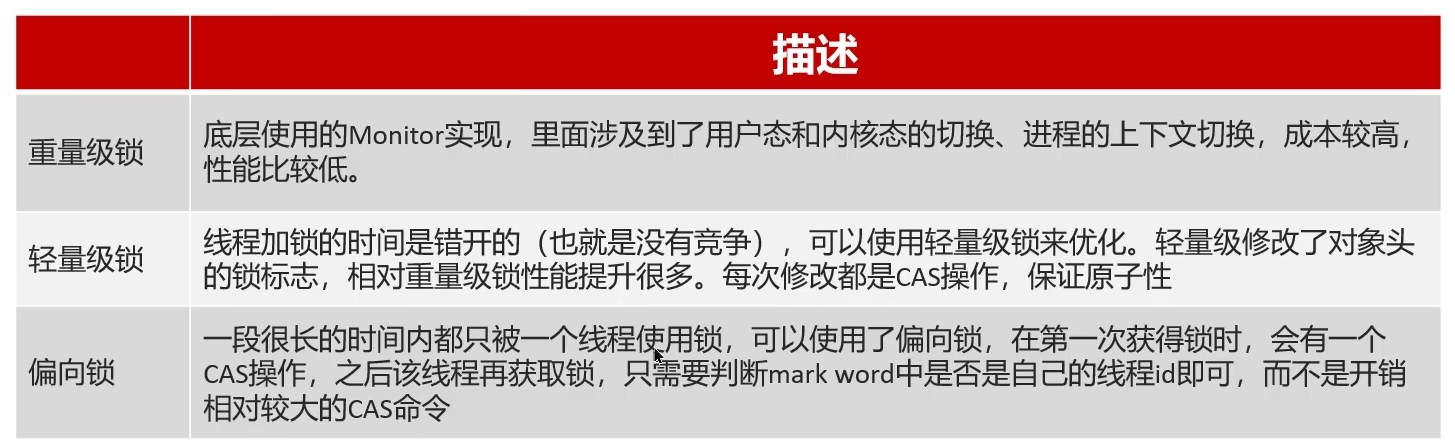
Monitor实现的锁属于重量级锁,里面涉及到了用户态和内核态的切换,进程的上下文切换,成本较高,性能较低
在jdk1.6引入了两种新型锁机制:偏向锁和轻量级锁,它们的引入是为了解决在没有多线程竞争或基本没有竞争的场景下因使用传统锁机制带来的性能开销问题
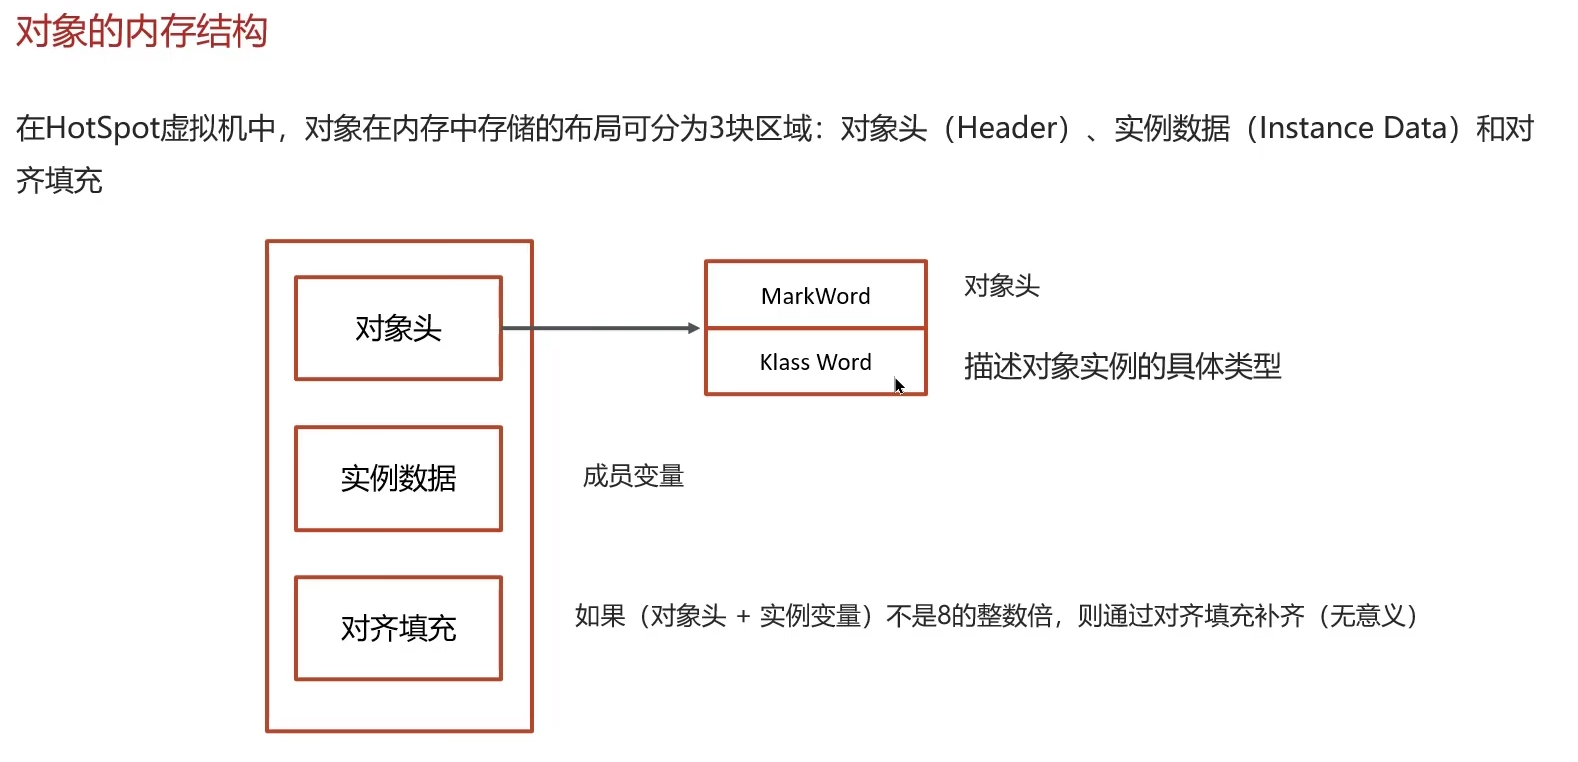
对象的内存结构:
在HotSpot虚拟机中,对象在内存中存储的布局可分为3块区域:对象头(Header),实例数据和对象填充
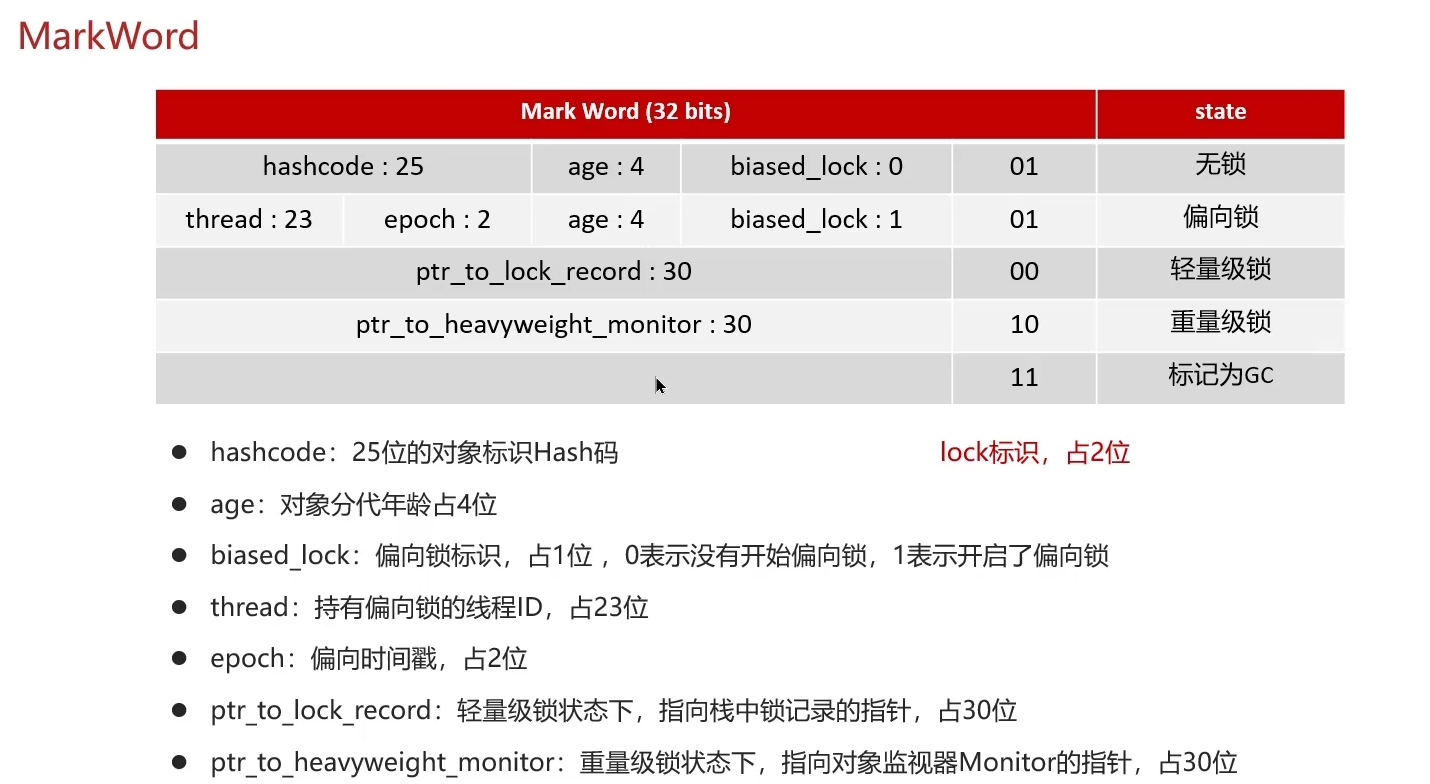
重量级锁:
轻量级锁:
加锁流程
1.在线程栈中创建一个Lock Record,将其obj字段指向锁对象
2.通过CAS指令将Lock Record的地址存储在对象头mark word中,如果对象处于无锁状态则修改成功,代表该线程获得了轻量级锁
3.如果当前线程已经持有锁了,代表这是一次锁重入。设置Lock Record第一部分为null,起到了一个重入计数器的作用
4.如果CAS修改失败。说明发生了竞争,需要膨胀为重量级锁
解锁过程:
1.遍历线程栈,找到所有obj字段等于当前锁对象的lock Record
2.如果Lock Record的Mark Word为null,代表这是一次重入,将obj设置为null后continue
3.如果Lock Record的Mark Word不为null,则利用CAS指令将对象头的mark word恢复为无锁状态。如果失败则膨胀为重量级锁
偏向锁:
轻量级锁在没有竞争时(就自己这个线程),每次重入仍然需要执行CAS操作
java6中引入了偏向锁来进一步优化:只有当第一次使用CAS将线程ID设置到对象的Mark Word头,之后发现这个线程ID是自己的就表示没有竞争,不用CAS。以后只要不发生竞争,这个对象就归该线程所有
java中的synchronized有偏向锁,轻量级锁,重量级锁三种形式,分别对应了锁只被一个线程持有,不同线程交替持有锁,多线程竞争锁三种情况
JMM(java内存模型):
定义了共享内存中多线程程序读写操作的行为规范,通过这些规则来规范对内存的读写操作从而保存指令的正确性
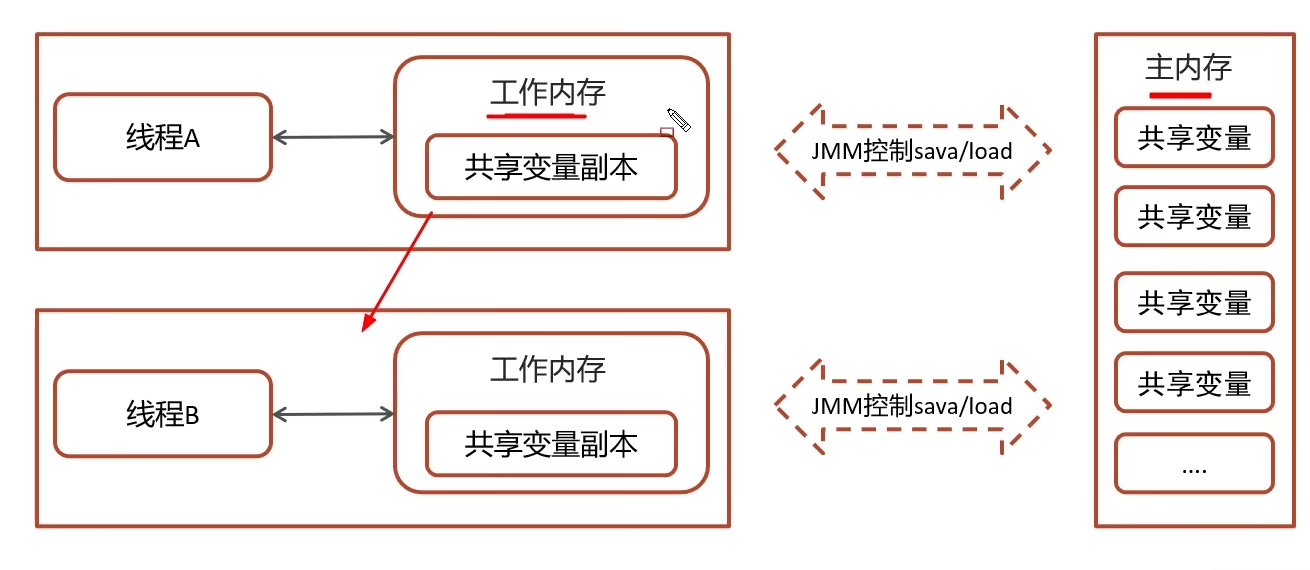
JMM把内存分为两块,一块是私有线程的工作区域(工作内存),一块是所有线程的共享内存(主内存)
线程和线程之间相互隔离,线程和线程交互需要通过主内存
CAS指令:
CAS的全称是:Compare And Swap(比较再交换),它体现一种乐观锁的思想,在无锁情况下保证线程操作共享数据的原子性
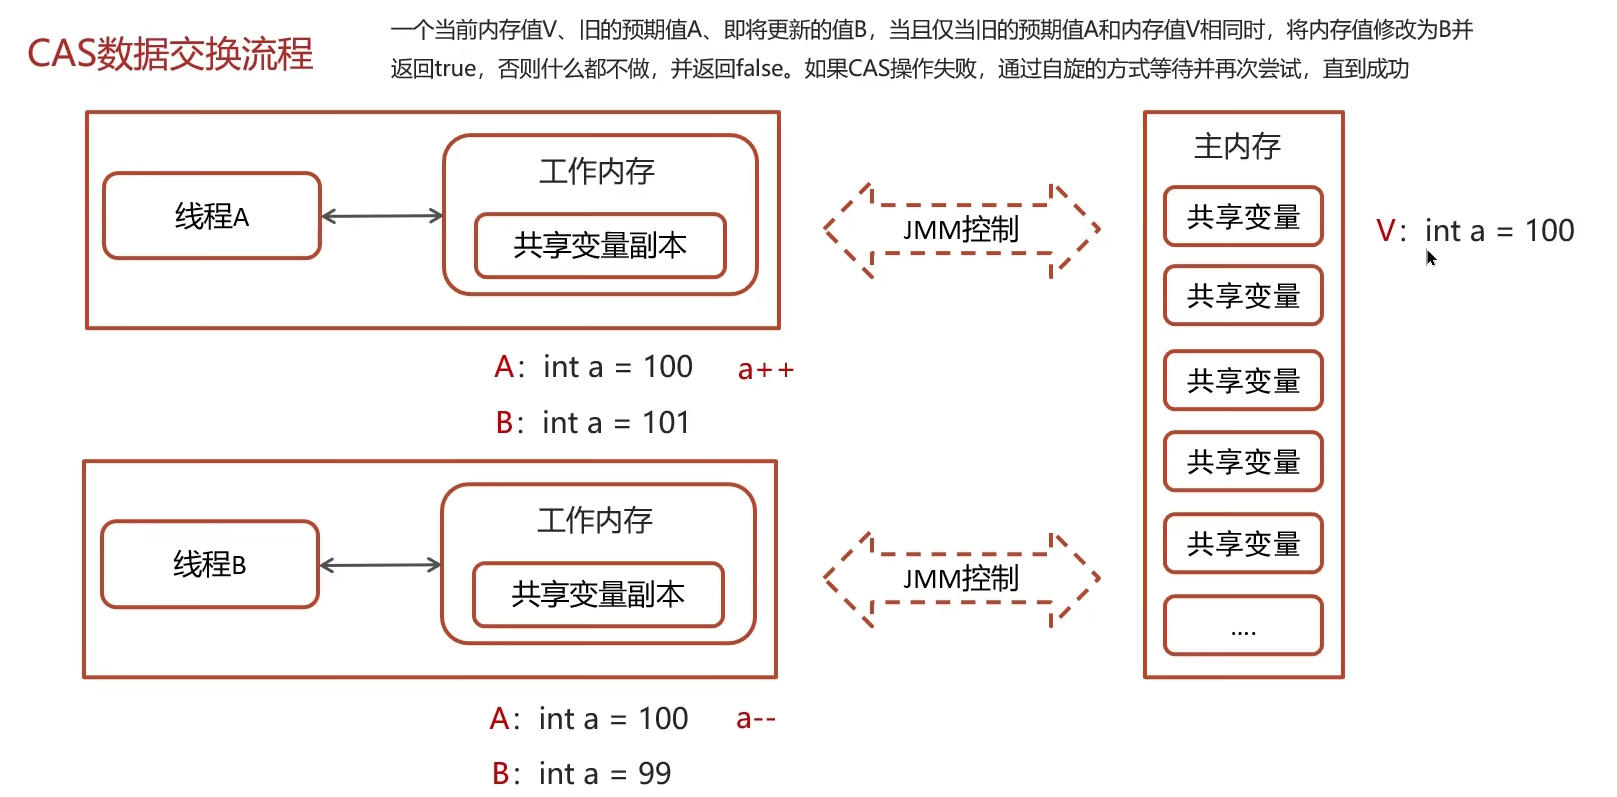
就是拿a值和这个v值比对如果相同就赋值b值不同就自旋
在JUC的包下实现的很多类都用到了CAS操作
自旋锁:自旋锁的自旋逻辑是检查 “锁的状态标记”(是否被其他线程持有),而非直接比较共享数据的新旧值。当锁被占用时,线程通过自旋等待;锁释放后,线程立即抢占锁进入临界区。这种机制避免了线程阻塞 / 唤醒的开销,适合锁持有时间短的场景。
乐观锁和悲观锁的思想:
CAS是基于乐观锁的思想:最乐观的估计,不怕别的线程来修改共享变量,就算改了也没关系,吃点亏重试(CAS吃点亏自旋)
synchronize是基于悲观锁的思想:最悲观的估计,得防着其他线程来修改共享变量,我上了锁你们都别想改,我改完解开锁,你们才有机会
volatile的理解:
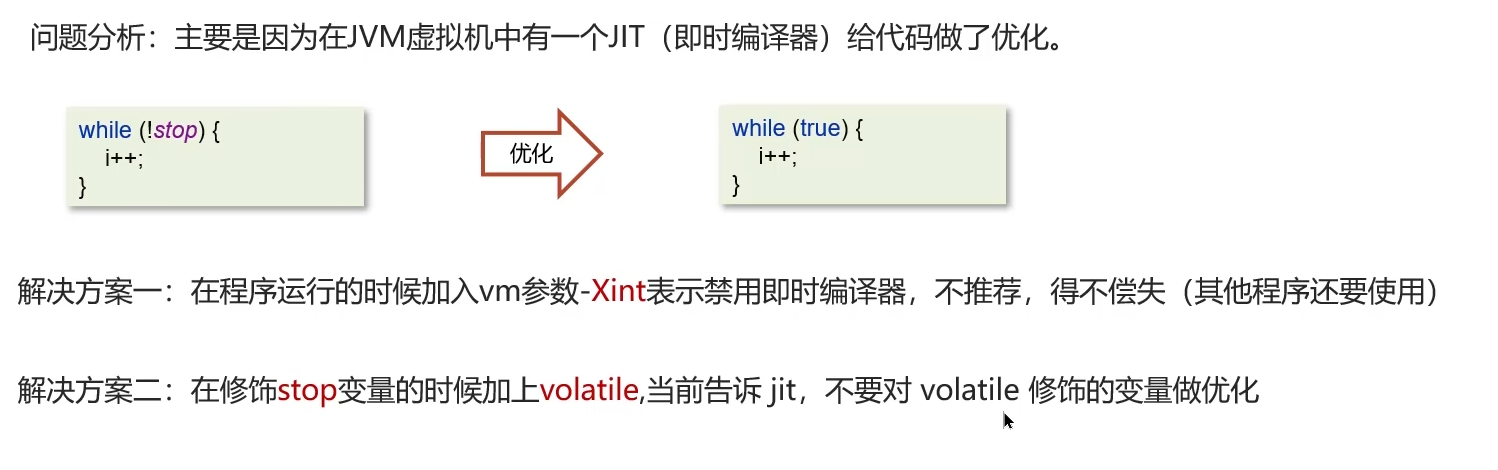
1.保证线程的可见性
用volatile修饰共享变量,能够防止编译器等优化发生,让一个线程对共享变量的修改对另一个线程可见
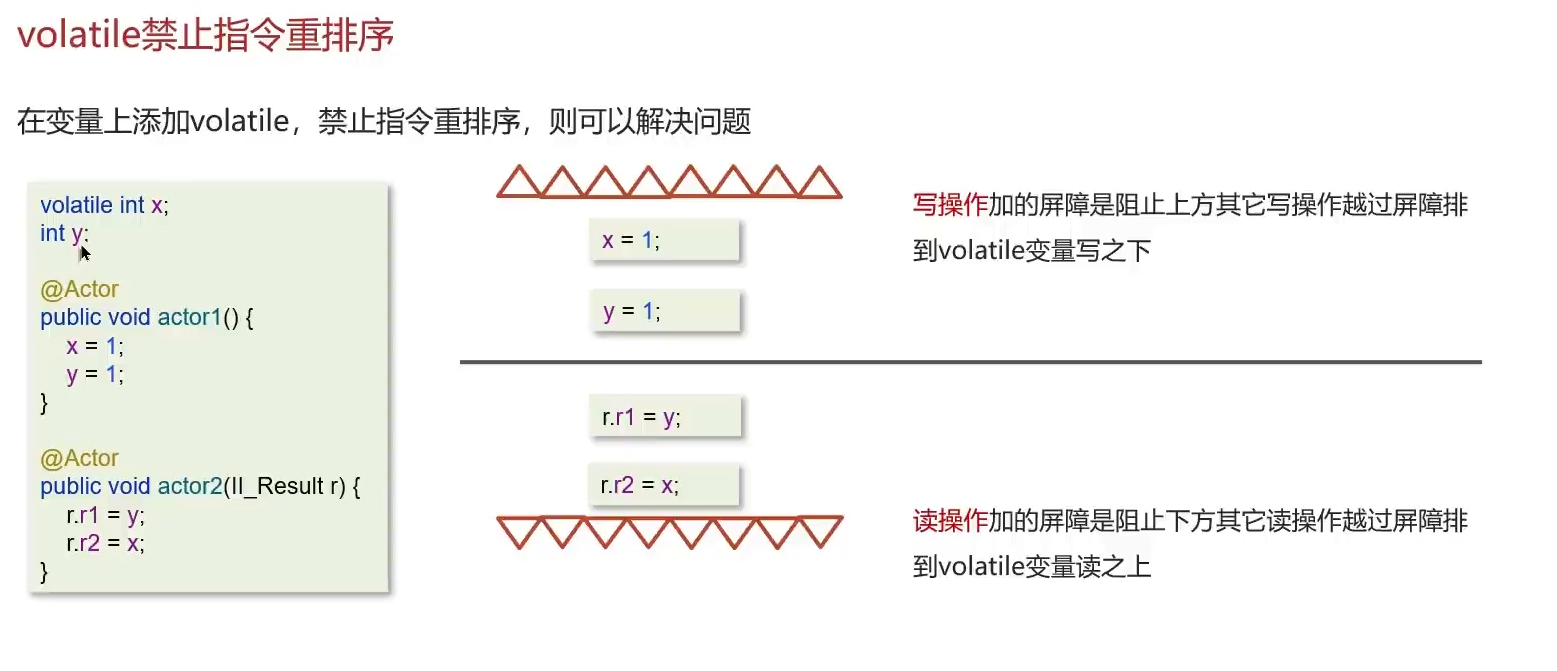
2.禁止指令重排序
用volatile修饰共享变量会在读、写共享变量时加入不同的屏障,阻止其他读写操作越过屏障,从而达到阻止重排序的效果
AQS(抽象队列同步器):
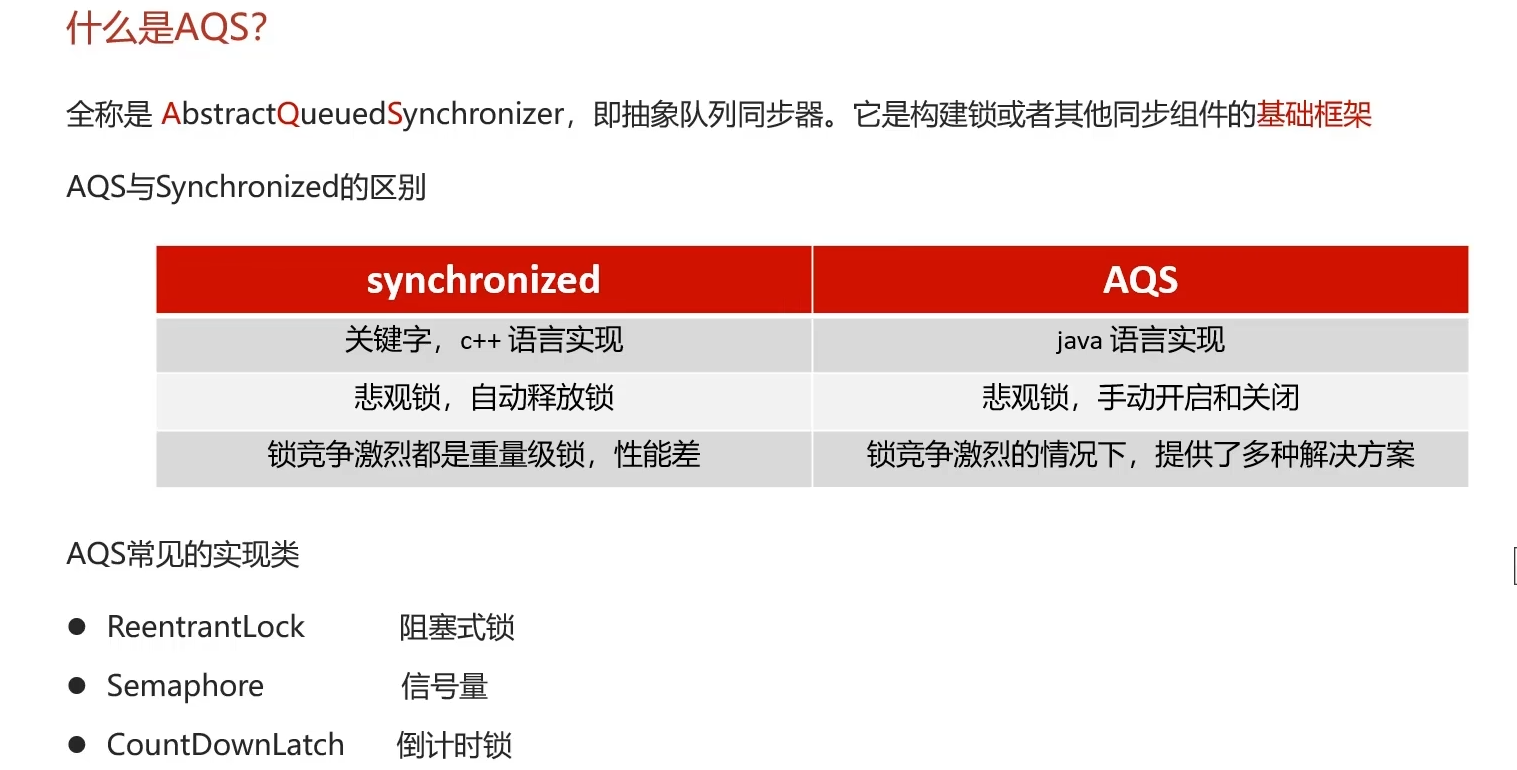
AQS是多线程中的队列同步器,是一种锁机制,它是作为一个基础框架使用的,像ReentrantLock,Semaphore都是基于AQS实现的
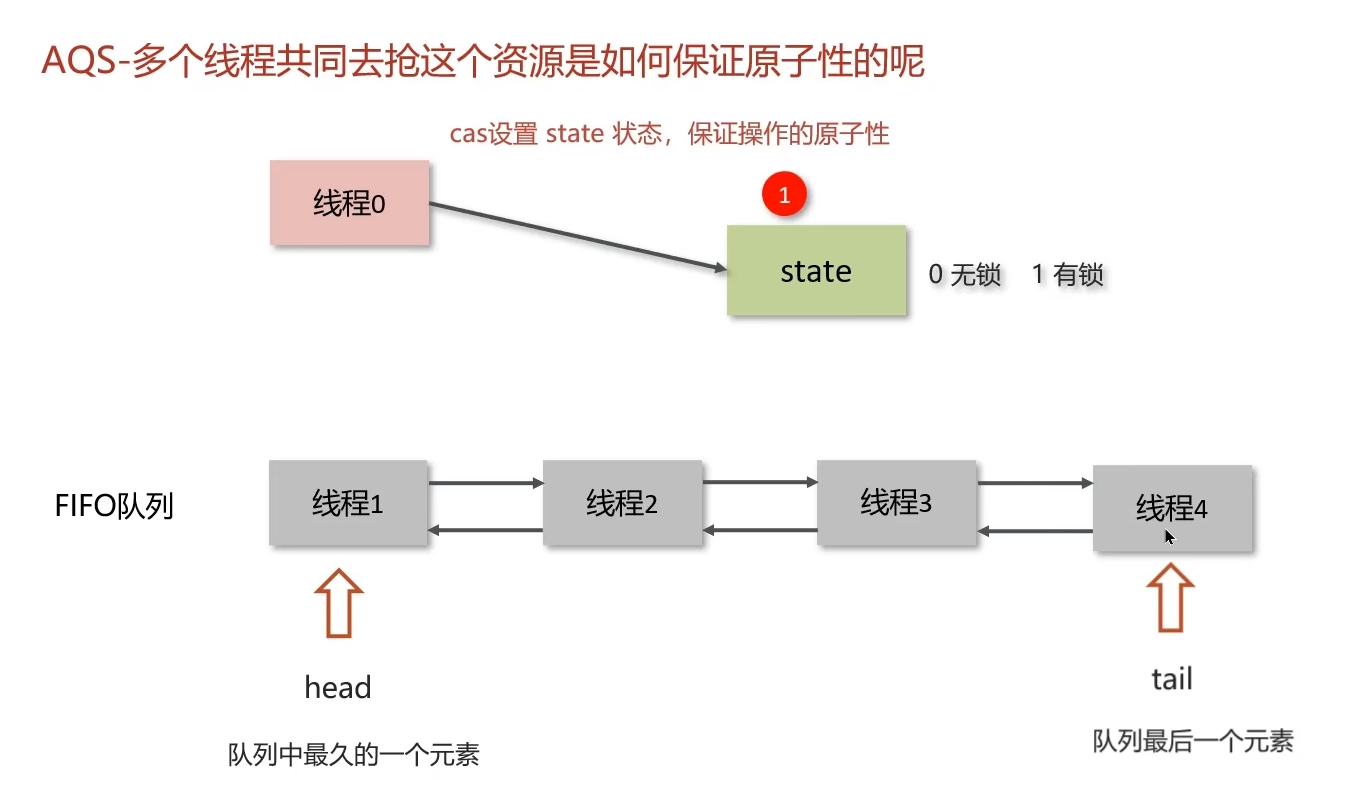
AQS内部维护了一个先进先出的双向队列,队列中存储的排队的线程
在AQS内部还有一个属性state,这个state就相当于一个资源,默认是0(无锁状态),如果队列中的有一个线程成功修改了state为1,则当前线程就相当于获取了资源
在对state修改的时候使用的cas操作,保证了多个线程修改的原子性
ReentrantLock的实现原理:
ReentrantLock(可重入锁),相对于synchronized具备以下特点:
1.可中断
2.可以设置超时时间
3.可以设置公平锁
4.支持多个条件变量
5.与synchronized一样,都支持插入
ReentrantLock主要利用CAS+AQS队列,它支持公平锁和非公平锁,两者的实现类似
构造方法接受一个可选的公平参数(默认非公平锁),当设置为null时就是公平锁,否则为非公平锁。公平锁的效率往往没有非公平锁的效率高。在许多线程访问的情况下,公平锁表现出较低的吞吐量
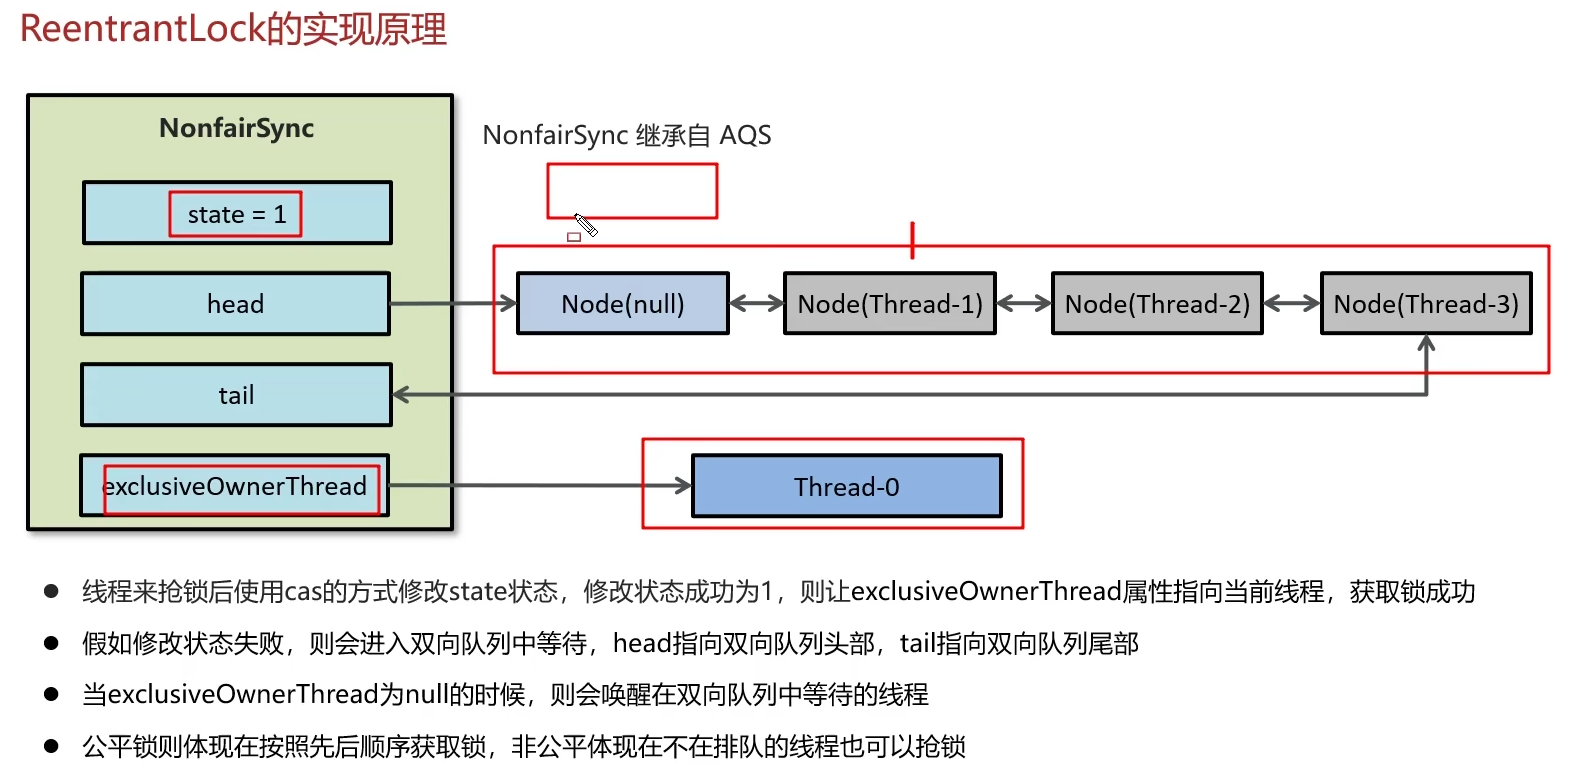
ReentrantLock表示支持重新进入的锁,调用lock方法获取锁之后,再次调用lock不会阻塞
支持公平和非公平锁,在提供的构造器的无参默认非公平,可以设置为公平锁
synchronized和Lock有什么区别:
语法层面:
synchronized是关键字,源码在jvm中,c++实现
Lock是接口,源码由jdk提供,用java语言实现
使用synchronized时,退出同步代码块会自动释放锁,用Lock时需要unlock方法释放锁
功能层面:
二者都属于悲观锁,都具备基本的的互斥,同步,锁重入功能
Lock提供了许多synchronized不具备的功能,如公平锁,可打断,可超时,多条件变量
Lock有适合不同场景的实现,如ReentrantLock,ReentrantReadWriteLock(读写锁)
性能层面:
在没有竞争时,synchronized做了很多优化,如偏向锁,轻量级锁
在竞争激烈的时候,Lock实现会提供更好的性能
死锁产生的条件是什么,如何进行死锁诊断
一个线程需要同时获取多把锁,这时就容易发生死锁
死锁诊断:
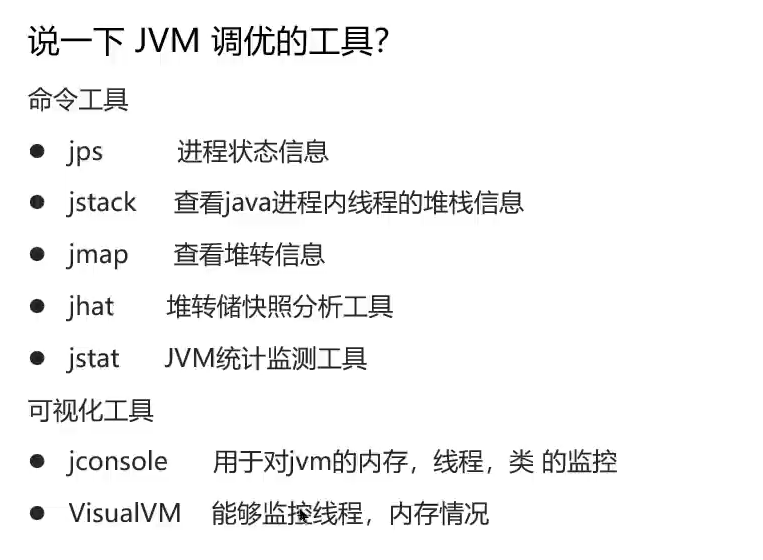
当程序发生了死锁现象,我们可以使用jdk自带的工具:jsp和jstack
jps:输出JVM中运行的进程状态信息
jstack:查看java进程内线程的堆栈信息,查看日志,检查是否有死锁,如果有死锁现象,需要查看具体代码分析后可修复
jconsole:可视化工具,VisualVM也可以检查死锁问题
ConcurrentHashMap:
1.底层数据结构
jdk1.7采用的是分段的数组+链表实现
jdk1.8采用的是数组+链表/红黑树
2.加锁的方式
jdk1.7采用的是分段锁,底层使用的是ReentrantLock
jdk1.8采用的是CAS添加新节点,采用synchronized锁定链表或红黑树的首节点,比分段锁更好,性能更好
导致并发程序出现根本原因是什么:
java并发编程三大特征:
原子性:一个线程在cpu中操作不可暂停,也不可中断,要不执行完成,要不不执行,锁解决
内存可见性:让一个线程对共享变量的修改对另一个线程可见,volatile解决
有序性:指令重排:处理器为了提高程序运行效率,可能对输出代码优化,它不保证程序中各个语句的执行先后顺序同代码中的顺序一致,但是它会保证程序最终执行结果和代码顺序执行的结果是一致的 volatile解决
线程池的核心参数:
1.核心线程数目
2.最大线程数目 = (核心线程+救急线程的最大数目)
3.生存时间-救急线程的生存单位,生存时间内没有新任务,此资源会被释放
4.时间单位-救急线程的生存时间单位
5.任务队列(阻塞队列)-当没有空闲核心线程时,新来任务会加入到此队列排队,队列满会创建救急线程执行任务
6.线程工厂-可以定制线程对象的创建,例如设置线程名字,是否守护线程
7.拒绝策略-当所有线程都繁忙,任务队列也满了会触发拒绝策略
线程池拒绝策略:
1.直接抛出异常,默认策略
2.用调用者所在的线程来执行任务
3.丢弃阻塞队列中靠最前的任务,并执行当前任务
4.直接丢弃任务
线程池中有哪些的阻塞队列:
1.ArrayBlockingQueue:基于数组结构的有界阻塞队列,FIFO
2.LinkedBlockingQueue:基于链表结构的有界阻塞队列,FIFO
3.DelayWorkQueue:是一个优先级队列,它可以保证每次出队的任务都是当前队列中执行时间最靠前的
4.SynchronousQueue:不存储元素的阻塞队列,每个插入操作必须等待一个移出操作
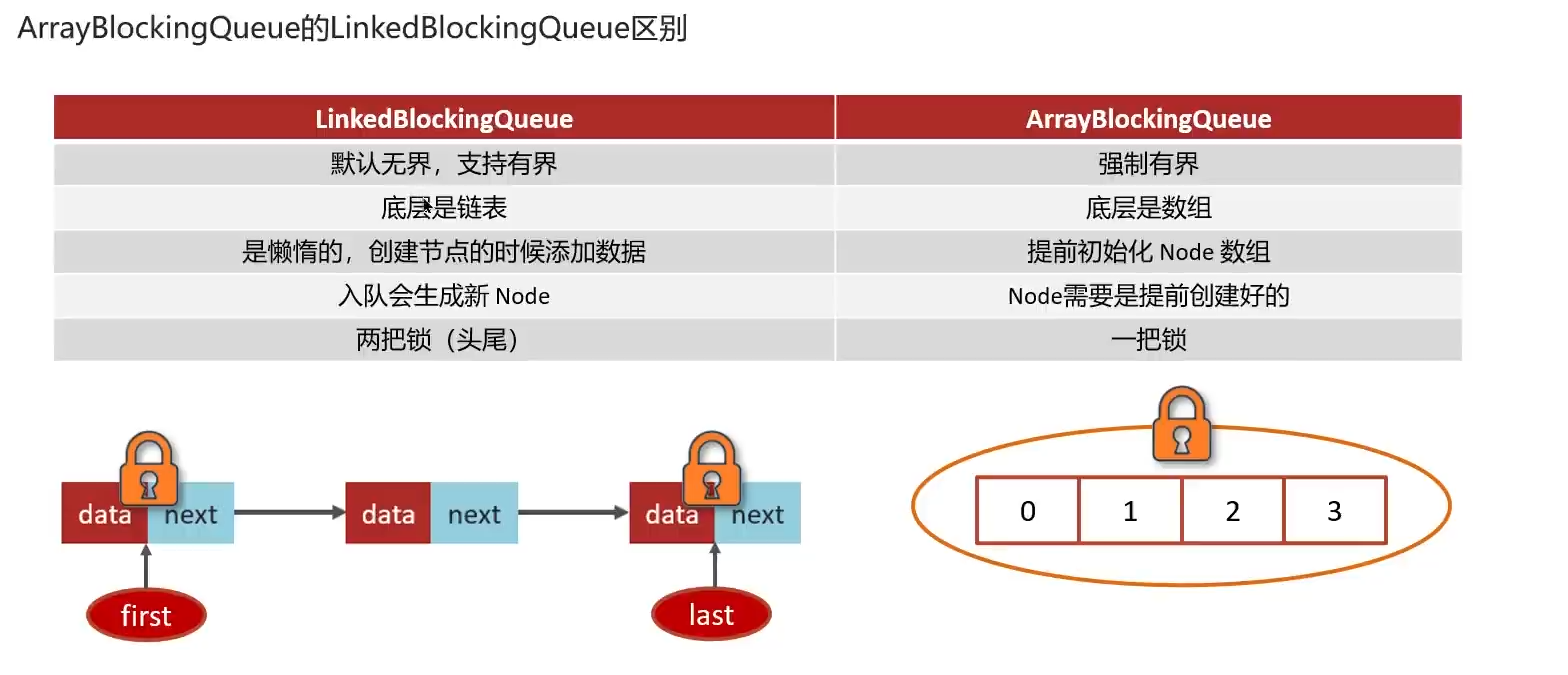
如何确定核心线程数:
1.高并发,任务执行短(cpu核数+1),减少上下文的切换
2.并发布不高,任务执行长
IO密集型任务(cpu核数*2+1)
计算密集任务(cpu核数+1)
线程池的种类有哪些:
1.newFixedThreadPool:创建一个定长线程池,可控制线程最大并发数,超出的线程在队列中等待
2.newSingleThreadExecutor:创建一个单线程化的线程池,它只会用唯一的工作线程来执行任务,保证所有的任务按照指定的顺序(FIFO)执行
3.newCachedThreadPool:创建一个可缓存线程池,如果线程池长度超过处理需要,可灵活回收空闲线程,若无可回收,则新建线程
4.newScheduledThreadPool:可以执行延迟任务的线程池,支持定时及周期任务执行
为什么不建议用Executor创建线程池:
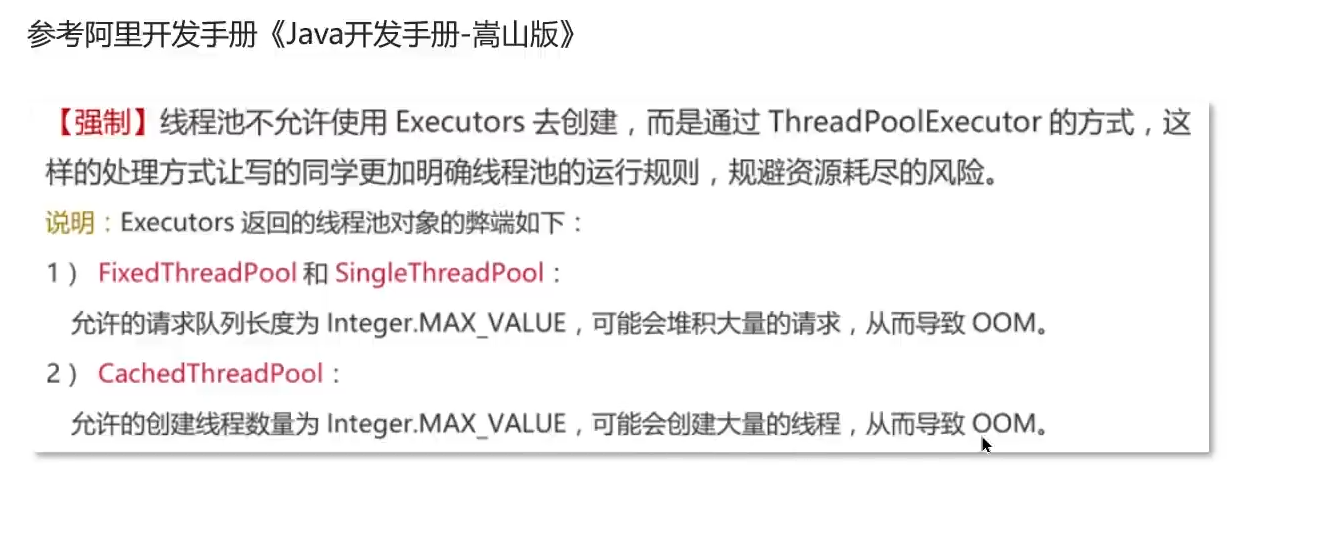
线程池使用场景:
CountDownLatch(闭锁/倒计时锁):用来进行线程同步协作,等待所有线程完成倒计时(一个或多个,等待其他多个线程完成某件事情之后才能执行)
其中构造参数用来初始化等待计数值
await()用来等待计数归零
countDown()用来计数减一
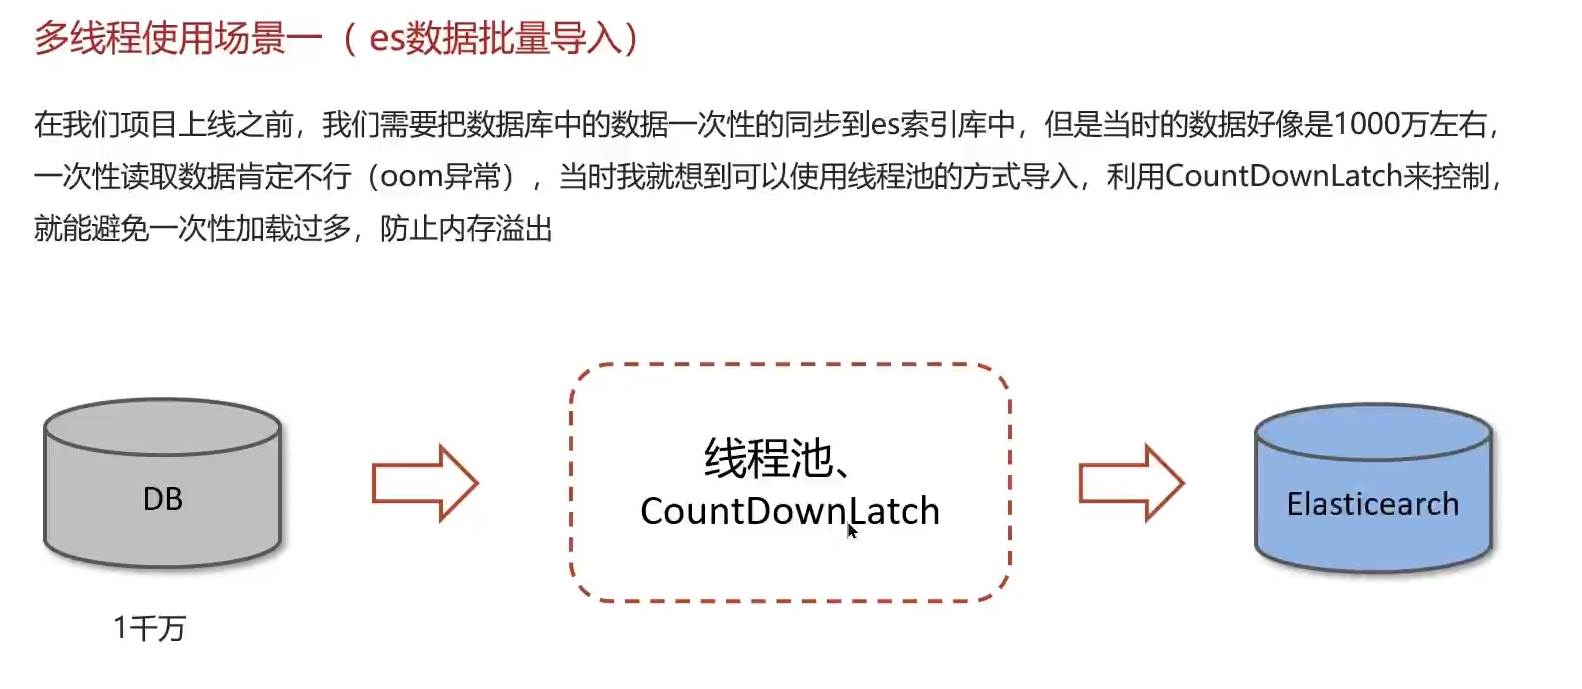
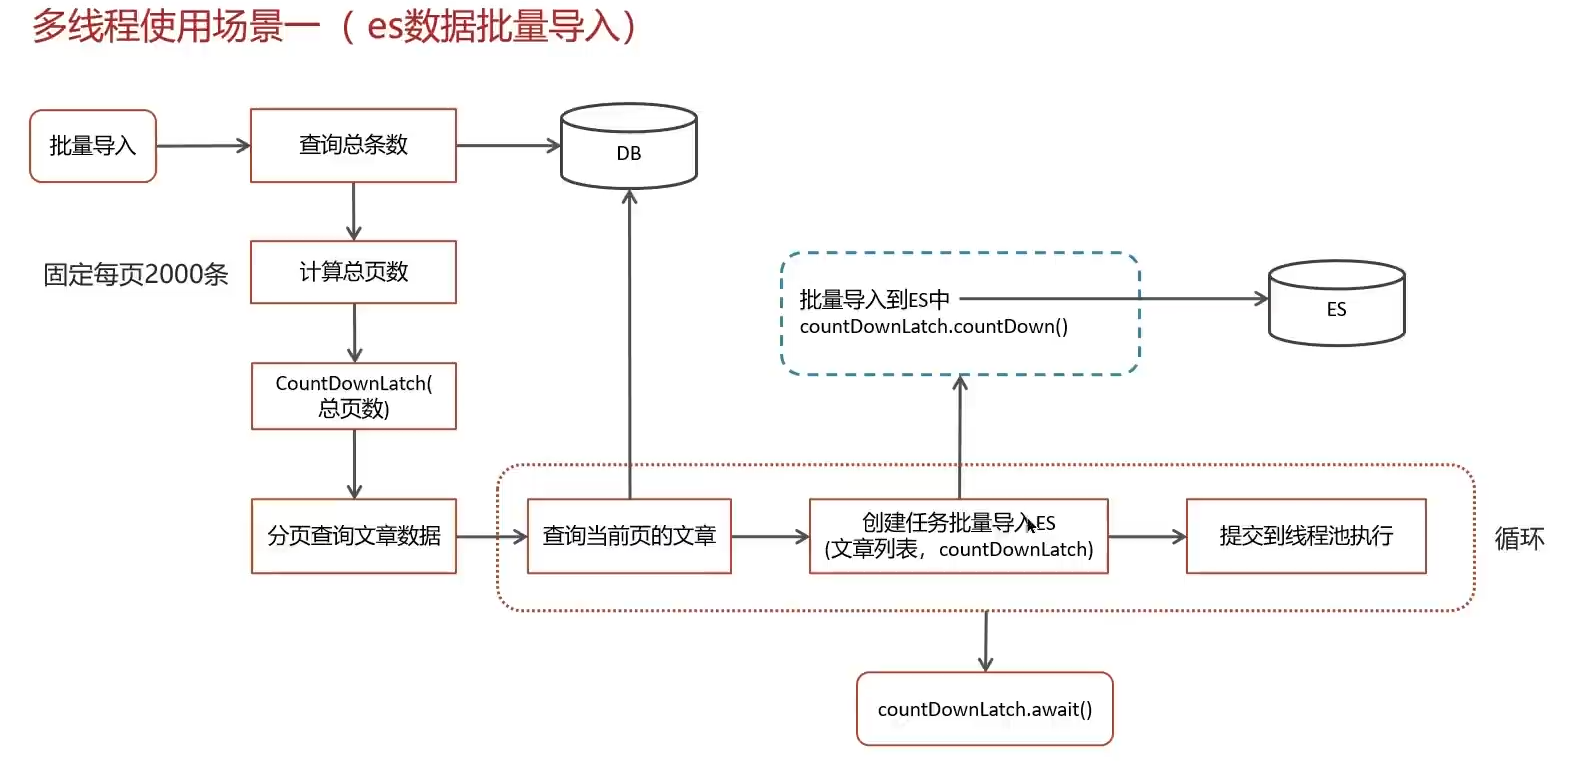
批量导入:使用线程池+CountDownLatch批量就把数据库的数据导入了ES(任意)中,避免OOM
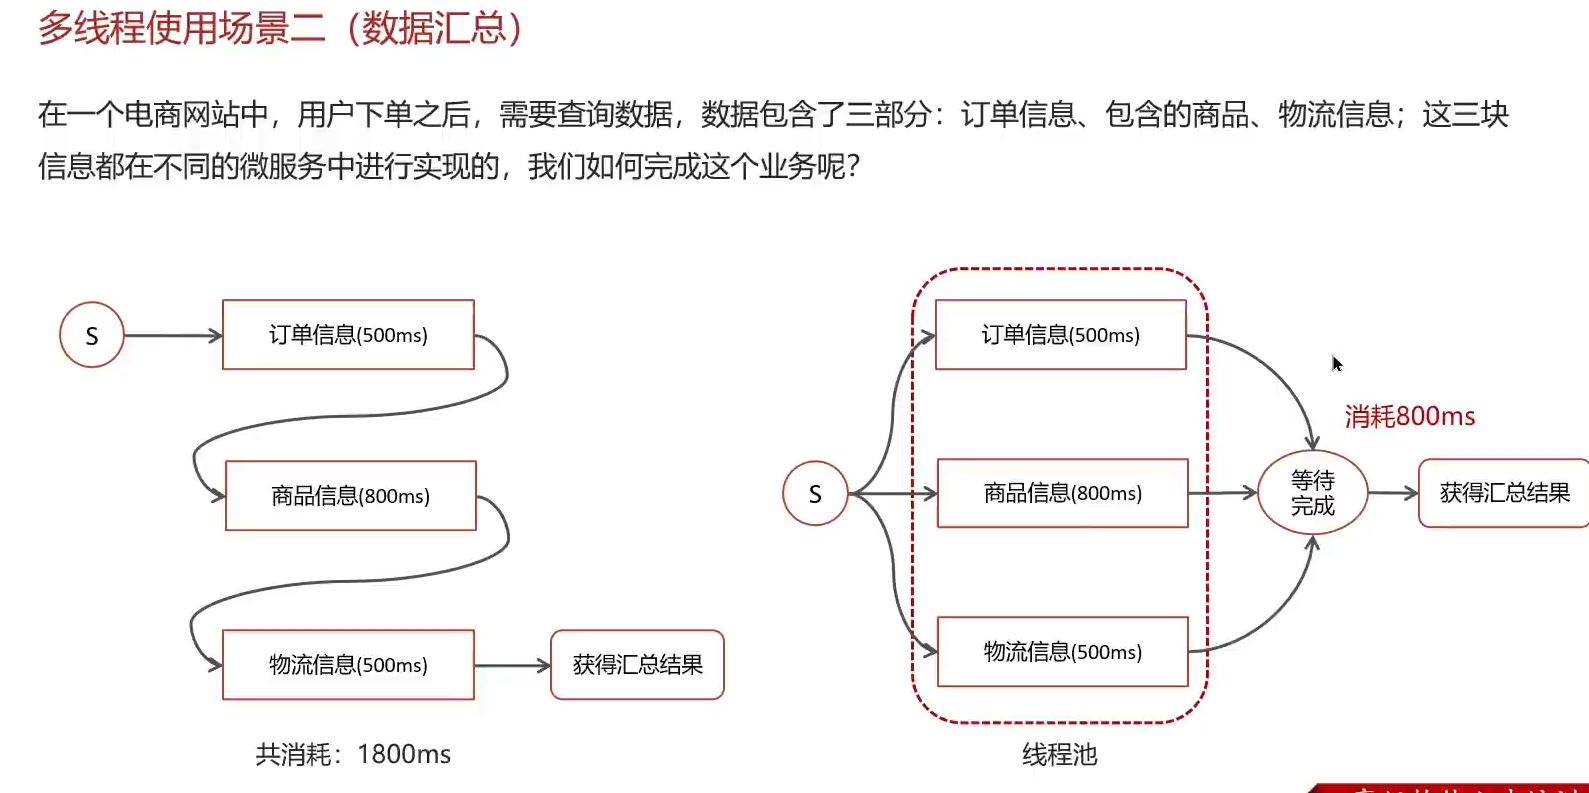
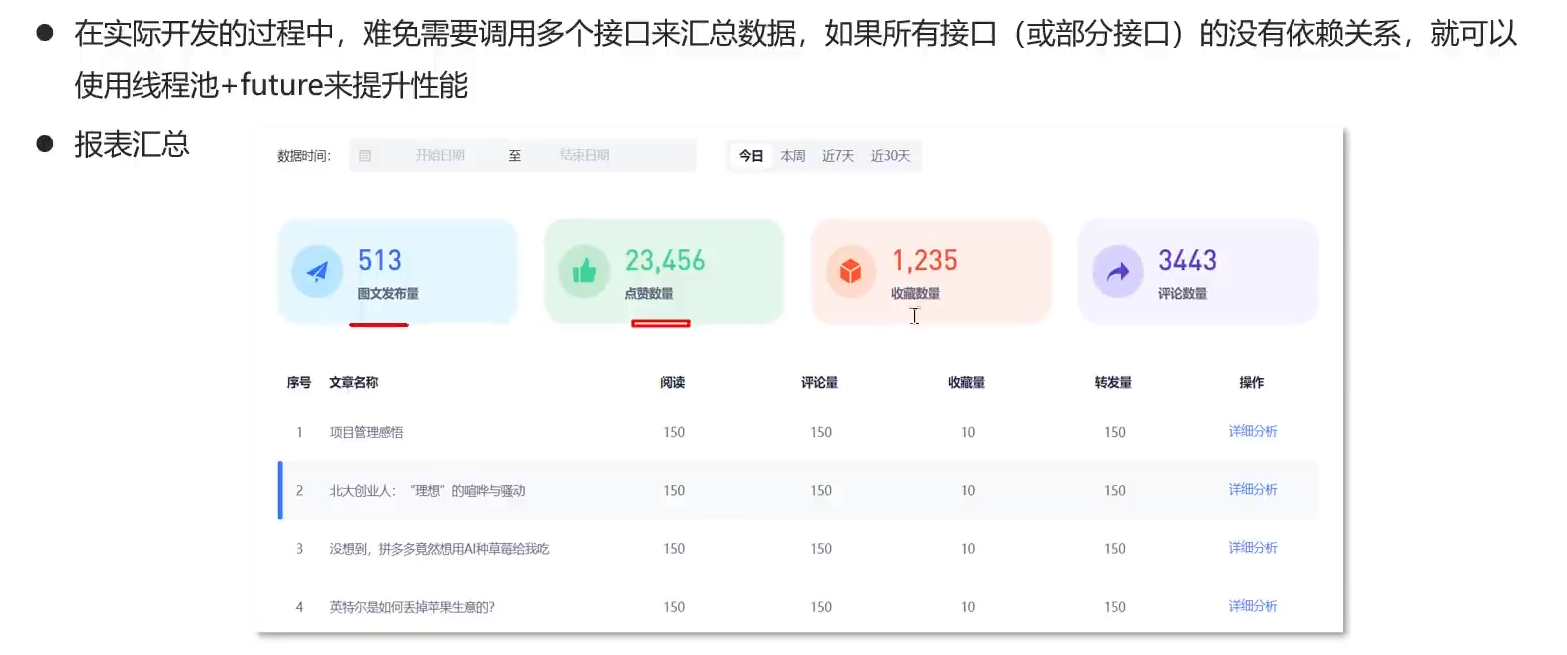
数据汇总:调用多个接口来汇总数据,如果所有接口(或部分接口)的没有依赖关系,就可以使用线程池+future来提升性能
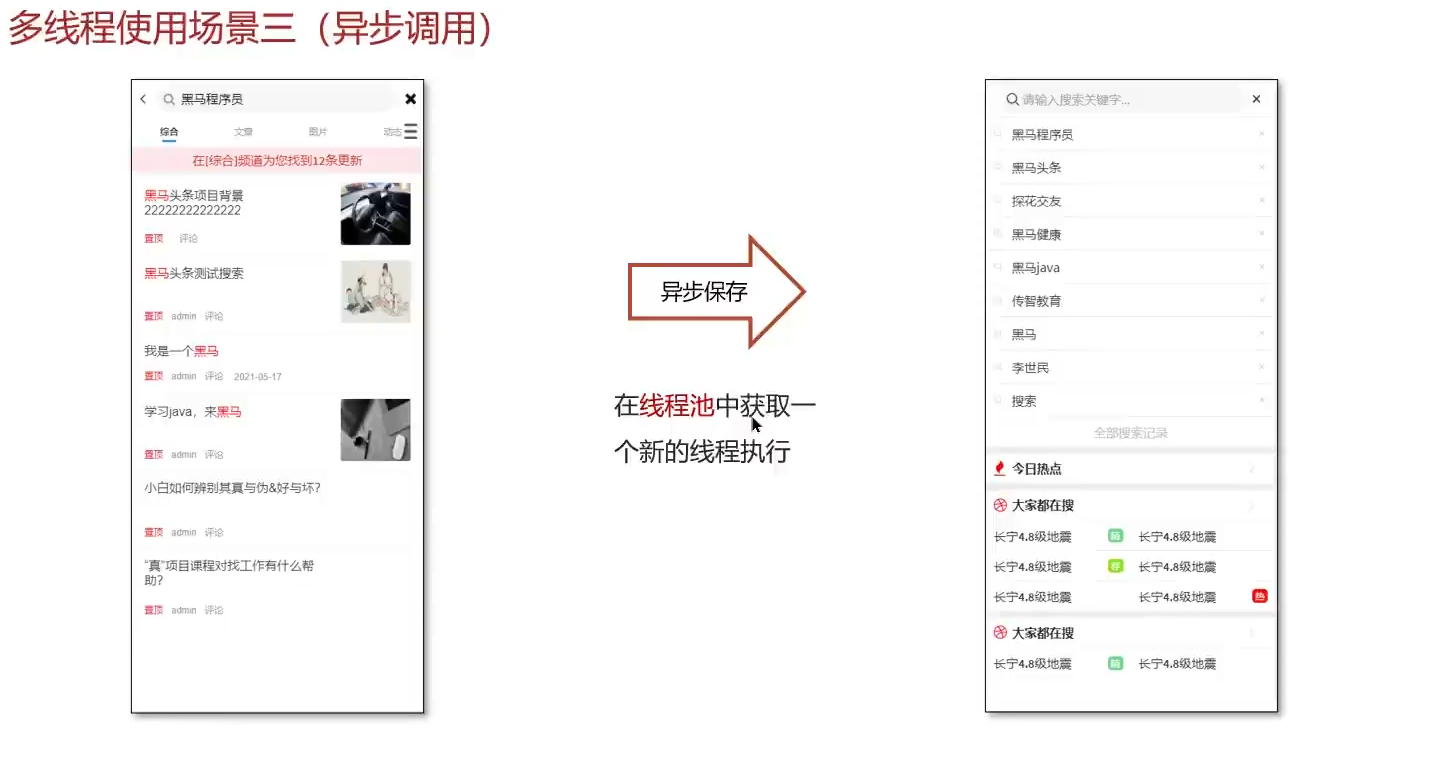
异步线程(线程池):为了避免下一级方法影响上一级方法,可以用异步线程调用下一个方法(不需要下一级方法返回值),可以提升方法响应时间
如何控制某个方法允许并发访问线程的数量:
Semphore信号量,底层是AQS,我们可以通过其限制的线程数量
使用场景:通常用于哪些资源有明确访问数量的场景,常用于限流
使用步骤:
1.创建一个Semaphore对象,可以给一个容量
2.semaphore.acquire():请求一个信号量,这时候的信号量-1(一旦没有可使用的信号量,也即信号量的个数变为负数的时候,再次请求的时候就会阻塞,直到其他线程释放了信号量)
3.semphore.release():释放一个信号量,此时信号量个数+1
ThreadLocal:
ThreadLocal是多线程对于解决线程安全的一个操作类,它会为每个线程都分配一个独立的线程副本从而解决变量并发访问冲突的问题。ThreadLocal实现了线程内的资源共享
谈谈你对ThreadLocal的理解:
1.ThreadLocal可以实现资源对象的线程隔离,让每个线程各用各的资源对象,避免争用引发的线程安全问题
2.ThreadLocal同时实现了线程内的资源共享
3.每个线程内都有一个ThreadLocalMap类型的成员变量,用来存储资源对象
3.1调用set方法,就是以ThreadLocal自己作为key,资源对象作为value,放入当前线程的ThreadLocalMap集合中
3.2调用get方法,就是以ThreadLocal自己作为key,到当前线程中查找相关联的资源值
3.3调用remove方法,就是以ThreadLocal自己作为key,移除当前线程相关联的资源值
ThreadLocal内存泄漏原理:
java对象中的四种引用类型:强引用,软引用,弱引用,虚引用
强引用:
最为普遍的引用方式,表示一个对象处于有用且必须的状态,如果一个对象具有强引用,则GC不会回收它,即使堆内存不足了,并可出现OOM,也不会回收
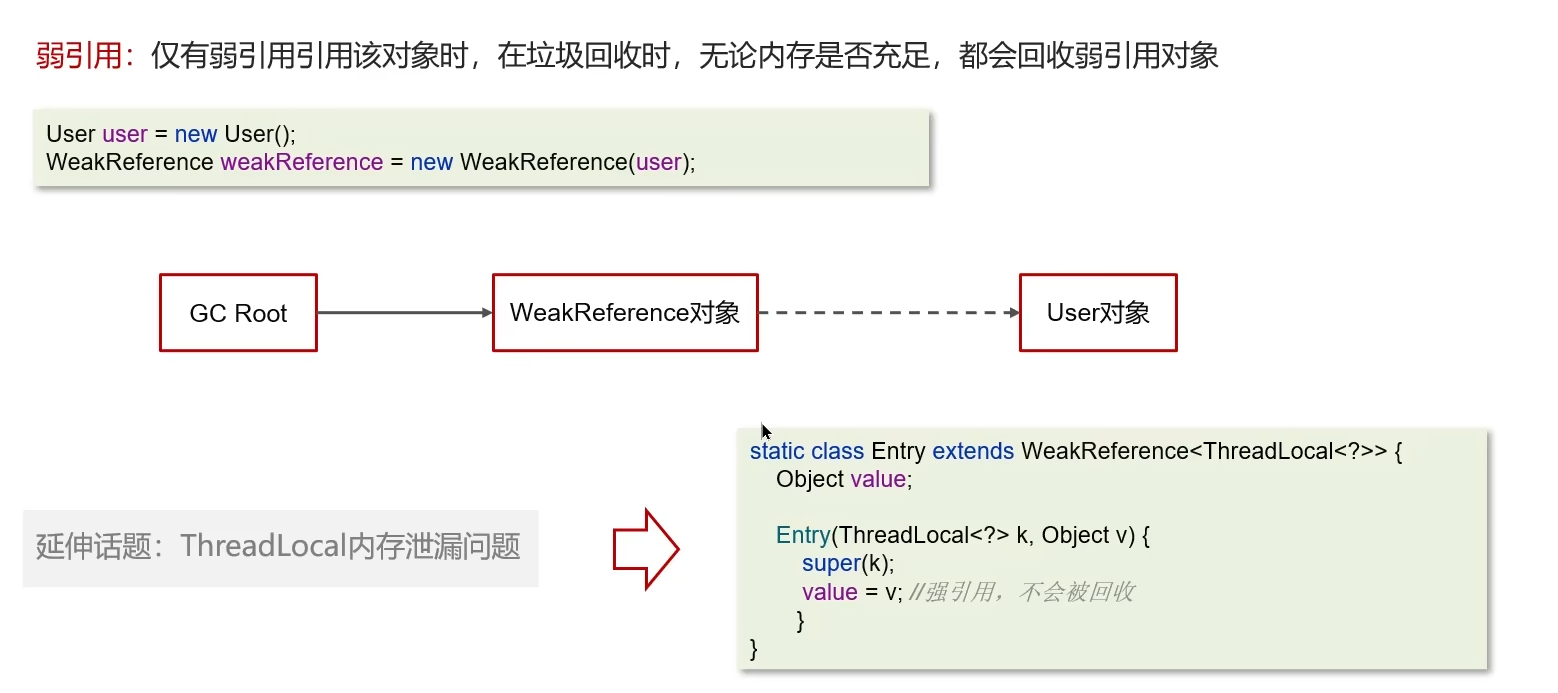
弱引用:
表示一个对象处于可能有用且非必须的状态。在GC线程扫描内存区域的时候,一旦发现弱引用,就会回收到弱引用相关联的对象。对于弱引用的回收,无关内存区域是否足够,一旦发现就会被回收
ThreadLocalMap的key是弱引用,值为强引用;key会被GC释放内存,关联value的内存并不会被释放,建议主动remove释放key,value。
JVM相关面试题:
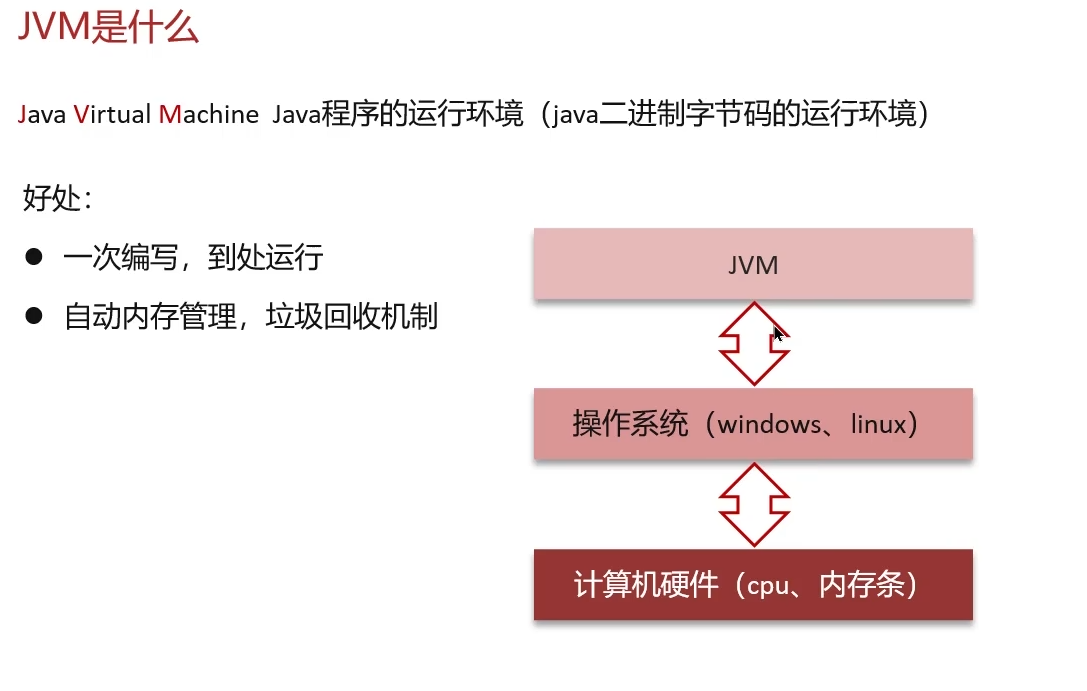
JVM的好处:
1.一次编写,到处运行
2.自动内存管理,垃圾回收机制
程序计数器:
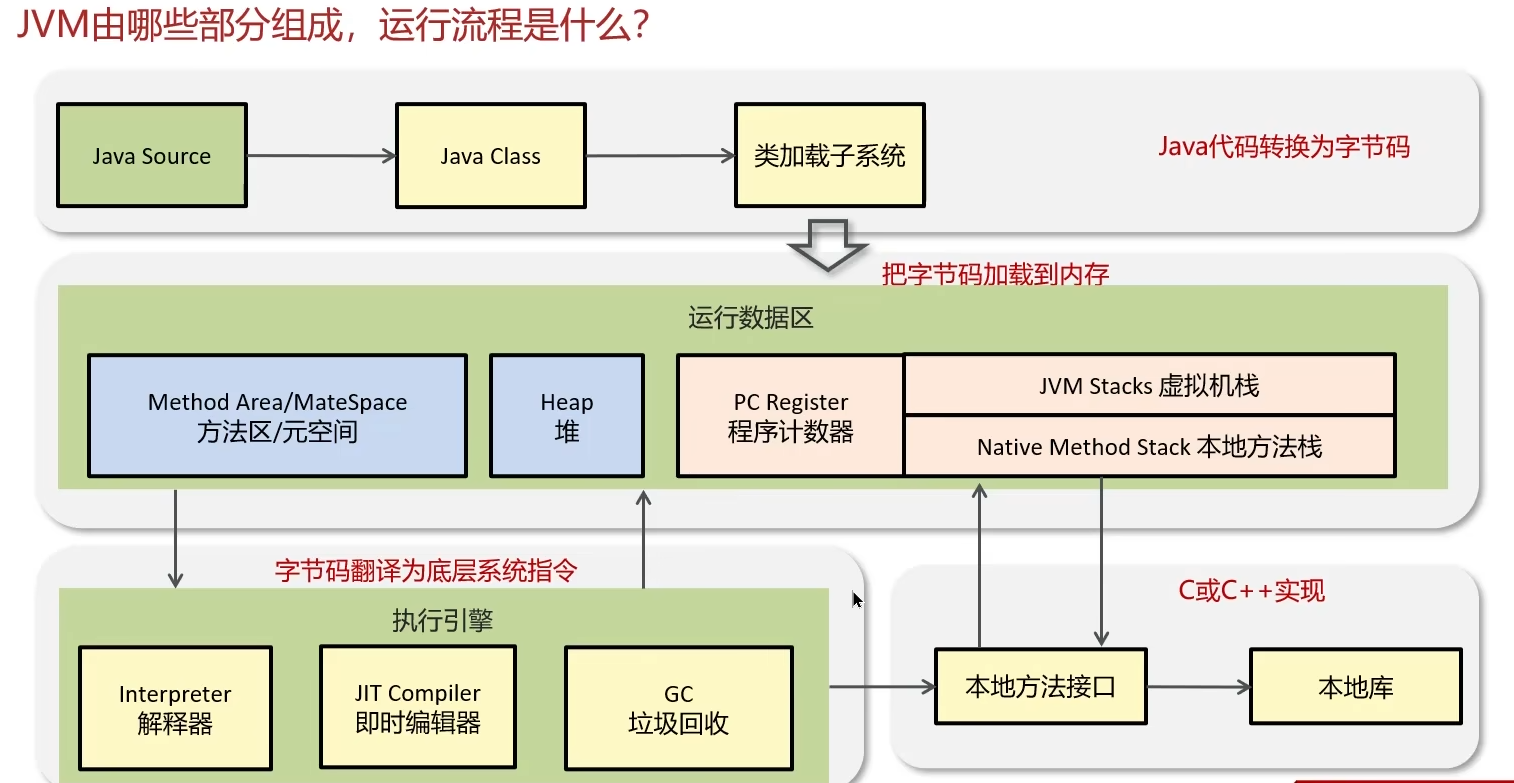
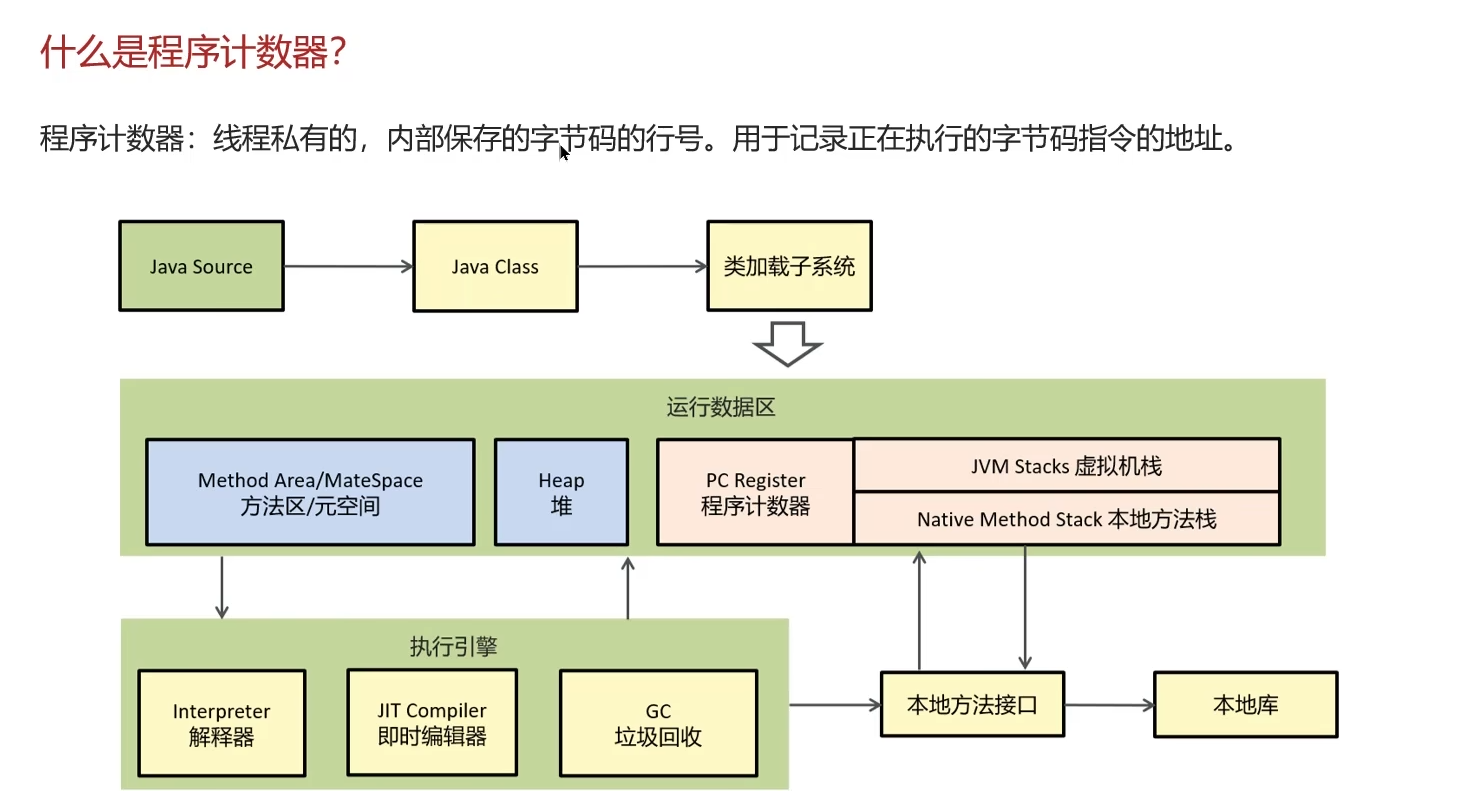
线程私有的,内部保存的字节码的行号。用于保存正在执行的字节码指令的地址
java堆:
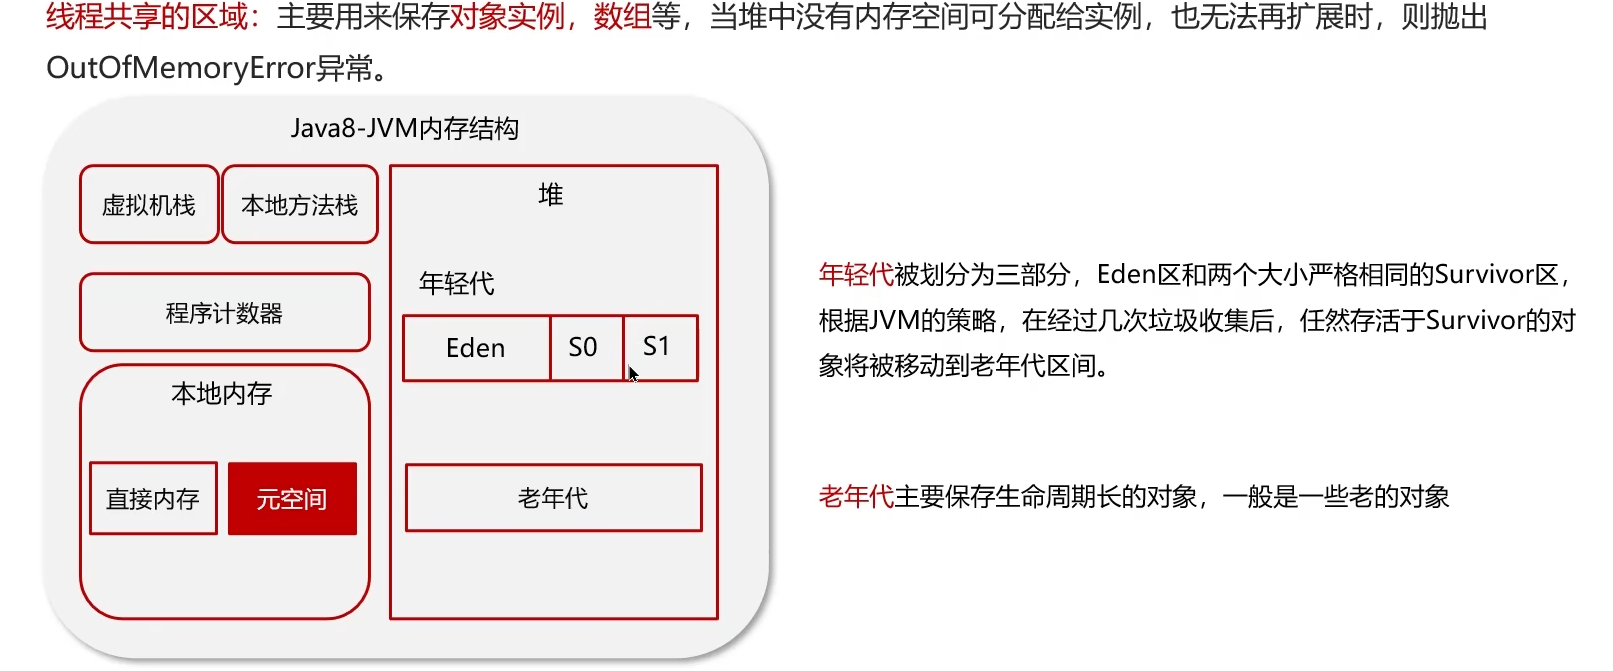
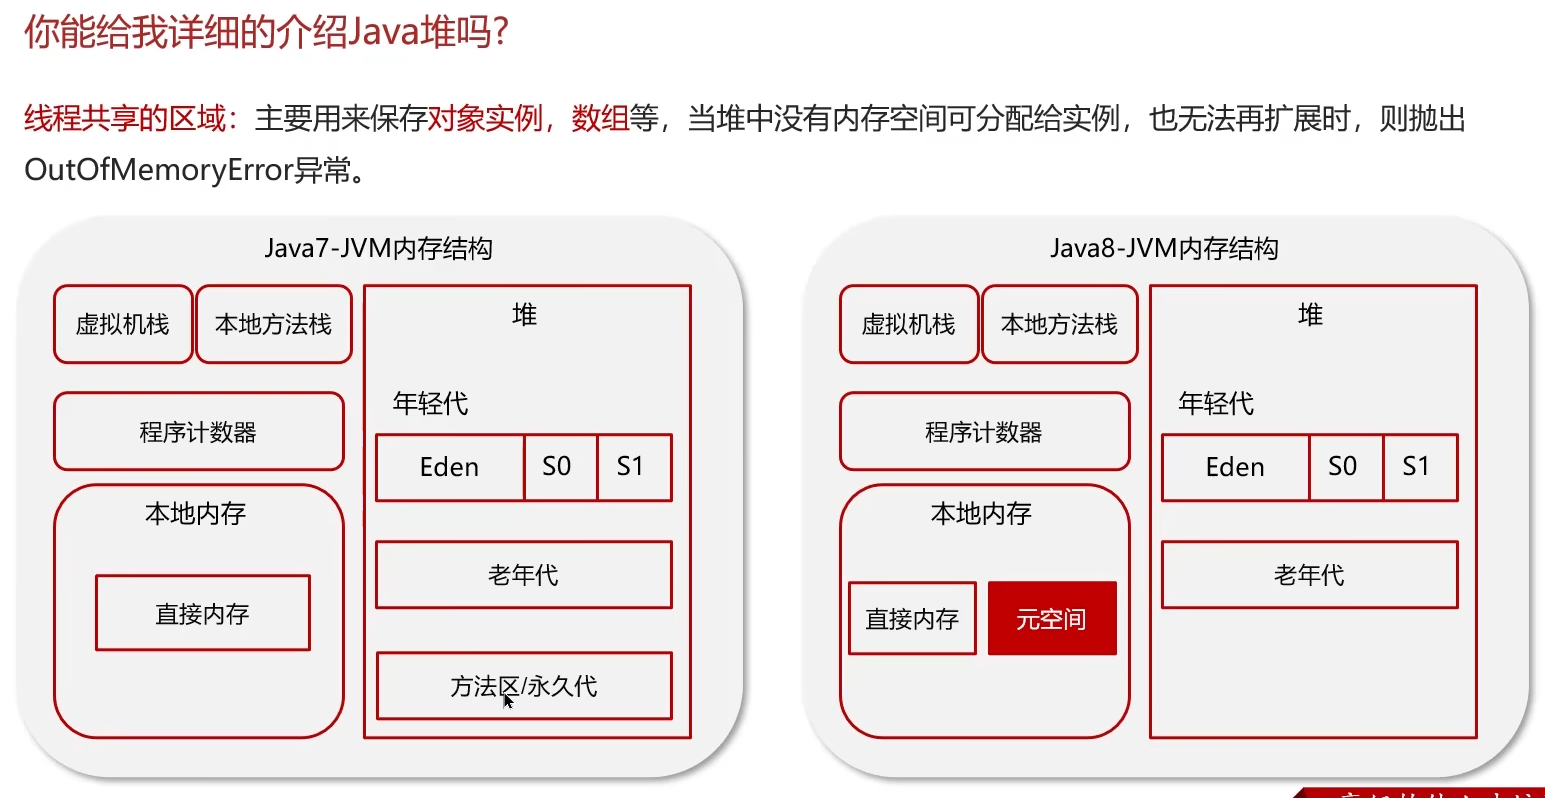
线程共享的区域:主要保存对象实例,数组。当堆中没有内存空间分配给实例,也无法拓展时,则抛出OOM异常
年轻代被划分为三部分,Eden区和两个大小严格的Survivor区,根据JVM的策略,在经过几次垃圾收集后,仍然存活于Survivor的对象将被移动到老年代区间
老年代主要保存生命周期长的对象,一般是一些老的对象
元空间保存的类信息,静态变量,常量,编译后的代码
jdk1.7和1.8的区别:
1.7中有一个永久代,存储的是类信息,静态变量,常量,编译后的代码
1.8移除了永久代,把数据存储到了本地内存的元空间中,防止内存溢出
虚拟机栈:
1. 每个线程运行时所需要的内存,称为虚拟机栈,先进后出
2.每个栈都由多个栈帧组成,对应每次方法调用时所占用的内存
3.每个线程只能有一个活动栈帧,对应着当前正在执行的那个方法
垃圾回收是否涉及栈内存:
垃圾回收主要指的就是堆内存,当栈帧弹栈以后,内存就会释放
栈内存分配越打越好吗:
未必,默认的栈内存通常为1024k
浪费内存
栈帧过大会导致线程数变少。例如,机器总内存512m,目前能活动的线程数则为512个如果把栈内存改为2048k,那么活动的栈帧就会减半
方法的局部变量是否线程安全:
如果方法内局部变量没有逃离方法的作用范围,它是线程安全的
如果是局部变量引用了对象,并逃离方法的作用范围,需要考虑线程安全
栈内存溢出情况:
栈帧过大会导致内存溢出,典型问题:递归调用
栈帧过大会导致栈内存溢出
堆栈的区别是什么:
栈内存一般用来存储局部变量和方法调用,但堆内存是用来存储java对象和数组的。堆会GC垃圾回收,栈不会
栈内存是线程私有的,堆内存是线程共有的
两者异常错误不同,但如果栈内存或堆内存不足都会抛出异常
方法区/元空间:
方法区就是各个线程共享的内存区域
主要存储类的信息,运行时常量池
虚拟机启动的时候创建,关闭虚拟机时释放
如果溢出会抛出OOM异常
常量池:
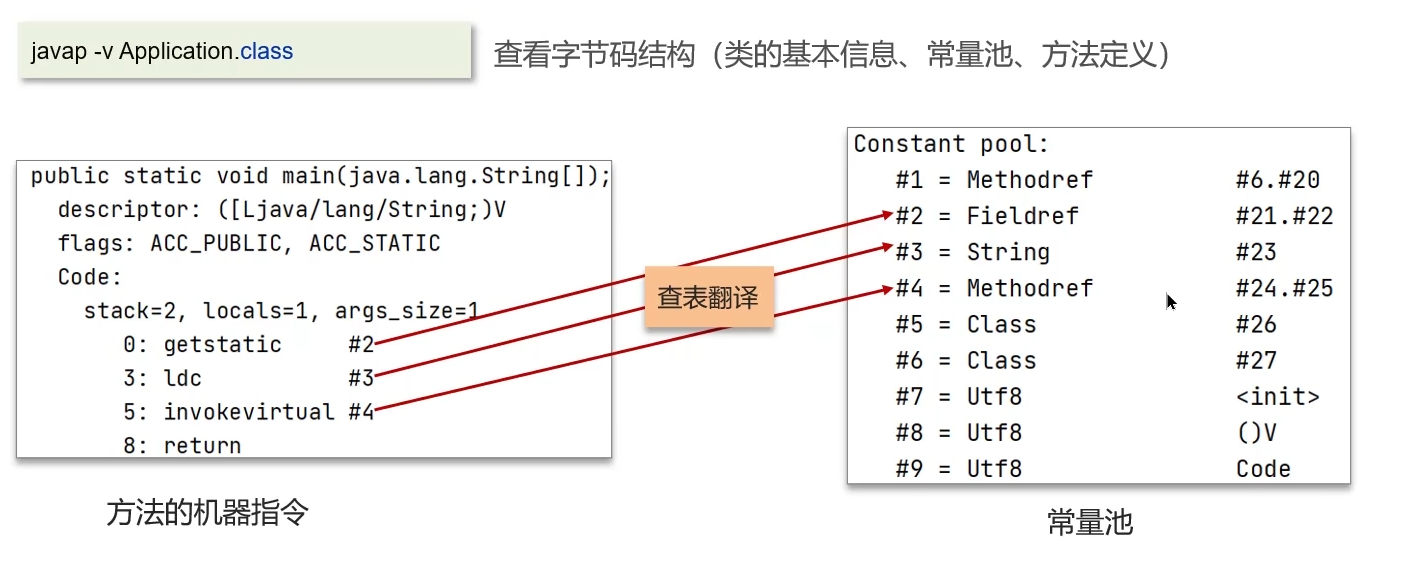
可以当作是一张表,虚拟机指令根据这张常量表找到要执行的类名,方法名,参数类型,字面量等信息
运行时常量池:
常量池是*.class文件中的,当该类被加载,它的常量信息就会放入运行时常量池,并把里面的符号地址变为真实地址
直接内存:
并不属于jvm的内存结构,不由jvm进行管理,是虚拟机的系统内存,常见于NIO操作时,用于数据缓冲区,它回收成本较高,但读写性能高
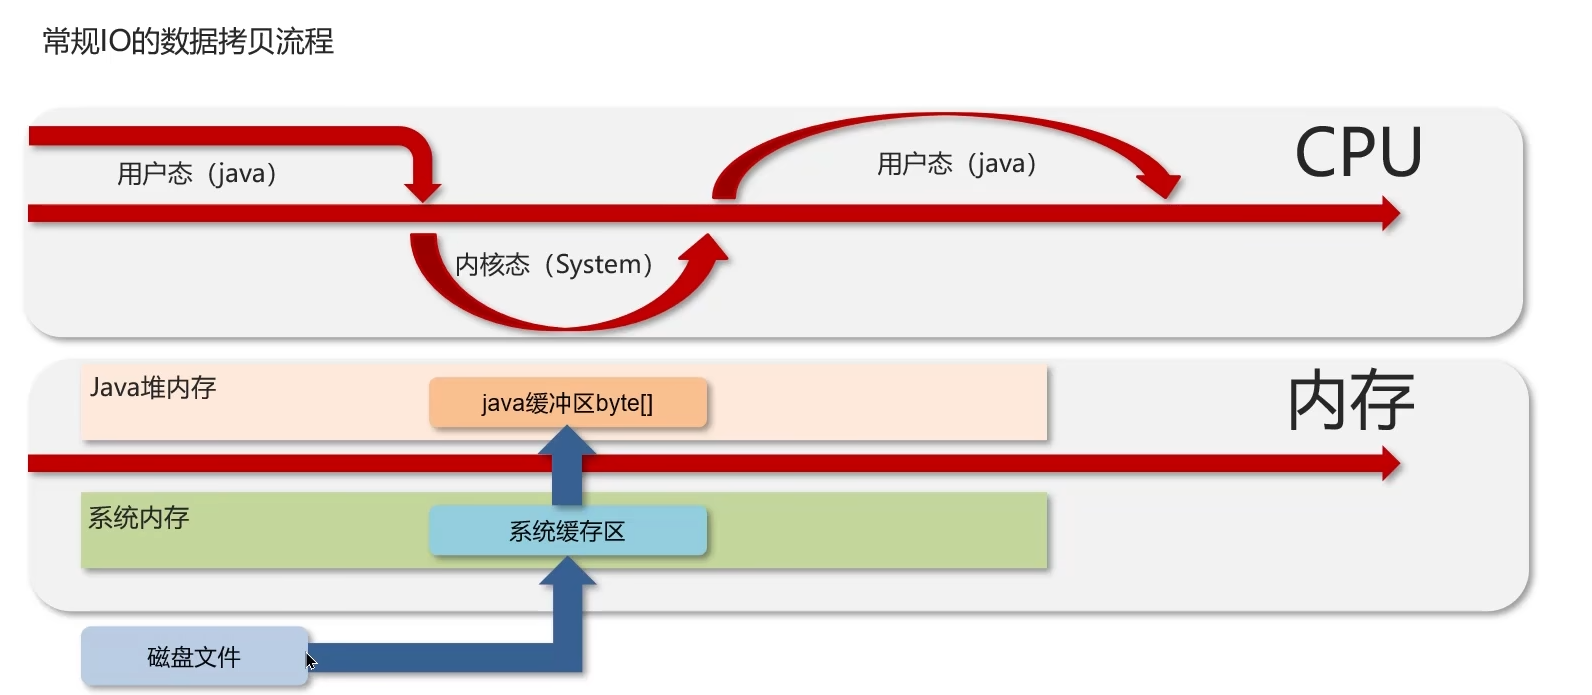
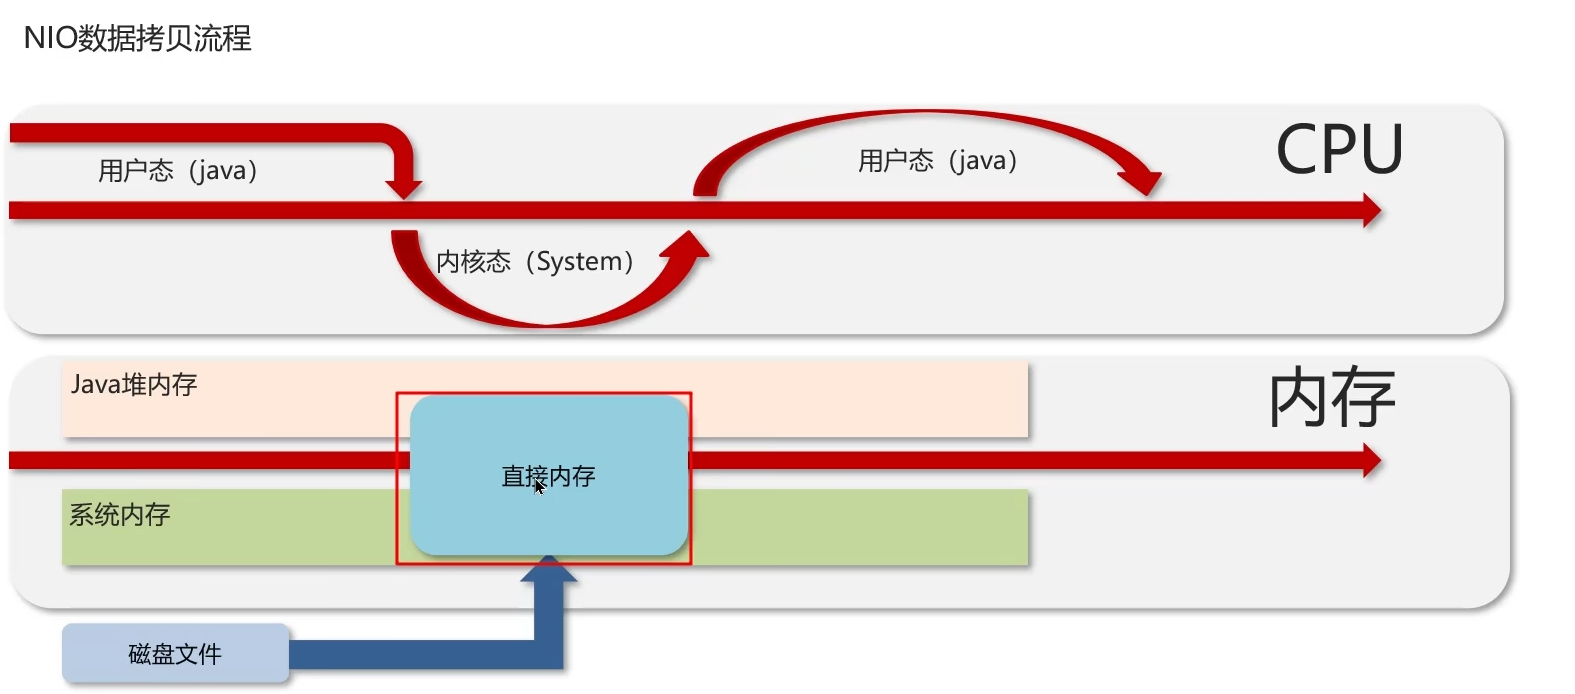
常见于NIO操作时,用于数据缓冲区,分配回收成本较高,但读写性能高,不受jvm内存回收管理
什么是类加载器,类加载器有哪些:
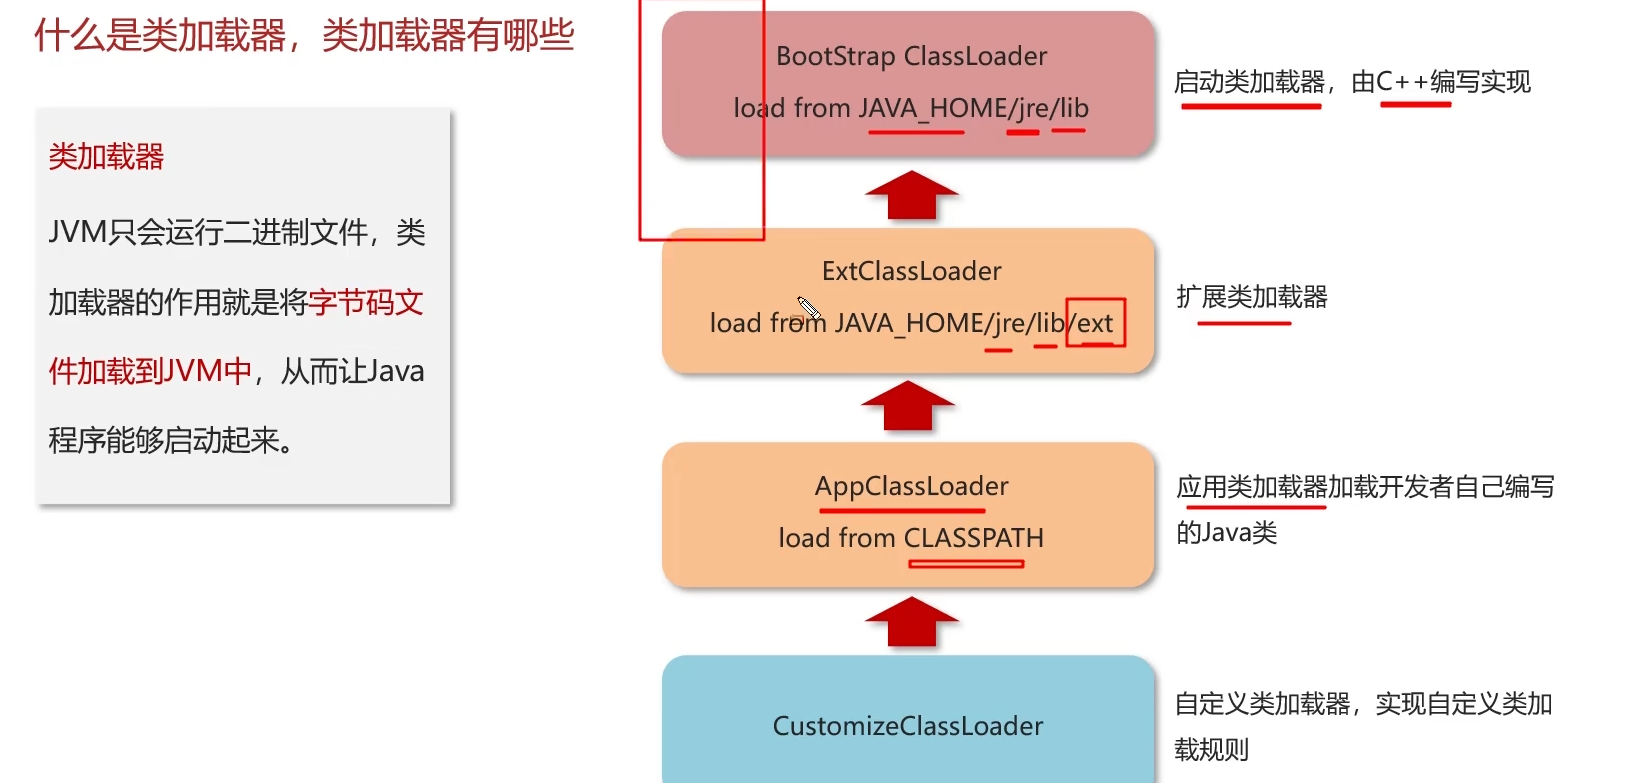
JVM只会运行二进制文件,类加载器的作用就是将字节码文件加载到jvm中,从而让java程序能够启动起来
 双亲委派模型:
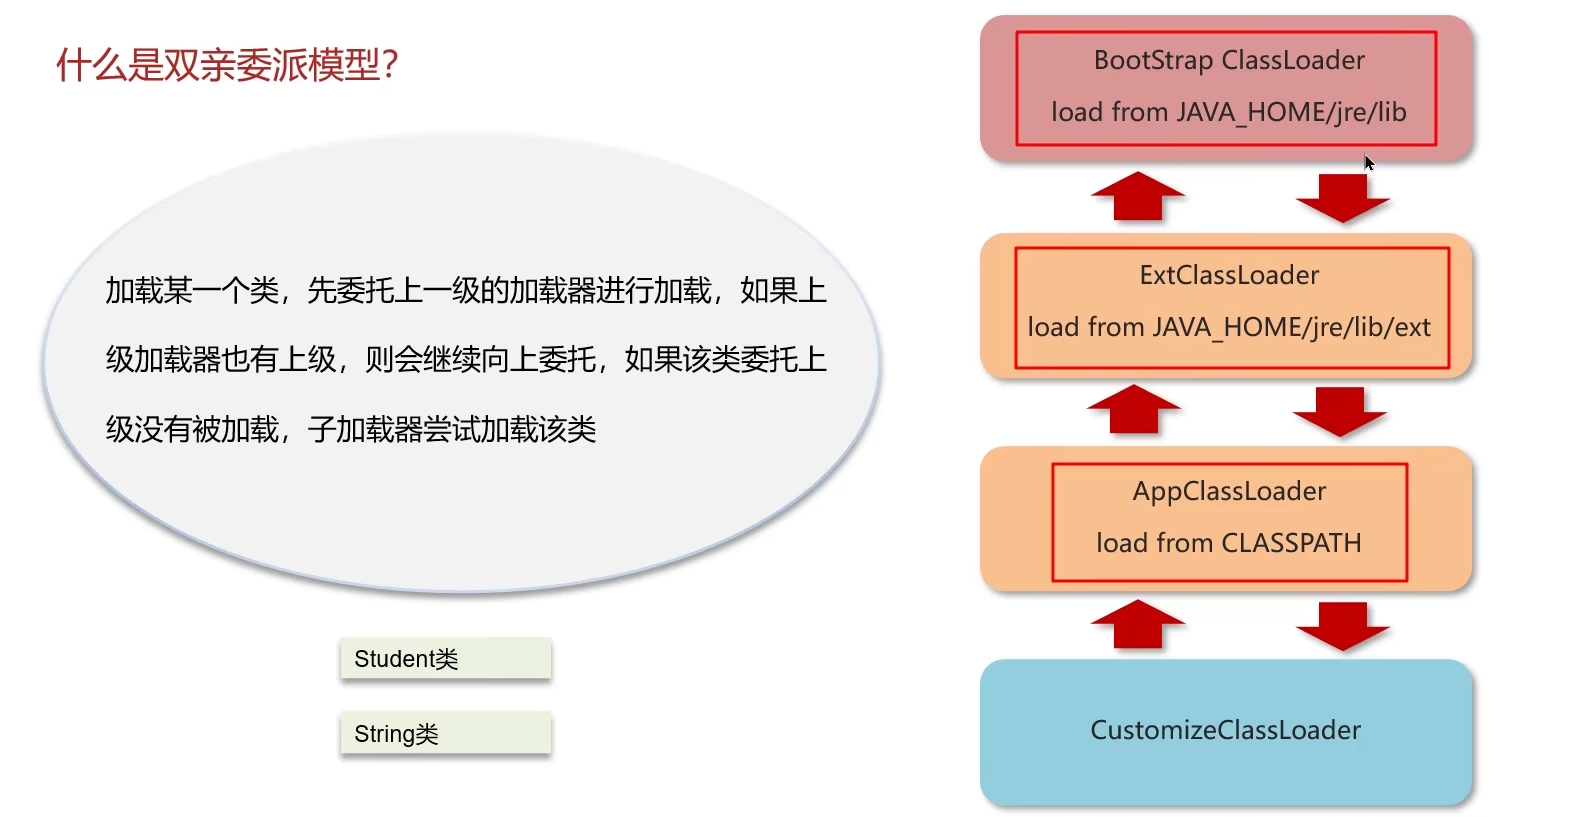
加载某一个类,先委托上一级的类加载器进行加载,如果上级加载器也有上级,则会继续向上委托,如果该类委托上级没有被加载,子加载器尝试加载该类
JVM为什么要采用双亲委派机制:
1.通过双亲委派机制可以避免某一个类被重复加载,当父类已经加载后无须重复加载,保证唯一性
2.为了安全,避免类库API被修改
类装载的执行过程:
类从加载到虚拟机开始,直到卸载为止,它的生命周期包括了:加载,验证,准备,解析,初始化,使用和卸载七个阶段。其中验证,准备,解析统称为连接。
加载:查找和导入class文件
验证:保证加载类的准确性
准备:为类变量分配内存并设置类变量初始值
解析:把类中的符号引用转化为直接引用
初始化:对类的静态变量,静态代码块执行初始化操作
使用:jvm开始从入口方法开始执行用户的程序代码
卸载:当用户程序代码执行完毕后,jvm开始销毁创建的Class对象
对象什么时候能被垃圾器回收:
回收的主要是堆中的对象,如果一个或多个对象没有任何的引用指向它了,那么这个对象现在就是垃圾,如果定位了垃圾,则有可能被垃圾回收器回收。
如果要定位什么是垃圾,有两种方式来确定,一种是引用计数法,一种是可达性分析算法
引用计数法:
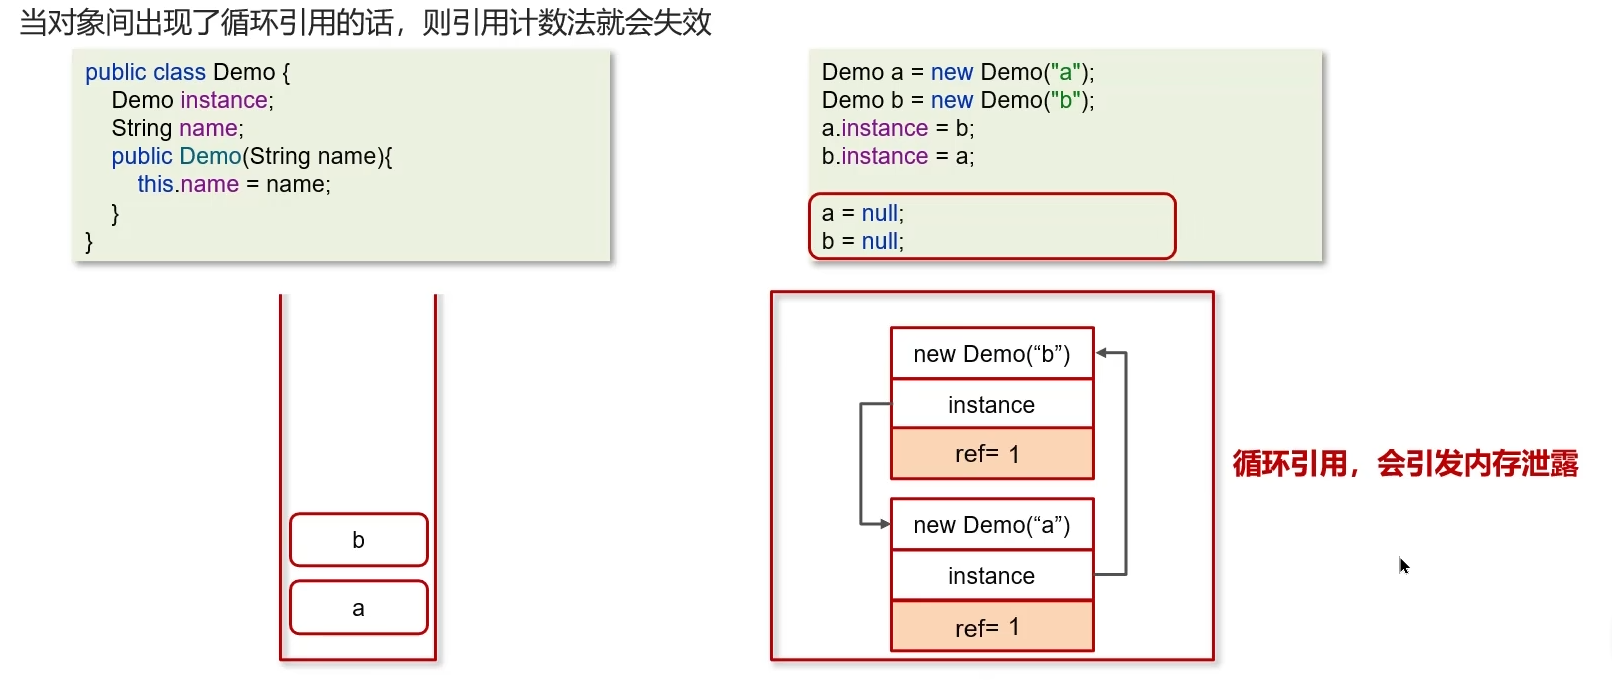
一个对象被引用了一次,在当前的对象头上递增一次引用次数,如果这个对象引用次数为0,代表这个对象可回收
当对象间出现了循环引用的话,引用计数法就会失效会导致内存泄漏。
可达性分析算法:
扫描堆中的对象,看着能否沿着GC Root对象为起点的引用链找到该对象,找不到代表可以回收
哪些对象可以作为GC Root:
1.虚拟机栈(栈帧中的本地变量表)中引用的对象
2.方法区中类静态属性引用的对象
3.方法区中常量引用的对象
4.本地方法栈中JNI引用的方法
JVM垃圾回收算法:
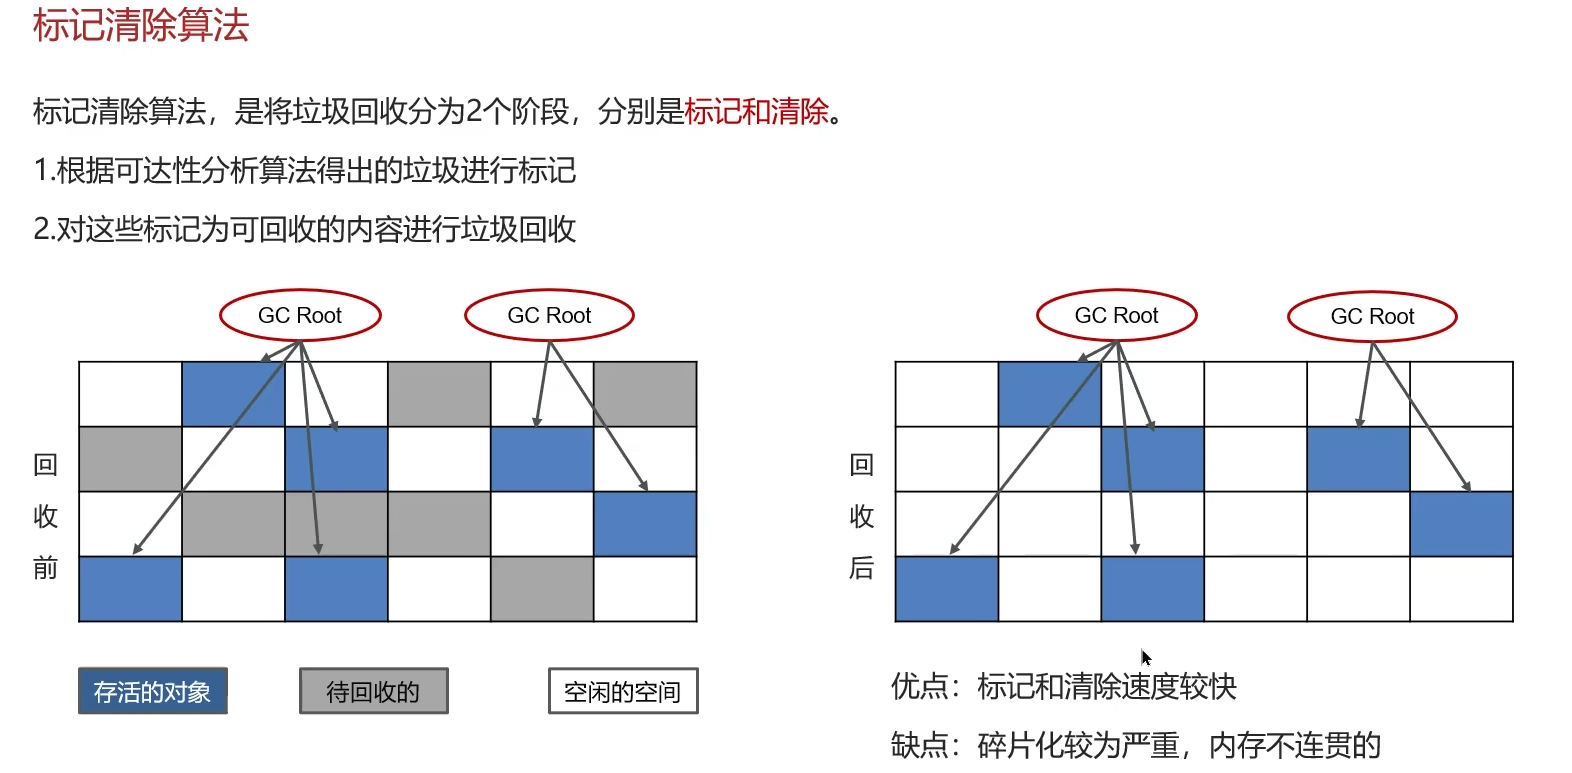
标记清除算法:
标记清楚算法,是将垃圾回收分为两个阶段:
1.根据可达性分析算法得出的垃圾进行标记
2.对这些标记为可回收的内容进行垃圾回收
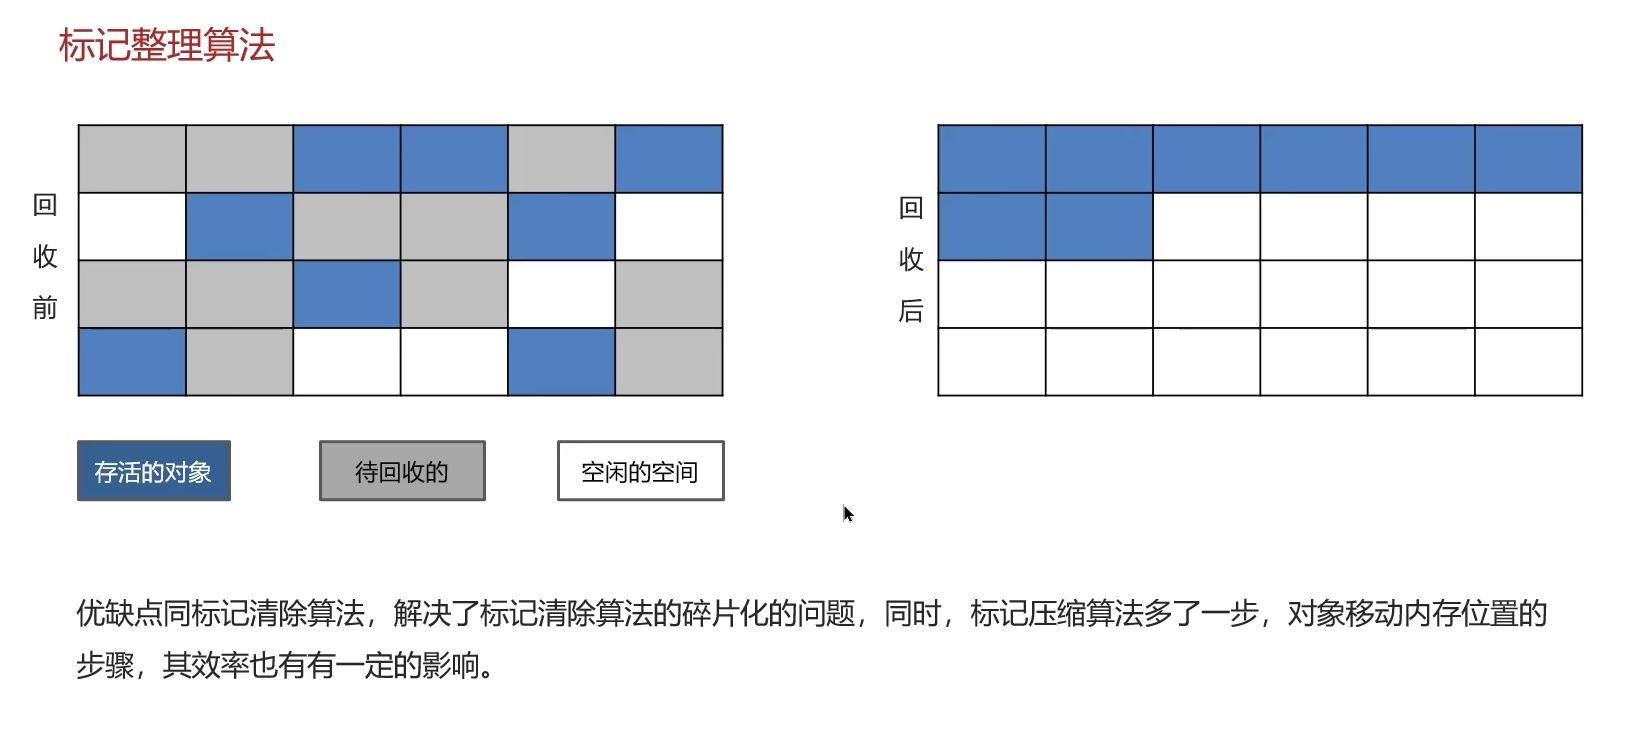
标记整理算法:
标记清除算法一样,将存活的对象都向内存另一端移动,然后清理边界以外的垃圾,无碎片,对象需要移动,效率低
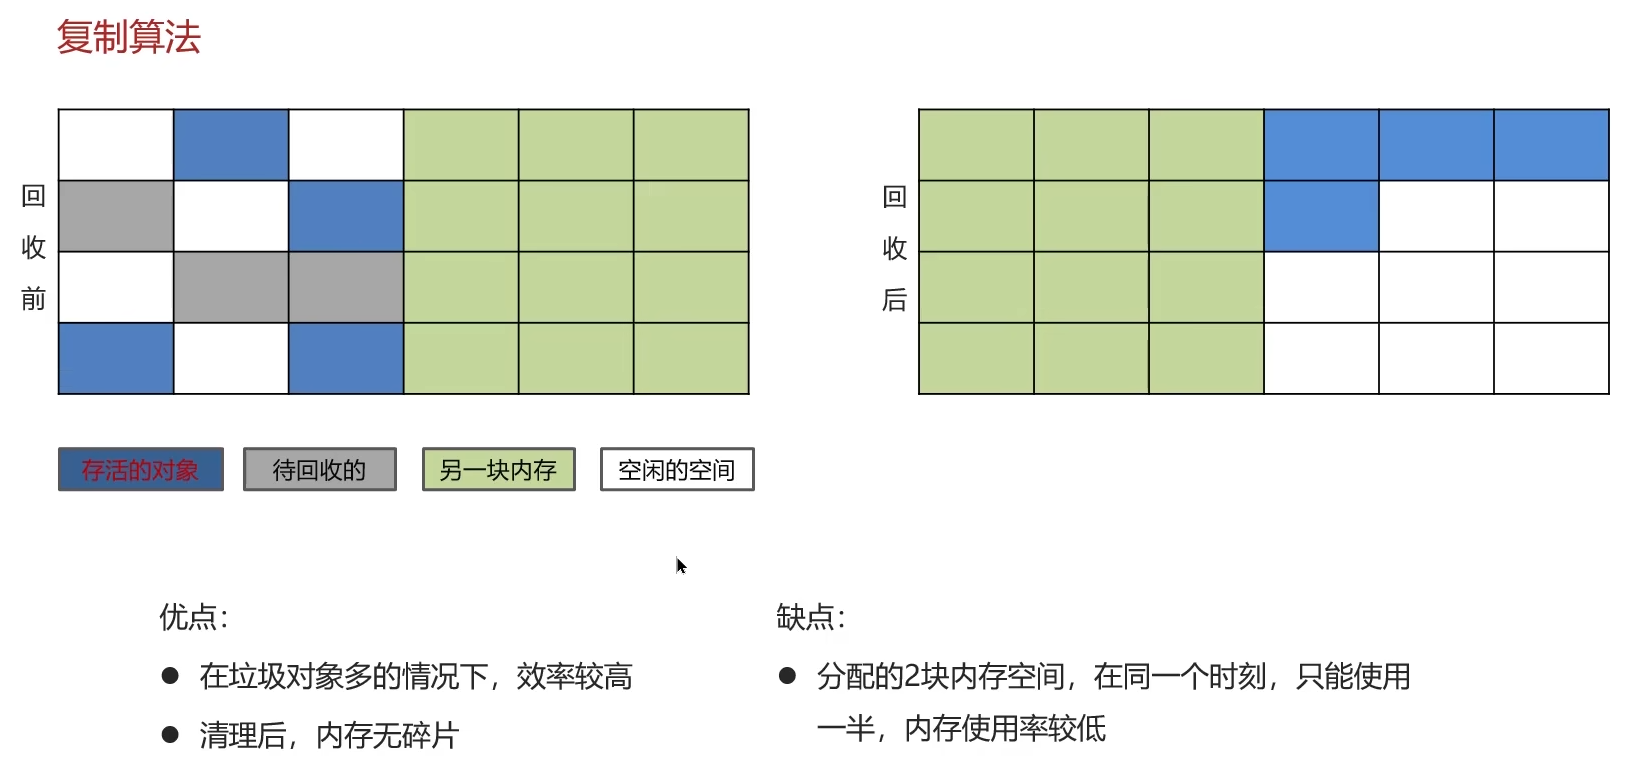
复制算法:
将原有的内存空间一分为二,每次只用其中的一块,正在使用的对象复制到另一个内存空间中,然后将该内存空间清空,交换两个内存的角色,完成垃圾的回收,内存使用率低
分代回收:
分代收集算法:
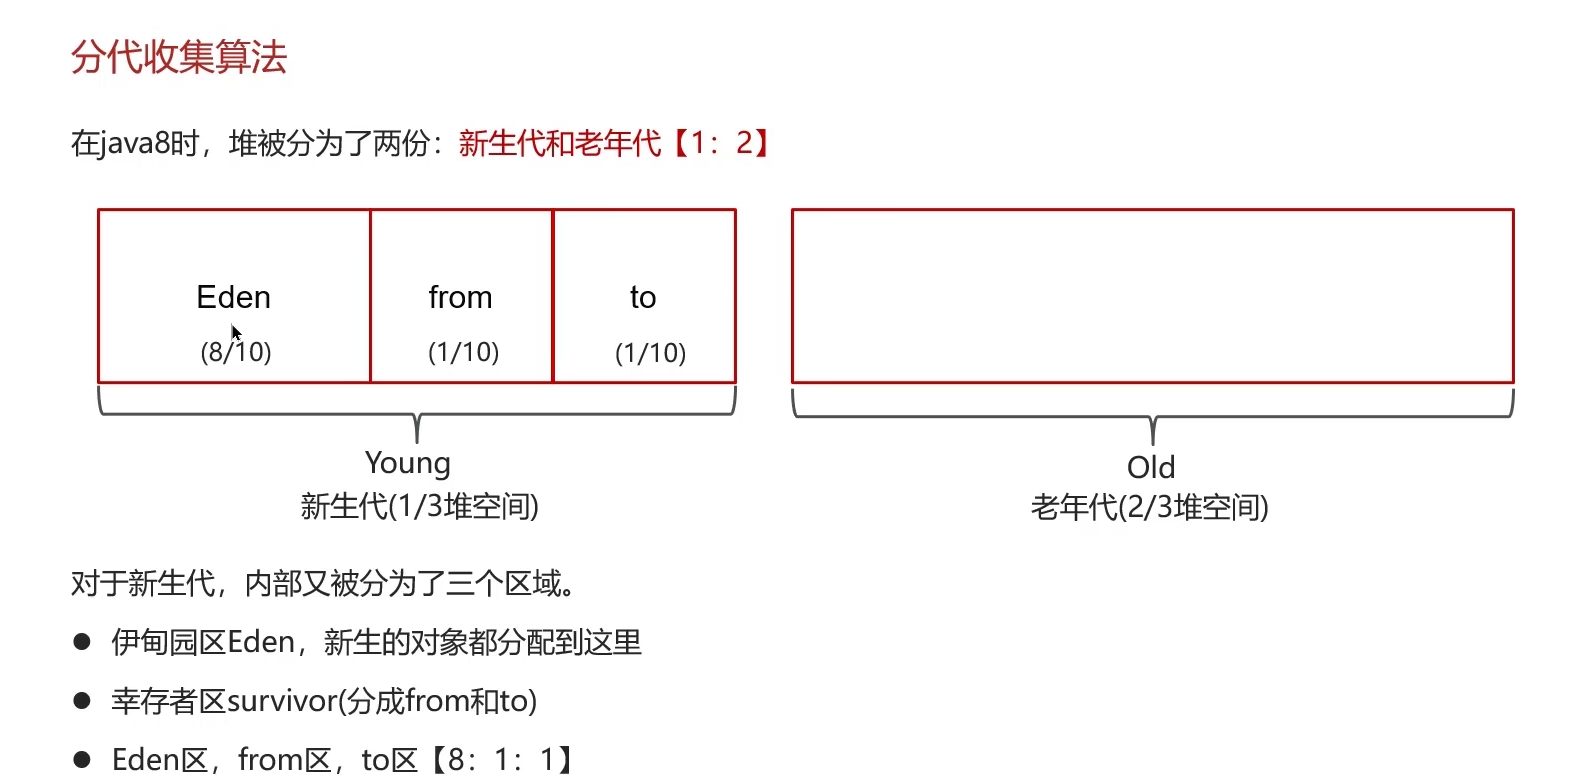
在java8中,堆被分为了两份:新生代和老年代,比例为1:8
对于新生代,内存又分为了三个区域
伊甸园区Eden,新生的对象都分配到这里
幸存者survivor(from,to)
Eden,from区,to区比例为8:1:1
分代收集算法-工作机制:
1.新创建的对象,都会先分配到eden区
2.当伊甸园区内存不足,标记伊甸园区与和from(现阶段没有)的存活对象
3.将存活对象采用复制算法复制到to中,复制完毕后,伊甸园和from内存都得到释放
4.经过一段时间后伊甸园区的内存又出现不足,标记eden区域to存活的对象,将存活的对象复制到from区
5.当幸存者对象熬过几次回收(最多15次),晋身到老年代(幸存区内存不足或大对象会导致提取晋升)
MinorGC,MixedGC,FullGC的区别是什么:
MinorGC【新生代】发生在新生代的垃圾回收,暂停时间短(STW)
MixedGC 新生代+老年代部分区域的垃圾回收,G1收集器持有
FullGC 新生代+老年代完整垃圾回收,暂停时间长(STW),应尽力避免
STW:暂停所有应用程序线程,等待垃圾回收的完成
JVM的垃圾回收器:
串行垃圾回收器:
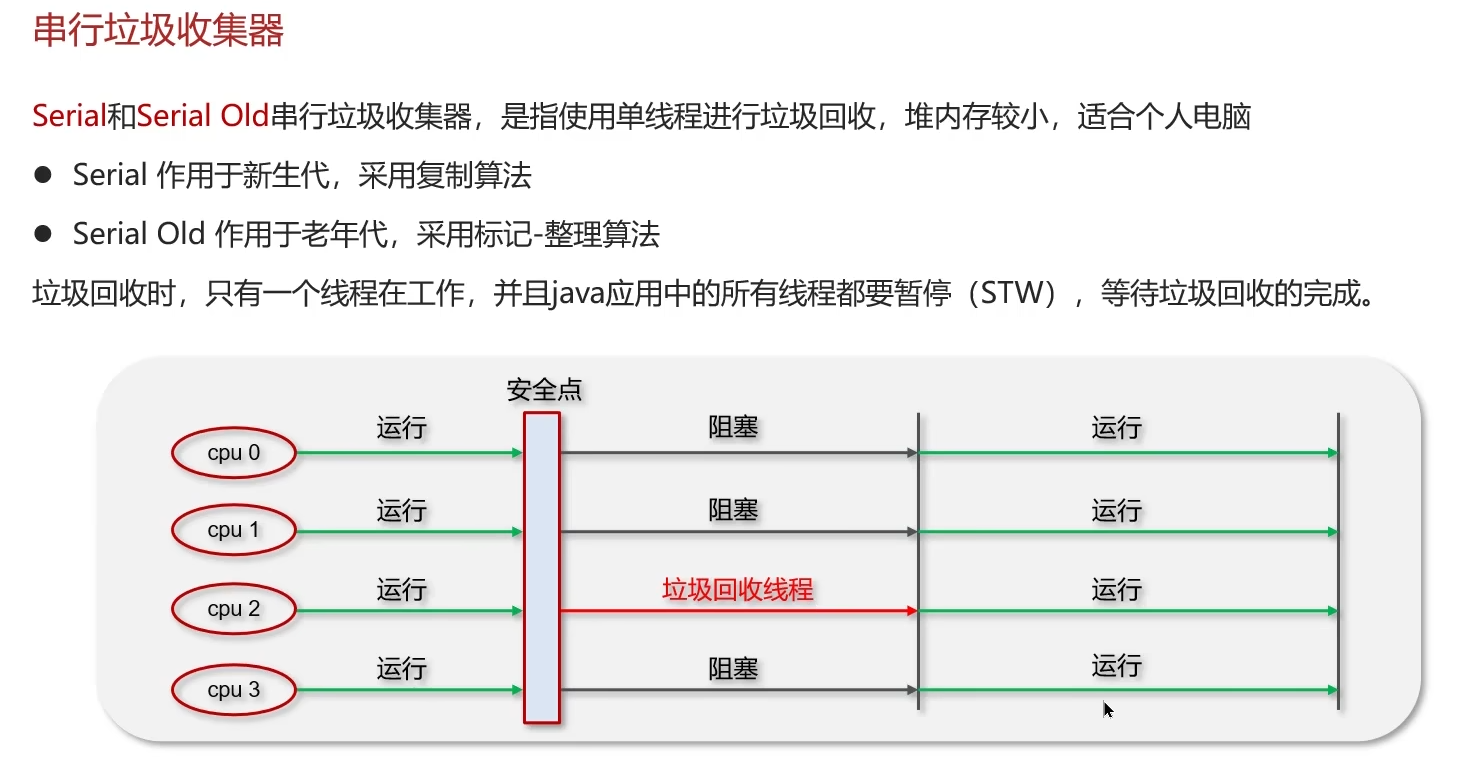
Serial和Serial Old串行垃圾回收器,是指使用单线程进行垃圾回收,堆内存较小,适合个人电脑
Serial作用于新生代,采用复制算法
Serial Old作用于老年代,采用标记-整理算法
垃圾回收时,只有一个线程在工作,并且java应用所有线程都要暂停(STW),等待垃圾回收的完成
并行垃圾收集器:
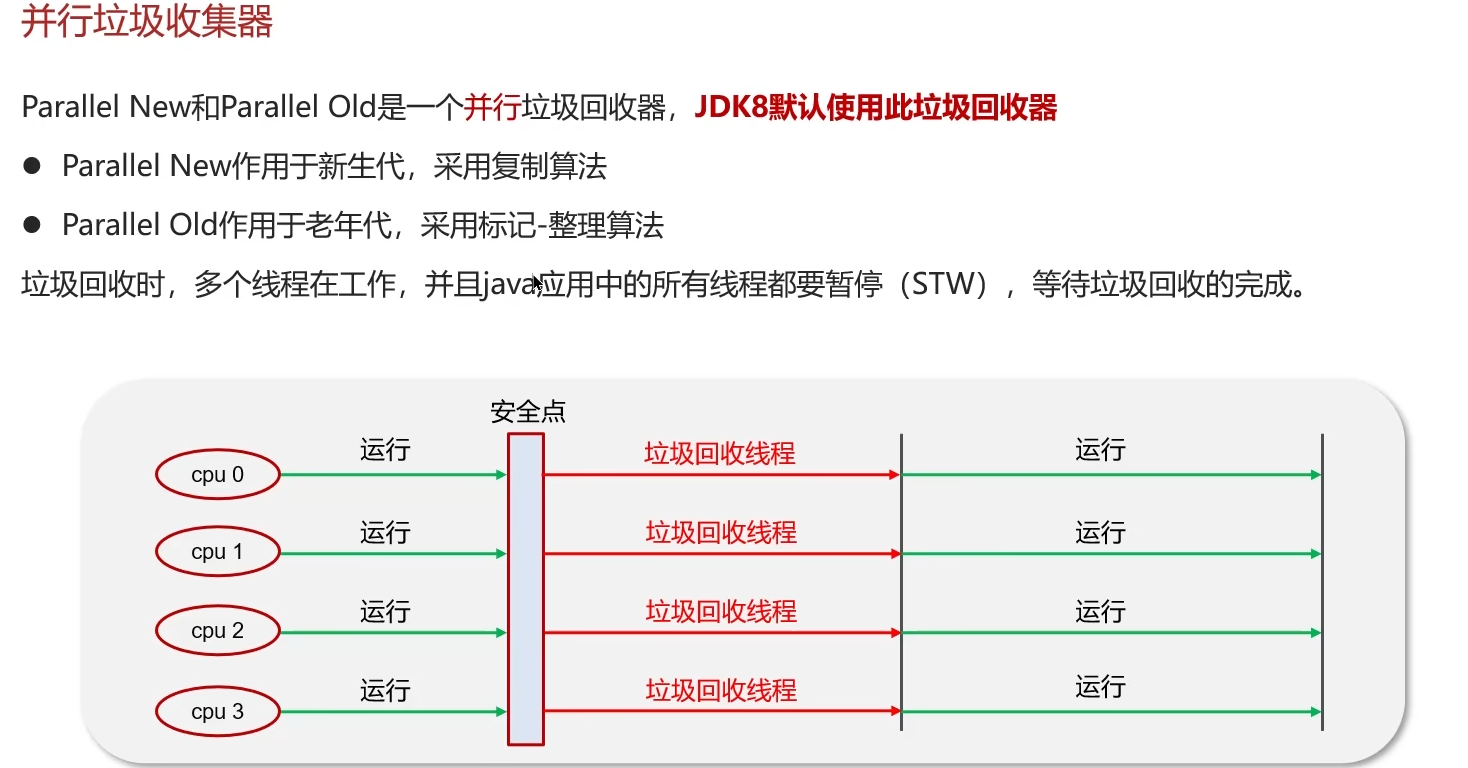
Paraller New和Parallel Old是一个并行垃圾回收器,JDK8默认使用此垃圾回收器
Paraller New作用于新生代,采用复制算法
Paraller Old作用于老年代,采用标记-整理算法
垃圾回收时,多个线程在工作,并且java应用中的所有线程都要暂停(STW),等待垃圾回收的完成
CMS(并发)垃圾回收器:
CMS是一款并发的,使用标记-清除算法的垃圾回收器,该回收器是针对老年代垃圾回收的,是一款获取最短回收停顿时间为目标的收集器,停顿时间短,用户体验好,最大特点是在进行垃圾回收的时候,应用仍然能正常运行
G1垃圾回收器:
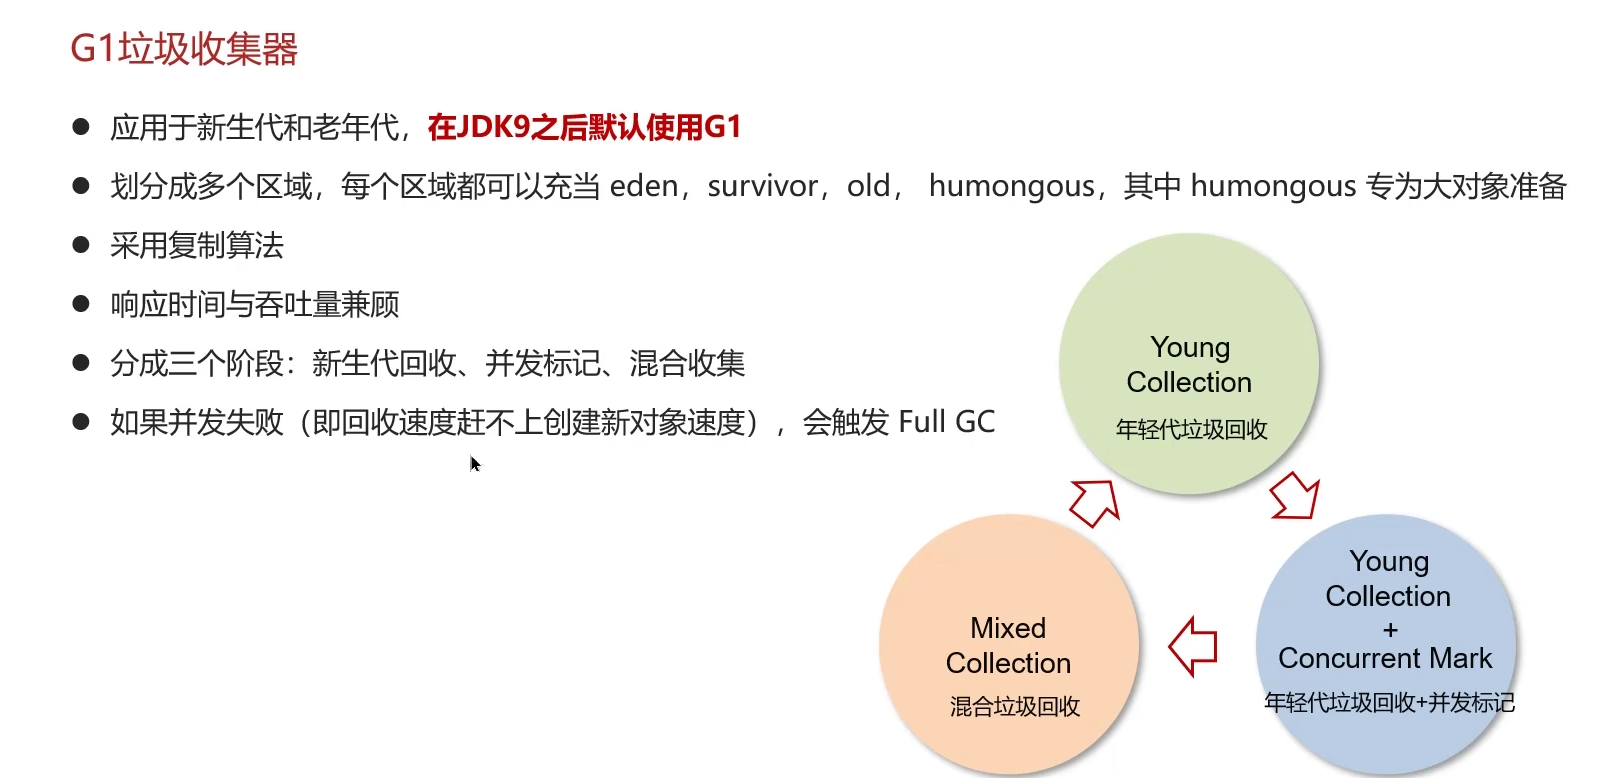
应用于新生代和老年代,在JDK9之后默认使用G1
默认划分成多个区域,每个区域都可以充当eden,survivor,old,humongous,其中humongous专为大对象准备
采用复制算法
响应时间和吞吐量兼顾
分为三个阶段:新生代回收,并发标记,混合收集
如果并发失败(即回收速度赶不上创建新对象速度),会触发Full GC
Young Collection(年轻代垃圾回收):
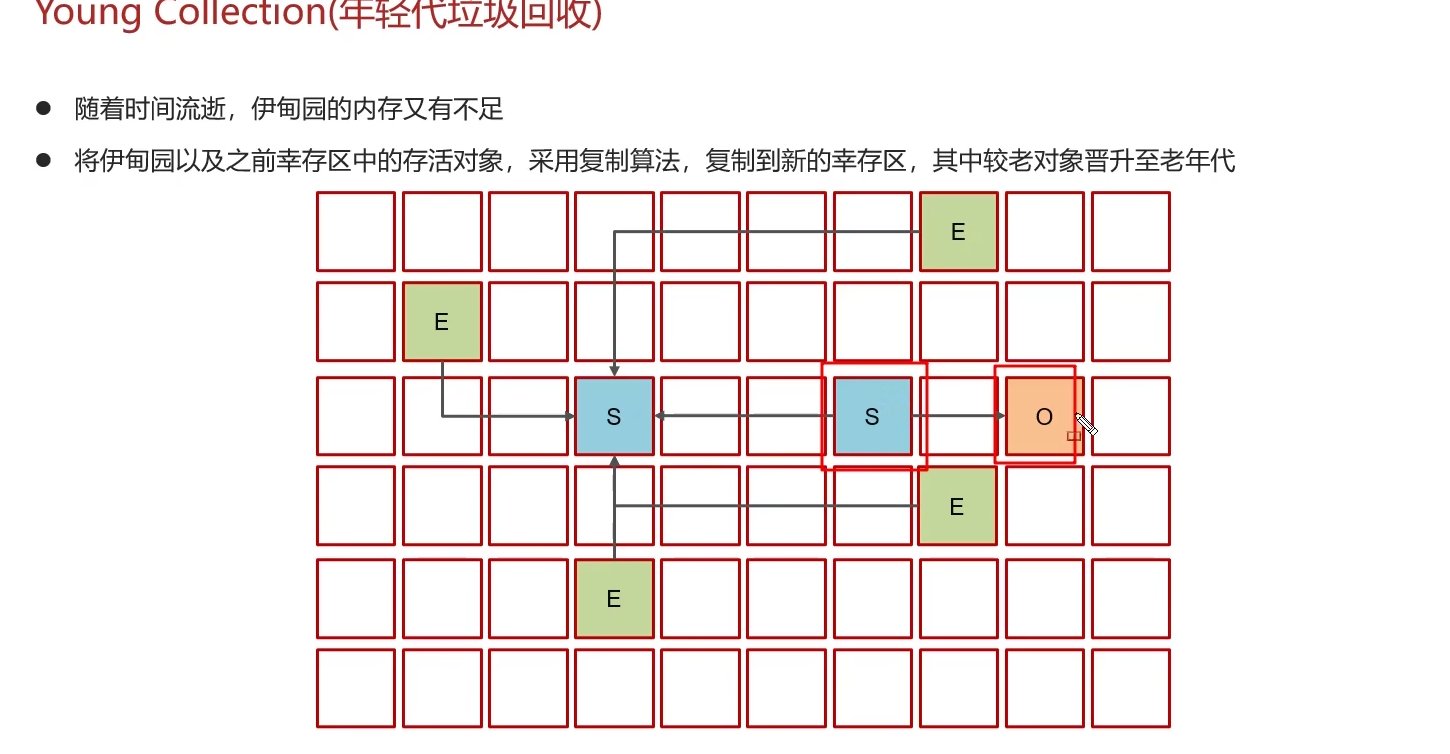
初始化,所有区域都处于空闲状态
创建了一些对象,挑选一些空闲区域作为伊甸园区存储这些对象
当伊甸园区需要垃圾回收时,挑出一些空闲区域作为幸存者,用复制算法存活对象,需要暂停用户线程
随着时间流逝,伊甸园的内存又有不足
将伊甸园以及之前幸存区的存活对象,采用复制算法,复制到新的幸存区,其中较老对象晋升至老年代
Young Collection +Concurrent Mark(年轻代垃圾回收+并发标记):
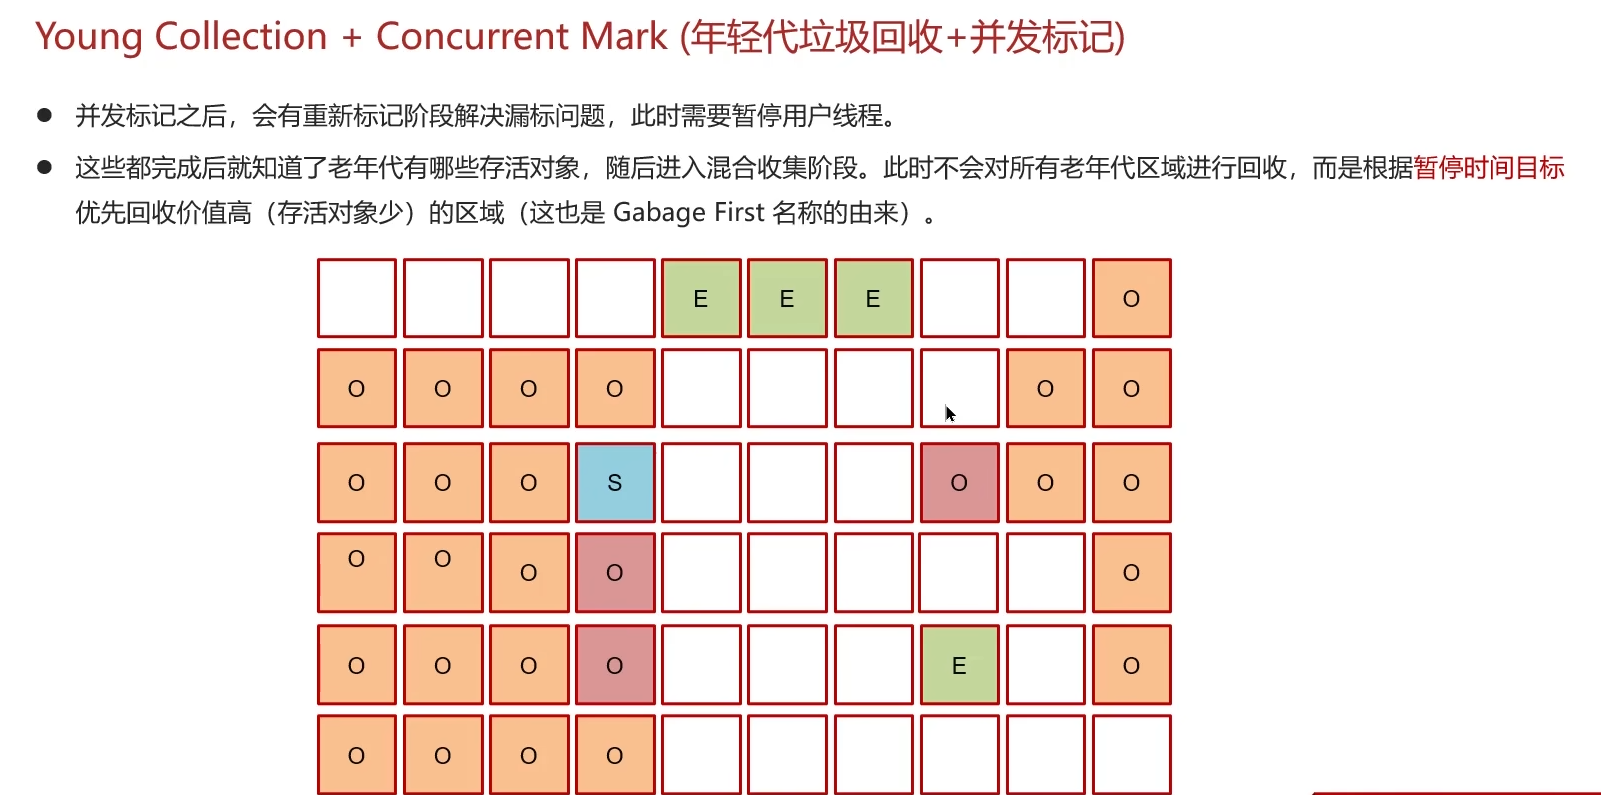
当老年代占用内存超过阈值(默认是45%),触发并发标记,这时无需暂停用户线程
并发标记之后,会有重新标记阶段解决漏标问题,此时需要暂停用户线程
这些都完成了之后就知道了老年代有哪些存活对象,随后进入混合收集阶段。此时不会对所有老年代区域进行回收,而是暂停时间目标优先回收价值高(存活对象少)的区域(这也是 Gabage First 名称的由来)
Mixed Collection(混合垃圾回收):
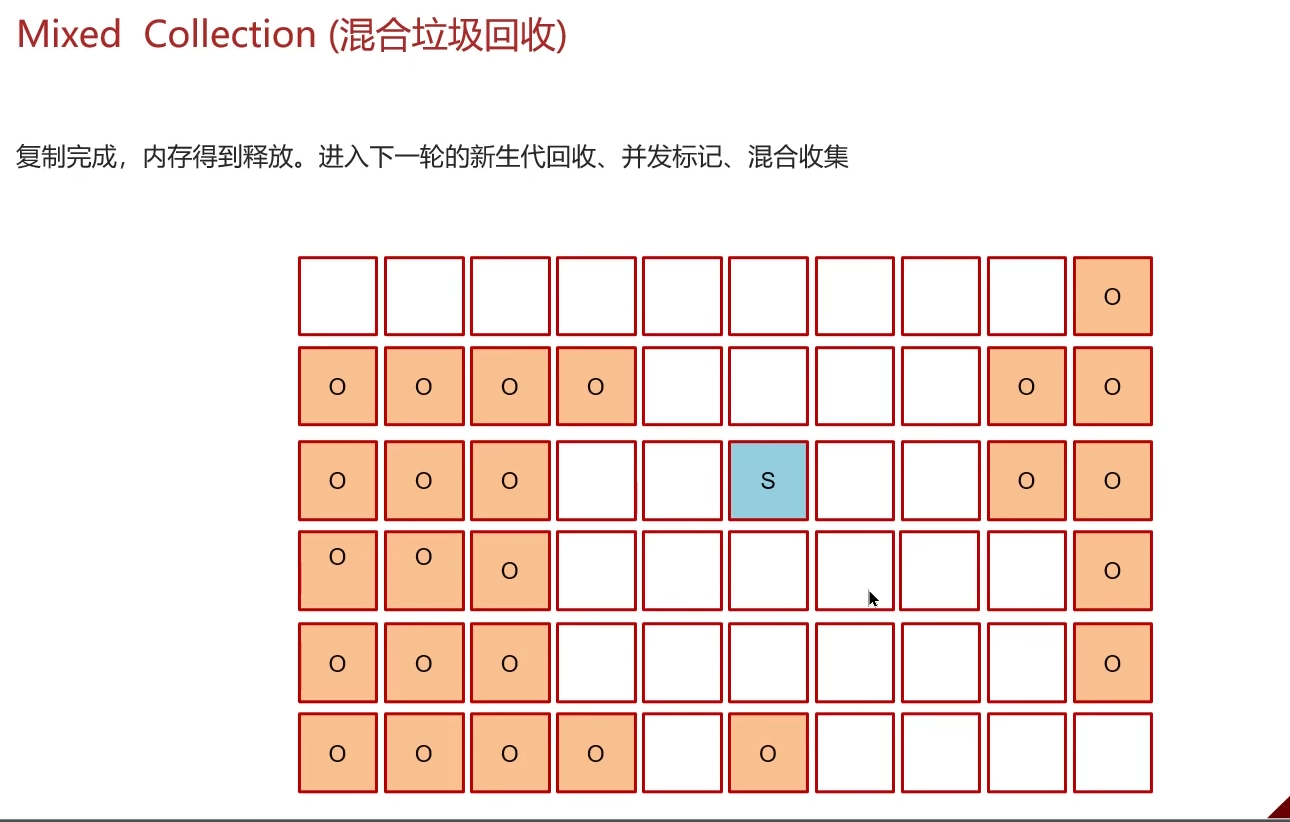
混合收集阶段,参与复制的有eden,survivor,old
复制完成,内存得到释放,进入下一轮的新生代回收,并发标记,混合收集
强引用,软引用,弱引用,虚引用的区别:
强引用:只要所有的GC Roots能找到,就不会被回收
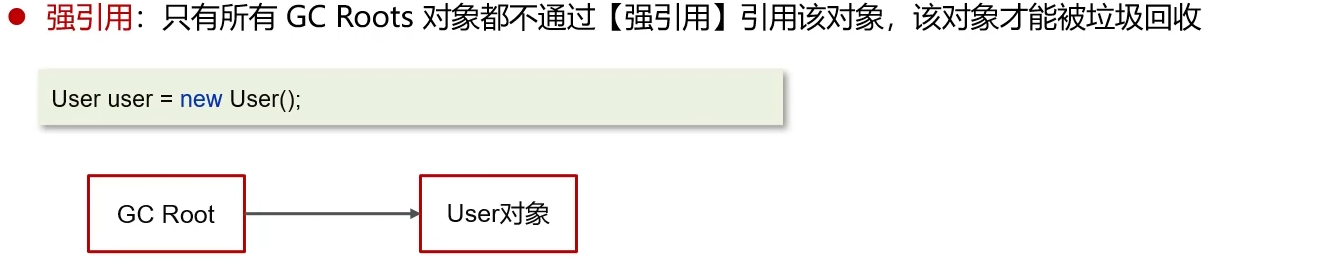
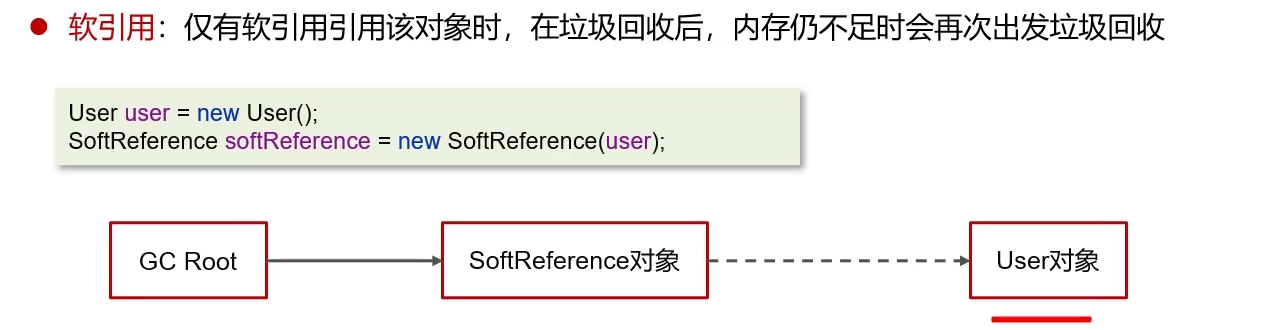
软引用:仅有软引用引用该对象时,在垃圾回收后,内存仍不足时会垃圾回收
弱引用:仅有弱引用引用该对象时,在垃圾回收时,无论内存是否充足,都会回收弱引用对象
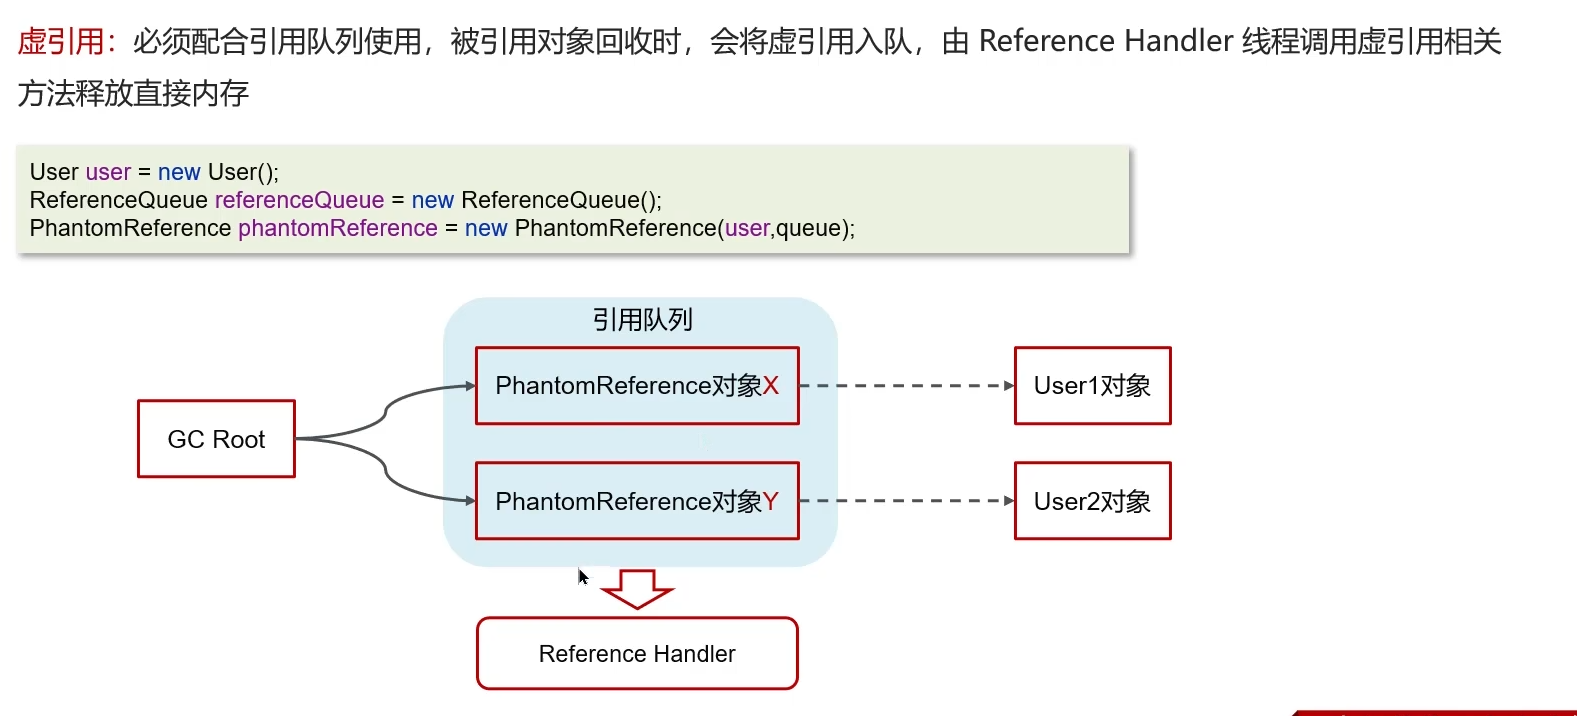
虚引用:必须配合引用队列使用,被引用对象回收时,会将虚引用入队,由Reference Handler线程调用虚引用相关方法释放内存
JVM调优的参数可以在哪设置参数值:
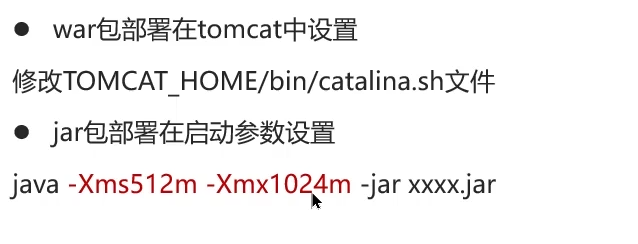
1.war包部署在tomcat中设置
2.jar包部署在启动参数设置
JVM调优的参数有哪些:
1.设置堆内存大小
2.虚拟机栈的设置
3.年轻代Eden区和两个Survivor区的比例
4.年轻代晋升老年代阈值
5设置垃圾回收器
JVM调优的工具:
JAVA内存泄漏排查思路:
内存泄漏一般是指堆内存,通常是指一些大对象不被回收的情况
1.通过jmap或设置jvm参数获取堆内存快照dump
2.通过工具,VisualVM去分析dump文件,VisualVM可以加载离线的dump文件
3.通过查看堆信息的情况,可以大概定位内存溢出是哪行代码出了问题
4.找到对应的代码,通过阅读上下文的情况,进行修复即可
CPU飙高的排查思路:
1.使用top命令查看占用的cpu情况
2.使用top命令查看后,可以查看是哪一个进程占用cpu较高
3.使用ps命令查看进程中的线程信息
4.使用jstack命令查看进程中哪些线程出现了问题,最终定位问题
设计模式:
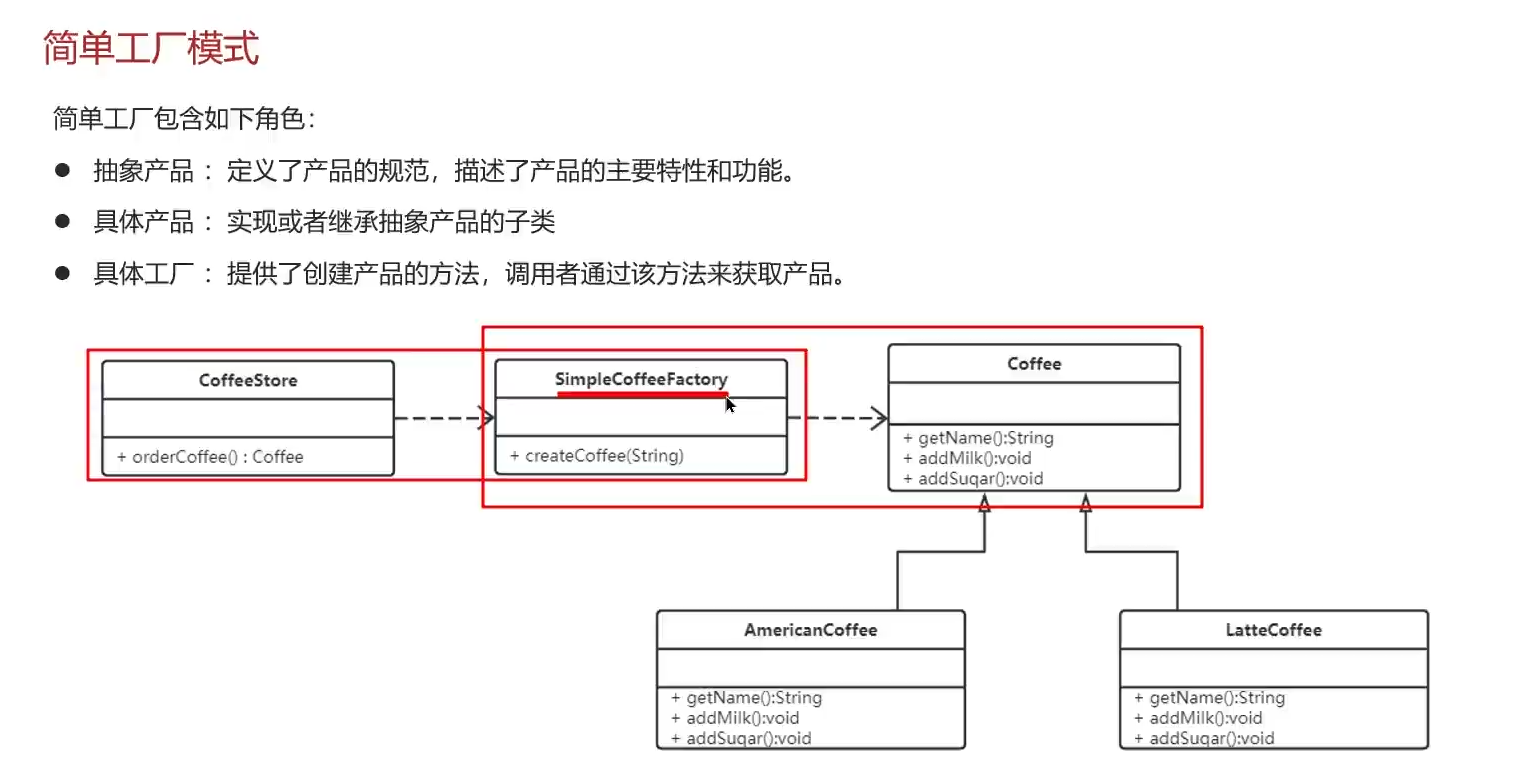
简单工厂模式:
简单工厂包含如下角色:
抽象产品:定义了产品的规范,描述了产品的主要特征和功能
具体产品:实现或继承抽象产品的子类
具体工厂:提供了创建产品的方法,调用者通过该方法来获取产品
工厂方法模式:
工厂方法模式的主要角色:
1.抽象工厂:提供了创建产品的接口,调用者通过它访问具体工厂的工厂方法来创建产品
2.具体工厂:主要是实现抽象工厂中的抽象方法,完成具体产品的创建
3.抽象产品:定义了产品的规范,描述了产品的主要特性和功能
4.具体产品:实现了抽象产品所定义的接口,由具体工厂来创建,它同具体工厂之间一一对应
调用关系:
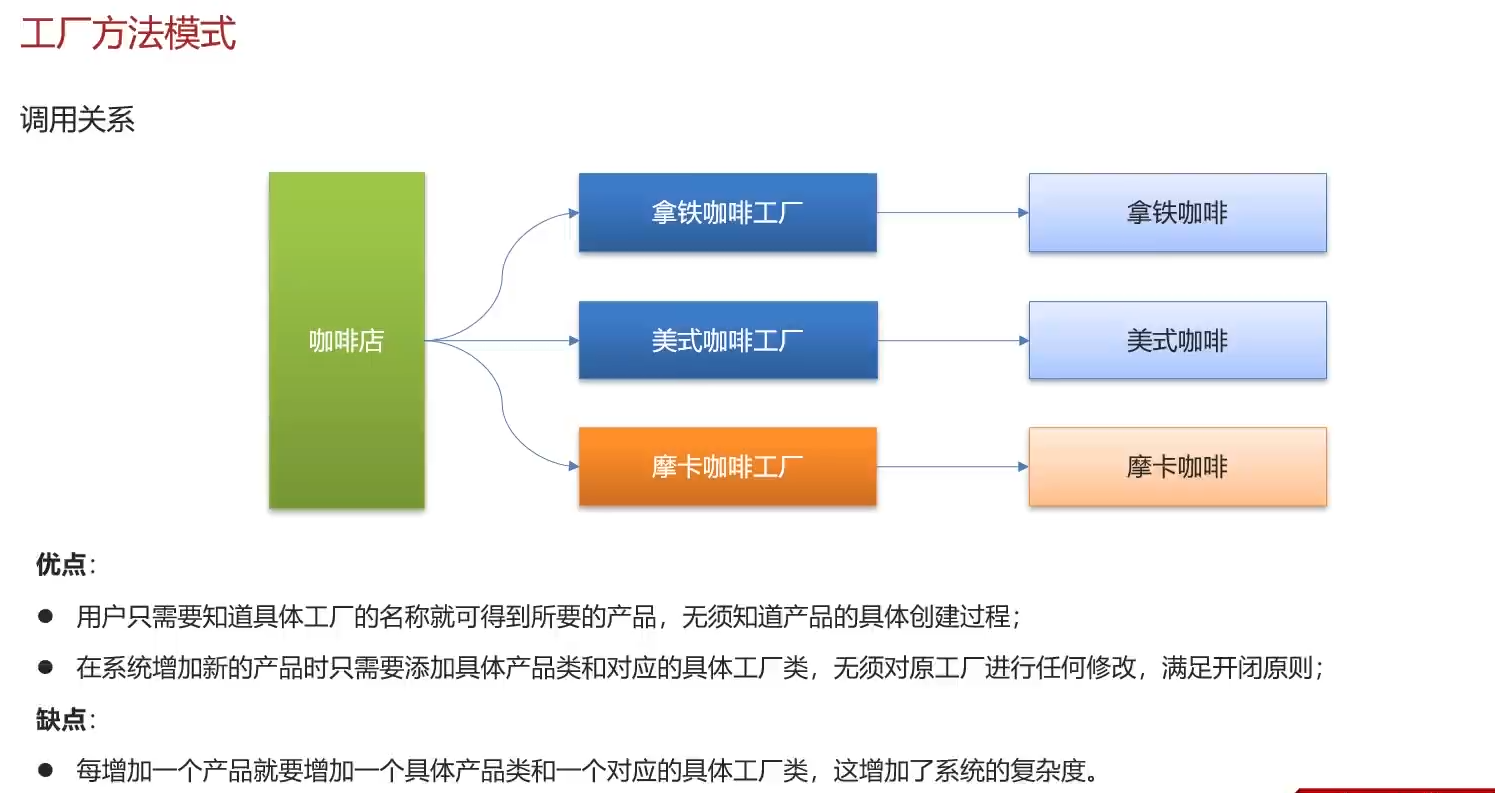
优点:
用户只需要具体工厂的名称就可以得到所需要的产品,无须知道产品的具体创建过程
缺点:
在系统增加新的产品就要增加一个具体产品类和对应的一个具体工厂类,增加了系统复杂度
抽象工厂模式:
工厂方法模式只能考虑生产同等级的产品,抽象工厂可以处理多等级产品的生产
抽象工厂模式是工厂方法模式的升级版本,工厂模式只生产一个等级的产品。而抽象工厂模式可生产多个等级的产品
一个超级工厂创建其他工厂,该超级工厂又称为其他工厂的工厂
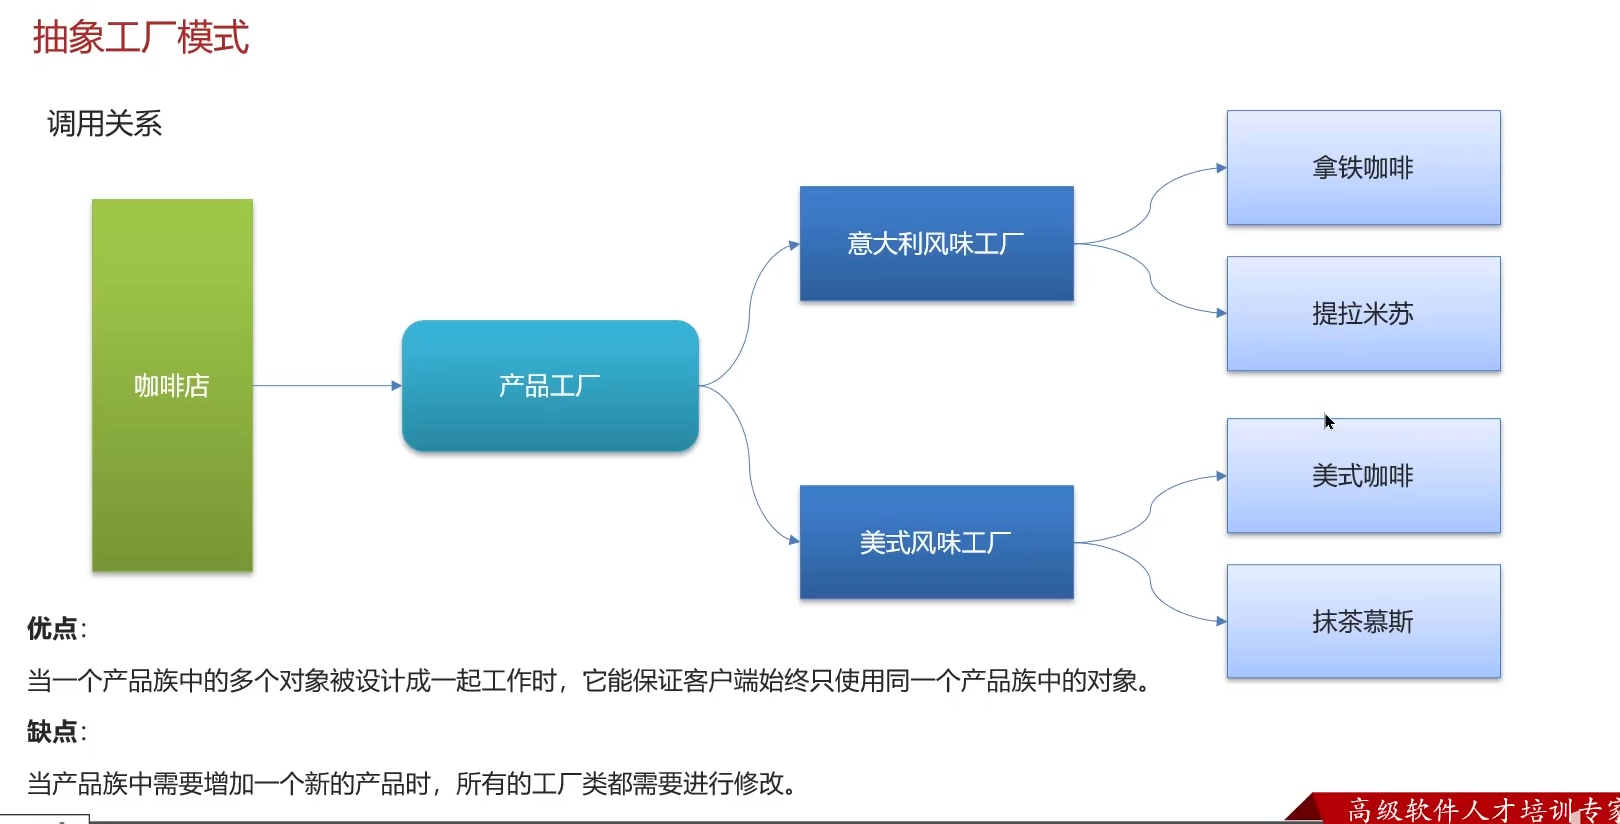
优点:
当一个产品族的多个对象被设计到一起工作时,它能保证客户端始终只使用同一个产品族中的对象
缺点:
当产品族需要增加一个产品时,所有工厂类都需要修改
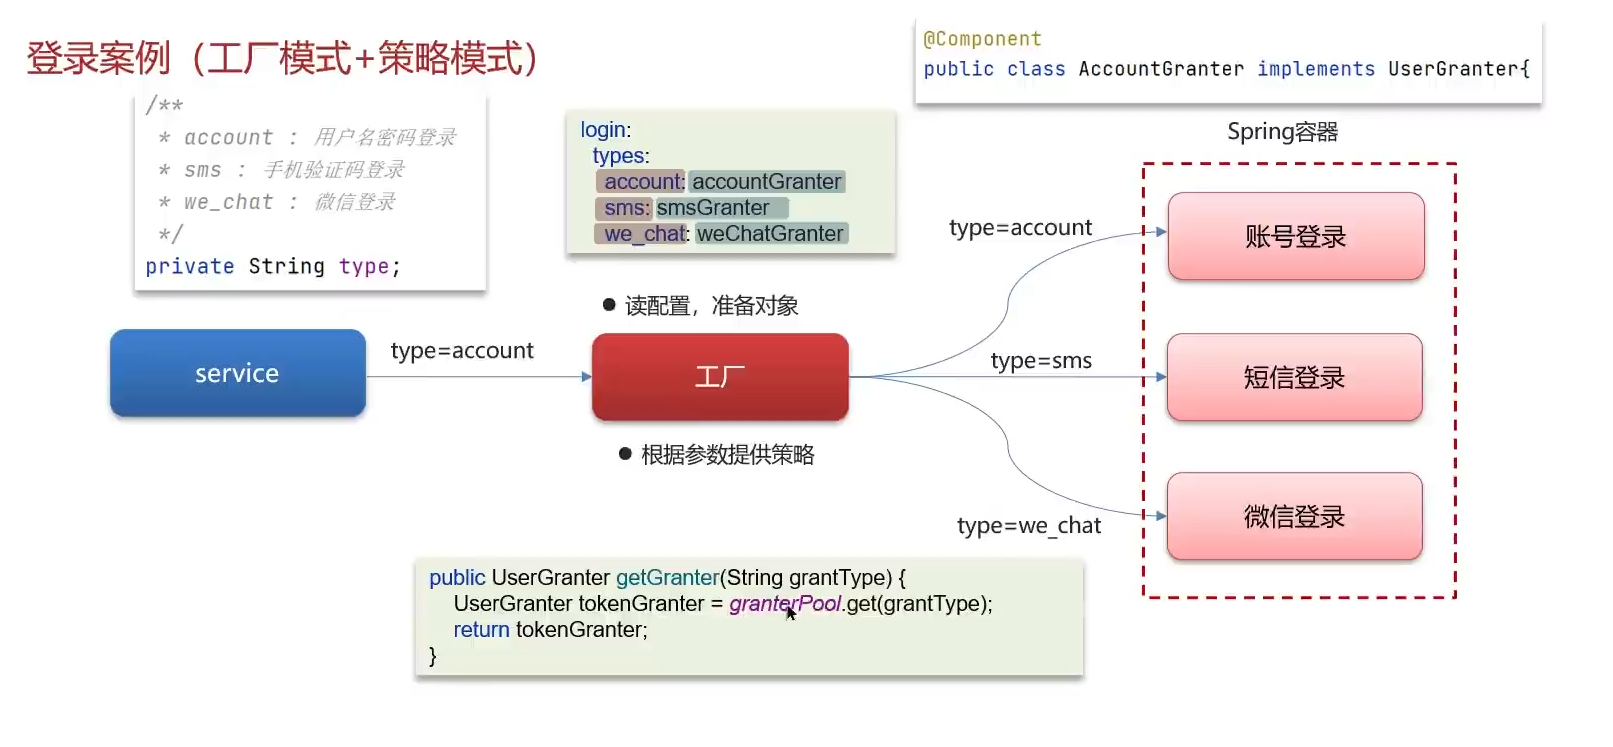
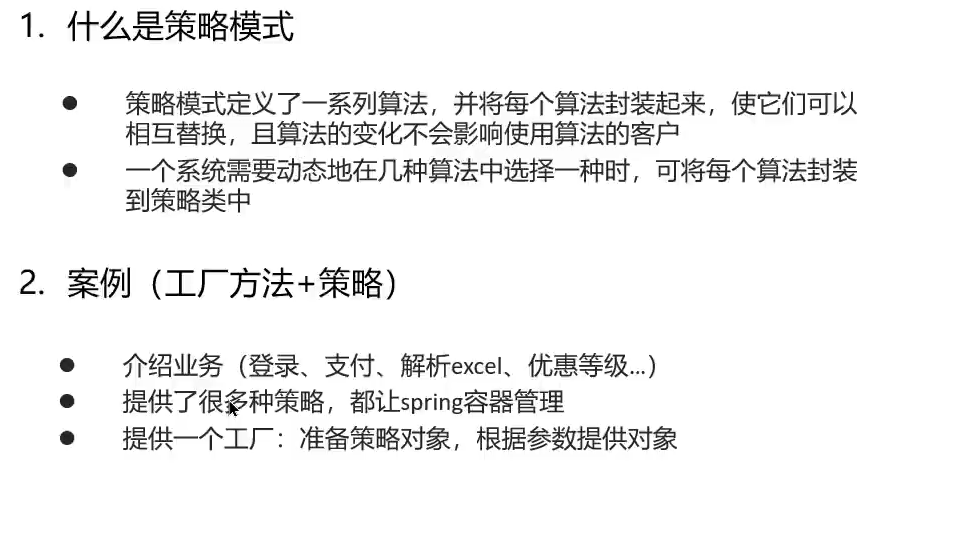
策略模式:
该模式定义了一系列算法,并将每个算法封装起来,使它们可以相互替换,且算法的变化不会影响使用算法的客户
它对算法进行封装,把使用算法的责任和算法的实现分割开来,并委派给不同的对象对这些算法进行管理
策略模式的主要角色如下:
抽象策略类:这是一个抽象角色,通常由一个接口或抽象类实现。此角色给出所有的具体策略类所需的接口
具体策略类:实现了抽象策略定义的接口,提供具体的算法实现或行为
环境类:持有一个策略类的引用,最终给客户端调用
优点:
策略类之间可以自由转换
易于扩展
避免使用多重条件选择语句(if else),充分体现面向对象设计思想
缺点:
客户端必须知道所有的策略类,并自行决定使用哪一个策略类
策略模式将产生很多策略类
登录案例(工厂模式+策略模式):
责任链设计模式:
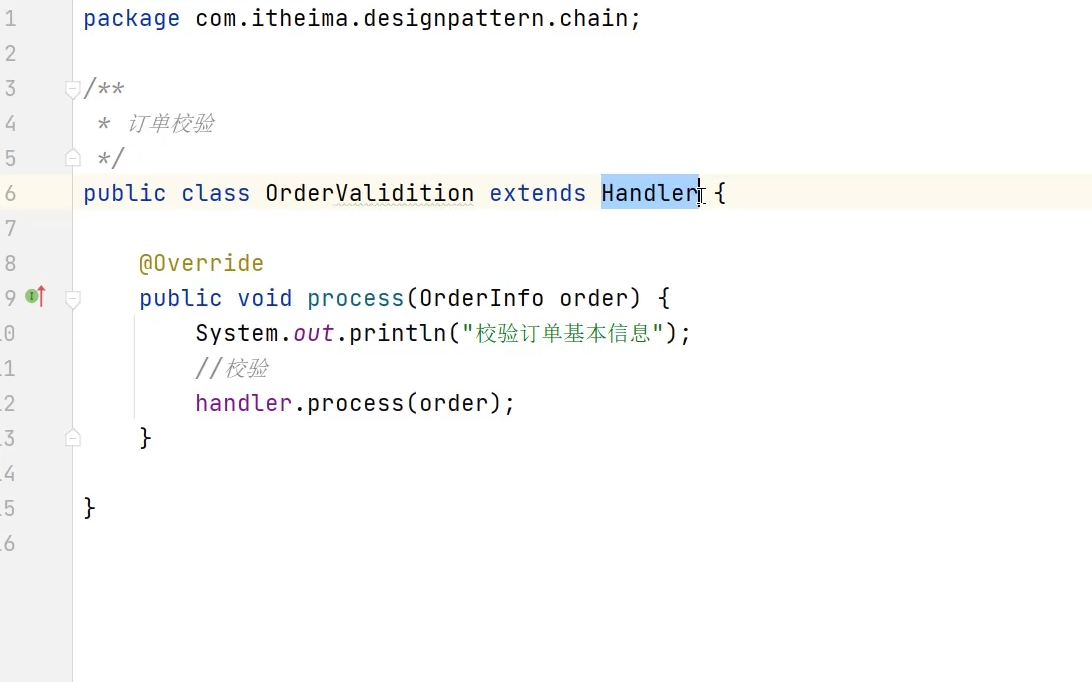
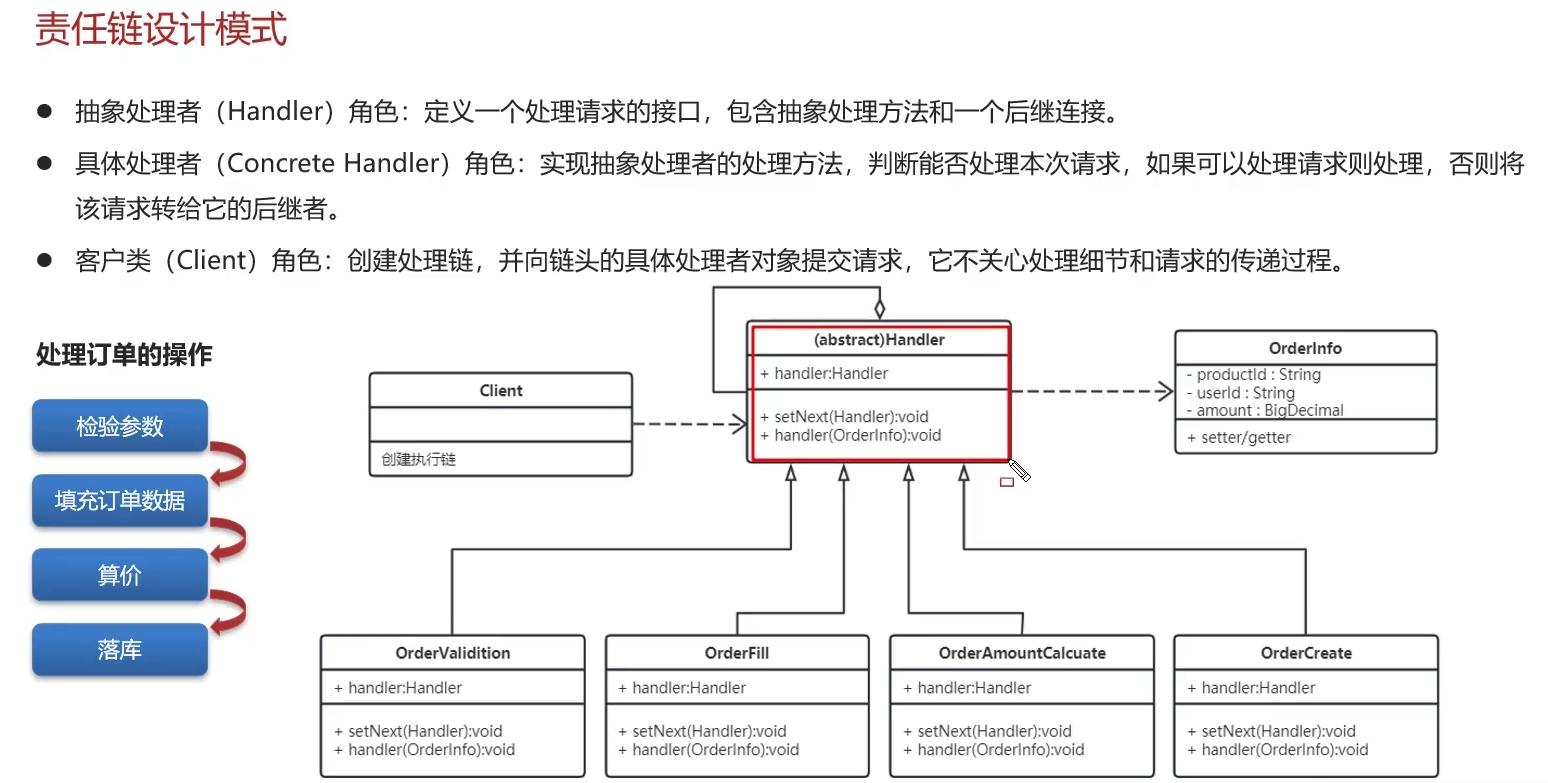
相当于是在一个类里面定义调用顺序,然后分别在各自的类里面写自己的方法。
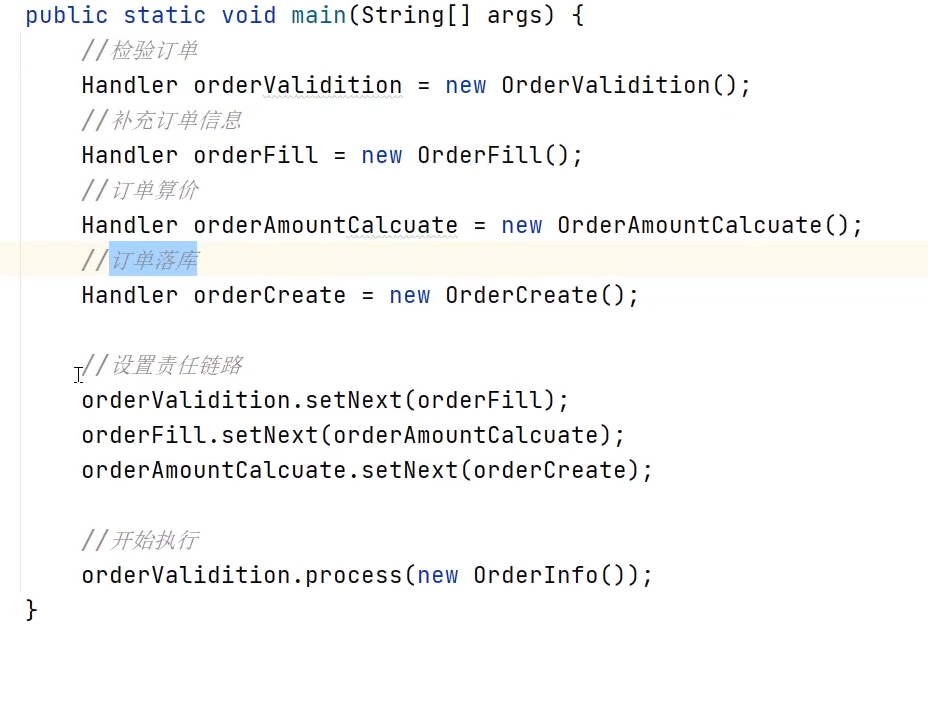
为了避免请求发送者与多个请求处理器耦合在一起,将所有请求的处理器通过前一对象记住下一个对象的引用而连成一条链;当有请求发生时,可将请求沿着这条链传递,直到有对象处理它为止
抽象处理者角色:定义一个处理请求的接口,包含抽象处理方法和一个后继连接
具体处理者角色:实现抽象处理者的处理方法,判断能否处理本次请求,如果可以处理请求则处理,否则将该请求转发给它的后继者
客户类角色:创建处理链,并向链头的具体处理者对象提交请求,它不关心处理细节和请求的传递过程
优点:
降低了对象之间的耦合度
增强了系统的可扩展性
增强了给对象指派职责的灵活性
责任链简化了对象之间的连接
责任分担
缺点:
对比较长的职责链,请求的处理可能涉及多个处理对象,系统性能将受到一定的影响
职责链建立的合理性要靠客户端来保证,增加了客户端的复杂性,可能会由于职责链的错误设置而导致系统出错,如可能导致循环调用
单点登录怎么实现的:
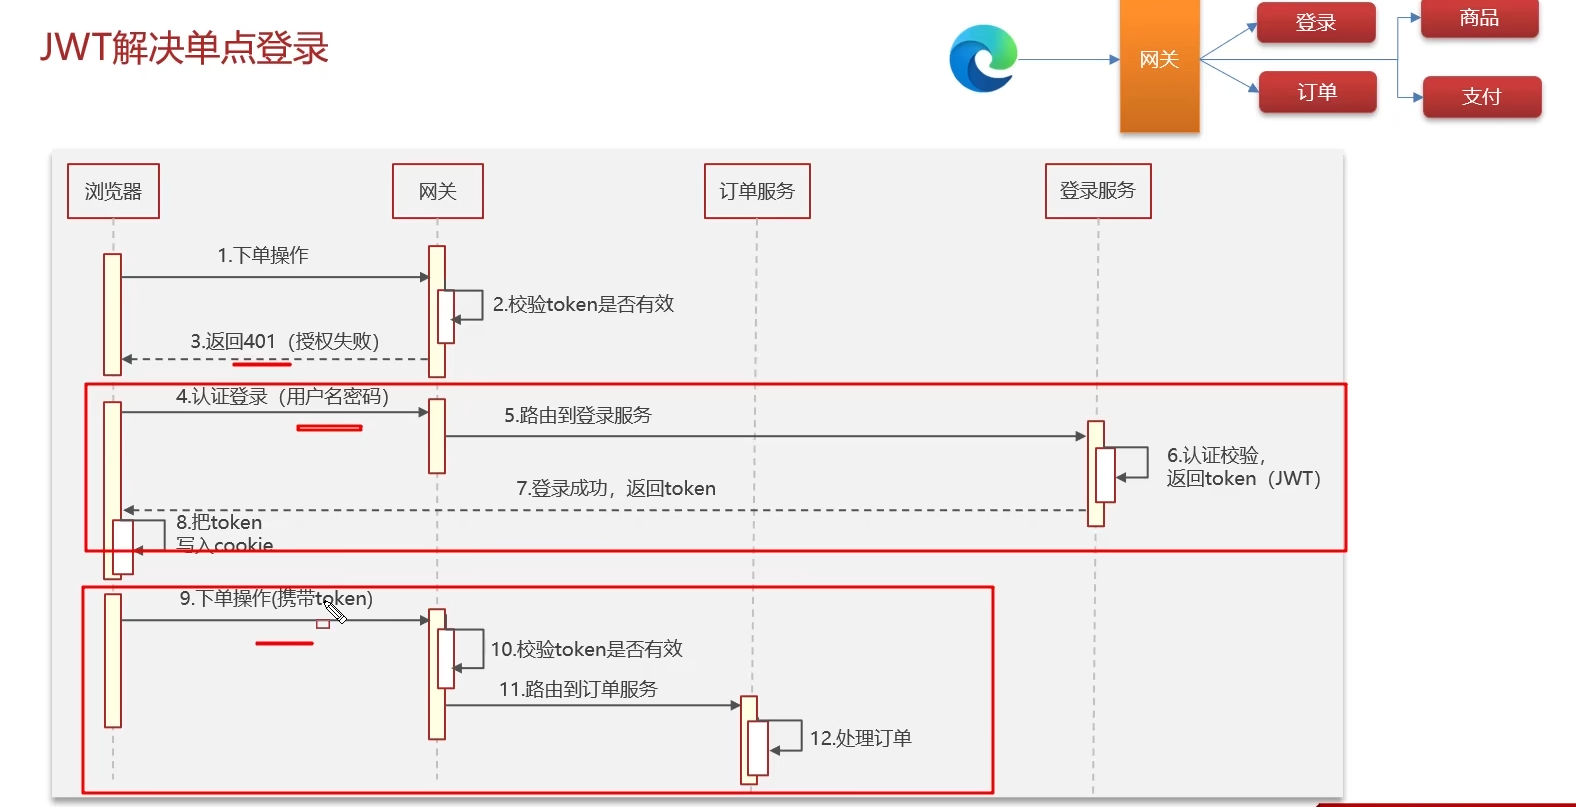
1.用户访问其它系统,会在网关判断token是否有效
2.如果token无效则会返回401(认证失败)前端跳转到登录页面
3.用户发送登录请求,返回浏览器一个token,浏览器把token保存到cookie
4.再去访问其他服务的时候,都需要携带token,由网关统一验证后路由到目标服务
权限认证如何实现:
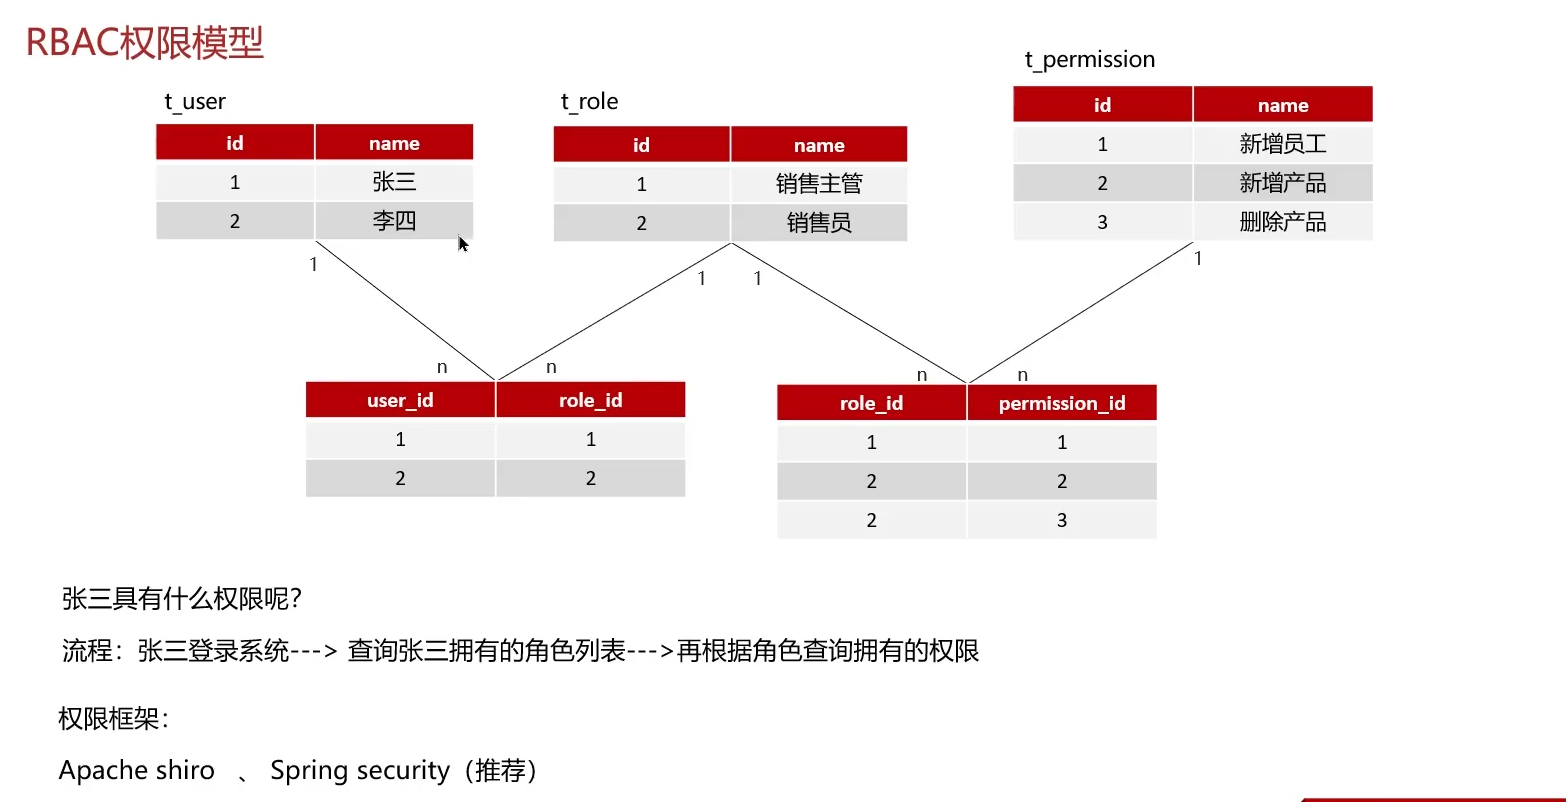
RBAC基于角色的访问控制:
3个基础部分组成:用户,角色,权限
具体实现:
5张表:用户表,角色表,权限表,用户角色中间表,角色权限中间表
7张表:用户表,角色表,权限表,菜单表,用户角色表,角色权限中间表,权限菜单中间表
上传数据的安全性怎么实现:
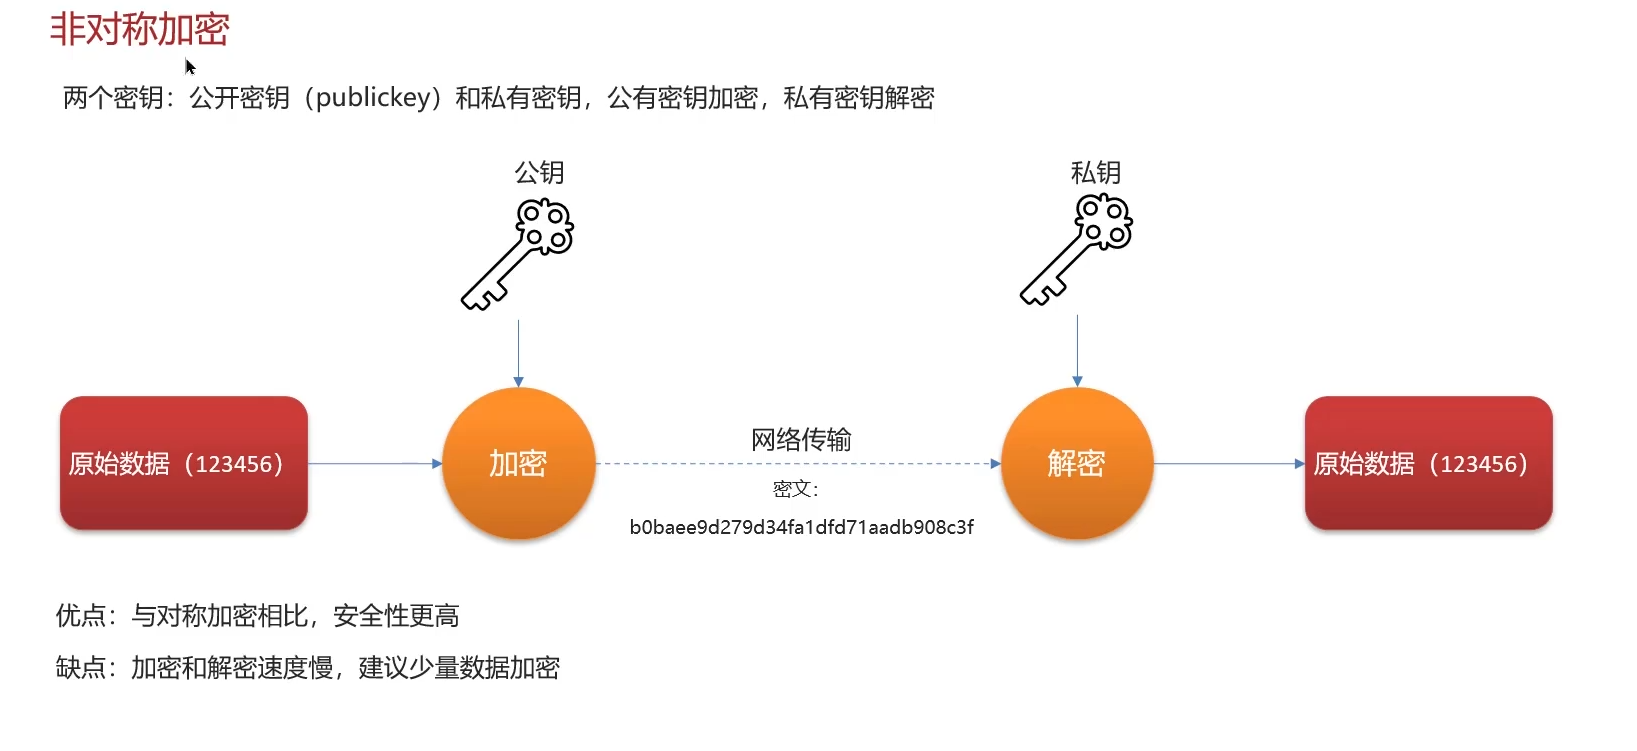
使用非对称或者对称加密,给前端一个公钥让他把数据加密后传到后台,后台负责解密后处理数据
对称加密:
文件加密和解密使用相同的密钥,即加密密钥也可以用作解密密钥
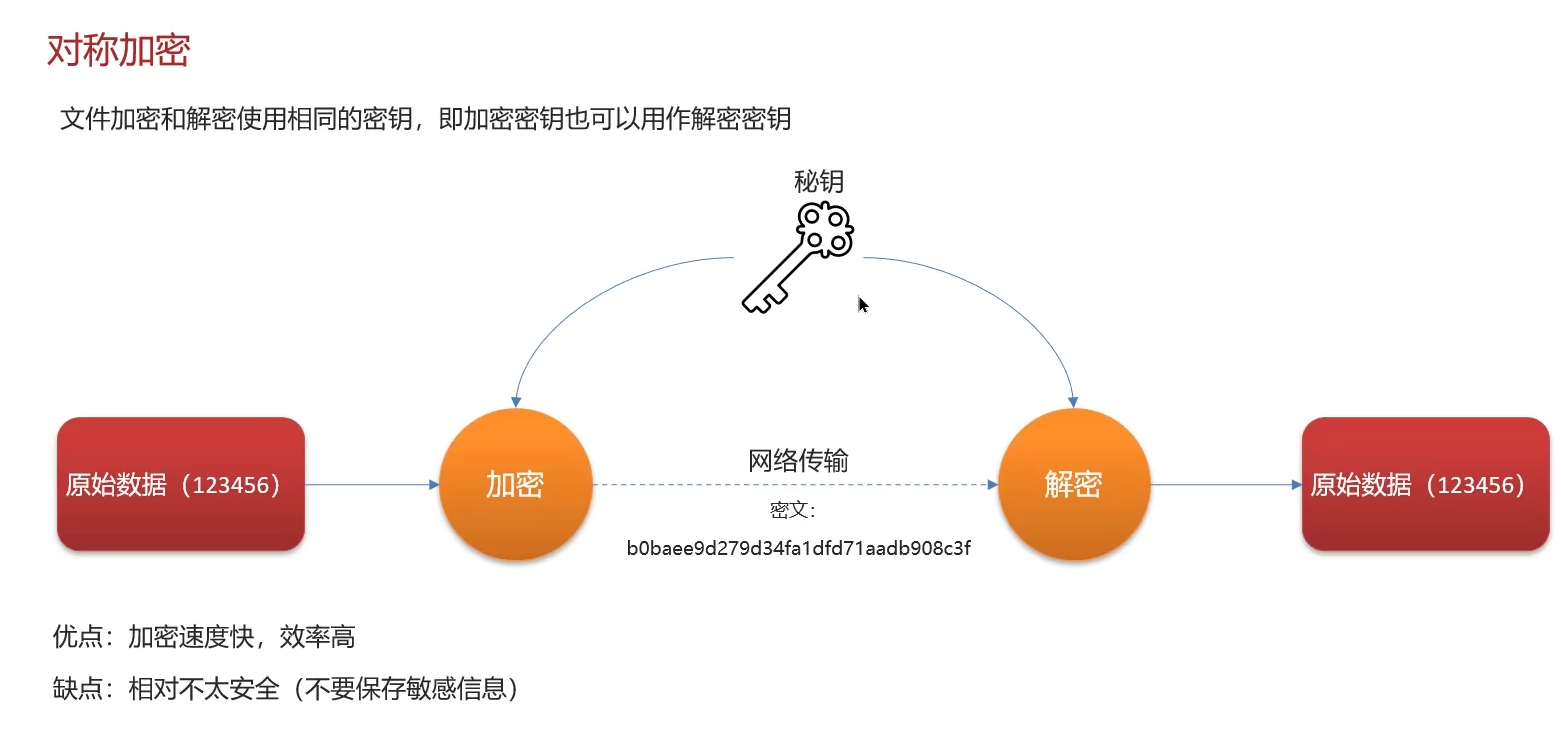
优点:加密速度快,效率高
缺点:相对不安全
非对称加密:
两个密钥:公开密钥和私有密钥,公有密钥加密,私有密钥解密
项目中日志怎么收集:
搭建了ELK日志采集系统
Elaticsearch是全文搜索分析引擎,可以对数据存储,搜索,分析
Logsrash是一个数据引擎,可以动态收集数据,可以对数据进行过滤,分析,将数据存储到指定的位置
Kibana是一个数据分析和可视化平台,配合Elasticsearch进行搜索,分析,图表展示
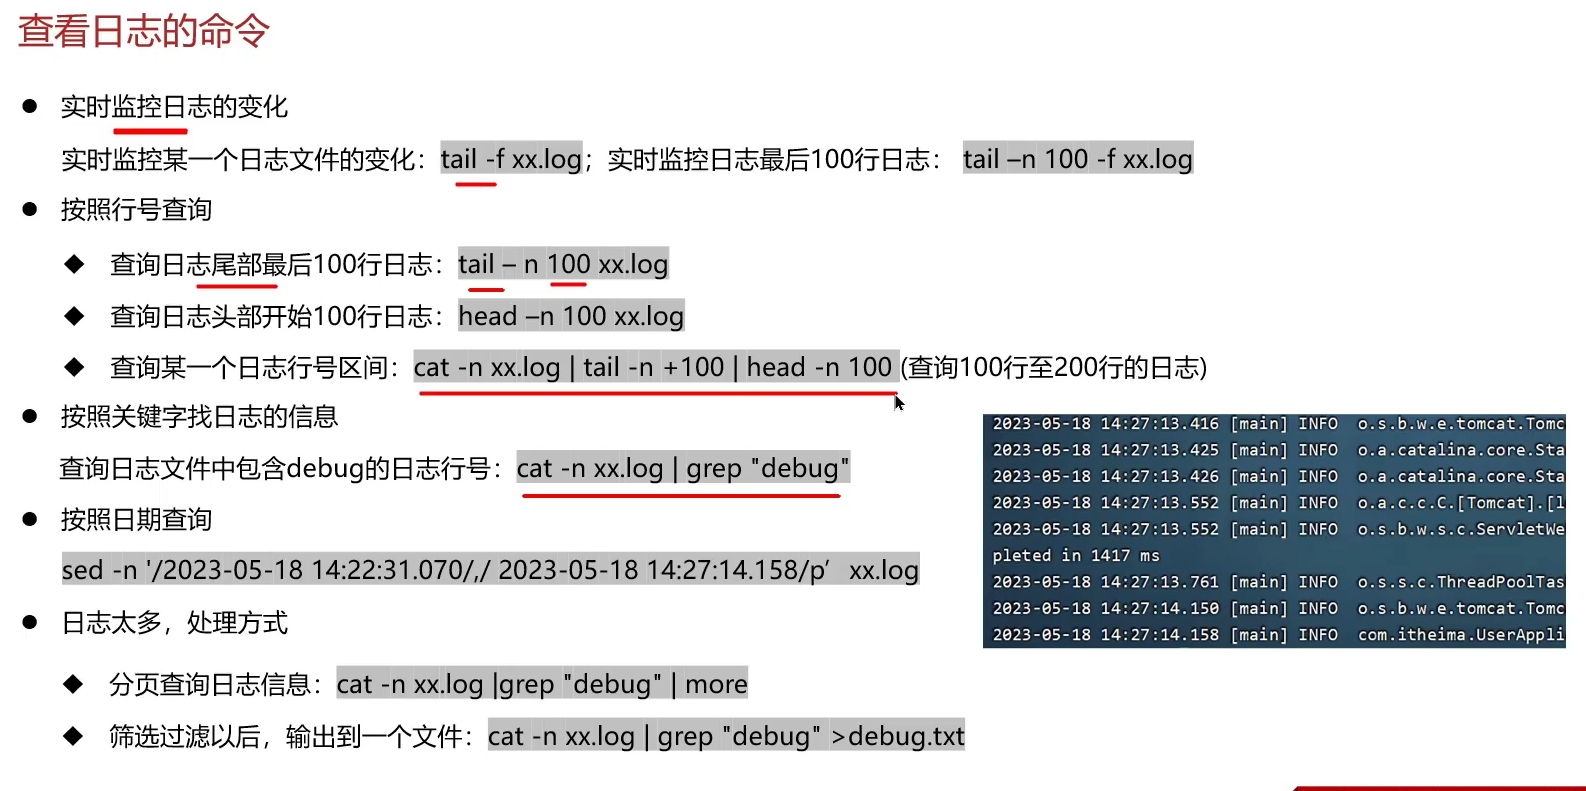
查看日志的命令:
怎么快速定位系统的瓶颈:
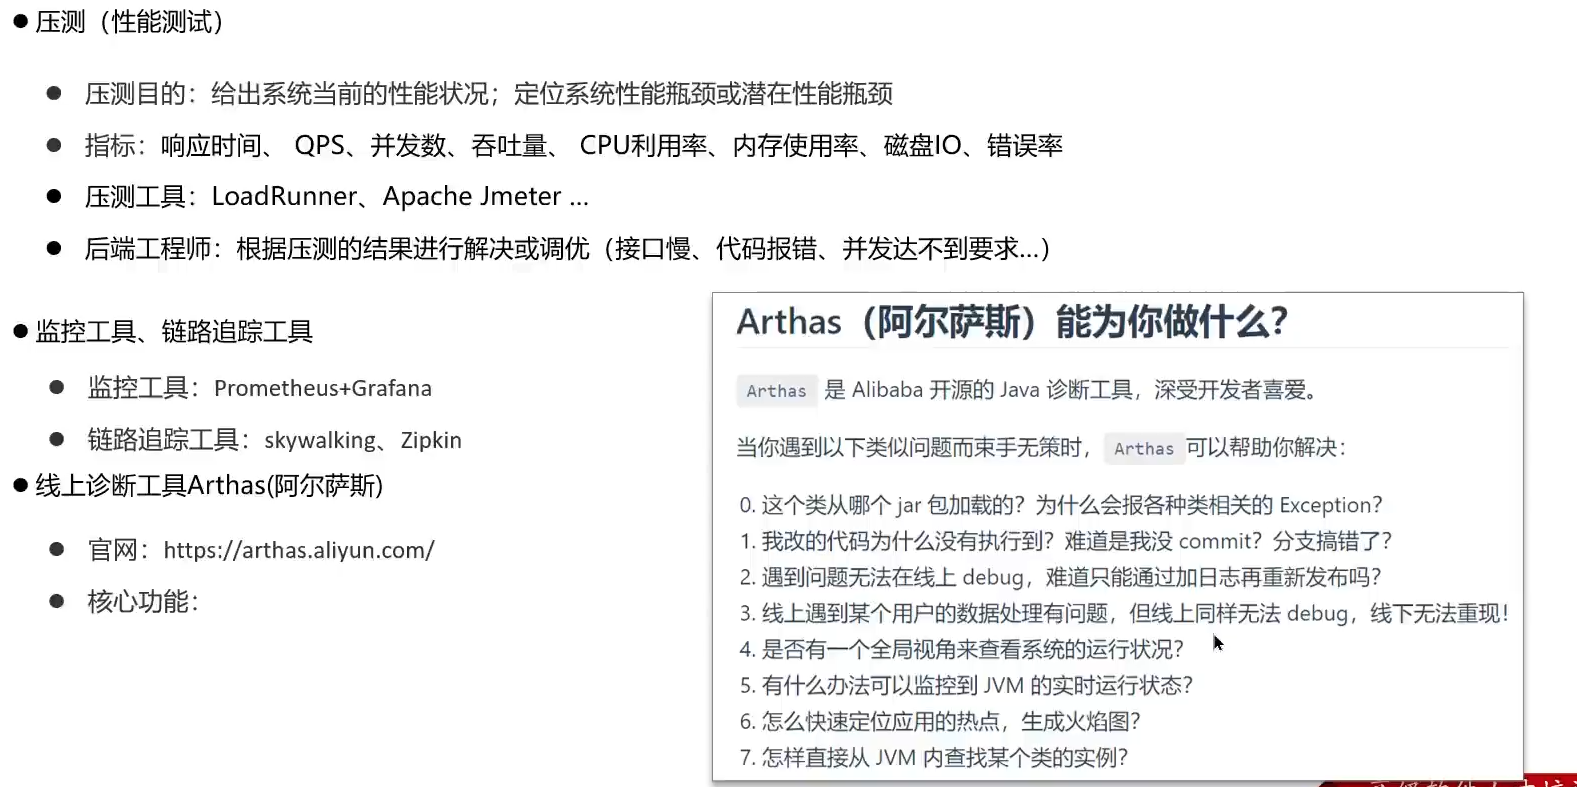
1.压测
2.监控工具,链路追踪工具
3.线上诊断工具
更多推荐


 28
 0
- 0


 已为社区贡献1条内容

所有评论(0)