
[Linux] Linux正则表达式 & awk命令
目录
Linux正则表达式
-
正则表达式作为一个pattern,将pattern与要搜索的字符串进行匹配,以便查找一个或多个字符串。
-
正则表达式,自成体系,由普通字符(例如字符a到z)和元字符组成的文字模式。
-
普通字符:没有显式指定为元字符的所有可打印和不可打印字符字符,包括所有大写和小写字母、所有数字、所有标点符号和其他一些符号。
-
元字符:出了普通字符之外的字符。
-
正则表达式,工具(vim、grep、less等)和程序语言(Perl、Python、C等)都使用正则表达式。
正则表达式分类:
-
普通正则表达式
-
扩展正则表示,支持更多的元字符。
环境准备
vim test_word
#写入
cat
category
acat
concatenate
dog
普通字符
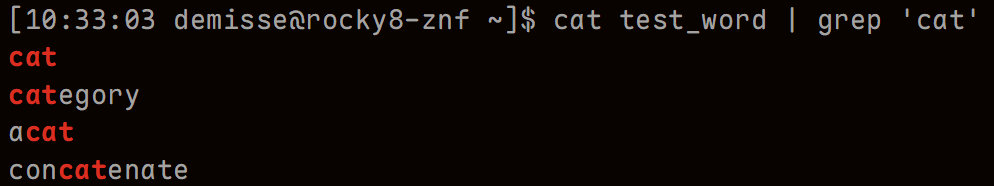
cat test_words | grep 'cat'
字符集
[…]
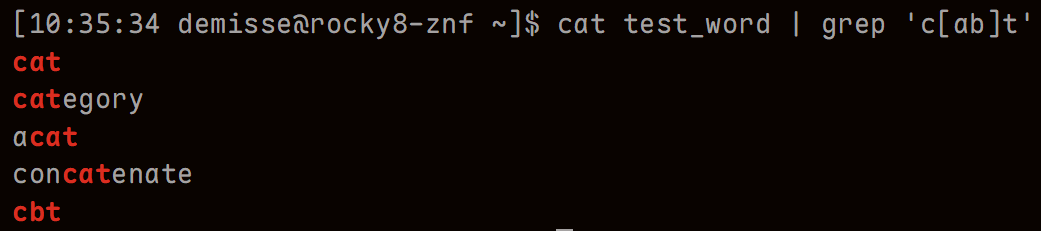
匹配[…]中的任意一个字符
echo cbt >> test_word
cat words | grep 'c[ab]t'
[a-z] [A-Z] [0-9]
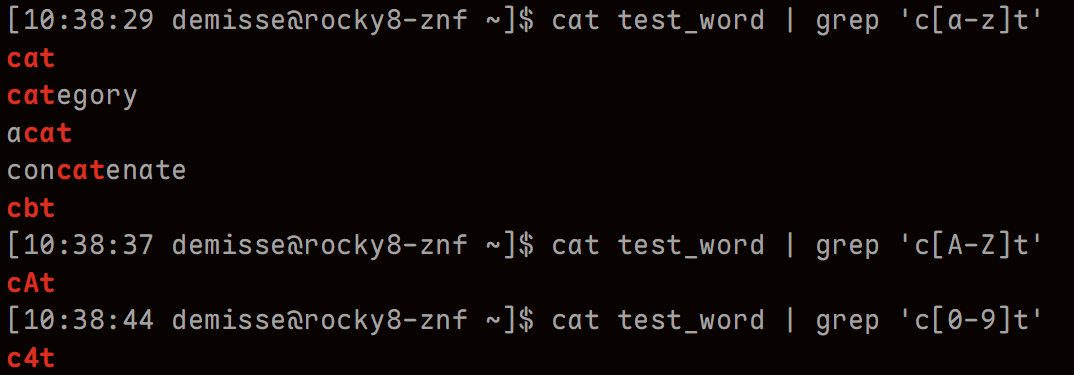
[a-z],匹配所有小写字母
[A-Z],匹配所有大写字母
[0-9],匹配所有数字
echo cAt >> test_word
echo c4t >> test_word
echo c-t >> test_word

cat test_word | grep 'c[a-z]t'
cat test_word | grep 'c[A-Z]t'
cat test_word | grep 'c[0-9]t'
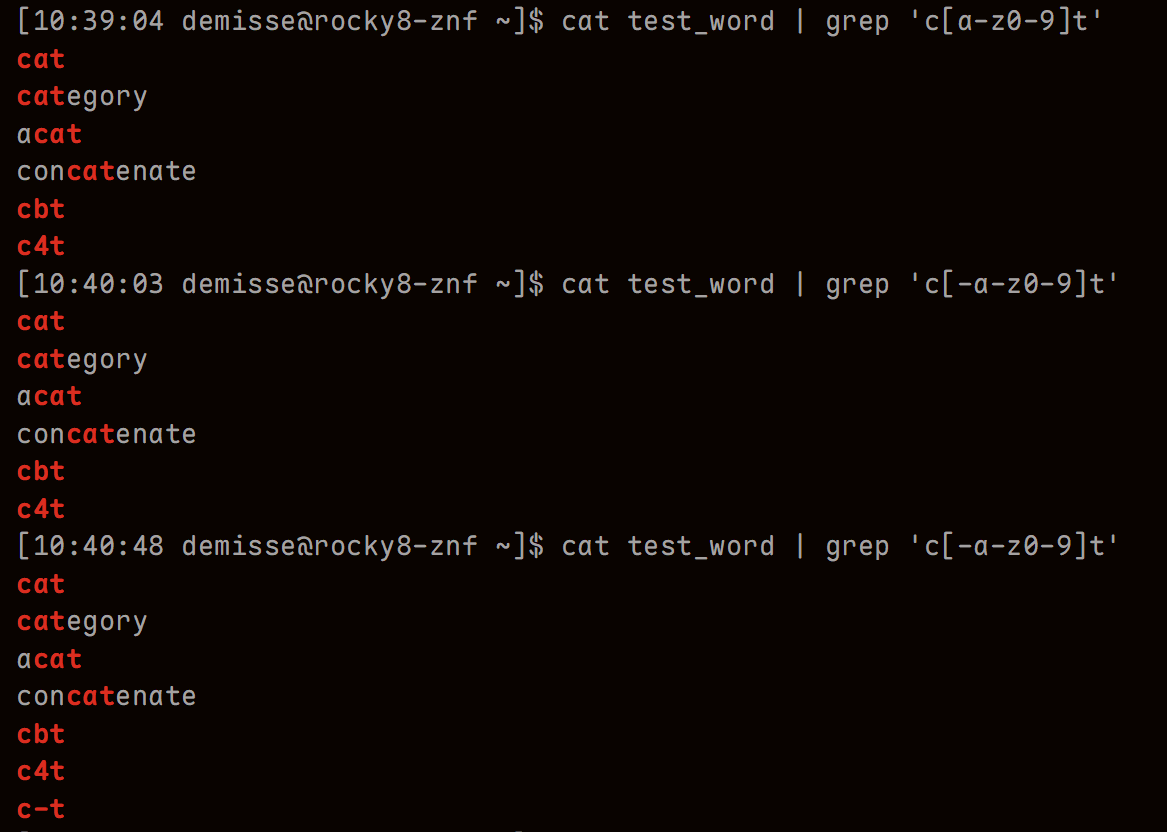
cat test_word | grep 'c[a-z0-9]t'
#匹配-符号,将该符号写在第一个位置
cat test_word | grep 'c[-a-z0-9]t'
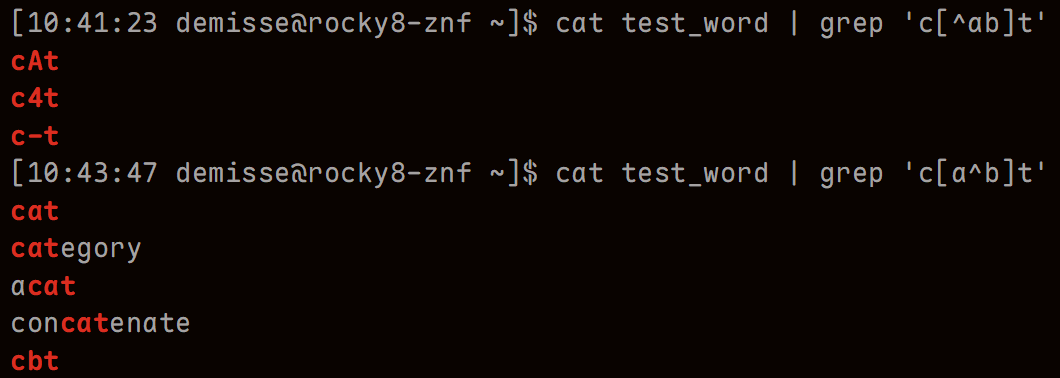
[^…]
匹配除了[…]中字符的所有字符
cat test_word | grep 'c[^ab]t'
#^放在中间会被当成普通字符
cat test_word | grep 'c[a^b]t'
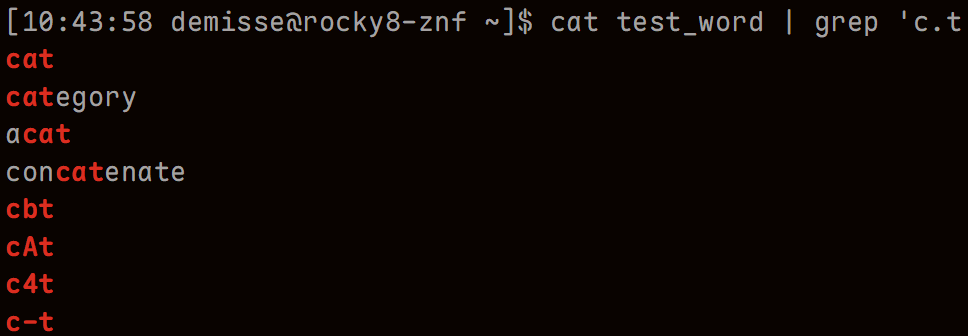
.
匹配除换行符(\n、\r)之外的任何单字符,相当于\[^\n\r]
\
将下一个字符标记为或特殊字符、或原义字符、或向后引用、或八进制转义符。
例如,'n'匹配字符'n'。\n匹配换行符。序列\\匹配\,而\(则匹配(。
echo c.t >> test_word
cat test_word | grep 'c\.t'
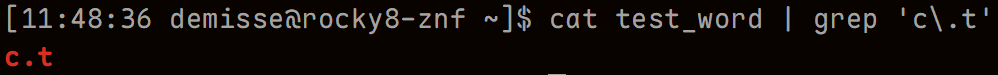
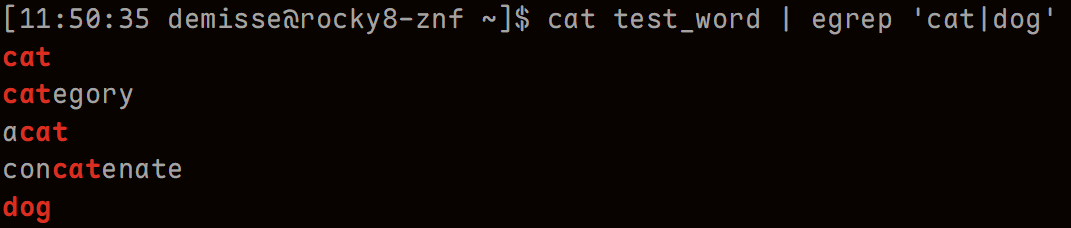
|
|符号是扩展表达式中元字符,指明两项之间的一个选择。要匹配|,需要使用\|
cat test_word | egrep 'cat|dog'
#或
cat test_word | grep -E 'cat|dog'
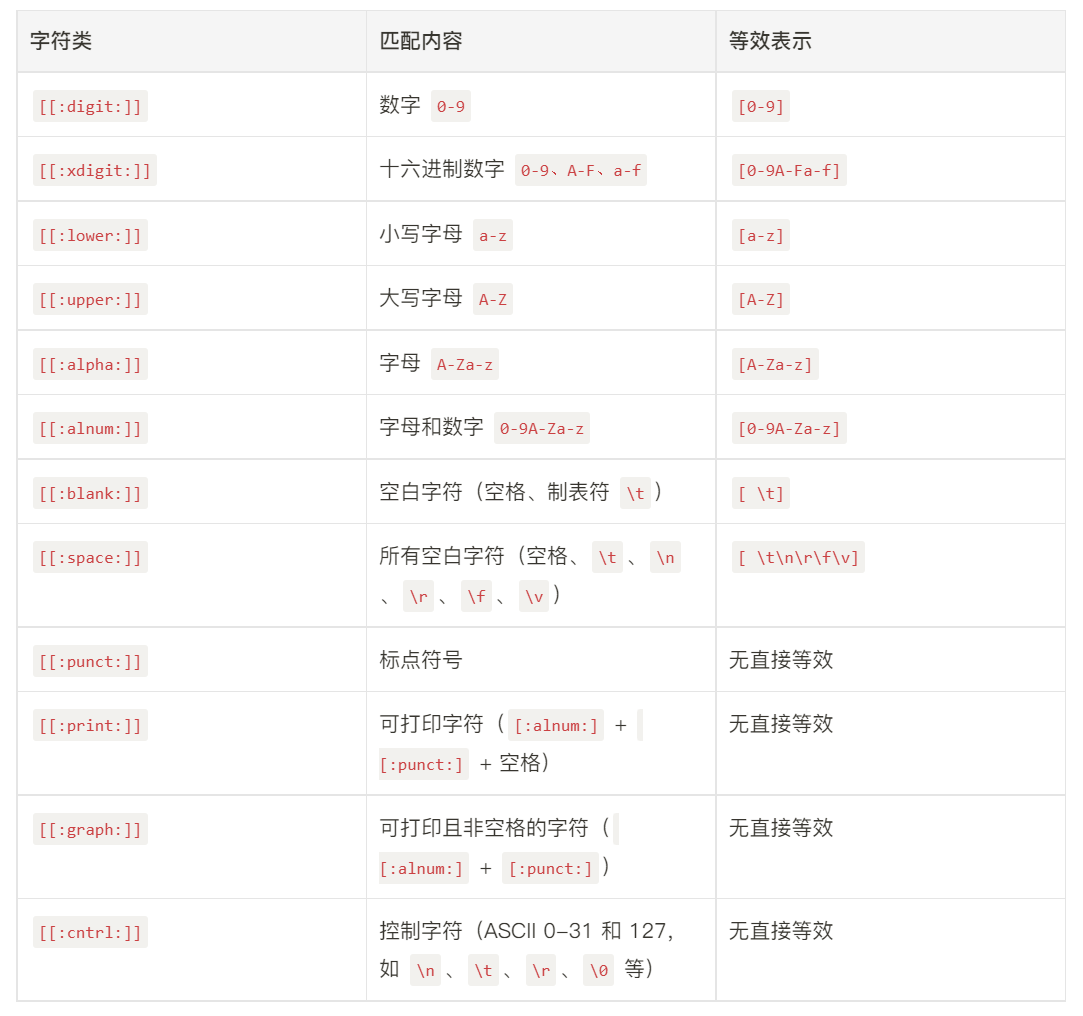
非打印字符
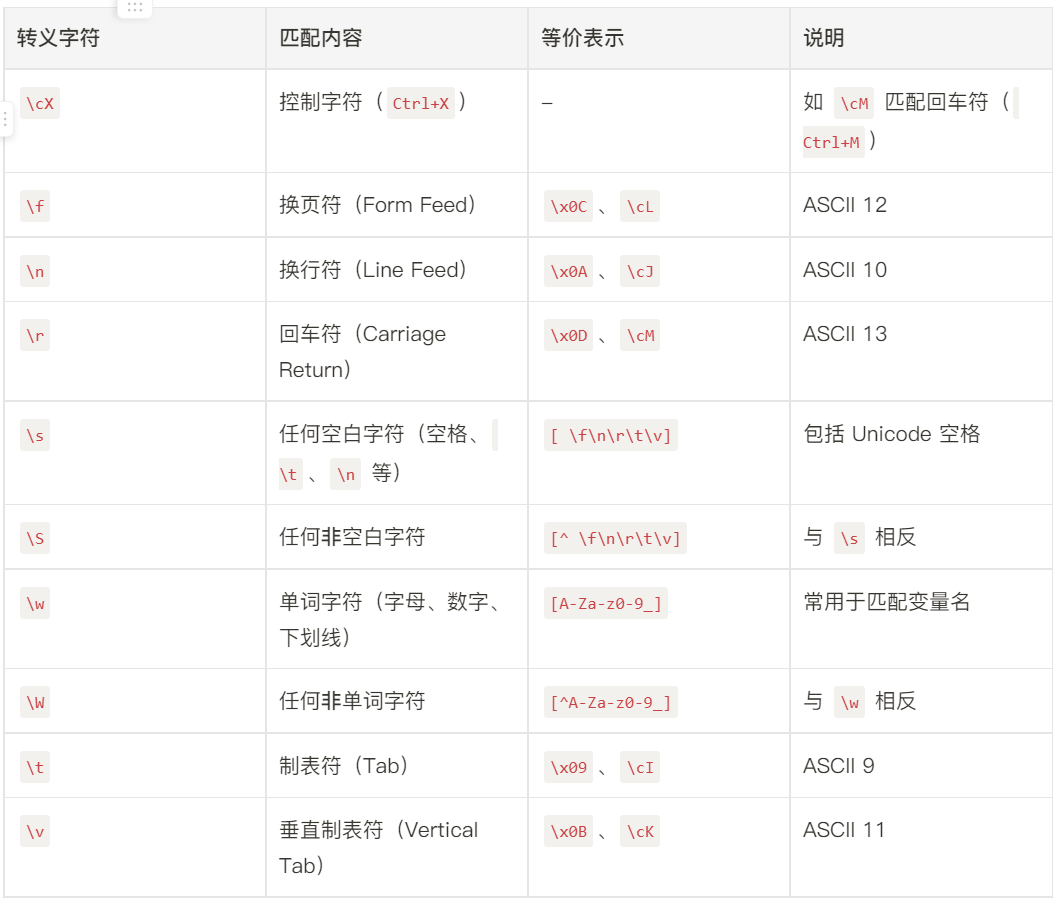
定位符
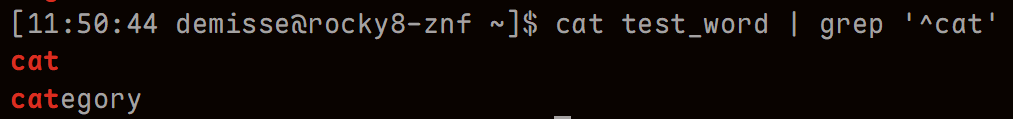
^
匹配首行位置
cat test_word | grep '^cat'
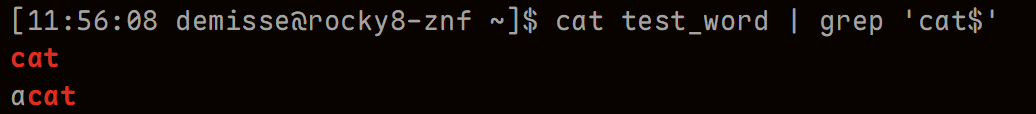
$
匹配行末位置
cat test_word | grep 'cat$'
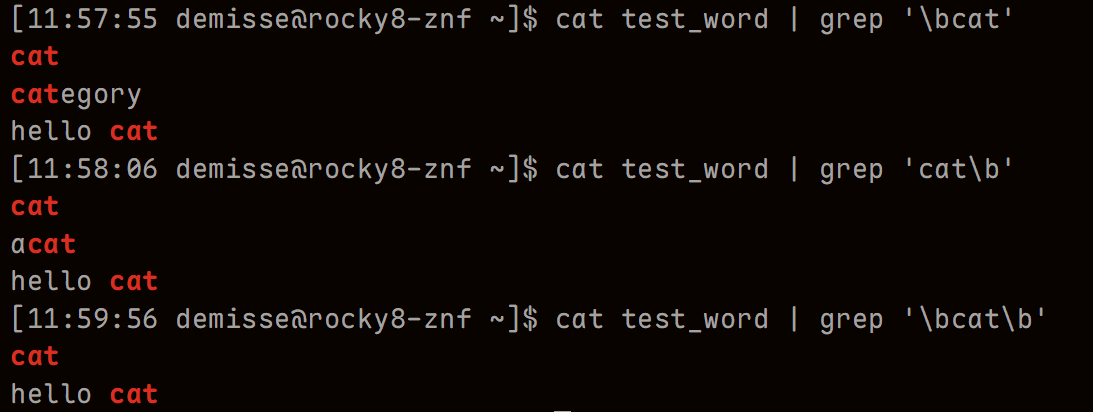
\b
匹配一个单词边界
echo hello cat >> test_word
cat test_word | grep '\bcat'
cat test_word | grep 'cat\b'
cat test_word | grep '\bcat\b'
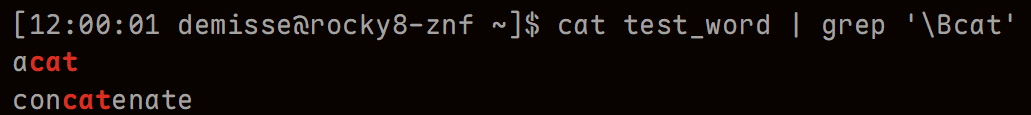
\B
非单词边界匹配
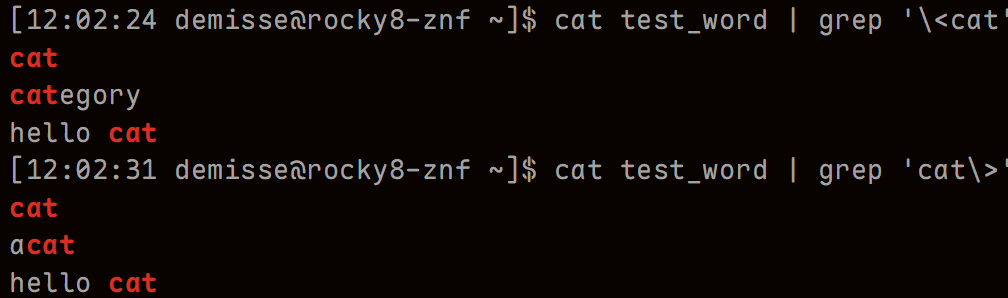
\< 和 >
-
\<,匹配一个单词左边界 -
\>,匹配一个单词右边界
cat test_word | grep '\<cat'
cat test_word | grep 'cat\>'
限定次数(扩展正则表达式)
用于指定子表达式的匹配次数,需配合egrep或grep -E:
-
*:匹配前面的子表达式任意次(包括 0 次),例如do*g匹配dg、dog、doog等。 -
+:匹配前面的子表达式至少 1 次,例如do+g匹配dog、doog等(不匹配dg)。 -
?:匹配前面的子表达式 0 次或 1 次,例如do?g匹配dg、dog(不匹配doog)。 -
{m}:匹配前面的子表达式 exactlym次,例如do{2}g匹配doog。 -
{m,n}:匹配前面的子表达式m到n次,例如do{2,3}g匹配doog、dooog。 -
{m,}:匹配前面的子表达式至少m次,例如do{2,}g匹配doog、dooog、doooog等。 -
{,n}:匹配前面的子表达式最多n次,例如do{,3}g匹配dg、dog、doog、dooog。
子表达式与反向引用
子表达式 ()
-
标记一个子表达式,用于分组匹配,例如:
bash
# 匹配'dog'重复2-3次的行
egrep '(dog){2,3}' words
反向引用
-
对带括号的子表达式的匹配结果进行引用,缓冲区编号从 1 开始(
\1、\2…),例如:bash
# 匹配重复的单词(如'of of'、'up up')
echo 'Is is the cost of of gasoline going up up?' | egrep -o '\b([a-z]+) \1\b'
应用示例:IP 地址匹配
匹配合法 IP 地址的正则表达式(IPv4):
grep -E '\b(([1-9]|[1-9][0-9]|1[0-9]{2}|2[0-4][0-9]|25[0-5])\.){3}([1-9]|[1-9][0-9]|1[0-9]{2}|2[0-4][0-9]|25[0-5])\b' ip.txt
支持正则表达式的工具
-
vim:用于搜索和替换文本
-
grep/egrep:用于文本搜索(
egrep支持扩展正则) -
less:用于文件内容查看时的搜索
-
其他:sed、awk 等
awk命令
一、awk 基础概述
1. 定位与作用
-
awk 是 Linux 文本处理三剑客之一,另外两个是 grep(擅长过滤)和 sed(擅长修改文本),awk 擅长取列和格式化输出。
-
可完成的任务包括文本处理、生成格式化的文本报告、运行简单的算术操作、执行常见的字符串操作等-。
2. 特性与形式
-
更像一门编程语言,支持自定义变量、条件语句、循环、数组、正则、函数等。
-
有三种形式:awk、gawk、nawk,平时所说的 awk 其实就是 gawk。
-
名称来源于三位创始人 Alf ed Aho、Peter Weinerger 和 ria Kernighan 姓氏的首字符。
二、awk 命令与脚本
1. 命令格式
-
格式一:
awk [options]'script'file(s) -
格式二:
awk [options]-f scriptfile file(s) -
说明:
-
script定义如何处理数据。 -
file是 awk 处理的数据来源,也可来自其它命令的输出。 -
-f scriptfile从脚本文件中读取 awk 命令,每行都是一个独立的 script。
2. 脚本结构
-
一个 awk 脚本通常由四部分组成,且通常被单引号或双引号包住:
-
BEGIN{action}:awk 执行pattern{action}前要执行的脚本,可用于变量初始化、打印输出表头等操作。 -
pattern{action}:决定动作语句何时触发,pattern可以是正则表达式、关系表达式、模式匹配表达式(使用~匹配和~!不匹配);action决定对数据如何处理,由一个或多个命令、函数、表达式组成-。 -
END{action}:awk 执行pattern{action}后要执行的脚本,如打印所有行的分析结果。 -
这三部分都是可选项目。
三、awk 工作流
-
从
BEGIN命令开始运行 AWK。 -
从输入流读取一行。
-
对读入的行,应用 AWK 命令。
-
如果存在未读取行,则重复步骤 2-3。
-
从
END命令结束运行 AWK。
四、awk 示例操作
1. 打印信息
-
示例 1:打印雇员信息
awk '{ print }'employee.txt。 -
示例 2:通过读取 awk 脚本打印雇员信息,先创建
commands.awk文件写入{print },再执行awk -f commands.awk employee.txt。 -
示例 3:输出包含 “张三” 的行
awk '/张三/{print}'employee.txt,也可简化为awk '/张三/'employee.txt。
2. 统计与判断
-
示例 4:统计包含 “术” 的记录数
bash
awk '/术/{count=count+1} END{ print "count="count }' employee.txt
输出结果为 count=2。
- 示例 5:输出总长度大于 10 的行,使用内置函数
length(),命令为awk 'length($0)>10{print $0}'employee.txt。
3. 综合示例(格式化输出雇员信息表)
-
表头:使用
BEGIN块,awk 'BEGIN{printf"序号\t名字\t部门\t年龄\n--------------"} { print }' employee.txt。 -
表尾:使用
END块,awk 'BEGIN{printf"序号\t名字\t部门\t年龄\n--------------"} { print } END{printf"--------------"}' employee.txt。
五、awk 选项
1. --help 选项
- 用于输出 awk 命令的帮助信息,如
awk --help。
2. -F 选项
-
作用:定义 awk 程序的分隔符,默认分隔符是空格。
-
语法:
-F fs或者--field-separator=fs。 -
示例:打印用户名和家目录,
head -n1 /etc/passwd | awk -F:'{ print $1" "$6}',输出root /root。
3. -v 选项
-
作用:预定义一些变量,在执行 AWK 程序之前定义,在
BEGIN语句之前已定义。 -
示例 1:将外部值传递给 awk,
VAR=10000; echo | awk -v VARABLE=$VAR '{ print VARABLE }',输出10000。 -
示例 2:定义内部变量,
var1="aaa"; var2="bbb"; echo | awk '{ print v1,v2}' v1=$var1 v2=$var2,输出aaa bbb。
4. -p 选项
-
作用:将当前的 awk 程序代码格式化并输出到 file 文件中。
-
格式:
--profile[=file]或者-p[file],默认导出到awkvars文件中。 -
示例:
awk --profile 'BEGIN{print"---Header---\n"} {print} END{print"---Footer---\n"}' employee.txt >/dev/null,生成的awkprof.out会包含格式化后的代码。
六、awk 内置变量
1. 部分内置变量及说明
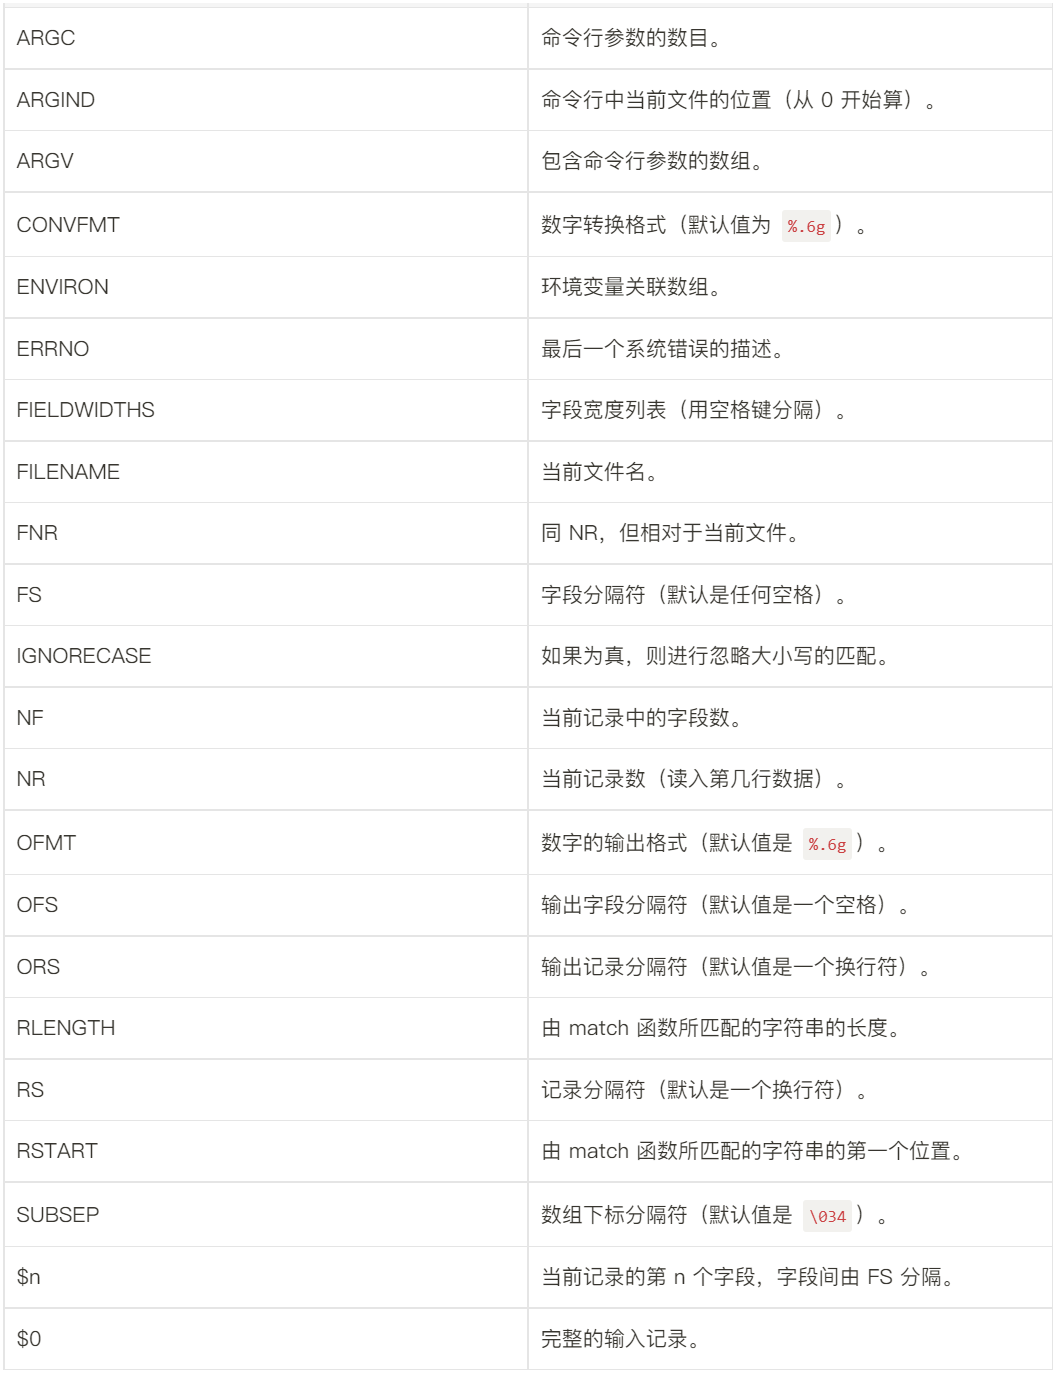
2. 部分变量示例
-
ARGC和ARGV:awk 'BEGIN{ print "Arguments="ARGC; for(i=0;i<=ARGC-1;++i) {printf"ARGV[%d]=%s\n",i,ARGV[i]} }' one two three four,输出Arguments=5及各参数值。 -
FS:默认是空格,awk 'BEGIN{print "FS=#"FS"#"}' | cat -A可查看。 -
NF:echo -e "一 二\n一 二 三\n一 二 三 四" | awk '{ print $0 "\t",NF}',输出每行的字段数。 -
NR:echo -e "一 二\n一 二 三\n一 二 三 四" | awk '{print NR"."$0}',输出带行号的内容。
七、awk 运算符
1. 赋值运算符
- 包括
=、+=、-=、*=、/=、%=、^=、**=,如x=5; x+=2结果为x=7。
2. 算术运算符
- 包括
+、-、*、/、%、^、**,如x=5; x=x+2结果为x=7。
3. 自增和自减运算符
++和--,如x=5; y=x+++2结果为x=6 y=7;x=5; y=++x+2结果为x=6 y=8。
4. 关系运算符
- 包括
<、<=、>、>=、==、!=,如x=25; y=24; if(x>y){print x">"y}输出25>24。
5. 正则表达式运算符
~(匹配)和!~(不匹配),如awk '$0~"四"' employee.txt输出包含 “四” 的行。
6. 逻辑运算符
- 包括
&&(逻辑与)、||(逻辑或)、!(逻辑非),如num=5; if(num>=0 && num<=7){print num"<=7"}输出5<=7。
7. 三目运算符
- 语法:
condition expression? statement1:statement2,如x=25; y=15; (x>y)?max=x:max=y结果为max=25。
八、awk 正则表达式
1. 字符集
-
[^...]匹配除了[...]中字符的所有字符;[a-z]匹配所有小写字母;[A-Z]匹配所有大写字母;[0-9]匹配所有数字等。 -
预定义字符集:
[[:digit:]](数字)、[[:lower:]](小写字母)、[[:upper:]](大写字母)等。
2. 转义字符
- 如
\n匹配换行符、\t匹配制表符、\w匹配字母、数字、下划线等。
3. 限定次数
*匹配前面的子表达式零次或多次;+匹配前面的子表达式一次或多次;?匹配前面的子表达式零次或一次;{n}匹配确定的 n 次等。
4. 定位符
^匹配行首位置;$匹配行末位置;\b匹配单词边界等。
九、awk 语句
1. 条件语句
-
if语句:if(condition) action,如num=10; if (num%2==0){printf"%d is even number.\n",num}输出10 is even number.。 -
if-else语句:if(condition) action-1 else action-2,如判断数字奇偶。 -
if-else-if语句:用于多个条件判断,如a=30; if(a==10){print "a=10"} else if(a==20){print "a=20"} else if(a==30){print "a=30"}输出a=30。
2. 循环语句
-
for循环:for (initialization; condition; increment/decrement) action,如输出 1-5for(i=1;i<=5;++i){print i}。 -
while循环:while (condition) action,如输出 1-5i=1; while(i<6){print i; ++i}。 -
do-while循环:do action while (condition),如输出 1-5i=1; do {print i; ++i} while (i<6)。
3. 循环控制语句
-
break:退出当前循环,如sum=0; for(i=0;i<20;++i){sum+=i; if(sum>50){break} else {print "sum="sum}}。 -
continue:终止当前迭代,开始下一个迭代,如输出 1-20 中的偶数for(i=1;i<=20;++i){if(i%2==0){print i} else{continue}}。 -
exit:退出当前程序,如sum=0; for(i=0;i<20;++i){sum+=i; if(sum>50){exit(10)} else {print "sum="sum}}。
十、awk 数组
1. 创建和访问数组
-
语法:
array_name[index] = value(创建 / 赋值);array_name[index](访问)。 -
示例:以水果为键、颜色为值
bash
awk 'BEGIN{
    colour["芒果"]="橘色";
    colour["橘子"]="黄色";
    colour["苹果"]="红色";
    print colour["芒果"], colour["橘子"], colour["苹果"]
}'
输出:橘色 黄色 红色
2. 打印数组元素
-
无序循环:
for (i in array) {print i ":" array[i]}示例:bash
awk 'BEGIN{
    colour["芒果"]="橘色"; colour["橘子"]="黄色"; colour["苹果"]="红色";
    for (i in colour) {print i ":" colour[i]}
}'
输出:苹果:红色 芒果:橘色 橘子:黄色
-
有序循环:通过数字索引遍历(适用于连续索引数组)
bash
awk 'BEGIN{
    colour[0]="橘色"; colour[1]="黄色"; colour[2]="红色";
    lens=length(colour);
    for(i=0;i<lens;i++) {print i ":" colour[i]}
}'
输出:0:橘色 1:黄色 2:红色
3. 删除数组元素
-
语法:
delete array_name[index]示例:删除 “橘子” 对应的元素bash
awk 'BEGIN{
    colour["芒果"]="橘色"; colour["橘子"]="黄色"; colour["苹果"]="红色";
    delete colour["橘子"];
    for(i in colour) {print i ":" colour[i]}
}'
输出:苹果:红色 芒果:橘色
4. 多维数组模拟
-
awk 仅支持一维数组,可通过字符串索引模拟多维数组(如
array["0,0"]=100)。 示例:bash
awk 'BEGIN{
    array["0,0"]=100; array["0,1"]=200; array["0,2"]=300;
    array["1,0"]=400; array["1,1"]=500; array["1,2"]=600;
    print "array[0,0]=" array["0,0"]; print "array[1,1]=" array["1,1"]
}'
输出:array[0,0]=100 array[1,1]=500
十一、awk 函数
1. 内置字符串函数

2. 内置算术函数
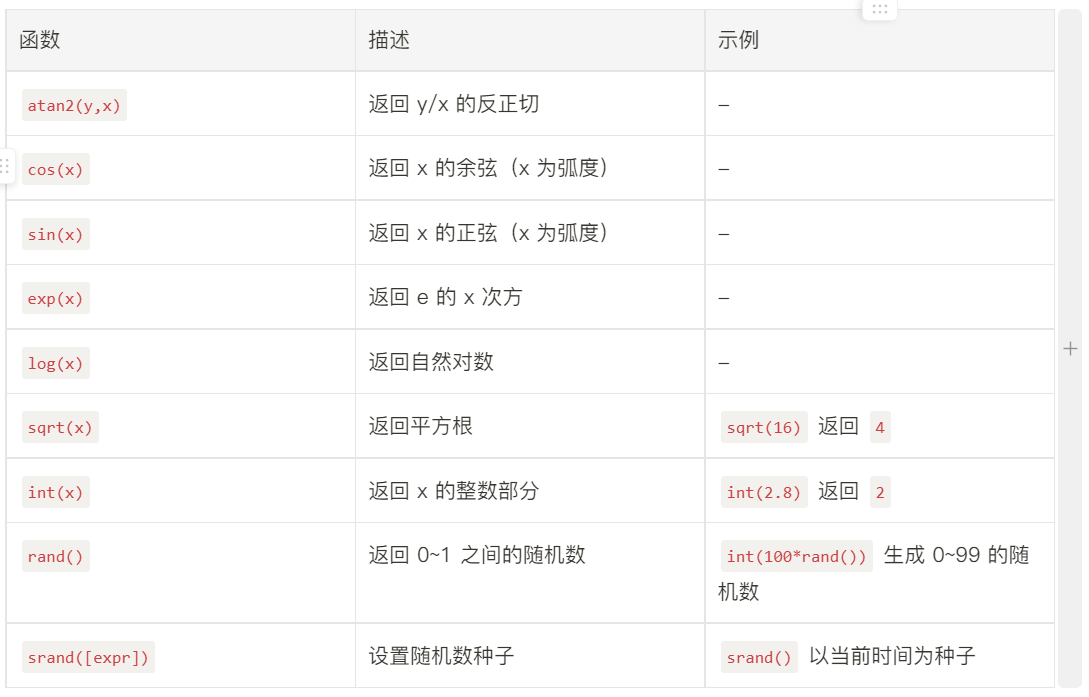
3. 内置时间函数
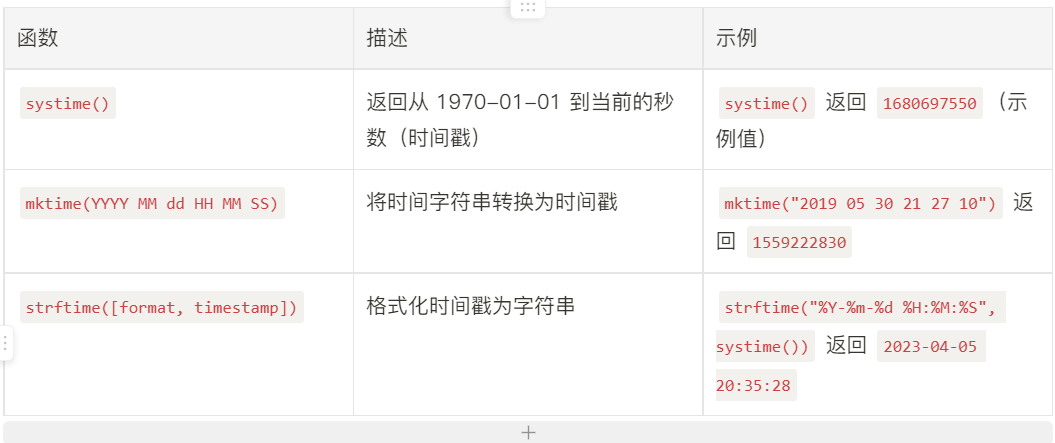
4. 其他内置函数
-
getline:从输入流读取下一行,示例:隔行打印awk '{getline; print $0}' employee.txt -
next:跳过当前行,处理下一行,示例:跳过 “王五” 所在行awk '{if($2~/王五/) {next}; print $0}' employee.txt -
nextfile:跳过当前文件,处理下一个文件 -
system(command):执行系统命令,示例:awk 'BEGIN{system("date")}'输出当前日期
5. 用户自定义函数
-
定义语法:
awk
function 函数名(参数1, 参数2, ...) {
    函数体;
    return 返回值;  # 可选
}
-
示例:定义求两数最大值的函数
bash
awk '
function max(a, b) {
    if (a > b) return a;
    else return b;
}
BEGIN { print "max(10, 20) =", max(10, 20) }
'
输出:max(10, 20) = 20
十二、awk 输出处理
1. 重定向
-
覆盖重定向
>:清空文件后写入,示例:awk 'BEGIN{print "newdata: Hello LaoMa!">"/tmp/message.txt"}' -
追加重定向
>>:追加到文件末尾,示例:awk 'BEGIN{print "newdata: Hello LaoMa!">>"/tmp/message.txt"}'
2. 管道
-
单向管道
|:将输出作为其他命令的输入,示例:awk 'BEGIN{print "hello,world!" | "tr [a-z] [A-Z]"}'输出HELLO,WORLD! -
双向管道
|&:支持双向读写,示例:通过tr转换大小写并读取结果
3. 美化输出(printf 函数)
-
格式化符:
-
%s(字符串)、%d(整数)、%f(浮点数)、%c(字符)等。 -
示例:
printf "姓名: %s, 年龄: %d\n", "张三", 23输出姓名: 张三, 年龄: 23 -
转义字符:
\n(换行)、\t(制表符)、\r(回车)等,示例:printf "编号\t姓名\t部门\n"输出带制表符的表头
更多推荐

 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)