
从数仓建设到标签开发:我的大厂面试复盘实录
"最近面试了几家互联网大厂的大数据的岗位,经历了从数据仓库建设到标签开发,再到性能优化的全方位'拷问'。今天就把这些实战经验整理出来,希望能帮到正在准备面试或对数据开发感兴趣的朋友们!"
先把面试题放在前面,以下问题和答案都是根据个人经验和技能总结整理的,我通过了该公司的面试,顺利拿到了offer,回答基本没什么问题,供大家参考。
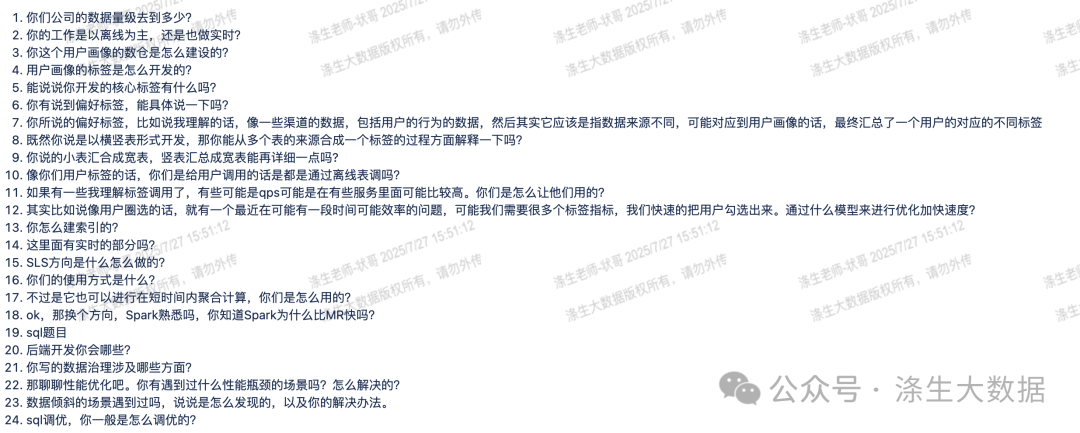
1.用户画像数仓建设
1.数据量级有多大?
面试官:你们公司的数据量级去到多少?
我们主要处理的是TB~PB级数据,用户行为日志每天增量约几十TB,用户画像表存储的是全量用户标签,约亿级用户 x 上千个标签,压缩后存储占用几十TB。
2.离线 or 实时?
面试官:你的工作是以离线为主,还是也做实时?
我们是离线+实时混合架构:
-
离线(T+1):基于Hive/Spark的批处理,计算长期稳定的标签(如用户性别、年龄、长期兴趣)。
-
实时(Flink/Kafka):处理短期动态标签(如最近浏览商品、实时点击行为),延迟控制在分钟级。
3.用户画像数仓怎么建设?
面试官:你这个用户画像的数仓是怎么建设的?
我们采用分层建模:
-
ODS层:原始数据(用户行为日志、业务DB数据)
-
DWD层:清洗后的明细数据(用户行为事件表、用户属性表)
-
DWS层:轻度聚合(用户行为统计、偏好计算)
-
ADS层:最终标签宽表(用户画像表,采用横表转竖表存储)
2.标签开发实战
4.用户标签怎么开发?
面试官:用户画像的标签是怎么开发的?
标签开发流程:
-
数据源分析(行为日志、交易数据、第三方数据)
-
规则定义(统计类、规则类、模型类标签)
-
ETL计算(SQL/Spark/Flink)
-
存储优化(Hive/ClickHouse/ES)
5.核心标签有哪些?
面试官:能说说你开发的核心标签有什么吗?
-
基础属性:性别、年龄、地域
-
行为偏好:浏览偏好(美妆/3C)、购买频次
-
价值分层:高价值用户、流失风险用户
-
实时兴趣:最近搜索关键词、点击商品
6.偏好标签如何计算?
面试官:你有说到偏好标签,能具体说一下吗?
数据来源:点击、浏览、搜索、收藏行为
计算方式:
-
TF-IDF:计算用户对商品类目的偏好权重
-
时间衰减:最近行为权重更高
-
聚合统计:按类目/品牌统计频次
7.多表如何合成一个标签?
面试官:既然你说是以横竖表形式开发,那你能从多个表的来源合成一个标签的过程解释一下吗?
举个个人真实经验,对数据表做了简化。
-
竖表(适合存储稀疏标签):
user_id | tag_name  | tag_value
1001    | gender    | male
1001    | age       | 25
-
横表(适合查询):
user_id | gender | age | preference
1001    | male   | 25  | { "3C":0.8, "美妆":0.2 }
-
ETL过程:用Spark SQL将多个竖表JOIN成宽表,并压缩存储。
3.性能优化方面
8.标签如何高效查询?
面试官:像你们用户标签的话,你们是给用户调用的话都是通过离线表调吗?
-
离线查询:Hive/ClickHouse,适合批量分析
-
在线服务:
-
Redis:缓存高频标签(如用户基础属性)
-
Elasticsearch:支持复杂条件圈选(如"年龄25-30,最近购买过美妆")
-
9.高QPS场景优化?
面试官:如果标签调用的QPS很高,你们怎么优化?
-
缓存策略:Redis集群 + 本地缓存(Caffeine)
-
读写分离:主库写,从库读
-
异步计算:Flink实时更新标签,减少查询压力
10.用户圈选如何加速?
面试官:用户圈选时如何优化查询速度?
-
预计算:提前计算常用组合标签
-
倒排索引:ES存储标签,支持快速过滤
-
列式存储:Parquet/ORC减少IO
4.其他一些技术问题
11.Spark为什么比MR快?
面试官:Spark为什么比MR快?
-
内存计算:MR每次落盘,Spark尽量内存计算
-
DAG优化:MR只有Map+Reduce两阶段,Spark支持复杂DAG
-
线程模型:MR是进程级,Spark是线程级,减少启动开销
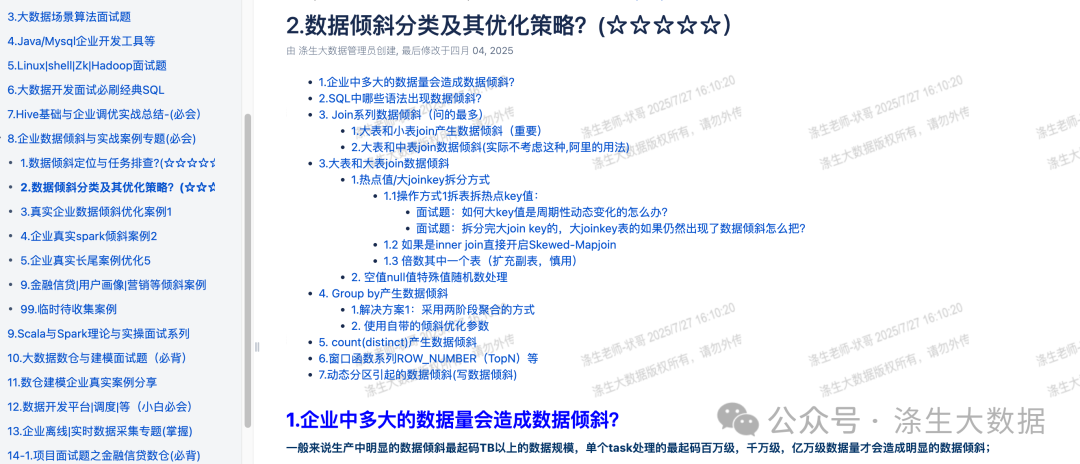
12.数据倾斜怎么解决?
面试官:数据倾斜的场景遇到过吗?怎么解决的?
举个遇到的场景:某个Task执行特别慢,大部分数据集中在少数Key
解决方案:
-
加盐:对倾斜Key加随机前缀,分散计算
-
两阶段聚合:先局部聚合,再全局聚合
-
广播小表:避免大表JOIN小表时的倾斜
5.SQL调优 & 数据治理
13.SQL调优技巧
面试官:SQL调优一般怎么做?
-
避免SELECT *:只取需要的列
-
合理使用分区:按时间/用户ID分区
-
JOIN优化:小表放右侧,大表用MAP JOIN
14.数据治理经验
面试官:数据治理涉及哪些方面?
-
元数据管理:标签口径、数据血缘
-
数据质量:监控空值率、重复数据
-
生命周期:冷热数据分层存储
- 分割线 -
"最近面试了几家互联网大厂的大数据的岗位,经历了从数据仓库建设到标签开发,再到性能优化的全方位'拷问'。今天就把这些实战经验整理出来,希望能帮到正在准备面试或对数据开发感兴趣的朋友们!"
先把面试题放在前面,以下问题和答案都是根据个人经验和技能总结整理的,我通过了该公司的面试,顺利拿到了offer,回答基本没什么问题,供大家参考。
1.用户画像数仓建设
1.数据量级有多大?
面试官:你们公司的数据量级去到多少?
我们主要处理的是TB~PB级数据,用户行为日志每天增量约几十TB,用户画像表存储的是全量用户标签,约亿级用户 x 上千个标签,压缩后存储占用几十TB。
2.离线 or 实时?
面试官:你的工作是以离线为主,还是也做实时?
我们是离线+实时混合架构:
-
离线(T+1):基于Hive/Spark的批处理,计算长期稳定的标签(如用户性别、年龄、长期兴趣)。
-
实时(Flink/Kafka):处理短期动态标签(如最近浏览商品、实时点击行为),延迟控制在分钟级。
3.用户画像数仓怎么建设?
面试官:你这个用户画像的数仓是怎么建设的?
我们采用分层建模:
-
ODS层:原始数据(用户行为日志、业务DB数据)
-
DWD层:清洗后的明细数据(用户行为事件表、用户属性表)
-
DWS层:轻度聚合(用户行为统计、偏好计算)
-
ADS层:最终标签宽表(用户画像表,采用横表转竖表存储)
2.标签开发实战
4.用户标签怎么开发?
面试官:用户画像的标签是怎么开发的?
标签开发流程:
-
数据源分析(行为日志、交易数据、第三方数据)
-
规则定义(统计类、规则类、模型类标签)
-
ETL计算(SQL/Spark/Flink)
-
存储优化(Hive/ClickHouse/ES)
5.核心标签有哪些?
面试官:能说说你开发的核心标签有什么吗?
-
基础属性:性别、年龄、地域
-
行为偏好:浏览偏好(美妆/3C)、购买频次
-
价值分层:高价值用户、流失风险用户
-
实时兴趣:最近搜索关键词、点击商品
6.偏好标签如何计算?
面试官:你有说到偏好标签,能具体说一下吗?
数据来源:点击、浏览、搜索、收藏行为
计算方式:
-
TF-IDF:计算用户对商品类目的偏好权重
-
时间衰减:最近行为权重更高
-
聚合统计:按类目/品牌统计频次
7.多表如何合成一个标签?
面试官:既然你说是以横竖表形式开发,那你能从多个表的来源合成一个标签的过程解释一下吗?
举个个人真实经验,对数据表做了简化。
-
竖表(适合存储稀疏标签):
user_id | tag_name  | tag_value
1001    | gender    | male
1001    | age       | 25
-
横表(适合查询):
user_id | gender | age | preference
1001    | male   | 25  | { "3C":0.8, "美妆":0.2 }
-
ETL过程:用Spark SQL将多个竖表JOIN成宽表,并压缩存储。
3.性能优化方面
8.标签如何高效查询?
面试官:像你们用户标签的话,你们是给用户调用的话都是通过离线表调吗?
-
离线查询:Hive/ClickHouse,适合批量分析
-
在线服务:
-
Redis:缓存高频标签(如用户基础属性)
-
Elasticsearch:支持复杂条件圈选(如"年龄25-30,最近购买过美妆")
-
9.高QPS场景优化?
面试官:如果标签调用的QPS很高,你们怎么优化?
-
缓存策略:Redis集群 + 本地缓存(Caffeine)
-
读写分离:主库写,从库读
-
异步计算:Flink实时更新标签,减少查询压力
10.用户圈选如何加速?
面试官:用户圈选时如何优化查询速度?
-
预计算:提前计算常用组合标签
-
倒排索引:ES存储标签,支持快速过滤
-
列式存储:Parquet/ORC减少IO
4.其他一些技术问题
11.Spark为什么比MR快?
面试官:Spark为什么比MR快?
-
内存计算:MR每次落盘,Spark尽量内存计算
-
DAG优化:MR只有Map+Reduce两阶段,Spark支持复杂DAG
-
线程模型:MR是进程级,Spark是线程级,减少启动开销
12.数据倾斜怎么解决?
面试官:数据倾斜的场景遇到过吗?怎么解决的?
举个遇到的场景:某个Task执行特别慢,大部分数据集中在少数Key
解决方案:
-
加盐:对倾斜Key加随机前缀,分散计算
-
两阶段聚合:先局部聚合,再全局聚合
-
广播小表:避免大表JOIN小表时的倾斜
5.SQL调优 & 数据治理
13.SQL调优技巧
面试官:SQL调优一般怎么做?
-
避免SELECT *:只取需要的列
-
合理使用分区:按时间/用户ID分区
-
JOIN优化:小表放右侧,大表用MAP JOIN
14.数据治理经验
面试官:数据治理涉及哪些方面?
-
元数据管理:标签口径、数据血缘
-
数据质量:监控空值率、重复数据
-
生命周期:冷热数据分层存储
- 分割线 -
为什么选择涤生大数据?
- 1.跟随行业专家学习:我们的导师不是传统的讲师,而是实际的行业专家。他们都是来自国内一线大厂的资深开发,大数据技术专家等。
- 2.跟企业在职开发一起学习:涤生的社招学员目前60%+是企业在职进阶学员,基本各大厂的进阶学员都有,他们的薪资从10k,15k,20k,25k,30k,35k,40k。所以你会跟很多企业在职人员一起交流学习
- 3.定制化课程设计:结合每位学员的进行定制化教学,学习规划,让你的学习更有重点;结合每个学员的时间规划学习进度,督促考核,让学习变得更加灵活。
- 4.专业教学和平台:术业有专攻,企业怎么用,面试怎么面,我们就怎么学,涤生让大数据学习不迷惘。目前涤生采购10台服务器,自研提供一站式大数据平台供学习使用,拒绝虚拟机。
- 5.专业的简历面试辅导:涤生内部所有同学简历面试辅导都包含在内,从学习到入职试用期全流程提供保障服务。2024年截止当前涤生到简历面试7级群的学员就业率98%+,2024年上岸200+同学,60+入职一线中大厂。当然也有不少培训找不到工作的同学,以及裁员的同学,空窗期太久,最终跟着我们搞顺利上岸
- 6.不错的口碑:在涤生这,只要你不摆烂,我们不抛弃不放弃。目前涤生的学员大概有25%是老学员推荐和转化。
- 7.专门的校招大数据:校招跟社招不一样。全网独家的校招大数据课程,专门的校招团队辅导,今年是第五届校招大数据,内部校招面试资料覆盖一线中大厂90%的面试。从校招规划+系统的大数据课程+实习面试辅导+简历面试辅导+实习期辅导+试用期辅导,一次收费一条龙全流程贯穿。2024春招+2025年春招累计50+同学拿到一线中大厂offer
更多推荐


 29
 0
- 0


 已为社区贡献7条内容

所有评论(0)