
图论算法实现:理论与应用详解

简介:图论是数学和计算机科学的重要分支,专注于顶点和边构成的图形结构的研究。文章全面探讨了图论的基础概念、核心算法以及在现实世界问题中的应用,包括图的构成、遍历方法、重要算法(如最短路径、拓扑排序、最小生成树、回路检测)以及实际应用场景(如网络路由、社交网络分析、交通规划等)。掌握图论算法对于解决现实世界的复杂问题至关重要,本书为读者提供了深入理解图论核心内容的宝贵资源。
1. 图论基础概述
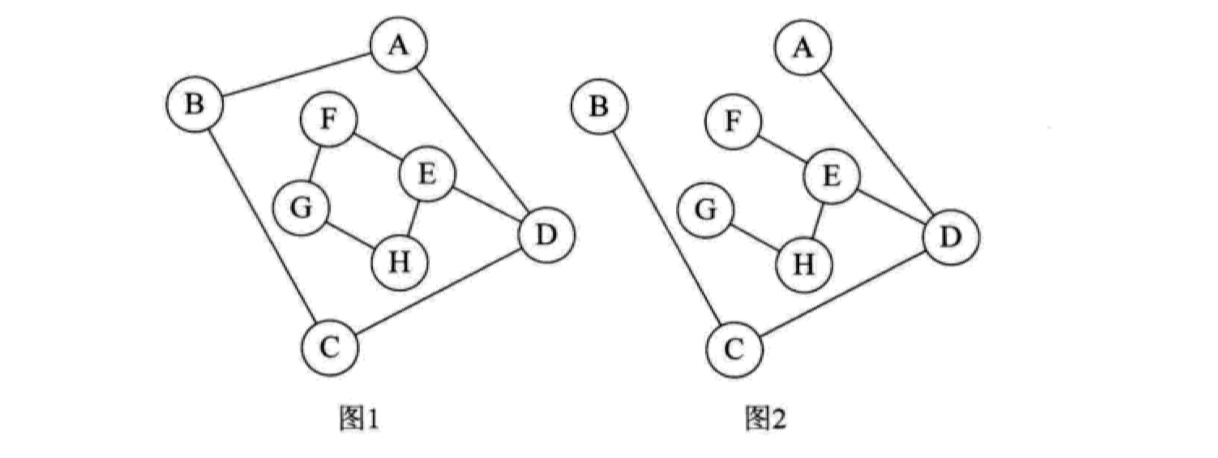
图论作为数学的一个分支,研究的是图的性质和图之间的关系。它以图这种数据结构为核心,广泛应用于计算机科学、网络设计、社会学、运筹学等多个领域。图由顶点(节点)和连接顶点的边组成,能够抽象化表示复杂的关系网络。图论的基本概念包括路径、环、连通性、子图等,这些概念帮助我们理解和解决实际问题中遇到的各种网络关系。接下来的章节,我们将逐步深入探讨图的分类、表示方法、遍历算法、关键算法以及高级问题解决等,探索图论在现实世界中的应用。
2. 图的表示与遍历
在当今IT行业中,图论作为一门基础而核心的学科,在网络科学、数据结构、优化算法等领域得到了广泛的应用。掌握图的表示方法和遍历技巧,是进行高级图论算法分析和应用的前提。本章节将详细介绍图的分类、表示方法和遍历算法。
2.1 图的分类与属性
2.1.1 无向图与有向图的特点
图(Graph)是由顶点(Vertex)集合和连接顶点的边(Edge)集合组成的一种数据结构。在图的分类中,无向图(Undirected Graph)与有向图(Directed Graph)是最基本的两种类型。
无向图的边没有方向,即边连接的两个顶点之间是双向的。举例来说,一个社交网络可以被视为无向图,因为朋友关系是双向的,即如果A是B的朋友,那么B也是A的朋友。
有向图的边具有方向,即边从一个顶点指向另一个顶点。在Web网络中,有向图可以表示网页之间的链接,即“超链接”是有方向的,从一个网页指向另一个网页。
2.1.2 加权图与非加权图的应用场景
加权图(Weighted Graph)是边具有权重的图,权重可以表示边的长度、成本、容量等。加权图在现实世界中有着广泛的应用,例如在交通运输网络中,权重可以代表道路的距离或通行时间,用于最短路径问题的求解。
非加权图(Unweighted Graph)的边没有权重,所有的边都被视为等价的。非加权图适用于只关注顶点间连接关系,而不关心连接方式的场景,例如社交网络中的关注关系。
2.2 图的表示方法
2.2.1 邻接矩阵的构建与特点
邻接矩阵(Adjacency Matrix)是一种表示图的方法,通常用一个二维数组表示,其中元素(a_{ij})表示顶点i与顶点j之间是否存在边。若存在,则(a_{ij})为边的权重;若不存在,则为0(无向图)或某个特定值(有向图)。
邻接矩阵的主要优点是直观且易于实现,便于检测任意两个顶点之间的连通性。然而,其缺点是空间复杂度高,特别是在稀疏图中,会浪费大量空间存储不存在的边。
# 示例Python代码:构建无向图的邻接矩阵表示

# 初始化顶点数和邻接矩阵
V = 4
adjacency_matrix = [[0 for x in range(V)] for y in range(V)]

# 添加边
edges = [(0, 1), (0, 2), (1, 2), (2, 3)]

for edge in edges:
    adjacency_matrix[edge[0]][edge[1]] = 1
    adjacency_matrix[edge[1]][edge[0]] = 1  # 无向图,所以也要填充对称位置
# 打印邻接矩阵
for row in adjacency_matrix:
    print(row)
2.2.2 邻接表的构建与优势分析
邻接表(Adjacency List)是另一种图的表示方法,它使用一个链表数组来表示图,数组的每个元素指向一条链表,链表中的每个节点包含一个顶点和其邻接顶点的列表。
邻接表的优点是节省空间,特别适合表示稀疏图。在邻接表中,可以迅速找到与任意顶点相邻的所有顶点,这在某些算法中是非常高效的。
# 示例Python代码:构建无向图的邻接表表示

# 初始化顶点数和邻接表
V = 4
adjacency_list = [[] for _ in range(V)]

# 添加边
edges = [(0, 1), (0, 2), (1, 2), (2, 3)]

for edge in edges:
    adjacency_list[edge[0]].append(edge[1])
    adjacency_list[edge[1]].append(edge[0])  # 无向图,所以也要添加对称边

# 打印邻接表
for i, neighbors in enumerate(adjacency_list):
    print(f"Vertex {i}: {neighbors}")
2.3 图的遍历算法
2.3.1 深度优先搜索(DFS)的原理与实现
深度优先搜索(DFS)是一种用于遍历或搜索树或图的算法。在DFS中,我们从根节点或任意节点开始,沿着树的深度遍历树的节点,尽可能深地搜索树的分支。
DFS的实现通常使用递归或栈。在图的表示中,我们通常从某个顶点开始,访问其邻接顶点,然后递归地对邻接顶点的邻接顶点进行同样的操作,直到没有新的顶点可以访问为止。
# 示例Python代码:实现无向图的深度优先搜索

# 使用邻接表表示图
edges = [(0, 1), (0, 2), (1, 2), (2, 3)]
adjacency_list = [[] for _ in range(4)]

for edge in edges:
    adjacency_list[edge[0]].append(edge[1])
    adjacency_list[edge[1]].append(edge[0])

# DFS实现
def DFS(graph, start, visited=None):
    if visited is None:
        visited = set()
    visited.add(start)
    print(start, end=" ")
    for neighbor in graph[start]:
        if neighbor not in visited:
            DFS(graph, neighbor, visited)
    return visited

# 执行DFS
DFS(adjacency_list, 0)
2.3.2 广度优先搜索(BFS)的原理与实现
广度优先搜索(BFS)是另一种用于遍历或搜索树或图的算法。与DFS不同,BFS按照树或图的层次,一层一层地进行遍历。
BFS的实现通常使用队列。从根节点或起始节点开始,先访问该节点,然后将其所有未访问的邻接节点添加到队列中,再按队列顺序访问这些节点的邻接节点,直到队列为空。
# 示例Python代码:实现无向图的广度优先搜索

from collections import deque

# 使用邻接表表示图
edges = [(0, 1), (0, 2), (1, 2), (2, 3)]
adjacency_list = [[] for _ in range(4)]

for edge in edges:
    adjacency_list[edge[0]].append(edge[1])
    adjacency_list[edge[1]].append(edge[0])

# BFS实现
def BFS(graph, start):
    visited = set()
    queue = deque([start])
    while queue:
        vertex = queue.popleft()
        if vertex not in visited:
            print(vertex, end=" ")
            visited.add(vertex)
            queue.extend(set(graph[vertex]) - visited)
    return visited

# 执行BFS
BFS(adjacency_list, 0)
在接下来的章节中,我们将进一步探索图论中的一些高级问题,如特殊路径问题和回路检测算法,以及图论在实际问题中的应用,如网络路由优化、社交网络分析和交通规划。通过对这些高级问题和应用的深入学习,可以更好地理解图论在解决复杂问题中的强大功能和应用价值。
3. 图论中的关键算法
3.1 最短路径问题
3.1.1 Dijkstra算法的理论基础与步骤
Dijkstra算法是一种用于在图中找到单源最短路径的算法,它适用于带权重的图,且权重必须为非负。其核心思想是贪心算法,通过逐步将顶点划分为两个子集——已经找到最短路径的顶点集合和未被探索的顶点集合,直到找到目标顶点的最短路径为止。
算法步骤如下:
- 将所有顶点划分为两个集合:已访问集合(已完成)和未访问集合(未完成)。
- 将起始顶点的距离设为0,所有其他顶点的距离设为无穷大。
- 选择未访问集合中距离最小的顶点,将其加入已完成集合。
- 更新当前顶点的相邻顶点的距离,即从当前顶点到未完成集合中每一个顶点的距离,并保存较小的值。
- 重复步骤3和4,直到未访问集合为空。
Dijkstra算法通常使用优先队列来实现,以优化距离更新步骤。
import heapq

def dijkstra(graph, start):
    distances = {vertex: float('infinity') for vertex in graph}
    distances[start] = 0
    priority_queue = [(0, start)]
    visited = set()

    while priority_queue:
        current_distance, current_vertex = heapq.heappop(priority_queue)

        if current_vertex in visited:
            continue

        visited.add(current_vertex)

        for neighbor, weight in graph[current_vertex].items():
            distance = current_distance + weight

            if distance < distances[neighbor]:
                distances[neighbor] = distance
                heapq.heappush(priority_queue, (distance, neighbor))

    return distances

# 示例图
graph = {
    'A': {'B': 1, 'C': 4},
    'B': {'A': 1, 'C': 2, 'D': 5},
    'C': {'A': 4, 'B': 2, 'D': 1},
    'D': {'B': 5, 'C': 1}
}

# 执行Dijkstra算法
print(dijkstra(graph, 'A'))
3.1.2 Floyd-Warshall算法的全局视角与优化
Floyd-Warshall算法是一种用于在加权图中找出所有顶点对之间的最短路径的算法。该算法不仅能解决单源最短路径问题,还能处理包含负权重边的图(但不能处理负权重环)。
Floyd-Warshall算法逐步将中间顶点数量从0增加到所有顶点的数量,逐步寻找更短的路径。其算法步骤如下:
- 初始化一个二维数组
dist[][],dist[i][j]表示顶点i到顶点j的初始距离。 - 若i和j之间没有直接的边,则
dist[i][j]为无穷大。 - 用图中直接的边更新
dist[][]。 - 通过三个顶点(k、i、j)来更新
dist[i][j],若通过顶点k的路径比直接路径短,则更新dist[i][j]。
优化Floyd-Warshall算法的关键在于避免重复计算,可以利用动态规划的思想来实现。
def floyd_warshall(graph):
    distances = {vertex: {vertex: 0 for vertex in graph} for vertex in graph}
    # 初始化距离矩阵
    for vertex in graph:
        for another_vertex in graph:
            if vertex != another_vertex:
                distances[vertex][another_vertex] = float('infinity')
    # 填入直接的距离
    for vertex in graph:
        for another_vertex, weight in graph[vertex].items():
            distances[vertex][another_vertex] = weight

    # Floyd-Warshall 算法
    for k in graph:
        for i in graph:
            for j in graph:
                if distances[i][j] > distances[i][k] + distances[k][j]:
                    distances[i][j] = distances[i][k] + distances[k][j]
    return distances

# 示例图
graph = {
    'A': {'B': 1, 'C': 4},
    'B': {'A': 1, 'C': 2, 'D': 5},
    'C': {'A': 4, 'B': 2, 'D': 1},
    'D': {'B': 5, 'C': 1}
}

# 执行Floyd-Warshall算法
print(floyd_warshall(graph))
3.1.3 Bellman-Ford算法的动态规划思想
Bellman-Ford算法同样可以用于找到加权图中所有顶点对之间的最短路径。与Floyd-Warshall算法不同,Bellman-Ford算法可以处理带有负权重边的图,还能检测出图中是否存在负权重环。
算法步骤如下:
- 初始化距离数组,每个顶点到起点的距离设为无穷大,到起点的距离设为0。
- 对图中的每条边进行
V-1次松弛操作(V为顶点的数量),更新最短路径。 - 检查图中是否有负权重环,通过再次对所有边进行松弛操作,如果距离还能被更新,则存在负权重环。
def bellman_ford(graph, start):
    distances = {vertex: float('infinity') for vertex in graph}
    distances[start] = 0
    predecessor = {vertex: None for vertex in graph}

    for _ in range(len(graph) - 1):
        for vertex in graph:
            for neighbor, weight in graph[vertex].items():
                if distances[vertex] + weight < distances[neighbor]:
                    distances[neighbor] = distances[vertex] + weight
                    predecessor[neighbor] = vertex

    return distances, predecessor

# 示例图
graph = {
    'A': {'B': -1, 'C': 4},
    'B': {'A': -1, 'C': 2, 'D': 5},
    'C': {'A': 4, 'B': 2, 'D': 1},
    'D': {'B': 5, 'C': 1}
}

# 执行Bellman-Ford算法
distances, _ = bellman_ford(graph, 'A')
print(distances)
3.2 拓扑排序与最小生成树
3.2.1 Kahn算法与TopologicalSort函数的区别与适用性
Kahn算法和TopologicalSort函数都用于在有向无环图(DAG)中进行拓扑排序,即将图中的顶点线性排序,使得对于任何一条有向边(u, v),顶点u都在顶点v之前。
Kahn算法使用了入度的概念:
- 计算所有顶点的入度。
- 将入度为0的顶点放入一个队列中。
- 当队列非空时,从队列中取出一个顶点,并遍历其所有邻接点,将邻接点的入度减1,若入度变为0,则将其加入队列。
- 重复步骤3,直到队列为空。
TopologicalSort函数则是基于深度优先搜索(DFS)的递归实现。
from collections import deque

def kahn_topological_sort(graph):
    in_degree = {u: 0 for u in graph}
    for u in graph:
        for v in graph[u]:
            in_degree[v] += 1
    queue = deque([u for u in in_degree if in_degree[u] == 0])
    sorted_list = []
    while queue:
        u = queue.popleft()
        sorted_list.append(u)
        for v in graph[u]:
            in_degree[v] -= 1
            if in_degree[v] == 0:
                queue.append(v)
    if len(sorted_list) == len(graph):
        return sorted_list
    else:
        raise ValueError("The graph has a cycle.")

# 示例图
graph = {
    'A': ['B', 'C'],
    'B': ['D'],
    'C': ['D'],
    'D': []
}

# 执行Kahn算法的拓扑排序
print(kahn_topological_sort(graph))
Kahn算法适用于入度较小的情况,因为其操作主要集中在处理入度为0的顶点;而TopologicalSort函数适用于需要递归遍历的情况,具有较好的适用性。
3.2.2 Prim算法与Kruskal算法的最小生成树构造
最小生成树(MST)问题是在加权连通图中找到一个包含所有顶点的边的集合,使得集合中边的权重总和最小,并且不形成环。
Prim算法从一个顶点开始,逐步向树中添加边和顶点。其步骤如下:
- 初始化一个空树T,选择一个起始顶点加入T。
- 在T中找出连接T和剩余顶点的权重最小的边,并将其加入T中。
- 重复步骤2,直到T中包含所有顶点。
import heapq

def prim(graph, start):
    mst = []
    visited = set([start])
    edges = [(cost, start, to) for to, cost in graph[start].items()]
    heapq.heapify(edges)

    while edges:
        cost, frm, to = heapq.heappop(edges)
        if to not in visited:
            visited.add(to)
            mst.append((frm, to, cost))

            for neighbor, weight in graph[to].items():
                if neighbor not in visited:
                    heapq.heappush(edges, (weight, to, neighbor))

    return mst

# 示例图
graph = {
    'A': {'B': 2, 'C': 3},
    'B': {'A': 2, 'C': 1, 'D': 1},
    'C': {'A': 3, 'B': 1, 'D': 5},
    'D': {'B': 1, 'C': 5}
}

# 执行Prim算法
print(prim(graph, 'A'))
Kruskal算法通过边来构造MST,其步骤如下:
- 将所有边按权重进行排序。
- 初始化一个空树T。
- 依序选择最小的边加入T中,但仅当这条边不会与T中的边形成环。
from collections import defaultdict

class DisjointSet:
    def __init__(self, vertices):
        self.vertices = vertices
        self.parent = {vertex: vertex for vertex in vertices}
        self.rank = {vertex: 0 for vertex in vertices}

    def find(self, item):
        if self.parent[item] != item:
            self.parent[item] = self.find(self.parent[item])
        return self.parent[item]

    def union(self, set1, set2):
        root1 = self.find(set1)
        root2 = self.find(set2)
        if root1 != root2:
            if self.rank[root1] > self.rank[root2]:
                self.parent[root2] = root1
            elif self.rank[root1] < self.rank[root2]:
                self.parent[root1] = root2
            else:
                self.parent[root2] = root1
                self.rank[root1] += 1
            return True
        return False

def kruskal(graph):
    edges = sorted(graph['edges'], key=lambda item: item[2])
    ds = DisjointSet(graph['vertices'])
    mst = []
    for edge in edges:
        u, v, weight = edge
        if ds.union(u, v):
            mst.append(edge)

    return mst

# 示例图
graph = {
    'vertices': ['A', 'B', 'C', 'D'],
    'edges': [('A', 'B', 2), ('A', 'C', 3), ('B', 'C', 1), ('B', 'D', 1), ('C', 'D', 5)]
}

# 执行Kruskal算法
print(kruskal(graph))
Prim算法更适用于边稠密的图,因为它是在顶点上进行操作;而Kruskal算法适合边稀疏的图,因为它是在边的基础上进行操作,适合边的排序和合并操作。
4. 图论的高级问题解决
在前几章的铺垫下,我们已经对图论有了基础的认识,并掌握了图的表示与遍历方法。在这一章,我们将深入了解图论的高级问题解决方法,其中包括特殊路径问题和回路检测算法。
4.1 特殊路径问题
4.1.1 欧拉路径的存在条件与应用
欧拉路径是一种特殊的路径,存在于图论中,且在实际应用中具有重大意义。要理解欧拉路径,首先需要明确欧拉图的定义:在欧拉图中,存在一条路径(或回路)能够通过图中的每条边恰好一次。
欧拉路径的判定条件
欧拉路径的存在条件是图必须满足以下两个之一:
1. 图是连通的,并且有且仅有0个或2个顶点的度数为奇数。
2. 图是连通的,并且所有顶点的度数均为偶数。
欧拉路径的实现
以有向图为例,如果每个顶点的入度与出度相等,那么图中存在欧拉回路。如果图中有两个顶点的入度和出度不等,且其他顶点都满足入度和出度相等,则这两个顶点分别是路径的起点和终点,存在欧拉路径。
# 示例代码:欧拉路径判定函数
def is_eulerian(graph):
    # 计算每个顶点的度数
    degree = {v: 0 for v in graph}
    for v in graph:
        degree[v] += len(graph[v])  # 有向图的出度
        for u in graph[v]:
            degree[u] += 1  # 有向图的入度

    odd_degree_vertices = [v for v in degree if degree[v] % 2 != 0]

    # 如果图是无向图,则所有顶点的度数必须都是偶数。
    if is_undirected_graph:
        return len(odd_degree_vertices) == 0
    # 如果图是有向图,则只有0个或2个顶点的度数为奇数。
    else:
        return len(odd_degree_vertices) in [0, 2]

# 判断是否为欧拉图
is_undirected_graph = False  # 根据实际情况设置
if is_eulerian(graph):
    print("图存在欧拉路径")
else:
    print("图不存在欧拉路径")
通过上述函数,我们可以判定一个给定的图是否存在欧拉路径。
欧拉路径的应用
在实际应用中,欧拉路径可用于解决诸多问题,例如:
- 清洁工安排清扫路线,要求每条街道只清扫一次;
- 某些棋类游戏的走法问题,如在国际象棋中,骑士巡游问题;
- 某些邮递员分发邮件,要求邮件分发路径覆盖每条道路一次。
4.1.2 哈密顿路径的判定方法与NP问题
哈密顿路径是一个从图的一个顶点到另一个顶点的路径,它恰好经过图中的每一个顶点一次。与欧拉路径不同,哈密顿路径的判定问题属于NP完全问题,目前没有已知的多项式时间复杂度的算法。
哈密顿路径的判定方法
要判定一个图是否包含哈密顿路径,最直接的方法是尝试所有可能的顶点排列,检查是否存在一条路径经过所有顶点一次。但是,这种方法的时间复杂度是阶乘级别的,对于大型图来说是不现实的。
# 示例代码:哈密顿路径的存在性检查(暴力法)
def is_hamiltonian(graph):
    path = []
    def hamiltonian_path(remaining):
        if not remaining:
            return len(path) == len(graph)
        last = path[-1]
        for v in remaining:
            if all(last != graph[u] for u in path) and all(v != graph[u] for u in path):
                path.append(v)
                if hamiltonian_path(remaining - {v}):
                    return True
                path.pop()
        return False

    return hamiltonian_path(set(graph.keys()))

# 检查图是否存在哈密顿路径
if is_hamiltonian(graph):
    print("图存在哈密顿路径")
else:
    print("图不存在哈密顿路径")
哈密顿路径与NP问题
哈密顿路径问题是NP问题,这意味着不存在多项式时间的算法来判定一个图是否包含哈密顿路径,但一旦给定一个路径,可以在多项式时间内验证这个路径是否是哈密顿路径。
哈密顿路径问题在实际中有广泛的应用,如旅行推销员问题(TSP),它寻求最短的路径来访问一系列城市,并返回出发点。这个问题与哈密顿路径密切相关,但加入了路径长度的考虑。
4.2 回路检测算法
4.2.1 Fleury算法的回路检测机制
Fleury算法是回路检测的一个经典算法,它通过在每次选择边时尝试尽可能少地切断剩余的图来进行。Fleury算法的核心思想是在遍历过程中尽量避免选择桥(割边),即不选择那些一旦被选择就会立即增加图的连通分量数的边。
# 示例代码:Fleury算法实现
def fleury(graph, start):
    path = [start]
    while len(path) < len(graph):
        for next_node in graph[path[-1]]:
            if len(set(path).intersection(graph[next_node])) == 1:
                path.append(next_node)
                break
        else:
            return None
    return path

# 使用Fleury算法检查回路
path = fleury(graph, 'A')
if path:
    print("存在回路:", path)
else:
    print("不存在回路")
4.2.2 Tarjan算法的回路检测优化
Tarjan算法是另一种有效的回路检测方法。它基于DFS(深度优先搜索)进行回路检测,并维护一个栈来记录访问路径,如果当前的边连接到栈中已有的顶点,则存在回路。
# 示例代码:Tarjan算法实现
def tarjan(graph, start):
    stack = []
    visited = set()
    rec_stack = set()

    def add_edge(v):
        if v not in stack:
            stack.append(v)
        else:
            while stack and stack[-1] != v:
                rec_stack.add(stack.pop())
            rec_stack.add(v)

    def remove_edge(v):
        while stack[-1] != v:
            rec_stack.remove(stack.pop())
        rec_stack.remove(v)
        stack.pop()

    def is_cyclic_util(v):
        if v not in visited:
            visited.add(v)
            rec_stack.add(v)

            for i, j in graph[v].items():
                if j not in visited:
                    add_edge(i)
                    if is_cyclic_util(j):
                        return True
                elif i in rec_stack:
                    return True

        remove_edge(v)
        return False

    if is_cyclic_util(start):
        return True
    else:
        return False

# 使用Tarjan算法检查回路
if tarjan(graph, 'A'):
    print("图中存在回路")
else:
    print("图中不存在回路")
4.2.3 Kosaraju算法的回路检测策略
Kosaraju算法的回路检测策略依赖于深度优先搜索(DFS)和强连通分量(SCC)的概念。通过两次DFS,首先在原图上进行,然后在转置图(即反向图)上进行,可以找到所有的强连通分量。
# 示例代码:Kosaraju算法实现
def kosaraju(graph):
    def dfs(node):
        visited.add(node)
        for neighbor in graph[node]:
            if neighbor not in visited:
                dfs(neighbor)
        stack.append(node)
    def dfs_transposed(node):
        visited_transposed.add(node)
        for neighbor in reversed_transposed[node]:
            if neighbor not in visited_transposed:
                dfs_transposed(neighbor)
        component.append(node)
    visited, visited_transposed, stack, component = set(), set(), [], []
    reverse_graph = {node: [] for node in graph}
    for node in graph:
        for neighbor in graph[node]:
            reverse_graph[neighbor].append(node)
    reversed_transposed = {node: [] for node in reverse_graph}

    for node in reverse_graph:
        for neighbor in reverse_graph[node]:
            reversed_transposed[neighbor].append(node)

    for node in graph:
        if node not in visited:
            dfs(node)
    for node in reverse_graph:
        if node not in visited_transposed:
            dfs_transposed(node)

    return stack, component

# 使用Kosaraju算法找出强连通分量
stack, component = kosaraju(graph)
if len(component) > 1:
    print("图中存在多个强连通分量,暗示存在回路")
else:
    print("图中不存在回路")
通过上述算法,我们可以有效地检测图中的回路,为图论问题的解决提供了有力的工具。
5. 图论在实际问题中的应用
5.1 网络路由与优化
在现代计算机网络中,路由选择和优化是极其重要的。图论在这一领域中提供了强大的理论基础和实用算法。网络可以被抽象为图,其中计算机网络的节点代表路由器或交换机,而边代表节点间的通信链路。
5.1.1 最短路径算法在网络路由中的应用
在网络路由中,最短路径算法是确定两个节点之间最快或成本最低的路径的关键。这类问题可以用著名的Dijkstra算法来解决。Dijkstra算法可以找到单源最短路径,也就是说,给定一个源点,算法会计算出从源点到图中所有其他节点的最短路径。
下面是一个使用Python实现的Dijkstra算法的简化例子:
import heapq

def dijkstra(graph, start):
    distances = {vertex: float('infinity') for vertex in graph}
    distances[start] = 0
    priority_queue = [(0, start)]

    while priority_queue:
        current_distance, current_vertex = heapq.heappop(priority_queue)
        if current_distance > distances[current_vertex]:
            continue
        for neighbor, weight in graph[current_vertex].items():
            distance = current_distance + weight
            if distance < distances[neighbor]:
                distances[neighbor] = distance
                heapq.heappush(priority_queue, (distance, neighbor))
    return distances

# 一个简单的图的示例
graph = {
    'A': {'B': 1, 'C': 4},
    'B': {'A': 1, 'C': 2, 'D': 5},
    'C': {'A': 4, 'B': 2, 'D': 1},
    'D': {'B': 5, 'C': 1}
}

print(dijkstra(graph, 'A'))
这个算法可以有效地在网络拓扑中找到两点之间的最短路径,这对于路由决策来说是至关重要的。
5.1.2 拓扑排序在网络拓扑设计中的重要性
拓扑排序是针对有向无环图(DAG)的一种排序算法。在计算机网络中,拓扑排序可以帮助我们了解数据包传输的依赖关系,以及确定网络中的层次结构。这对于网络设计和故障排除尤为重要。
一个拓扑排序的Python实现示例如下:
from collections import defaultdict, deque

def topological_sort(graph):
    in_degree = {k: 0 for k in graph}  # 初始化所有节点的入度为0
    for u in graph:
        for v in graph[u]:
            in_degree[v] += 1

    queue = deque([k for k in in_degree if in_degree[k] == 0])
    order = []
    while queue:
        u = queue.popleft()
        order.append(u)
        for v in graph[u]:
            in_degree[v] -= 1
            if in_degree[v] == 0:
                queue.append(v)
    assert len(order) == len(graph), "Graph has a cycle"
    return order

# 一个简单的有向无环图示例
graph = {
    'A': ['B', 'C'],
    'B': ['D'],
    'C': ['D'],
    'D': []
}

print(topological_sort(graph))
拓扑排序让我们能够按照从源头到末端的顺序处理网络中的节点,这对于网络安装、维护和升级计划的制定是十分有用的。
5.2 社交网络分析
社交网络可以被视为图的集合,其中的节点代表人,边代表人之间的关系,如朋友关系、关注关系等。图论在社交网络分析中发挥着重要作用,可以帮助我们发现社交网络中的结构特性、重要个体和群体。
5.2.1 图论在社交网络中的应用实例
社交网络中的一些应用实例包括社区检测、影响力最大化、信息传播等。例如,社区检测可以帮助我们找到社交网络中的小团体,这些小团体中的成员可能有着更强的相互联系。K-means算法在社区检测中是一个常用的方法,它能够将图中的节点分组成多个社区,每个社区内部的联系紧密,而跨社区的联系较为稀疏。
5.2.2 社交网络分析中的关键图论算法
在社交网络分析中,PageRank算法是一个关键算法,它通过考虑网络中节点的入链数量和质量来衡量节点的重要性。PageRank算法最初由谷歌创始人拉里·佩奇和谢尔盖·布林开发,用于网页排名,但实际上它在任何有向图中评估节点重要性时都非常有用。
这些算法的应用帮助我们更好地理解和分析社交网络的内在结构,并且对于营销策略、政治运动、信息传播等都具有重要价值。
5.3 交通规划与物流管理
在交通规划和物流管理中,图论提供了强大的工具来模拟和优化网络中的路径。从确定道路网络中两点之间的最优路径到整个物流网络的设计和效率优化,图论都能发挥其独特的作用。
5.3.1 最小生成树算法在交通网络规划中的应用
最小生成树(MST)算法是一种找到无向图中所有节点的连通子图,并且使得子图中边的权重之和最小的算法。在交通网络规划中,可以使用Prim算法或Kruskal算法来找到包含所有城市(节点)的最小成本道路网(MST)。这样的网络将确保交通的连通性,同时将建设和维护成本降到最低。
以下是一个使用Kruskal算法的Python示例代码:
class DisjointSet:
    def __init__(self, vertices):
        self.vertices = vertices
        self.sets = {vertex: [vertex] for vertex in vertices}

    def find(self, item):
        if item not in self.sets:
            return None
        if self.sets[item] == [item]:
            return item
        self.sets[item] = self.find(self.sets[item][0])
        return self.sets[item]

    def union(self, set1, set2):
        root1 = self.find(set1)
        root2 = self.find(set2)
        if root1 != root2:
            self.sets[root1] += self.sets[root2]
            del self.sets[root2]

def kruskal(graph):
    mst = []
    weight = 0
    vertices = list(graph.keys())
    ds = DisjointSet(vertices)
    edges = [(weight, start, end) for start, adjacencies in graph.items()
             for end, weight in adjacencies.items()]
    edges.sort()
    for current_weight, start, end in edges:
        if ds.find(start) != ds.find(end):
            mst.append((start, end, current_weight))
            ds.union(start, end)
            weight += current_weight
    return mst, weight

# 示例图
graph = {
    'A': {'B': 1, 'C': 2},
    'B': {'A': 1, 'C': 3, 'D': 4},
    'C': {'A': 2, 'B': 3, 'D': 5},
    'D': {'B': 4, 'C': 5}
}

print(kruskal(graph))
5.3.2 图论在网络设计和优化中的实际案例
在实际的物流网络设计中,考虑的因素包括配送成本、时间效率、货物的类型等。图论可以帮助我们构建最优的物流路径,最小化配送时间和成本。例如,通过构建一个加权图来表示配送中心和目的地之间的关系,可以使用最短路径算法来找到运输货物的最短或最快路径。
在现实世界中,FedEx和UPS等大型物流公司就是利用图论中的算法来优化它们的全球物流网络。通过这种优化,公司能够节省大量成本并提高客户满意度。
在这些章节中,我们可以看到图论不仅是一个抽象的理论领域,而且其算法和技术已广泛应用于现实世界的众多问题中。这些应用不仅提高了效率,还为复杂问题提供了最优解。
简介:图论是数学和计算机科学的重要分支,专注于顶点和边构成的图形结构的研究。文章全面探讨了图论的基础概念、核心算法以及在现实世界问题中的应用,包括图的构成、遍历方法、重要算法(如最短路径、拓扑排序、最小生成树、回路检测)以及实际应用场景(如网络路由、社交网络分析、交通规划等)。掌握图论算法对于解决现实世界的复杂问题至关重要,本书为读者提供了深入理解图论核心内容的宝贵资源。
更多推荐

 3
 0
- 0


 已为社区贡献6条内容

所有评论(0)