
接口自动化测试
目录
1. 接口测试
1.1 接口的概念
接口一般来说有两种,一种是程序内部的接口,一种是系统对外的接口。
程序内部的接口:方法与方法之间,模块与模块之间的交互,程序内部抛出的接口,比如博客系统,有登录模块、发布文章模块等等,那你要发布文章就必须先登录,要发布文章就得登录,那么这两个模块就得有交互,它就会抛出一个接口,供内部系统进行调用。
系统对外的接口:比如你要从别的网站或服务器上获取资源或信息,别人肯定不会把数据库共享给
你,他只能给你提供一个他们写好的方法来获取数据,你引用他提供的接口就能使用他写好的方法,从而达到数据共享的目的,比如说咱们用的app、网址这些它在进行数据处理的时候都是通过接口来进行调用的。
接口类型有很多,如HTTP API接口、RPC等等,文章中基于HTTP API接口进行讨论。
1.2 接口测试
1.2.1 概念
接口测试是测试系统组件间接口的一种测试。接口测试主要用于检测外部系统与系统之间以及内部各个子系统之间的交互点。测试的重点是要检查数据的交换,传递和控制管理过程,以及系统间的相互逻辑依赖关系等。
简而言之,所谓接口测试就是通过测试不同情况下的入参与之相应的出参信息来判断接口是否符合或满足相应的功能性、安全性要求。
1.2.2 接口组成
接口文档示例:auth.getAccessToken | 微信开放文档微信开发者平台文档 https://developers.weixin.qq.com/minigame/dev/api-backend/open-api/access-token/auth.getAccessToken.html接口文档应该包含以下内容:
- 接口说明
- 调用url
- 请求方法(get/post)
- 请求参数、参数类型、请求参数说明
- 返回参数说明
由接口文档可知,接口至少应有请求地址、请求方法、请求参数(入参和出参)组成,部分接口有请求头header。
标头(header):是服务器以HTTP协议传HTML资料到浏览器前所送出的字符串,在标头与HTML文件之间尚需空一行分隔,一般存放cookie、token等信息。
header和⼊参有什么关系?它们不都是发送到服务器的参数吗?
它们确实都是发送到服务器里的参数,但它们是有区别的,。header里存放的参数一般存放的是一些校验信息,比如cookie,它是为了校验这个请求是否有权限请求服务器,如果有,它才能请求服务器,然后把请求地址连同入参一起发送到服务器,然后服务器会根据地址和入参来返回出参。也就是说,服务器是先接受header信息进行判断该请求是否有权限请求,判断有权限后,才会接受请求地址和入参的。
1.3 接口测试重要性
接口其实就是前端页面或APP等调用与后端做交互用的,有人会问,功能测试都测好了,为什么还要测接口呢?
比如测试用户注册功能,规定用户名为6~18个字符,包含字母(区分大小写)、数字、下划线。
首先功能测试时肯定会对用户名规则进行测试时,比如输入20个字符、输入特殊字符等,但这些可能只是在前端做了校验,后端可能没做校验,如果有人通过抓包绕过前端校验直接发送到后端怎么办呢?试想一下,如果用户名和密码未在后端做校验,而有人又绕过前端校验的话,那用户名和密码不就可以随便输了吗?如果是登录可能会通过SQL注入等手段来随意登录,甚至可以获取管理员权限,那这样不是很恐怖?
所以,接口测试的必要性就体现出来了:
- 可以发现很多在页面上操作发现不了的bug
- 检查系统的异常处理能力
- 检查系统的安全性、稳定性
- 前端随便变,接口测好了,后端不用变
1.4 如何执行接口测试
在进行接口测试前,还需要了解:
1、get和post请求
get和post是常见的请求方法。如果是get请求的话,直接在浏览器里输入就行了,只要在浏览器里面直接能请求到的,都是get请求,如果是post的请求的话,就不行了,就得借助工具来发送。
post请求在浏览器输入的话也会转变成get请求。
2、http状态码
每发出一个http请求之后,都会有一个响应,http本身会有一个状态码,来标示这个请求是否成功,常见的状态码有以下几种:
- 200 2开头的都表示这个请求发送成功,最常见的就是200,就代表这个请求是ok的,服务器也返回了。
- 300 3开头的代表重定向,最常见的是302,把这个请求重定向到别的地方了。
- 400 400代表客户端发送的请求有语法错误,401代表访问的页面没有授权,403表示没有权限访问这个页面,404代表没有这个页面。
- 500 5开头的代表服务器有异常,500代表服务器内部异常,504代表服务器端超时,没返回结果。
接口测试分两步走:通过接口设计用例+结合业务逻辑来设计用例
1.4.1 接口用例的编写
1、通过性验证:首先肯定要保证这个接口功能是好使的,也就是正常的通过性测试,按照接口文档上的参数,正常传入,是否可以返回正确的结果。
| 用例编写 | 用例标题 | 前置条件 | 测试步骤 | 预期结果 | 实际结果 | 测试结果 |
| 01 | 接口正常调用测试 | 接口服务正常运行 | 1、按照接口文档要求,传入所有 必填参数 2、调用接口 3、检查返回结果 | 返回状态码200,返回 结果符合预期(如操作 成功、返回数据完整 |
2、参数组合:现在有一个操作商品的接口,有个字段type,传1的时候代表修改商品,商品id、商品名称、价格有一个是必传的,type传2的时候是删除商品,商品id是必传的,这样的,就要测参数组合了,type传1的时候,只传商品名称能不能修改成功,id、名称、价格都传的时候能不能修改成功。
| 用例编号 | 用例标题 | 前置条件 | 测试步骤 | 预期结果 | 实际结果 | 测试结果 |
| 02 | 修改商品只传商 品名称测试 | 接口服务正 常运行,商 品存在 | 1、设置type=1 2、只传商品名称 3、调用接口 | 返回状态码200,商 品名称修改成功,其 他信息不变 | ||
| 03 | 修改商品传id、 名称、价格测试 | 接口服务正 常运行,商 品存在 | 1、设置type=1 2、传入商品id、名称、价格 3、调用接口 | 返回状态码200,商 品信息修改成功 | ||
| 04 | 删除商品测试 | 接口服务正 常运行,商 品存在 | 1、设置type=2 2、传入商品id 3、调用接口 | 返回状态码200,商 品删除成功 |
3、接口安全
- 绕过验证,比如说购买了一个商品,它的价格是300元,那我在提交订单时候,我把这个商品的价格改成3元,后端有没有做验证,更狠点,我把钱改成-3,是不是我的余额还要增加?
- 绕过身份授权,比如说修改商品信息接口,那必须得是卖家才能修改,那我传一个普通用户,能不能修改成功,我传一个其他的卖家能不能修改成功。
- 参数是否加密,比如说我登陆的接口,用户名和密码是不是加密,如果不加密的话,别人拦截到你的请求,就能获取到你的信息了,加密规则是否容易破解。
- 密码安全规则,密码的复杂程度校验。
| 用例编号 | 用例标题 | 前置条件 | 测试步骤 | 预期结果 | 实际结果 | 测试结果 |
| 05 | 绕过价格 验证测试 | 接口服务 正常运行 | 1、购买商品 2、提交订单时,将商品 价格改为3元 3、调用接口 | 返回状态码400或403,提示 价格验证失败 | ||
| 06 | 绕过身 份授权测试 | 接口服务 正常运行 | 1、使用普通用户调用修 改商品信息接口 2、调用接口 | 返回状态码403,提示无 权限操作 | ||
| 07 | 参数加密测 试 | 接口服务 正常运行 | 1、检查登录接口的用 户名和密码是否加密 | 用户名和密码已加密,且 加密规则难以破解 | ||
| 08 | 密码复杂度 校验测试 | 接口服务 正常运行 | 1、注册或修改密码 时,输入不符合复杂度 要求的密码 | 返回状态码400,提示密码 不符合安全规则 |
4、异常验证:
所谓异常验证,也就是我不按照你接口文档上的要求输入参数,来验证接口对异常情况的校验。比如说必填的参数不填,输入整数类型的,传入字符串类型,长度是10的,传11,总之就是你说怎么来,我就不怎么来,其实也就这三种,必传非必传、参数类型、入参长度。
| 用例编号 | 用例标题 | 前置条件 | 测试步骤 | 预期结果 | 实际结果 | 测试结果 |
| 09 | 必填参数缺失测试 | 接口服务正常运行 | 1、不传必填参数(如 商品id) 2、调用接口 | 返回状态码400,提示必填 参数缺失 | ||
| 10 | 参数类型错误测试 | 接口服务正常运行 | 1、传入错误类型的参 数(如将整数类型传 为字符串) 2、调用接口 | 返回状态码400,提示参数 类型错误 | ||
| 11 | 参数长度超限测试 | 接口服务正常运行 | 1、传入长度超限的参 数(如长度限制为 10,传入11) 2、调用接口 | 返回状态码400,提示参数 长度超限 |
1.4.2结合业务逻辑来设计用例
根据业务逻辑来设计的话,就是根据自己系统的业务来设计用例,这个每个公司的业务不一样,就得具体的看自己公司的业务了,其实这也和功能测试设计用例是一样的。
举个例子,拿贴吧来说,贴吧的需求是这样的:
- 登录失败5次,就需要等待15分钟之后再登录
- 新注册的用户需要过了实习期才能发帖
- 删除帖子扣除积分
- .……
像这样需要把这些测试点列出来,然后再去造数据测试对应的测试点。
2. 接口自动化测试
2.1 概念
接口自动化是通过对接口进行测试和模拟,以确保软件系统内部的各个组件能够正确地相互通信和交换数据。接口自动化测试可以显著提高测试效率和准确性。因为接口测试专注于测试系统内部的逻辑和数据传输,而不是像U测试那样关注用户的操作和交互。同时,由于接口测试直接针对系统内部的结构和功能,可以更容易地发现和定位问题,减少测试成本和时间。
2.2 接口自动化流程
2.2.1 需求分析
- 分析请求:明确接口的URL、请求方法(如get、post、PUT、DELETE等)、请求头、请求参数和请求体等信息。
- 分析响应:确定接口返回的数据格式、状态码以及可能的错误信息。
2.2.2 挑选自动化接口
- 根据项目的时间、人员安排和接口的复杂度,挑选适合自动化测试的接口。
- 优先选择核心业务接口、频繁使用的接口以及容易出错的接口进行自动化测试。
功能复杂度:优先选择功能复杂、逻辑分支多的接口进行自动化测试。例如,涉及多种支付方式、多种订单状态转换的订单管理接口,手动测试难以全面覆盖所有场景,烈自动化测试可以更高效地进行测试。
高风险功能:选择对业务影响大、风险高的接口进行自动化测试,确保其稳定性和可靠性。例如,涉及资金操作的支付接口,一旦出现问题可能导致严重的经济损失,因此需要进行充分的自动化测试。
重复性高:对于需要频繁执行的测试任务,如回归测试中的接口测试,自动化测试可以避免重复手动测试的繁琐和低效,提高测试效率。
假设我们正在开发一个在线教育平台,该平台包含以下接口:
| 接口名称 | 功能描述 | 功能复杂度 | 高风险功能 | 重复性高 |
| 登录接口 | 用户登录系统 | 中 | 是 | 是 |
| 新增课程接口 | 添加新的课程 | 高 | 是 | 是 |
| 查询课程接口 | 根据条件查询课程 | 高 | 是 | 是 |
| 修改课程接口 | 修改课程信息 | 高 | 是 | 是 |
| 删除课程接口 | 删除课程 | 中 | 是 | 是 |
| 用户注册接口 | 用户注册 | 中 | 是 | 是 |
| 用户信息查询接口 | 查询用户信息 | 中 | 是 | 是 |
| 用户信息修改接口 | 修改用户信息 | 中 | 是 | 是 |
| 课程购买接口 | 用户购买课程 | 高 | 是 | 是 |
| 验证码接口 | 获取登录验证码 | 中 | 中 | 中 |
| 合同上传接口 | 上传合同 | 中 | 中 | 中 |
| 添加合同接口 | 添加新的合同 | 中 | 中 | 中 |
| 合同列表接口 | 查询合同列表 | 中 | 中 | 中 |
| 课程评价接口 | 用户对课程进行评价 | 中 | 中 | 中 |
| 课程评论接口 | 用户对课程发表评论 | 中 | 中 | 中 |
| 课程收藏接口 | 用户收藏课程 | 中 | 中 | 中 |
功能复杂度:
- 新增课程接口:涉及多个参数(课程名称、课程描述、课程价格等)需要与其他模块(如课程分类模块)交互。
- 查询课程接口:支持多种查询条件(课程名称、课程类型、课程状态等),逻辑复杂。
- 课程购买接口:涉及支付流程、订单生成等复杂逻辑。
高风险功能:
- 登录接口:用户登录是系统的核心功能,任何问题都会影响用户体验。
- 新增课程接口:课程信息的正确性直接影响平台的运营。
- 用户注册接口:用户注册是系统的基础功能,任何问题都会影响用户获取服务。
重复性高:
- 登录接口:用户每次使用系统都需要登录。
- 查询课程接口:用户频繁查询课程信息。
- 用户信息查询接口:用户经常查看自己的信息。
2.2.3 设计自动化测试用例
- 如果在功能测试阶段已经设计了测试用例,可以直接拿来使用。
- 根据接口需求和功能,设计正向测试用例(正常场景)和反向测试用例(异常场景),包括边界值测试、参数组合测试等。
2.2.4 搭建自动化测试环境
- 选择合适的编程语言(如Python、Java等)和开发环境(如PyCharm、IntelliJIDEA等)来实现自动化测试。
- 以Python为例,安装必要的依赖库,如requests用于发送HTTP请求,pytest用于测试框架。
2.2.5 设计自动化执行框架
- 设计一个框架来执行测试用例,包括报告生成、参数化处理和用例执行逻辑。
2.2.6 编写代码
- 根据设计好的测试用例和框架,编写自动化测试脚本。
2.2.7 执行用例
- 使用测试框架(如unittest、pytest)来执行编写的测试用例。
2.2.8 生成测试报告
- 测试完成后,生成测试报告。可以使用工具如HtmlTestRunner或Allure来生成易于阅读的报告。
接口自动化流程是面试考点
2.3 第一个简单的自动化接口
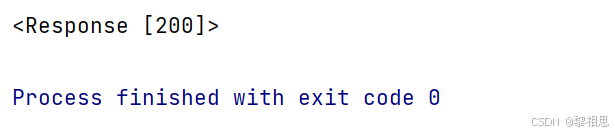
示例:对百度接口发起请求
import requests
r = requests.get("https://www.baidu.com")
print(r)
返回值:
2.4 Requests模块
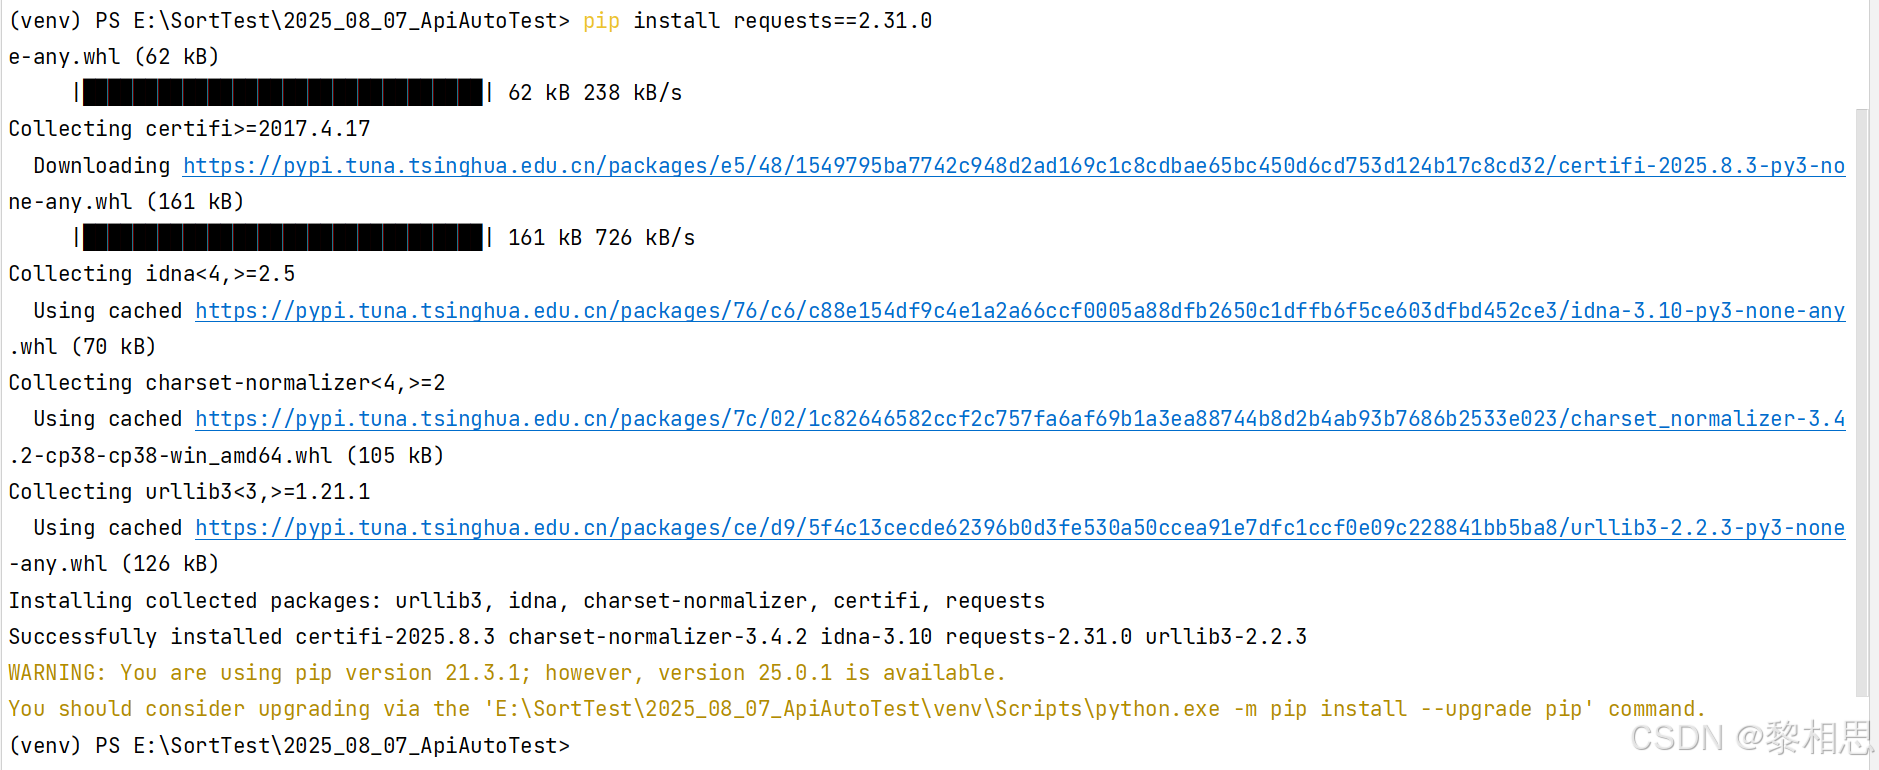
2.4.1 安装
命令行通过pip工具进行安装,命令:
pip install requests==2.31.0
#建议跟博客统一版本,避免因版本不同造成的使用差异
安装成功示例:
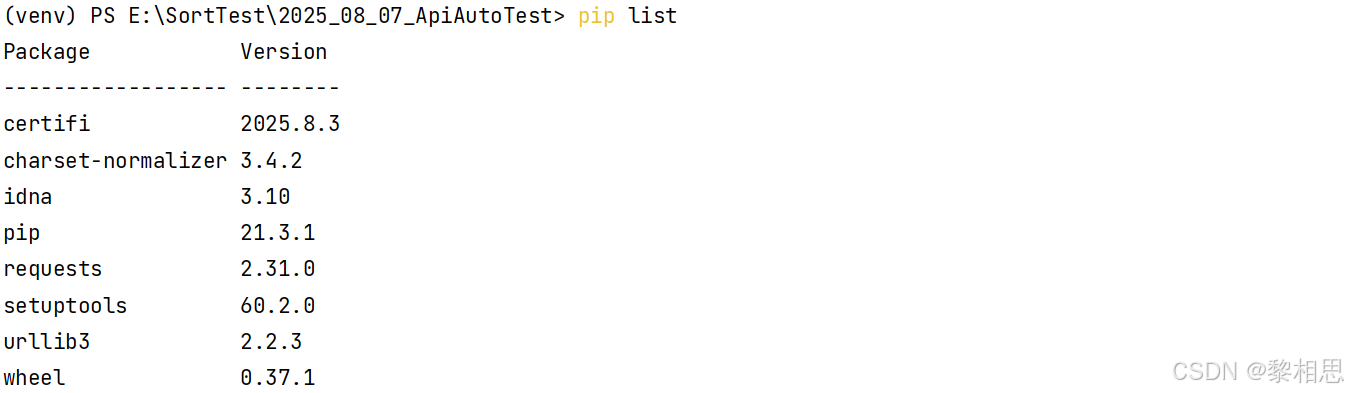
检查当前项目下包是否更新:
2.4.2 介绍
requests库是一个非常流行的HTTP客户端库,用于发送HTTP请求。requests.get方法用于发送一个HTTPget请求到指定的URL
requests.get方法返回一个Response对象,这个对象包含了服务器返回的所有信息。如:
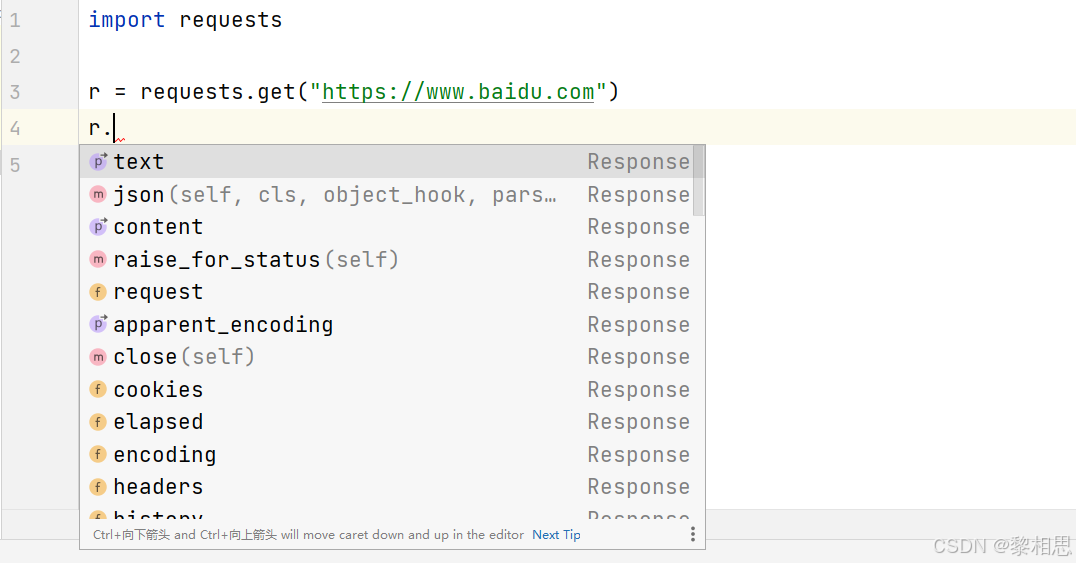
Response对象提供的属性/方法介绍:
| 属性/方法 | 描述 |
| r.status_code | 响应状态码 |
| r.content | 字节方式的响应体,会自动解码gzip和deflate压缩 |
| r.headers | 以字典对象存储服务器响应头,若键不存在则返回None |
| r.json() | Requests中内置的JSON解析方法,将响应体解析为JSON格式 |
| r.url | 获取实际请求的URL |
| r.encoding | 编码格式,根据响应头部的字符编码确定 |
| r.cookies | 获取服务器设置的cookies |
| r.raw | 返回原始响应体,不进行任何处理 |
| r.text | 字符串方式的响应体,会自动根据响应头部的字符编码进行解码 |
| r.raise_for_status() | 失败请求(非200响应)抛出异常 |
2.4.3 常见请求方法
#发起get请求
def get(url, params=None, **kwargs)

#发起post请求
def post(url, data=None, json=None, **kwargs)

#⽀持不同请求⽅式,method:指定请求⽅法,
#⽀持``get``, ``OPTIONS``, ``HEAD``, ``post``, ``PUT``, ``PATCH``, or ``DELETE``
def request(method, url, **kwargs)
使用示例:
import requests

get = requests.get("https://www.baidu.com")
post = requests.post("https://www.baidu.com")

req_get = requests.request("GET","https://www.baidu.com")
#传递参数时指定参数
# req_post = requests.request("POST","https://www.baidu.com")#第一种写法
# req_post = requests.request(url="POST",method="https://www.baidu.com")#第二种写法
req_post = requests.request(url="https://www.baidu.com",method="POST")#第三种写法

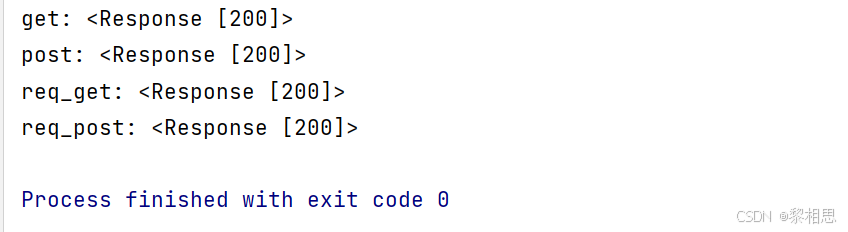
print("get:",get)
print("post:",post)
print("req_get:",req_get)
print("req_post:",req_post)
结果:
2.4.4 添加请求信息
| 参数名 | 描述 |
| url | 请求的接口 |
| headers | 一个字典,包含要发送的HTTP头。 |
| cookies | 一个字典、列表或者RequestsCookieJar对象,包含要发送的cookies。 |
| files | 一个字典,包含要上传的文件。 |
| data | 一个字典、列表或者字节串,包含要发送的请求体数据。 |
| json | 一个字典,将被转换为JSON格式并发送。 |
| params | 一个字典、列表或者字节串,将作为查询字符串附加到URL上。 |
| auth | 一个元组,包含用户名和密码,用于HTTP认证。 |
| timeout | 一个浮点数或元组,指定请求的超时时间。 |
| proxies | 一个字典,包含代理服务器的信息。 |
| verify | 一个布尔值或字符串,指定是否验证SSL证书。 |
示例1:博客详情接口
#请求博客详情页接口
#必须要先登录--在请求头添加用户登录凭证(User_token_header)
#带有参数

#这里的get请求,url上拼接的参数也可以单独拿下来
# url = "http://8.137.19.140:9090/blog/getBlogDetail?blogId=141214" #方式一,直接跟在哦后面
url = "http://8.137.19.140:9090/blog/getBlogDetail" #方式二,取出来

param = {
    "blogId":141214
}
#定义请求头
header = {
    "User_token_header":"eyJhbGciOiJIUzI1NiJ9.eyJpZCI6MSwidXNlck5hbWUiOiJ6aGFuZ3NhbiIsImV4cCI6MTc1NDU4MTMzMX0.icEkcv5uUMuluMBCILLOZ4lfjkh7V3V5d9fLYvdCciY"
}

r = requests.request(method="GET",url=url,params=param,headers=header)
print(r.json())
示例2:博客登录接口
#博客系统登录接口
# POST 表单格式
url = "http://8.137.19.140:9090/user/login"

data = {
    "username":"lisi",
    "password":"123456"
}

#这里的data换成params也是可以的,但是post请求一般用data,get请求用params
r = requests.request(method="POST",url=url,data=data)
print(r.json())
示例3:添加cookie信息
以博客园接口为例:https://account.cnblogs.com/user/userinfo
代码:
url = "https://account.cnblogs.com/user/userinfo"
# 定义请求头信息
header = {
    "Accept":"application/json, text/javascript, */*; q=0.01"
} #定义cookie信息
cookie = {
    ".Cnblogs.AspNetCore.Cookies":"CfDJ8DfB03_iObVLoqH7ndAeeDgVJetjhlYbwnntg9Uy7_bcLryJ_RIEtfbgLsOt7uinPvbNdpBCrZ_PSO5PvJVIw1lWKGW_BmqUG4pK2jDjEGKO8vaJdJ74bQWmCZW5U5wMaUO6QMrJFftQN8k31pgTbuD4X4lX-9kWMqGkzXkGkNb8C8hU_MyCqe9ZqjSDDSoPp4lFXTZ_MgBMGJLMzyw61Otnrrp2BXpw9oGbK14Q5ibK4_cAAL0cOPN1hYq1tDjbUs_CoDAyJanjddoezpNU6KQTchSOAmfFCbcuTLrDBlrHYHgnP75YE8pb4-AsJuaNrN74fBlYhJ_BQHKmvs_GJmj1L1seks5C32Lx7it67uq9be_7oDyj6ZLvTnZdryWXlucNb7EPE27P1-djOPq8MY15hSNVjO86Gcn8kDBbfyCee8Yi3exGOr026dRtPLSVjPdSbKV0st6Xd8so1oVJlKH2amdiX1Pofe7h_Yf6S-eVG_pnL6_frtvpCNbpVgApxB5Wm1yyy0UXLy31UmVSuo5RJN6BQr4DXQ7umCz-yfpFjnZSUiuskBcwG83N3ww"
}
r= requests.post(url=url, headers=header, cookies=cookie)
print(r.json())
问题:上传参数选择params、json还是data?
- params用于在URL中传递查询参数(Query Parameters),通常用于GET请求,但也可以用于其他类型的请求。
- json用于在请求体(Body)中传递JSON格式的数据,通常用于POST或PUT请求。
- data用于在请求体(Body)中传递表单数据,通常用于POST或PUT请求。
若参数上传格式选择为json格式,Content-Type会自动被设置为application/json
有了requests库,可以实现对接口发起http请求,然而自动化测试中,我们需要编写大量的测试用例,这些用例的组织、执行和管理也需要使用其他更强大的框架——pytest框架。
requests库专注于HTTP请求的发送,而pytest框架则提供了测试的组织、执行和管理功能。
2.5 自动化框架pytest
支持Python语言的接口自动化框架有很多,以下是支持Python的接口自动化主流框架对比分析:
主流框架对比表:
| 维度 | unittest (Python内置) | pytest | Robot Framework |
| 安装方式 | 无需安装(Python标准库) | pip install pytest | pip install robotframework |
| 语法风格 | 基于类(需继承TestCase) | 函数式或面向对象(无需样板代码) | 关键字驱动(表格化用例) |
| 断言方法 | self.assertEqual()等 | 原生 assert表达式 | 关键字断言(如Should Be Equal) |
| 参数化支持 | 需subTest或第三方库 | 内置@pytest.mark.parametrize | 数据驱动(TestTemplate) |
| 插件生态 | 少(依赖扩展库如 HTMLTestRunner | 丰富(如pytest-html、pytest-xdist、allure-pytest) | 一般(需安装额外库如 RequestsLibrary |
| 测试报告 | 需插件生成报告 | 支持多格式报告(HTML、Allure等) | 自带详细日志和报告 |
| 学习曲线 | 中等(需熟悉xUnit模式) | 低(语法简洁) | 高(需掌握关键字和语法) |
| BDD支持 | 不支持 | 支持(通过pytest-bdd插件) | 支持(通过robotframework-bdd) |
| 适用场景 | 简单项目或遗留系统维护 | 复杂项目、高扩展性需求 | 团队协作、非技术人员参与 |
2.5.1 pytest介绍
pytest官方文档:Get Started - pytest documentationhttps://docs.pytest.org/en/stable/getting-started.html
pytest是一个非常流行且高效的Python测试框架,它提供了丰富的功能和灵活的用法,使得编写和
运行测试用例变得简单而高效。
为什么选择pytest:
- 简单易用:pytest的语法简洁清晰,对于编写测试用例非常友好,几乎可以在几分钟内上手。
- 强大的断言库:pytest内置了丰富的断言库,可以轻松地进行测试结果的判断。
- 支持参数化测试:pytest支持参数化测试,允许使用不同的参数多次运行同一个测试函数,这大大提高了测试效率。
- 丰富的插件生态系统:pytest有着丰富的插件生态系统,可以通过插件扩展各种功能,比如覆盖率测试、测试报告生成(如pytest-html插件可以生成完美的HTML测试报告)、失败用例重复执行(如pytest-rerunfailures插件)等。此外,pytest还支持与selenium、requests、appinum等结合,实现Web自动化、接口自动化、App自动化测试。
- 灵活的测试控制:pytest允许跳过指定用例,或对某些预期失败的case标记成失败,并支持重复执行失败的case。
2.5.2 安装
安装pytest8.3.2 要求python版本在3.8及以上。
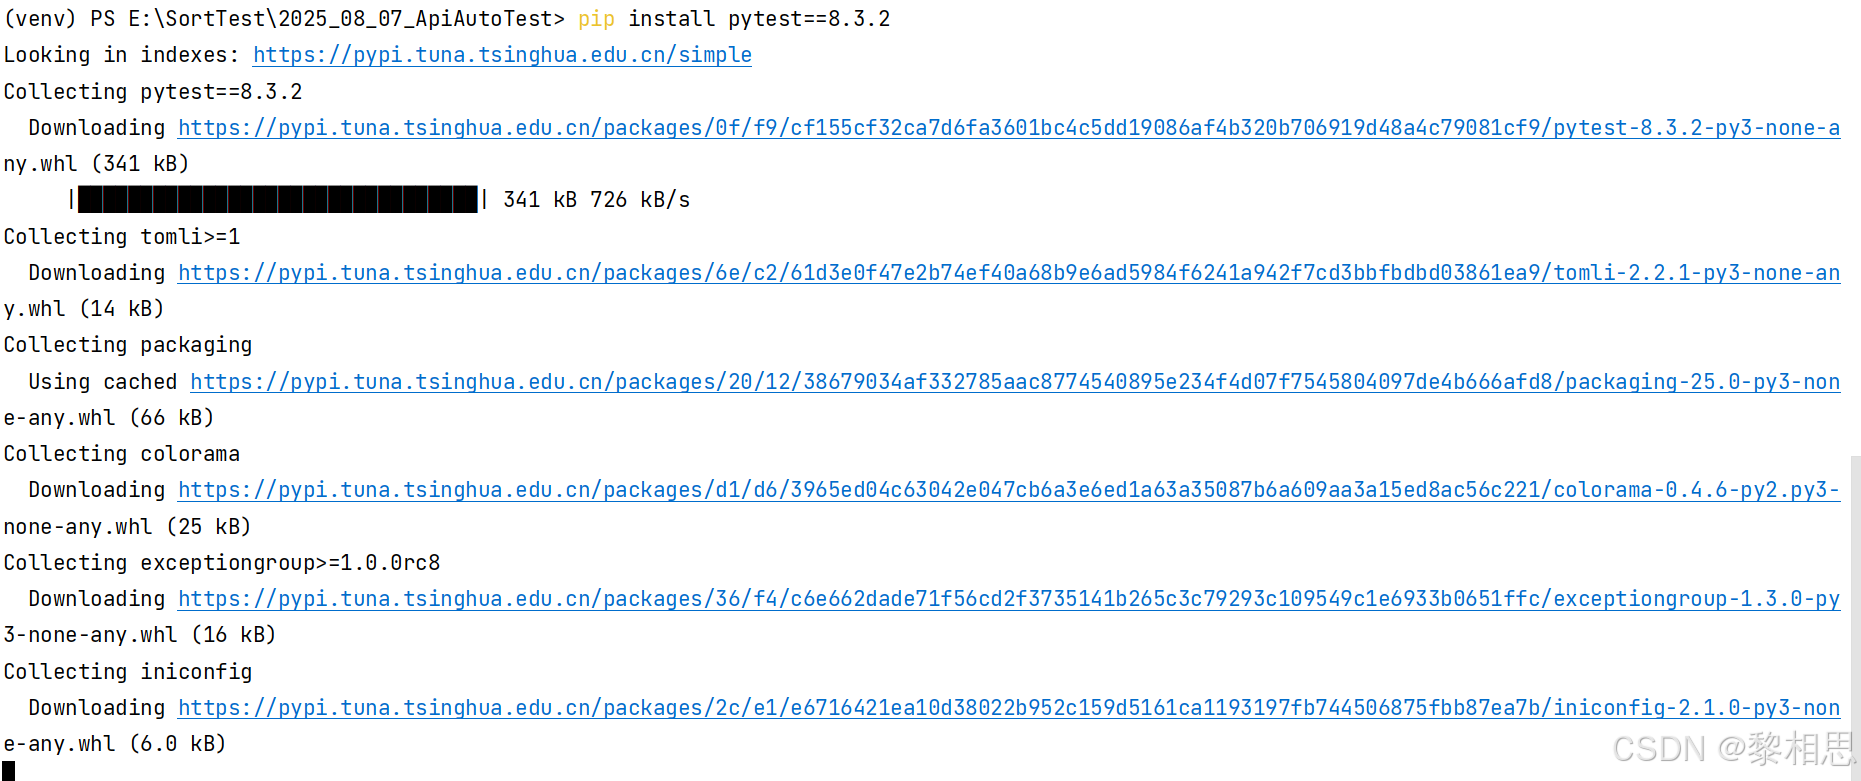
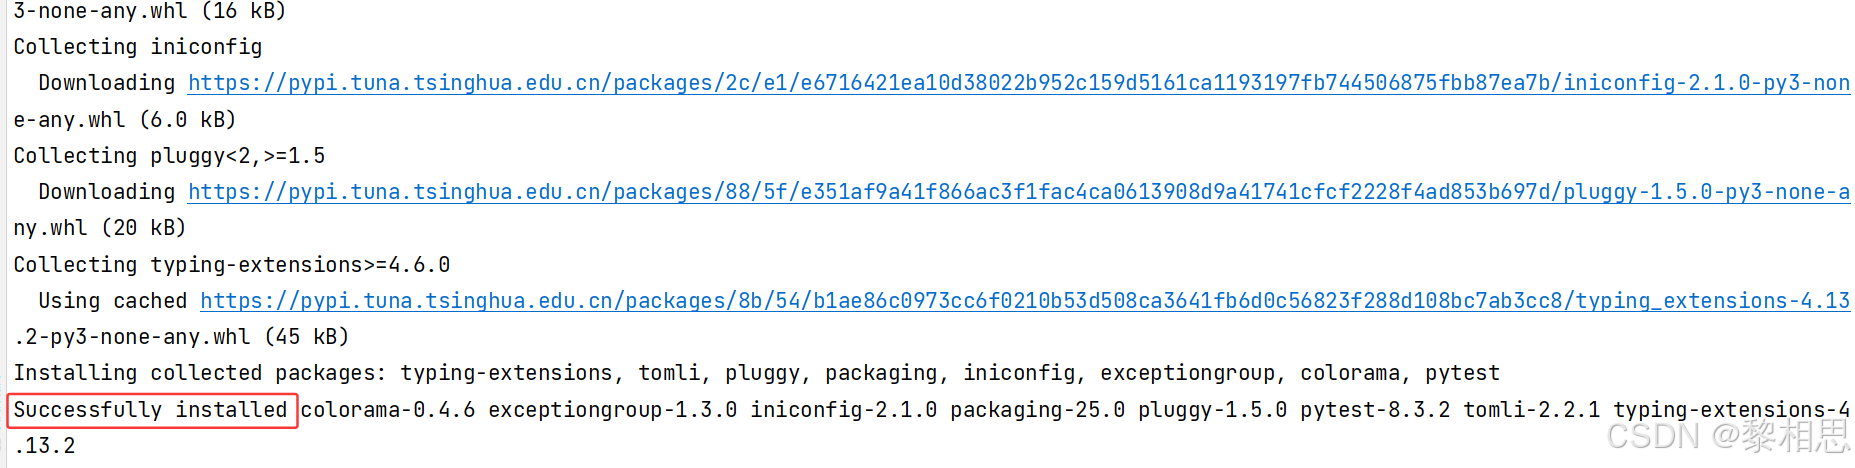
pip install pytest==8.3.2
#建议跟博客统⼀版本,避免因版本不同造成的使⽤差异
若python版本低于3.8,可参考表格不同的pytest版本支持的python版本:
| pytest版本 | 最低python版本 |
| 8.0+ | 3.8+ |
| 7.1+ | 3.7+ |
| 6.2 - 7.0 | 3.6+ |
| 5.0 - 6.1 | 3.5+ |
| 3.3 - 4.6 | 2.7,3.4+ |
安装成功示例:
用pip list查看已安装的包
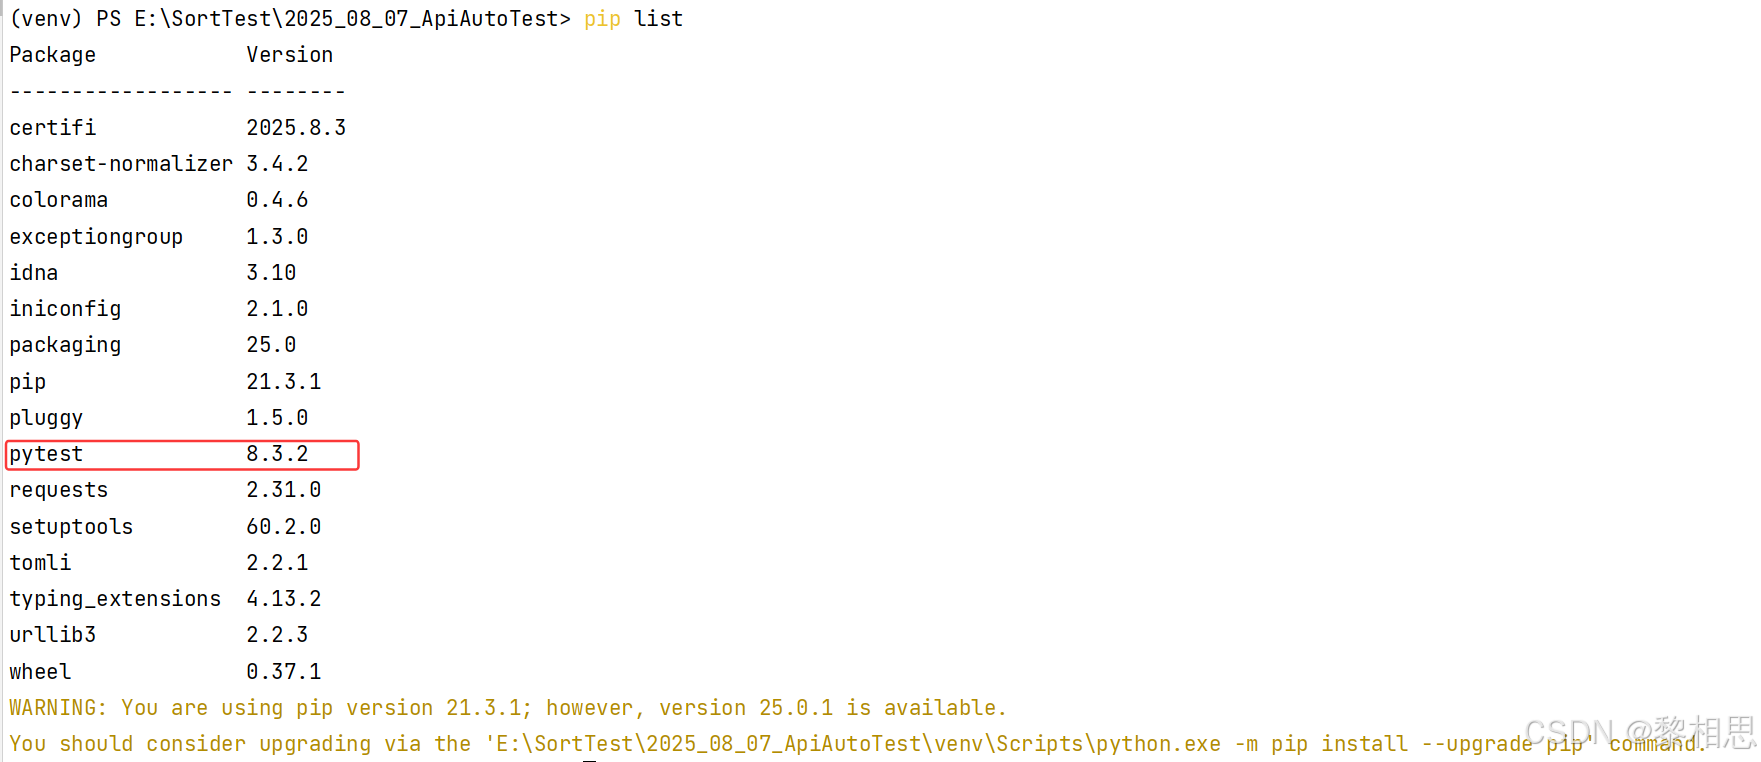
安装好pytest后,确认pycharm中python解释器已经更新,来看一下有pytest框架和没有pytest框架编写代码的区别:
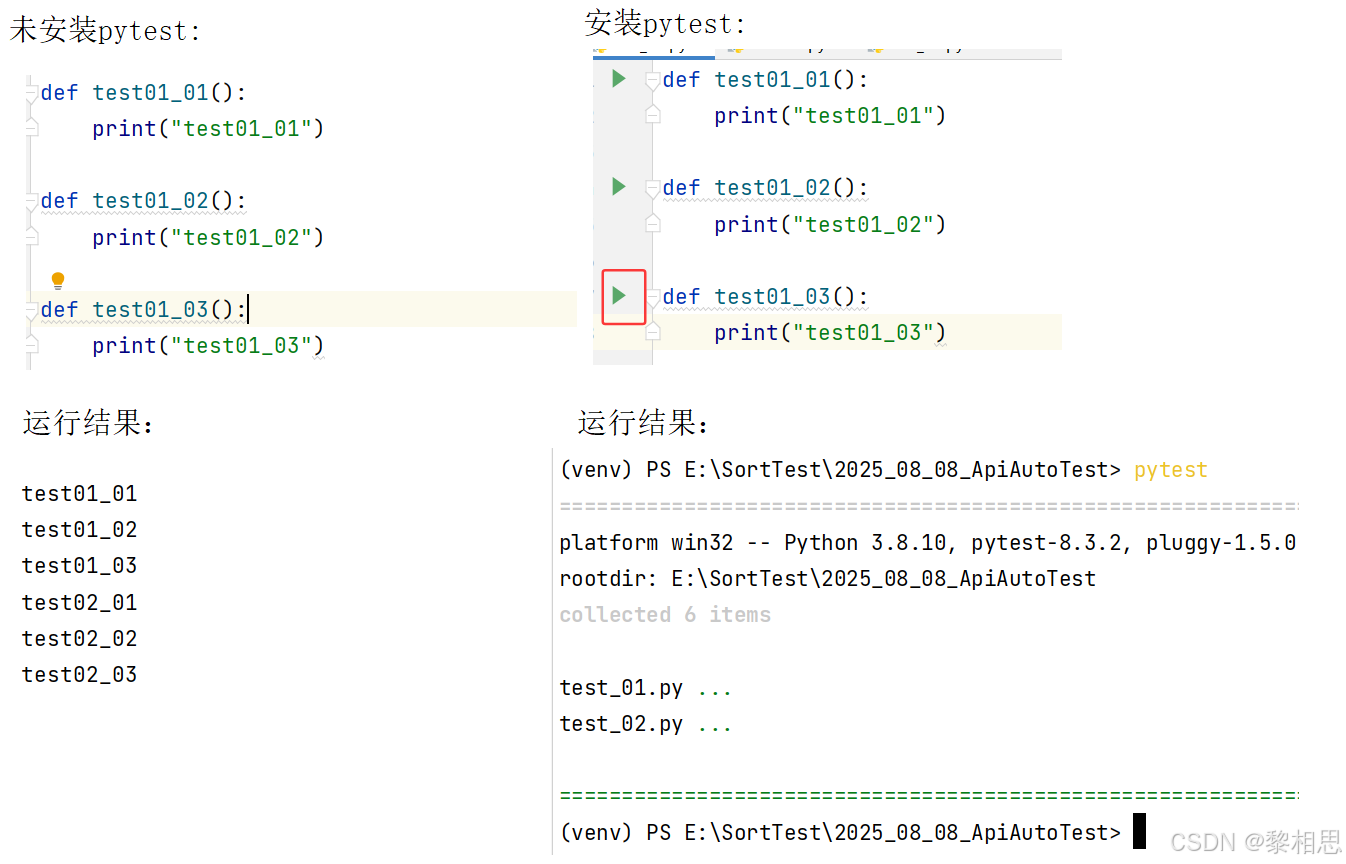
两张对比图可以明显看出来,未安装pytest框架的情况下需要编写main函数,在main函数中手动调用测试用例testO1;安装了pytest框架后方法名前有直接运行标志。
然而并不是所有的方法都可以直接运行,需要遵循pytest中的用例命名规则。
2.5.3 用例运行规则
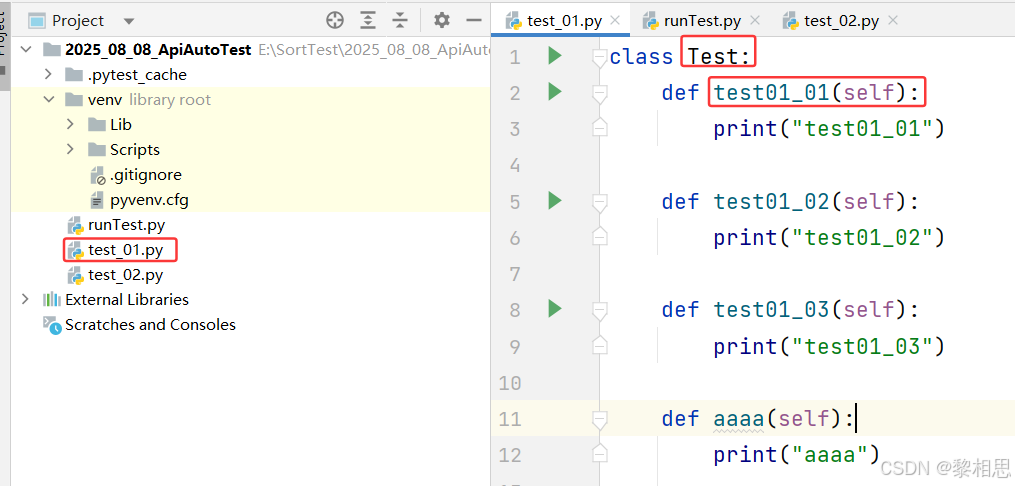
- 文件名必须以test_开头或者_test结尾。
- 测试类必须以Test开头,并且不能有__init__方法。
- 测试方法必须以test开头
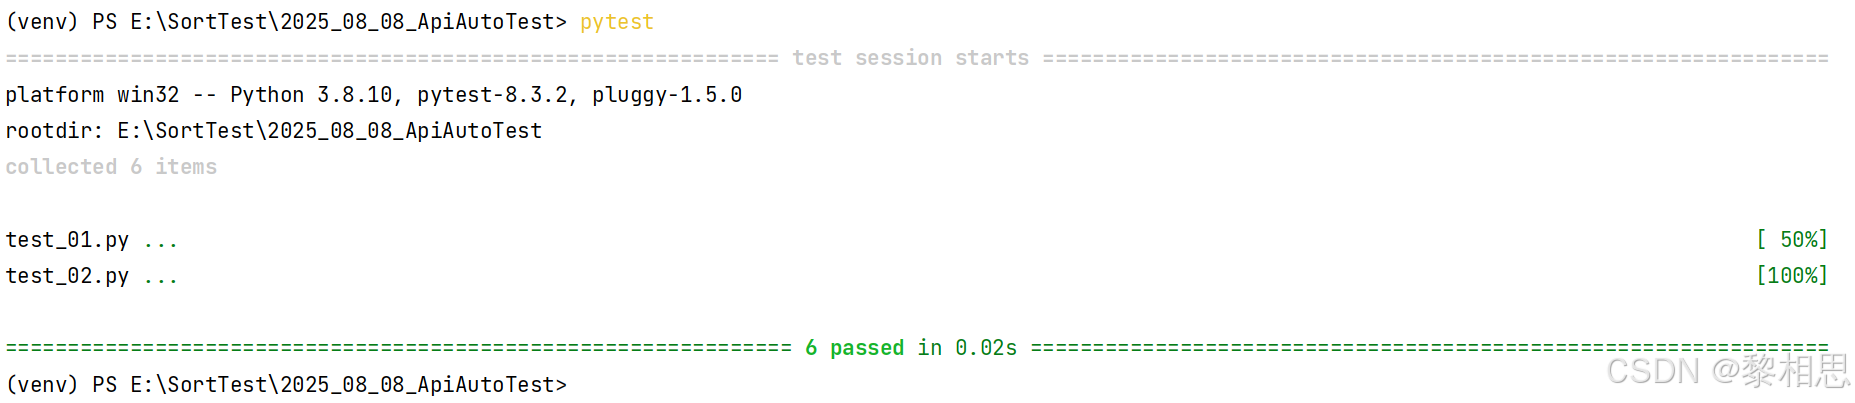
当满足以上要求后,可通过命令行参数pytest直接运行符合条件的用例:
注意:python类中不可以添加init方法
class Test:
    def __init__(self):
        print("__init__")
    def test01_01(self):
        print("test01_01")
执行结果:
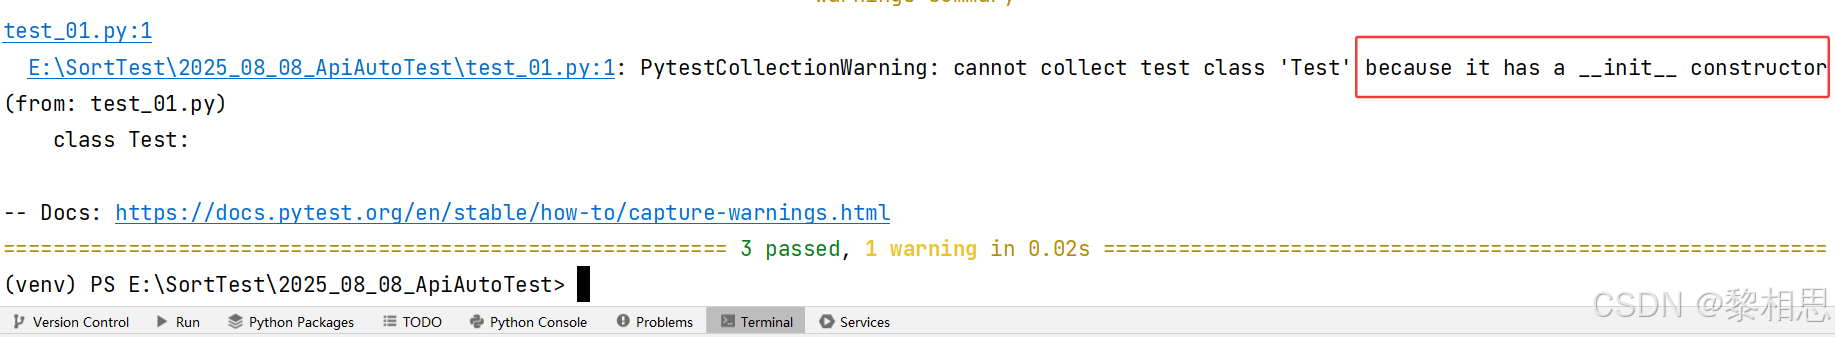
由于pytest的测试收集机制,测试类中不可以定义__init__方法。pytest采用自动发现机制来收集测试用例。它会自动实例化测试类并调用其所有以test结尾的方法作为测试用例。如果测试类中定义了__init__方法,那么当pytest实例化该类时,__init__方法会被调用,这可能会掩盖测试类的实际测试逻辑,并引入额外的副作用,影响测试结果的准确性。
若测试类中存在初始化操作该采取什么方案?
为了避免使用__init方法,建议在pytest中使用其他替代方案,如使用setUp()和tearDown()方法、使用类属性、使用fixture函数。
2.5.4 pytest命令参数
pytest提供了丰富的命令行选项来控制测试的执行。以下是一些常用的pytest命令行参数及其使用说明。
pytest -h #查看适用文档| 命令 | 描述 | 备注 |
| pytest | 在当前目录及其子目录中搜索并运行 测试。 | |
| pytest -v | 增加输出的详细程度。 | |
| pytest -s | 显示测试中的print语句。 | |
| pytest test_module.py | 运行指定的测试模块。 | |
| pytest test_dir/ | 运行指定目录下的所有测试。 | |
| pytest -k <keyword> | 只运行测试名包含指定关键字的测 试。 | |
| pytest -m <marker> | 只运行标记为指定标记的测试。 | |
| pytest -q | 减少输出的详细程度。 | |
| pytest --html=report.html | 生成HTML格式的测试报告。 | 需要安装pytest-html插 件 |
| pytest --cov | 测量测试覆盖率 | 需要 安装pytest-cov插 件 |
示例1:运行符合运行规则的用例
pytest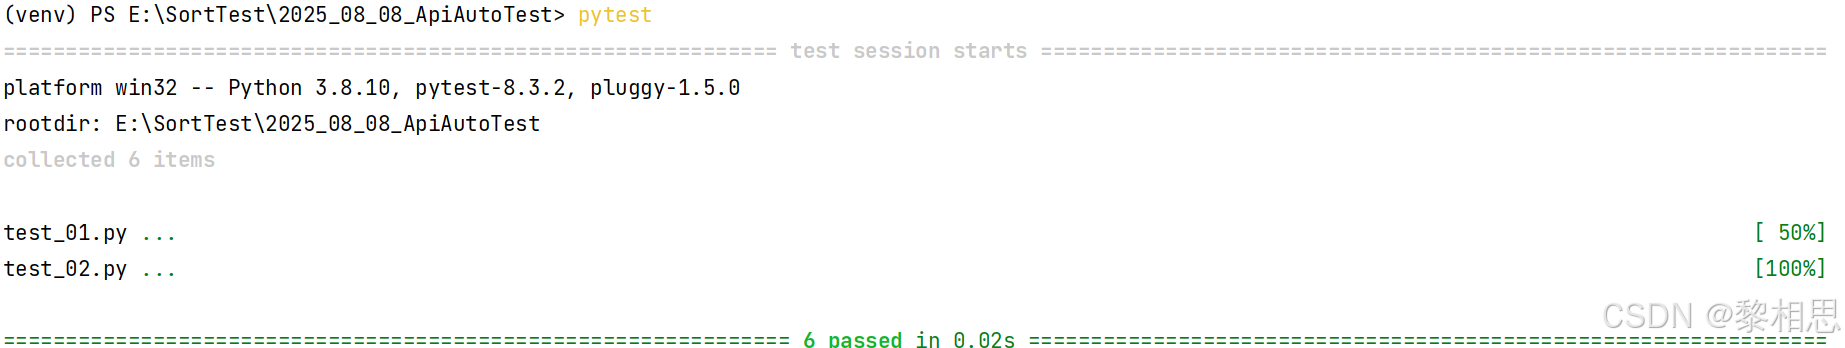
这里不会输出测试用例中print内容
示例2:详细打印,并输入print内容
pytest -s -v 或者 pytest -sv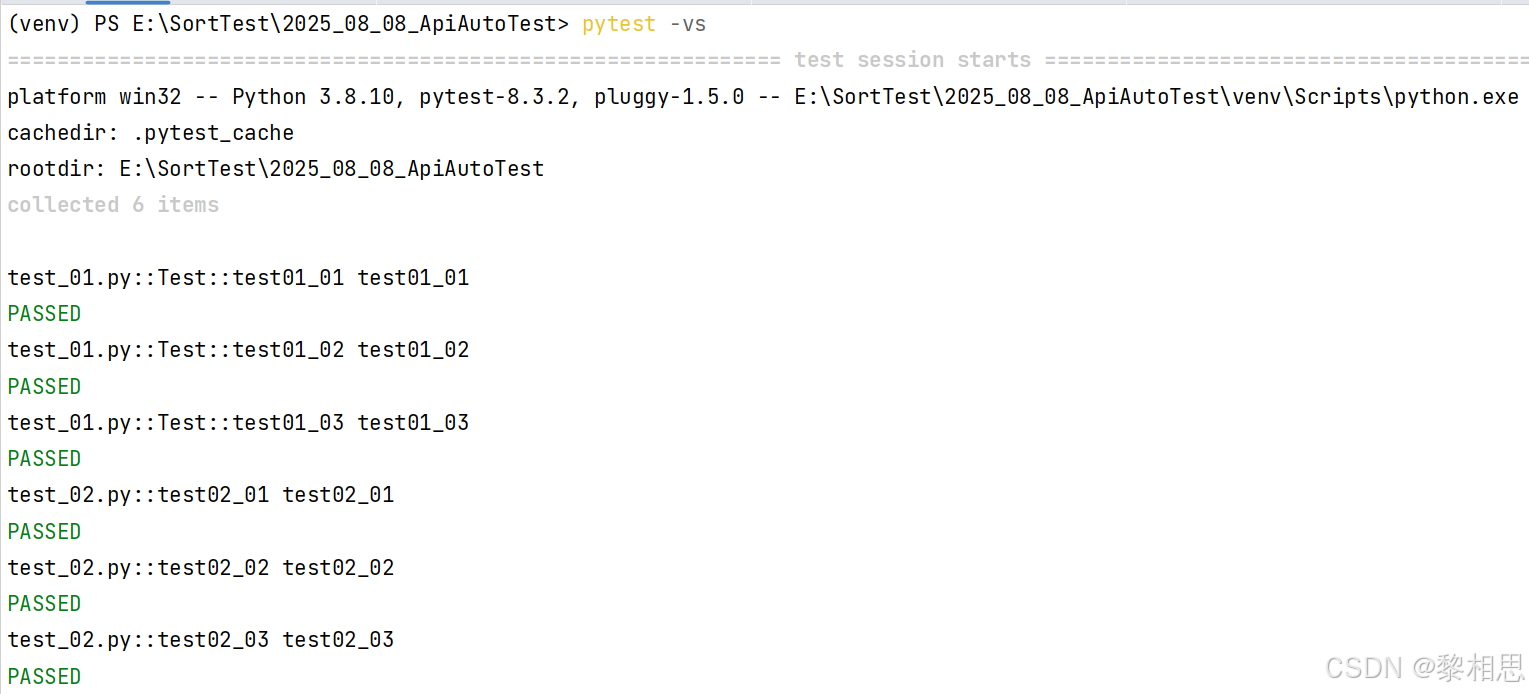
示例3:指定文件/测试用例
#指定⽂件:pytest 包名/⽂件名
pytest .\test_01.py

#指定测试⽤例: pytest 包名/⽂件名::类名::⽅法名
pytest cases/test_01.py::Test::test_a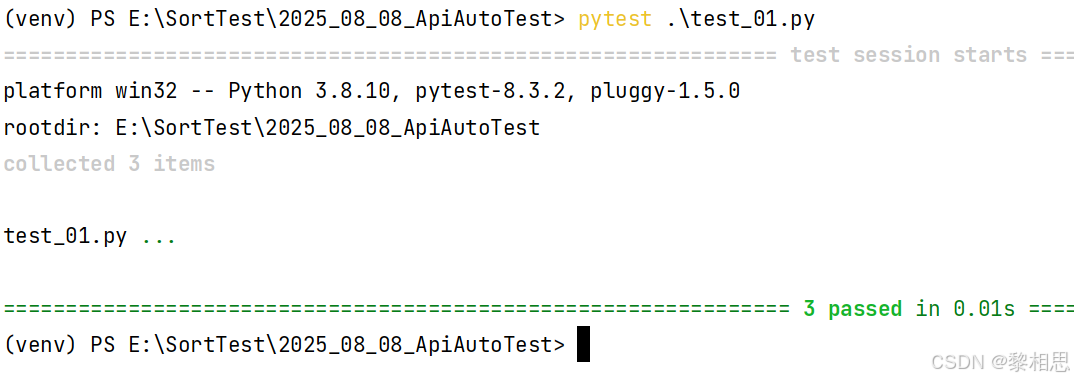
问题:当我们既要详细输出,⼜要指定⽂件时,命令会⼜臭⼜⻓,⽽且每次运⾏都需要⼿动输⼊命令,如何解决?
将需要的相关配置参数统一放到pytest配置文件中。
2.5.5 pytest配置文件
在当前项目下创建pytest.ini文件,该文件为pytest的配置文件,以下为常见的配置选项:
| 参数 | 解释 |
| addopts | 指定在命令行中默认包含的选项。 |
| testpaths | 指定搜索测试的目录。 |
| python_files | 指定发现测试模块时使用的文件匹配模式。 |
| python_classes | 指定发现测试类时使用的类名前缀或模式。 |
| python_functions | 指定发现测试函数和方法时使用的函数名前缀或模式。 |
| norecursedirs | 指定在搜索测试时应该避免递归进入的目录模式。 |
| markers | 定义测试标记,用于标记测试用例。 |
示例:详细输出cases包下文件名以case_开头且方法名以A_开头的所有用例
[pytest]
addopts = -vs
testpaths = ./cases
python_files = case_*.py
python_classes = A_
python_functions = A_
配置好pytest.ini文件后,命令行执行pytest命令即可,无需再额外指定其他参数:
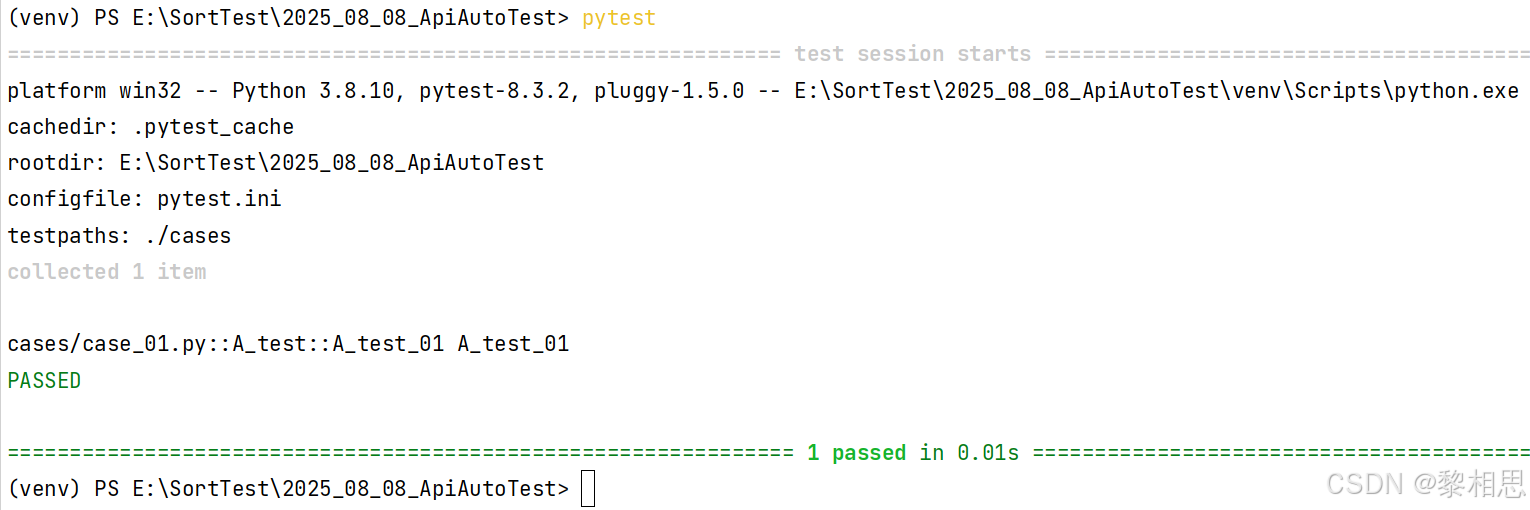
pytest.ini文件通常位于项目的根目录下。通过在pytest.ini中定义配置项,可以覆盖pytest的默认行为,以满足项目的需求。
2.5.6 前后置
遗留问题:使用pytest框架,测试类中不可以添加init()方法,如何进行数据的初始化?
在测试框架中,前后置是指在执行测试用例前和测试用例后执行一些额外的操作,这些操作可以用于设置测试环境、准备测试数据等,以确保测试的可靠性
pytest框架提供三种方法做前后置的操作:
- setup_method和teardown_method:这两个方法用于类中的每个测试方法的前置和后置操作。
- setup_class和teardown_class:这两个方法用于整个测试类的前置和后置操作。
- fixture:这是pytest推荐的方式来实现测试用例的前置和后置操作。fixture提供了更灵活的控制和更强大的功能。(该内容后续在fixture章节中详细讲解)
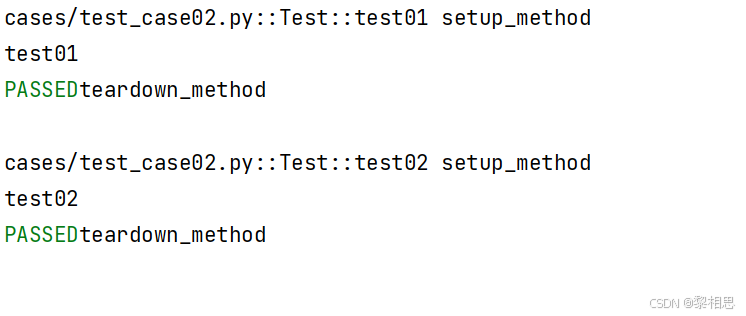
示例1:setup_method和teardown_method
class Test:
    def setup_method(self):
        print("setup_method")

    def test01(self):
        print("test01")

    def test02(self):
        print("test02")

    def teardown_method(self):
        print("teardown_method")
结果:
示例2:setup_class和teardown_class
class Test:

    def setup_class(self):
        print("setup_class")

    def test01(self):
        print("test01")

    def test02(self):
        print("test02")

    def teardown_class(self):
        print("teardown_class")
结果:
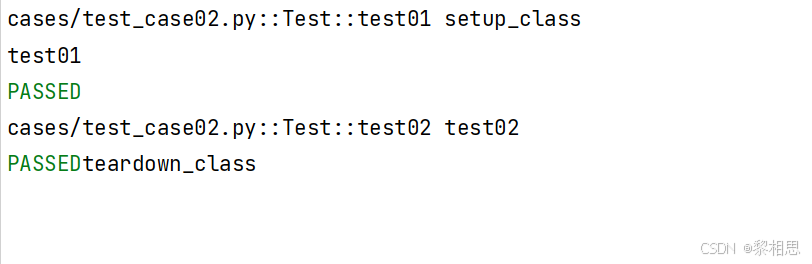
2.5.7 断言
断言(assert)是一种调试辅助工具,用于检查程序的状态是否符合预期。如果断言失败(即条件为假),Python解释器将抛出一个AssertionError异常。断言通常用于检测程序中的逻辑错误。
pytest允许你在Python测试中使用标准的Pythonassert语句来验证预期和值。
基本语法:
assert 条件,错误信息- 条件:必须是一个布尔表达式。
- 错误信息:当条件为假时显示的错误信息,可选。
示例1:基本数据类型的断言
def test_base():
    a = 1
    b = 2
    assert a == b

    str1 = "hello"
    str2 = "hello"
    assert str1 == str2
示例2:数据结构断言
def test_ds():
    #断言列表
    expect_list = [1,"apple",3.14]
    actual_list = [1,"apple",3.14]
    assert expect_list == actual_list

    #断言元组
    expect_tuple = (1,"apple",3.14)
    actual_tuple = (1,"apple",3.14)
    assert expect_tuple == actual_tuple

    #断言字典
    expect_dict = {"name":"Alice","age":25}
    actual_dict = {"name":"Alice","age":25}
    assert expect_dict == actual_dict

    #断言集合
    expect_set = {1,2,3,"apple"}
    actual_set ={1,2,3,"apple"}
    assert expect_set == actual_set
示例3:函数断言
def drivide (a,b):
    assert b != 0,"除数不能为0"
    return a / b

def test():
    #正常情况
    print(drivide(5,2))
    #触发断言
    #print(drivide(5,0)) #AssertionError:除数不能为0
示例4:接口返回值断言
#测试接口返回数据所有内容:字段&字段值
def test_01():
    url = "http://8.137.19.140:9090/blog/getList"
    header = {
        "user_token_header":"eyJhbGciOiJIUzI1NiJ9.eyJpZCI6MSwidXNlck5hbWUiOiJ6aGFuZ3NhbiIsImV4cCI6MTc1NDY1NjQ4Nn0.Yjvln8iw9XJMtW-K3yX-sZs7ayZymjzWFMH_ds9sXLc"
    }
    r = requests.request(method="GET",url=url,headers=header)
    print(r.json())

    expect_data = {'code': 'SUCCESS', 'errMsg': '', 'data': []}
    actual_data = r.json()
    assert expect_data == actual_data


#对关键字段进行校验
def test_02():
    url = "http://8.137.19.140:9090/blog/getList"
    header = {
        "user_token_header":"eyJhbGciOiJIUzI1NiJ9.eyJpZCI6MSwidXNlck5hbWUiOiJ6aGFuZ3NhbiIsImV4cCI6MTc1NDY1NjQ4Nn0.Yjvln8iw9XJMtW-K3yX-sZs7ayZymjzWFMH_ds9sXLc"
    }
    r = requests.request(method="GET",url=url,headers=header)
    # assert r.json()["data"][0]["id"] == 141848,"id错误"
    # assert r.json()["code"] == "SUCCESS"
    assert r.json()["data"][0]["content"] == "##在这里写下一篇博客"

def test_03():
    url = "http://112.126.76.148:8080"
    r = requests.get(url=url)
    print(r.text)
    text = "你愿意给我一个机会,让我用余生来守护这份美好吗?"
    assert text in r.text #text是否包含在r.text中
2.5.8 参数化
参数化设计是自动化设计中的一个重要组成部分,它通过定义设计参数和规则,使得设计过程更加灵活和可控。
pytest中内置的pytest.mark.parametrize装饰器允许对测试函数的参数进行参数化。
示例1:在用例上使用参数化
@pytest.mark.parametrize("test_input,expected",[("3+5",8),("2+4",6),("6*9",42)])
def test_eval(test_input,expected):
    assert eval(test_input) == expected
这里,@parametrize装饰器定义了三个不同的(test_input,expected)元组,以便test_eval函数将依次使用它们运行三次。
也可以在类或模块上使用parametrize标记,这将使用参数集调用多个函数
示例2:在类上使用参数化
@pytest.mark.parametrize("n,expected",[(1,2),(3,4)])
class TestClass:
    def test_simple_case(self,n,expected):
        assert n + 1 == expected

    def test_weird__simple_case(self,n,expected):
        assert(n * 1) + 1 == expected
要对模块中的所有测试进行参数化,你可以将pytestmark全局变量复制:
pytestmark = pytest.mark.parametrize("data",(1,2))
class Test_A:
    def test_a01(self,data):
        print(data)
    def test_a02(self,data):
        print("data")

class Test_B:
    def test_b01(self,data):
        print(data)
    def test_b02(self,data):
        print("data")
除了使用@parametrize添加参数化外,pytest.fixture()允许对fixture函数进行参数化。
示例3:自定义参数化数据源
def data_provider():
    #....
    return ["a","b","c"]

@pytest.mark.parametrize("data",data_provider())
def test_data(data):
    print(data)
2.5.9 fixture
pytest中的fixture是一种强大的机制,用于提供测试函数所需的资源或上下文。它可以用于设置测试环境、准备数据等。以下是fixture的一些核心概念和使用场景.
2.5.9.1 基本使用
示例1:使用与不使用fixture标记
未标记fixture方法的调用 -- 函数名调用
#未标记fixture方法的调用 -- 函数名调用
def fixture_01():
    print("第一个finxture方法")

def test_01():
    fixture_01()
    print("第一个测试用例")
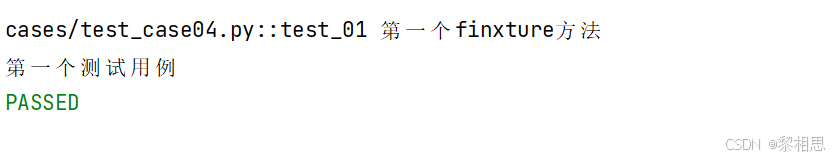
结果:
fixture标记的方法调用
@pytest.fixture
def fixture_01():
    print("第一个finxture方法")

def test_01(fixture_01):
    print("第一个测试用例")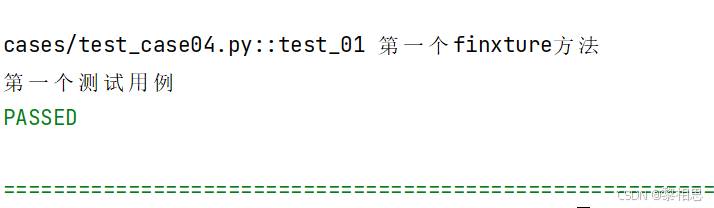
未标记fixture方法的调用与fixture标记的方法调用完全不一样,前者需要在方法体中调用,而后者可以将函数名作为参数进行调用。
测试脚本中存在的很多重复的代码、公共的数据对象时,使用fixture最为合适
示例2:访问列表页和详情页之前都需要执行登录操作
@pytest.fixture
def login():
    print("登录")

def test_blogList(login):
    print("测试博客列表页")

def test_blogDeail(login):
    print("测试博客详情页")
结果:

通过使用@pytest.fixture装饰器来告诉pytest一个特定函数是一个fixture,通过运行结果可见,在执行列表页和详情页之前都会先执行1ogin方法。
2.5.9.2 fixture嵌套
#fixture嵌套调用
@pytest.fixture
def first():
    print("first")

@pytest.fixture
def second(first):
    print("second")

def test(second):
    print("test")

#比较两个列表是否相同

@pytest.fixture
def first_entry():
    return "a"
@pytest.fixture
def order(first_entry):
    return[first_entry]

def test_string(order):
    #["a"]
    order.append("b") #["a","b"]
    assert order == ["a","b"]
测试不必局限于单个fixture,它们可以依赖于您想要的任意数量的fixture,并且fixture也可以使用其他fixture。pytest最伟大的优势之一是其极其灵活的fixture系统,它允许我们将测试的复杂需求简化为更简单和有组织的函数,我们只需要每个函数描述它们所依赖的事物
2.5.9.3 请求多个fixture
class Fruit:
    def __init__(self,name):
        self.name = name

    def __eq__(self, other):
        return self.name == other.name

@pytest.fixture
def my_fruit():
    return Fruit("apple")

@pytest.fixture
def your_fruit(my_fruit):
    return [my_fruit,Fruit("banana")]

#你的水果里是否包含我的水果
def test_fruit(my_fruit,your_fruit):
    assert my_fruit in your_fruit
测试和fixture不仅限于一次请求单个fixture,它们可以请求任意多个。
2.5.9.4 yield fixture
当我们运行测试时,我们希望确保它们能够自我清理,以便它们不会干扰其他测试(同时也避免留下大量测试数据来膨胀系统)。pytest中的fixture提供了一个非常有用拆卸系统,它允许我们为每
个fixture定义具体的清理步骤。
“Yield”fixture使用yield而不是return。有了这些fixture,我们可以运行一些代码,并将对象返回给请求的fixture/test,就像其他fixture一样。唯一的不同是:
- return被替换为yield。
- 该fixture的任何拆卸代码放置在yield之后。
一旦pytest确定了fixture的线性顺序,它将运行每个fixture直到它返回或yield然后继续执行列表中的下一个fixture做同样的事情。
测试完成后,pytest将逆向遍历fixture列表,对于每个yield的fixture,运行yield语句之后的代码。
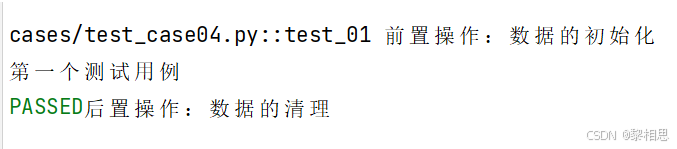
示例1:
@pytest.fixture()
def operator():
    print("前置操作:数据的初始化")

    yield

    print("后置操作:数据的清理")

def test_01(operator):
    print("第一个测试用例")
结果:
示例2:创建文件句柄与关闭文件
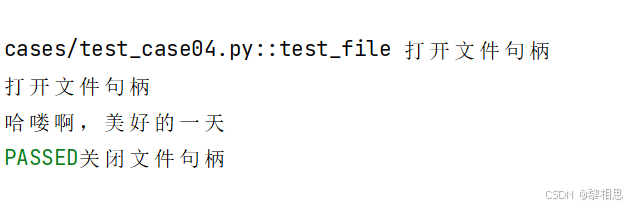
@pytest.fixture
def file_read():
    print("打开文件句柄")
    fo = open("test.txt","r",encoding="utf-8") #不需要指定相等路径,直接写文件名即可

    yield fo

    print("关闭文件句柄")
    fo.close()

@pytest.fixture
def file_write():
    print("打开文件句柄")
    fo = open("test.txt","w",encoding="utf-8") #不需要指定相等路径,直接写文件名即可

    return fo
    # yield fo
    #
    # print("关闭文件句柄")
    # fo.close()


def test_file(file_read,file_write):
    #往文件中写数据
    w = file_write
    w.write("哈喽啊,美好的一天")
    w.close()

    #读取文件中写好的数据
    r = file_read
    str = r.read()
    print(str)
运行结果:
2.5.9.5 带参数的fixture
pytest.fixture(scope='', params='', autouse='', ids='', name='')参数详解:
- scope参数用于控制fixture的作用范围,决定了fixture的生命周期。可选值有:
function(默认):每个测试函数都会调用一次fixture。
class:在同一个测试类中共享这个fixture。
module:在同一个测试模块中共享这个fixture。(一个文件里)
session:整个测试会话中共享这个fixture。
- autouse参数默认为False。如果设置为True,则每个测试函数都会自动调用该fixture,无需显式传入
- params参数用于参数化fixture,支持列表传入。每个参数值都会使fixture执行一次,类似于for循环
- ids参数与params配合使用,为每个参数化实例指定可读的标识符(给参数取名字)
- name参数用于为fixture显式设置一个名称。如果使用了name,则在测试函数中需要使用这个名称来引l用fixture(给fixture取名字)
示例1:scope的使用
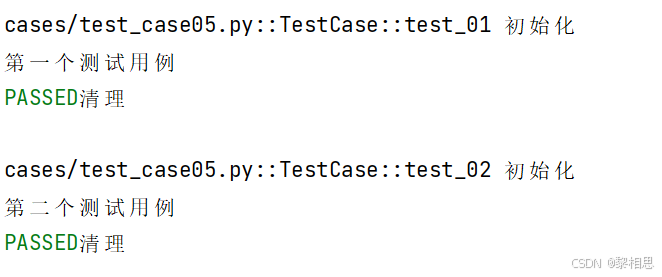
scope="function"
import pytest


@pytest.fixture(scope="function")
def fixture_01():
    print("初始化")
    yield
    print("清理")

class TestCase:
    def test_01(self,fixture_01):
        print("第一个测试用例")

    def test_02(self,fixture_01):
        print("第二个测试用例")
结果:
scope="class"
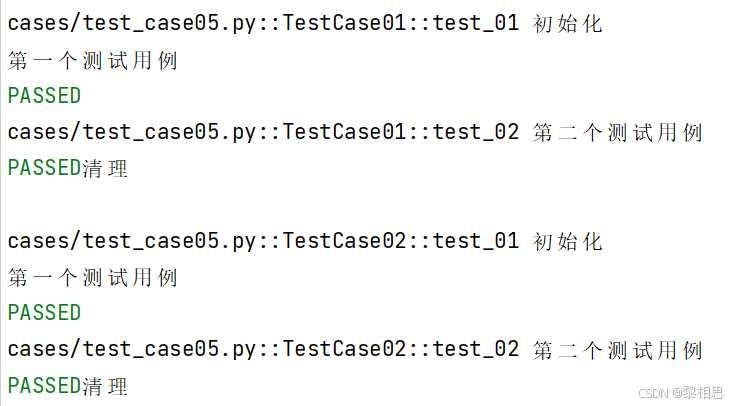
import pytest


@pytest.fixture(scope="class")
def fixture_01():
    print("初始化")
    yield
    print("清理")

class TestCase01:
    def test_01(self,fixture_01):
        print("第一个测试用例")

    def test_02(self,fixture_01):
        print("第二个测试用例")


class TestCase02:
    def test_01(self,fixture_01):
        print("第一个测试用例")

    def test_02(self,fixture_01):
        print("第二个测试用例")
结果:
结论:
- scope默认为function,这里的function可以省略不写,当scope="function"时,每个测试函数都会调用一次fixture。scope="class"时,在同一个测试类中,fixture只会在类中的第一个测试函数开始前执行一次,并在类中的最后一个测试函数结束后执行清理。
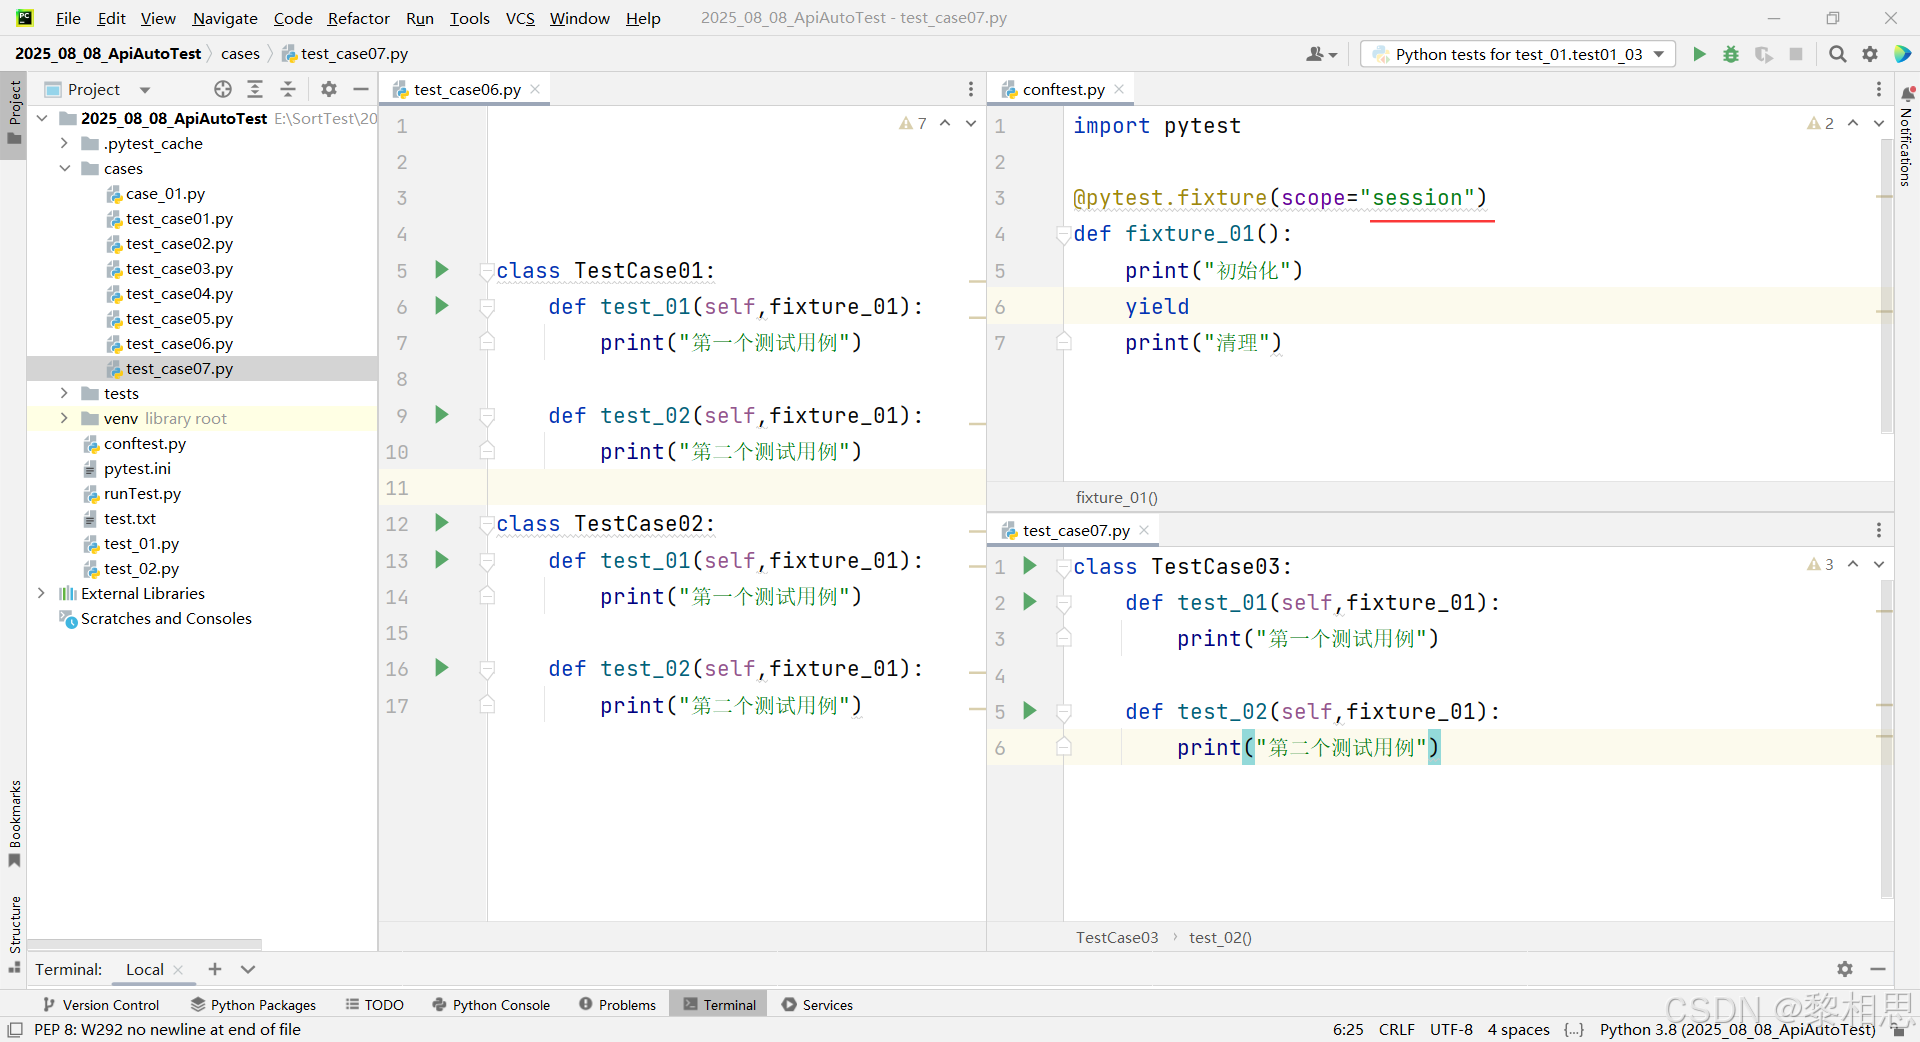
- 当 scope="moudle"、scope="session"时可用于实现全局的前后置应用,这里需要多个文件的配合。
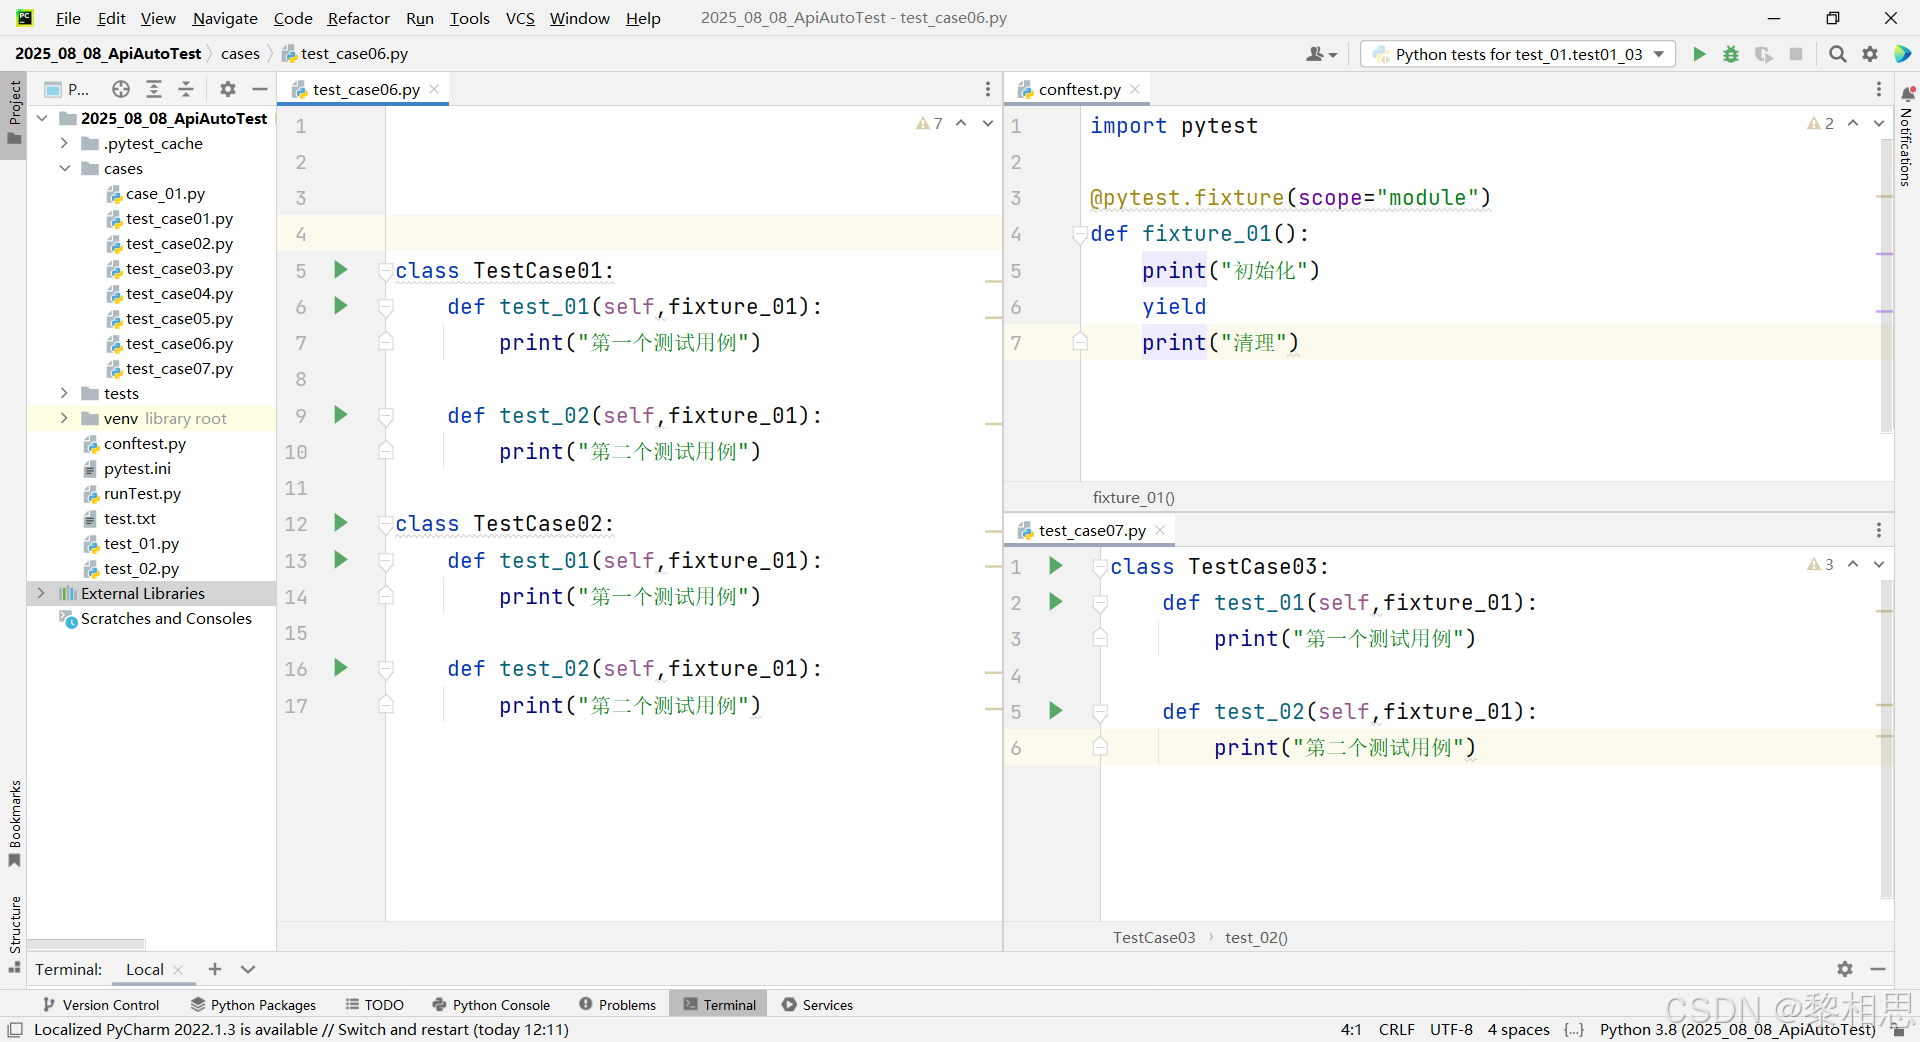
conftest.py和@pytest.fixture结合使用实现全局的前后置应用
@pytest.fixture与conftest.py文件结合使用,可以实现在多个测试模块(·py)文件中共享前后置操作,这种结合的方式使得可以在整个测试项目中定义和维护通用的前后置逻辑,使测试代码更加模块化和可维护。
规则:
- conftest.py是一个单独存放的夹具配置文件,名称是固定的不能修改
- 你可以在项目中的不同目录下创建多个conftest.py文件,每个conftest.py文件都会对其所在目录及其子目录下的测试模块生效
- 在不同模块的测试中需要用到conftest.py的前后置功能时,不需要做任何的import导入操作
- 作用:可以在不同的·py文件中使用同一个fixture函数
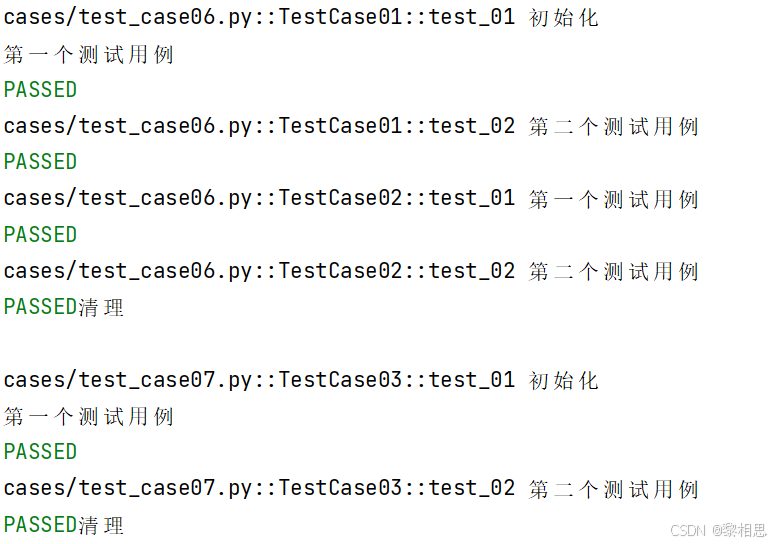
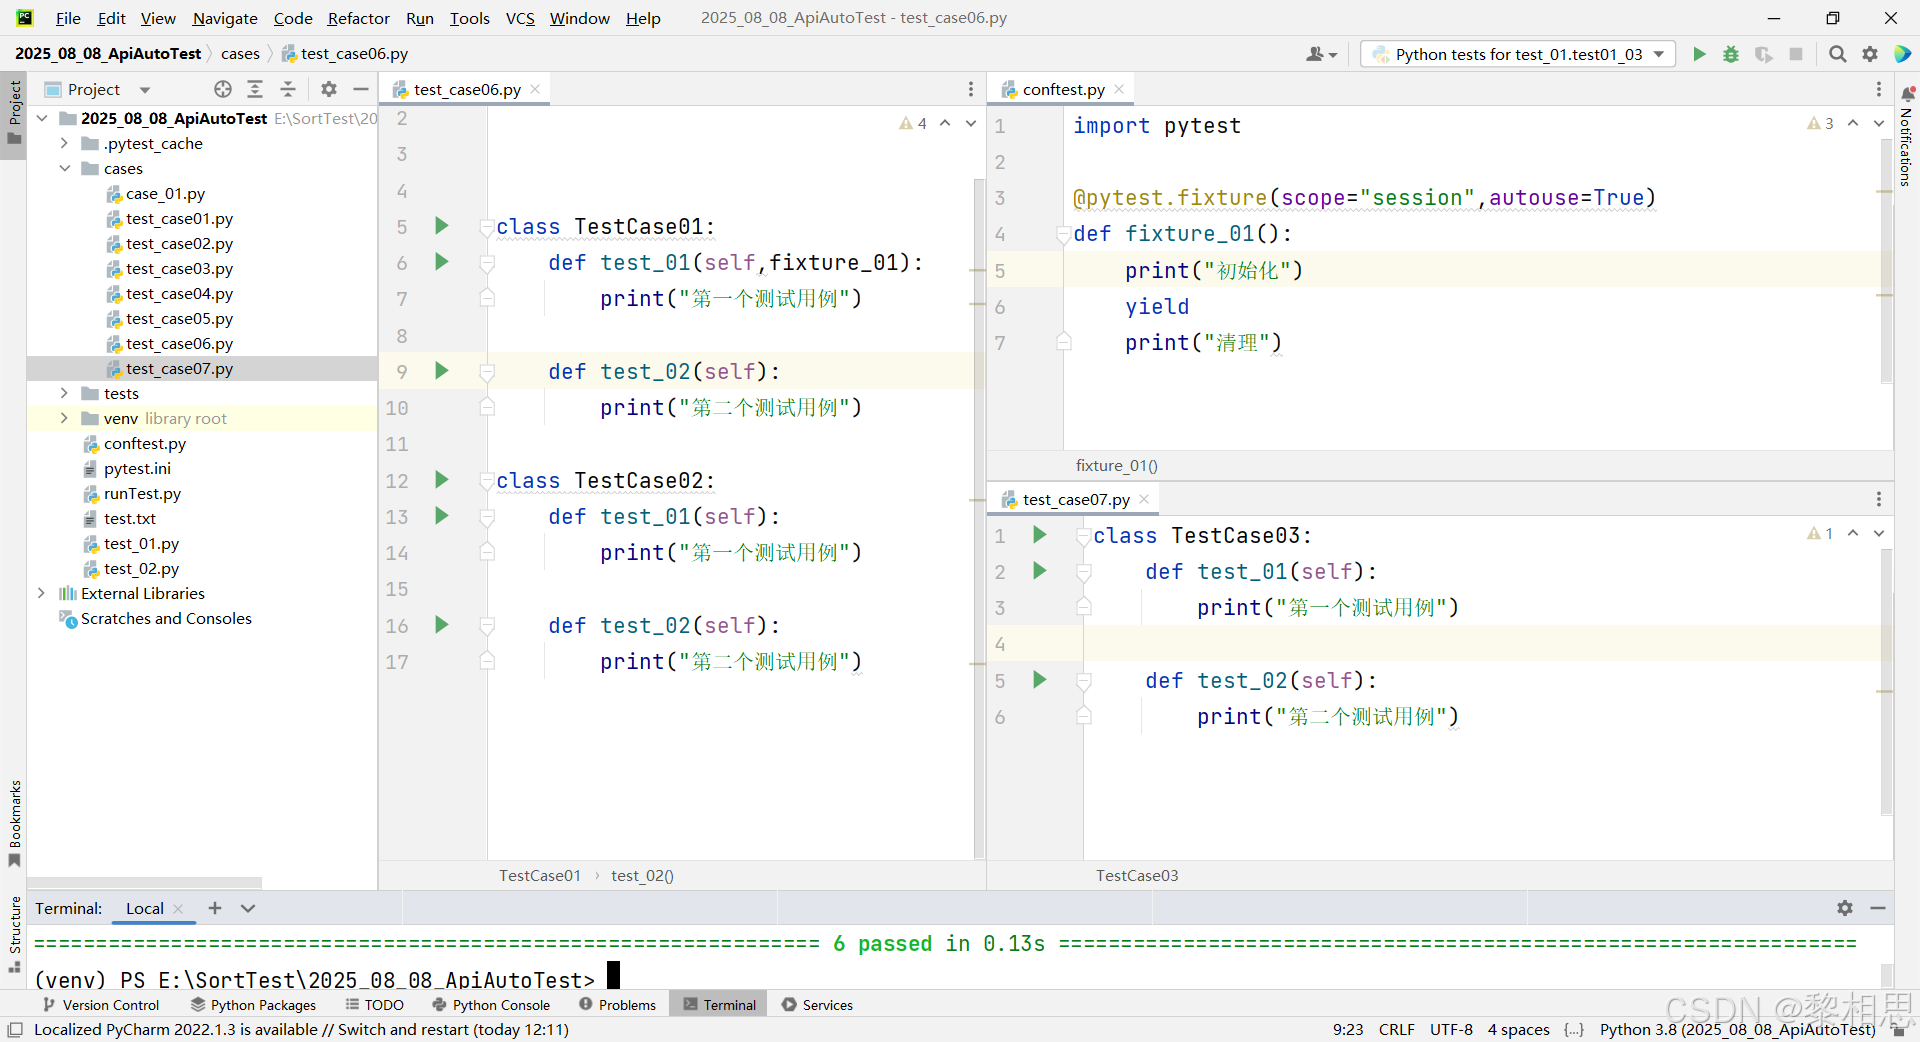
示例2:scope="moudle" scope="session"实现全局的前后置应用
运行结果:
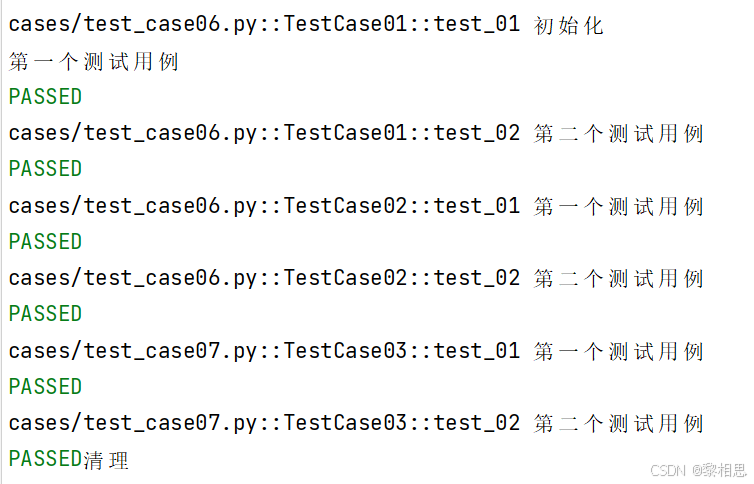
当scope="session"时:
运行结果:
示例3:autouse的使用
运行结果:
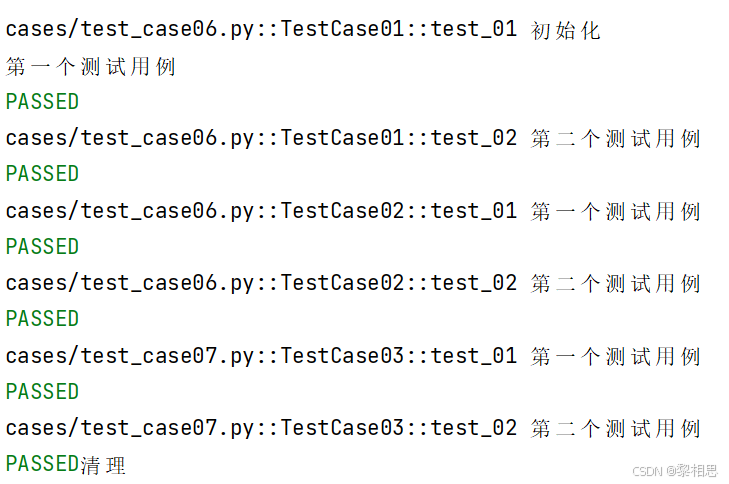
autouse默认为False,即当前的fixture需要手动显示调用,在该案例之前我们默认使用的都是autouse=False。
当autouse=True时,fixture会在所有测试函数执行之前自动调用,无论这些测试函数是否显式地引用了该fixture。
示例4:通过params实现参数化
@pytest.fixture(params=[1,2,3])
def data_provider(request):
    return request.param

def test_data(data_provider):
    print(data_provider)
结果:
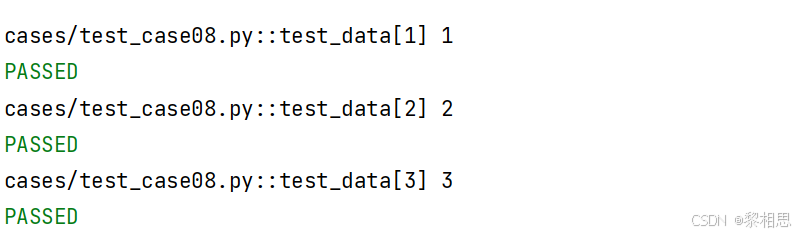
前面我们已经学过pytest中通过@pytest.mark.parametrize实现参数化,通过fixture也可以实现参数化,那么到底哪一种更好呢?
如果测试场景主要涉及简单的参数传递,且不需要复杂的资源管理,建议使用parametrize,因为它更简单直接;如果测试需要动态加载外部数据,或者需要管理复杂的测试资源(如数据库连接、文件操作等),建议使用fixture,在某些情况下,也可以结合使用parametrize和fixture,以充分利用两者的优点。总结来说,parametrize更适合简单场景,而fixture更适合需要动态数据和资源管理的复杂场景。
2.6 YAML
官方文档:
https://pyyaml.org/wiki/PyYAMLDocumentationhttps://pyyaml.org/wiki/PyYAMLDocumentationYAML是一种数据序列化语言,用于以人类可读的形式存储信息。它最初代表“YetAnotherMarkup
Language”,但后来更改为“YAMLAin’t Markup Language” (YAML不是一种标记语言),以区别于真正的标记语言。
它类似于XML和JSON文件,但使用更简洁的语法。
特点:
- YAML是一种非常简单的基于文本的人类可读的语言,用于在人和计算机之间交换数据。
- YAML是不是一种编程语言。它主要用于存储配置信息。
- YAML的缩进就像Python的缩进一样优雅。
- YAML还减少了JSON和XML文件中的大部分“噪音”格式,例如引I号、方括号和大括号。
注意:
- YAML是区分大小写。
- YAML不允许使用制表符Tab键,(你之所按下TabYAML仍能使用,是因为编辑器被配置为按下Tab键会导致插入适当数量的空格)。
- YAML是遵循严格缩进的。
2.6.1 YAML介绍
YAML文件的后缀名是.yaml或.yml,本着能少写不多写的原则,我们常用的是.yml。
yaml中支持不同数据类型,但在写法上稍有区别,详见下表:
| YAML | JSON | |
| 简单标量值 | | |
| 整数和浮点数 | | |
| 布尔值 | | |
| 字符串 | | |
| 列表 | | |
| 映射(字典) | | |
| 嵌套结构 | | |
以上语法若短时间内⽆法掌握,我们也有很多⼯具可供使⽤,如json转yaml
JSON 转 YAML 工具 | 简化数据格式转换 - 嘉澍工具将JSON格式的数据转换为YAML格式,简化配置文件的编辑和管理。YAML语法简洁,广泛应用于配置管理和数据存储。https://www.jashtool.com/json/to-yaml
2.6.2 使用
lyaml文件通常作为配置文件来使用,可以使用yaml库来读取和写入YAML文件
安装yaml库:
pip install PyYAML==6.0.1
#建议跟博客统⼀版本,避免因版本不同造成的使⽤差异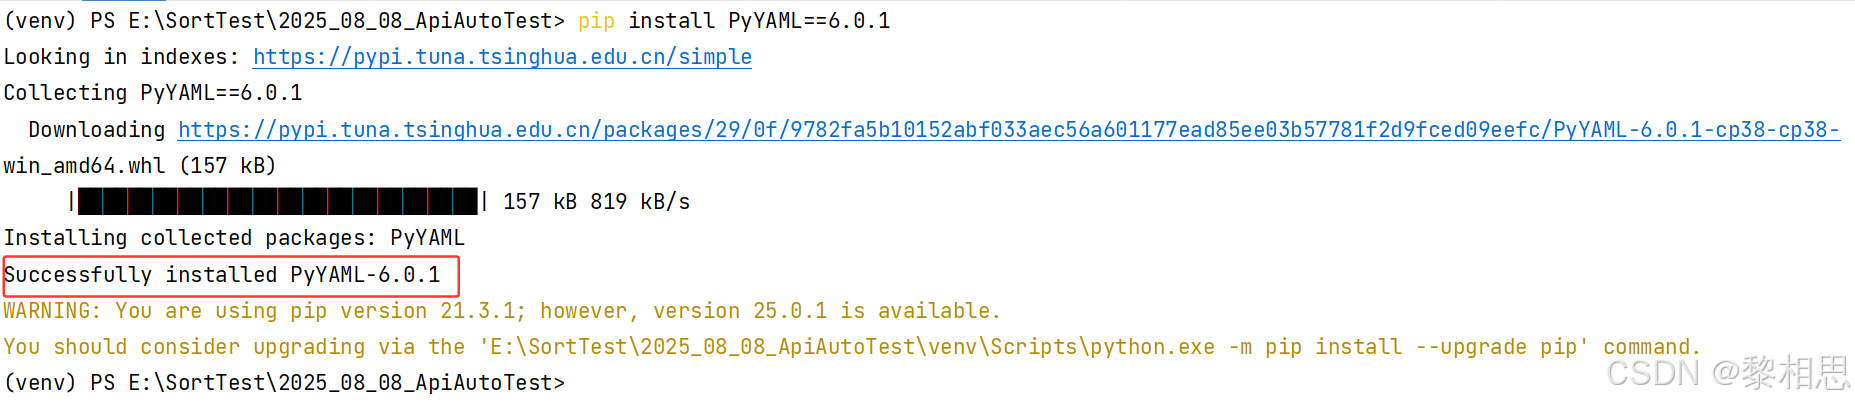
创建yaml文件:
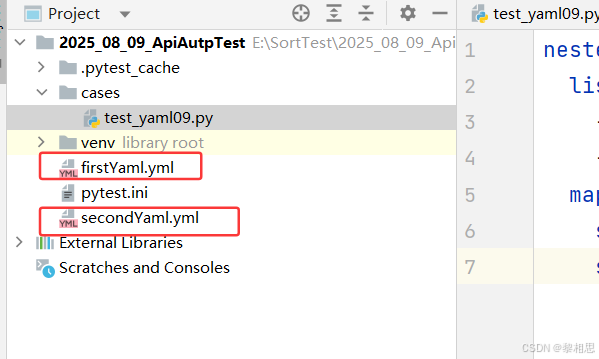
读取和写入yaml文件:
import yaml

#追加
def write_yaml(data):
    with open("./firstYaml.yml",encoding="utf-8",mode="a+") as f:
        yaml.safe_dump(data,stream=f)

#读取
def read_yaml():
    with open("./secondYaml.yml",encoding="utf-8",mode="r") as f:
        data = yaml.safe_load(f)
        print(data)

#清空yaml文件
def clear_yaml():
    with open("./firstYaml.yml",encoding="utf-8",mode="w") as f:
        f.truncate()#该方法不属于yaml提供


def atest_writeyaml():
    data = {
        "code": "SUCCESS",
        "errMsg": "",
        "data": [
            {
                "id": 142854,
                "title": "发布页面自动化功能测试",
                "content": "##在这里写下一篇博客",
                "userId": 1,
                "deleteFlag": 0,
                "createTime": "2025-08-09 18:03",
                "updateTime": "2025-08-09T10:03:07.000+00:00",
                "loginUser": False
            }
        ]
    }
    write_yaml(data)

def test_readyaml():
    read_yaml()

#往yaml文件中写了数据,把文件请空再重新写新的数据
def atest_clearyaml():
    clear_yaml()
2.7 JSON Schema
JSON Schema一个用来定义和校验JSON的web规范,简而言之,JSONSchema是用来校验json是否符合预期。
根据json创建JSONSchema后,你可以使用你选择的语言中的验证器将示例数据与你的模式进行验证。
2.7.1 安装
pip install jsonschema==4.23.0
#建议跟博客统⼀版本,避免因版本不同造成的使⽤差异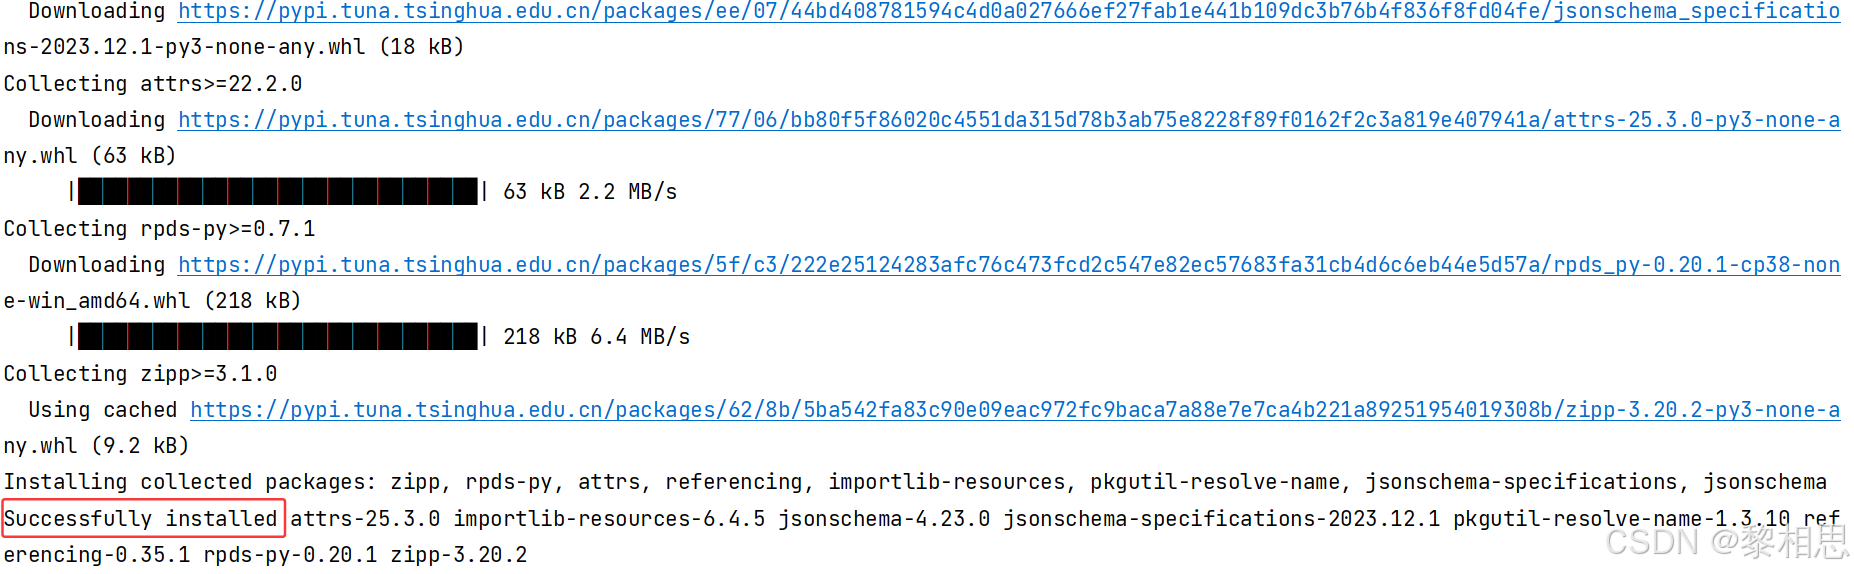
2.7.2 介绍
JSON:
{
    "code": "SUCCESS",
    "errMsg": "",
    "data": false
}
JSON Schema:
{
    "type": "object",
    "required": [],
    "properties": {
    "code": {
            "type": "string"
        },
            "errMsg": {
            "type": "string"
        },
            "data": {
            "type": "string"
        }
    }
}
通过上面的对比可见,JSONSchema从多个方面对JSON数据进行校验。
如“type"、"required”、"properties等以确保其正确性和一致性。接下来我们来了解JSONSchema中的关键词以及作用。
json转JSON Schema太麻烦?使用现有工具自动转换:在线JSON转Schema工具 - ToolTT在线工具箱在线将JSON转换成Schemahttps://tooltt.com/json2schema/注意:工具不是万能的,结果可能存在错误,要对自动生成的结果进行二次检查
示例:校验博客列表页返回的json数据
from jsonschema.validators import validate
import requests

def test01():
    jsonschema = {
      "type": "object",
      "required": [],
      "properties": {
        "code": {
          "type": "string"
        },
        "errMsg": {
          "type": "string"
        },
        "data": {
          "type": "array",
          "items": {
            "type": "object",
            "required": [],
            "properties": {
              "id": {
                "type": "number"
              },
              "title": {
                "type": "string"
              },
              "content": {
                "type": "string"
              },
              "userId": {
                "type": "number"
              },
              "deleteFlag": {
                "type": "number"
              },
              "createTime": {
                "type": "string"
              },
              "updateTime": {
                "type": "string"
              },
              "loginUser": {
                "type": "boolean"
              }
            }
          }
        }
      }
    }
    url = "http://8.137.19.140:9090/blog/getList"
    header = {
        "user_token_header":"eyJhbGciOiJIUzI1NiJ9.eyJpZCI6MSwidXNlck5hbWUiOiJ6aGFuZ3NhbiIsImV4cCI6MTc1NDc1NTcxM30.8k657_cYC1XbYaSXxuObRIuYS7dF1Kf91YfTmAae0_w"
    }
    r = requests.get(url=url,headers=header)
    validate(r.json(),jsonschema)
2.7.2.1 数据类型
type关键字指定了数据类型
可以验证JSON数据中每个属性的数据类型是否符合预期。常见的数据类型包括:
| type | 解释 |
| string | 字符串类型,用于文本数据。 |
| number | 数字类型,用于表示浮点数 |
| integer | 整数类型,用于表示整数 |
| boolean | 布尔类型,值为true或false |
| object | 对象类型,用于嵌套的JSON对象 |
| array | 数组类型,用于列表或集合 |
| null | 空值类型 |
示例:
{
    "type": "object",
    "properties": {
        "name": { "type": "string" },
        "age": { "type": "integer" }
    }
}
properties是一个验证关键字。当你定义properties时,你创建了一个对象,其中每个属性代表正在验证的JSON数据中的一个键。
代码:
def test_02():
  json = {
    "name":"zhangsan",
    "height":163.5,
    "female":False,
    "hobby":{
      "aaa":"aaa",
      "bbb":"bbb"
    }
  }

  json_scheam = {
    "type":"object",
    "properties":{
      "name":{
        "type":"string"
      },
      "height":{
        "type":"number"
      },
      "female": {
        "type": "boolean"
      },
      "hobby":{
        "type":"object",
        "properties":{
          "aaa":{
            "type":"string"
          },
          "bbb":{
            "type":"string"
          }
        }
      }
    }
  }

  validate(json,json_scheam)
def test_03():
json = {
"data":[
{
"name","zhangsan",
"age",20
},
{
"name":"lisi",
"age":18
}
],
"addr":None
}
json_schema = {
"type":"object",
"properties":{
"addr":{
"type":"null"
},
"data":{
"type":"array",
"properties":{
"name":{
"type":"string"
},
"age":{
"type":"integer"
}
}
}
}
}
json_schema1 = { #相较于上面的更规范
"type": "object",
"properties": {
"data": {
"type": "array",
"items": {
"type": "object",
"properties": {
"name": {
"type": "string"
},
"age": {
"type": "number"
}
}
}
}
}
}
validate(json,json_schema)2.7.2.2 最大最小值
- minimum和maximum:指定数值的最小值和最大值。
- exclusiveMinimum和exclusiveMaximum:指定数值必须严格大于或小于某个值(不包含等于)。
示例:
def test_04():
  json = {
    "name":"zhangsan",
    "age":100
  }

  json_schema = {
    "type": "object",
    "required": [],
    "properties": {
      "name": {
        "type": "string"
      },
      "age": {
        "type": "number",
        # "minimum":0,
        # "maximum":100
        "exclusiveMinimum":0,
        "exclusiveMaximum":100
      }
    }
  }

  validate(instance=json,schema=json_schema)
2.7.2.3 字符串特殊校验
pattern:使用正则表达式来验证字符串是否符合特定的模式。
正则表达式语法网址:
正则表达式在线测试 - 在线工具该工具主要针对程序开发人员,通过该工具可以快速准备的判断所写的正则是否能正确匹配相应的字符https://www.sojson.com/regex/check.html代码:
def test_05():
  json = {
    "name": "zhangsan",
    "age": 100
  }

  json_schema = {
    "type": "object",
    "required": [],
    "properties": {
      "name": {
        "type": "string",
        "pattern": "\S{8,}"
      },
      "age": {
        "type": "number"
      }
    }
  }
  validate(instance=json, schema=json_schema)
2.7.2.4 数组约束
- minItems和maxItems:指定数组的最小和最大长度。
- uniqueItems:确保数组中的元素是唯一的。
- items:定义数组中每个元素的类型和约束。
def test_06():
  json = {
    "data":["hello","world"],
    "str":"hello"
  }

  json_schema = {
    "type": "object",
    "required": [],
    "properties": {
      "data": {
        "type": "array",
        #针对数组添加最大和最小长度限制
        "minItems":1,
        "maxItems":5,
        #要去数组中元素唯一
        "uniqueItems":True,
        "items": {
          "type": "number"
        }
      },
      "str": {
        "type": "string"
      }
    }
  }

  validate(instance=json,schema=json_schema)
2.7.2.5 对象约束
- minProperties和maxProperties:指定对象的最小和最大属性数量。
- additionalProperties:控制是否允许对象中存在未在properties中定义的额外属性,默认为True。
def test_07():
  json = {
      "code": "SUCCESS",
      "errMsg": "",
      "data": [
          {
              "id": 142874,
              "title": "自动化功能测试",
              "content": "##在这里写下一篇博客",
              "userId": 1,
              "deleteFlag": 0,
              "createTime": "2025-08-09 22:47",
              "updateTime": "2025-08-09T14:47:54.000+00:00",
              "loginUser": False,
              "aaa": False,
              "bbb": False,
              "ccc": False,
          }
      ]
  }

  json_schema = {
    "type": "object",
    # "additionalProperties": False,
    # 最小的属性数量
    "minProperties": 3,
    # 最大的属性数量
    "maxProperties": 3,
    "required": [],
    "properties": {
      "code": {
        "type": "string"
      },
      "errMsg": {
        "type": "string"
      },
      "data": {
        "type": "array",
        "items": {
          "type": "object",
          "required": [],
          #只能有properties里限制的这些项,不允许有额外的字段
          # "additionalProperties":False,
          #最小的属性数量
          # "minProperties":8,
          #最大的属性数量
          # "maxProperties": 10,
          "properties": {
            "id": {
              "type": "number"
            },
            "title": {
              "type": "string"
            },
            "content": {
              "type": "string"
            },
            "userId": {
              "type": "number"
            },
            "deleteFlag": {
              "type": "number"
            },
            "createTime": {
              "type": "string"
            },
            "updateTime": {
              "type": "string"
            },
            "loginUser": {
              "type": "boolean"
            }
          }
        }
      }
    }
  }

  validate(instance=json,schema=json_schema)
2.7.2.6 必需属性
通过required关键字,JSON Schema可以指定哪些属性是必需的。如果JSON实例中缺少这些必需属性,验证将失败。
示例:
def test_08():
  json = {
      "code": "SUCCESS",
      "errMsg": "",
      "data": [
          {
              "id": 142874,
              "title": "自动化功能测试",
              "content": "##在这里写下一篇博客",
              "userId": 1,
              "deleteFlag": 0,
              "createTime": "2025-08-09 22:47",
              "updateTime": "2025-08-09T14:47:54.000+00:00",
              "loginUser": False
          }
      ]
  }

  json_schema = {
    "type": "object",
    #添加必需属性
    "required": ["code","errMsg","data"],
    "properties": {
      "code": {
        "type": "string"
      },
      "errMsg": {
        "type": "string"
      },
      "data": {
        "type": "array",
        "items": {
          "type": "object",
          "required": ["id","loginUser"],
          "properties": {
            "id": {
              "type": "number"
            },
            "title": {
              "type": "string"
            },
            "content": {
              "type": "string"
            },
            "userId": {
              "type": "number"
            },
            "deleteFlag": {
              "type": "number"
            },
            "createTime": {
              "type": "string"
            },
            "updateTime": {
              "type": "string"
            },
            "loginUser": {
              "type": "boolean"
            }
          }
        }
      }
    }
  }

  validate(instance=json,schema=json_schema)
2.7.2.7 依赖关系
dependentRequired可以定义属性之间的依赖关系。例如,如果某个属性存在,则必须存在另一个属性。
示例:
def test_09():
  json = {
    "username":"zhangsan",
    "age":18,
    "height":175,
    "gemder":"female",
    "hobby":{
      # "aaa":"aaa",
      "bbb":"bbb"
    }
  }
  schema = {
    "type": "object",
    "required": [],
    "properties": {
      "username": {
        "type": "string"
      },
      "age": {
        "type": "number"
      },
      "height": {
        "type": "number"
      },
      "gemder": {
        "type": "string"
      },
      "hobby":{
        "type":"object",
        "properties":{
          "aaa":{
            "type":"string"
          },
          "bbb":{
            "type":"string"
          }
        },
        "dependentRequired":{
          "aaa":["bbb"]
        }
      }
    },
    "dependentRequired":{
      "age":["height","gemder"]
    }
  }

  validate(instance=json,schema=schema)
2.8 logging日志模块
2.8.1介绍
logging是Python标准库中的一个模块,它提供了灵活的日志记录功能。通过logging,开发者可以方便地将日志信息输出到控制台、文件、网络等多种目标,同时支持不同级别的日志记录,以满足不同场景下的需求。
2.8.2 使用
示例1:全局logging
import logging

#默认情况下,logging输入warning及以上级别的日志
#指定输出级别,输入info及以上级别的日志
logging.basicConfig(level=logging.INFO)

logging.debug("this is a debug message")
logging.info("this is a info message")
logging.warning("this is a warning message")
logging.error("this is a error message")
logging.critical("this is a critical message")
结果:
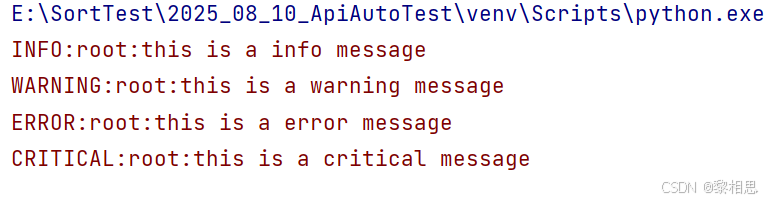
示例2:自定义logger并输出到控制台
import logging

logger = logging.getLogger("my_logger")
# logging.getLogger(__name__)#用模块名做当前日志的日志名
#给logger对象配置自己的日志 级别
logger.setLevel(level=logging.DEBUG)

logger.debug("this is a debug message")
logger.info("this is a info message")
logger.warning("this is a warning message")
logger.error("this is a error message")
logger.critical("this is a critical message")
结果:
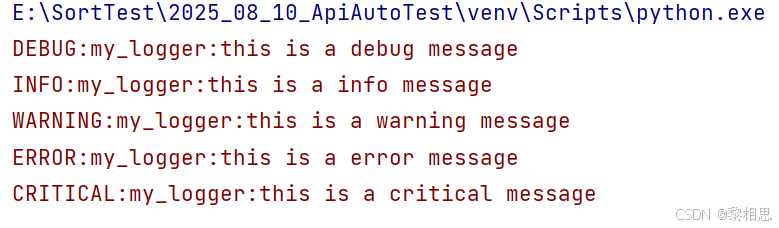
示例3:自定义logger并输出到日志文件
import logging

logger = logging.getLogger("my_logger")
# logging.getLogger(__name__)#用模块名做当前日志的日志名
#给logger对象配置自己的日志 级别
logger.setLevel(level=logging.DEBUG)

#创建文件处理器 -- 将日志输出到mylog.log (可以自动创建)
handler = logging.FileHandler(filename="mylog.log")

#将处理器添加到日志记录器中
logger.addHandler(handler)

logger.debug("this is a debug message")
logger.info("this is a info message")
logger.warning("this is a warning message")
logger.error("this is a error message")
logger.critical("this is a critical message")
结果:
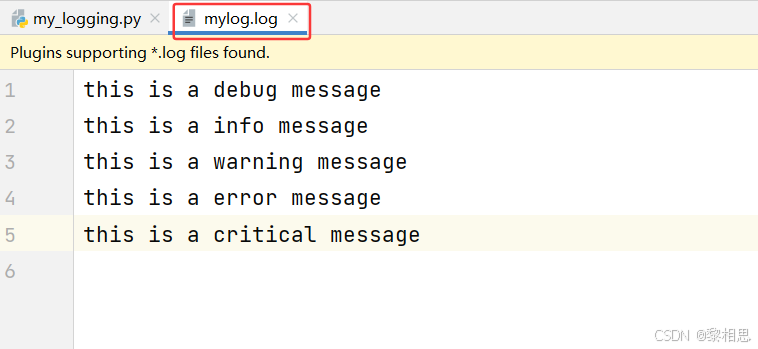
- 获取日志记录器:1ogging·getLogger(__name__)获取一个日志记录器对象,name是当前模块的名称。使用模块名称作为日志记录器的名称有助于在大型项目中区分不同模块的日志。
- 设置日志级别:logger.setLevel(logging·DEBUG)将日志记录器的级别设置为DEBUG,这意味着所有DEBUG及以上级别的日志都会被记录。
⽇志级别⾦字塔:DEBUG < INFO < WARNING < ERROR < CRITICAL ⾼于设定级别的⽇志才会被处理
- 创建文件处理器:logging.FileHandler(filename="test.log")创建一个文件处理器,将日志信息写入到名为test.log的文件中。
- 添加处理器:logger.addHandler(handler)将文件处理器添加到日志记录器中,这样日志记录器就会使用这个处理器来处理日志信息。
示例4:设置日志格式
import logging

logger = logging.getLogger("my_logger")
# logging.getLogger(__name__)#用模块名做当前日志的日志名
#给logger对象配置自己的日志 级别
logger.setLevel(level=logging.ERROR)

#创建文件处理器 -- 将日志输出到mylog.log (可以自动创建)
handler = logging.FileHandler(filename="mylog.log")

#创建一个日子格式器对象
formatter = logging.Formatter(
    "%(asctime)s %(levelname)s [%(name)s] [%(filename)s (%(funcName)s:%(lineno)d)] - %(message)s"
)

#将指定格式设置到处理器上
handler.setFormatter(formatter)

#将处理器添加到日志记录器中
logger.addHandler(handler)

logger.debug("this is a debug message")
logger.info("this is a info message")
logger.warning("this is a warning message")
logger.error("this is a error message")
logger.critical("this is a critical message")
结果:
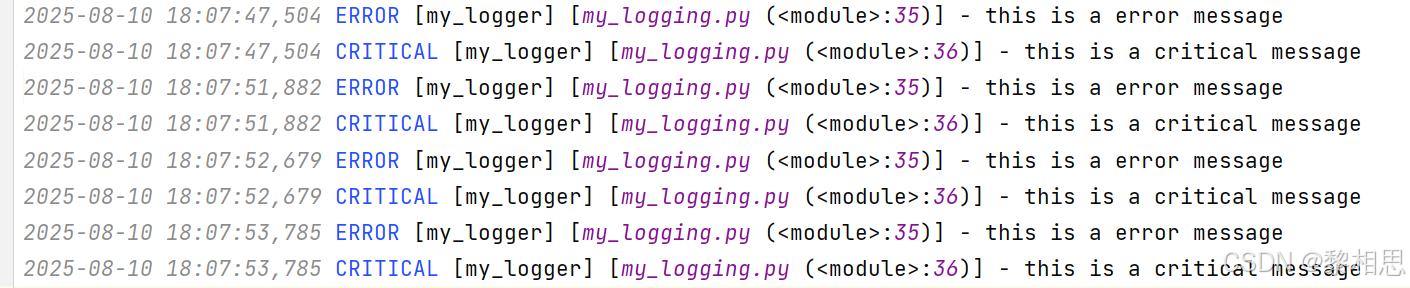
logging·Formatter是用于定义日志输出格式的类。在构造函数中,传递了一个格式字符串,用于指定日志信息的格式。格式字符串中使用了一些特殊的占位符(以%开头),这些占位符会被替换为相应的日志信息内容。
| 格式占位符 | 说明 |
| %(asctime)s | 日志记录的时间戳,通常显示为日期和时间 |
| %(levelname)s | 日志级别(如DEBUG、INFO、WARNING、ERROR、CRITICAL)。 |
| %(name)s | 日志记录器的名称,通常为模块名称。 |
| %(filename)s | 日志记录发生的文件名。 |
| %(funcName)s | 日志记录发生的函数名。 |
| %(lineno)d | 日志记录发生的行号。 |
| %(message)s | 日志消息本身。 |
handler.setFormatter(formatter)将创建的格式器对象设置到处理器上。这意味着处理器在处理日志信息时,会使用这个格式器来格式化日志信息,
通过这种方式,你可以控制日志信息的输出格式,使其包含你感兴趣的信息,如时间戳、日志级别、文件名、函数名、行号等。
2.9 测试报告allure
2.9.1 介绍
AllureReport由一个框架适配器和allure命令行工具组成,是一个流行的开源工具,用于可视化测试运行的结果。它可以以很少甚至零配置的方式添加到您的测试工作流中。它生成的报告可以在任何地方打开,并且任何人都可以阅读,无需深厚的技术知识,
2.9.2 安装
2.9.2.1 下载allure-pytest包
pip install allure-pytest==2.13.5
#建议跟博客统⼀版本,避免因版本不同造成的使⽤差异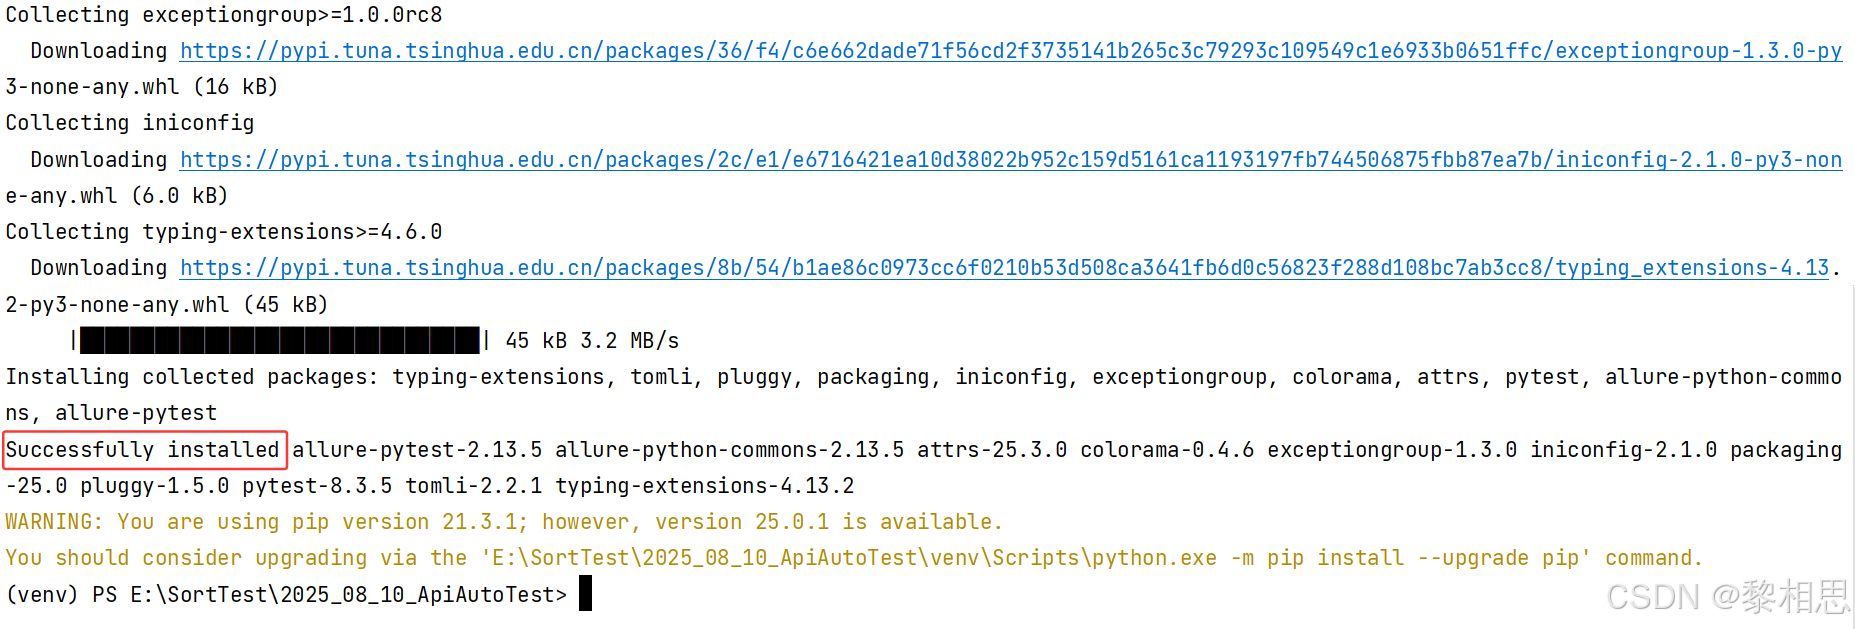
2.9.2.2 下载Windows版Allure报告
下载压缩包:
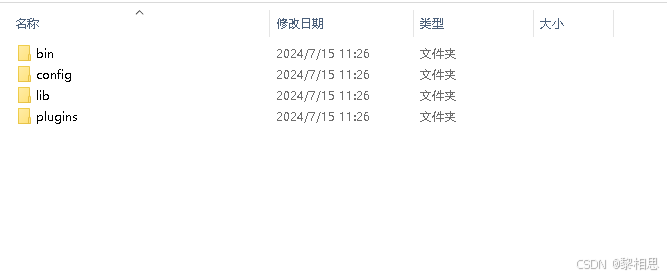
添加环境变量:
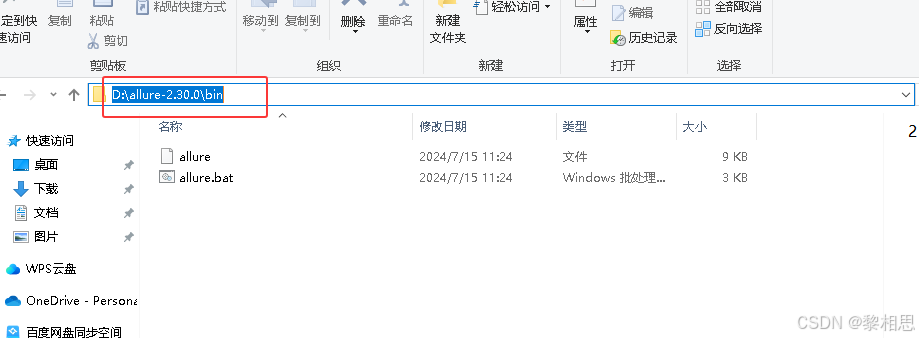
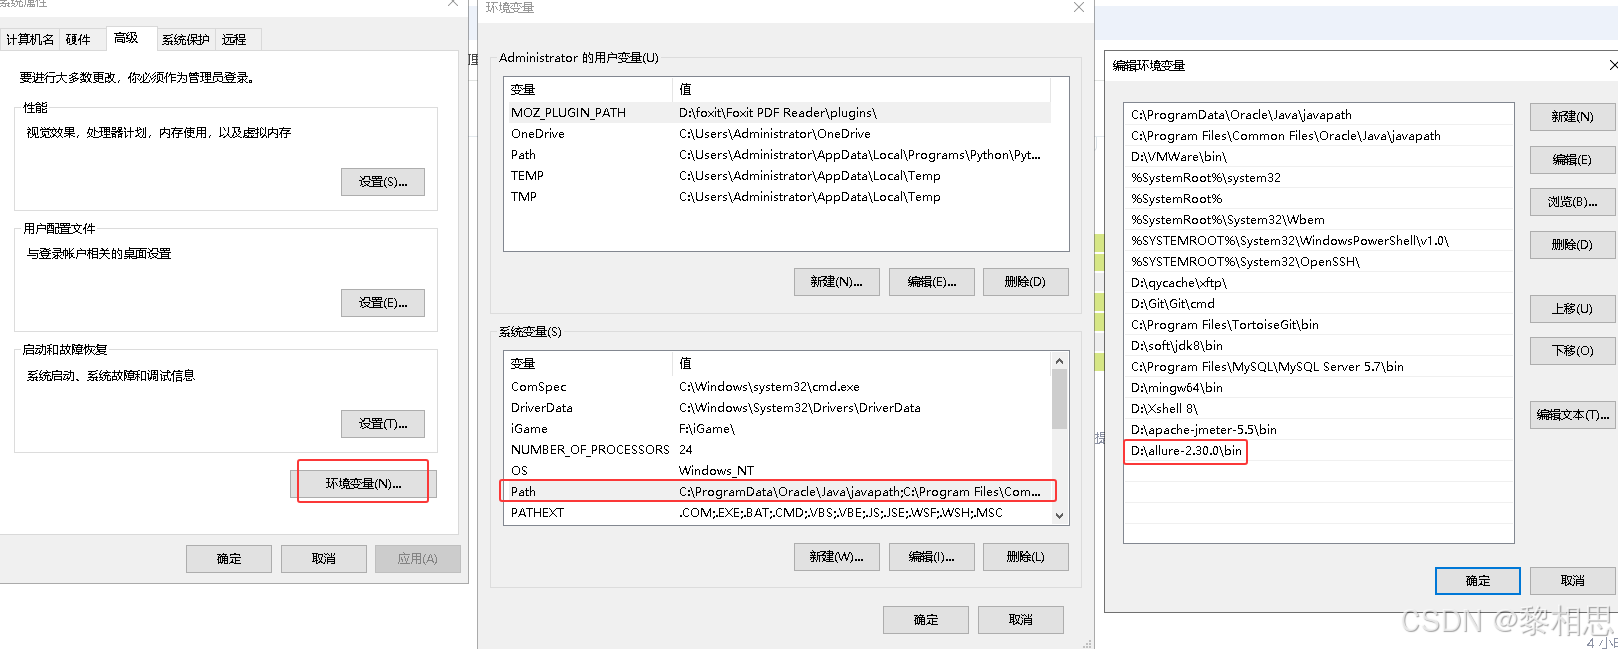
确认结果:
cmd窗口:
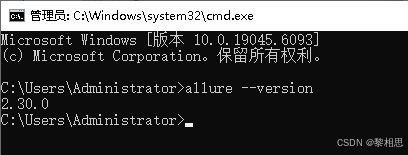
pycharm:
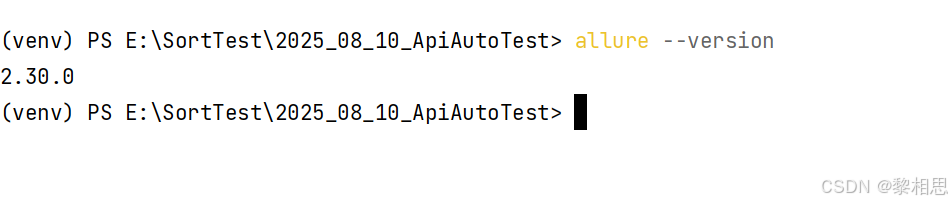
若出现cmd中执行allure--version可以打印版本,但是pycharm控制台执行命令提示命题找不到,则需要修改pycharm中命令行环境,如下:
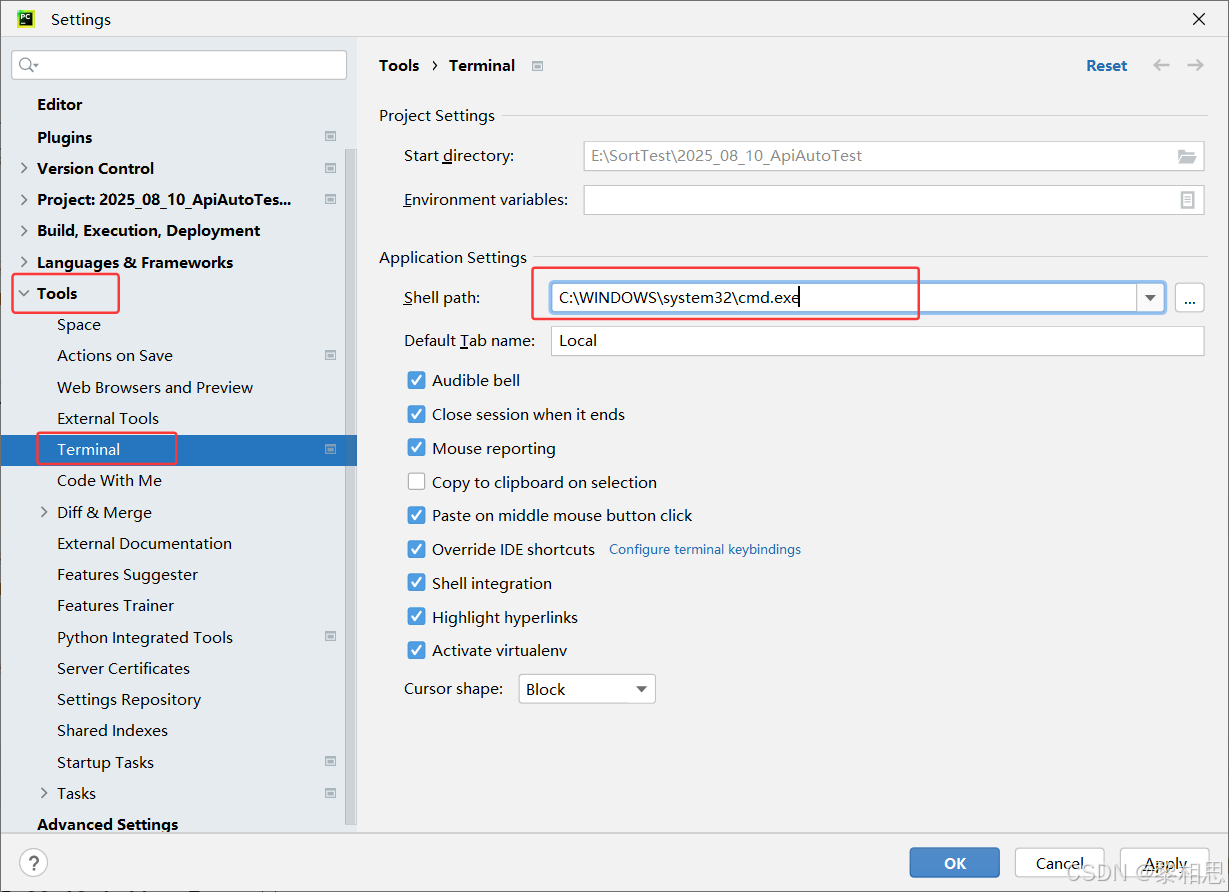
保存后需要重启pycharm!!!!!!
检查pycharm中命令⾏是否可以使⽤allure命令。
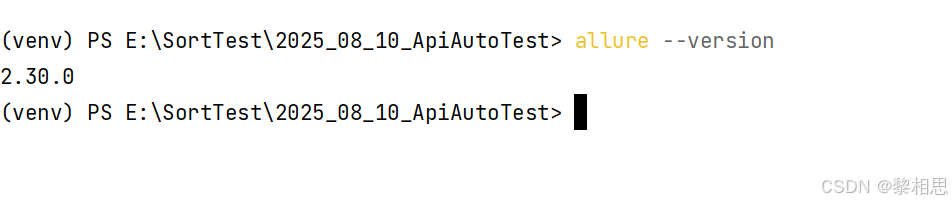
2.9.3 使用
2.9.3.1 运行自动化,并指定测试报告放置路径
pytest --alluredir=results_dir(保存测试报告的路径)
示例:pytest --alluredir=allure-results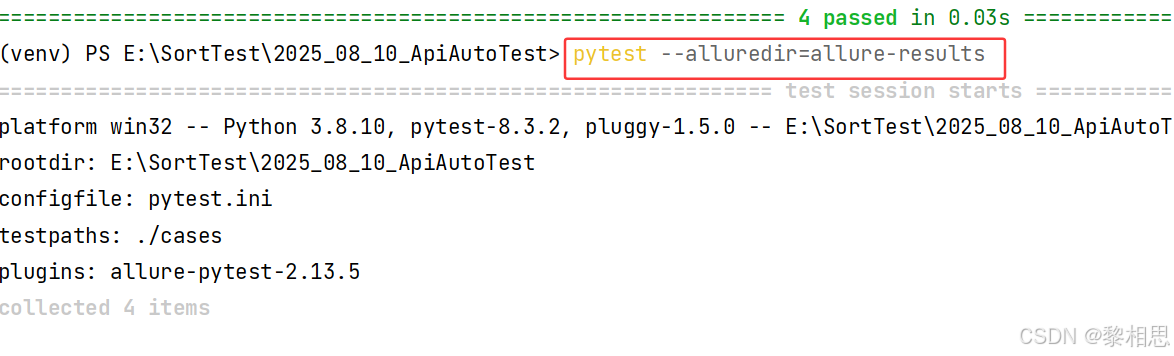
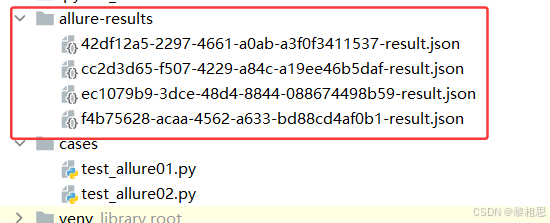
当前项目下自动生成allure-results文件夹,存放报告相关文件
生成测试报告可以在控制台通过命令将结果保存在allre-results文件夹中,也可以在pytest.ini文件中配置测试报告放置路径。
addopts = -vs --alluredir allure-results
2.9.3.2 查看测试报告
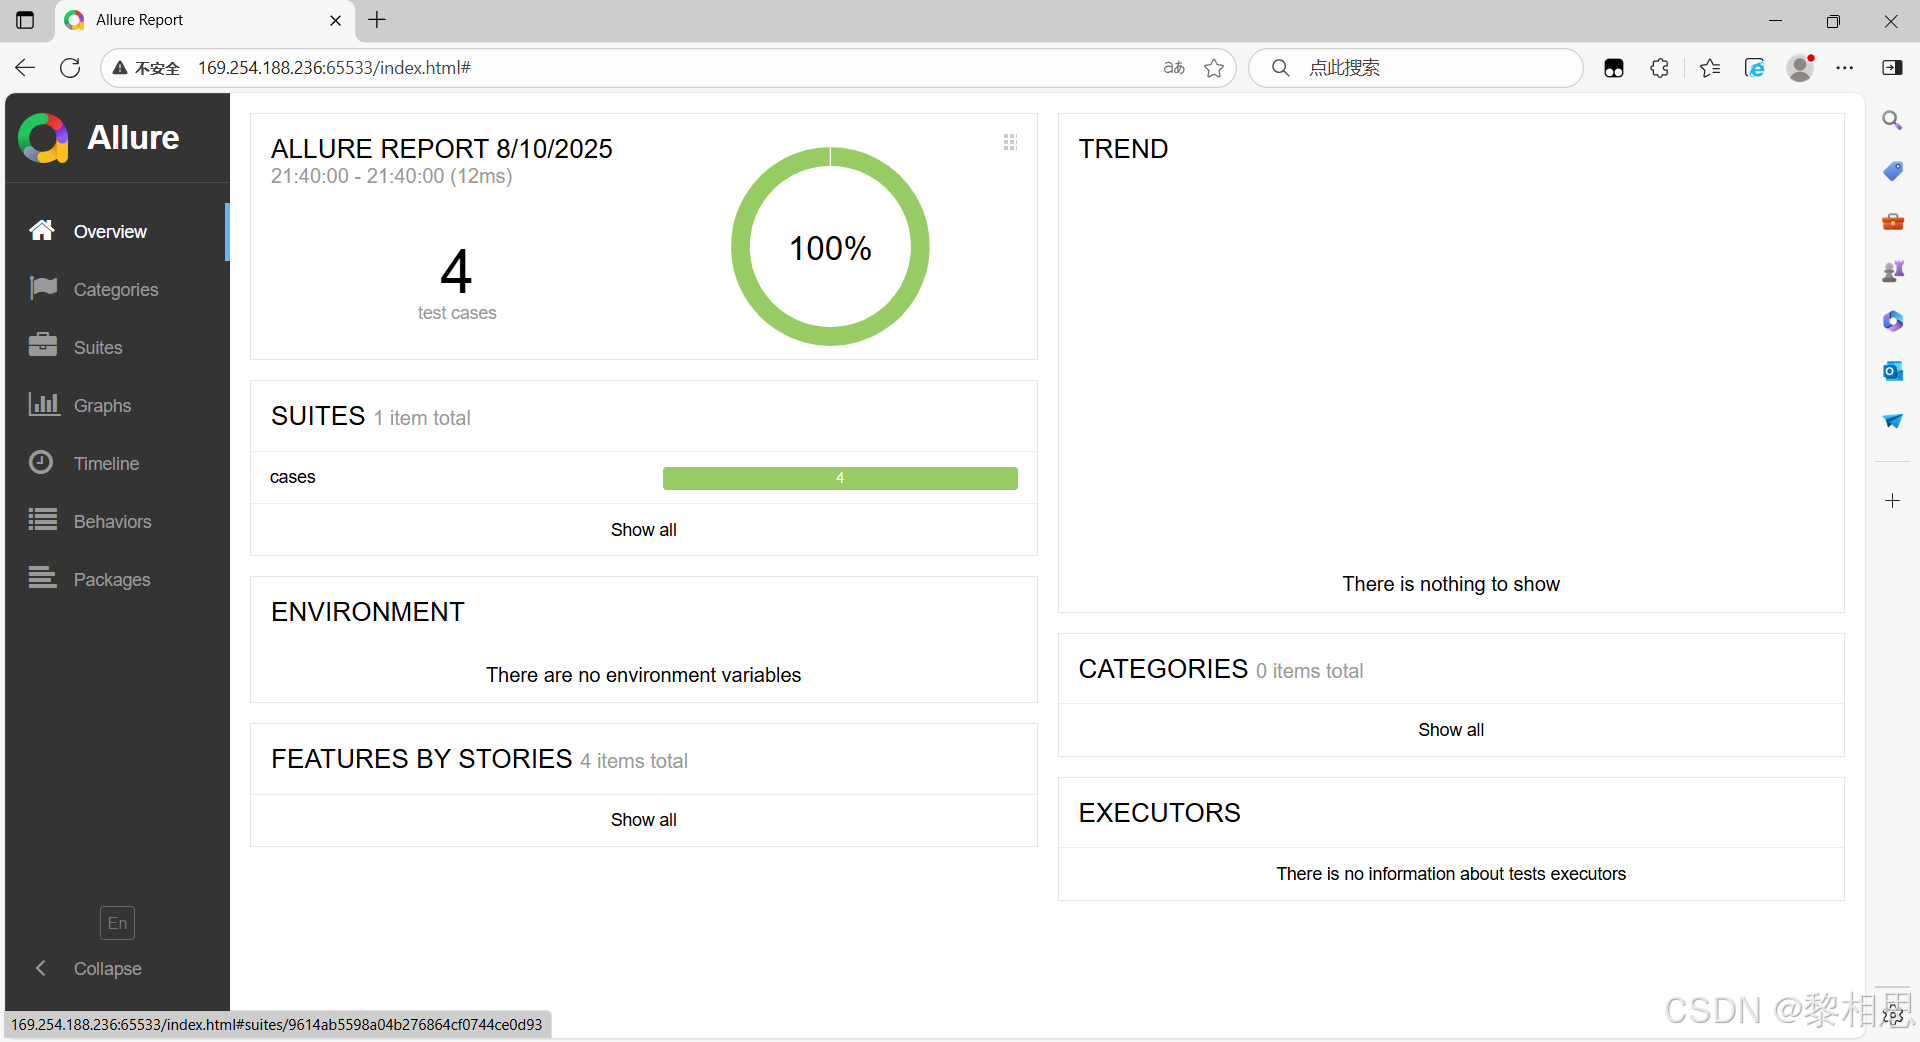
⽅法⼀:启动⼀个本地服务器来在浏览器中展⽰测试报告
终端执行命令:allure serve [options] <allure-results>,自动在浏览器打开测试报告
- --host:指定服务器监听的主机地址,默认为localhost。
- --port:指定服务器监听的端口号,默认为0(自动选择空闲端口)
- --clean-alluredir:清除上一次生成的测试报告
示例:
#不指定端⼝号和主机地址
allure serve .\allure-results\

#指定端⼝号
allure serve --port 8787 .\allure-results\ (必须是空闲的端口号,不能被占用)

#清除上⼀次⽣成的测试报告
allure serve .\allure-results\ --clean-alluredir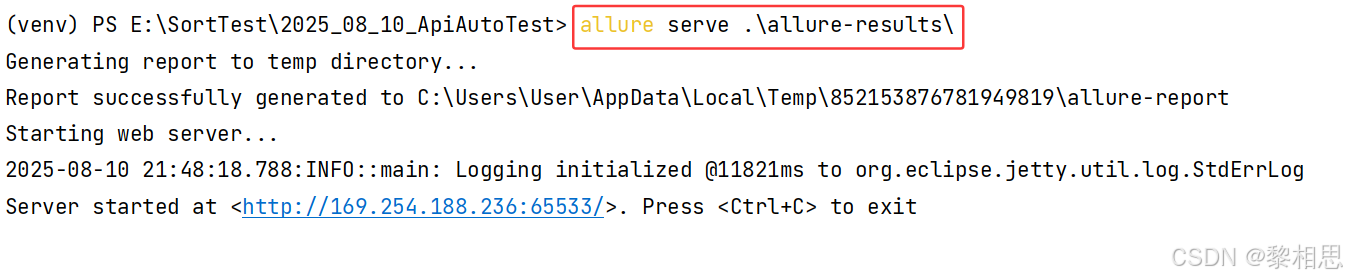
方法二:从测试结果生成测试报告
终端执行命令:allure generate [options] <allure-results> -o <reports>
示例:
allure generate .\allure-results\ -o .\allure-report --clean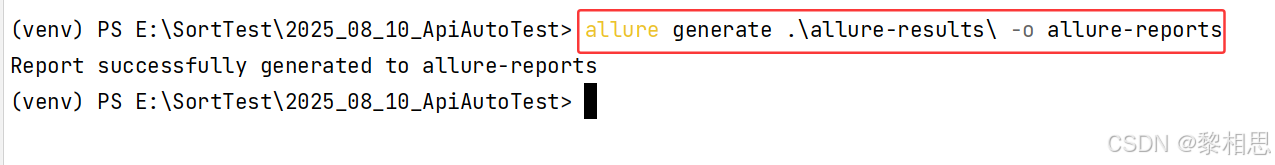
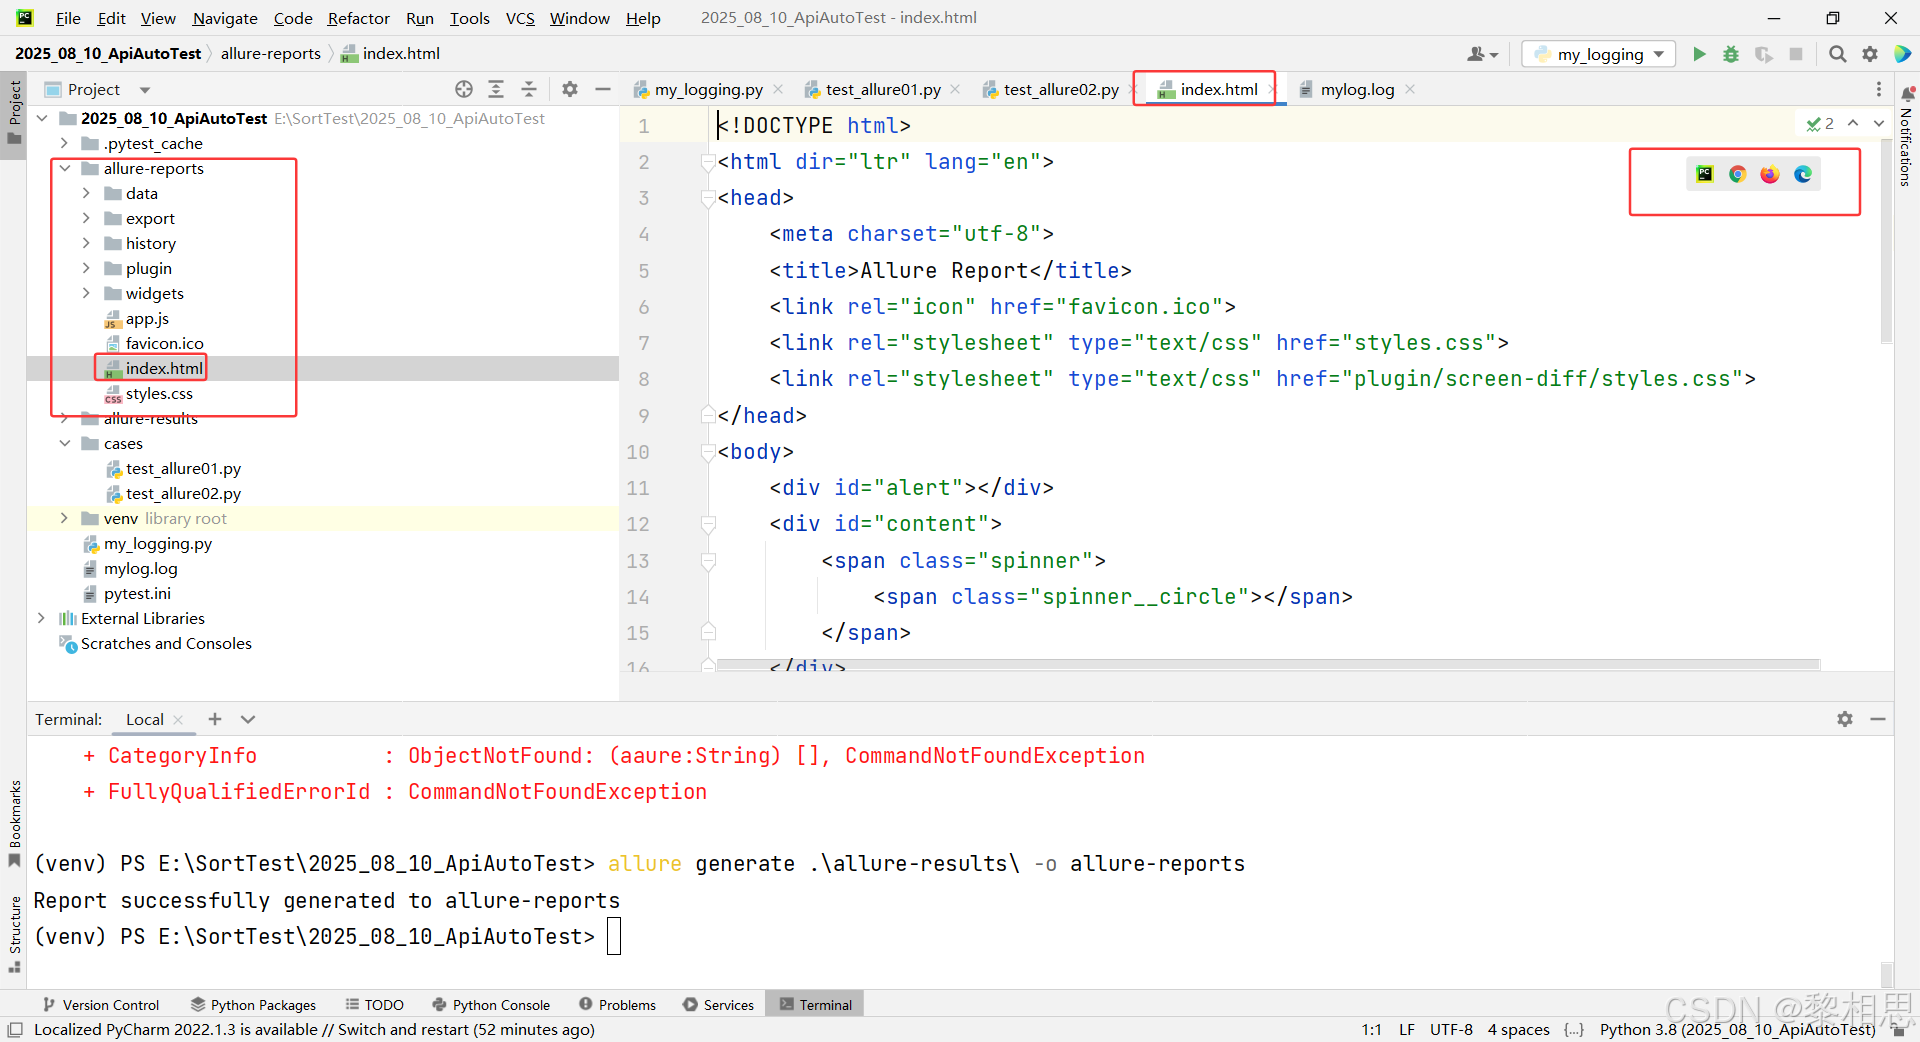
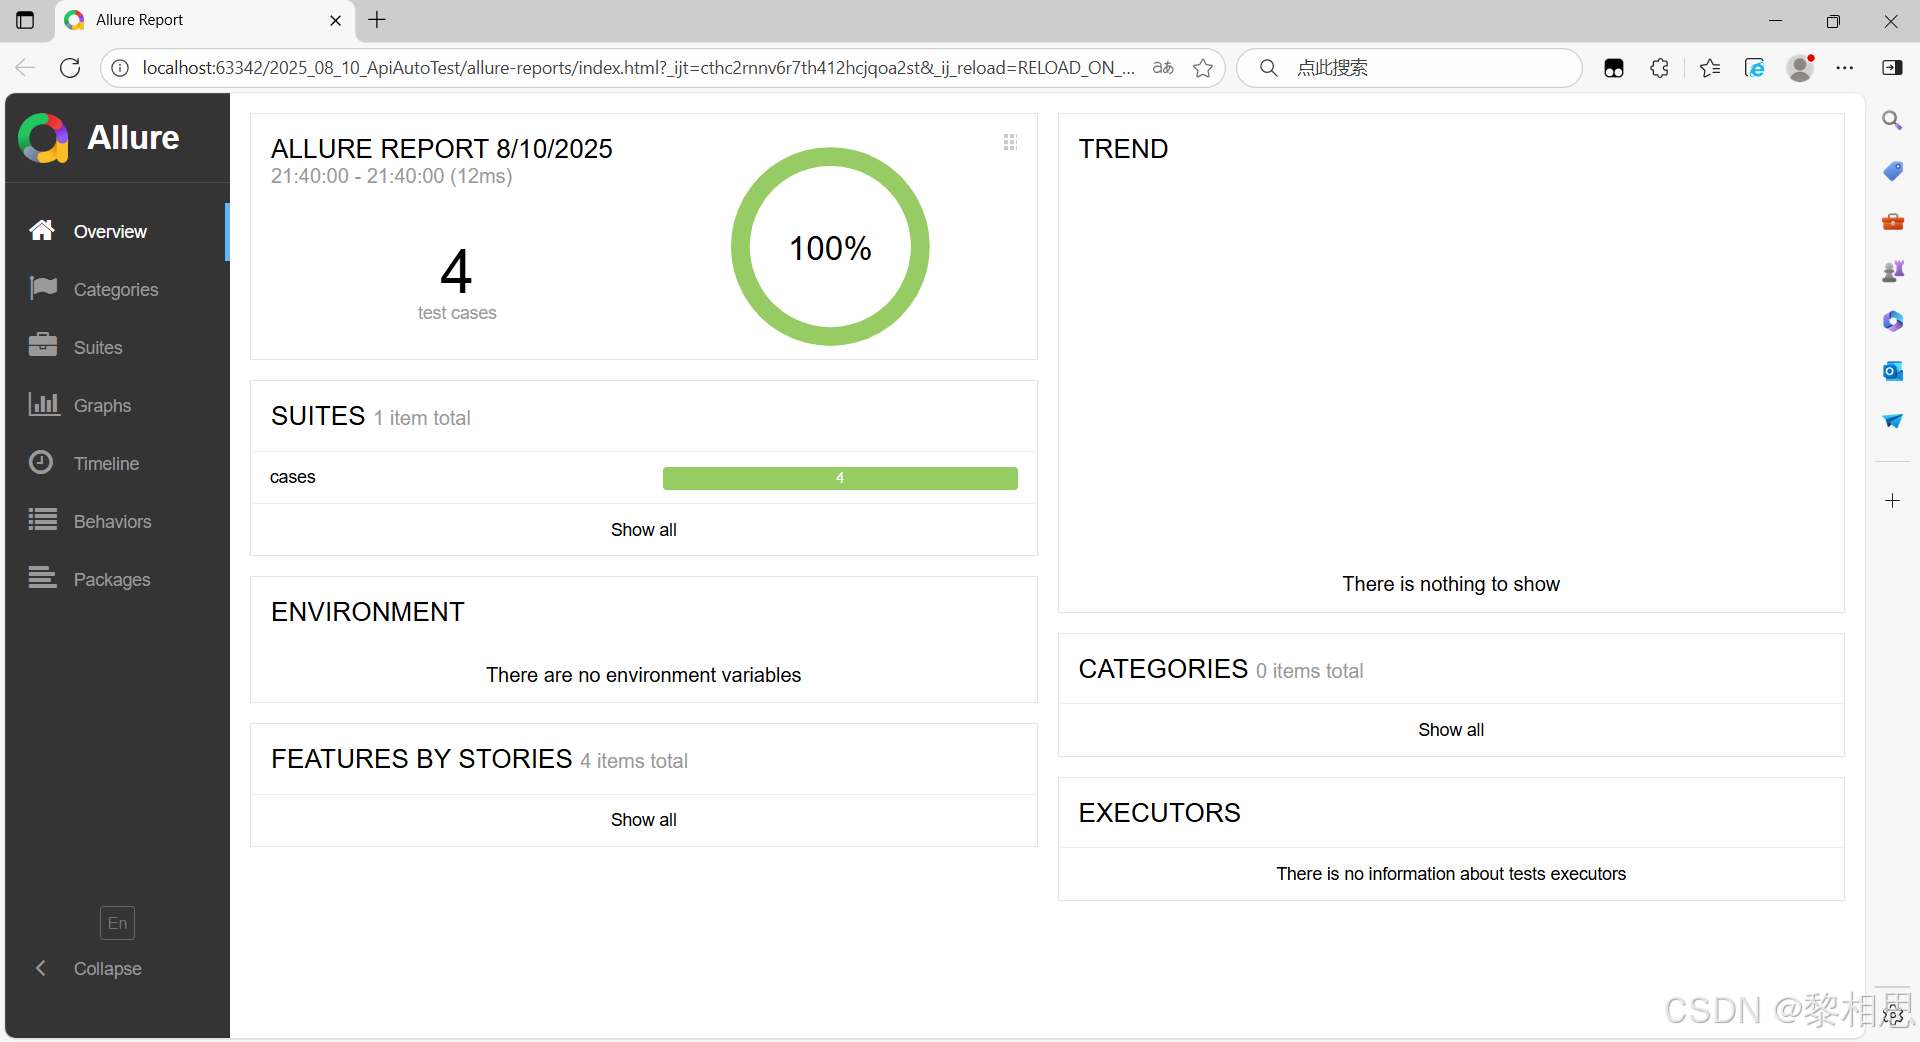
2.9.3.3 配置pytest.ini文件
生成测试报告可以在控制台通过命令将结果保存在allre-results文件夹中,也可以在pytest.ini文件中配置测试报告放置路径。
addopts = -vs --alluredir allure-results --clean-alluredir(清除历史的json文件)2.9.3.4 清除历史html文件
当我们第一次运行allure generate .\allure-results\ -o allure-reports命令生成html文件时不会出错,但是第二次运行这个命令就会出错。
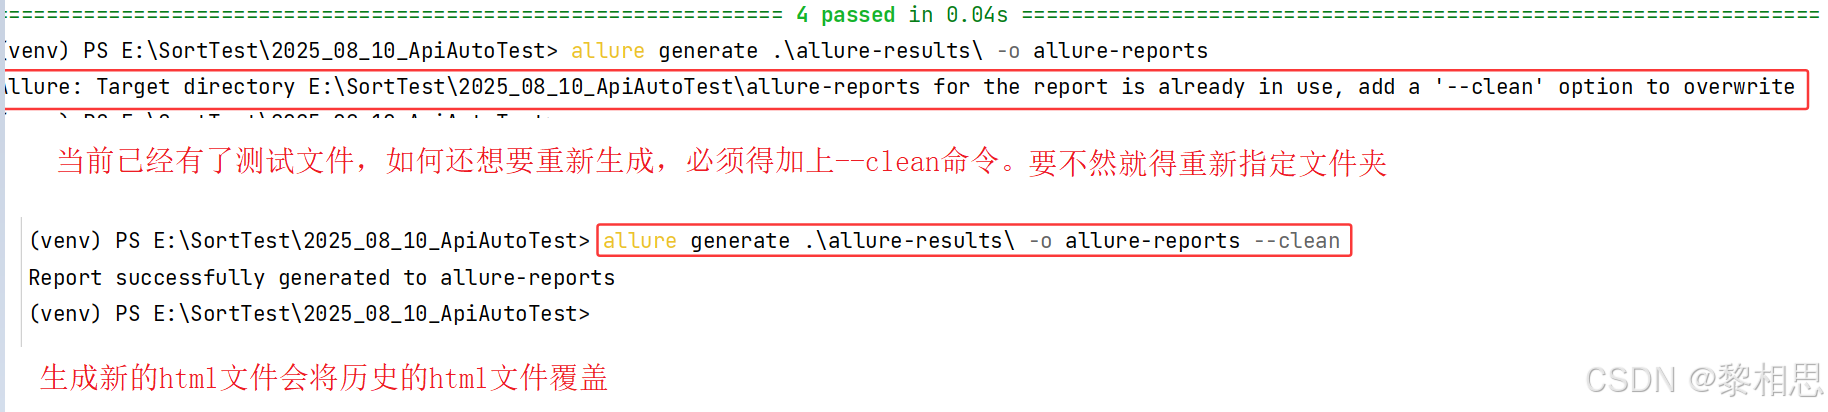
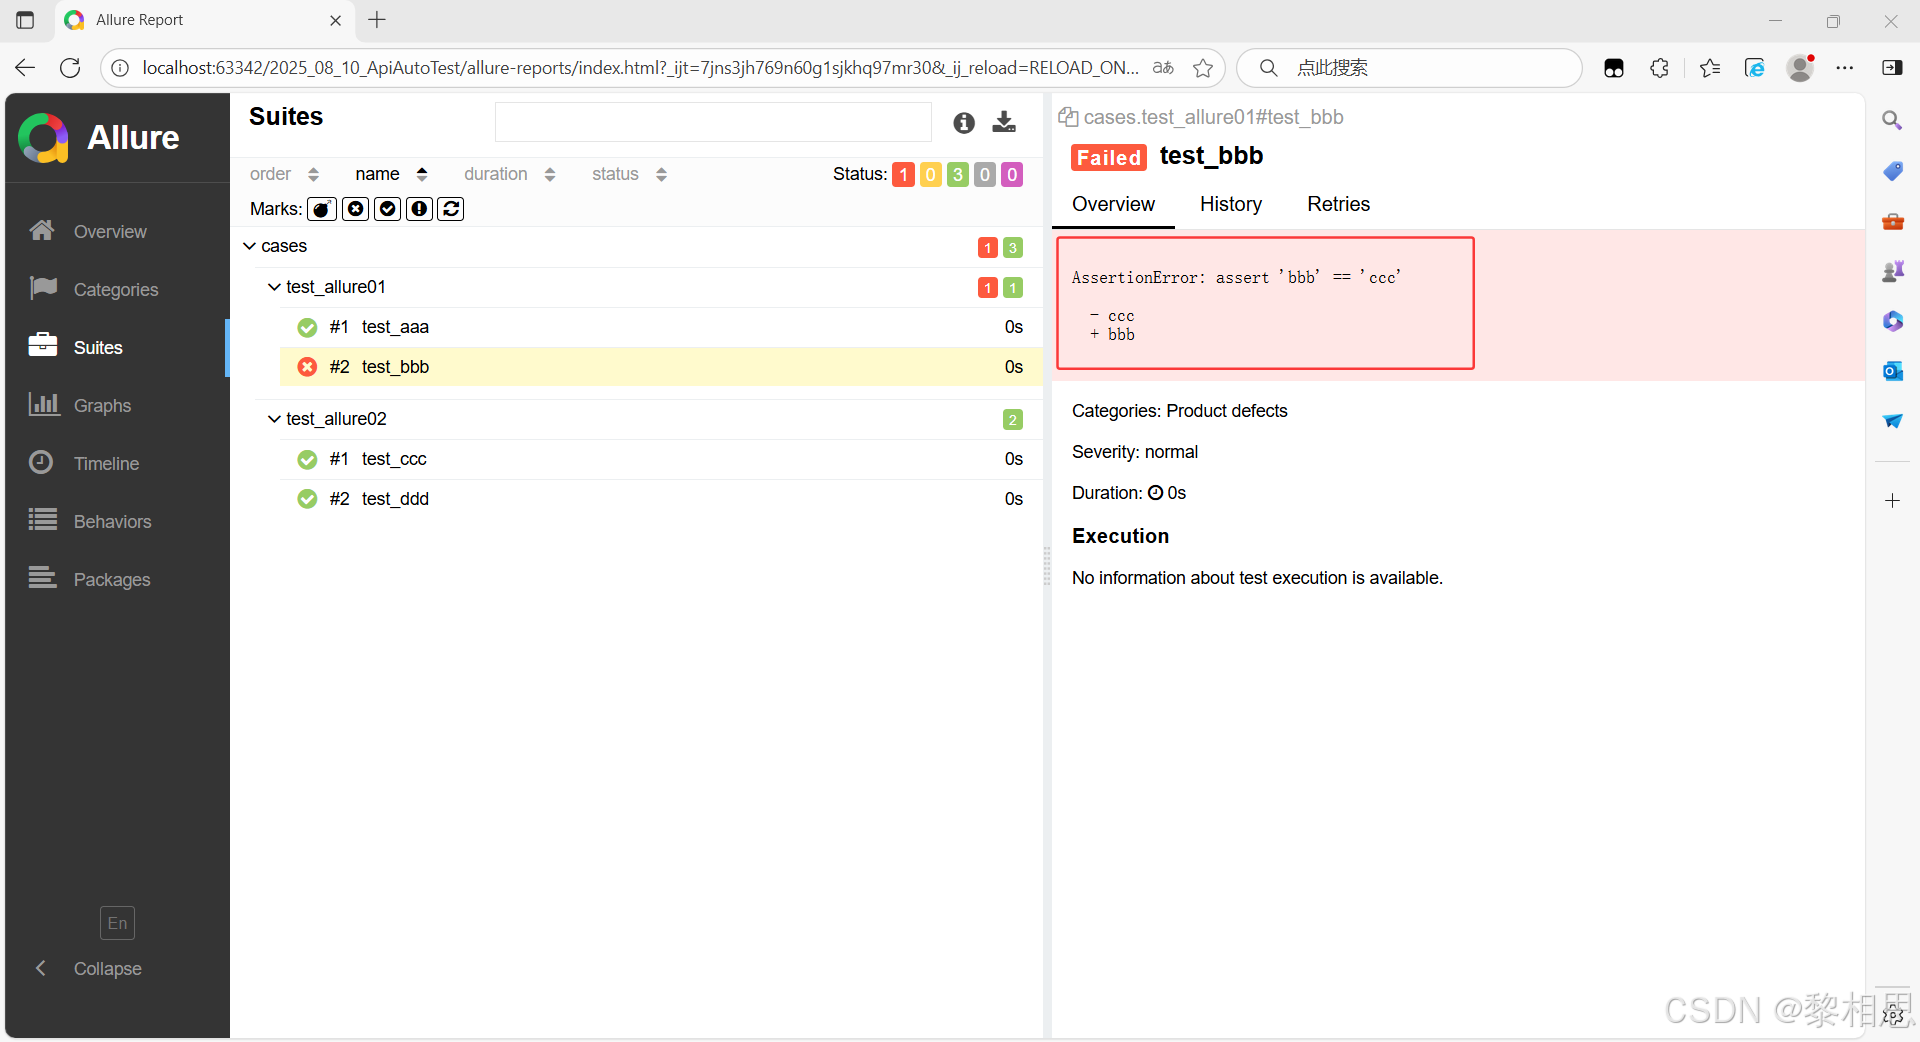
2.9.3.5 执行失败的用例
代码:
def test_aaa():
    assert "aaa" == "aaa"
def test_bbb():
    assert "bbb" == "ccc"(断言报错)
运行(生成json文件):
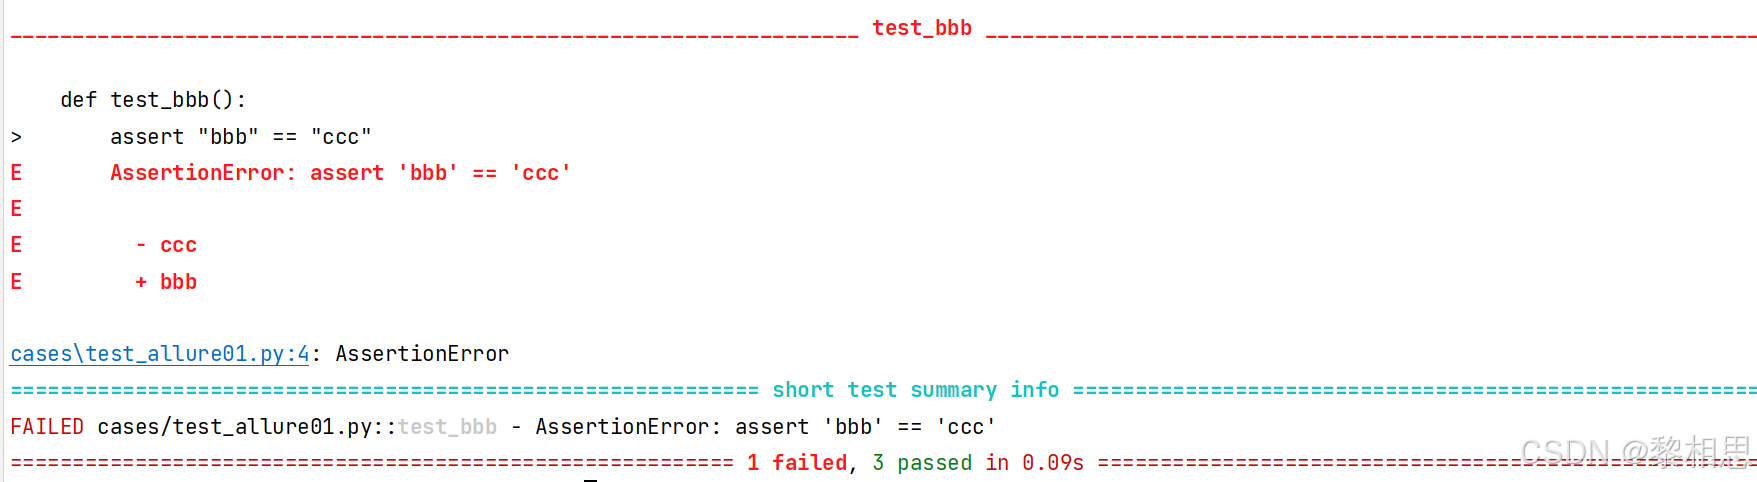
生成html文件并查看:

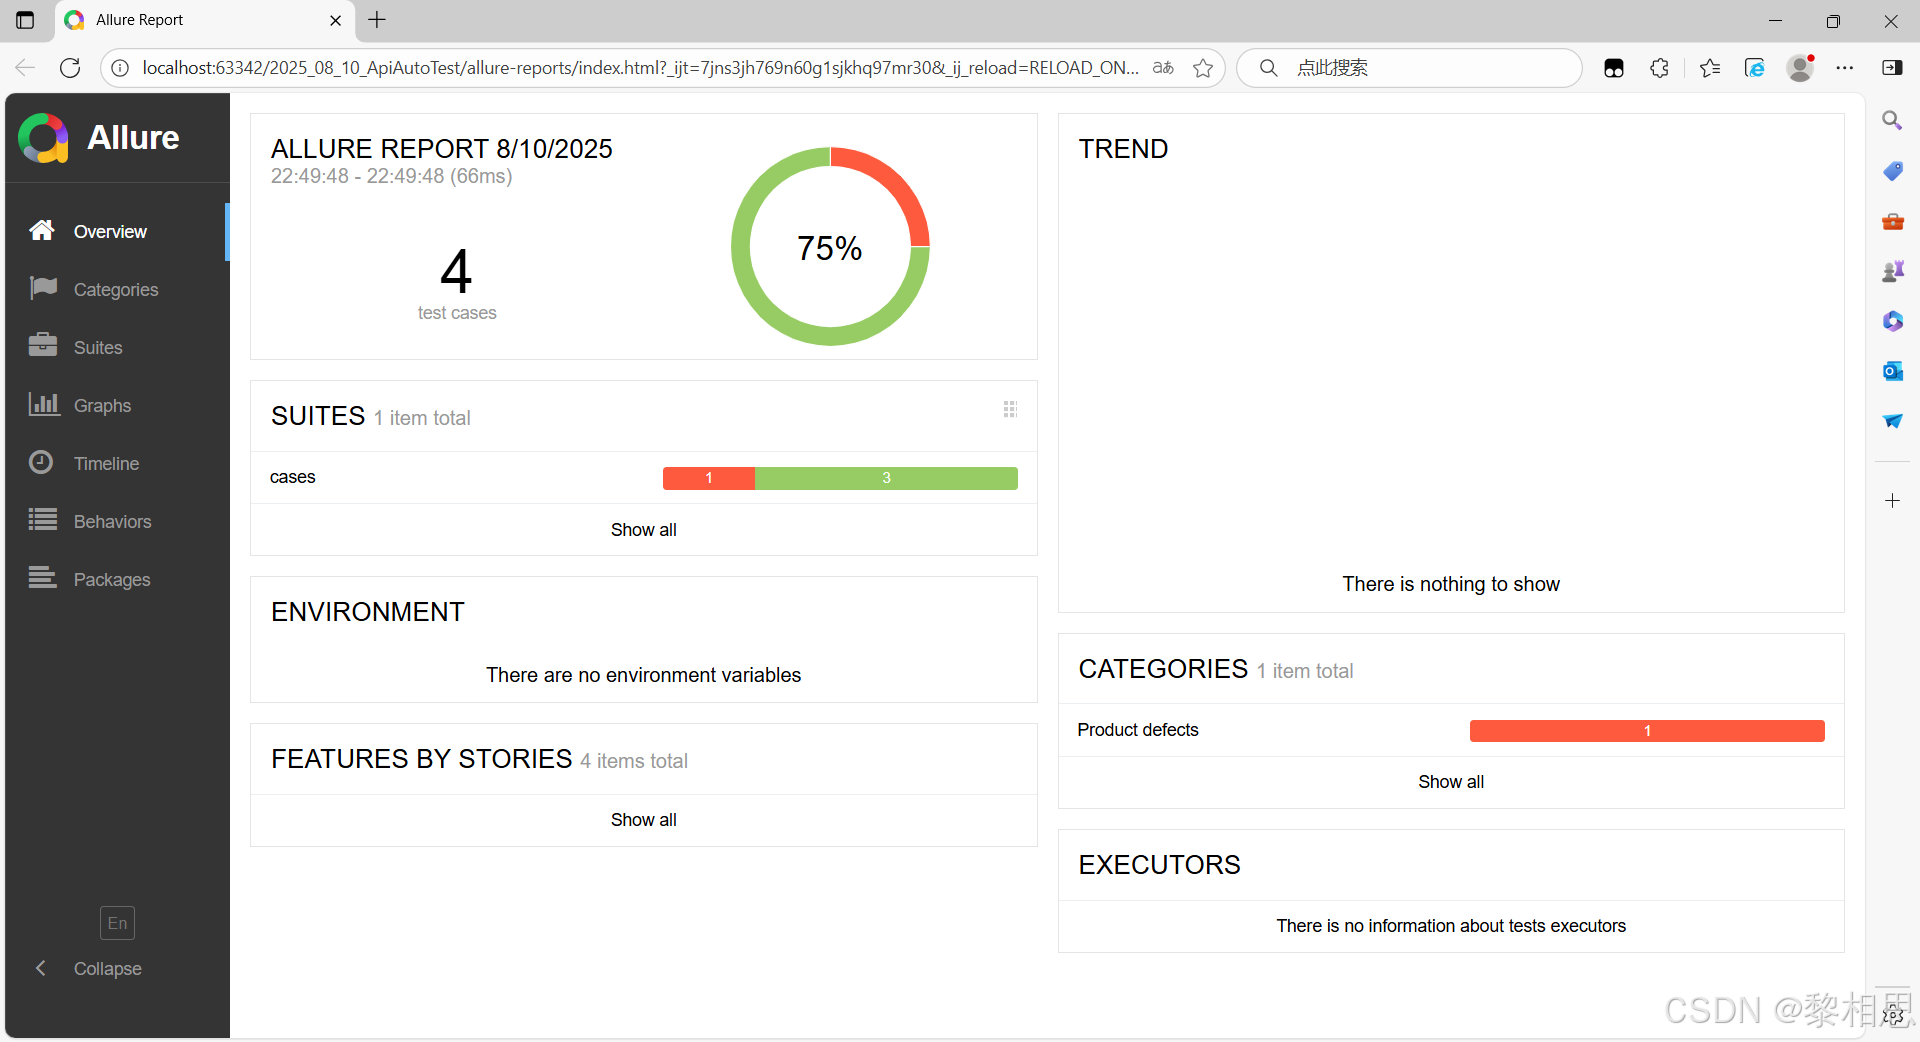
附录
Gitee地址
https://gitee.com/Axurea/test-developmenthttps://gitee.com/Axurea/test-development
笔记
代码
docker安装博客系统服务
 https://gitee.com/Axurea/test-development/blob/master/docker%E5%AE%89%E8%A3%85%E5%8D%9A%E5%AE%A2%E7%B3%BB%E7%BB%9F%E6%9C%8D%E5%8A%A1.png
更多推荐
 6
 0
- 0


 已为社区贡献2条内容

所有评论(0)