
shardingJdbc--基础--3.1--集成springboot--4版本--水平分表分库,垂直分库,公共表,读写分离
·
shardingJdbc–基础–3.1–集成springboot–4版本–水平分表分库,垂直分库,公共表,读写分离
代码位置:https://gitee.com/DanShenGuiZu/learnDemo/tree/master/Sharding-JDBC-learn
1、准备
1.1、 环境搭建
| 项目 | 版本 | 备注 |
|---|---|---|
| mysql | 5.1.47 | |
| spring-boot | 2.5.4 | |
| Sharding-JDBC | 4.0.0-RC1 | |
| mybatis-plus | 2.0.0 |
1.2、 创建数据库和表
# 创建订单库order_db
CREATE DATABASE `order_db` CHARACTER SET 'utf8' COLLATE 'utf8_general_ci';

# 在order_db中创建t_order_1、t_order_2表
DROP TABLE IF EXISTS `t_order_1`;
CREATE TABLE `t_order_1`  (
  `order_id` bigint(20) NOT NULL COMMENT '订单id',
  `price` decimal(10, 2) NOT NULL COMMENT '订单价格',
  `user_id` bigint(20) NOT NULL COMMENT '下单用户id',
  `status` varchar(50) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL COMMENT '订单状态',
  PRIMARY KEY (`order_id`) USING BTREE
) ENGINE = InnoDB CHARACTER SET = utf8 COLLATE = utf8_general_ci ROW_FORMAT = Dynamic;

DROP TABLE IF EXISTS `t_order_2`;
CREATE TABLE `t_order_2`  (
  `order_id` bigint(20) NOT NULL COMMENT '订单id',
  `price` decimal(10, 2) NOT NULL COMMENT '订单价格',
  `user_id` bigint(20) NOT NULL COMMENT '下单用户id',
  `status` varchar(50) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL COMMENT '订单状态',
  PRIMARY KEY (`order_id`) USING BTREE
) ENGINE = InnoDB CHARACTER SET = utf8 COLLATE = utf8_general_ci ROW_FORMAT = Dynamic;
1.3、代码–水平分表
包含水平分表的配置和功能
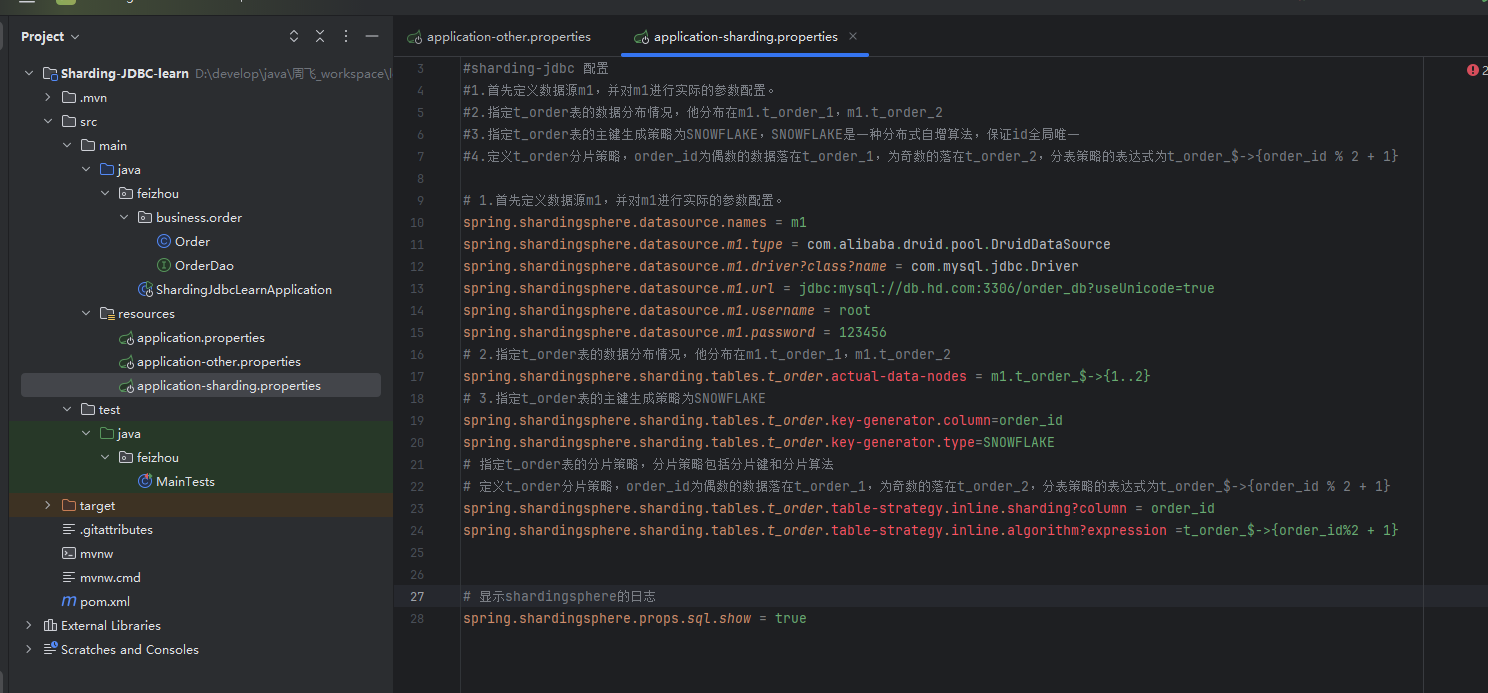
1.3.1、代码结构和位置
位置:https://gitee.com/DanShenGuiZu/learnDemo/tree/master/Sharding-JDBC-learn
1.3.2、maven配置
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>
    <parent>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-parent</artifactId>
        <version>2.5.4</version>
        <relativePath/> <!-- lookup parent from repository -->
    </parent>
    <groupId>feizhou</groupId>
    <artifactId>Sharding-JDBC-learn</artifactId>
    <version>0.0.1-SNAPSHOT</version>
    <name>Sharding-JDBC-learn</name>
    <description>Sharding-JDBC-learn</description>
    <url/>
    <licenses>
        <license/>
    </licenses>
    <developers>
        <developer/>
    </developers>
    <scm>
        <connection/>
        <developerConnection/>
        <tag/>
        <url/>
    </scm>
    <properties>
        <java.version>1.8</java.version>
    </properties>
    <dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-test</artifactId>
            <scope>test</scope>
        </dependency>

        <!--sharding-jdbc-->

        <dependency>
            <groupId>javax.interceptor</groupId>
            <artifactId>javax.interceptor-api</artifactId>
            <version>1.2</version>
        </dependency>
        <dependency>
            <groupId>mysql</groupId>
            <artifactId>mysql-connector-java</artifactId>
            <version>5.1.47</version>
        </dependency>


        <dependency>
            <groupId>org.mybatis.spring.boot</groupId>
            <artifactId>mybatis-spring-boot-starter</artifactId>
            <version>2.0.0</version>
        </dependency>
        <dependency>
            <groupId>com.alibaba</groupId>
            <artifactId>druid-spring-boot-starter</artifactId>
            <version>1.1.16</version>
        </dependency>
        <dependency>
            <groupId>org.apache.shardingsphere</groupId>
            <artifactId>sharding-jdbc-spring-boot-starter</artifactId>
            <version>4.0.0-RC1</version>
        </dependency>
        <dependency>
            <groupId>com.baomidou</groupId>
            <artifactId>mybatis-plus-boot-starter</artifactId>
            <version>3.1.0</version>
        </dependency>
        <dependency>
            <groupId>com.baomidou</groupId>
            <artifactId>mybatis-plus-generator</artifactId>
            <version>3.1.0</version>
        </dependency>
        <dependency>
            <groupId>org.mybatis</groupId>
            <artifactId>mybatis-typehandlers-jsr310</artifactId>
            <version>1.0.2</version>
        </dependency>

        <!--lombok依赖,是为了简化实体类的编写代码量-->
        <dependency>
            <groupId>org.projectlombok</groupId>
            <artifactId>lombok</artifactId>
        </dependency>

    </dependencies>

    <build>
        <plugins>
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maven-plugin</artifactId>
            </plugin>
        </plugins>
    </build>


</project>
1.3.3、核心代码
OrderDao
@Mapper
@Component
public interface OrderDao {
    /**
     * 新增订单
     * @param price 订单价格
     * @param userId 用户id
     * @param status 订单状态
     * @return
     */
    @Insert("insert into t_order(price,user_id,status) value(#{price},#{userId},#{status})")
    int insertOrder(@Param("price") BigDecimal price, @Param("userId")Long userId,
                    @Param("status")String status);
    /**
     * 根据id列表查询多个订单
     * @param orderIds 订单id列表
     * @return
     */
    @Select({"<script>" +
            "select " +
            " * " +
            " from t_order t" +
            " where t.order_id in " +
            "<foreach collection='orderIds' item='id' open='(' separator=',' close=')'>" +
            " #{id} " +
            "</foreach>"+
            "</script>"})
    List<Map> selectOrderbyIds(@Param("orderIds") List<Long> orderIds);
}
Order
@Data
public class Order implements Serializable {
    private static final long serialVersionUID = 849675519182821942L;
    /**
     * 订单id
     */
    private Long orderId;
    /**
     * 订单价格
     */
    private Double price;
    /**
     * 下单用户id
     */
    private Long userId;
    /**
     * 订单状态
     */
    private String status;


}
application-sharding.properties
#sharding-jdbc 配置
#1.首先定义数据源m1,并对m1进行实际的参数配置。
#2.指定t_order表的数据分布情况,他分布在m1.t_order_1,m1.t_order_2
#3.指定t_order表的主键生成策略为SNOWFLAKE,SNOWFLAKE是一种分布式自增算法,保证id全局唯一
#4.定义t_order分片策略,order_id为偶数的数据落在t_order_1,为奇数的落在t_order_2,分表策略的表达式为t_order_$->{order_id % 2 + 1}

# 1.首先定义数据源m1,并对m1进行实际的参数配置。
spring.shardingsphere.datasource.names = m1
spring.shardingsphere.datasource.m1.type = com.alibaba.druid.pool.DruidDataSource
spring.shardingsphere.datasource.m1.driver?class?name = com.mysql.jdbc.Driver
spring.shardingsphere.datasource.m1.url = jdbc:mysql://db.hd.com:3306/order_db?useUnicode=true
spring.shardingsphere.datasource.m1.username = xxxx
spring.shardingsphere.datasource.m1.password = xxxx
# 2.指定t_order表的数据分布情况,他分布在m1.t_order_1,m1.t_order_2
spring.shardingsphere.sharding.tables.t_order.actual‐data‐nodes = m1.t_order_$->{1..2}
# 3.指定t_order表的主键生成策略为SNOWFLAKE
spring.shardingsphere.sharding.tables.t_order.key‐generator.column=order_id
spring.shardingsphere.sharding.tables.t_order.key‐generator.type=SNOWFLAKE
# 指定t_order表的分片策略,分片策略包括分片键和分片算法
# 定义t_order分片策略,order_id为偶数的数据落在t_order_1,为奇数的落在t_order_2,分表策略的表达式为t_order_$->{order_id % 2 + 1}
spring.shardingsphere.sharding.tables.t_order.table‐strategy.inline.sharding?column = order_id
spring.shardingsphere.sharding.tables.t_order.table‐strategy.inline.algorithm?expression =t_order_$->{order_id%2 + 1}


# 显示shardingsphere的日志
spring.shardingsphere.props.sql.show = true
MainTests
@SpringBootTest
class MainTests {

    @Resource
    private OrderDao orderDao;
    @Test
    void contextLoads() {
        System.out.println(1111);
    }
    /**
     *
     * 测试水平分表
     * order_id为偶数的数据落在t_order_1表
     * order_id为奇数的数据落在t_order_2表
     */
    @Test
    public void insertOrder(){
        for (int i = 0 ; i<10; i++){
            orderDao.insertOrder(new BigDecimal((i+1)*5),1L,"WAIT_PAY");
        }
    }


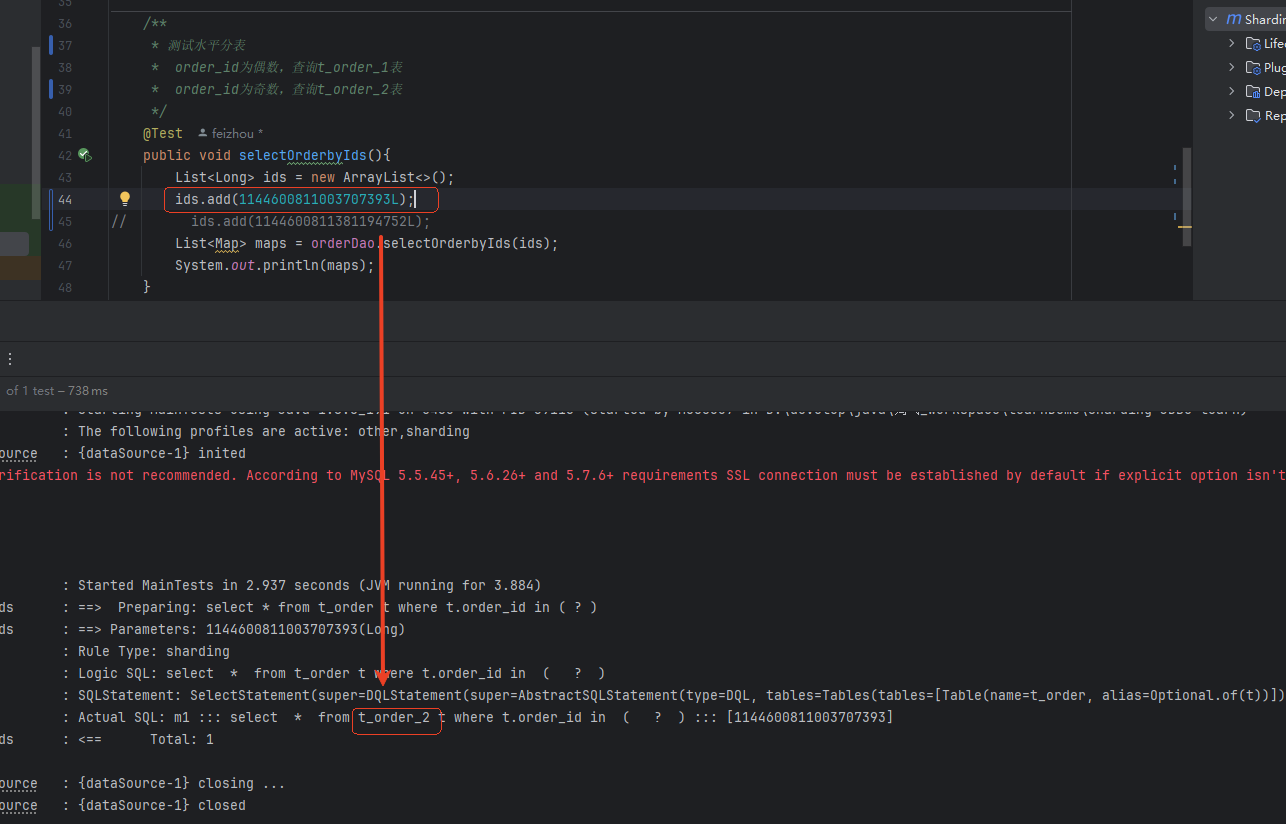
    /**
     *  测试水平分表
     *  order_id为偶数,查询t_order_1表
     *  order_id为奇数,查询t_order_2表
     */
    @Test
    public void selectOrderbyIds(){
        List<Long> ids = new ArrayList<>();
        ids.add(373771636085620736L);
        ids.add(373771635804602369L);
        List<Map> maps = orderDao.selectOrderbyIds(ids);
        System.out.println(maps);
    }

}
2、 水平分表测试
order_id为偶数的数据落在t_order_1表
order_id为奇数的数据落在t_order_2表
2.1、插入测试
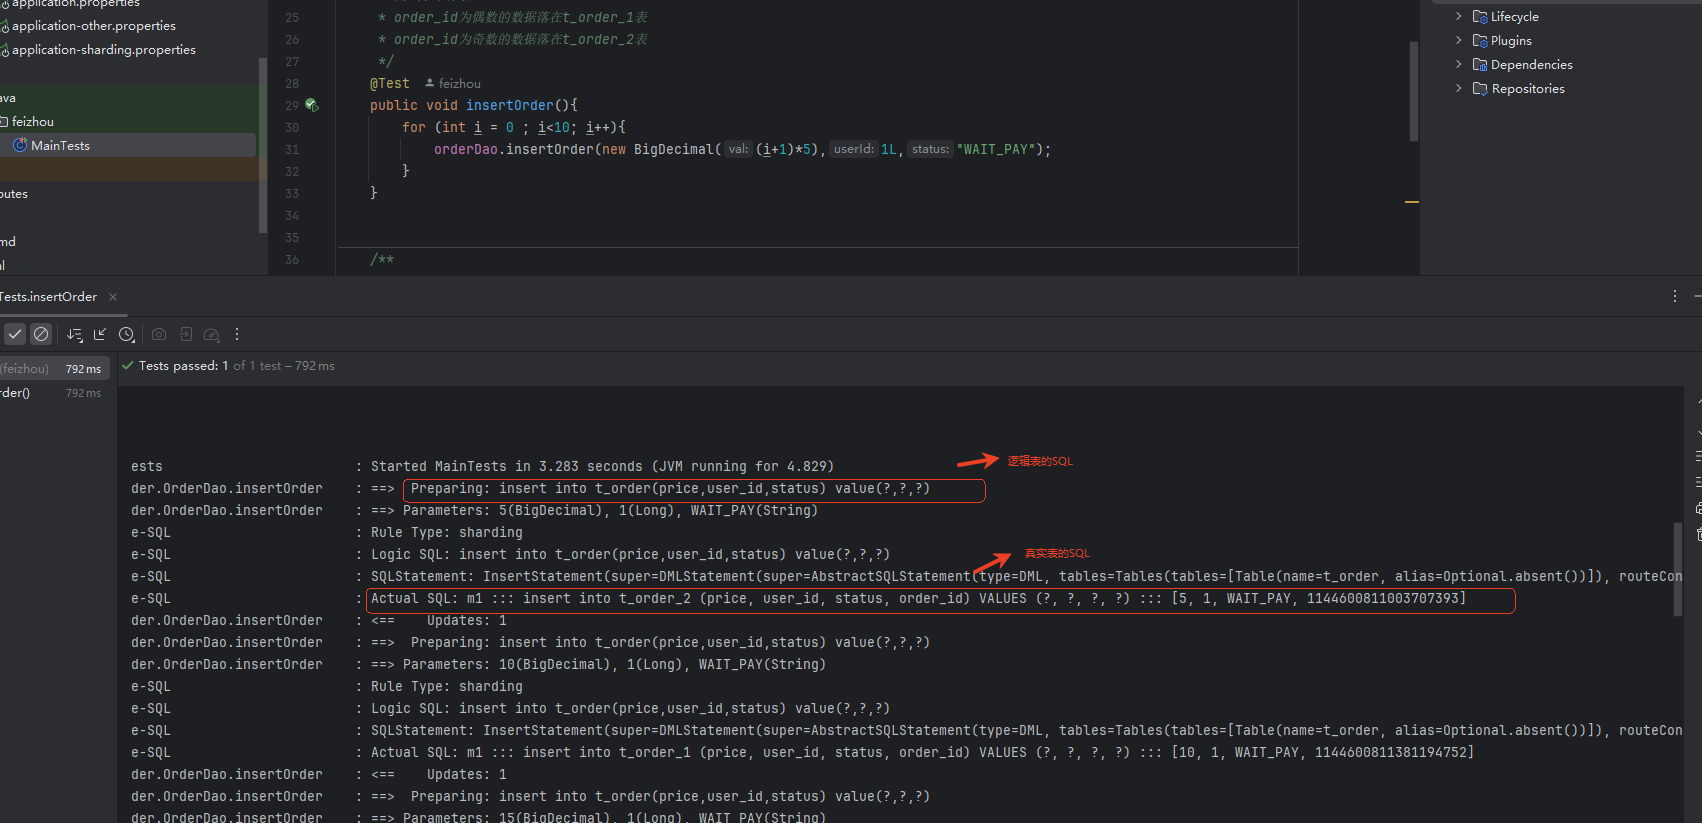
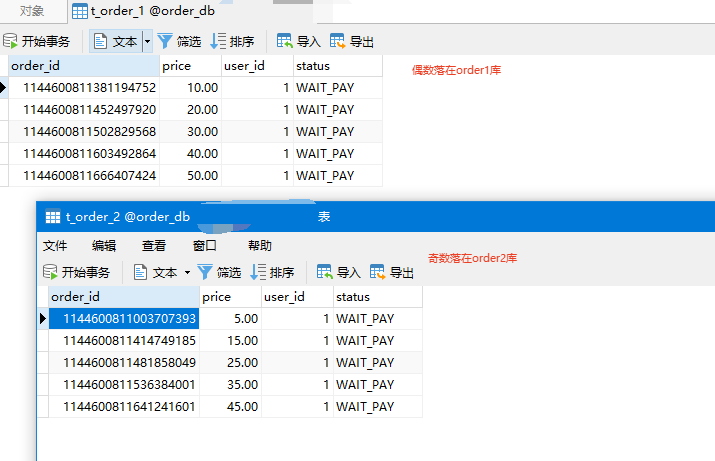
分析
Sharding-JDBC在拿到sql之后干了哪些事儿
- 解析sql,获取片键值,在本例中是order_id
- Sharding-JDBC通过规则配置 t_order_$->{order_id % 2 + 1},知道了当order_id为偶数时,应该往t_order_1表插数据,为奇数时,往t_order_2插数据。
- 于是Sharding-JDBC根据order_id的值改写sql语句,改写后的SQL语句是真实所要执行的SQL语句。
- 执行改写后的真实sql语句
- 将所有真正执行sql的结果进行汇总合并,返回。
2.2、查询测试
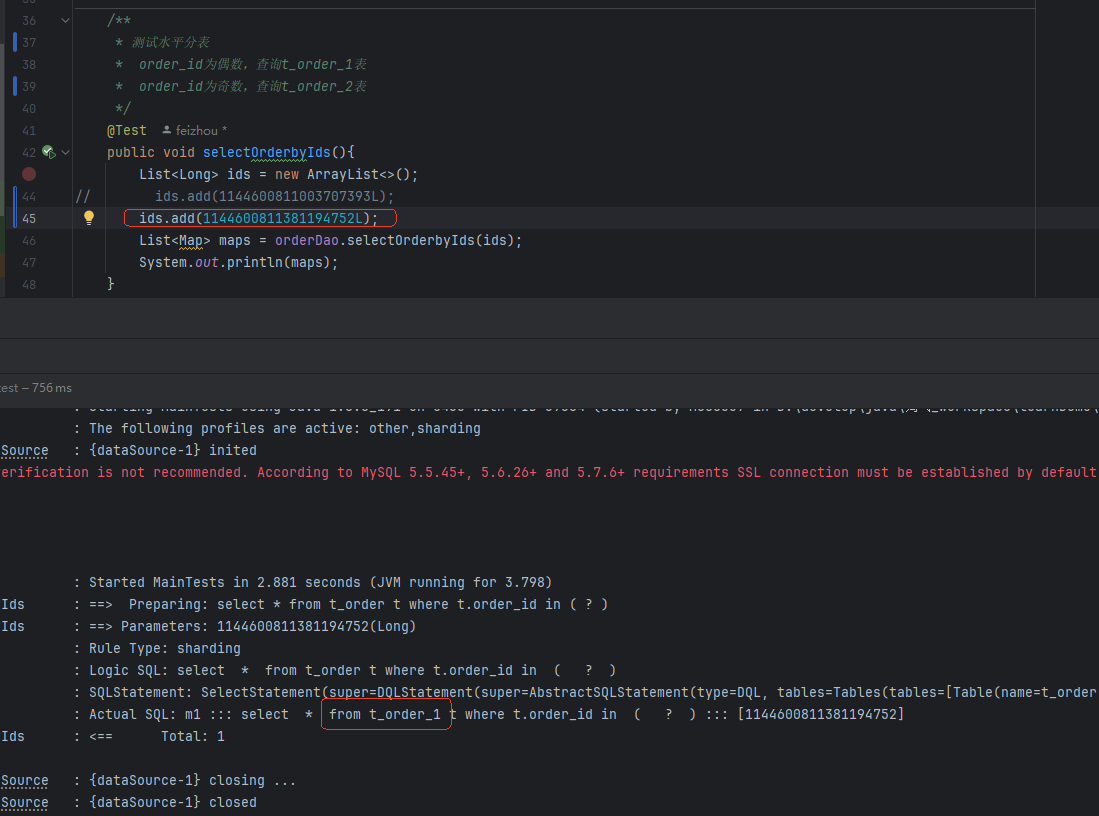
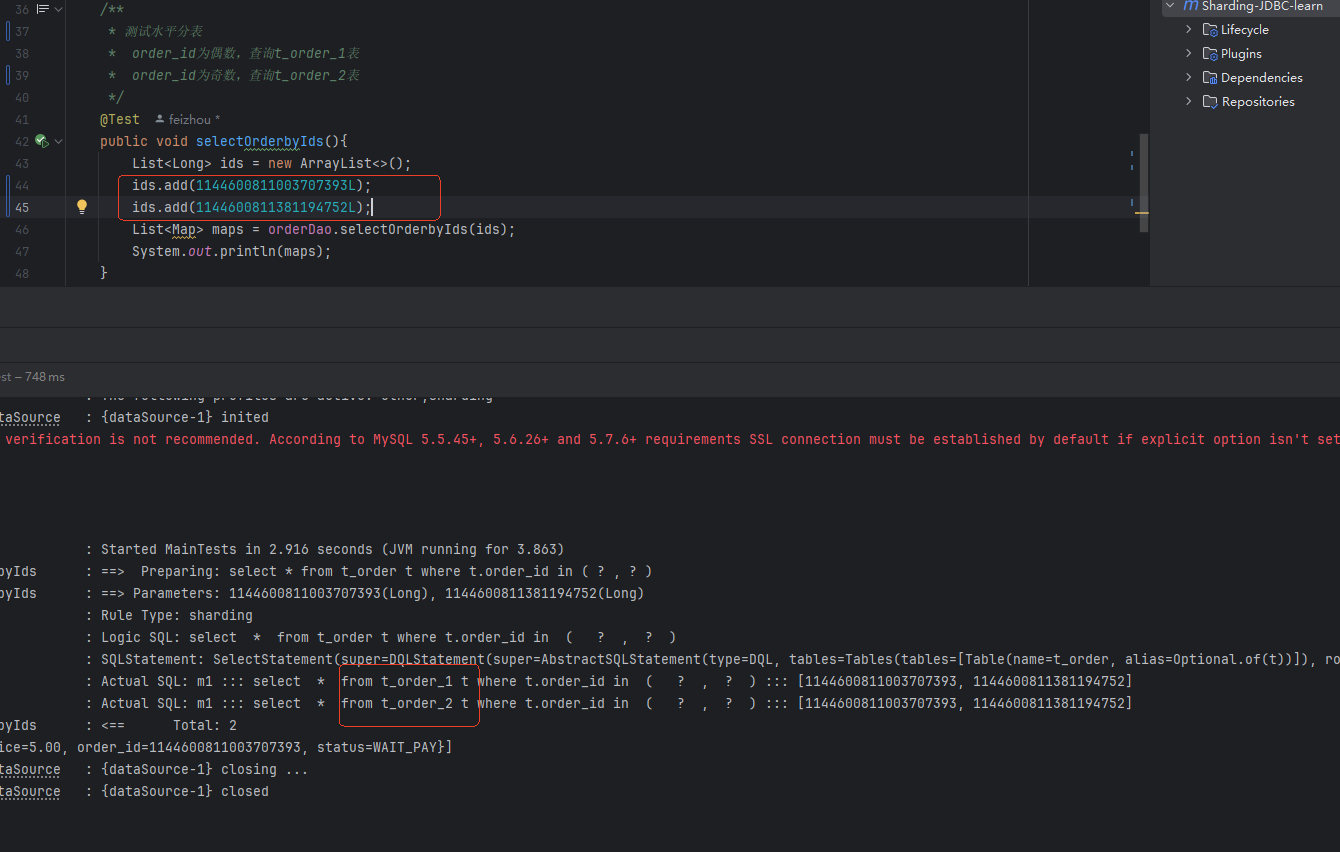
3、水平分库
通过分片键,将数据插入order_db_1和order_db_2库中的对应表
3.1、准备
3.1.1、创建库和表
# 创建2个库
CREATE DATABASE `order_db_1` CHARACTER SET 'utf8' COLLATE 'utf8_general_ci';
CREATE DATABASE `order_db_2` CHARACTER SET 'utf8' COLLATE 'utf8_general_ci';

# 分别在以上2个库中创建2个表
DROP TABLE IF EXISTS `t_order_1`;
CREATE TABLE `t_order_1` (
`order_id` bigint(20) NOT NULL COMMENT '订单id',
`price` decimal(10, 2) NOT NULL COMMENT '订单价格',
`user_id` bigint(20) NOT NULL COMMENT '下单用户id',
`status` varchar(50) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL COMMENT '订单状态',
PRIMARY KEY (`order_id`) USING BTREE
) ENGINE = InnoDB CHARACTER SET = utf8 COLLATE = utf8_general_ci ROW_FORMAT = Dynamic;

DROP TABLE IF EXISTS `t_order_2`;
CREATE TABLE `t_order_2` (
`order_id` bigint(20) NOT NULL COMMENT '订单id',
`price` decimal(10, 2) NOT NULL COMMENT '订单价格',
`user_id` bigint(20) NOT NULL COMMENT '下单用户id',
`status` varchar(50) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL COMMENT '订单状态',
PRIMARY KEY (`order_id`) USING BTREE
) ENGINE = InnoDB CHARACTER SET = utf8 COLLATE = utf8_general_ci ROW_FORMAT = Dynamic;
3.2、了解分片策略
3.2.1、分片策略定义方式
# 分库策略,如何将一个逻辑表映射到多个数据源
spring.shardingsphere.sharding.tables.<逻辑表名称>.database-strategy.<分片策略>.<分片策略属性名>= #分片策略属性值

# 分表策略,如何将一个逻辑表映射为多个实际表
spring.shardingsphere.sharding.tables.<逻辑表名称>.table-strategy.<分片策略>.<分片策略属性名>= #分片策略属性值
3.2.2、Sharding-JDBC自带几种分片策略
3.2.2.1、standard(标准分片策略)
- 对应类: StandardShardingStrategy
- 支持操作:提供对 SQL 语句中的
=, IN, BETWEEN AND的分片操作 - 分片键数量:只支持单分片键
- 算法/特点:
- PreciseShardingAlgorithm(必选):处理
=, IN分片 - RangeShardingAlgorithm(可选):处理
BETWEEN AND分片,如果不配置,SQL中的BETWEEN AND将按照全库路由处理。
- PreciseShardingAlgorithm(必选):处理
3.2.2.2、complex(复合分片策略)
- 对应类:ComplexShardingStrategy
- 支持操作:提供对 SQL 语句中的
=, IN, BETWEEN AND的分片操作 - 分片键数量:支持多分片键
- 由于多分片键之间的关系复杂,因此并未进行过多的封装,而是直接将分片键值组合以及分片操作符透传至分片算法,完全由应用开发者实现,提供最大的灵活度。
3.2.2.3、inline(行表达式分片策略)
- 对应类:InlineShardingStrategy
- 支持操作:提供对SQL语句中的
= , IN的分片操作 - 分片键数量:只支持单分片键
- 算法/特点:
- 使用 Groovy 表达式
- 适用于简单分片算法
- 示例:
t_user_$->{u_id % 8}表示根据 u_id 模 8 分成 8 张表(t_user_0 到 t_user_7)
3.2.2.4、hint(Hint 分片策略)
- 对应类:HintShardingStrategy
- 算法/特点:
- 通过 Hint 而非 SQL 解析的方式分片
- 适用于分片字段非 SQL 决定,而由其他外置条件决定的场景
- 可通过 Java API 和 SQL 注释(待实现)两种方式使用
- 示例:内部系统按照员工登录主键分库,而数据库中无此字段
3.2.2.5、none(不分片策略)
- 对应类:对应 NoneShardingStrategy
- 不分片的策略
3.3、代码
application-sharding2.properties
创建分片策略配置文件
#sharding-jdbc分片规则配置
#数据源
spring.shardingsphere.datasource.names = m1,m2

spring.shardingsphere.datasource.m1.type = com.alibaba.druid.pool.DruidDataSource
spring.shardingsphere.datasource.m1.driver-class-name = com.mysql.jdbc.Driver
spring.shardingsphere.datasource.m1.url = jdbc:mysql://zhoufei.db.com:3307/order_db_1?useUnicode=true
spring.shardingsphere.datasource.m1.username = root
spring.shardingsphere.datasource.m1.password = root
spring.shardingsphere.datasource.m2.type = com.alibaba.druid.pool.DruidDataSource
spring.shardingsphere.datasource.m2.driver-class-name = com.mysql.jdbc.Driver
spring.shardingsphere.datasource.m2.url = jdbc:mysql://zhoufei.db.com:3307/order_db_2?useUnicode=true
spring.shardingsphere.datasource.m2.username = root
spring.shardingsphere.datasource.m2.password = root


# 分库策略,以user_id为分片键,分片策略为user_id % 2 + 1,user_id为偶数操作m1数据源,否则操作m2。
spring.shardingsphere.sharding.tables.t_order.database-strategy.inline.sharding-column = user_id
spring.shardingsphere.sharding.tables.t_order.database-strategy.inline.algorithm-expression = m$->{user_id % 2 + 1}


# 指定t_order表的数据分布情况,配置数据节点如下
# m1.t_order_1
# m1.t_order_2

# m2.t_order_1
# m2.t_order_2
# 如果这里配置如m1.t_order_$->{1..2},则查询时只会查询m1库的表
spring.shardingsphere.sharding.tables.t_order.actual-data-nodes = m$->{1..2}.t_order_$->{1..2}

# 指定t_order表的主键生成策略为SNOWFLAKE
spring.shardingsphere.sharding.tables.t_order.key-generator.column=order_id
spring.shardingsphere.sharding.tables.t_order.key-generator.type=SNOWFLAKE

# 指定t_order表的分片策略,分片策略包括分片键和分片算法
spring.shardingsphere.sharding.tables.t_order.table-strategy.inline.sharding-column = order_id
spring.shardingsphere.sharding.tables.t_order.table-strategy.inline.algorithm-expression = t_order_$->{order_id % 2 + 1}


# 打开sql输出日志
spring.shardingsphere.props.sql.show = true
OrderDao
package feizhou.business.order;

import org.apache.ibatis.annotations.Insert;
import org.apache.ibatis.annotations.Mapper;
import org.apache.ibatis.annotations.Param;
import org.apache.ibatis.annotations.Select;
import org.springframework.stereotype.Component;

import java.math.BigDecimal;
import java.util.List;
import java.util.Map;

@Mapper
@Component
public interface OrderDao {
    /**
     * 新增订单
     * @param price 订单价格
     * @param userId 用户id
     * @param status 订单状态
     * @return
     */
    @Insert("insert into t_order(price,user_id,status) value(#{price},#{userId},#{status})")
    int insertOrder(@Param("price") BigDecimal price, @Param("userId")Long userId,
                    @Param("status")String status);
    /**
     * 根据id列表查询多个订单
     * @param orderIds 订单id列表
     * @return
     */
    @Select({"<script>" +
            "select " +
            " * " +
            " from t_order t" +
            " where t.order_id in " +
            "<foreach collection='orderIds' item='id' open='(' separator=',' close=')'>" +
            " #{id} " +
            "</foreach>"+
            "</script>"})
    List<Map> selectOrderbyIds(@Param("orderIds") List<Long> orderIds);


    /**
     * 根据id列表和用户id查询订单
     * @param orderIds
     * @return
     */
    @Select("<script>" +
            "select" +
            " * " +
            " from t_order t " +
            " where t.order_id in " +
            " <foreach collection='orderIds' open='(' separator=',' close=')' item='id'>" +
            " #{id} " +
            " </foreach>" +
            " and user_id = #{userId} " +
            "</script>")
    List<Map> selectOrderbyUserAndIds(@Param("userId") Long userId,@Param("orderIds") List<Long> orderIds);
}
MainTests
  /**
     *
     * 分库策略
     * 以user_id为分片键,分片策略为user_id % 2 + 1,user_id为偶数操作m1数据源,否则操作m2。
     *
     * 分表策略
     * order_id为偶数的数据落在t_order_1表
     * order_id为奇数的数据落在t_order_2表
     */
    @Test
    public void insertOrder2(){
     orderDao.insertOrder(new BigDecimal(1),Long.valueOf(1),"WAIT_PAY");

        for (int i = 0 ; i<10; i++){
            //userId为奇数时插入到sharding_db_2
            orderDao.insertOrder(new BigDecimal((i+1)*5),1L,"WAIT_PAY");
        }
        for (int i = 0 ; i<10; i++){
            ///userId为偶数时插入到sharding_db_1
            orderDao.insertOrder(new BigDecimal((i+1)*10),2L,"WAIT_PAY");
        }
    }
    /**
     *
     * 使用分库分片键查询测试
     *
     * 分库策略
     * 以user_id为分片键,分片策略为user_id % 2 + 1,user_id为偶数操作m1数据源,否则操作m2。
     *
     * 分表策略
     * order_id为偶数的数据落在t_order_1表
     * order_id为奇数的数据落在t_order_2表
     */
    @Test
    public void selectOrderbyUserAndIds(){

        List<Long> ids = new ArrayList<>();
        ids.add(1037479531180457984L);
        ids.add(1037479530777804801L);

//        //user_id为偶数操作m1数据源,order_id为偶数的数据落在t_order_1表
//        List<Map> maps = orderDao.selectOrderbyUserAndIds(2L,ids);

        //user_id为偶数操作m1数据源,order_id包含奇数和偶数,会查t_order_1、t_order_2表
//        List<Map> maps = orderDao.selectOrderbyUserAndIds(2L,ids);

        //user_id为奇数操作m2数据源,order_id包含奇数和偶数,会查t_order_1、t_order_2表
        List<Map> maps = orderDao.selectOrderbyUserAndIds(1L,ids);

    }
3.4、插入测试
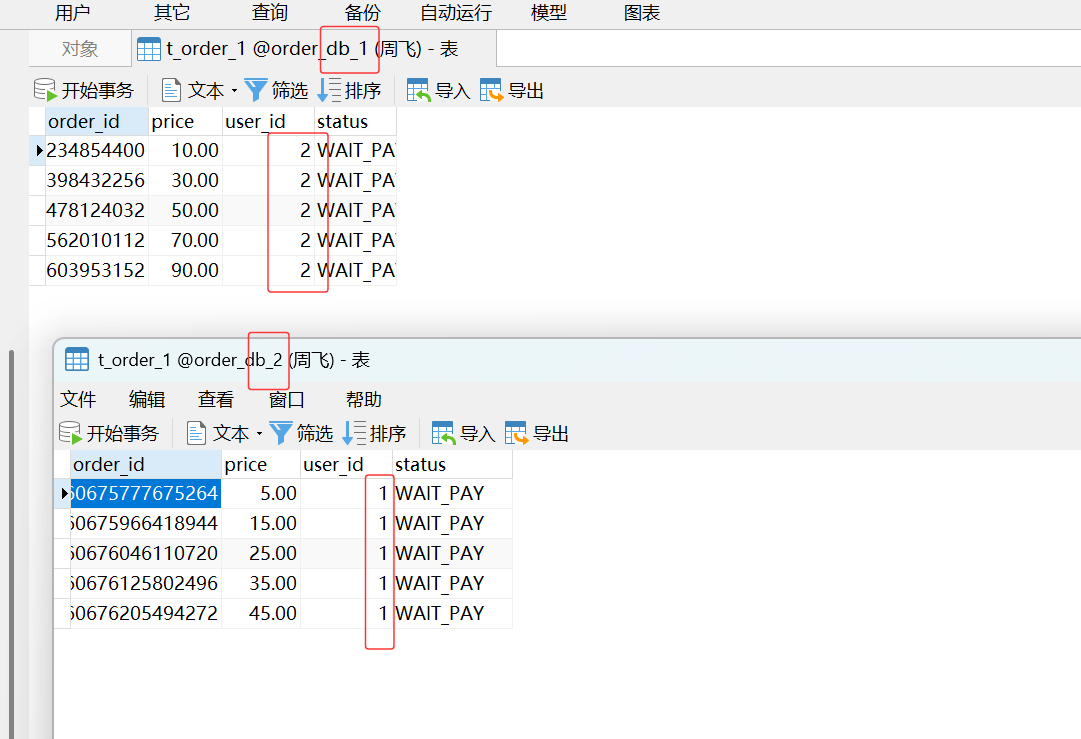
3.5、查询测试
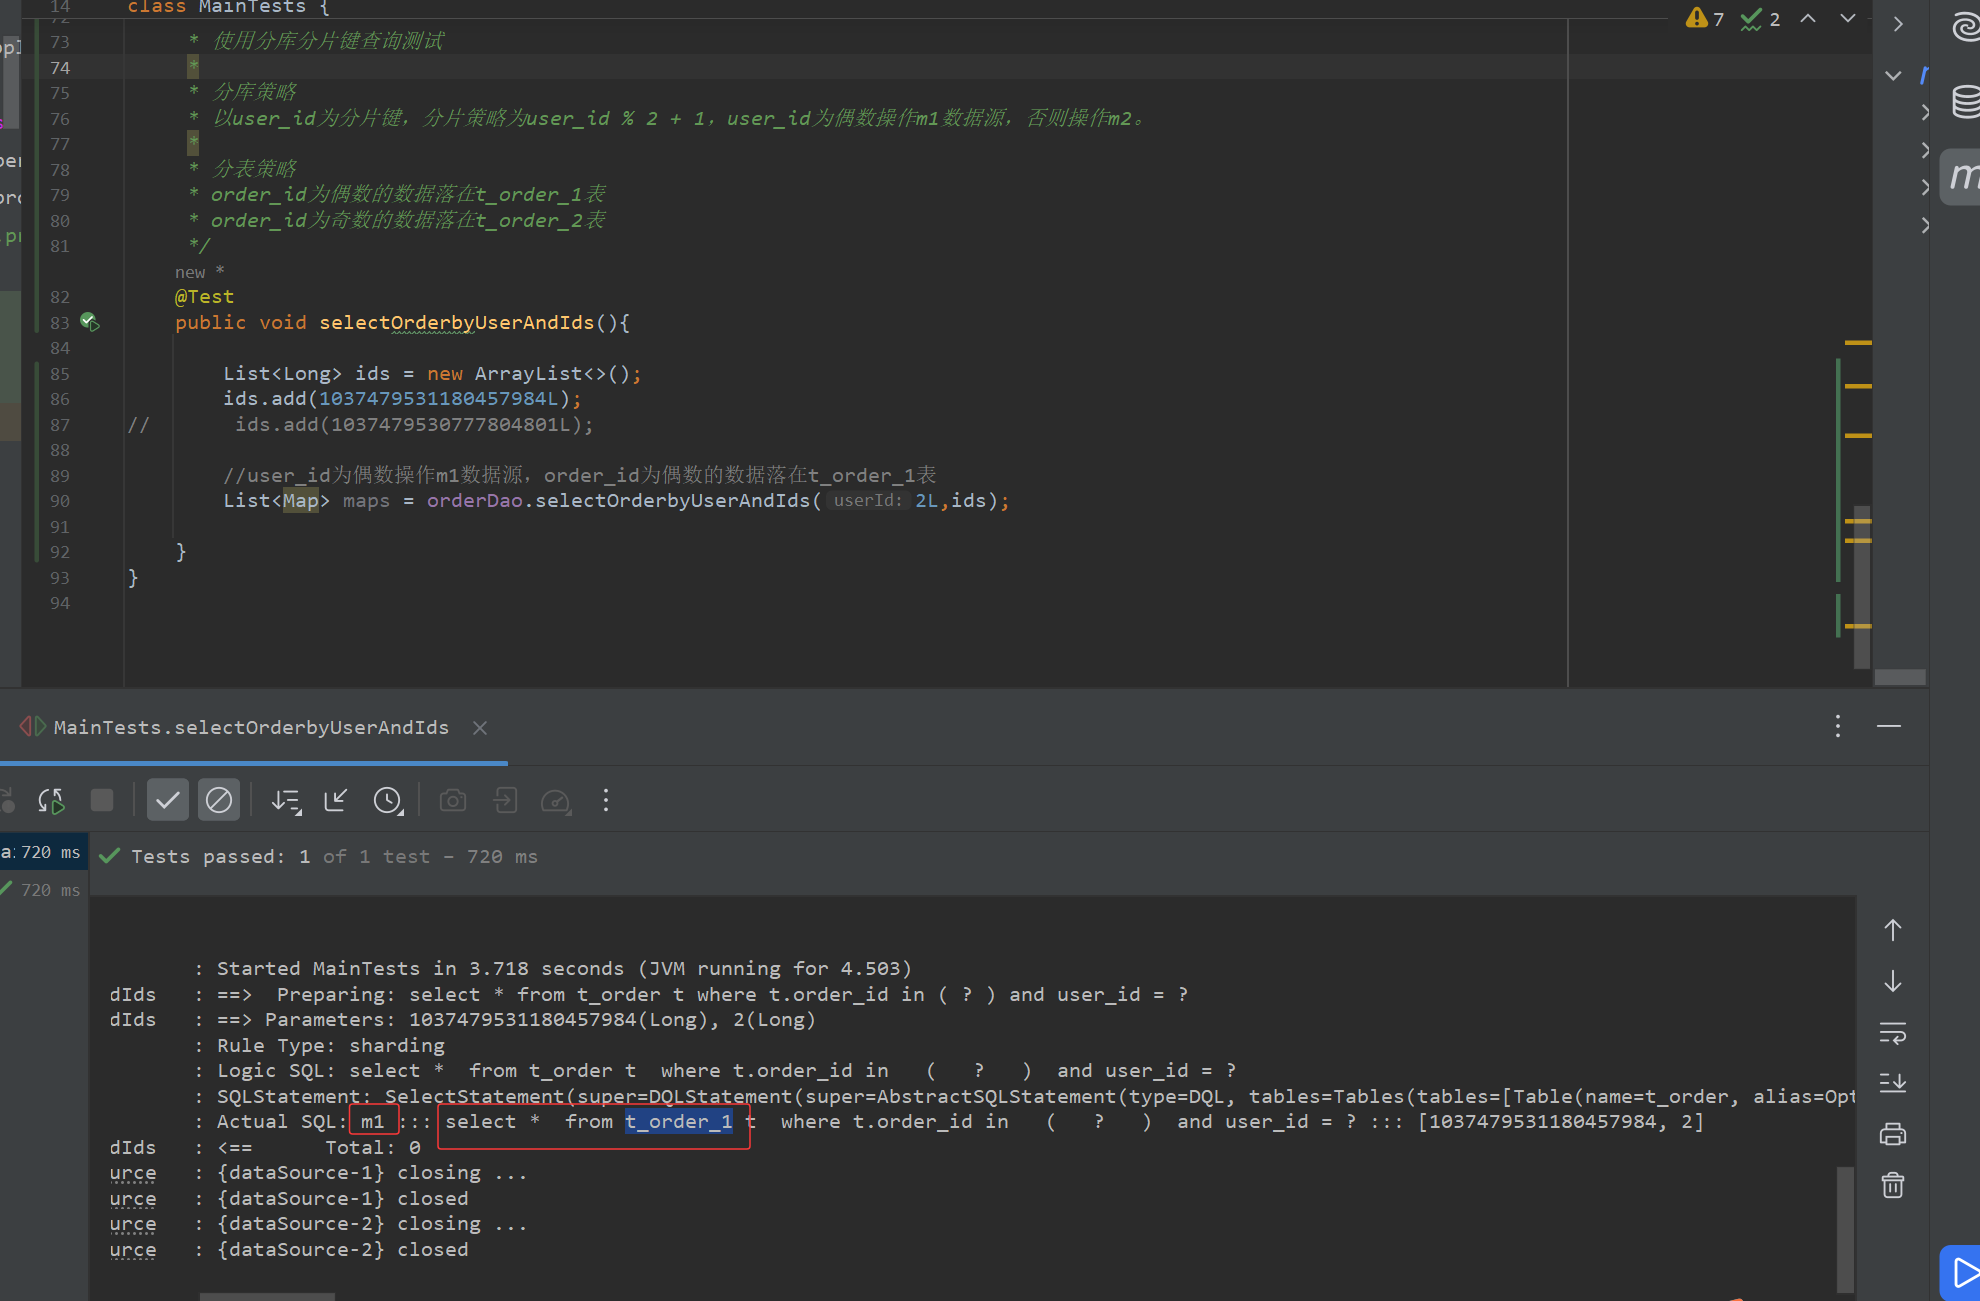
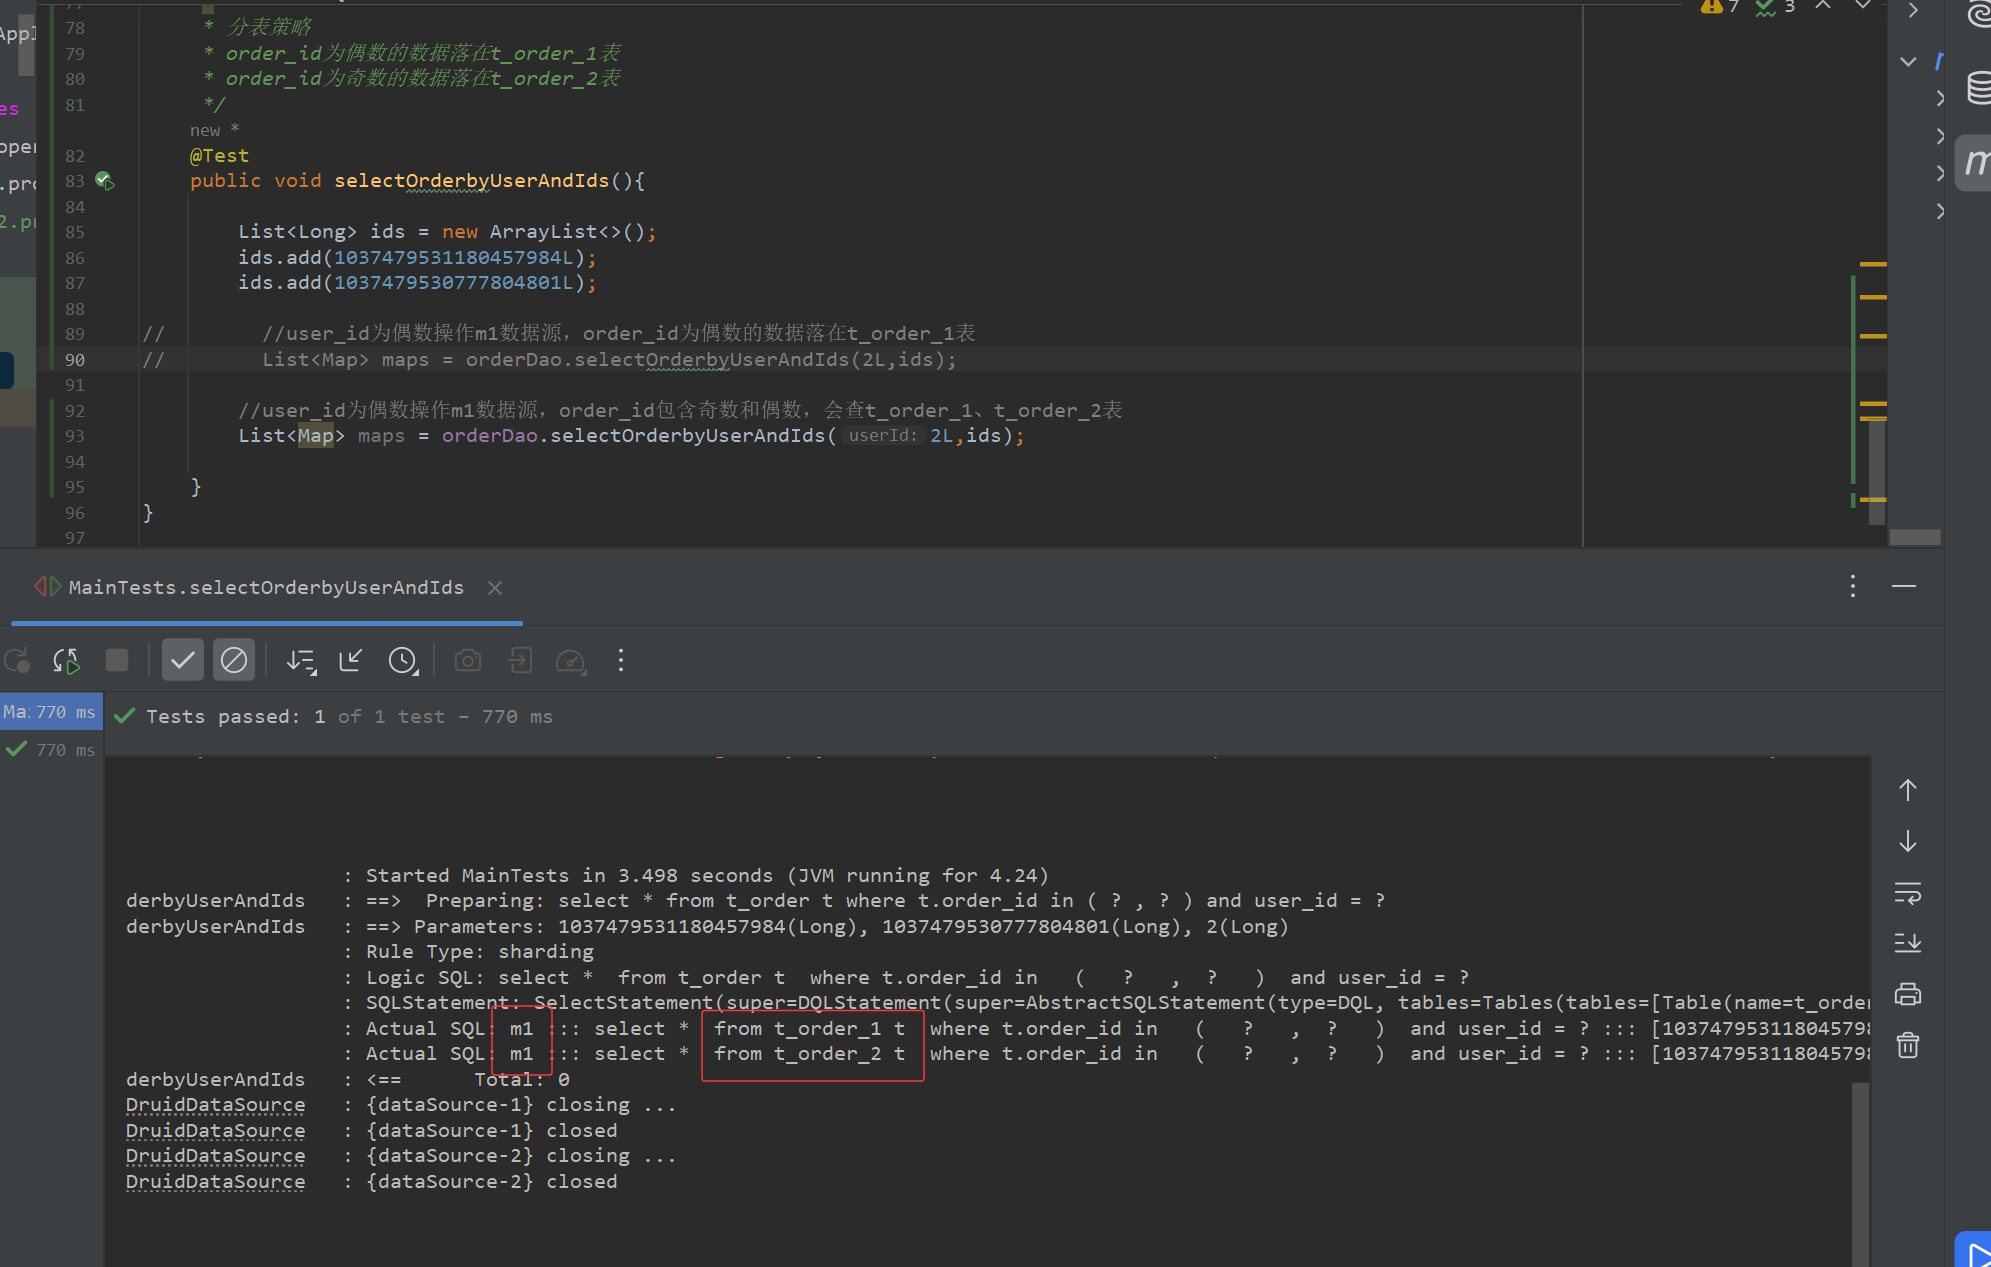
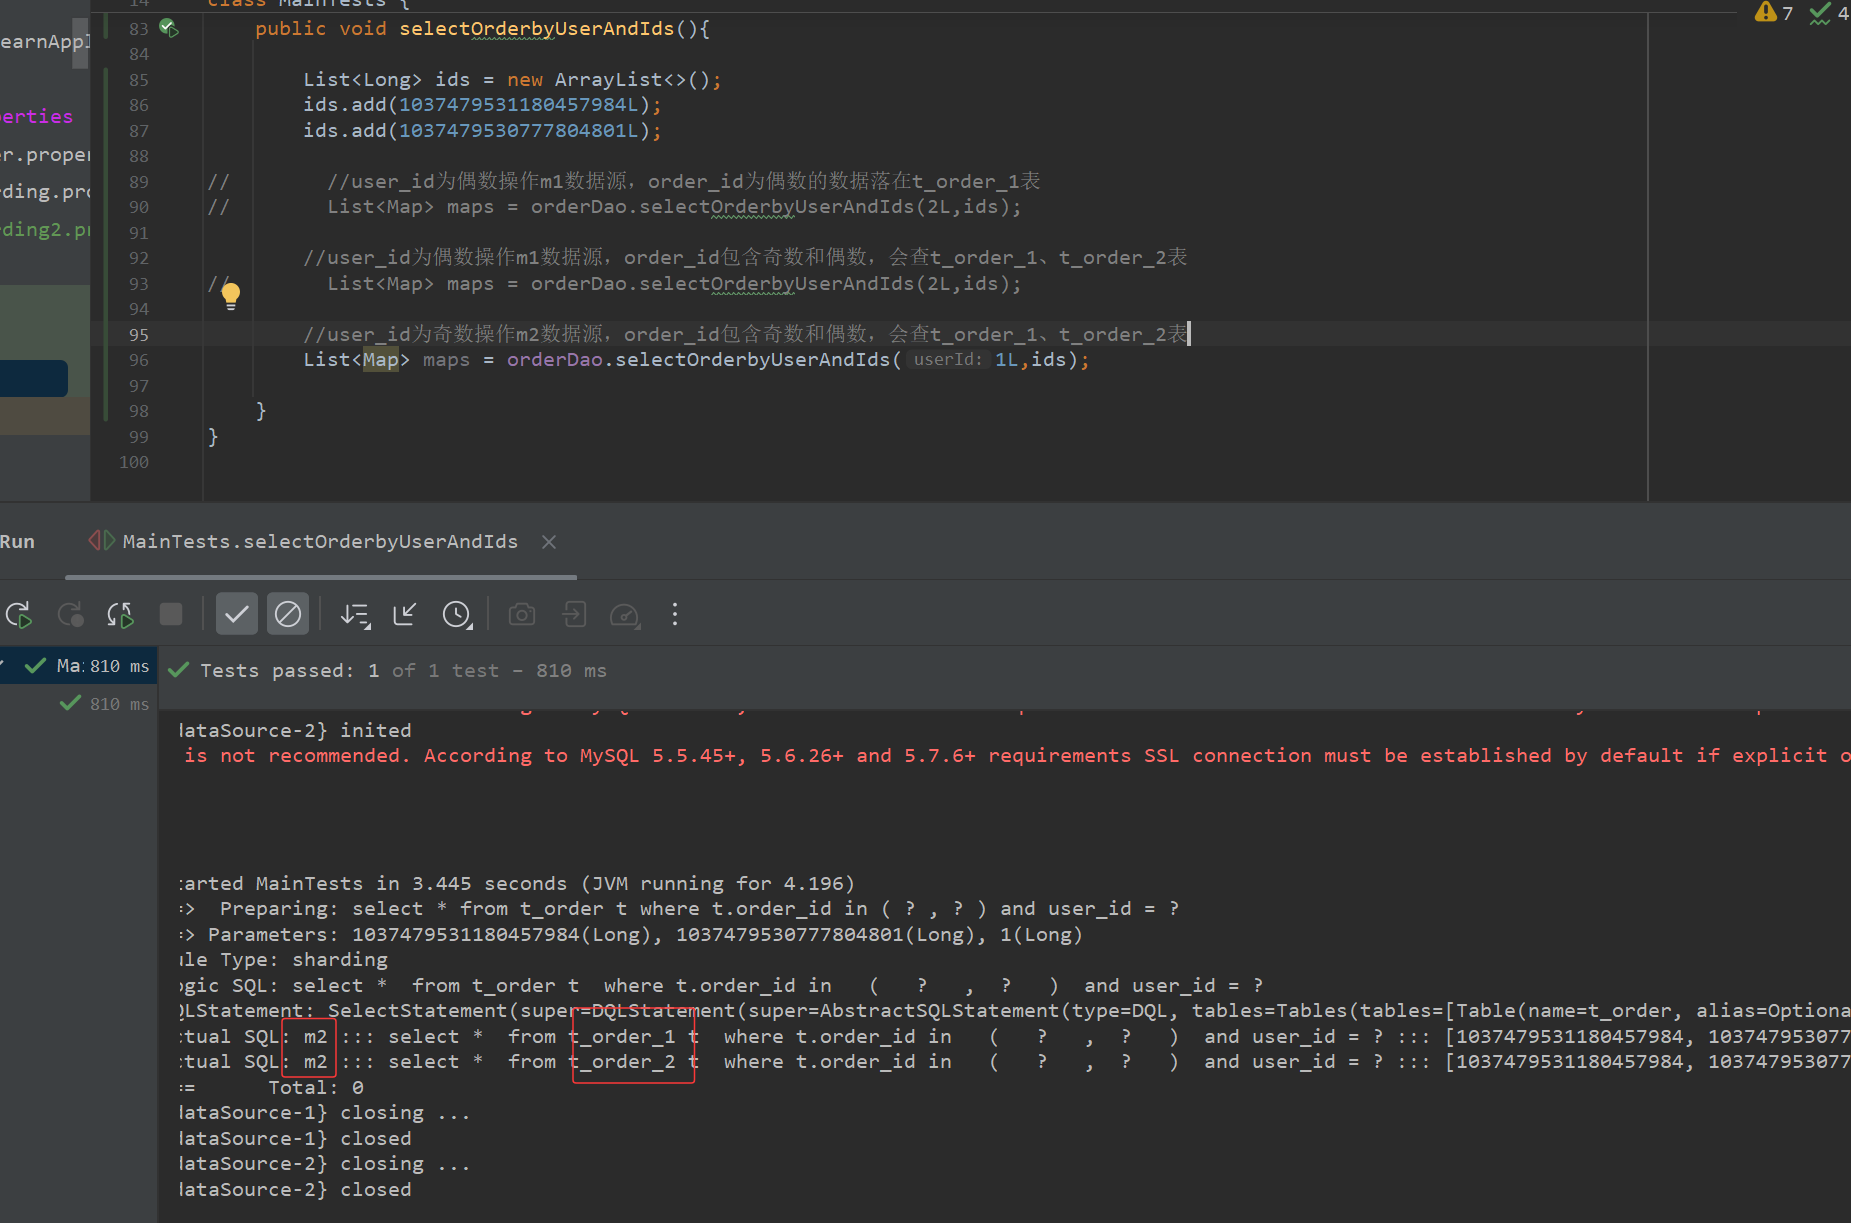
4、垂直分库
垂直分库是指按照业务将表进行分类,分布到不同的数据库上面,它的核心理念是专库专用。
4.1、准备
#  创建数据库user_db
CREATE DATABASE `user_db` CHARACTER SET 'utf8' COLLATE 'utf8_general_ci';

# 创建表
DROP TABLE IF EXISTS `t_user`;
CREATE TABLE `t_user` (
  `user_id` bigint(20) NOT NULL COMMENT '用户id',
  `fullname` varchar(255) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL COMMENT '用户姓名',
  `user_type` char(1) DEFAULT NULL COMMENT '用户类型',
  PRIMARY KEY (`user_id`) USING BTREE
) ENGINE = InnoDB CHARACTER SET = utf8 COLLATE = utf8_general_ci ROW_FORMAT = Dynamic;
4.2、代码
application-sharding3.properties
#数据源,新增m0数据源,对应user_db
spring.shardingsphere.datasource.names = m0,m1,m2
...
spring.shardingsphere.datasource.m0.type = com.alibaba.druid.pool.DruidDataSource
spring.shardingsphere.datasource.m0.driver‐class‐name = com.mysql.jdbc.Driver
spring.shardingsphere.datasource.m0.url = jdbc:mysql://zhoufei.db.com:3307/user_db?useUnicode=true
spring.shardingsphere.datasource.m0.username = root
spring.shardingsphere.datasource.m0.password = root

# t_user分表策略,固定分配至m0的t_user真实表
spring.shardingsphere.sharding.tables.t_user.actual-data-nodes = m$->{0}.t_user
spring.shardingsphere.sharding.tables.t_user.table-strategy.inline.sharding-column = user_id
spring.shardingsphere.sharding.tables.t_user.table-strategy.inline.algorithm-expression = t_user
UserDao
package feizhou.business.order;

import org.apache.ibatis.annotations.Insert;
import org.apache.ibatis.annotations.Mapper;
import org.apache.ibatis.annotations.Param;
import org.apache.ibatis.annotations.Select;
import org.springframework.stereotype.Component;

import java.util.List;
import java.util.Map;

/**
 * @ClassName: UserDao
 * @Description 请描述下该类是做什么的
 * @Author feizhou
 * @Date 2025/6/29  19:55
 * @Verson 1.0
 **/
@Mapper
@Component
public interface UserDao {
    /**
     * 新增用户
     * @param userId 用户id
     * @param fullname 用户姓名
     * @return
     */
    @Insert("insert into t_user(user_id, fullname) value(#{userId},#{fullname})")
    int insertUser(@Param("userId")Long userId,@Param("fullname")String fullname);
    /**
     * 根据id列表查询多个用户
     * @param userIds 用户id列表
     * @return
     */
    @Select({"<script>",
            " select",
            " * ",
            " from t_user t ",
            " where t.user_id in",
            "<foreach collection='userIds' item='id' open='(' separator=',' close=')'>",
            "#{id}",
            "</foreach>",
            "</script>"
    })
    List<Map> selectUserbyIds(@Param("userIds")List<Long> userIds);
}
MainTests
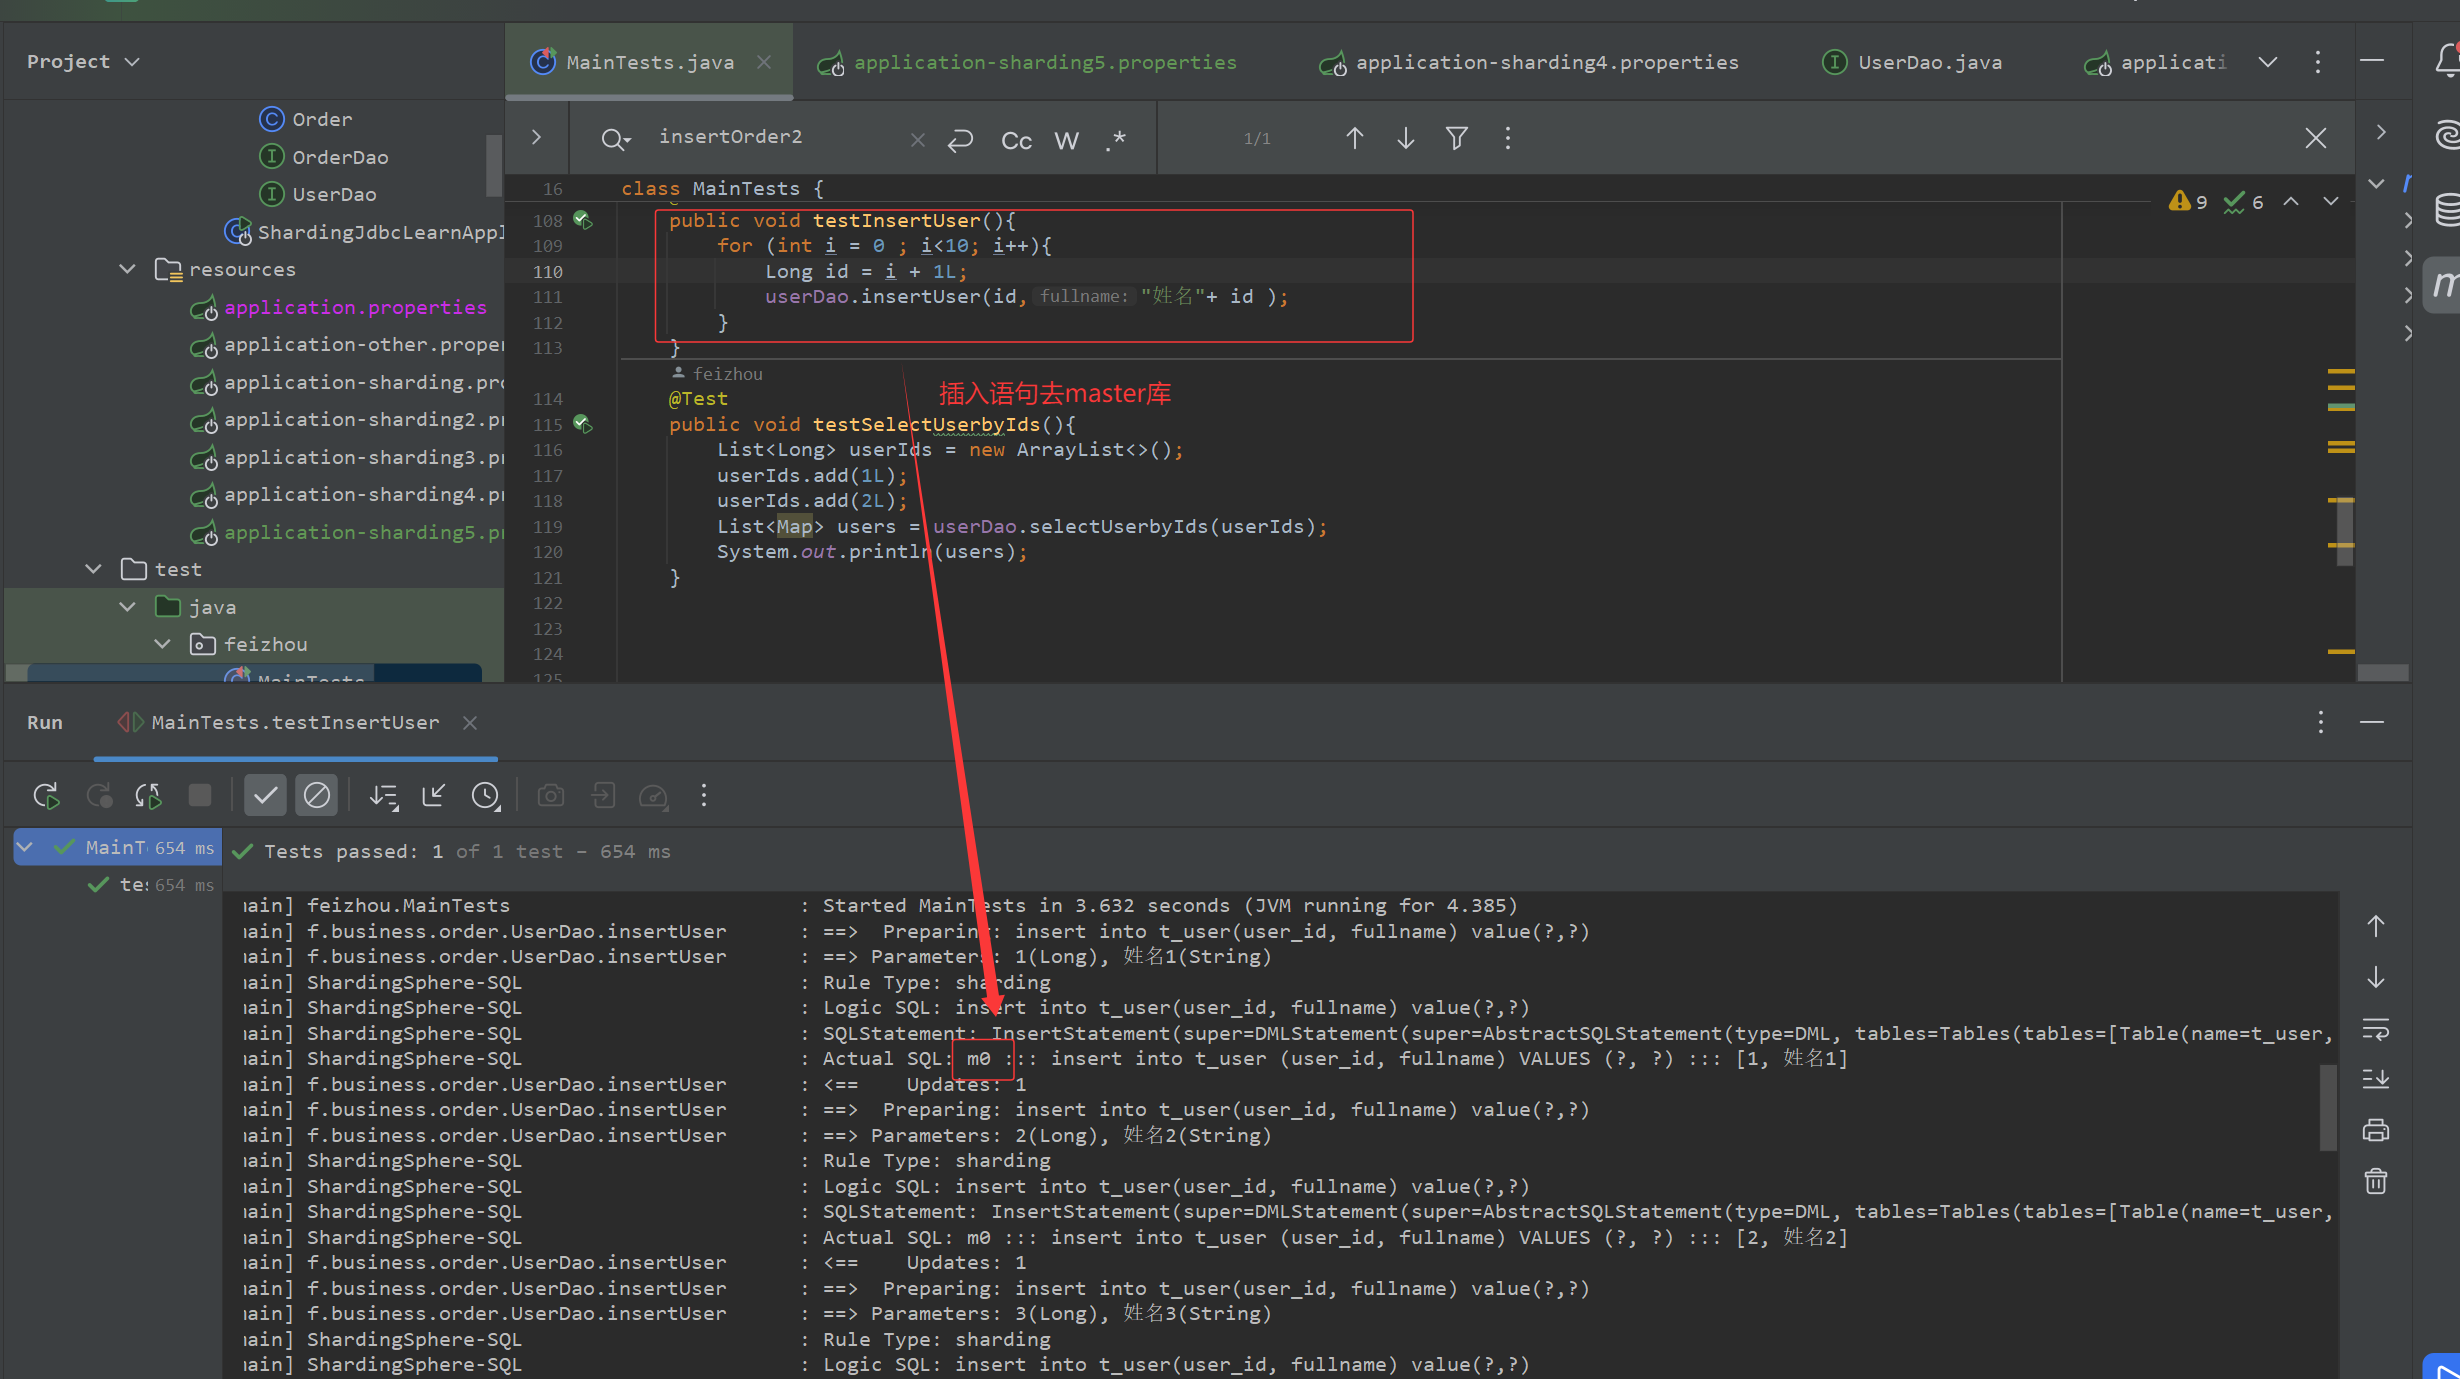
    @Test
    public void testInsertUser(){
        for (int i = 0 ; i<10; i++){
            Long id = i + 1L;
            userDao.insertUser(id,"姓名"+ id );
        }
    }
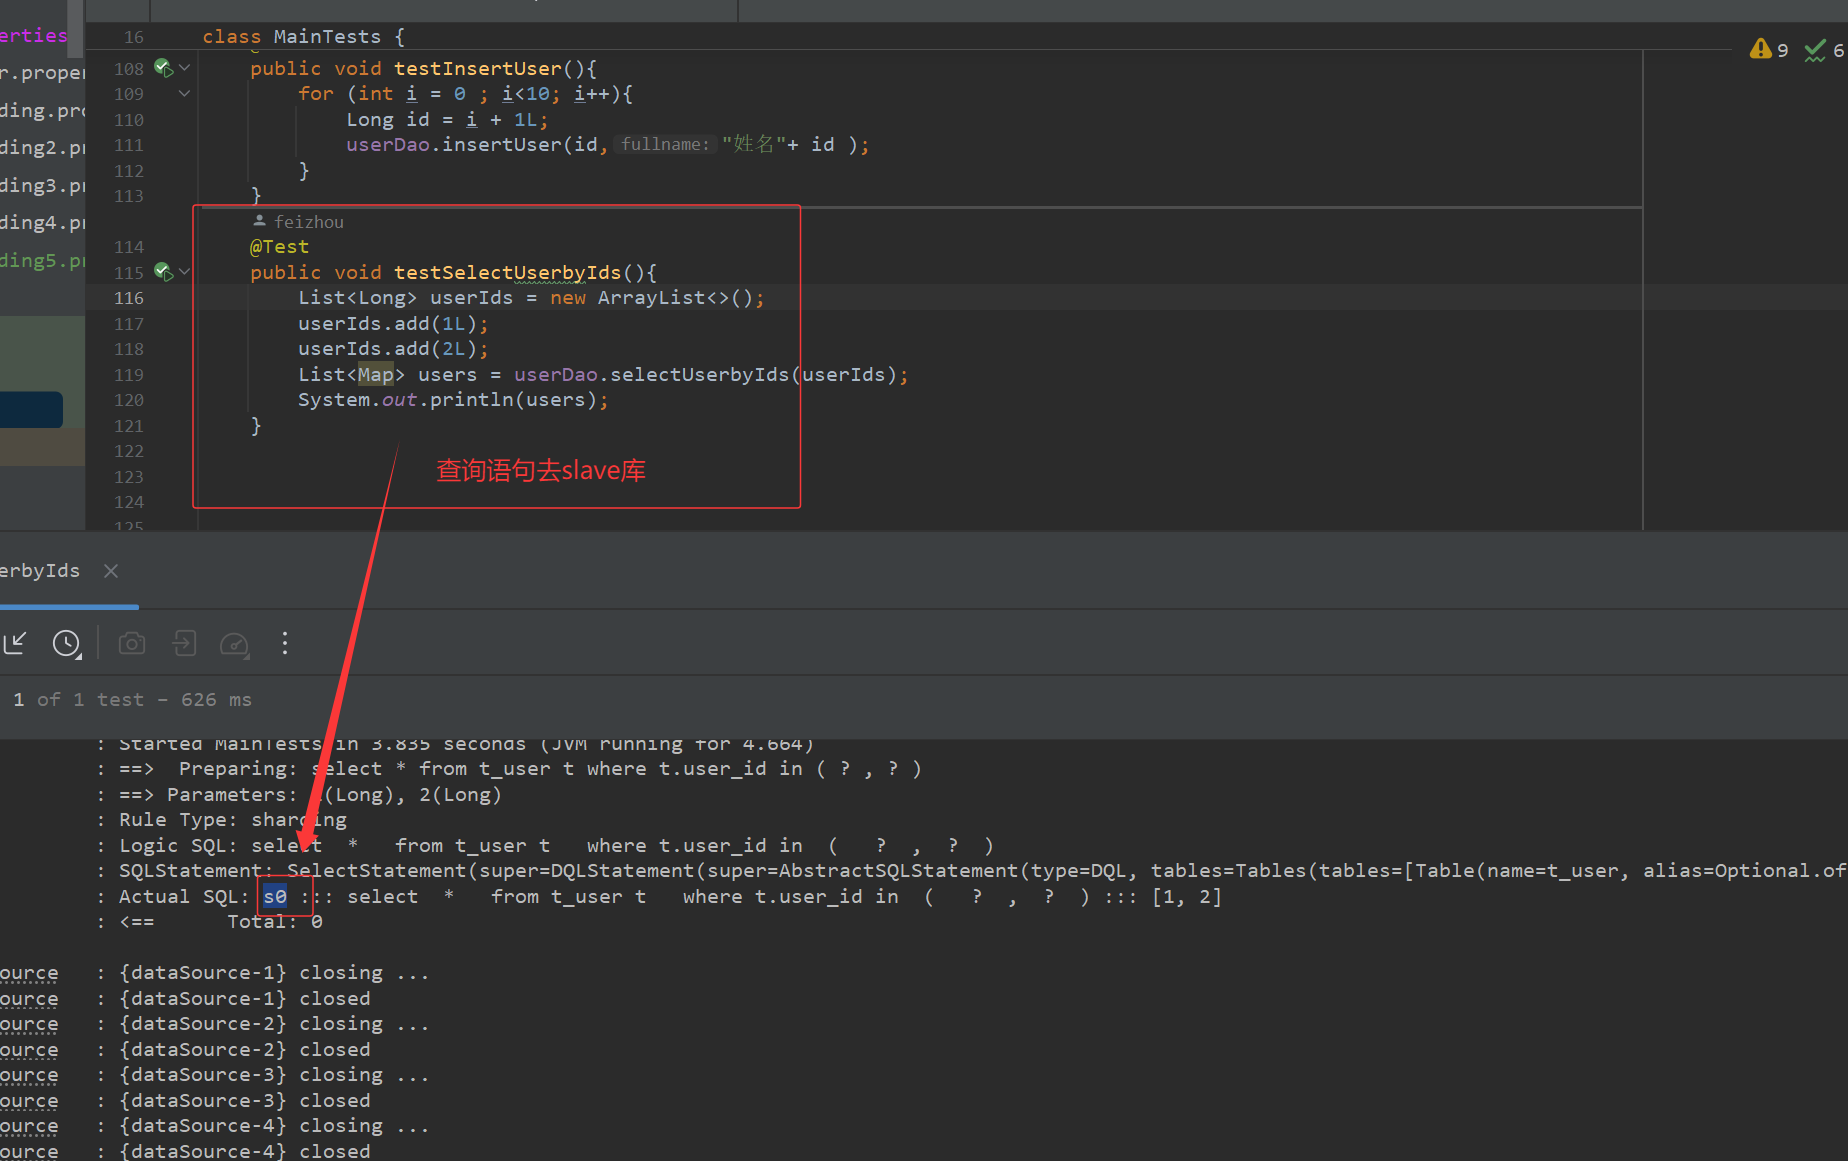
    @Test
    public void testSelectUserbyIds(){
        List<Long> userIds = new ArrayList<>();
        userIds.add(1L);
        userIds.add(2L);
        List<Map> users = userDao.selectUserbyIds(userIds);
        System.out.println(users);
    }
4.3、测试
4.3.1、插入
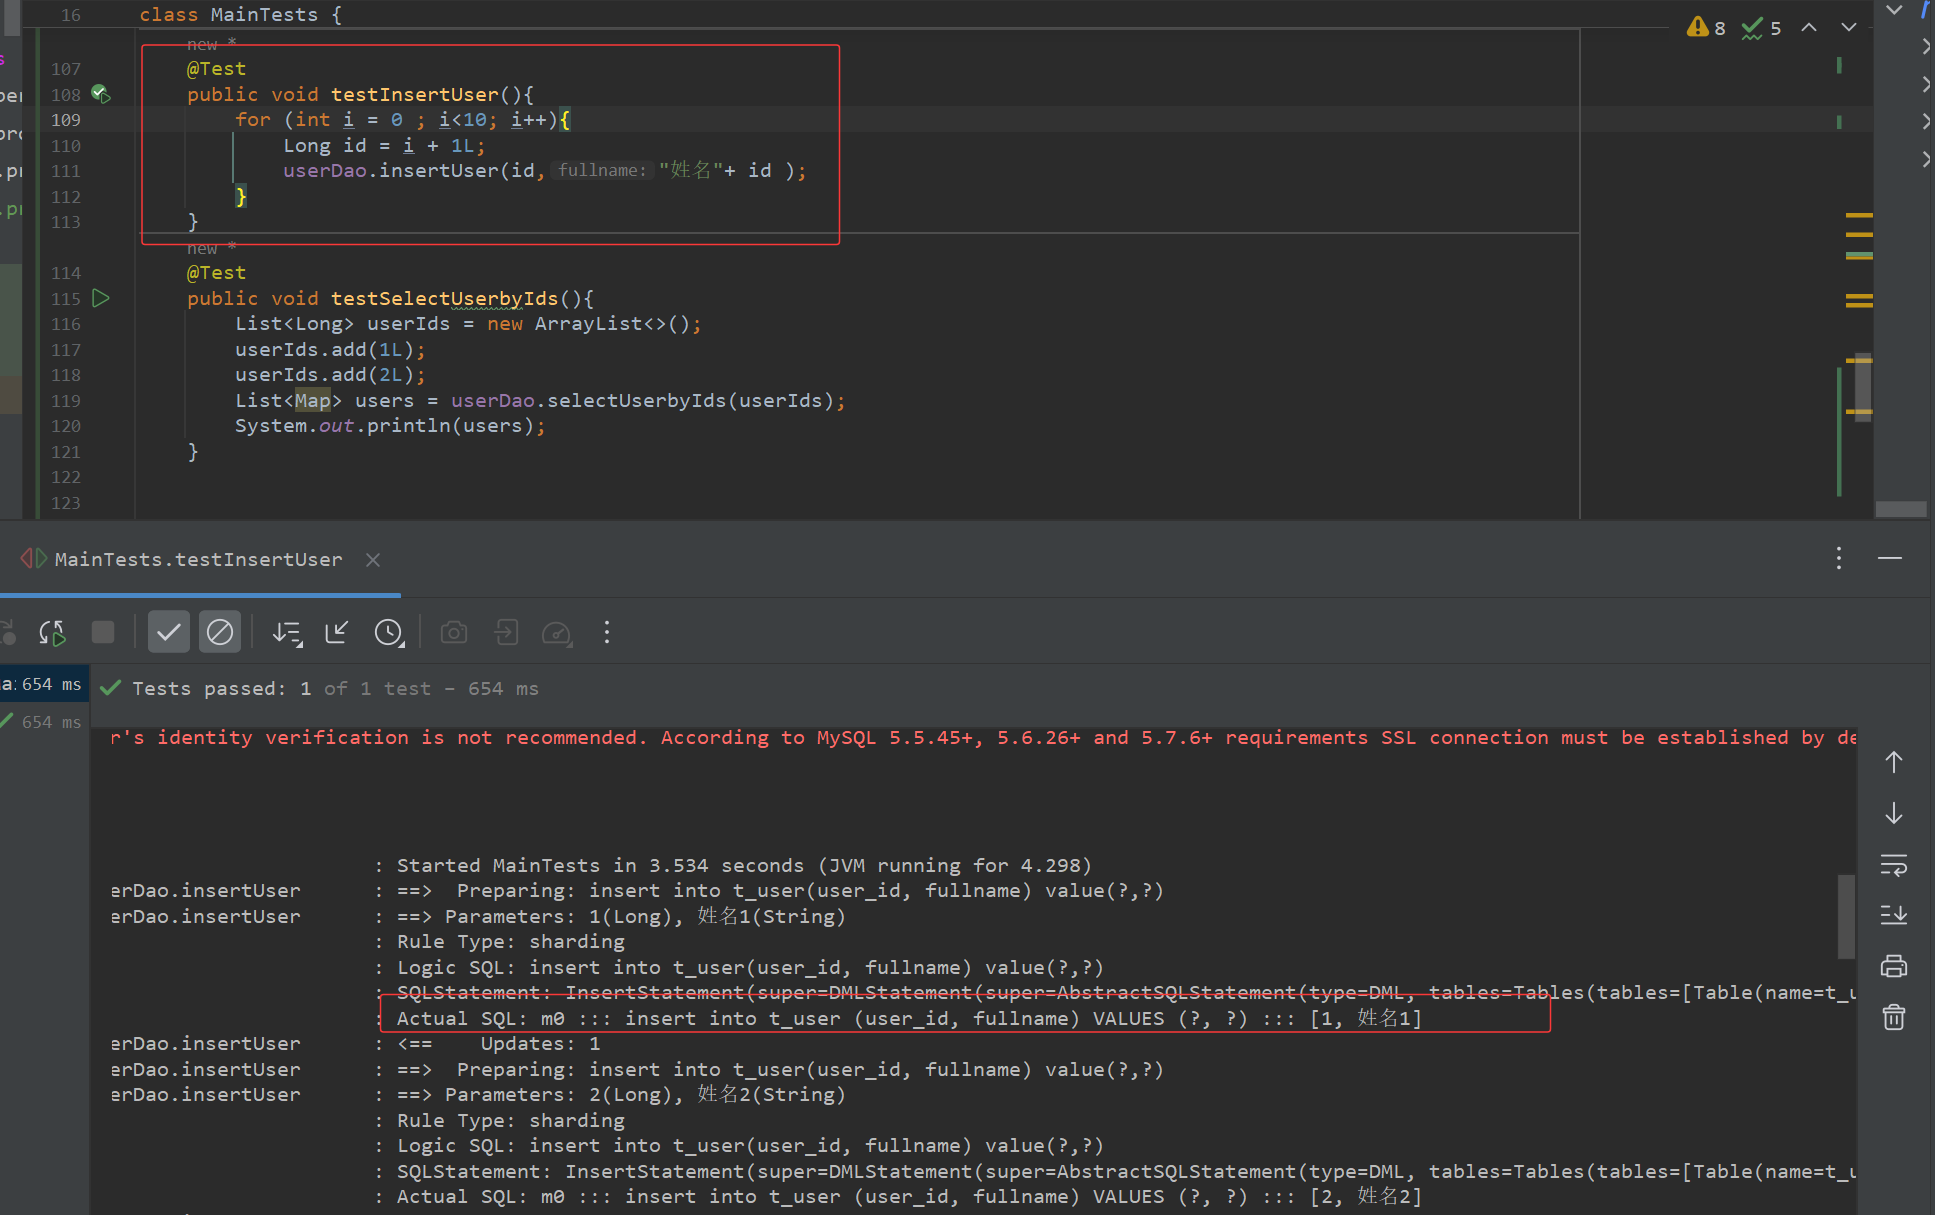
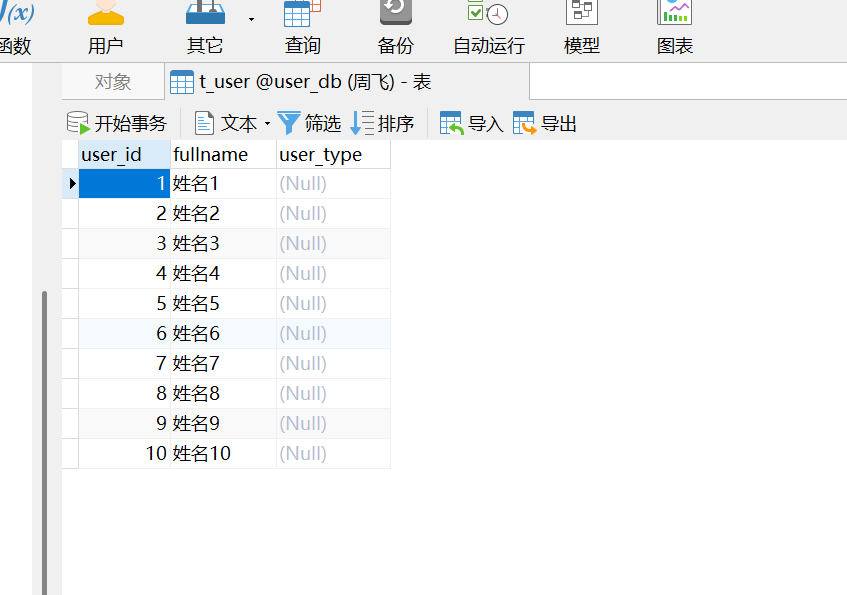
3.3.2、查询
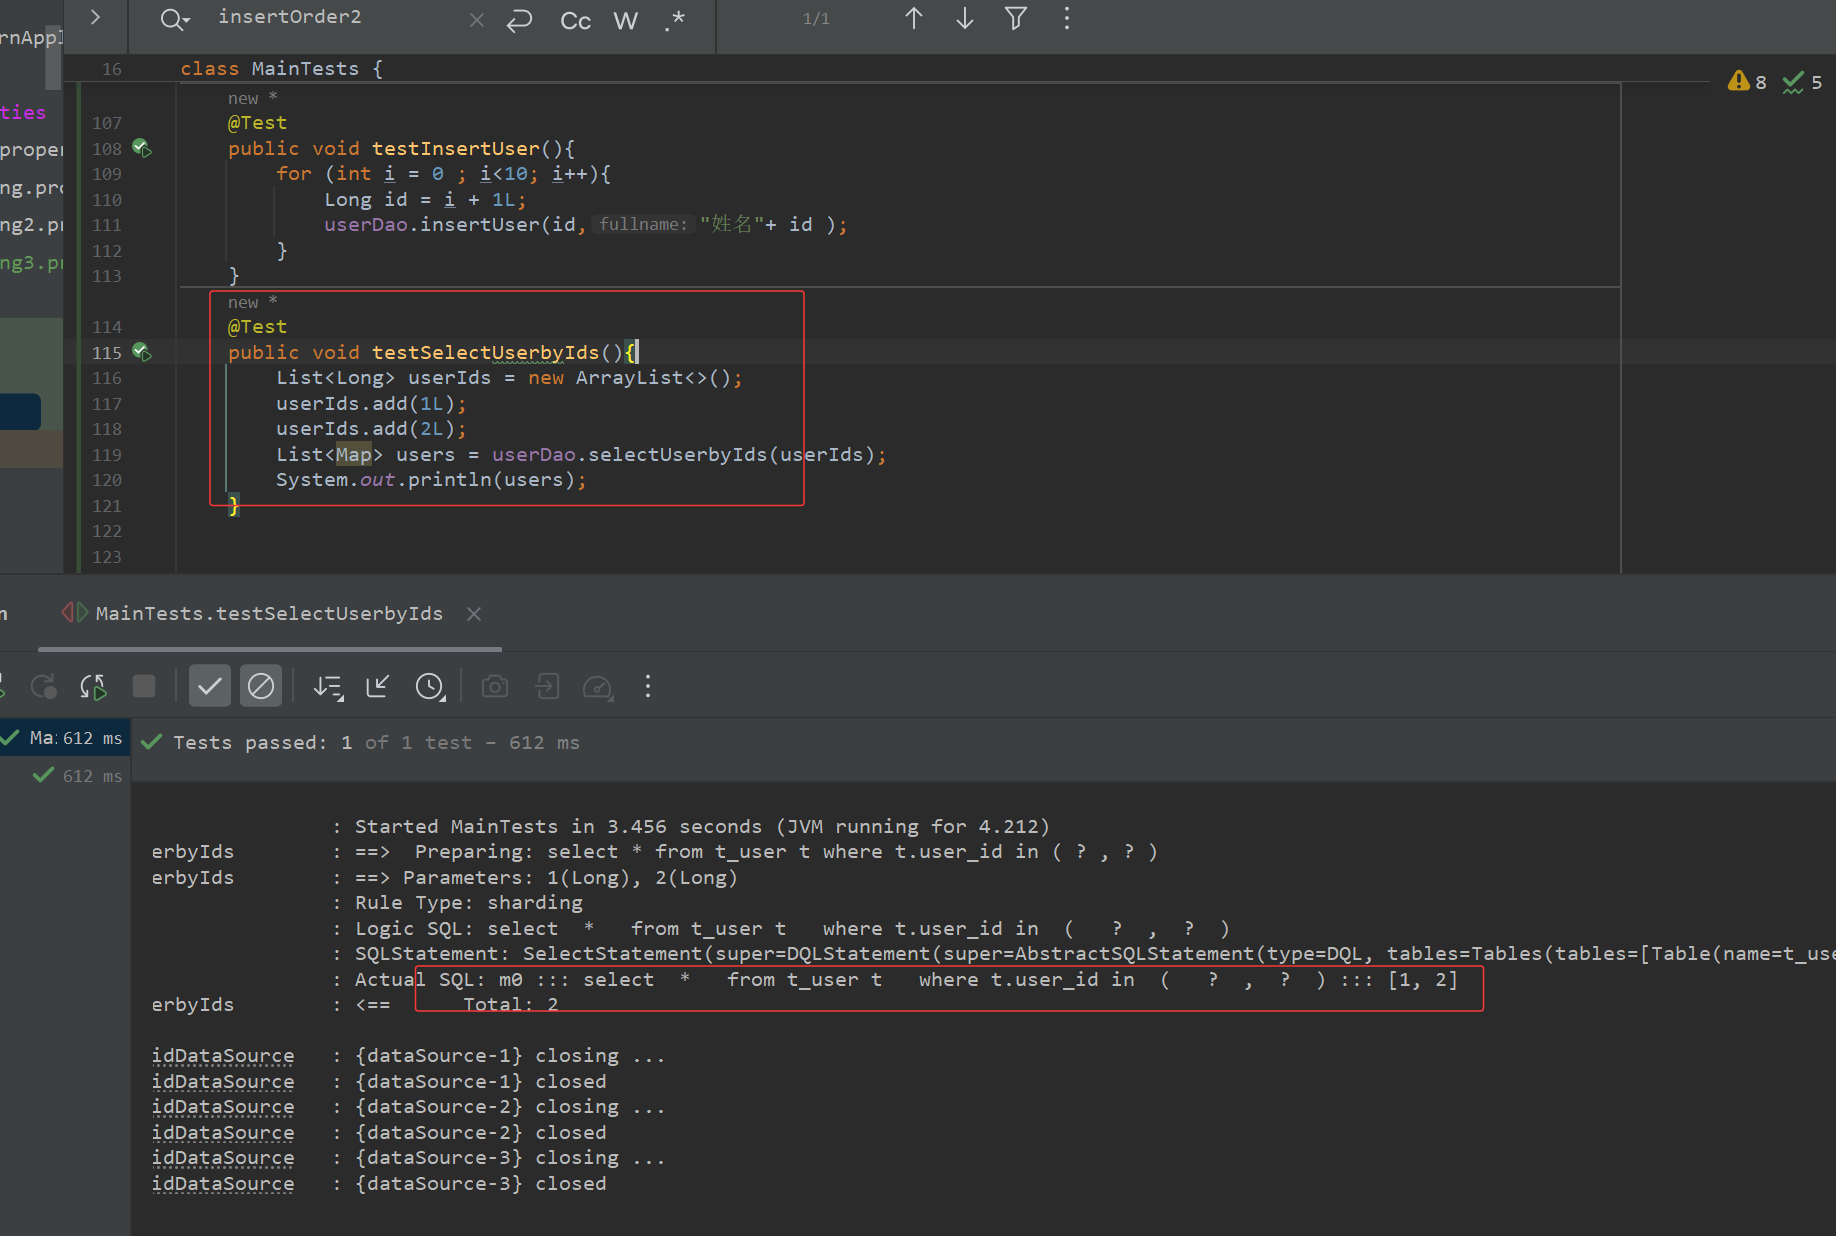
5、公共表
- 使用Sharding-JDBC实现公共表。
- 将公共表在每个数据库都保存一份,所有更新操作都同时发送到所有分库执行。
5.1、特点
- 数据量较小
- 变动少
- 属于高频联合查询的依赖表。
- 举例:参数表、数据字典表等属于此类型。
5.2、准备
5.2.1、分别在user_db、order_db_1、order_db_2中创建t_dict表
CREATE TABLE `t_dict` (
    `dict_id` bigint(20) NOT NULL COMMENT '字典id',
    `type` varchar(50) NOT NULL COMMENT '字典类型',
    `code` varchar(50) NOT NULL COMMENT '字典编码',
    `value` varchar(50) NOT NULL COMMENT '字典值',
    PRIMARY KEY (`dict_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;
5.3、代码
application-sharding4.properties
# 指定t_dict为公共表
spring.shardingsphere.sharding.broadcast‐tables=t_dict
DictDao
package feizhou.business.order;

import org.apache.ibatis.annotations.Delete;
import org.apache.ibatis.annotations.Insert;
import org.apache.ibatis.annotations.Mapper;
import org.apache.ibatis.annotations.Param;
import org.apache.ibatis.annotations.Select;
import org.springframework.stereotype.Component;

import java.util.List;
import java.util.Map;

/**
 * @ClassName: DictDao
 **/
@Mapper
@Component
public interface DictDao {
    /**
     * 新增字典
     * @param type 字典类型
     * @param code 字典编码
     * @param value 字典值
     * @return
     */
    @Insert("insert into t_dict(dict_id,type,code,value) value(#{dictId},#{type},#{code},#{value})")
    int insertDict(@Param("dictId") Long dictId,@Param("type") String type, @Param("code")String code, @Param("value")String value);
    /**
     * 删除字典
     * @param dictId 字典id
     * @return
     */
    @Delete("delete from t_dict where dict_id = #{dictId}")
    int deleteDict(@Param("dictId") Long dictId);

    /**
     * 根据id列表查询多个用户
     * @param userIds 用户id列表
     * @return
     */
    @Select({"<script>",
            " select",
            " * ",
            " from t_user t ,t_dict b",
            " where t.user_type = b.code and t.user_id in",
            "<foreach collection='userIds' item='id' open='(' separator=',' close=')'>",
            "#{id}",
            "</foreach>",
            "</script>"
    })
    List<Map> selectUserInfobyIds(@Param("userIds") List<Long> userIds);

}
MainTests
    /**
     *
     * 通过日志可以看出,对t_dict的表的操作会被广播至所有数据源。
     * 插入操作被广播至所有数据源。
     */
    @Test
    public void testInsertDict(){
        //t_dict设置为公共表后,插入数据时会同时插入所有数据源
        dictDao.insertDict(1L,"user_type","1","超级管理员");
        dictDao.insertDict(2L,"user_type","2","二级管理员");
    }

    /**
     *
     * 通过日志可以看出,对t_dict的表的操作会被广播至所有数据源。
     * 删除操作被广播至所有数据源
     */
    @Test
    public void testDeleteDict(){
        //删除公共表同理
        dictDao.deleteDict(2L);
    }

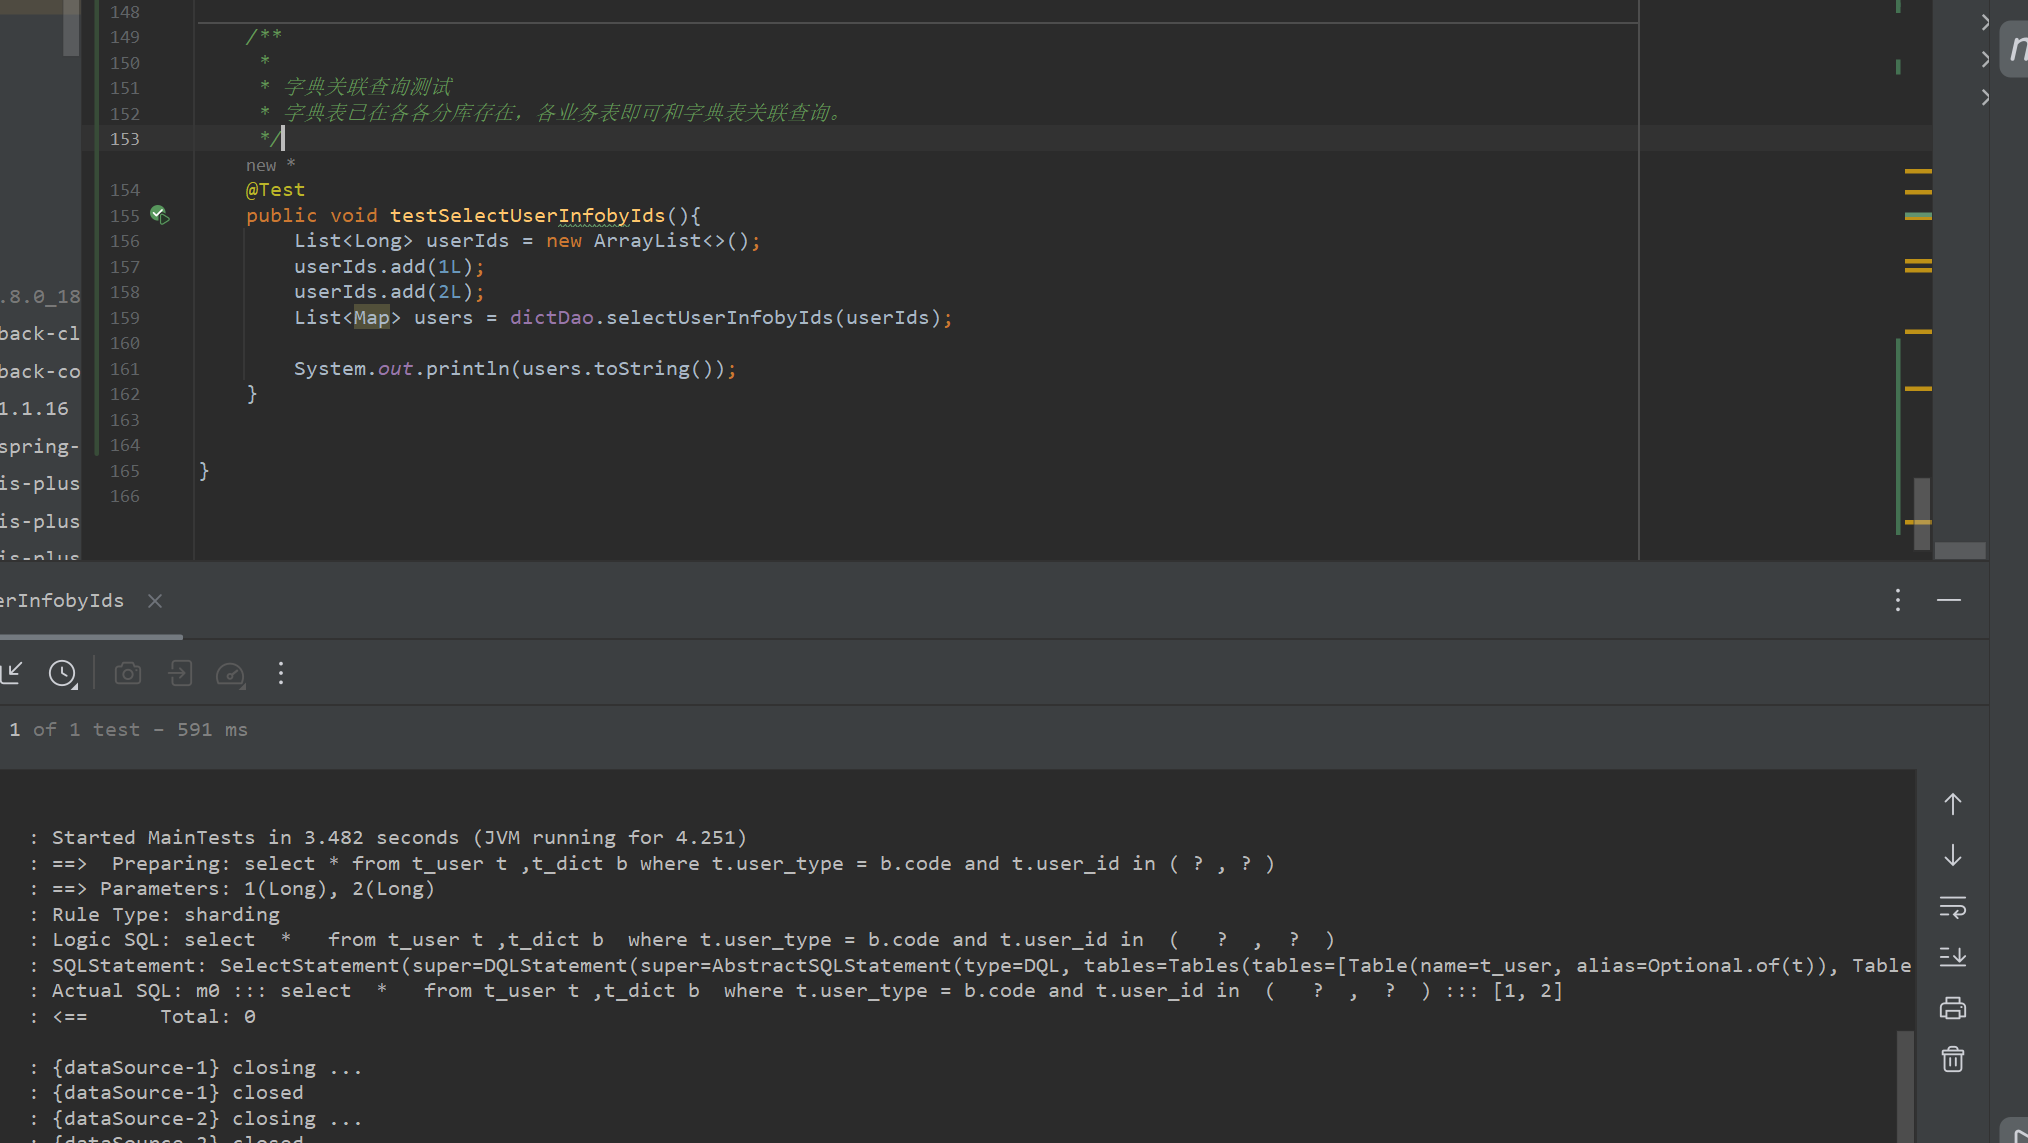
    /**
     *
     * 字典关联查询测试
     * 字典表已在各各分库存在,各业务表即可和字典表关联查询。
     */
    @Test
    public void testSelectUserInfobyIds(){
        List<Long> userIds = new ArrayList<>();
        userIds.add(1L);
        userIds.add(2L);
        List<Map> users = dictDao.selectUserInfobyIds(userIds);

        System.out.println(users.toString());
    }
5.4、测试
5.4.1、对t_dict的表的操作会被广播至所有数据源
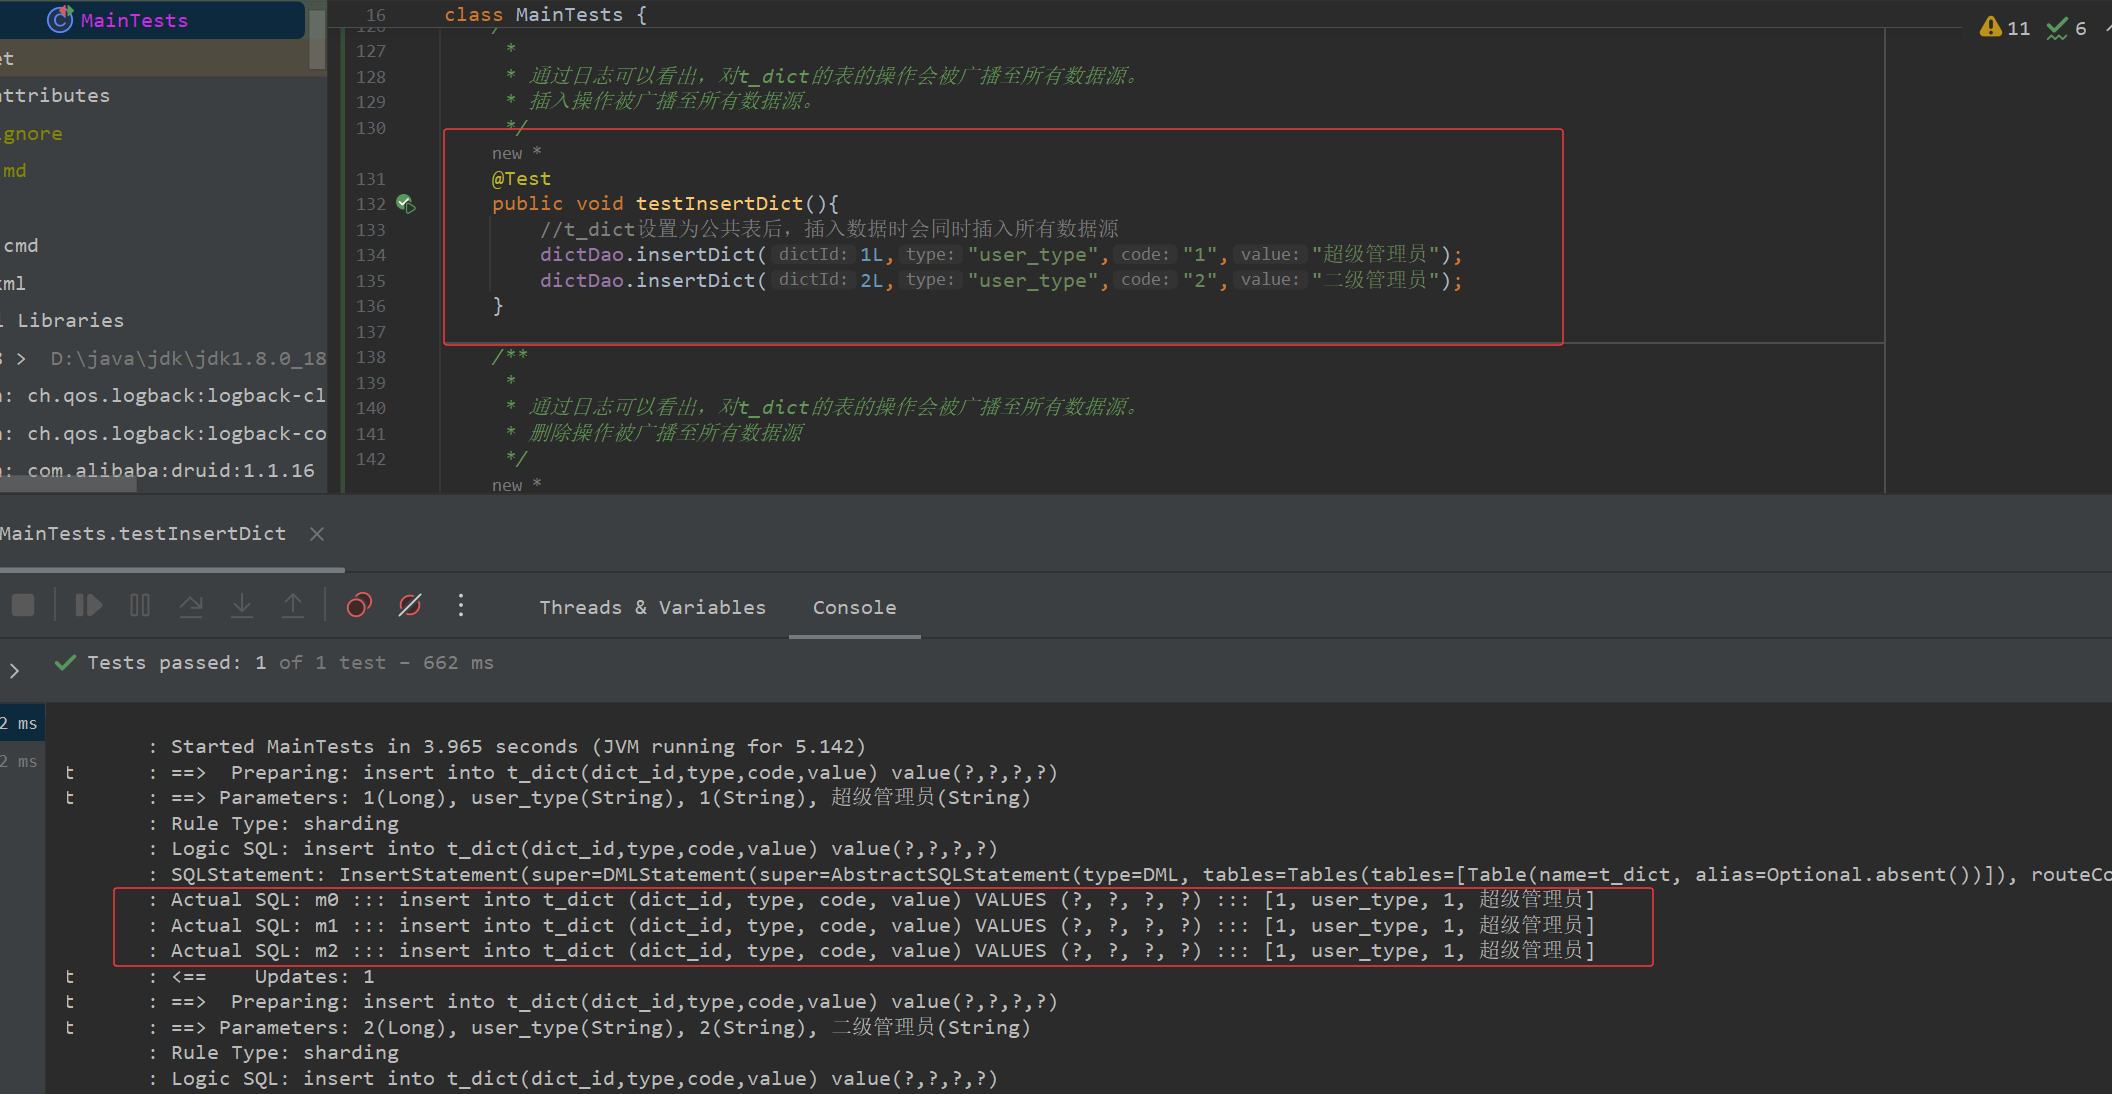
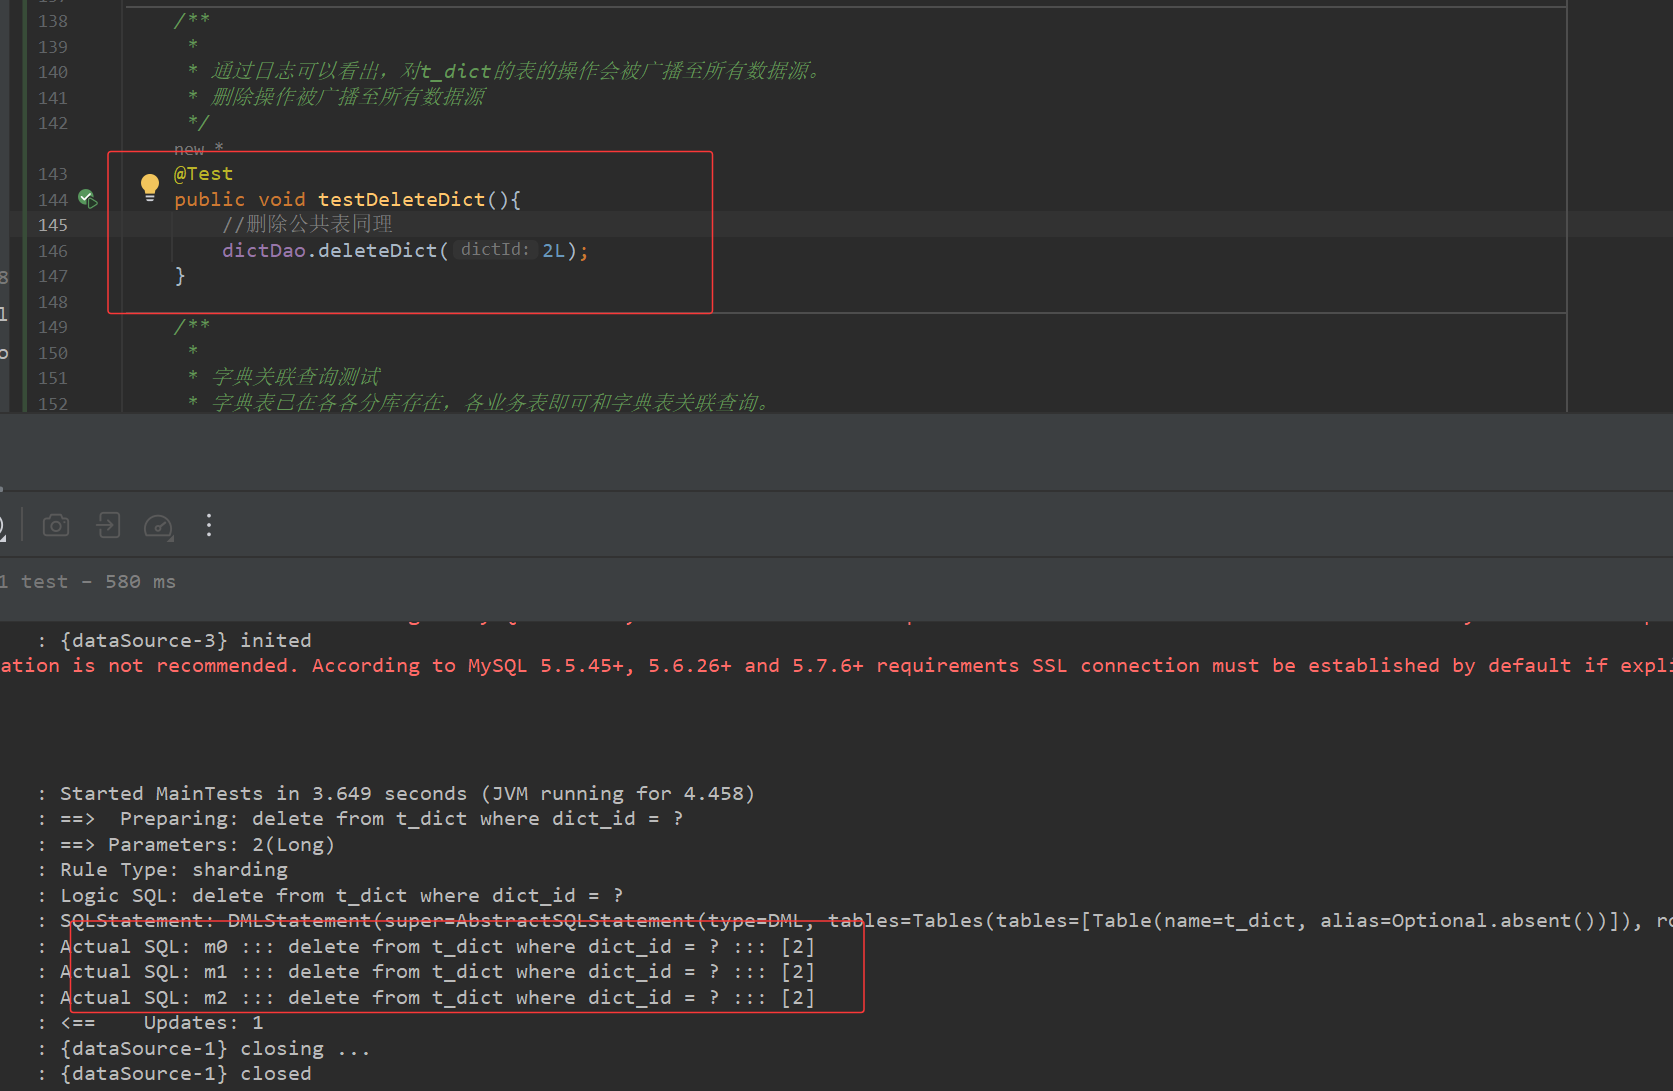
5.4.2、字典关联查询测试
6、读写分离
- Sharding-JDBC读写分离是根据SQL语义的分析,将读操作和写操作分别路由至主库与从库。
- Sharding-JDBC提供透明化读写分离,让使用方尽量像使用一个数据库一样使用主从数据库集群。
6.1、准备
搭建1主1从数据库,因为这个比较简单,我这就不写了。
- user_db:主库
- user_db1:从库
6.2、代码
application-sharding5.properties
# 增加数据源s0,使用上面主从同步配置的从库
spring.shardingsphere.datasource.names = m0,m1,m2,s0
...
spring.shardingsphere.datasource.s0.type = com.alibaba.druid.pool.DruidDataSource
spring.shardingsphere.datasource.s0.driver‐class‐name = com.mysql.jdbc.Driver
spring.shardingsphere.datasource.s0.url = jdbc:mysql://zhoufei.db.com:3307/user_db1?useUnicode=true
spring.shardingsphere.datasource.s0.username = root
spring.shardingsphere.datasource.s0.password = root

# 主库从库逻辑数据源定义ds0为user_db
spring.shardingsphere.sharding.master-slave-rules.ds0.master-data-source-name=m0
spring.shardingsphere.sharding.master-slave-rules.ds0.slave-data-source-names=s0

# t_user分表策略,固定分配至ds0的t_user真实表
spring.shardingsphere.sharding.tables.t_user.actual-data-nodes = ds0.t_user
6.3、测试
更多推荐



 18
 0
- 0


 已为社区贡献9条内容

所有评论(0)