
草稿!! 【二叉树系列算法核心纲要】【前中后序本质】【后序利用子树结果】【遍历 or 分解】
本文核心思想概要
本文围绕二叉树问题的求解本质展开,核心思想可梳理为以下要点:
- 二叉树解题的两大核心思路:
- 一是基于遍历函数配合外部变量跟踪状态的“遍历思路”,体现回溯思想;
- 二是通过递归利用子树返回值推导结果的“分解问题思路”,体现动态规划思想,二者分别对应不同场景的问题求解需求。
- 前中后序遍历的本质:
- 并非简单的顺序差异,而是前中后序是递归过程中代码执行的关键时机。
- 前序对应“刚进入节点时”,中序对应“左子树遍历完毕后”,后序对应“左右子树均遍历完毕后”。
- 其中后序位置因能同时获取左右子树信息,成为解决子树相关问题的核心关键。
-
排序算法与遍历框架的关联:快速排序的逻辑对应二叉树前序遍历框架(先构造分界点,再递归处理子数组);归并排序则对应后序遍历框架(先递归处理子数组,再合并结果),揭示了遍历思想在经典算法中的底层应用。
-
动态规划、回溯与DFS的区别:三者的核心差异在于关注点不同——动态规划聚焦整棵子树的结果(依赖后序位置整合子树信息),回溯侧重节点间的路径(操作逻辑位于for循环内),DFS则关注单个节点的处理(操作逻辑位于for循环外)。
掌握这些本质规律,可高效破解各类二叉树及扩展问题。
二叉树完全解析:从解题思路到算法实现
一、二叉树解题的两种核心思路
二叉树问题的求解可归纳为两种核心思维模式,覆盖绝大多数场景:
1. 遍历思路(回溯思想)
- 核心逻辑:通过遍历整棵二叉树,在遍历过程中记录关键信息,最终推导答案
- 实现方式:定义
traverse函数配合外部变量存储中间结果 - 本质:关注节点的访问顺序和路径跟踪,类似回溯算法的执行流程
2. 分解问题思路(动态规划思想)
- 核心逻辑:将原问题拆解为子树问题,通过子树的解推导当前节点的解
- 递归三部曲:
- 函数定义:明确参数、返回值(子问题的解)
- 终止条件:确定递归的边界(如空节点返回特定值)
- 单次递归逻辑:如何通过左右子树的返回值计算当前节点的解
- 本质:利用分治思想,通过子问题结果组合得到原问题结果
二、排序算法与二叉树遍历的关联
排序算法的核心逻辑与二叉树遍历框架高度吻合,是理解遍历本质的绝佳案例:
1. 快速排序与前序遍历
快速排序的执行流程完全符合二叉树前序遍历框架:
- 步骤:
- 对数组
nums[st...ed]找分界点p - 调整元素使
nums[st...p-1] ≤ nums[p] < nums[p+1...ed] - 递归处理左右子数组
nums[st...p-1]和nums[p+1...ed]
- 对数组
void sort(int nums[], int st, int ed) {
    if (st >= ed) return;  // 终止条件:子数组长度为0或1
    // ****** 前序位置 ******:先处理当前节点(构造分界点)
    int p = partition(nums, st, ed);  // 构造分界点
    // 递归处理左右子数组
    sort(nums, st, p-1);
    sort(nums, p+1, ed);
}
- 关联:先处理当前节点(构造分界点),再递归处理子问题,对应二叉树前序遍历的"先根后左右"逻辑。
2. 归并排序与后序遍历
归并排序的执行流程对应二叉树后序遍历框架:
- 步骤:
- 对数组
nums[st...ed]拆分:nums[st...mid]和nums[mid+1...ed] - 递归排序两个子数组
- 合并两个有序子数组得到最终结果
- 对数组
void sort(int nums[], int st, int ed) {  // 修正:Java数组格式改为C++
    if (st == ed) return;  // 终止条件:子数组长度为1
    int mid = (st + ed) / 2;

    // 先递归处理左右子数组
    sort(nums, st, mid);
    sort(nums, mid+1, ed);

    // ****** 后序位置 ******:子问题处理完毕后合并结果
    merge(nums, st, mid, ed);  // 合并两个有序子数组
}
- 关联:先递归处理子问题(排序子数组),再处理当前节点(合并结果),对应二叉树后序遍历的"先左右后根"逻辑,属于典型的分治算法。
二、二叉树的遍历方式
二叉树的遍历是所有操作的基础,主要分为递归遍历(DFS) 和层序遍历(BFS) 两大类。
1. 递归遍历(DFS)
递归遍历通过函数自身调用实现,核心是控制节点的访问时机。
二叉树节点定义
class TreeNode {
public:
    int val;
    TreeNode* left;  // 左子节点指针
    TreeNode* right; // 右子节点指针

    // 构造函数
    TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
};
递归遍历框架
void traverse(TreeNode* root) {
    if (root == nullptr) return;  // 终止条件:空节点直接返回

    // 左子树遍历
    traverse(root->left);
    // 右子树遍历
    traverse(root->right);
}
- 遍历逻辑:优先深入左子树,直至空节点,再回溯尝试右子树,最终返回父节点
- 关键特性:遍历顺序仅由左右子节点的递归调用顺序决定,与其他代码无关
2. 前中后序遍历的本质
前中后序遍历的核心区别在于代码执行的时机,而非遍历路径的差异。遍历路径(root指针的移动顺序)固定,但处理逻辑的位置决定了结果:
void traverse(TreeNode* root) {
    if (root == nullptr) return;

    // 前序位置:刚进入当前节点时执行
    traverse(root->left);  // 遍历左子树
    // 中序位置:左子树遍历完毕,即将开始右子树遍历时执行
    traverse(root->right); // 遍历右子树
    // 后序位置:右子树遍历完毕,即将离开当前节点时执行
}
- 前序位置:节点被首次访问时(如记录节点值、初始化状态)
- 中序位置:左子树完全处理后(如二叉搜索树的有序遍历)
- 后序位置:左右子树均处理后(如计算子树统计信息)
- 补充:二叉搜索树(BST)的中序遍历结果为有序序列,这是BST的核心特性。
3. 层序遍历(BFS)
层序遍历按"从上到下、从左到右"的层级顺序访问节点,通过队列实现。
写法一:基础版(无法区分层级)
void levelOrderTraverse(TreeNode* root) {
    if (root == nullptr) return;  // 空树直接返回
    std::queue<TreeNode*> q;  // 队列存储待访问节点
    q.push(root);  // 根节点入队

    while (!q.empty()) {
        TreeNode* cur = q.front();  // 取出队头节点
        q.pop();

        // 访问当前节点(此处添加具体处理逻辑)

        // 左右子节点入队(确保下一层节点被访问)
        if (cur->left != nullptr) q.push(cur->left);
        if (cur->right != nullptr) q.push(cur->right);
    }
}
- 缺点:无法记录节点所在层级,适用于无需层级信息的场景。
写法二:层级标记版(常用)
void levelOrderTraverse(TreeNode* root) {
    if (root == nullptr) return;
    std::queue<TreeNode*> q;
    q.push(root);
    int depth = 1;  // 根节点视为第1层

    while (!q.empty()) {
        int sz = q.size();  // 当前层节点数量
        // 遍历当前层所有节点
        while (sz-- > 0) {
            TreeNode* cur = q.front();
            q.pop();

            // 访问节点并输出层级信息
            std::cout << "depth = " << depth << ", val = " << cur->val << std::endl;

            // 子节点入队
            if (cur->left != nullptr) q.push(cur->left);
            if (cur->right != nullptr) q.push(cur->right);
        }
        depth++;  // 当前层遍历完毕,进入下一层
    }
}
- 核心技巧:通过
sz = q.size()记录当前层节点数,确保一次性处理完当前层所有节点后再进入下一层。
写法三:带权重/附加信息版
适用于节点路径有权重或需记录额外信息的场景:
// 存储节点及附加信息(如深度、权重等)
class State {
public:
    TreeNode* node;  // 节点指针
    int depth;       // 节点深度(可扩展为权重等)

    // 构造函数
    State(TreeNode* node, int depth) : node(node), depth(depth) {}
};

void levelOrderTraverse(TreeNode* root) {
    if (root == nullptr) return;
    std::queue<State> q;  // 队列存储节点及附加信息
    q.push(State(root, 1));  // 根节点深度为1

    while (!q.empty()) {
        State cur = q.front();
        q.pop();

        // 访问节点及附加信息
        std::cout << "depth = " << cur.depth << ", val = " << cur.node->val << std::endl;

        // 子节点入队,传递附加信息
        if (cur.node->left != nullptr) {
            q.push(State(cur.node->left, cur.depth + 1));
        }
        if (cur.node->right != nullptr) {
            q.push(State(cur.node->right, cur.depth + 1));
        }
    }
}
三、深入理解前中后序遍历
前中后序遍历的本质是递归过程中处理节点的三个关键时机,而非简单的顺序差异。
1. 递归遍历的共性与特性
所有递归遍历(包括数组、链表、二叉树)均存在前序和后序位置:
- 前序位置:递归调用前,刚进入当前节点/元素时
- 后序位置:递归调用后,即将离开当前节点/元素时
示例:递归遍历数组与链表
// 递归遍历数组
void traverse(std::vector<int>& arr, int i) {
    if (i == arr.size()) return;
    // 前序位置:处理arr[i]
    traverse(arr, i + 1);  // 递归下一个元素
    // 后序位置:处理arr[i]
}

// 递归遍历单链表
class ListNode {  // 补充链表节点定义
public:
    int val;
    ListNode* next;
    ListNode(int x) : val(x), next(nullptr) {}
};

void traverse(ListNode* head) {
    if (head == nullptr) return;
    // 前序位置:处理head->val
    traverse(head->next);  // 递归下一个节点
    // 后序位置:处理head->val
}
经典案例:倒序打印单链表
void traverse(ListNode* head) {
    if (head == nullptr) return;
    traverse(head->next);  // 先递归到最后一个节点
    // 后序位置:从最后一个节点开始打印
    std::cout << head->val << std::endl;
}
- 逻辑:后序位置确保打印操作在递归完成后执行,实现从尾到头的顺序。
2. 前中后序位置的能力差异
不同位置的代码可获取的信息不同,决定了其适用场景:
- 前序位置:仅能通过函数参数获取父节点传递的信息(如层级、路径)
- 中序位置:可获取参数信息 + 左子树返回值(如BST的有序遍历)
- 后序位置:可获取参数信息 + 左右子树返回值(能力最强,适用于需综合子树结果的场景)
2. 后序位置的特殊价值
后序位置因能同时获取左右子树的结果,成为解决子树相关问题的关键:
- 需计算子树统计信息(如节点数、深度、直径)时必须使用后序位置
- 动态规划思想在二叉树中的应用几乎都依赖后序位置
四、二叉树问题实例解析
通过具体问题理解两种解题思路的应用。
1. 二叉树的最大深度
思路一:遍历思路(回溯思想)
class Solution {
    int depth = 0;  // 记录当前深度
    int res = 0;    // 记录最大深度

public:
    int maxDepth(TreeNode* root) {
        traverse(root);
        return res;
    }

    void traverse(TreeNode* root) {
        if (root == nullptr) return;
        // 前序位置:进入节点,深度+1
        depth++;
        // 叶子节点时更新最大深度
        if (root->left == nullptr && root->right == nullptr) {
            res = std::max(res, depth);  // 修正:拼写错误"deqth"→"depth"
        }
        traverse(root->left);  // 遍历左子树
        traverse(root->right); // 遍历右子树
        // 后序位置:离开节点,深度-1(回溯)
        depth--;
    }
};
- 关键:前序位置增加深度,后序位置恢复深度,通过外部变量记录最大值。
思路二:分解问题思路(动态规划思想)
class Solution {
public:
    // 函数定义:输入根节点,返回二叉树最大深度
    int maxDepth(TreeNode* root) {
        if (root == nullptr) return 0;  // 空节点深度为0

        // 分解问题:当前深度 = 左右子树最大深度 + 1
        int leftMax = maxDepth(root->left);
        int rightMax = maxDepth(root->right);  // 修正:拼写错误"righMax"→"rightMax"

        // 后序位置:综合左右子树结果
        return 1 + std::max(leftMax, rightMax);
    }
};
- 关键:后序位置已获取左右子树深度,直接计算当前节点深度,时间复杂度 O(N)。
2. 二叉树的前序遍历
思路一:遍历思路
class Solution {
public:
    std::vector<int> res;  // 外部变量存储结果

    std::vector<int> preorderTraversal(TreeNode* root) {
        traverse(root);
        return res;
    }

    void traverse(TreeNode* root) {
        if (root == nullptr) return;
        // 前序位置:记录节点值
        res.push_back(root->val);
        traverse(root->left);
        traverse(root->right);
    }
};
思路二:分解问题思路
class Solution {
public:
    std::vector<int> preorderTraversal(TreeNode* root) {
        std::vector<int> res;
        if (root == nullptr) return res;  // 空节点返回空数组

        // 前序遍历 = 根节点值 + 左子树前序 + 右子树前序
        res.push_back(root->val);

        // 递归获取左子树前序结果
        std::vector<int> left = preorderTraversal(root->left);
        res.insert(res.end(), left.begin(), left.end());

        // 递归获取右子树前序结果(修正:原代码误写为left)
        std::vector<int> right = preorderTraversal(root->right);
        res.insert(res.end(), right.begin(), right.end());

        return res;
    }
};
3. 二叉树的直径
二叉树的直径是指任意两节点之间的最长路径长度(边数),等于某节点左右子树深度之和的最大值。
思路一:低效解法(遍历+分解)
class Solution {
    int maxDiameter = 0;  // 记录最大直径

public:
    int diameterOfBinaryTree(TreeNode* root) {
        traverse(root);
        return maxDiameter;
    }

    // 遍历每个节点计算直径
    void traverse(TreeNode* root) {
        if (root == nullptr) return;
        // 前序位置:计算当前节点的直径
        int leftMax = maxDepth(root->left);
        int rightMax = maxDepth(root->right);
        maxDiameter = std::max(maxDiameter, leftMax + rightMax);

        traverse(root->left);
        traverse(root->right);
    }

    // 计算子树最大深度
    int maxDepth(TreeNode* root) {
        if (root == nullptr) return 0;
        return 1 + std::max(maxDepth(root->left), maxDepth(root->right));
    }
};
- 缺陷:时间复杂度 O(N²),因每个节点需重复计算子树深度。
思路二:优化解法(后序位置综合结果)
class Solution {
    int maxDiameter = 0;  // 记录最大直径

public:
    int diameterOfBinaryTree(TreeNode* root) {
        maxDepth(root);  // 计算深度的同时更新直径
        return maxDiameter;
    }

    // 计算深度时同步更新直径
    int maxDepth(TreeNode* root) {
        if (root == nullptr) return 0;

        int leftMax = maxDepth(root->left);
        int rightMax = maxDepth(root->right);

        // 后序位置:已获取左右子树深度,直接计算直径
        maxDiameter = std::max(maxDiameter, leftMax + rightMax);

        return 1 + std::max(leftMax, rightMax);
    }
};
- 优化点:后序位置同时处理深度计算和直径更新,时间复杂度降至 O(N)。
五、动规/回溯/DFS的区别与联系
从二叉树视角可清晰区分三种算法的核心关注点:
1. 动态规划(分解问题思路)
- 核心:关注整棵子树的结果,利用子树返回值推导当前节点结果
- 对应遍历位置:后序位置(需综合左右子树结果)
- 示例:计算二叉树节点总数
// 函数定义:输入二叉树,返回节点总数
int count(TreeNode* root) {
    if (root == nullptr) return 0;
    int leftCount = count(root->left);  // 左子树节点数
    int rightCount = count(root->right);  // 右子树节点数
    // 后序位置:综合子树结果
    return leftCount + rightCount + 1;  // 当前树总节点数 = 左 + 右 + 1
}
2. 回溯算法
- 核心:关注节点之间的"树枝"(路径选择),需记录选择并回溯
- 对应遍历位置:for循环内部(需明确路径的起点和终点)
- 示例:多叉树的回溯遍历
// 多叉树节点定义
class Node {
public:
    int val;
    std::vector<Node*> children;  // 子节点列表
    Node(int x) : val(x) {}
};

// 回溯算法框架
void backtrack(Node* root) {
    if (root == nullptr) return;
    for (Node* child : root->children) {
        // 做选择:记录从root到child的路径
        backtrack(child);  // 递归子节点
        // 撤销选择:清除路径记录
    }
}
3. DFS算法(遍历思路)
- 核心:关注单个节点的处理,不依赖子树结果(或仅需单向结果)
- 对应遍历位置:前序位置(处理节点本身)
- 示例:节点值加一操作
void traverse(TreeNode* root) {
    if (root == nullptr) return;
    // 前序位置:处理当前节点
    root->val++;
    traverse(root->left);
    traverse(root->right);
}
4. 关键区别:"做选择/撤销选择"的位置
-
DFS算法:选择逻辑在for循环外,关注节点本身
void dfs(Node* root) { if (root == nullptr) return; // 做选择:处理root for (Node* child : root->children) { dfs(child); } // 撤销选择:清理root的处理痕迹 } -
回溯算法:选择逻辑在for循环内,关注路径(树枝)
void backtrack(Node* root) {
    if (root == nullptr) return;
    for (Node* child : root->children) {
        // 做选择:记录root到child的路径
        backtrack(child);
        // 撤销选择:清除路径记录
    }
}
六、层序遍历的核心逻辑
层序遍历通过"双层循环"实现层级划分,外层控制深度,内层处理当前层节点:
// 层序遍历计算二叉树深度
int levelTraverse(TreeNode* root) {
    if (root == nullptr) return 0;
    std::queue<TreeNode*> q;
    q.push(root);
    int depth = 0;

    // 外层循环:控制层级(从上到下)
    while (!q.empty()) {
        int sz = q.size();  // 当前层节点数量
        // 内层循环:处理当前层所有节点(从左到右)
        for (int i = 0; i < sz; i++) {
            TreeNode* cur = q.front();
            q.pop();

            // 子节点入队,为下一层做准备
            if (cur->left != nullptr) q.push(cur->left);
            if (cur->right != nullptr) q.push(cur->right);
        }
        depth++;  // 当前层处理完毕,深度+1
    }
    return depth;
}
- 核心:通过
sz = q.size()固定当前层节点数,确保内层循环仅处理当前层节点,实现层级划分。
总结
二叉树问题的核心是理解前中后序位置的特性和两种解题思路的适用场景:
- 需综合左右子树结果 → 分解问题思路(后序位置)
- 需跟踪路径或状态 → 遍历思路(前序+后序回溯)
- 层序相关问题 → 队列实现的双层循环
掌握这些本质,可举一反三解决绝大多数二叉树及扩展问题。
二叉树思路篇
汇总前文二叉树思想核心纲领,解决二叉树问题的两种核心思维模式如下:
一、遍历的思维模式
核心本质
通过完整遍历二叉树的所有节点,在遍历过程中记录或计算所需信息,依赖外部变量(如全局变量、引用参数)存储中间结果,最终通过遍历结果得到答案。
适用场景
当问题需要收集所有节点的信息、跟踪遍历路径,或问题答案依赖于“遍历过程中的实时状态”时,优先使用遍历思维。例如:
- 计算二叉树所有节点的总和、平均值;
- 查找二叉树中是否存在某条路径和等于目标值;
- 收集二叉树中所有叶子节点的值;
- 记录节点的前/中/后序遍历序列。
操作步骤
- 定义一个
traverse递归函数,参数通常包含当前节点和用于记录结果的外部变量; - 在遍历的不同时机(前序/中序/后序位置)执行具体操作:
- 前序位置:进入节点时操作(如记录当前节点值到路径中);
- 中序位置:遍历左子树后、右子树前操作(如二叉搜索树中需在此位置处理节点值顺序);
- 后序位置:离开节点时操作(如从路径中移除当前节点,或汇总子树结果);
- 遍历完成后,外部变量中存储的即为最终答案。
关键特点
- 核心逻辑集中在“遍历过程中的操作”,不依赖子问题的返回值;
- 外部变量是结果的载体,递归函数本身可能无返回值(或返回值仅用于控制遍历流程)。
二、分解问题的思维模式
核心本质
将原问题分解为子树的子问题,通过定义递归函数的“返回值”,让子树的结果“自底向上”传递给父节点,最终由根节点的子问题结果推导得出原问题答案。
适用场景
当问题可以拆解为左子树和右子树的独立子问题,且父节点的答案可通过“左子树结果+右子树结果+当前节点操作”组合而成时,优先使用分解问题思维。例如:
- 求二叉树的最大深度(左子树深度与右子树深度的最大值+1);
- 判断二叉树是否为平衡树(左子树平衡且右子树平衡,且左右深度差≤1);
- 判断二叉树是否对称(左子树的左节点与右子树的右节点对称,左子树的右节点与右子树的左节点对称);
- 求二叉树中两个节点的最近公共祖先。
操作步骤
- 定义递归函数的返回值含义(明确子问题的输出是什么);
- 明确当前节点的答案如何通过“左子树的返回值”和“右子树的返回值”计算得出;
- 处理递归的边界条件(如空节点时的返回值);
- 最终通过根节点的递归函数返回值得到原问题答案。
关键特点
- 核心逻辑集中在“子问题结果的组合”,依赖递归函数的返回值传递信息;
- 无需外部变量,递归函数的返回值直接承载子问题的答案,体现“自底向上”的推导过程。
三、两种思维的共性原则
无论使用哪种思维模式,都需聚焦于单个节点的职责:
- 单独抽出一个二叉树节点,明确它需要做什么(是记录信息?还是计算子问题结果?);
- 明确操作的时机(前序/中序/后序位置)——前序适合“准备工作”,中序适合“中间处理”,后序适合“汇总结果”;
- 无需关心其他节点,递归机制会自动在所有节点上执行相同的逻辑。
本文就以几道比较简单的题目为例,带你实践运用这几条总纲,理解「遍历」的思维和「分解问题」的思维有何区别和联系。
第一题、翻转二叉树
我们先从简单的题开始,看看力扣第 226 题「翻转二叉树」,输入一个二叉树根节点 root,让你把整棵树镜像翻转,比如输入的二叉树如下:
要把整棵树镜像翻转, 实际上就是将每个节点的左右子树都翻转!
心中默念二叉树解题总纲要,两种思路:分解问题和遍历所有节点的思路。
遍历的思路
- 写一个traverse遍历所有节点,
- 每个节点要做什么?让他把自己的左右子节点交换!
- 前中后序,什么时机做?前中后都可以!什么时候都一样!因为不需要用到子树的返回结果,早晚都一样。
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */
class Solution {
public:
    TreeNode* invertTree(TreeNode* root) {
        traverse(root);
        return root;
    }

    void traverse(TreeNode* root) {
        if (root != nullptr) {

            // **** 前序位置 ****
            TreeNode* tmp = root->left;
            root->left = root->right;
            root->right = tmp;

            // 遍历左右子节点
            traverse(root->left);
            traverse(root->right);
        }
    }
};
一开始写成 void traverse(TreeNode* root) {
if (root == nullptr) return nullptr; 错喽!void!!traverse是遍历用的!!!
class Solution:
	# 主函数
	def invertTree(self, root):
		self.traverse(root)
		return root
	# 遍历二叉树
	def traverse(self, root):
		if not root:
			return

		# *** 前序位置 ***
		# 处理节点
		tmp = root.right
		root.right = root.left
		root.left = tmp

		# 遍历框架,遍历左右子树的节点
		self.traverse(root.left)
		self.traverse(root.right)
以上是遍历的思路 每遍历到一个新节点 就交换其左右子节点
分解问题的思想
原问题要我们用invertTree 函数将root翻转
// 定义:将以 root 为根的这棵二叉树翻转,返回翻转后的二叉树的根节点
TreeNode* invertTree(TreeNode* root);
invertTree(x) 要返回一个镜像翻转好的x!那就是先把x左子树翻转,x右子树翻转!然后翻转x本身!也就是把左子树接到右边!右子树接在 左边!
相当于把原来翻转整棵树的问题分解成了左右子树 以及 自身 三个子问题!
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */
class Solution {
public:
    TreeNode* invertTree(TreeNode* root) {
        if (root == nullptr) {
            return nullptr;
        }

        TreeNode* left = invertTree(root->left);
        TreeNode* right = invertTree(root->right);

        //
        root->right = left;
        root->left = right;

        return root;
    }
};
# Definition for a binary tree node.
# class TreeNode:
#     def __init__(self, val=0, left=None, right=None):
#         self.val = val
#         self.left = left
#          self.right = right
class Solution:
    def invertTree(self, root: Optional[TreeNode]) -> Optional[TreeNode]:
        # 当前节点的翻转结果  等于将下面节点翻转好!
        if not root:
            return None
        # 左右先翻转好
        left = self.invertTree(root.left)
        right = self.invertTree(root.right)

        # 接着对调换好的两个左右子树
        root.right = left
        root.left = right

        return root
分解问题」的思路,核心在于你要给递归函数一个合适的定义,然后用函数的定义来解释你的代码;如果你的逻辑成功自恰,那么说明你这个算法是正确的。
第二题、填充节点的右侧指针
这是力扣第 116 题「填充每个二叉树节点的右侧指针」,看下题目:
- 填充每个节点的下一个右侧节点指针 | 力扣 | LeetCode | 🟠
给定一个 完美二叉树 ,其所有叶子节点都在同一层,每个父节点都有两个子节点。二叉树定义如下:
struct Node {
int val;
Node *left;
Node *right;
Node *next;
}
填充它的每个 next 指针,让这个指针指向其下一个右侧节点。如果找不到下一个右侧节点,则将 next 指针设置为 NULL。
初始状态下,所有 next 指针都被设置为 NULL。
示例 1:
输入:root = [1,2,3,4,5,6,7]
输出:[1,#,2,3,#,4,5,6,7,#]
解释:给定二叉树如图 A 所示,你的函数应该填充它的每个 next 指针,以指向其下一个右侧节点,如图 B 所示。序列化的输出按层序遍历排列,同一层节点由 next 指针连接,‘#’ 标志着每一层的结束。
示例 2:
输入:root = []
输出:[]
提示:
树中节点的数量在 [0, 212 - 1] 范围内
-1000 <= node.val <= 1000
进阶:
你只能使用常量级额外空间。
使用递归解题也符合要求,本题中递归程序占用的栈空间不算做额外的空间复杂度。
这道题怎么做呢?来默念二叉树解题总纲:
1、这题能不能用「遍历」的思维模式解决?
很显然,一定可以。
每个节点要做的事也很简单,把自己的 next 指针指向右侧节点就行了。
也许你会模仿上一道题,直接写出如下代码:// 二叉树遍历函数
void traverse(TreeNode* root) {
if (root == NULL || root->left == NULL) {
return;
}
// 把左子节点的 next 指针指向右子节点
root->left->next = root->right;
traverse(root->left);
traverse(root->right);
}但是,这段代码其实有很大问题,因为它只能把相同父节点的两个节点穿起来,再看看这张图:
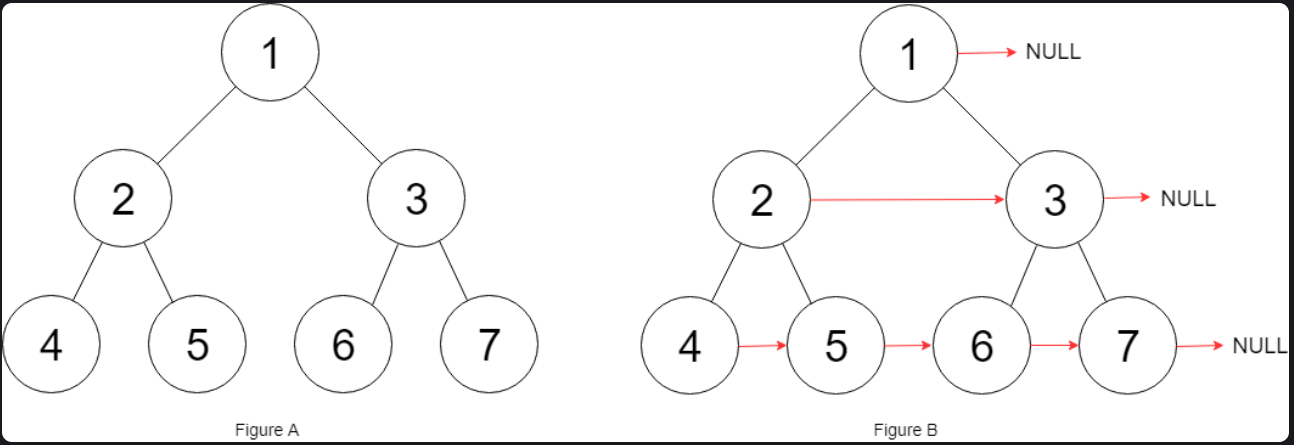
节点 5 和节点 6 不属于同一个父节点,那么按照这段代码的逻辑,它俩就没办法被穿起来,这是不符合题意的,但是问题出在哪里?
传统的 traverse 函数是遍历二叉树的所有节点,但现在我们想遍历的其实是两个相邻节点之间的「空隙」。
所以我们可以在二叉树的基础上进行抽象,你把图中的每一个方框看做一个节点: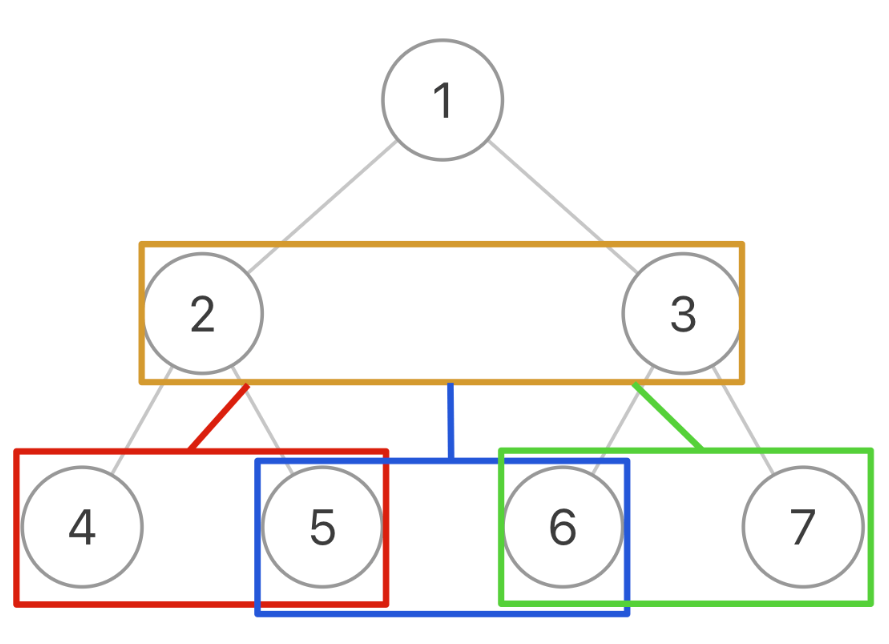
这样,一棵二叉树被抽象成了一棵三叉树,三叉树上的每个节点就是原先二叉树的两个相邻节点。
现在,我们只要实现一个 traverse 函数来遍历这棵三叉树,每个「三叉树节点」需要做的事就是把自己内部的两个二叉树节点穿起来:
很有意思的抽象为!!三叉树!!
/*
// Definition for a Node.
class Node {
public:
    int val;
    Node* left;
    Node* right;
    Node* next;

    Node() : val(0), left(NULL), right(NULL), next(NULL) {}

    Node(int _val) : val(_val), left(NULL), right(NULL), next(NULL) {}

    Node(int _val, Node* _left, Node* _right, Node* _next)
        : val(_val), left(_left), right(_right), next(_next) {}
};
*/

class Solution {
public:
    Node* connect(Node* root) {
        if (root == nullptr) return nullptr;
        traverse(root->left, root->right);
        return root;
    }

    void traverse(Node* n1, Node* n2) {
        if (n1 == nullptr || n2 == nullptr) return;
        n1->next = n2;
        // 遍历三叉树
        traverse(n1->left, n1->right);
        traverse(n1->right, n2->left);
        traverse(n2->left, n2->right);
    }
};
另一个与这里无关的思路是层序遍历
"""
# Definition for a Node.
class Node:
    def __init__(self, val: int = 0, left: 'Node' = None, right: 'Node' = None, next: 'Node' = None):
        self.val = val
        self.left = left
        self.right = right
        self.next = next
"""

class Solution:
    def connect(self, root: 'Optional[Node]') -> 'Optional[Node]':
        # 依旧是层序遍历,只不过在单层遍历时记录本层的头部节点
        # 然后再遍历时让前一个节点指向本节点即可
        if not root:
            return root

        queue = collections.deque([root])

        while queue:
            size = len(queue)
            prev = None

            for i in range(size):
                node = queue.popleft()

                if prev:
                    prev.next = node

                prev = node

                if node.left:
                    queue.append(node.left)
                if node.right:
                    queue.append(node.right)

        return root
这样,traverse 函数遍历整棵「三叉树」,将所有相邻节的二叉树节点都连接起来,也就避免了我们之前出现的问题,把这道题完美解决。
2、这题能不能用「分解问题」的思维模式解决?
嗯,好像没有什么特别好的思路,所以这道题无法使用「分解问题」的思维来解决。
第三题、将二叉树展开为链表
- 二叉树展开为链表 | 力扣 | LeetCode | 🟠
给你二叉树的根结点 root ,请你将它展开为一个单链表:
展开后的单链表应该同样使用 TreeNode ,其中 right 子指针指向链表中下一个结点,而左子指针始终为 null 。
展开后的单链表应该与二叉树 先序遍历 顺序相同。
示例 1:
输入:root = [1,2,5,3,4,null,6]
输出:[1,null,2,null,3,null,4,null,5,null,6]
示例 2:
输入:root = []
输出:[]
示例 3:
输入:root = [0]
输出:[0]
提示:
树中结点数在范围 [0, 2000] 内
-100 <= Node.val <= 100
进阶:你可以使用原地算法(O(1) 额外空间)展开这棵树吗?
题目来源:力扣 114. 二叉树展开为链表。
void traverse(TreeNode* root) {
- 遍历?
1、这题能不能用「遍历」的思维模式解决?
乍一看感觉是可以的:对整棵树进行前序遍历,一边遍历一边构造出一条「链表」就行了:// 虚拟头节点,dummy.right 就是结果
TreeNode* dummy = new TreeNode(-1);
// 用来构建链表的指针
TreeNode* p = dummy;
void traverse(TreeNode* root) {
if (root == nullptr) {
return;
}
// 前序位置
p->right = new TreeNode(root->val);
p = p->right;
traverse(root->left);
traverse(root->right);
}
但是注意 flatten 函数的签名,返回类型为 void,也就是说题目希望我们在原地把二叉树拉平成链表。
这样一来,没办法通过简单的二叉树遍历来解决这道题了。
分解问题+ 递归?
分析题意与函数签名定义:
// 主函数定义:输入节点root,然后以节点root为根的二叉树会被拉平为一条链表
void flatten(TreeNode* root);
假设flatten作用于x flatten(x) 作用是拉平以x为根的二叉树!假设flatten 也作用于 x的左右子树 并且后序位置 操作x !
则flatten逻辑是! 拉平好的左右子树变成左右子链!然后把拉好的左链子先连在x上 接着把右链连上左链!
这样就成功拉平了以x为根节点的树!!
关键逻辑就在于 后序位置进行处理!
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */
class Solution {
public:
    void flatten(TreeNode* root) {
        if (root == nullptr) {
            return;
        }

        flatten(root->left); // 注意这里flatten是void类型!!!
        flatten(root->right);

        TreeNode* left = root->left;
        TreeNode* right = root->right;

        root->left = nullptr;
        root->right = left;
        TreeNode* p = root;
        while (p->right != nullptr) {
            p = p->right;
        }
        p->right = right;
    }
};
还有个迭代的方法,这里不作为重点(但是豆包帮我给这个解法写上详细注释!写下这个解法的思路!)
# Definition for a binary tree node.
# class TreeNode:
#     def __init__(self, val=0, left=None, right=None):
#         self.val = val
#         self.left = left
#         self.right = right
class Solution:
    def flatten(self, root: Optional[TreeNode]) -> None:
        """
        Do not return anything, modify root in-place instead.
        """
        """
        一、遍历所有节点
            1. 检查当前根节点有无左子树
                (1) 若有,找到当前左子树的右节点left_most_right
                (2) 将当前根节点的右子树 接到 left_most_right后面
                (3) 将当前根节点的左子树接到根节点的右子树位置
            2. root = root.right
        """
        if root is None:
            None
        cur = root
        while cur:
            if cur.left: # 左子树不为空?
                most_right_node = cur.left
                # 找到当前左子树最右的节点
                while most_right_node.right:
                    most_right_node = most_right_node.right
                #
                most_right_node.right = cur.right

                cur.right = cur.left

                cur.left = None
            cur = cur.right
二叉树构造篇
前面讲了「遍历」和「分解问题」两种思维方式
二叉树的构造问题一般都是使用「分解问题」的思路:构造整棵树 = 根节点 + 构造左子树 + 构造右子树。
第一题比较简单!
654. 最大二叉树 | 力扣 | LeetCode | 🟠
给定一个不重复的整数数组 nums 。 最大二叉树 可以用下面的算法从 nums 递归地构建:
创建一个根节点,其值为 nums 中的最大值。
递归地在最大值 左边 的 子数组前缀上 构建左子树。
递归地在最大值 右边 的 子数组后缀上 构建右子树。
返回 nums 构建的 最大二叉树 。
示例 1:
输入:nums = [3,2,1,6,0,5]
输出:[6,3,5,null,2,0,null,null,1]
解释:递归调用如下所示:
- [3,2,1,6,0,5] 中的最大值是 6 ,左边部分是 [3,2,1] ,右边部分是 [0,5] 。
- [3,2,1] 中的最大值是 3 ,左边部分是 [] ,右边部分是 [2,1] 。
- 空数组,无子节点。
- [2,1] 中的最大值是 2 ,左边部分是 [] ,右边部分是 [1] 。
- 空数组,无子节点。
- 只有一个元素,所以子节点是一个值为 1 的节点。
- [0,5] 中的最大值是 5 ,左边部分是 [0] ,右边部分是 [] 。
- 只有一个元素,所以子节点是一个值为 0 的节点。
- 空数组,无子节点。
示例 2:
- [3,2,1] 中的最大值是 3 ,左边部分是 [] ,右边部分是 [2,1] 。
输入:nums = [3,2,1]
输出:[3,null,2,null,1]
提示:
1 <= nums.length <= 1000
0 <= nums[i] <= 1000
nums 中的所有整数 互不相同
用python写非常简单!因为由index和切片!
# Definition for a binary tree node.
# class TreeNode:
#     def __init__(self, val=0, left=None, right=None):
#         self.val = val
#         self.left = left
#         self.right = right
class Solution:
    def constructMaximumBinaryTree(self, nums: List[int]) -> Optional[TreeNode]:
        if not nums: return None
        split_idx = nums.index(max(nums))
        left = self.constructMaximumBinaryTree(nums[:split_idx])
        right = self.constructMaximumBinaryTree(nums[split_idx + 1:])
        return TreeNode(max(nums), left, right)
python!缩进要统一!全用空格或者tab!
c++ 代码就有点麻烦了!python的切片和api确实好用!index max!cpp里面都要自己实现!
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */
class Solution {
public:
    TreeNode* constructMaximumBinaryTree(vector<int>& nums) {
        // 分解问题的思路
        return build(nums, 0, nums.size() - 1);
    }

    TreeNode* build(vector<int>& nums, int lo, int hi) {
        // base case?
        if (nums.empty() || lo > hi) return nullptr;

        // 找出 lo 到 hi 范围的 max值 以及对应的索引idx
        int idx = -1;
        int max_x = INT_MIN;
        for (int i = lo ; i <= hi; i++) {
            if (nums[i] > max_x) {
                idx = i;
                max_x = nums[i];
            }
        }

        TreeNode* left = build(nums, 0, idx - 1);
        TreeNode* right = build(nums, idx + 1, nums.size() - 1);
        TreeNode* root = new TreeNode(max_x, left, right);

        return root;
    }
};
这样写一直过不了!!后来才发现
TreeNode* left = build(nums, 0, idx - 1);
TreeNode* right = build(nums, idx + 1, nums.size() - 1);
这两句写错了!注意范围是lo到hi!!!
写成
TreeNode* root = new TreeNode(max_x);
    root->left = build(nums, lo, idx - 1);
    root->right = build(nums, idx + 1, hi);

    return root;
马上过了!
那写成
    TreeNode* left = build(nums, lo, idx - 1);
    TreeNode* right = build(nums, idx + 1, hi);
    TreeNode* root = new TreeNode(max_x, left, right);

    return root;
也过了!!!
注意两种写法都可以!!
(豆包把这些纠错 思考 尝试过程都写下来!)
通过前序和中序遍历结果构造二叉树
面试笔试中常考:
- 从前序与中序遍历序列构造二叉树 | 力扣 | LeetCode | 🟠
给定两个整数数组 preorder 和 inorder ,其中 preorder 是二叉树的先序遍历, inorder 是同一棵树的中序遍历,请构造二叉树并返回其根节点。
示例 1:
输入: preorder = [3,9,20,15,7], inorder = [9,3,15,20,7]
输出: [3,9,20,null,null,15,7]
示例 2:
输入: preorder = [-1], inorder = [-1]
输出: [-1]
提示:
1 <= preorder.length <= 3000
inorder.length == preorder.length
-3000 <= preorder[i], inorder[i] <= 3000
preorder 和 inorder 均 无重复 元素
inorder 均出现在 preorder
preorder 保证 为二叉树的前序遍历序列
inorder 保证 为二叉树的中序遍历序列
题目来源:力扣 105. 从前序与中序遍历序列构造二叉树。
// 函数签名如下
TreeNode* buildTree(vector<int>& preorder, vector<int>& inorder);
有了前面一道题做参考!其实构造二叉树就是找到根节点 做出来 然后 递归构造左右子树就可以了!
preorder inorder 各有什么特点?
void traverse(TreeNode* root) {
    if(root == NULL)
        return;
    // 前序遍历
    preorder.push_back(root->val);
    traverse(root->left);
    traverse(root->right);
}

void traverse(TreeNode* root) {
    if(root == NULL)
        return;
    traverse(root->left);
    // 中序遍历
    inorder.push_back(root->val);
    traverse(root->right);
}
preorder 和 inorder 数组中的元素分布有如下特点: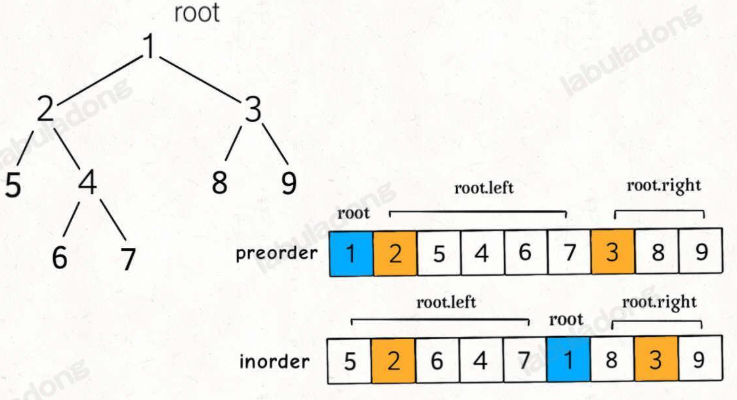
找到根节点非常简单!前序遍历preorder的第一个值preorder[0] 就是根节点的值!
关键在于我们要如何通过根节点的值,将preorder 和 inorder 数组划分成两半,递归地构造根节点的左右子树?
创建一个build辅助函数,输入两种遍历preorder 和 inorder ,递归的构造左右子树,然后拼在root上,
关键在于每次递归构造时,如何选定左右子树的范围!即要对前序和中序遍历中哪一段代表左右子树非常了解!
根据分解问题 + 递归构造的思路可以写出一下代码!
现在最大的问题是? 处该怎么填??
TreeNode* buildTree(vector<int>& preorder, vector<int>& inorder) {
	// 根据函数定义,用 preorder 和 inorder 构造二叉树
	return build(preorder, 0, preorder.size() - 1,
                inorder, 0, inorder.size() - 1);
}

// build函数定义:
// 如果前序遍历数组为preorder[preST, preEND]
// 如果中序遍历数组为inorder[inST, preEND]
TreeNode* build(vector<int>& preorder, int preStart, int preEnd,
				vector<int>& inorder, int inStart, int inEnd) {
	// base case?
	if ()
	// root 节点对应的值就是前序遍历数组的第一个!
	int rootVal = preorder[preStart];
	int index;
	// 找到中序遍历中rootVal的索引!
	for (int i = inStart; i <= inEnd; i++) {
		if (inorder[i] == rootVal) {
			index = i;
			break;
		}
	}
	// 这里的关键是利用index得到左子树的节点数量
	int leftSize() = index - inStart;
	// 构造根节点,递归构造子树
	TreeNode* root = new TreeNode(rootVal);
	root->left = build(preorder, ???, ???,
						inorder, ???, ???);
	root->right = build(preorder, ???, ???,
						inorder, ???, ???);
	return root;
}
用for循环缺点index效率不高
可以进一步优化!
由于题干说到元素不重复,所以可以用哈希表来存储所有值,这样就快速的通过哈希表来查询index
// 存储 inorder 中值到索引的映射
unordered_map<int, int> valToIndex;

TreeNode* buildTree(vector<int>& preorder, vector<int>& inorder) {
    for (int i = 0; i < inorder.size(); i++) {
        valToIndex[inorder[i]] = i;
    }
    return build(preorder, 0, preorder.size() - 1,
                 inorder, 0, inorder.size() - 1);
}

TreeNode* build(vector<int>& preorder, int preStart, int preEnd,
                vector<int>& inorder, int inStart, int inEnd) {
    int rootVal = preorder[preStart];
    // 避免 for 循环寻找 rootVal
    int index = valToIndex[rootVal];
    // ...
}
下面就是填空题!
	root->left = build(preorder, ???, ???,
						inorder, ???, ???);
	root->right = build(preorder, ???, ???,
						inorder, ???, ???);
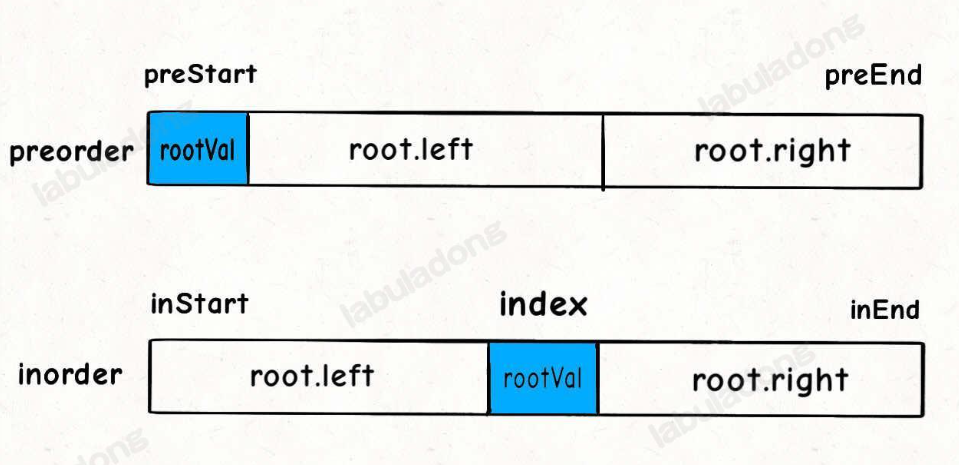
对于左右子树对应的 inorder 数组的起始索引和终止索引比较容易确定:
inorder:【inStart …index-1, index, index+1,…inEnd】
inStart …index-1 是左子树
index+1,…inEnd是右子树
index处是根节点
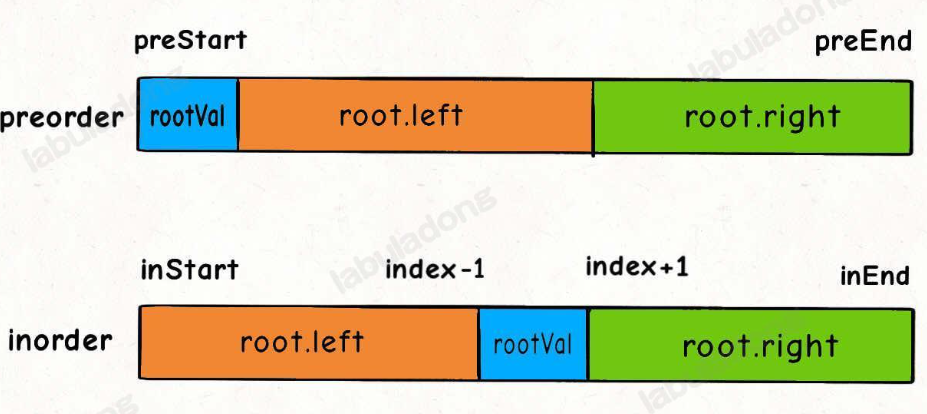
对于preorder?利用好left_size!通过index可以方便的计算left_size!
left_size = index - inStart
preorder:【preStart,preStart+1 …preStart+left_size,preStart + left_size + 1…preEnd】
preStart处是根节点
preStart+1 …preStart+left_size 是左子树
preStart + left_size + 1…preEnd 是右子树!
int leftSize = index - inStart;

root.left = build(preorder, preStart + 1, preStart + leftSize,
                  inorder, inStart, index - 1);

root.right = build(preorder, preStart + leftSize + 1, preEnd,
                   inorder, index + 1, inEnd);
看着参数多,实际上只是控制数组的起止位置罢了!
class Solution {
public:
	// 全局变量 哈希表 valToIndex 存储 索引映射!
	unordered_map<int, int> valToIndex;

	//
	TreeNode* buildTree(vector<int>& preorder, vector<int>& inorder) {
	    	// 存入哈希表, 全局变量, 另一个辅助函数也可以修改!
    	for (int i = 0; i < inorder.size(); i++) {
    		valToIndex[inorder[i]] = i;
    	}
    	return build(preorder, 0, preorder.size() - 1,
    					inorder, 0, inorder.size() - 1);

	TreeNode* build(vector<int>& preorder, int preStart, int preEnd,
                    vector<int>& inorder, int inStart, int inEnd) {
    	// base case!?
    	if (preStart > preEnd) {
    		return NULL;
    	}


		// 避免for循环找index!
		int rootVal = preorder[preStart];
		int index = valToIndex[rootVal];
		int leftSize = index - inStart;
		// 先构造当前根节点
		TreeNode* root = new TreeNode(rootVal);
		// 递归构造左右子树
		root->left = build(preorder, preStart + 1, preStart + leftSize
							inorder, inStart, index - 1);
		root->right = build(preorder, preStart + leftSize + 1, preEnd
							inorder, index + 1, inEnd);
		return root;
通过后序和中序遍历结果构造二叉树
类似上一题,这次我们利用后序和中序遍历的结果数组来还原二叉树,这是力扣第 106 题「从后序和中序遍历序列构造二叉树」:
- 从中序与后序遍历序列构造二叉树 | 力扣 | LeetCode | 🟠
给定两个整数数组 inorder 和 postorder ,其中 inorder 是二叉树的中序遍历, postorder 是同一棵树的后序遍历,请你构造并返回这颗 二叉树 。
示例 1:
输入:inorder = [9,3,15,20,7], postorder = [9,15,7,20,3]
输出:[3,9,20,null,null,15,7]
示例 2:
输入:inorder = [-1], postorder = [-1]
输出:[-1]
提示:
1 <= inorder.length <= 3000
postorder.length == inorder.length
-3000 <= inorder[i], postorder[i] <= 3000
inorder 和 postorder 都由 不同 的值组成
postorder 中每一个值都在 inorder 中
inorder 保证是树的中序遍历
postorder 保证是树的后序遍历
题目来源:力扣 106. 从中序与后序遍历序列构造二叉树。
这道题跟上面的几乎一样!
因为后序遍历
void traverse(TreeNode* root) {
if (root == NULL) return;
traverse(root->left);
traverse(root->right);

// 后序遍历
postorder.push_back(root->val);
}
void traverse(TreeNode* root) {
if (root == NULL) return;
traverse(root->left);

// 中序遍历
inorder.push_back(root->val);

traverse(root->right);
}
postorder 和 inorder 数组中的元素分布有如下特点: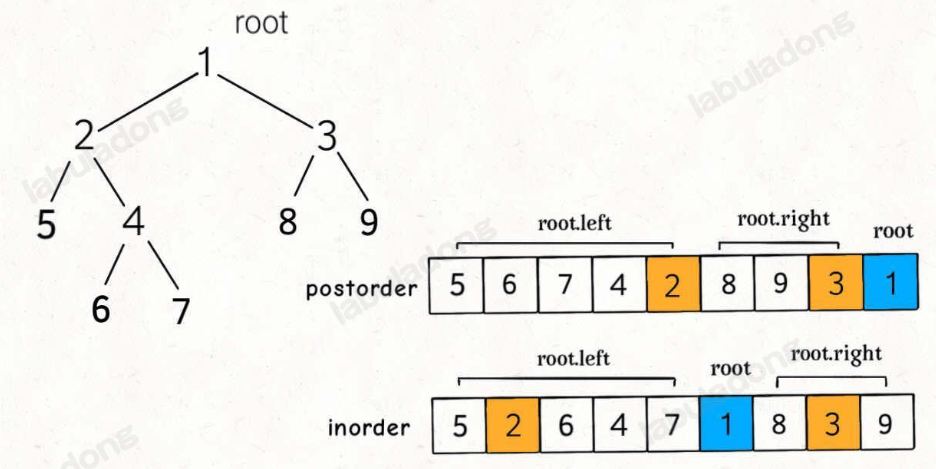
postorder是先遍历左子树 右子树 最后根节点!所以最后一个元素postorder[-1]就是根节点!
然后套路基本差不多,到inorder中寻找根节点索引!
计算leftSize!
然后postorder 的 索引0(poststart) 到索引poststart + leftSize - 1 这leftSize长度的数组就是左子树!
接着 postorder 索引 到 倒数第二个元素
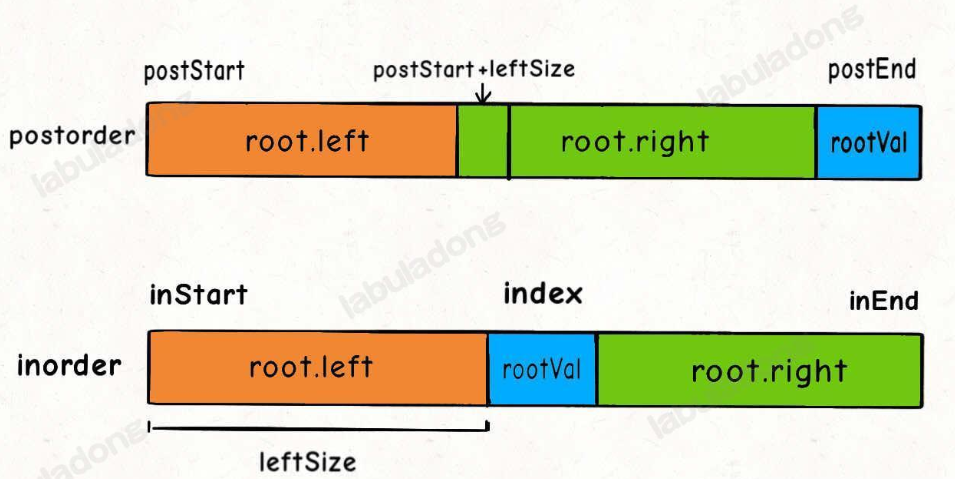
class Solution {
    // 存储 inorder 中值到索引的映射
    unordered_map<int, int> valToIndex;

public:
    TreeNode* buildTree(vector<int>& inorder, vector<int>& postorder) {
        for (int i = 0; i < inorder.size(); i++) {
            valToIndex[inorder[i]] = i;
        }
        return build(inorder, 0, inorder.size() - 1,
                     postorder, 0, postorder.size() - 1);
    }

    // 定义:中序遍历数组为 inorder[inStart..inEnd],
    // 后序遍历数组为 postorder[postStart..postEnd],
    // build 函数构造这个二叉树并返回该二叉树的根节点
    TreeNode* build(vector<int>& inorder, int inStart, int inEnd,
                    vector<int>& postorder, int postStart, int postEnd) {

        if (inStart > inEnd) {
            return nullptr;
        }
        // root 节点对应的值就是后序遍历数组的最后一个元素
        int rootVal = postorder[postEnd];
        // rootVal 在中序遍历数组中的索引
        int index = valToIndex[rootVal];
        // 左子树的节点个数
        int leftSize = index - inStart;
        TreeNode* root = new TreeNode(rootVal);

        // 递归构造左右子树
        root->left = build(inorder, inStart, index - 1,
                           postorder, postStart, postStart + leftSize - 1);

        root->right = build(inorder, index + 1, inEnd,
                            postorder, postStart + leftSize, postEnd - 1);
        return root;
    }
};
有了前一题的铺垫,这道题很快就解决了,无非就是 rootVal 变成了最后一个元素,再改改递归函数的参数而已,只要明白二叉树的特性,也不难写出来。
通过后序和前序遍历结果构造二叉树
这是力扣第 889 题「根据前序和后序遍历构造二叉树」,给你输入二叉树的前序和后序遍历结果,让你还原二叉树的结构。
函数签名如下:TreeNode* constructFromPrePost(vector& preOrder, vector& postOrder);
注意 这道题跟前面的有本质区别!!那就是 通过后序和前序遍历结果构造的二叉树结果不唯一!!
如果有多种可能的还原结果,你可以返回任意一种。构建二叉树的套路很简单,先找到根节点,然后找到并递归构造左右子树即可。
前两道题,可以通过前序或者后序遍历结果找到根节点,然后根据中序遍历结果确定左右子树(题目说了树中没有 val 相同的节点)。
用后序遍历和前序遍历结果还原二叉树,解法逻辑上和前两道题差别不大,也是通过控制左右子树的索引来构建:
- 首先可以确定的是前序遍历第一个元素 或者 后序遍历最后一个节点 是根节点!
- 假设前序遍历第二个元素是左子树根节点值(可能不存在左子树,所以”假设“ 所以前序和后序构造的二叉树不唯一!)
- 后序遍历中找到前面假设的左子树根节点的值,确定其索引,进而确定左子树数组长度,进而确定左子树范围和右子树范围
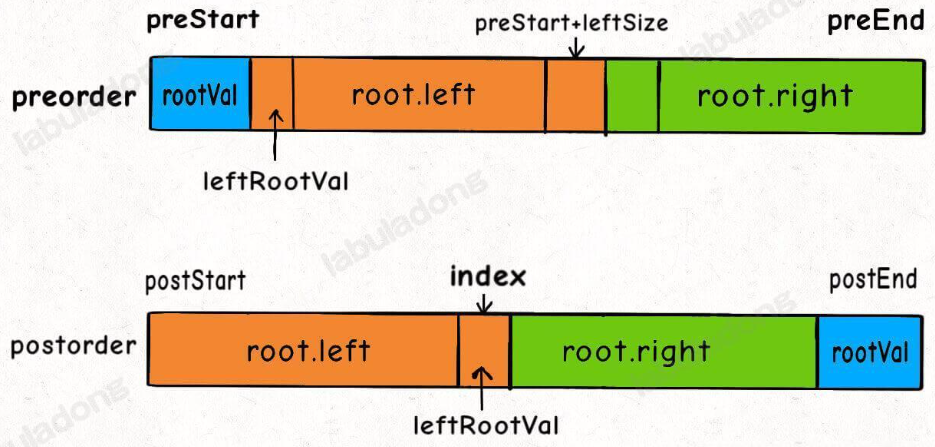
class Solution {
    // 存储 postorder 中值到索引的映射
    unordered_map<int, int> valToIndex;
public:
    TreeNode* constructFromPrePost(vector<int>& preorder, vector<int>& postorder) {
		// 哈希表存储post的索引!
        for (int i = 0; i < postorder.size(); i++) {
            valToIndex[postorder[i]] = i;
        }
        return build(preorder, 0, preorder.size() - 1,
                    postorder, 0, postorder.size() - 1);
	}
    // 定义:根据 preorder[preStart..preEnd] 和 postorder[postStart..postEnd]
    TreeNode* build(vector<int>& preorder, int preStart, int preEnd,
                   vector<int>& postorder, int postStart, int postEnd) {
        if (preStart > preEnd) {
            return nullptr;
        }
        if (preStart == preEnd) {
            return new TreeNode(preorder[preStart]);
        }

        // root 节点对应的值就是前序遍历数组的第一个元素
        int rootVal = preorder[preStart];
        // root.left 的值是前序遍历第二个元素
        // 通过前序和后序遍历构造二叉树的关键在于通过左子树的根节点
        // 确定 preorder 和 postorder 中左右子树的元素区间
        int leftRootVal = preorder[preStart + 1];
        // leftRootVal 在后序遍历数组中的索引
        int index = valToIndex[leftRootVal];
        // 左子树的元素个数
        int leftSize = index - postStart + 1;

        // 先构造出当前根节点
        TreeNode* root = new TreeNode(rootVal);

        // 递归构造左右子树
        // 根据左子树的根节点索引和元素个数推导左右子树的索引边界
        root->left = build(preorder, preStart + 1, preStart + leftSize,
                postorder, postStart, index);
        root->right = build(preorder, preStart + leftSize + 1, preEnd,
                postorder, index + 1, postEnd - 1);

        return root;
    }
};
为什么通过前序遍历和后序遍历结果还原的二叉树可能不唯一呢?
关键在这一句:
int leftRootVal = preorder[preStart + 1];
我们假设前序遍历的第二个元素是左子树的根节点,但实际上左子树有可能是空指针,那么这个元素就应该是右子树的根节点。由于这里无法确切进行判断,所以导致了最终答案的不唯一。
至此,通过前序和后序遍历结果还原二叉树的问题也解决了。
最后呼应下前文,二叉树的构造问题一般都是使用「分解问题」的思路:构造整棵树 = 根节点 + 构造左子树 + 构造右子树。先找出根节点,然后根据根节点的值找到左右子树的元素,进而递归构建出左右子树。
还有个关键点!!
不太能明白最后一题的 base case 里的这条的逻辑是啥……
if (preStart === preEnd) {
  return new TreeNode(preorder[preStart]);
}
@jswxwxf 这条也是 base case,即数组中只有一个元素时,直接构建出这个节点。
之所以前两道题目中没有这个逻辑,直接把空指针作为 base case,主要是因为这道题的解法后面有这样一段代码:
int leftRootVal = preorder[preStart + 1];
为了要保证索引不越界,必须保证 preStart + 1 <= preEnd,即 preStart < preEnd,所以要把 preStart == preEnd 的情况作为 base case 单独处理。
如果你去掉这一句,应该会报索引越界的错误。
为啥前序后序那需要判断preStart == preEnd呢 前面几道题的咋不需要因为本题和前两个题最大的不同之处就是需要在preorder中找到左根节点呀,也就是preorder[preStart+1],如果不加这个判断语句那么如果preStart指针与preEnd指针都在同一处也就是仅剩一个节点的情况时,你这个preStart+1不就数组越界了吗。下面的这些逻辑判断都是默认节点数目大于等于2个的时候且preStart != preEnd的时候才能进行,要不你都找不到左根节点,接下来的操作就没有意义了呀。
二叉树心法(序列化篇)
序列化和反序列化,得先从 JSON 数据格式说
本文是承接
二叉树心法(纲领篇) 的第三篇文章,前文
二叉树心法(构造篇) 带你学习了二叉树构造技巧,本文加大难度,让你对二叉树同时进行「序列化」和「反序列化」。
JSON 的运用非常广泛,比如我们经常将编程语言中的结构体序列化成 JSON 字符串,存入缓存或者通过网络发送给远端服务,消费者接受 JSON 字符串然后进行反序列化,就可以得到原始数据了。
这就是序列化和反序列化的目的,以某种特定格式组织数据,使得数据可以独立于编程语言。
那么假设现在有一棵用 Java 实现的二叉树,我想把它通过某些方式存储下来,然后用 C++ 读取这棵并还原这棵二叉树的结构,怎么办?这就需要对二叉树进行序列化和反序列化了
零、前/中/后序和二叉树的唯一性
唯一性与空指针信息有关!
先思考一个问题:什么样的序列化的数据可以反序列化出唯一的一棵二叉树?
比如说,如果给你一棵二叉树的前序遍历结果,你是否能够根据这个结果还原出这棵二叉树呢?
答案是也许可以,也许不可以,具体要看你给的前序遍历结果是否包含空指针的信息。如果包含了空指针,那么就可以唯一确定一棵二叉树,否则就不行。
举例来说,如果我给你这样一个不包含空指针的前序遍历结果 [1,2,3,4,5],那么如下两棵二叉树都是满足这个前序遍历结果的:
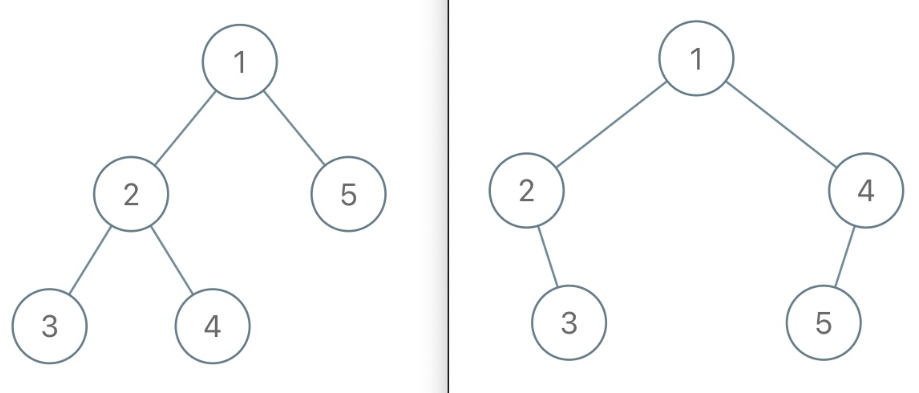
给定不包含空指针信息的前序遍历结果,是不能还原出唯一的一棵二叉树的。
但如果我的前序遍历结果包含空指针的信息,那么就能还原出唯一的一棵二叉树了。比如说用 # 表示空指针,上图左侧的二叉树的前序遍历结果就是 [1,2,3,#,#,4,#,#,5,#,#],上图右侧的二叉树的前序遍历结果就是 [1,2,#,3,#,#,4,5,#,#,#],它俩就区分开了。
即便你包含了空指针的信息,也只有前序和后序的遍历结果才能唯一还原二叉树,中序遍历结果做不到。
简单说下原因:因为前序/后序遍历的结果中,可以确定根节点的位置,而中序遍历的结果中,根节点的位置是无法确定的。
更直观的,比如如下两棵二叉树显然拥有不同的结构,但它俩的中序遍历结果都是 [#,1,#,1,#],无法区分:
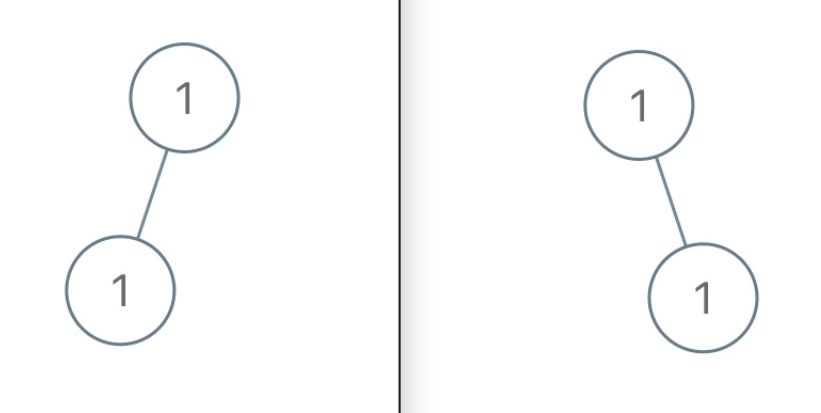
总结下结论,当二叉树中节点的值不存在重复时:
如果你的序列化结果中不包含空指针的信息,且你只给出一种遍历顺序,那么你无法还原出唯一的一棵二叉树。
如果你的序列化结果中不包含空指针的信息,且你会给出两种遍历顺序,分两种情况:
2.1. 如果你给出的是前序和中序,或者后序和中序,那么你可以还原出唯一的一棵二叉树。
2.2. 如果你给出前序和后序,那么你无法还原出唯一的一棵二叉树。
如果你的序列化结果中包含空指针的信息,且你只给出一种遍历顺序,也要分两种情况:
3.1. 如果你给出的是前序或者后序,那么你可以还原出唯一的一棵二叉树。
3.2. 如果你给出的是中序,那么你无法还原出唯一的一棵二叉树。
力扣第 297 题「二叉树的序列化与反序列化」就是给你输入一棵二叉树的根节点 root,要求你实现如下一个类:
class Codec {
public:
    // 把一棵二叉树序列化成字符串
    string serialize(TreeNode* root);

    // 把字符串反序列化成二叉树
    TreeNode* deserialize(string data);
};
用 serialize 方法将二叉树序列化成字符串,用 deserialize 方法将序列化的字符串反序列化成二叉树,至于以什么格式序列化和反序列化,这个完全由你决定。
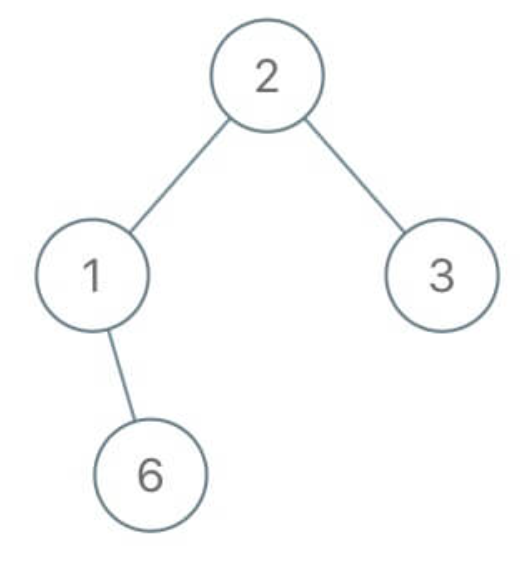
serialize 方法也许会把它序列化成字符串 2,1,#,6,#,#,3,#,#,其中 # 表示 null 指针,那么把这个字符串再输入 deserialize 方法,依然可以还原出这棵二叉树。
也就是说,这两个方法会成对儿使用,你只要保证他俩能够自洽就行了。
想象一下,二叉树是一个二维平面内的结构,而序列化出来的字符串是一个线性的一维结构。所谓的序列化不过就是把结构化的数据「打平」,本质就是在考察二叉树的遍历方式。
二叉树的遍历方式有哪些?递归遍历方式有前序遍历,中序遍历,后序遍历;迭代方式一般是层级遍历。本文就把这些方式都尝试一遍,来实现 serialize 方法和 deserialize 方法
前序遍历解法
在前序位置收集节点,即可获得前序遍历结果:
后序遍历解法
中序遍历可以解么?
层序遍历解法
二叉树心法(后序篇) 后序妙用!
复述下前文关于后序遍历的描述:
前序位置的代码只能从函数参数中获取父节点传递来的数据,而后序位置的代码不仅可以获取参数数据,还可以获取到子树通过函数返回值传递回来的数据。
那么换句话说,一旦你发现题目和子树有关,那大概率要给函数设置合理的定义和返回值,在后序位置写代码了。
看题,这是力扣第 652 题「寻找重复的子树」:
- 寻找重复的子树 | 力扣 | LeetCode | 🟠
给你一棵二叉树的根节点 root ,返回所有 重复的子树 。
对于同一类的重复子树,你只需要返回其中任意 一棵 的根结点即可。
如果两棵树具有 相同的结构 和 相同的结点值 ,则认为二者是 重复 的。
示例 1:
输入:root = [1,2,3,4,null,2,4,null,null,4]
输出:[[2,4],[4]]
示例 2:
输入:root = [2,1,1]
输出:[[1]]
示例 3:
输入:root = [2,2,2,3,null,3,null]
输出:[[2,3],[3]]
提示:
树中的结点数在 [1, 5000] 范围内。
-200 <= Node.val <= 200
老套路,先思考,对于某一个节点,它应该做什么。
比如说,你站在图中这个节点 2 上: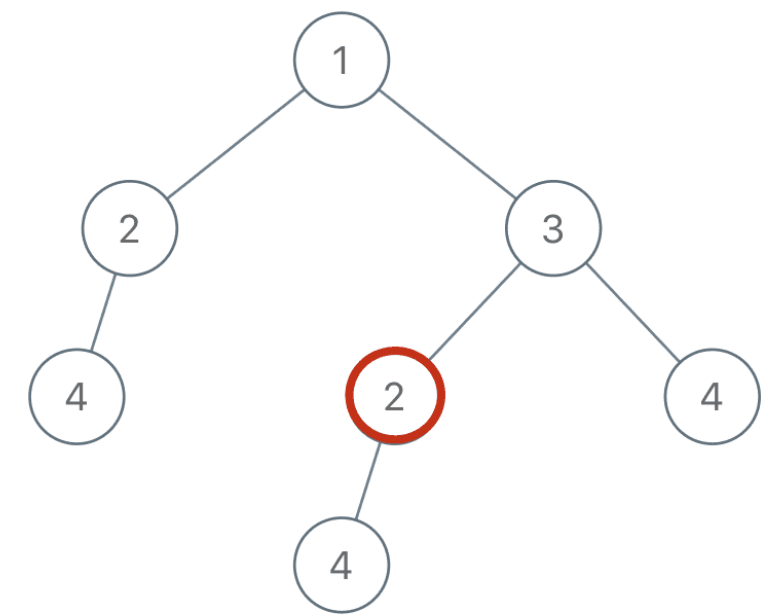
想知道以自己为根的子树是不是重复的,是否应该被加入结果列表中,你需要知道什么信息?
你需要知道以下两点:
1、以我为根的这棵二叉树(子树)长啥样?
2、以其他节点为根的子树都长啥样?
首先来思考,我如何才能知道以自己为根的这棵二叉树长啥样?
其实想到这里,就可以判断本题需要在二叉树的后序位置写代码了。
为什么?很简单呀,我要知道以自己为根的子树长啥样,是不是得先知道我的左右子树长啥样,再加上自己,就构成了整棵子树的样子?左右子树的样子,可不就得在后序位置通过递归函数的返回值传递回来吗?
举个非常简单的例子:计算一棵二叉树有多少个节点。
// 定义:输入一棵二叉树,返回这棵二叉树的节点总数
int count(TreeNode* root) {
    if (root == nullptr) {
        return 0;
    }
    // 当前节点关心的是两个子树的节点总数分别是多少
    // 因为用子问题的结果可以推导出原问题的结果
    int leftCount = count(root->left);
    int rightCount = count(root->right);
    // 后序位置,左右子树节点数加上自己就是整棵树的节点数
    return leftCount + rightCount + 1;
}
标准的后序遍历框架嘛,和我们本题在本质上没啥区别对吧。
现在,明确了要用后序遍历,那应该怎么描述一棵二叉树的模样呢?
更多推荐


 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)