
Quartz调度原理
问题:
1、Job没有继承Thread和实现Runnable,是怎么被调用的?通过反射还是什么?
2、任务是什么时候被调度的?是谁在监视任务还是监视Trigger?
3、任务是怎么被调用的?谁执行了任务?
4、任务本身有状态吗?还是触发器有状态?
看源码的入口
Scheduler scheduler = factory.getScheduler();
scheduler.scheduleJob(jobDetail, trigger);
scheduler.start();
获取调度器实例
读取配置文件
public Scheduler getScheduler() throws SchedulerException {
  if (cfg == null) {
    // 读取quartz.properties配置文件
    initialize();
 }
  // 这个类是一个HashMap,用来基于调度器的名称保证调度器的唯一性
  SchedulerRepository schedRep = SchedulerRepository.getInstance();

  Scheduler sched = schedRep.lookup(getSchedulerName());
  // 如果调度器已经存在了
  if (sched != null) {
    // 调度器关闭了,移除
    if (sched.isShutdown()) {
      schedRep.remove(getSchedulerName());
   } else {
      // 返回调度器
      return sched;
   }
 }

  // 调度器不存在,初始化
  sched = instantiate();

  return sched;
 }
instantiate()方法中做了初始化的所有工作:
// 存储任务信息的JobStore
 JobStore js = null;
 // 创建线程池,默认是SimpleThreadPool
 ThreadPool tp = null;
 // 创建调度器
 QuartzScheduler qs = null;
 // 连接数据库的连接管理器
 DBConnectionManager dbMgr = null;
 // 自动生成ID
 // 创建线程执行器,默认为DefaultThreadExecutor
 ThreadExecutor threadExecutor;
创建线程池(包工头)
830行和839行,创建了一个线程池,默认是配置文件中指定的SimpleThreadPool。
String tpClass = cfg.getStringProperty(PROP_THREAD_POOL_CLASS, SimpleThreadPool.class.getName());
 tp = (ThreadPool) loadHelper.loadClass(tpClass).newInstance();
SimpleThreadPool里面维护了三个list,分别存放所有的工作线程、空闲的工作线程和忙碌的工作线程。我们可以把SimpleThreadPool理解为包工头。
private List<WorkerThread> workers;
 private LinkedList<WorkerThread> availWorkers = new LinkedList<WorkerThread>();
 private LinkedList<WorkerThread> busyWorkers = new LinkedList<WorkerThread>();
tp的runInThread()方法是线程池运行线程的接口方法。参数Runnable是执行的任务内容。
取出WorkerThread去执行参数里面的runnable(JobRunShell)。
WorkerThread wt = (WorkerThread)availWorkers.removeFirst();
 busyWorkers.add(wt);
 wt.run(runnable);
WorkerThread(工人)
WorkerThread是SimpleThreadPool的内部类,用来执行任务。我们把WorkerThread理解为工人。在WorkerThread的run方法中,执行传入的参数runnable任务: runnable.run();
创建调度线程(项目经理)
1321行,创建了调度器QuartzScheduler:
qs = new QuartzScheduler(rsrcs, idleWaitTime, dbFailureRetry); 在 QuartzScheduler的构造函数中,创建了QuartzSchedulerThread,我们把它理解为项目经理,它会调用包工头的工人资源,给他们安排任务。 并且创建了线程执行器schedThreadExecutor,执行了这个QuartzSchedulerThread,也就是调用了它的run方法。
// 创建一个线程,resouces里面有线程名称
 this.schedThread = new QuartzSchedulerThread(this, resources);
 // 线程执行器
 ThreadExecutor schedThreadExecutor = resources.getThreadExecutor();
 //执行这个线程,也就是调用了线程的run方法
 schedThreadExecutor.execute(this.schedThread);

 点开 QuartzSchedulerThread 类,找到run方法,这个是Quartz任务调度的核心方法:

   public void run() {
     int acquiresFailed = 0;
    // 检查scheuler是否为停止状态
     while (!halted.get()) {
       try {
         // check if we're supposed to pause...
         synchronized (sigLock) {
           // 检查是否为暂停状态
           while (paused && !halted.get()) {
             try {
               // wait until togglePause(false) is called...
               // 暂停的话会尝试去获得信号锁,并wait一会
               sigLock.wait(1000L);
            } catch (InterruptedException ignore) {
            }

             // reset failure counter when paused, so that we don't
             // wait again after unpausing
             acquiresFailed = 0;
          }

           if (halted.get()) {
             break;
          }
        }

         // wait a bit, if reading from job store is consistently
         // failing (e.g. DB is down or restarting)..
         // 从JobStore获取Job持续失败,sleep一下
         if (acquiresFailed > 1) {
           try {
             long delay = computeDelayForRepeatedErrors(qsRsrcs.getJobStore(), acquiresFailed);
             Thread.sleep(delay);
          } catch (Exception ignore) {
          }
        }
         // 从线程池获取可用的线程
         int availThreadCount = qsRsrcs.getThreadPool().blockForAvailableThreads();
         if(availThreadCount > 0) { // will always be true, due to semantics of blockForAvailableThreads...

           List<OperableTrigger> triggers;

           long now = System.currentTimeMillis();

           clearSignaledSchedulingChange();
           try {
             // 获取需要下次执行的triggers
             // idleWaitTime: 默认30s
             // availThreadCount:获取可用(空闲)的工作线程数量,总会大于1,因为该方法会一直阻塞,直到有工作线程空闲下来。
             // maxBatchSize:一次拉取trigger的最大数量,默认是1
             // batchTimeWindow:时间窗口调节参数,默认是0
             // misfireThreshold: 超过这个时间还未触发的trigger,被认为发生了misfire,默认60s
             // 调度线程一次会拉取NEXT_FIRETIME小于(now + idleWaitTime +batchTimeWindow),大于(now - misfireThreshold)的,min(availThreadCount,maxBatchSize)个triggers,默认情况下,会拉取未来30s、过去60s之间还未fire的1个trigger
             triggers = qsRsrcs.getJobStore().acquireNextTriggers(
                 now + idleWaitTime, Math.min(availThreadCount, qsRsrcs.getMaxBatchSize()), qsRsrcs.getBatchTimeWindow());
             // 省略…………

             // set triggers to 'executing'
             List<TriggerFiredResult> bndles = new ArrayList<TriggerFiredResult>();

             boolean goAhead = true;
             synchronized(sigLock) {
               goAhead = !halted.get();
            }
             if(goAhead) {
               try {
                 // 触发Trigger,把ACQUIRED状态改成EXECUTING
                 // 如果这个trigger的NEXTFIRETIME为空,也就是未来不再触发,就将其状态改为COMPLETE
                 // 如果trigger不允许并发执行(即Job的实现类标注了@DisallowConcurrentExecution),则将状态变为BLOCKED,否则就将状态改为WAITING
                 List<TriggerFiredResult> res = qsRsrcs.getJobStore().triggersFired(triggers);
                 // 省略…………
                 continue;
              }

            }

             // 循环处理Trigger
             for (int i = 0; i < bndles.size(); i++) {
               TriggerFiredResult result = bndles.get(i);
               TriggerFiredBundle bndle = result.getTriggerFiredBundle();
               Exception exception = result.getException();

               // 省略…………

               JobRunShell shell = null;
               try {
                 // 根据trigger信息实例化JobRunShell(implements Runnable),同时依据JOB_CLASS_NAME实例化Job,随后我们将JobRunShell实例丢入工作线。
                 shell = qsRsrcs.getJobRunShellFactory().createJobRunShell(bndle);
                 shell.initialize(qs);
              } catch (SchedulerException se) {
                 qsRsrcs.getJobStore().triggeredJobComplete(triggers.get(i), bndle.getJobDetail(), CompletedExecutionInstruction.SET_ALL_JOB_TRIGGERS_ERROR);
                 continue;
              }
               // 执行JobRunShell的run方法
               if (qsRsrcs.getThreadPool().runInThread(shell) == false) {
                 // 省略…………
JobRunShell的作用
JobRunShell instances are responsible for providing the 'safe' environment for Job s to run in, and for performing all of the work of executing the Job, catching ANY thrown exceptions, updating the Trigger with the Job's completion code, etc.A JobRunShell instance is created by a JobRunShellFactory on behalf of the QuartzSchedulerThread which then runs the shell in a thread from the configured ThreadPool when the scheduler determines that a Job has been triggered.
JobRunShell用来为Job提供安全的运行环境的,执行Job中所有的作业,捕获运行中的异常,在任务执行完毕的时候更新Trigger状态,等等。
JobRunShell实例是用JobRunShellFactory为QuartzSchedulerThread创建的,在调度器决定一个Job被触发的时候,它从线程池中取出一个线程来执行任务。
线程模型总结
SimpleThreadPool:包工头,管理所有WorkerThread
WorkerThread:工人,把Job包装成JobRunShell,执行
QuartSchedulerThread:项目经理,获取即将触发的Trigger,从包工头出拿到worker,执行Trigger绑定的任务
绑定JobDetail和Trigger
// 存储JobDetail和Trigger
 resources.getJobStore().storeJobAndTrigger(jobDetail, trig);
 // 通知相关的Listener
 notifySchedulerListenersJobAdded(jobDetail);
 notifySchedulerThread(trigger.getNextFireTime().getTime());
 notifySchedulerListenersSchduled(trigger);
启动调度器
// 通知监听器
 notifySchedulerListenersStarting();
 if (initialStart == null) {
   initialStart = new Date();
   this.resources.getJobStore().schedulerStarted();
   startPlugins();
 } else {
   resources.getJobStore().schedulerResumed();
 }
 // 通知QuartzSchedulerThread不再等待,开始干活
 schedThread.togglePause(false);
 // 通知监听器
 notifySchedulerListenersStarted();
源码总结
- getScheduler方法创建线程池ThreadPool,创建调度器QuartzScheduler,创建调度线程QuartzSchedulerThread,调度线程初始处于暂停状态。
- scheduleJob将任务添加到JobStore中。
- scheduler.start()方法激活调度器,QuartzSchedulerThread从timeTrriger取出待触发的任务,并包装成TriggerFiredBundle,然后由JobRunShellFactory 创建TriggerFiredBundle的执行线程JobRunShell, 调度执行通过线程池SimpleThreadPool去执行JobRunShell, 而JobRunShell执行的就是任务类的execute方法:job.execute(JobExecutionContext context)。
集群原理
集群原理
基于数据库,如何实现任务的不重跑不漏跑?
问题1:如果任务执行中的资源是“下一个即将触发的任务”,怎么基于数据库实现这个资源的竞争?
问题2:怎么对数据的行加锁?

QuartzSchedulerThread第287行,获取下一个即将触发的Trigger
triggers = qsRsrcs.getJobStore().acquireNextTriggers(
调用 JobStoreSupport的acquireNextTriggers()方法,2793行
调用JobStoreSupport.executeInNonManagedTXLock()方法,3829行:
return executeInNonManagedTXLock(lockName,
尝试获取锁,3843行:
transOwner = getLockHandler().obtainLock(conn, lockName);
下面有回滚和释放锁的语句,即使发生异常,锁同样能释放。
调用DBSemaphore的obtainLock()方法,103行
public boolean obtainLock(Connection conn, String lockName)
     throws LockException {
     if (!isLockOwner(lockName)) {
       executeSQL(conn, lockName, expandedSQL, expandedInsertSQL);
调用StdRowLockSemaphore的executeSQL()方法,78行。
最终用JDBC执行SQL,语句内容是expandedSQL和expandedInsertSQL。
ps = conn.prepareStatement(expandedSQL);
问题:expandedSQL和expandedInsertSQL是一条什么SQL语句?似乎我们没有赋值?
在StdRowLockSemaphore的构造函数中,把定义的两条SQL传进去:
public StdRowLockSemaphore() {
  super(DEFAULT_TABLE_PREFIX, null, SELECT_FOR_LOCK, INSERT_LOCK);
 }
public static final String SELECT_FOR_LOCK = "SELECT * FROM "
      + TABLE_PREFIX_SUBST + TABLE_LOCKS + " WHERE " + COL_SCHEDULER_NAME + " = " + SCHED_NAME_SUBST
      + " AND " + COL_LOCK_NAME + " = ? FOR UPDATE";

  public static final String INSERT_LOCK = "INSERT INTO "
    + TABLE_PREFIX_SUBST + TABLE_LOCKS + "(" + COL_SCHEDULER_NAME + ", " + COL_LOCK_NAME + ") VALUES ("
    + SCHED_NAME_SUBST + ", ?)";
它调用了父类DBSemaphore的构造函数:
public DBSemaphore(String tablePrefix, String schedName, String defaultSQL, String defaultInsertSQL) {
    this.tablePrefix = tablePrefix;
    this.schedName = schedName;
    setSQL(defaultSQL);
    setInsertSQL(defaultInsertSQL);
 }
在setSQL()和setInsertSQL()中为expandedSQL和 expandedInsertSQL赋值。
执行的SQL语句:
select * from QRTZ_LOCKS t where t.lock_name='TRIGGER_ACCESS' for update
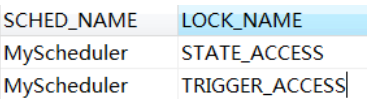
在我们执行官方的建表脚本的时候,QRTZ_LOCKS表,它会为每个调度器创建两行数据,获取Trigger和触发Trigger是两把锁:
任务为什么重复执行
在我们的演示过程中,有多个调度器,任务没有重复执行,也就是默认会加锁,什么情况下不会上锁呢?
JobStoreSupport的executeInNonManagedTXLock()方法
如果lockName为空,则不上锁
if (lockName != null) {
        // If we aren't using db locks, then delay getting DB connection
         // until after acquiring the lock since it isn't needed.
        if (getLockHandler().requiresConnection()) {
          conn = getNonManagedTXConnection();
        }

        transOwner = getLockHandler().obtainLock(conn, lockName);
      }

      if (conn == null) {
        conn = getNonManagedTXConnection();
      }
而上一步JobStoreSupport的acquireNextTriggers()方法,
1)如果acquireTriggersWithinLock=true或者batchTriggerAcquisitionMaxCount>1时,locaName赋值为LOCK_TRIGGER_ACCESS,此时获取Trigger会加锁。
2)否则,如果isAcquireTriggersWithinLock()值是false并且maxCount=1的话,lockName赋值为null,这种情况获取Trigger下不加锁。
public List<OperableTrigger> acquireNextTriggers(final long noLaterThan, final int maxCount, final long timeWindow)
    throws JobPersistenceException {

    String lockName;
    if(isAcquireTriggersWithinLock() || maxCount > 1) {
      lockName = LOCK_TRIGGER_ACCESS;
    } else {
      lockName = null;
 }
acquireTriggersWithinLock变量默认是false:
private boolean acquireTriggersWithinLock = false;
maxCount来自QuartzSchedulerThread:
triggers = qsRsrcs.getJobStore().acquireNextTriggers(
                now + idleWaitTime, Math.min(availThreadCount, qsRsrcs.getMaxBatchSize()), qsRsrcs.getBatchTimeWindow());
getMaxBatchSize()来自QuartzSchedulerResources,代表Scheduler一次拉取trigger的最大数量,默认是1:
private int maxBatchSize = 1;
这个值可以通过参数修改,代表允许调度程序节点一次获取(用于触发)的触发器的最大数量,默认值是1。
org.quartz.scheduler.batchTriggerAcquisitionMaxCount=1
根据以上两个默认值,理论上在获取Trigger的时候不会上锁,但是实际上为什么没有出现频繁的重复执行问题?因为每个调度器的线程持有锁的时间太短了,单机的测试无法体现,而在高并发的情况下,有可能会出现这个问题。
QuartzSchedulerThread的triggersFired()方法:
List<TriggerFiredResult> res = qsRsrcs.getJobStore().triggersFired(triggers);
调用了JobStoreSupport的triggersFired()方法,接着又调用了一个triggerFired triggerFired(Connection conn, OperableTrigger trigger)方法:
如果Trigger的状态不是ACQUIRED,也就是说被其他的线程fire了,返回空。但是这种乐观锁的检查在高并发下难免会出现ABA的问题,比如线程A拿到的时候还是ACQUIRED状态,但是刚准备执行的时候已经变成了EXECUTING状态,这个时候就会出现重复执行的问题。
if (!state.equals(STATE_ACQUIRED)) {
   return null;
 }
总结,如果:
如果设置的数量为1(默认值),并且使用JDBC JobStore(RAMJobStore不支持分布式,只有一个调度器实例,所以不加锁),则属性org.quartz.jobStore.acquireTriggersWithinLock应设置为true。否则不加锁可能会导致任务重复执行。
org.quartz.scheduler.batchTriggerAcquisitionMaxCount=1
org.quartz.jobStore.acquireTriggersWithinLock=true
更多推荐
 26
 0
- 0


 已为社区贡献5条内容

所有评论(0)