
非递归迭代实现二叉树遍历
非递归迭代实现二叉树遍历
🌟🌟hello,各位读者大大们你们好呀🌟🌟
🚀🚀系列专栏:【C++的学习】
📝📝本篇内容:前序遍历;中序遍历;后序遍历;求两个数组的交集
⬆⬆⬆⬆上一篇:二叉树进阶(二叉搜索树)
💖💖作者简介:轩情吖,请多多指教(> •̀֊•́ ) ̖́-
在以前我们讲的二叉树遍历中,有前序遍历、中序遍历、后序遍历,它们使用的方法都是递归遍历,递归遍历过深一定会有栈溢出的问题,因此我们一般用递归写法的也要尝试使用循环来代替。
1.前序遍历
首先要先回顾一下什么是前序遍历,前序遍历的顺序是“根结点-左子树-右子树”,那么循环也是要遵守这个顺序。像这种情况,我们就需要使用一些数据结构来帮助我们达成。
基本思路:
我们使用栈来模拟“根-左子树-右子树”这个顺序
①将结点的值进行打印或存储
②然后循环将左结点放入栈中
③将栈顶的元素pop出来,相等于就是将二叉树从下往上的“根结点”取出来
④再处理左结点的右子树,即pop出来的结点的右子树
⑤右子树又需要重复①开始的步骤直到栈为空
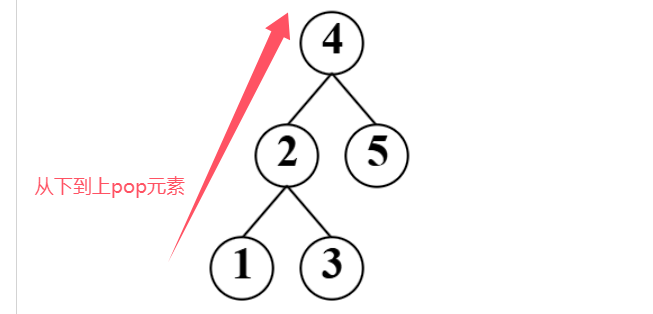
在leetcode上也有题目:二叉树的前序遍历 可以使用循环来解决
接着我们来看一下代码
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */
class Solution {
public:
    vector<int> preorderTraversal(TreeNode* root) {
        vector<int> data;
        //1.创建栈
        stack<TreeNode*> st;
        //2.先将第一批的左结点放入栈中
        TreeNode* cur=root;
        while(cur)
        {
            //根据前序遍历的特性,结点的val
            data.push_back(cur->val);
            st.push(cur);
            cur=cur->left;
        }

        //3.接着处理右子树,右子树也需要对其左子树进行放入栈中处理
        while(!st.empty())
        {
            //取栈顶元素
            cur=st.top();
            //从栈中pop掉
            st.pop();

           //处理右子树
           cur=cur->right;

           //右子树的左子树放入栈中
           while(cur)
           {
            //根据前序遍历的特性,结点的val
            data.push_back(cur->val);
            st.push(cur);
            cur=cur->left;
           }


        }

        return data;
    }
};
当然有看着更加简洁的版本
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */
class Solution {
public:
    vector<int> preorderTraversal(TreeNode* root) {
    TreeNode* cur=root;
    stack<TreeNode*> node;
    vector<int> data;

    //cur不为空或栈不为空就说明二叉树还没遍历完
    while(cur||(!node.empty()))
    {
     //循环将左结点放入栈中
    while(cur)
    {
        //将结点的值存起来
        data.push_back(cur->val);
        node.push(cur);
        cur=cur->left;
    }

    //取出栈顶的值
    auto tp=node.top();
    //pop栈顶的值
    node.pop();

    //继续处理右子树
    cur=tp->right;
    }

    return data;
    }
};
2.中序遍历
中序遍历的思路其实和前序遍历差不多,但是我们依旧先来回顾一下它的顺序“左子树-根结点-右子树”。
基本思路:
①然后循环将左结点放入栈中
②将栈顶的元素pop出来,相等于就是将二叉树从下往上的“根结点”取出来
③将取出的结点的值进行打印或存储
④再处理左结点的右子树,即pop出来的结点的右子树
⑤右子树又需要重复①开始的步骤直到栈为空
可以发现和前序遍历的唯一区别就是取结点的值的顺序
leetcode题目
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */
class Solution {
public:
    vector<int> inorderTraversal(TreeNode* root) {
    TreeNode* cur=root;
    stack<TreeNode*> node;
    vector<int> data;

    //cur不为空或栈不为空就说明二叉树还没遍历完
    while(cur||(!node.empty()))
    {
     //循环将左结点放入栈中
    while(cur)
    {

        node.push(cur);
        cur=cur->left;
    }

    //取出栈顶的值
    auto tp=node.top();
    //pop栈顶的值
    node.pop();

    //将结点的值存起来
    data.push_back(tp->val);

    //继续处理右子树
    cur=tp->right;
    }

    return data;
    }
};
3.后序遍历
后序遍历是三个遍历中最难实现的,当然我们还是先回顾一下它的遍历顺序是“左子树-右子树-根结点”
基本思路:
①然后循环将左结点放入栈中
②将栈顶的元素pop出来,相等于就是将二叉树从下往上的“根结点”取出来
③再处理左结点的右子树,即pop出来的结点的右子树
④当右子树为空时可以直接pop并且取其值,或者上一个被删除的结点和当前结点(取出来的左结点)的右结点(右子树)相等就可以删除取值了
⑤否则取出的结点不进行pop,右子树又需要重复①开始的步骤直到栈为空
因此在我们进行删除的时候,需要有一个变量来记录上一个被删除的结点
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left),
 * right(right) {}
 * };
 */
class Solution {
public:
    vector<int> postorderTraversal(TreeNode* root) {
        TreeNode* cur = root;
        TreeNode* prev; // 记录上一个被删除的结点
        stack<TreeNode*> node;
        vector<int> data;

        // cur不为空或栈不为空就说明二叉树还没遍历完
        while (cur || (!node.empty()))
         {
            // 循环将左结点放入栈中
            while (cur)
            {

                node.push(cur);
                cur = cur->left;
            }

            // 取出栈顶的值
            auto tp = node.top();

            // 两种pop的情况
            if (tp->right == nullptr || tp->right == prev)
            {
                // 取值
                data.push_back(tp->val);
                // pop栈顶的值
                node.pop();
                // 记录此次删除的结点
                prev = tp;
            } else
            {
                // 继续处理右子树
                cur = tp->right;
            }
        }

        return data;
    }
};
4.求两个数组的交集
这里额外讲一下leetcode上的一道题,求两个数组的交集,还是比较简单的
基本思路:
①首先比较的两个数组需要为有序,这样才能为后序比较大小建立基础
②进行判断,相等就是交集,同时++
③不相等的话,小的++
④重复②③直到一个集合走完就结束了
class Solution {
public:
    vector<int> intersection(vector<int>& nums1, vector<int>& nums2) {
        //1.先将两个数组进行从小到大排序
        sort(nums1.begin(),nums1.end());
        sort(nums2.begin(),nums2.end());

         vector<int> data;
        //进行比较
        int i=0,j=0;
        while(i<nums1.size()&&j<nums2.size())
        {
            //不相等的话,小的先走,这样才能有机会找到相等大的大值
            if(nums1[i]>nums2[j])
            {
                j++;
            }
            else if(nums1[i]<nums2[j])
            {
                i++;
            }
            //相等就是交集,同时++
            else
            {
               data.push_back(nums1[i]);
               i++;
               j++;
            }
        }

        //只要有一个数组走完,就结束了,其余的肯定都不是交集

        //去重,排序有两个目的:方便现在去重;方便找差集
        vector<int>::iterator it=unique(data.begin(),data.end());
        //unique不会改变data的大小,因此我们需要自己调整
        data.resize(it-data.begin());
        return data;

    }
};
讲到交集,那么也会提到差集
差集的思路也很简单
①相等就同时++
②不相等,小的就是差集,小的++
③一个集合走完了,剩下没走完的值也是差集
🌸🌸非递归迭代实现二叉树遍历的知识大概就讲到这里啦,博主后续会继续更新更多数据结构的相关知识,干货满满,如果觉得博主写的还不错的话,希望各位小伙伴不要吝啬手中的三连哦!你们的支持是博主坚持创作的动力!💪💪
更多推荐


 14
 0
- 0


 已为社区贡献1条内容

所有评论(0)