
集合与哈希表的深入应用实例分析

简介:集合和哈希表是编程中关键的数据结构,分别用于确保数据唯一性和提供快速的数据访问。集合在Python中通过大括号或set()创建,支持并集、交集、差集等操作。哈希表则依赖哈希函数实现快速的查找、插入和删除,以字典的形式在Python中实现。集合和哈希表在去重、成员测试、高效查找等领域有着广泛的应用。本篇文章深入探讨这些数据结构的特性、用途,并提供编程实例,旨在帮助读者掌握其实际应用。 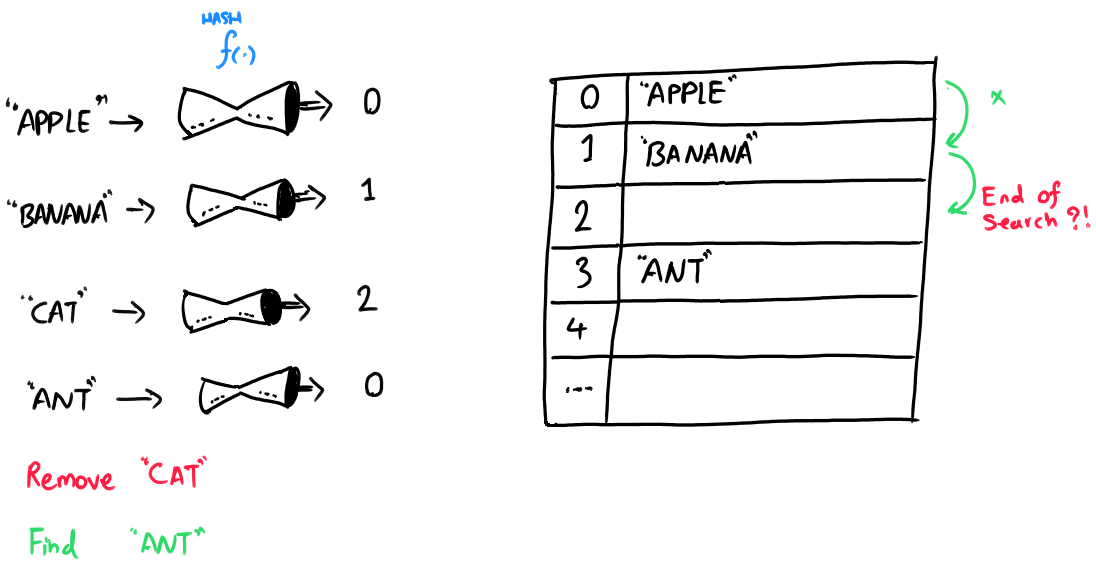
1. 集合与哈希表的理论基础
集合与哈希表是计算机科学中广泛使用的两种数据结构,它们在不同的应用领域里发挥着不可替代的作用。在深入探讨其在编程中的具体应用之前,理解其理论基础是至关重要的。
集合,作为一种数学上的概念,表示一组无序且不重复的元素集。在计算机科学中,集合通常被用来进行数据操作,如去重、比较、交集、并集等。为了高效实现这些操作,集合的数据结构必须支持快速的查找和插入。
哈希表,又称散列表,是一种通过哈希函数来访问的数据结构。它通过哈希函数把键映射到表中的位置,以实现快速的查找、插入和删除。哈希表的效率极高,尤其是在处理大量数据的场景中,其平均查找时间复杂度为O(1),这使得哈希表成为实现集合操作的理想选择之一。
理解集合与哈希表的基础理论,是掌握其高级应用和优化技巧的先决条件。接下来,我们将逐步深入这些概念,探索它们在实际编程中的具体应用。
2. 集合的基本概念与操作实践
2.1 集合的定义与特性
集合是一组无序且唯一的元素组成的组合。它是数学和计算机科学中的基本概念,广泛应用于数据结构、算法、数据库等领域。在编程语言中,集合通常作为内置的数据结构,提供了一系列操作方法来维护数据的唯一性和处理数据集合的运算。
2.1.1 唯一性原理
集合中的元素不允许重复,这是集合与数组、列表等数据结构最大的区别。唯一性原理是集合操作的核心,也是其在数据去重、快速查找等场景下表现出色的关键因素。
为了保证集合元素的唯一性,通常会采用哈希函数来快速定位元素存储位置。哈希函数可以将一个集合中的元素映射到一个固定范围的数字上,这样就可以在常数时间复杂度内完成元素的查找、插入和删除操作。
2.1.2 无序性与可变性解析
集合是无序的数据结构,意味着元素的存储和遍历不会按照任何特定的顺序。这就使得集合在处理时更加灵活,因为它不关心元素的排列顺序,只关注元素是否存在于集合中。
集合的可变性是指集合可以在运行时动态地增加或删除元素。这种动态调整机制使得集合能适应不断变化的数据需求,例如在运行过程中更新数据集、整合多个数据集等。
2.2 集合操作的基本实例
集合操作通常包括添加、删除元素以及计算两个集合的并集、交集和差集。下面我们将通过具体实例来展示如何在编程语言中实现这些集合操作。
2.2.1 集合元素的添加与删除方法
在大多数编程语言中,集合都有相应的库或内置方法来添加和删除元素。
以Python语言为例,以下是向集合中添加和删除元素的示例代码:
# 创建一个空集合
s = set()

# 添加元素
s.add(1)
s.update([2, 3, 4])

# 打印集合元素
print(s)  # 输出: {1, 2, 3, 4}

# 删除元素
s.remove(1)
s.discard(5)  # 如果元素不存在,discard不会抛出异常

# 打印当前集合元素
print(s)  # 输出: {2, 3, 4}
在这里, add 方法用于添加单个元素,而 update 方法可以一次性添加多个元素。 remove 方法用于删除指定元素,如果元素不存在会抛出一个 KeyError 异常,而 discard 方法则不会抛出异常,即使元素不存在。
2.2.2 集合的并集、交集与差集运算实例
集合的并集、交集和差集运算是非常常见的集合操作,它们是集合论的基础。
举个例子,假设我们有两个集合 A 和 B ,分别包含元素 {1, 2, 3} 和 {3, 4, 5} ,我们想要计算它们的并集、交集和差集:
# 定义两个集合
A = {1, 2, 3}
B = {3, 4, 5}

# 计算并集
union_set = A.union(B)  # 或者使用 A | B
print("并集:", union_set)  # 输出: 并集: {1, 2, 3, 4, 5}

# 计算交集
intersection_set = A.intersection(B)  # 或者使用 A & B
print("交集:", intersection_set)  # 输出: 交集: {3}

# 计算差集(A - B)
difference_set = A.difference(B)  # 或者使用 A - B
print("差集 (A - B):", difference_set)  # 输出: 差集 (A - B): {1, 2}

# 计算差集(B - A)
difference_set = B.difference(A)
print("差集 (B - A):", difference_set)  # 输出: 差集 (B - A): {4, 5}
在这些操作中, union 方法用于计算并集, intersection 方法用于计算交集,而 difference 方法用于计算差集。在Python中,我们也可以使用操作符 | 、 & 和 - 来执行相应的集合运算。
通过这些基础操作,我们可以组合构建更复杂的集合操作,以满足多样化的数据处理需求。
3. 哈希表的理论与实现技巧
3.1 哈希表的定义与特性
3.1.1 快速查找原理与效率分析
哈希表是一种通过哈希函数组织数据以支持快速查找的数据结构。其基本思想是通过一个哈希函数将要查找的键映射到表中的一个位置来访问记录,以达到快速查找的目的。
哈希函数的设计直接决定了哈希表的性能。一个优秀的哈希函数应该能够尽可能均匀地分布数据,避免过多的冲突。通常,哈希函数会根据记录的关键字计算得到。这里的关键字可以是整数,也可以是字符串等。
哈希表的核心操作是插入、删除和查找。在理想情况下,这三个操作的平均时间复杂度都是O(1),这意味着无论表中有多少数据,操作的时间都是恒定的。这种高效的性能使得哈希表在需要快速查找的场景中得到广泛应用。
然而,在现实应用中,哈希冲突是不可避免的,尤其是当表的大小有限时。解决冲突的方法有多种,比如链地址法和开放地址法。冲突解决策略的选择也会影响到哈希表的性能。
3.1.2 动态调整机制与冲突解决策略
动态调整机制是指在哈希表中的元素数量达到一定程度后,自动将表的大小加倍,并重新散列所有的元素到新的位置。这一过程称为再散列或者重哈希。动态调整的目的是为了降低哈希冲突的概率,保持哈希表的高效性能。
冲突解决策略是指在发生哈希冲突时如何处理。常见的冲突解决策略包括:
- 链地址法:在每个哈希表的位置上维护一个链表,所有哈希到该位置的元素都存储在链表中。
- 开放地址法:当发生冲突时,按照某个规则在表中探测下一个空位置,直到找到一个空位置为止。
- 再哈希法:使用多个哈希函数,当发生冲突时尝试另一个哈希函数继续计算位置。
每种策略都有其优缺点,适用于不同的场景。选择合适的冲突解决策略和动态调整机制对于构建高性能的哈希表至关重要。
3.2 哈希表的应用实现
3.2.1 字典在Python中的哈希表实现
在Python中,字典(dict)是一种内置的数据类型,其内部实现就是基于哈希表。Python的字典可以非常快速地进行元素的插入、删除和查找操作。
# 示例代码:Python中字典的基本操作
my_dict = {}
my_dict['key1'] = 'value1'  # 插入操作
print(my_dict['key1'])      # 查找操作
del my_dict['key1']          # 删除操作
Python的字典在内部使用了一种称为“开放地址法”的冲突解决策略,以及动态调整机制。当字典的大小超过一定阈值时,会自动将哈希表的大小加倍,并重新哈希所有的元素。
3.2.2 哈希表在其他编程语言中的应用对比
在其他编程语言中,哈希表的应用也非常广泛。例如,在Java中,HashMap类提供了哈希表的实现;在C++中,可以通过unordered_map来使用哈希表。
每种语言的实现都有其特点和优化之处。例如,Java中的HashMap提供了fail-fast迭代器,能够在发现结构性修改时快速报错。而C++的unordered_map则提供了多种哈希策略和定制选项,允许开发者更细致地控制哈希表的行为。
通过比较不同语言中哈希表的实现和性能,我们可以得到如何在特定场景下选择合适的哈希表实现的深刻理解。
表格和流程图示例
为了更直观地展示哈希表的冲突解决策略的比较,我们可以使用表格来列举不同策略的优缺点:
| 策略 | 优点 | 缺点 | |---------|----------------------------------------|----------------------------------------| | 链地址法 | 实现简单,易于管理。 | 存储额外的指针,空间使用率可能降低。 | | 开放地址法 | 空间利用率高,不需要额外的指针。 | 高冲突率可能导致性能下降。 | | 再哈希法 | 适应性强,能够减少冲突。 | 实现复杂度较高,性能依赖于哈希函数的多样性。 |
接下来是一个简化的mermaid流程图,描述了哈希表的插入过程:
graph TD
A[开始插入操作] --> B{计算哈希值}
B -->|无冲突| C[放置元素]
B -->|有冲突| D{选择冲突解决策略}
D -->|链地址法| E[追加到链表]
D -->|开放地址法| F[探测下一个空位]
D -->|再哈希法| G[使用另一个哈希函数]
E --> H[结束插入操作]
F --> H
G --> H
本章从哈希表的基础理论到实际应用,逐步深入讨论了哈希表的定义、特性、动态调整机制以及在不同编程语言中的实现。通过代码、表格和流程图的综合运用,对哈希表的理论与实践进行了全面的分析。
4. 集合在编程中的实际应用
4.1 集合在数据处理中的应用
4.1.1 数据去重与快速查找
在数据处理领域,集合被广泛应用于数据去重和快速查找,这是因为集合的唯一性特性可以确保元素的不重复性,而集合的操作效率可以提供快速查找的能力。
以Python中的集合操作为例,我们可以使用集合来去除列表中的重复元素,从而实现去重的目的。例如,有一个包含重复元素的列表 data_list ,我们可以通过将这个列表转换为集合,然后再转换回列表的方式去除重复元素。代码示例如下:
data_list = [1, 2, 2, 3, 4, 4, 5]
unique_data = list(set(data_list))
通过上述操作, unique_data 将包含去重后的元素 [1, 2, 3, 4, 5] 。
除了去重,集合在快速查找方面的应用也非常广泛。在处理大量数据时,如果需要频繁检查元素是否存在,使用集合可以大幅提高效率。因为集合底层是通过哈希表实现的,查找的时间复杂度为O(1),远快于列表和数组的O(n)复杂度。
4.1.2 集合在算法优化中的实例
集合除了在数据处理中应用广泛外,它在算法优化中也是一个重要的工具。在一些算法问题中,比如求两个集合的交集、并集、差集,集合的操作可以提供简洁直观的解决方案。
以求两个集合交集的问题为例,我们可以使用集合的交集操作来找出两个集合中共同的元素。在Python中,这可以简单地通过 & 操作符或者 .intersection() 方法实现。例如,给定两个集合 set1 和 set2 ,我们可以使用以下代码来找到它们的交集:
set1 = {1, 2, 3, 4}
set2 = {3, 4, 5, 6}
intersection = set1 & set2  # 或者使用 intersection = set1.intersection(set2)
通过这个操作, intersection 将包含 {3, 4} ,即两个集合的交集。
集合在算法中的应用不仅限于基本操作,还可以用于实现更高级的算法优化,例如使用集合来快速查找和消除重复项。在一些动态规划或回溯算法中,使用集合存储中间结果或避免重复计算可以显著提高算法的执行效率。
4.2 集合在复杂数据结构中的应用
4.2.1 多维集合的操作实例
在处理复杂数据结构时,集合的概念也可以扩展到多维情况。例如,当我们需要处理多个集合的组合时,可以使用集合的笛卡尔积来生成所有可能的组合。
在Python中,可以使用 itertools.product() 函数来计算多个集合的笛卡尔积。以下是一个简单的例子:
import itertools

set1 = {'a', 'b', 'c'}
set2 = {1, 2, 3}

# 计算 set1 和 set2 的笛卡尔积
cartesian_product = list(itertools.product(set1, set2))
cartesian_product 将包含所有可能的组合,如 [('a', 1), ('a', 2), ('a', 3), ('b', 1), ('b', 2), ('b', 3), ('c', 1), ('c', 2), ('c', 3)] 。
多维集合的操作不仅限于笛卡尔积,还包括处理多维空间的交集、并集以及差集运算。这些操作在几何数据处理、游戏开发等领域有着广泛的应用。
4.2.2 集合在数据库查询优化中的应用
在数据库系统中,集合的概念同样有着重要的作用,尤其是在查询优化方面。关系型数据库中的查询操作常常依赖于集合运算,如并集、交集、差集等。通过SQL语句,我们可以对表中的数据进行集合操作,从而实现复杂的查询需求。
假设我们有两个表 table1 和 table2 ,我们想要找出两个表中都存在的记录,我们可以使用SQL的内连接(INNER JOIN)来实现:
SELECT table1.column1, table1.column2
FROM table1
INNER JOIN table2
ON table1.common_key = table2.common_key;
这条查询语句实际上就是执行了两个表记录的交集操作,返回的记录是两个表在 common_key 上匹配的记录。
使用集合操作进行数据库查询优化的关键在于合理地使用SQL的集合运算符和连接类型,以及对索引的合理设计,这些都是提高查询效率的关键因素。
通过这些示例,我们可以看到集合在编程中的实际应用是多方面的,无论是在简单的数据处理还是复杂的应用场景中,集合都提供了一种简洁而强大的工具,帮助开发者实现更高效的数据操作。
5. 哈希表在编程中的实际应用场景
哈希表是一种通过哈希函数来映射键与值的关联数据结构,它支持快速的插入、删除和查找操作。在这一章节,我们将深入探讨哈希表在编程中的两个核心应用场景:数据库索引和缓存系统。这些应用利用哈希表独特的数据组织方式和高效的查询能力,极大优化了数据存储和访问性能。
5.1 哈希表在数据库索引中的应用
5.1.1 索引结构设计与哈希表
数据库索引是加速数据检索的机制,它依赖于索引结构来实现。哈希表作为一种非顺序性的数据组织方式,很自然地被应用于索引结构的设计中,特别是在键值对存储或需要快速精确匹配的场景。
在传统的关系型数据库中,索引通常用于加快查询速度。例如,B树和B+树是常用的索引结构,它们通过平衡树的特性,将数据有序地组织起来,以支持范围查询和前缀匹配等操作。然而,哈希表适合用于等值查询,它能在常数级的平均时间复杂度内返回查询结果。具体到数据库索引,当用户执行等值查询时,如 SELECT * FROM table WHERE key = value ,利用哈希表作为索引能够非常快速地定位到数据。
5.1.2 哈希表索引优化查询性能的实例
为了更具体地理解哈希表在数据库索引中的应用,让我们看一个简单的例子。假设有一个用户表(users),每个用户都有一个唯一的ID作为主键。使用哈希表作为这个ID字段的索引,可以在查询时直接定位到存储了用户信息的内存地址。
假设哈希函数为 hash(id) = (id * prime) % index_size ,其中 prime 是一个质数, index_size 是哈希表的大小。这样,当我们要查询ID为4的用户信息时,我们计算 hash(4) 得到索引位置,然后直接访问该位置。由于哈希表的平均时间复杂度为O(1),这个查询过程非常迅速。
不过,由于哈希冲突的存在(两个不同的ID计算出相同的哈希值),在实际应用中,通常需要使用链地址法或开放地址法来解决冲突。这意味着在每个哈希桶中可能存储一个链表或指向多个值的指针,用于存储发生冲突的数据项。
5.2 哈希表在缓存系统中的实现
5.2.1 缓存机制与哈希表的结合
缓存是另一种利用哈希表高效数据访问性能的系统。缓存系统通常用于存储经常被访问的数据,减少对原始数据源(如硬盘或网络)的访问次数,从而提高性能。
在缓存系统中,哈希表可以用来快速定位缓存的数据项。通常情况下,缓存数据项以键值对的形式存储,键对应于需要查询的数据项的标识符,值是数据项本身。通过哈希表,可以将键转换为哈希值,并直接定位到缓存中存储的值。
例如,在Web应用中,对于一个经常被请求的页面,我们可以将页面内容哈希后存储在内存缓存中。当有新的请求到来时,我们可以快速通过哈希表确定请求的页面内容是否在缓存中。
5.2.2 哈希表在分布式缓存系统中的应用实例
分布式缓存系统,如Redis和Memcached,广泛用于现代的Web应用中,它们使用哈希表来管理缓存数据。这些系统通常将数据分布在多个服务器上,以便在大规模场景下提供高可用性和扩展性。
以Redis为例,它利用哈希表作为其内部数据结构之一,支持键值对的存储。当执行一个 SET 操作来存储数据时,Redis会使用哈希函数计算键的哈希值,然后将键值对存储在相应的哈希桶中。哈希桶通常包含一个指向数据项的指针,如果发生冲突,Redis使用链地址法来解决。
例如,在一个分布式缓存场景中,哈希表可以帮助系统快速决定一个键值对应该存储在哪个节点上。Redis通过哈希槽(hash slots)的概念将数据分布到不同的节点上,每个节点负责一定范围的哈希槽。使用 CRC16 算法计算键的哈希值,然后对哈希槽总数取模,最终得到键值对存储的目标节点。
-- Lua脚本伪代码
local key = KEYS[1]
local hash = crc16(key) % total_slots
local node = find_node_by_slot(hash)
在这个过程中,哈希表通过快速的哈希计算和冲突解决机制,极大地提升了数据的存储和检索效率,为分布式缓存系统提供了坚实的数据结构基础。
总结来看,哈希表在数据库索引和缓存系统中扮演了重要角色,它以其独特的数据结构和快速的访问特性,极大地提升了数据检索效率。然而,其应用并不限于这两个领域,它在许多其他场景中也展现出了巨大的潜力。在接下来的章节中,我们将继续探索集合与哈希表的更多应用案例,以及它们在未来技术发展中的潜在趋势。
6. 集合与哈希表综合应用案例分析
在前几章中,我们已经探讨了集合与哈希表的理论基础、基本概念、实现技巧以及它们在编程中的实际应用。本章节将通过综合应用案例分析,进一步揭示集合与哈希表在真实世界问题解决中的强大能力。
6.1 集合与哈希表在互联网技术中的综合应用
6.1.1 大数据去重与快速检索案例
在处理大规模数据集时,去重和快速检索是常见的需求。集合和哈希表在此场景下扮演着关键角色,它们能够以极高的效率完成这两个任务。
以处理社交网络上用户生成的内容为例。每天,社交网络平台可能会接收到来自全球数十亿用户的海量消息。这些消息需要去重以避免冗余,并且支持快速检索以响应用户的查询。
实现步骤:
-
数据预处理: 首先,将用户消息存储到一个集合中,利用集合的唯一性原理自动去除重复项。
python messages = set() # 创建一个空集合用于存储不重复的消息 -
消息存储: 将每个新消息添加到集合中,通过检查是否已存在来防止重复。
python def add_message(message, messages): if message not in messages: messages.add(message) # 如果消息不在集合中,则添加 else: print("Duplicate message not added.")
- 快速检索: 使用哈希表的快速查找特性,我们可以构建一个消息到其出现次数的映射,实现O(1)时间复杂度的检索。
python from collections import defaultdict message_counts = defaultdict(int) for message in messages: message_counts[message] += 1
- 索引构建: 进一步,可以使用哈希表为消息内容建立索引,以支持高效的检索功能。
python message_index = {} for idx, message in enumerate(messages): message_index[message] = idx
有了消息索引,我们可以立即检索到任何消息的索引位置,从而快速定位和访问。
6.1.2 分布式系统中集合与哈希表的协同工作实例
分布式系统由多个相互协作的节点构成,它们共同处理复杂的计算任务。在这样的系统中,集合与哈希表可以共同发挥作用,保证数据的一致性和操作的高效性。
应用场景:
想象一个分布式缓存系统,它需要处理大量对数据的并发读写操作。为了保证数据的一致性和系统的高可用性,我们需要实现一种机制来跟踪缓存数据的版本和位置。
- 缓存版本管理: 利用哈希表存储每个缓存项的版本信息,这样每个缓存项都有一个全局唯一的版本标识。
python cache_versions = {} def update_cache_version(key, version): cache_versions[key] = version
- 数据一致性维护: 当有数据更新时,集合可用于追踪需要更新或删除的数据项。
python updated_keys = set() def process_update(key): updated_keys.add(key) # 更新逻辑...
- 快速定位与恢复: 哈希表可以在分布式环境下快速定位缓存项的位置,并能快速恢复数据。
python def locate_cache(key, cache_nodes): version = cache_versions.get(key) if version: return cache_nodes[key] # 返回定位到的缓存节点 else: return None
- 系统容错: 集合也可用于记录系统中的故障节点,便于后续进行故障恢复或负载均衡。
python faulty_nodes = set() def mark_faulty_node(node): faulty_nodes.add(node) # 标记逻辑...
通过这些步骤,我们可以看到集合和哈希表在维护分布式系统中的数据一致性和快速处理大规模数据操作方面起到的核心作用。
6.2 集合与哈希表在机器学习中的应用
在机器学习领域,集合与哈希表也被广泛应用于数据处理和模式识别。
6.2.1 特征选择与集合的关系处理
特征选择是机器学习中一个重要的数据预处理步骤,其目的是从高维数据集中选择出最相关的特征子集,以提高模型的性能和可解释性。
实现步骤:
-
特征评估: 首先,需要评估每个特征对于模型预测的重要性。一种常用的方法是计算特征与目标变量之间的互信息。
-
特征排序: 然后,根据评估结果,将特征按重要性排序。
-
选择特征: 使用集合数据结构可以方便地进行特征选择。因为集合具有唯一性特性,我们可以快速排除掉重复的特征。
-
构建模型: 选择出来的特征子集将用于训练机器学习模型。
python from sklearn.feature_selection import mutual_info_classif import numpy as np # 假设X是特征数据集,y是目标变量 mi_scores = mutual_info_classif(X, y) sorted_features = np.argsort(mi_scores)[::-1] # 降序排序特征 selected_features = set(sorted_features[:num_features]) # 选择前num_features个特征
6.2.2 哈希表在相似性搜索中的应用实例
在机器学习和数据挖掘任务中,相似性搜索是一个常见问题。使用哈希表,我们可以快速地执行大规模相似性搜索。
实现步骤:
- 特征哈希: 利用哈希函数,将高维特征空间映射到低维哈希码。
python def feature_hashing(features, num_hash_functions): hash_table = {} for feature in features: hash_code = hash_function(feature) % num_hash_functions if hash_code not in hash_table: hash_table[hash_code] = [feature] else: hash_table[hash_code].append(feature) return hash_table
-
存储与检索: 在哈希表中存储特征及其索引,可以快速检索到近似邻居。
-
快速搜索: 给定一个查询特征,我们可以快速找到哈希表中的相关项,执行快速的近似搜索。
python def search(query_feature, hash_table): hash_code = hash_function(query_feature) % num_hash_functions return hash_table.get(hash_code, [])
通过这种方式,哈希表能有效地支持大规模数据集中的快速相似性搜索,对于构建如推荐系统、图像检索系统等应用至关重要。
在本章节中,我们通过综合应用案例分析了集合与哈希表在不同领域中的实际应用。集合的唯一性与快速操作能力以及哈希表的快速查找与存储优势,在大数据处理、互联网技术和机器学习领域中的应用显示了其在现代信息技术中的核心地位。接下来,我们将探讨集合与哈希表在理论和应用上的未来发展趋势。
7. 集合与哈希表的未来发展趋势
集合与哈希表作为计算机科学中的基础数据结构,随着技术的发展,它们的应用范围和理论基础也在不断拓展和深化。在本章节中,我们将深入探讨集合与哈希表的未来发展趋势,并对未来可能出现的技术革新进行预测。
7.1 集合理论的最新进展
随着计算能力的飞速提升和新型应用场景的不断涌现,集合理论也在不断地被赋予新的内涵和应用。
7.1.1 集合在量子计算中的潜力分析
量子计算代表了计算能力的一次质的飞跃。在量子计算机中,数据的表示和处理方式与传统计算机有很大差异。量子比特(qubits)可以同时表示0和1的状态,这一特性使得集合在量子计算中有着特殊的应用潜力。例如,量子集合可以通过量子比特的叠加状态来存储和操作大量数据,极大地提高集合运算的效率。
flowchart TD
    A[开始] --> B[创建量子集合]
    B --> C[量子比特叠加操作]
    C --> D[量子并行计算]
    D --> E[量子集合结果输出]
    E --> F[结束]
7.1.2 集合与图论的交叉应用前景
集合理论和图论之间有着紧密的联系。图论中的节点和边可以被看作是集合中的元素和元素之间的关系。随着复杂网络分析需求的增加,集合与图论的结合将更加紧密。通过将图转化为集合的操作,可以更高效地进行图的遍历、最短路径搜索和网络社区的检测等任务。
7.2 哈希表技术的未来展望
哈希表作为一种高效的数据检索结构,在各种软件系统中被广泛采用。随着技术的进步,哈希表技术也在逐步演进。
7.2.1 安全哈希算法的发展趋势
安全哈希算法(如SHA-3)在保证数据完整性和验证方面发挥着重要作用。随着网络攻击技术的提升,安全哈希算法也需要不断地更新迭代,以抵御新型攻击。未来的发展趋势将包括提高算法的抗碰撞性能、增加算法的计算效率,以及保障算法在各种计算资源下的稳定性和适应性。
7.2.2 哈希表在新型存储技术中的应用展望
新型存储技术,如非易失性内存(NVM)和新型固态存储设备,为哈希表的实现提供了新的物质基础。这些存储设备具有高速读写能力和持久化存储的特点,有望改善哈希表在传统存储介质上的性能瓶颈。未来,哈希表在新型存储技术中的应用将可能带来更短的延迟和更高的吞吐量,进一步推动数据密集型应用的发展。
graph TD
    A[开始] --> B[识别新型存储技术特性]
    B --> C[优化哈希表数据布局]
    C --> D[调整哈希函数适应存储特性]
    D --> E[实现高效率的读写操作]
    E --> F[评估性能提升]
    F --> G[结束]
在未来,集合理论和哈希表技术的发展将继续影响软件工程、网络安全、数据分析和其他众多领域。理解和把握这些技术的未来趋势对于IT行业的专业人士来说至关重要。随着技术的不断创新,我们可以预见,集合与哈希表将在未来的信息时代中继续发挥它们不可或缺的作用。
简介:集合和哈希表是编程中关键的数据结构,分别用于确保数据唯一性和提供快速的数据访问。集合在Python中通过大括号或set()创建,支持并集、交集、差集等操作。哈希表则依赖哈希函数实现快速的查找、插入和删除,以字典的形式在Python中实现。集合和哈希表在去重、成员测试、高效查找等领域有着广泛的应用。本篇文章深入探讨这些数据结构的特性、用途,并提供编程实例,旨在帮助读者掌握其实际应用。
更多推荐


 21
 0
- 0


 已为社区贡献9条内容

所有评论(0)