
二叉树生成、遍历与树形输出的全面解读

简介:二叉树是计算机科学中广泛使用的数据结构,主要涉及节点生成、三种基本遍历(先序、中序、后序)方法,以及树形输出技术。本篇文章详细介绍了如何使用C语言实现二叉树的基本概念和操作,包括节点的定义、树的构建、遍历算法的递归实现,以及不同风格(垂直与水平)的树形输出。掌握这些技能对于处理搜索、排序和表达式解析等问题至关重要,并且有助于提升编程技能和对更高级树形数据结构的理解。 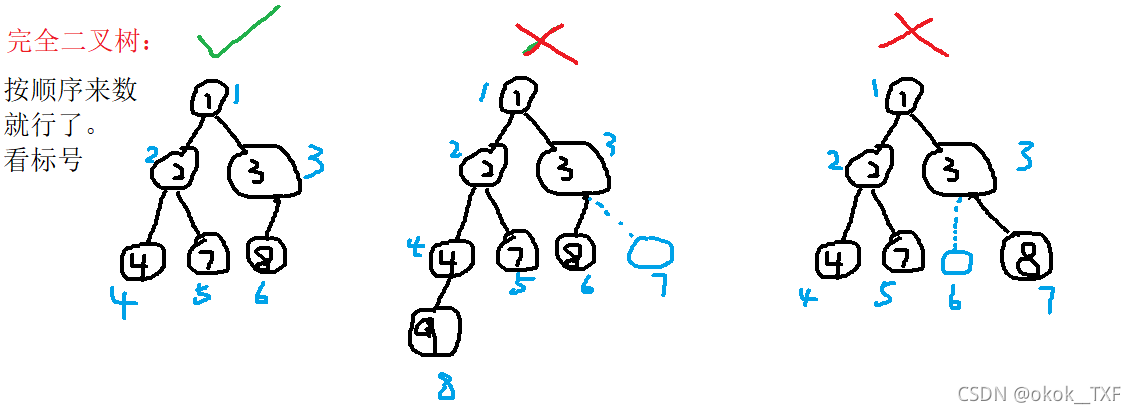
1. 二叉树的定义与特点
1.1 二叉树的基本概念
二叉树是一种常见的树形结构数据,在计算机科学和数据结构中占有重要地位。每个节点最多有两个子节点,分别是左子节点和右子节点。二叉树的特点之一是它的节点层次分明,根节点位于最顶层,其余节点按照从上到下、从左到右的顺序排列。
1.2 二叉树的重要特性
二叉树具有递归性质,对于树中的每个节点,其左子树和右子树也分别是一颗二叉树,这一性质使得二叉树非常适合使用递归算法进行处理。此外,二叉树的层级结构使得它在实现查找和排序算法时效率较高,特别是在二叉搜索树(Binary Search Tree, BST)的应用中。
1.3 二叉树的分类
二叉树根据其结构的不同可以分为多种类型,如完全二叉树、满二叉树和平衡二叉树等。完全二叉树和满二叉树是按照节点排列的完整性来分类的,而平衡二叉树则强调节点插入和删除操作后树的平衡性。理解这些分类有助于我们在实际应用中选择最适合的二叉树结构。
2. C语言中二叉树节点的结构体定义
在构建和处理二叉树时,C语言中的结构体(struct)提供了强大的数据组织能力。通过对节点的定义,可以进一步实现整个树的创建、遍历、查找、插入、删除等操作。本章将深入探讨如何在C语言中定义一个二叉树的节点,并分析其结构体的使用方式。
2.1 二叉树节点的基本结构
2.1.1 数据域的定义
二叉树的节点通常包含数据域和指针域,其中数据域用于存储节点的值,这个值可以是整数、字符或者是指向其他复杂数据结构的指针。定义一个基本的数据域,需要考虑数据的类型和数据的可变性。
typedef struct TreeNode {
    int data; // 数据域,这里以整型为例
    // 其他类型的数据域可以是 char, float, double, 或者是指向结构体的指针等
} TreeNode;
2.1.2 指针域的定义
指针域则包含了指向该节点左右子树节点的指针。这是构建树形结构的关键,通过这些指针,节点之间得以相互链接,形成完整的树状结构。
typedef struct TreeNode {
    int data;
    struct TreeNode *left;  // 指向左子节点的指针
    struct TreeNode *right; // 指向右子节点的指针
} TreeNode;
2.2 结构体与指针的结合应用
2.2.1 结构体指针的使用
在C语言中,结构体指针的使用是构建链式数据结构的基础。通过使用结构体指针,可以在程序中动态地创建和管理二叉树的节点。
TreeNode *createNode(int value) {
    TreeNode *newNode = (TreeNode*)malloc(sizeof(TreeNode)); // 动态分配内存
    if (newNode == NULL) {
        // 处理内存分配失败的情况
        exit(1);
    }
    newNode->data = value;
    newNode->left = NULL;
    newNode->right = NULL;
    return newNode;
}
2.2.2 动态内存分配在二叉树中的应用
在C语言中,动态内存分配提供了灵活的数据管理方式,尤其适合用于构建二叉树这种动态变化的数据结构。
void insertNode(TreeNode **root, int value) {
    // 插入节点的具体实现,这里简化说明
    // 请参考后续章节中的详细二叉树插入操作
}
在上述代码中,我们创建了一个新的树节点,并通过指针的指针( TreeNode ** )来修改原有树根的指向,这在插入或删除节点时尤其有用。
通过本章的介绍,我们已经对C语言中二叉树节点的结构体定义有了初步的认识,下一章将探索二叉树生成的基本思路和方法。
3. 二叉树生成的基本思路和方法
在计算机科学中,二叉树是一种重要的数据结构,它的生成方法直接决定了树的形态与性能。本章将深入探讨二叉树生成的基本思路和方法,包括递归构建思想和非递归策略,并分析它们的适用场景和优缺点。
3.1 递归思想与二叉树的构建
3.1.1 递归创建二叉树的原理
递归构建二叉树是基于树的递归定义而实现的。在构建过程中,我们从根节点开始,递归地为每个非空子节点创建左右子树。递归创建的核心在于,每个子树的创建都遵循相同的模式,即先创建根节点,再创建左右子树。
以下是使用C语言递归创建一个简单的二叉树的代码示例:
#include <stdio.h>
#include <stdlib.h>

// 定义二叉树节点的结构体
typedef struct TreeNode {
    int value;
    struct TreeNode *left;
    struct TreeNode *right;
} TreeNode;

// 创建一个新节点
TreeNode* createNode(int value) {
    TreeNode* newNode = (TreeNode*)malloc(sizeof(TreeNode));
    newNode->value = value;
    newNode->left = NULL;
    newNode->right = NULL;
    return newNode;
}

// 递归创建二叉树
TreeNode* createBinaryTree() {
    int value;
    scanf("%d", &value);
    if (value == -1) { // 假设输入-1表示空节点
        return NULL;
    }
    TreeNode* root = createNode(value);
    printf("Enter left child of %d: ", value);
    root->left = createBinaryTree();
    printf("Enter right child of %d: ", value);
    root->right = createBinaryTree();
    return root;
}

int main() {
    // 创建二叉树
    TreeNode* root = createBinaryTree();
    // ... 后续操作 ...
    return 0;
}
在上述代码中,我们首先定义了二叉树节点的结构体 TreeNode 。然后,实现了一个创建新节点的函数 createNode 和一个递归创建二叉树的函数 createBinaryTree 。通过读取输入,我们构建出一个二叉树,其中 -1 被用作空节点的占位符。
3.1.2 递归方法构建特定规则的二叉树
在某些特定的应用场景下,可能需要构建具有特殊规则的二叉树,如完全二叉树、满二叉树或平衡二叉树等。递归方法构建这类二叉树的关键在于按照特定规则编写递归函数。
以构建一个完全二叉树为例,我们可以按照完全二叉树的性质进行递归创建:
TreeNode* createCompleteBinaryTree(int n) {
    if (n <= 0) {
        return NULL;
    }
    TreeNode* root = createNode(n);
    if (2 * n <= 2 * (n - 1)) {
        root->left = createCompleteBinaryTree(2 * n);
        root->right = createCompleteBinaryTree(2 * n + 1);
    }
    return root;
}
在上述代码中,我们首先创建了根节点,然后根据完全二叉树的性质,为节点分配左右子节点。这种方法确保了构建的二叉树符合完全二叉树的定义。
3.2 非递归生成二叉树的策略
递归方法虽然直观且易于理解,但在处理大型树或栈溢出敏感的应用时,非递归方法可能是更合适的选择。本节将探讨使用栈实现非递归建树的策略和广度优先、深度优先算法在非递归建树中的应用。
3.2.1 使用栈实现非递归建树
使用栈实现非递归建树的基本思路是通过栈的后进先出(LIFO)特性来模拟递归调用栈。在建树过程中,我们按照层次遍历的方式进行,先访问根节点,然后依次将子节点入栈。
下面是使用栈非递归创建二叉树的C语言实现:
TreeNode* createBinaryTreeWithStack() {
    int value;
    scanf("%d", &value);
    if (value == -1) {
        return NULL;
    }
    TreeNode* root = createNode(value);
    TreeNode** stack = (TreeNode**)malloc(sizeof(TreeNode*) * 100); // 假设栈足够大
    int top = -1;

    stack[++top] = root; // 根节点入栈

    while (top >= 0) {
        TreeNode* node = stack[top--];
        printf("Enter left child of %d: ", node->value);
        int leftVal;
        scanf("%d", &leftVal);
        if (leftVal != -1) {
            node->left = createNode(leftVal);
            stack[++top] = node->left;
        }
        printf("Enter right child of %d: ", node->value);
        int rightVal;
        scanf("%d", &rightVal);
        if (rightVal != -1) {
            node->right = createNode(rightVal);
            stack[++top] = node->right;
        }
    }
    free(stack); // 释放栈内存
    return root;
}
在这个函数中,我们使用了一个栈来跟踪需要处理的节点。通过不断地将节点入栈和出栈,我们模拟了递归创建二叉树的过程,但避免了递归可能引发的栈溢出问题。
3.2.2 广度优先和深度优先算法的应用
在非递归建树的场景中,广度优先搜索(BFS)和深度优先搜索(DFS)算法都可以被应用。BFS通常使用队列实现,而DFS通常使用栈实现。由于栈的后进先出特性,它自然适用于DFS。
这里我们提供一个使用DFS非递归构建二叉树的框架,以便于对DFS有更深入的理解和应用:
void DFSCreateBinaryTree(TreeNode** root) {
    // 创建栈用于存储树节点
    TreeNode** stack = (TreeNode**)malloc(sizeof(TreeNode*) * 100);
    int top = -1;
    // 假设读取输入的方式已定义为函数readValue(),空节点输入为-1
    int value = readValue();
    *root = createNode(value);
    stack[++top] = *root;
    while (top >= 0) {
        TreeNode* node = stack[top--];
        value = readValue();
        if (value != -1) {
            node->left = createNode(value);
            stack[++top] = node->left;
        }
        value = readValue();
        if (value != -1) {
            node->right = createNode(value);
            stack[++top] = node->right;
        }
    }
    free(stack);
}
在这个例子中,我们使用了一个栈来存储即将创建的节点,并按照DFS的方式遍历栈。每次从栈中弹出一个节点,然后为其创建左右子节点并将其子节点压入栈中。
至此,我们已经详细讨论了二叉树生成的基本思路和方法,包括递归思想和非递归策略。接下来,我们将进一步探索二叉树的不同遍历方式,这将为我们提供更多的工具来处理和分析二叉树。
4. 三种经典遍历方式的介绍和C语言实现
4.1 前序、中序和后序遍历的概念与算法
4.1.1 遍历的定义和特点
在讨论二叉树的遍历方法之前,需要明确遍历的定义。二叉树的遍历是指从根节点出发,按照某种规则访问树中所有节点,且每个节点仅被访问一次的过程。常见的三种遍历方式分别为前序遍历(Pre-order)、中序遍历(In-order)和后序遍历(Post-order)。
前序遍历的特点是先访问根节点,然后递归地进行前序遍历左子树,接着递归地进行前序遍历右子树。中序遍历则是先递归地进行中序遍历左子树,然后访问根节点,最后递归地进行中序遍历右子树。后序遍历则是先递归地进行后序遍历左子树,然后递归地进行后序遍历右子树,最后访问根节点。这三种遍历方式各自有着独特的应用场景和特性。
4.1.2 遍历的递归和非递归实现
前序遍历
递归实现前序遍历的伪代码如下:
void preOrderTraversal(TreeNode *node) {
    if (node == NULL) {
        return;
    }
    // 访问当前节点
    visit(node);
    // 递归遍历左子树
    preOrderTraversal(node->left);
    // 递归遍历右子树
    preOrderTraversal(node->right);
}
非递归实现则通常使用栈来进行,伪代码如下:
void preOrderTraversalNonRecursive(TreeNode *root) {
    if (root == NULL) {
        return;
    }
    Stack *stack = createStack();
    TreeNode *current = root;
    while (current != NULL || !stackIsEmpty(stack)) {
        while (current != NULL) {
            // 访问当前节点
            visit(current);
            push(stack, current);
            current = current->left;
        }
        if (!stackIsEmpty(stack)) {
            // 弹出并访问节点
            TreeNode *topNode = pop(stack);
            current = topNode->right;
        }
    }
    freeStack(stack);
}
中序遍历
递归实现中序遍历的伪代码:
void inOrderTraversal(TreeNode *node) {
    if (node == NULL) {
        return;
    }
    // 递归遍历左子树
    inOrderTraversal(node->left);
    // 访问当前节点
    visit(node);
    // 递归遍历右子树
    inOrderTraversal(node->right);
}
非递归实现使用栈:
void inOrderTraversalNonRecursive(TreeNode *root) {
    if (root == NULL) {
        return;
    }
    Stack *stack = createStack();
    TreeNode *current = root;
    while (current != NULL || !stackIsEmpty(stack)) {
        while (current != NULL) {
            push(stack, current);
            current = current->left;
        }
        if (!stackIsEmpty(stack)) {
            // 弹出并访问节点
            TreeNode *topNode = pop(stack);
            visit(topNode);
            current = topNode->right;
        }
    }
    freeStack(stack);
}
后序遍历
递归实现后序遍历的伪代码:
void postOrderTraversal(TreeNode *node) {
    if (node == NULL) {
        return;
    }
    // 递归遍历左子树
    postOrderTraversal(node->left);
    // 递归遍历右子树
    postOrderTraversal(node->right);
    // 访问当前节点
    visit(node);
}
非递归实现后序遍历较为复杂,一般需要两个栈来实现,伪代码如下:
void postOrderTraversalNonRecursive(TreeNode *root) {
    if (root == NULL) {
        return;
    }
    Stack *stack1 = createStack();
    Stack *stack2 = createStack();
    push(stack1, root);
    while (!stackIsEmpty(stack1)) {
        TreeNode *current = pop(stack1);
        push(stack2, current);
        // 先压入左子节点
        if (current->left != NULL) {
            push(stack1, current->left);
        }
        // 再压入右子节点
        if (current->right != NULL) {
            push(stack1, current->right);
        }
    }
    while (!stackIsEmpty(stack2)) {
        TreeNode *current = pop(stack2);
        visit(current);
    }
    freeStack(stack1);
    freeStack(stack2);
}
4.2 层次遍历的实现
4.2.1 使用队列进行层次遍历
层次遍历(Level Order Traversal)是指按照从根节点开始到叶子节点的每一层,从左至右的顺序访问节点。层次遍历通常使用队列来实现。
伪代码如下:
void levelOrderTraversal(TreeNode *root) {
    if (root == NULL) {
        return;
    }
    Queue *queue = createQueue();
    enqueue(queue, root);
    while (!queueIsEmpty(queue)) {
        TreeNode *current = dequeue(queue);
        visit(current);
        if (current->left != NULL) {
            enqueue(queue, current->left);
        }
        if (current->right != NULL) {
            enqueue(queue, current->right);
        }
    }
    freeQueue(queue);
}
4.2.2 层次遍历的应用实例
层次遍历在很多应用中都非常实用,例如,可以用于计算二叉树的深度。以下是使用层次遍历计算二叉树深度的示例代码:
int getBinaryTreeDepth(TreeNode *root) {
    if (root == NULL) {
        return 0;
    }
    Queue *queue = createQueue();
    int depth = 0;
    TreeNode *current;
    enqueue(queue, root);
    while (!queueIsEmpty(queue)) {
        int levelSize = queueSize(queue);
        depth++;
        while (levelSize > 0) {
            current = dequeue(queue);
            if (current->left != NULL) {
                enqueue(queue, current->left);
            }
            if (current->right != NULL) {
                enqueue(queue, current->right);
            }
            levelSize--;
        }
    }
    freeQueue(queue);
    return depth;
}
通过上述代码,我们可以在遍历每一层的同时递增深度计数器,从而获得二叉树的整体深度。这种方法仅使用基本的队列操作,因此在内存使用上相对高效。
层次遍历还有其他的应用场景,例如用于BFS(广度优先搜索)中,或在需要按层级操作的算法中。它的实现方法简洁,效率较高,是二叉树遍历中非常基础且重要的方法之一。
5. 树形输出的不同方法和实现
5.1 树形结构的可视化方法
树形输出的常见格式
在计算机科学中,树形结构是通过视觉图形来表示层级和层次关系的一种常用方式。它是一种非常直观的表现形式,尤其在表示数据结构、文件系统以及组织结构等方面非常有效。树形输出可以有多种表现形式,包括但不限于文本式输出、图形界面展示以及使用图形库绘制。
文本式输出是最简单直接的表示方法,通过缩进来表示父子关系,如下所示:
       A
     / | \
    B  C  D
   /|   |\
  E F   G H
图形界面展示则通过图形界面元素(如节点和连接线)来构建树形结构,通常比文本式输出更加直观和易于理解。
使用图形库绘制是一种更为美观且功能强大的可视化方法。常见的图形库如Graphviz、D3.js等能够支持生成复杂且美观的树形图,便于开发者在网页或者其他应用程序中展示树形结构。
美化树形输出的技巧
美化树形输出的目的是为了使信息更易于阅读和理解。以下是一些常用的技巧:
- 颜色区分 :使用不同的颜色来区分不同的层级或类别,可以增强视觉效果,使观察者更容易区分信息的不同部分。
-
连线样式 :调整连线的样式,如使用实线或虚线,以及调整连线的宽度,有助于突出信息结构。
-
节点样式 :为节点添加不同形状或者增加阴影效果,可以使得树形结构更加立体和醒目。
-
交互性 :如果树形输出是通过网页或图形界面展示的,增加交互功能如点击展开、缩放等,可以使用户更方便地查看和分析数据。
-
布局算法 :使用不同的布局算法来排列节点,例如水平布局、垂直布局或径向布局,可以针对不同的需求选择最合适的展现方式。
5.2 实际应用中的树形输出
文件系统的树形表示
在操作系统中,文件系统是树形结构的一个典型应用。每个文件夹可以视为树的一个节点,文件夹内的文件和子文件夹则是这个节点的子节点。这样的结构不仅方便管理文件,还易于实现文件的查找、排序等功能。
在C语言中,可以通过递归遍历的方式来表示文件系统的树形结构。例如,下面的代码展示了如何递归地列出一个目录及其所有子目录中的文件:
#include <stdio.h>
#include <stdlib.h>
#include <dirent.h>
#include <sys/stat.h>

void list_dir(const char *path) {
    DIR *d;
    struct dirent *dir;
    if (!(d = opendir(path))) {
        perror("opendir");
        return;
    }
    while ((dir = readdir(d)) != NULL) {
        if (dir->d_type == DT_DIR) {
            printf("%s/\n", dir->d_name);
            char path2[256];
            sprintf(path2, "%s/%s", path, dir->d_name);
            list_dir(path2);
        } else {
            printf("%s\n", dir->d_name);
        }
    }
    closedir(d);
}

int main() {
    list_dir("/path/to/directory"); // 替换为实际目录路径
    return 0;
}
组织结构的树形图绘制
在组织结构中,公司部门、员工和领导之间的层级关系也可以通过树形结构来表示。这种表示方式可以帮助分析组织内的权力结构、职责分配以及沟通路径等。
在C语言中,可以通过构建二叉树的方式来模拟组织结构,并通过前序、中序或者后序遍历来输出组织结构图。下面是一个简单的代码示例:
#include <stdio.h>
#include <stdlib.h>

typedef struct node {
    char name[50];
    struct node *left;
    struct node *right;
} Node;

// 创建树节点
Node* create_node(const char *name) {
    Node* node = (Node*)malloc(sizeof(Node));
    strcpy(node->name, name);
    node->left = NULL;
    node->right = NULL;
    return node;
}

// 向树中添加节点,模拟组织结构
void add_node(Node **root, const char *name, const char *parent) {
    if (*root == NULL) {
        *root = create_node(name);
    } else {
        if (strcmp((*root)->name, parent) == 0) {
            Node *new_node = create_node(name);
            if ((*root)->left == NULL) {
                (*root)->left = new_node;
            } else if ((*root)->right == NULL) {
                (*root)->right = new_node;
            } else {
                printf("Cannot add '%s', '%s' already has two children.\n", name, parent);
                free(new_node);
            }
        } else {
            add_node(&((*root)->left), name, parent);
            add_node(&((*root)->right), name, parent);
        }
    }
}

// 递归输出组织结构树
void print_tree(Node *node, int level) {
    if (node == NULL) return;
    print_tree(node->right, level + 1);
    for (int i = 0; i < level; i++) {
        printf("  ");
    }
    printf("%s\n", node->name);
    print_tree(node->left, level + 1);
}

int main() {
    Node *org_chart = NULL;
    add_node(&org_chart, "Alice", "CEO");
    add_node(&org_chart, "Bob", "CEO");
    add_node(&org_chart, "Charlie", "Alice");
    add_node(&org_chart, "Dave", "Alice");
    add_node(&org_chart, "Eve", "Bob");
    add_node(&org_chart, "Frank", "Bob");

    print_tree(org_chart, 0); // 打印组织结构图

    // 释放内存...
    return 0;
}
以上代码通过递归遍历二叉树的方式,模拟了组织结构的层级关系,并将组织结构以树形图的方式展示出来。需要注意的是,这里仅展示了一个简化版本,实际应用中组织结构可能更为复杂,可能需要构建多叉树等数据结构来更准确地表示。
6. 二叉树的应用场景分析
6.1 二叉搜索树的应用
二叉搜索树(BST)是一种特殊的二叉树,它满足任何一个节点的左子树中的所有元素都小于该节点本身,右子树中的所有元素都大于该节点本身。这种特殊的结构决定了BST在数据检索和排序方面的高效性。
6.1.1 二叉搜索树的特点
二叉搜索树的特点主要包括以下几点:
- 每个节点都包含一个键值和两个指向子树的指针。
- 左子树中的所有键值都小于其父节点的键值。
- 右子树中的所有键值都大于其父节点的键值。
- 左右子树也分别是二叉搜索树。
二叉搜索树允许快速查找、添加和删除节点。查找操作的时间复杂度在最坏情况下是O(log n),当树完全不平衡时退化成链表。删除节点的操作稍微复杂,可能需要更新被删除节点的子树。
6.1.2 在排序和查找中的应用
在排序方面,二叉搜索树可以被用来构建一个有序的数据集。通过对树进行中序遍历(访问左子树→节点→右子树),可以得到一个递增序列。二叉搜索树的排序效率取决于树的平衡性。
在查找方面,二叉搜索树提供了一种有效的方式去检索数据。比如,查找一个特定的值,可以从树的根节点开始,如果目标值比根节点的值小,则往左子树查找,反之则往右子树查找。这个过程可以不断递归或迭代进行,直到找到目标值或者遍历到叶子节点为止。
一个简单的C语言实现查找操作的代码示例如下:
struct TreeNode {
    int value;
    struct TreeNode *left;
    struct TreeNode *right;
};

// 递归函数查找特定值
struct TreeNode* searchBST(struct TreeNode* root, int value) {
    if (root == NULL || root->value == value) {
        return root;
    }
    if (value < root->value) {
        return searchBST(root->left, value);
    } else {
        return searchBST(root->right, value);
    }
}
在这个代码中, root 是二叉搜索树的根节点, value 是我们要查找的值。如果找到对应的节点,函数返回该节点的指针;如果没有找到,返回 NULL 。该操作的时间复杂度是O(h),其中h是树的高度。
6.2 堆和优先队列的实现
堆是一种特殊的完全二叉树,它满足父节点的键值或索引总是大于或等于(在最小堆中)或小于或等于(在最大堆中)任何一个子节点的键值或索引。堆常被用于实现优先队列,这是因为堆的特性使得最大的元素总是位于树的根节点,这为快速检索最大元素提供了便利。
6.2.1 堆的概念及其性质
堆(Heap)通常分为两种:最大堆(Max Heap)和最小堆(Min Heap)。在最大堆中,任何一个父节点的值都大于或等于其子节点的值。而在最小堆中,任何一个父节点的值都小于或等于其子节点的值。
堆的性质包括:
- 堆是一棵完全二叉树。
- 堆中的所有节点的值都满足堆的性质。
堆通常用一维数组来表示,这是因为数组可以非常方便地通过计算索引来访问父节点和子节点。
6.2.2 堆在优先队列中的应用
在优先队列中,元素具有优先级属性,并且我们总希望移除最高优先级的元素。堆结构正好可以满足这种需求。优先队列通常需要支持两个操作:
- 插入(push):将新元素加入优先队列。
- 删除(pop):移除并返回优先队列中的最高优先级元素。
使用堆实现优先队列可以保证 push 和 pop 操作都在O(log n)时间内完成,其中n是堆中元素的数量。
下面是一个堆插入操作的C语言实现示例:
#define MAX_SIZE 100

void push(int heap[], int* size, int element) {
    // 堆未满,添加新元素到数组末尾
    if (*size < MAX_SIZE) {
        heap[(*size)++] = element;
        int index = *size - 1;
        // 维护最大堆性质,向上调整
        while (index && heap[(index - 1) / 2] < heap[index]) {
            swap(&heap[(index - 1) / 2], &heap[index]);
            index = (index - 1) / 2;
        }
    }
}

void swap(int *a, int *b) {
    int t = *a;
    *a = *b;
    *b = t;
}
在此代码中, heap 代表一个最大堆的数组表示, size 是当前堆中元素的数量, element 是要插入的新元素。插入操作首先在数组末尾添加元素,然后通过向上调整的方式来维持堆的性质。如果新插入的元素比它的父元素大,就将新元素与父元素交换,直到新元素的父元素不再比它小。
这样,通过堆结构,我们可以快速实现优先队列的需求,支持高效的数据组织和快速的优先级管理。
7. 二叉树的高级操作与优化
在数据结构的学习与应用中,二叉树作为一种基础而重要的数据结构,不仅在理论研究上占有重要位置,在实际应用中也经常出现。在本章中,我们将探讨二叉树的高级操作及优化,包括平衡二叉树的概念、维护以及B树和B+树在数据库中的应用。
7.1 平衡二叉树的概念和维护
7.1.1 平衡二叉树(AVL树)的介绍
AVL树,是一种自平衡的二叉搜索树,由Adelson-Velsky和Landis提出,因此得名。在AVL树中,任何节点的两个子树的高度最大差别为一。如果在插入或删除节点后,任一节点的平衡因子(左右子树的高度差)超过1,则会通过旋转来重新调整树的平衡。
为了保证树的平衡性,AVL树在插入和删除节点时需要进行一系列旋转操作。常见的旋转操作包括单旋转(右旋、左旋)和双旋转(左右旋、右左旋)。
7.1.2 AVL树的旋转操作和平衡维护
在讨论AVL树的旋转操作前,需要先理解节点的平衡因子和四种旋转操作的概念:
- 平衡因子 :节点的左子树高度减去右子树高度。
- 左旋 :围绕节点进行,将节点的右子节点移到该节点的位置,并将原节点移为其左子节点。
- 右旋 :围绕节点进行,将节点的左子节点移到该节点的位置,并将原节点移为其右子节点。
- 左-右旋 :先左旋,后右旋。
- 右-左旋 :先右旋,后左旋。
下面是一个AVL树在插入节点后的平衡调整示例:
假设有一个AVL树的节点结构定义如下:
typedef struct AVLNode {
    int key;
    int height;
    struct AVLNode *left;
    struct AVLNode *right;
} AVLNode;
我们首先需要实现获取节点高度的函数以及计算平衡因子的函数,然后实现各种旋转操作函数。这里提供左旋转操作的伪代码:
AVLNode* leftRotate(AVLNode *x) {
    AVLNode *y = x->right;
    AVLNode *T2 = y->left;

    // Perform rotation
    y->left = x;
    x->right = T2;

    // Update heights
    x->height = max(getHeight(x->left), getHeight(x->right)) + 1;
    y->height = max(getHeight(y->left), getHeight(y->right)) + 1;

    // Return new root
    return y;
}
在每次插入和删除节点后,我们需要从插入或删除点开始向上逐级更新节点的高度,并检查每个节点的平衡因子是否在允许范围内。如果不在,根据平衡因子的不同情况,执行相应的旋转操作。
7.2 B树和B+树在数据库中的应用
7.2.1 B树和B+树的基本概念
B树(B-Tree)和B+树都是平衡多路查找树,广泛应用于数据库和文件系统。它们能够保持数据的有序性,同时减少磁盘I/O操作的次数。
B树的每个节点可以包含多个键值和子节点,允许从树的根节点到每个叶子节点的路径长度相同。与AVL树不同,B树更加适合磁盘存储系统,因为它能够有效地读取和写入大量数据。
B+树是B树的一种变体,在B+树中,所有的数据记录都存储在叶子节点中,非叶子节点仅存储键值和指向子节点的指针。
7.2.2 数据库索引和B树的应用实例
在数据库系统中,B树被用于实现索引结构,以快速定位数据。这里以B树在SQL数据库中的应用为例进行说明:
- 数据插入:在插入数据时,B树通过分裂节点的方式来保持树的平衡。
- 数据检索:通过遍历B树,可以快速找到对应的键值。
- 数据更新:更新操作可能会涉及节点的分裂和合并。
- 数据删除:删除操作可能需要合并子节点和调整树的高度。
B树在数据库索引中的应用,能够显著提高数据检索的效率,尤其是在大数据量的情况下。
虽然我们已经详细探讨了平衡二叉树(AVL树)和B树的高级操作,但需要注意的是,优化二叉树并不仅仅局限于平衡和旋转操作,还包括诸如优化存储结构、减少内存分配、并行计算等多方面的技术和策略。在接下来的章节中,我们将继续深入探讨二叉树的优化方法。
简介:二叉树是计算机科学中广泛使用的数据结构,主要涉及节点生成、三种基本遍历(先序、中序、后序)方法,以及树形输出技术。本篇文章详细介绍了如何使用C语言实现二叉树的基本概念和操作,包括节点的定义、树的构建、遍历算法的递归实现,以及不同风格(垂直与水平)的树形输出。掌握这些技能对于处理搜索、排序和表达式解析等问题至关重要,并且有助于提升编程技能和对更高级树形数据结构的理解。
更多推荐

 15
 0
- 0


 已为社区贡献7条内容

所有评论(0)