
动态规划 8. 01背包问题解法(二维dp数组、滚动数组)以及python中输入的处理方法
动态规划 8. 01背包问题解法(二维dp数组、滚动数组)以及python中输入的处理方法
最重要的两句话:
- dp[i][j] 表示从下标为[0-i]的物品里任意取,放进容量为j的背包,价值总和最大是多少。
- 递归公式:
dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i])
二维dp数组解法
-
思路
这里用
weight[i]表示物品i对应的重量,value[i]表示物品i的价值题目中物品种类数量为
M,背包最大容量为N-
开一个二维dp表
行
i表示当前轮到物品i,一共M行;列
j表示当前背包容量为j,范围为[0, N]!(记住是一共N+1列)定义:
dp[i][j] 表示从下标在区间 [0, i] 内的物品里任意取,放进容量为j的背包,其最大的价值总和 -
找到递推式
dp[i][j]的来源有两种情况:-
不放物品
i:这也有两种可能情况:
-
当前背包可能容量不足以放置物品
i,因此最大价值必然是dp[i - 1][j]这种情况在遍历时要单独拿出来处理!!!
因为这种情况下,不存在
j - weight[i] (或者说j - weight[i] **为负数)** -
当前背包容量足以放置物品
i,但是可能容量并没有很大,或者由于其他原因,导致放完物品
i后的背包价值,还不如不放物品i,而是保持与dp[i - 1][j]一样的配置
背包容量为
j,里面不放物品i的最大价值是dp[i - 1][j]。**直观理解:**
dp[i][j]的上方的格子的值。 -
-
放物品
i:背包留出物品
i的容量来放物品i;然后,剩余背包容量为
j - weight[i],
dp[i - 1][j - weight[i]] 为背包容量为j - weight[i]且不放物品i的最大价值;那么
dp[i - 1][j - weight[i]] + value[i] ,就是背包放物品i得到的最大价值。**直观理解:**
dp[i][j]前一行的格子中,选择对应的剩余背包容量的格子,然后加上新放入的物品i的价值
递归公式:
dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i]) -
-
dp初始化方法
最初全部初始化为0
-
对于最左列
dp[i][0] : 如果背包容量j为0的话,即,无论是选取哪些物品,背包价值总和一定为0。 -
对于最上行
dp[0][j] : 即i为0,存放编号0的物品的时候,各个容量的背包所能存放的最大价值。此时,我们手中只能选择编号为0的物品,
因此,当背包容量
j小于编号为0的物品时,初始化dp[0][j]为0,当背包容量
j大于等于于编号为0的物品时,初始化dp[0][j]为value[0]
-
-
确定遍历顺序
先遍历物品还是先遍历背包重量都没问题
一般外循环遍历物品(行),内循环遍历背包重量(列)
-
-
代码
import sys
lines = sys.stdin.readlines()

# 获取输入内容
M, N = map(int, lines[0].strip().split()) # M: 研究材料数;N: 行李空间
weights = list(map(int, lines[1].strip().split()))
values = list(map(int, lines[2].strip().split()))

# 初始化dp:
# dp[i][j] 表示从下标在区间[0, i]内的物品里任意取,放进容量为j的背包,其最大的价值总和
dp = [[0] * (N + 1) for _ in range(M)]
for j in range(weights[0], N + 1):
    # j >= weights[0]时,dp[0][j] = values[0]
    dp[0][j] = values[0]
# 最开始初始化已经为0,所以不需要再手动初始化最左列

# 递推遍历
for i in range(1, M): # 当前物品索引i
    for j in range(1, N + 1): # 当前背包最大容量j
        if weights[i] > j: # 当前背包容量j不足以放置物品i
            dp[i][j] = dp[i-1][j]
        else: # 当前背包容量j可以放置物品i
            dp[i][j] = max(dp[i-1][j],
                    dp[i-1][j-weights[i]] + values[i])

print(dp[-1][-1])
滚动数组解法(重要)
-
思路
详细可见后面对代码随想录的摘录,这里只记录我认为的要点
-
其实就是压缩物品(行)维度
-
重点在于,递推公式改变为:
dp[j] = max(dp[j], dp[j - weight[i]] + value[i]),而遍历顺序要变为逆序遍历!!!
这里用
weight[i]表示物品i对应的重量,value[i]表示物品i的价值题目中物品种类数量为
M,背包最大容量为N-
开一个一维dp表
列
j表示当前背包容量为j,范围为[0, N]!(记住是一共N+1列)定义:
dp[j] 表示选取物品放进容量为j的背包,其最大的价值总和为dp[j] -
找到递推式
dp[j]为 容量为j的背包所背的最大价值。
dp[j]可以通过dp[j - weight[i]]推导出来,dp[j - weight[i]]表示容量为j - weight[i]的背包所背的最大价值。
dp[j - weight[i]] + value[i] 表示 容量为[j - 物品i重量] 的背包 加上 物品i的价值。(也就是容量为j的背包,放入物品i了之后的价值即:dp[j])此时
dp[j]有两个选择,一个是取自己dp[j] 相当于 二维dp数组中的dp[i-1][j],即不放物品i,一个是取dp[j - weight[i]] + value[i],即放物品i,指定是取最大的,毕竟是求最大价值,所以递归公式为:
dp[j] = max(dp[j], dp[j - weight[i]] + value[i]);可以看出相对于二维dp数组的写法,就是把
dp[i][j]中i的维度去掉了。GPT生成的解释: (关键点在于,能这样递推,是因为后面遍历顺序改变了,采用的是逆序遍历!)
在 01 背包问题的 一维 dp 数组优化 过程中,我们不需要考虑
dp[j - weight[i]] 是否在本轮迭代中被更新过,这是因为 遍历的顺序保证了正确性。以下是详细解释:1. 为什么可以这样做?
核心原因在于:
-
dp[j] = max(dp[j], dp[j - weight[i]] + value[i]) 这个公式的正确性依赖于 dp[j - weight[i]] 在更新 dp[j] 之前,仍然是“上一层”的值。 - 通过逆序遍历(从
j = bag_size 递减到j = weight[i]),我们确保dp[j - weight[i]] 在使用时,仍然是上一层的结果,而不会被当前物品的计算影响。
2. 为什么不需要担心
dp[j - weight[i]] 被更新的问题?如果我们采用 正序遍历(即
j 从0 增加到bag_size),在计算dp[j] 时,dp[j - weight[i]] 可能已经被本轮i 迭代的计算修改了,导致错误的状态传播。但我们使用 逆序遍历(从
j = bag_size 递减到j = weight[i]),这样dp[j - weight[i]] 在dp[j] 计算时,仍然保持着上一次 i-1 轮次的值,保证了递推公式的正确性。 -
-
dp初始化方法
最初初始化全为0
由于这里第一行也可以放入循环中,且逆序遍历,因此不需要再像二维dp方法中那样初始化最上行了
-
确定遍历顺序(最重要!!!)
-
一定要外层遍历物品,内层遍历背包容量!!!
-
二维dp遍历的时候,背包容量是从小到大,而一维dp遍历的时候,背包一定要从大到小。
也就是说,这里:
外循环从左往右遍历(这个无关紧要)
内循环**从右往左遍历!!!(这个很重要)**
因为倒序遍历是为了保证物品i只被放入一次! 但如果一旦正序遍历了,那么物品0就会被重复加入多次!
(正序遍历会导致在计算
dp[j] 而需要引用dp[j-weight[i]] 时,dp[j-weight[i]] 已经在前面的遍历中更新过了,导致错误)遍历代码:
for i in range(M): # 应该先遍历物品,如果遍历背包容量放在上一层,那么每个dp[j]就只会放入一个物品
    for j in range(N, weights[i] - 1, -1): # 倒序遍历背包容量!能够保证物品i只被放入一次。
    # 注意起始和终止的背包容量,其中终止的背包容量设置是因为再往前走,背包将放不下物品i,导致dp[j]直接和上一层相同,无需再手动拷贝了
        dp[j] = max(dp[j], dp[j-weights[i]] + values[i])
注意起始和终止的背包容量,
其中终止的背包容量设置是因为如果再往前遍历,背包将放不下物品
i ,导致dp[j] 直接和上一层相同,无需再手动拷贝了 -
-
-
代码:
import sys
lines = sys.stdin.readlines()

# 获取输入内容
M, N = map(int, lines[0].strip().split()) # M: 研究材料数;N: 行李空间
weights = list(map(int, lines[1].strip().split()))
values = list(map(int, lines[2].strip().split()))

# 初始化dp:
# dp[j] 表示选取物品放进容量为j的背包,其最大的价值总和为dp[j]
dp = [0] * (N + 1)

# 递推遍历
for i in range(M): # 应该先遍历物品,如果遍历背包容量放在上一层,那么每个dp[j]就只会放入一个物品
    for j in range(N, weights[i] - 1, -1): # 倒序遍历背包容量!能够保证物品i只被放入一次。
    # 注意起始和终止的背包容量,其中终止的背包容量设置是因为再往前走,背包将放不下物品i,导致dp[j]直接和上一层相同,无需再手动拷贝了
        dp[j] = max(dp[j], dp[j-weights[i]] + values[i])

print(dp[-1])
下面摘录代码随想录中对01背包的理论讲解作为参考
-
理论讲解,均摘自代码随想录:
对于面试的话,其实掌握01背包和完全背包,就够用了,最多可以再来一个多重背包。
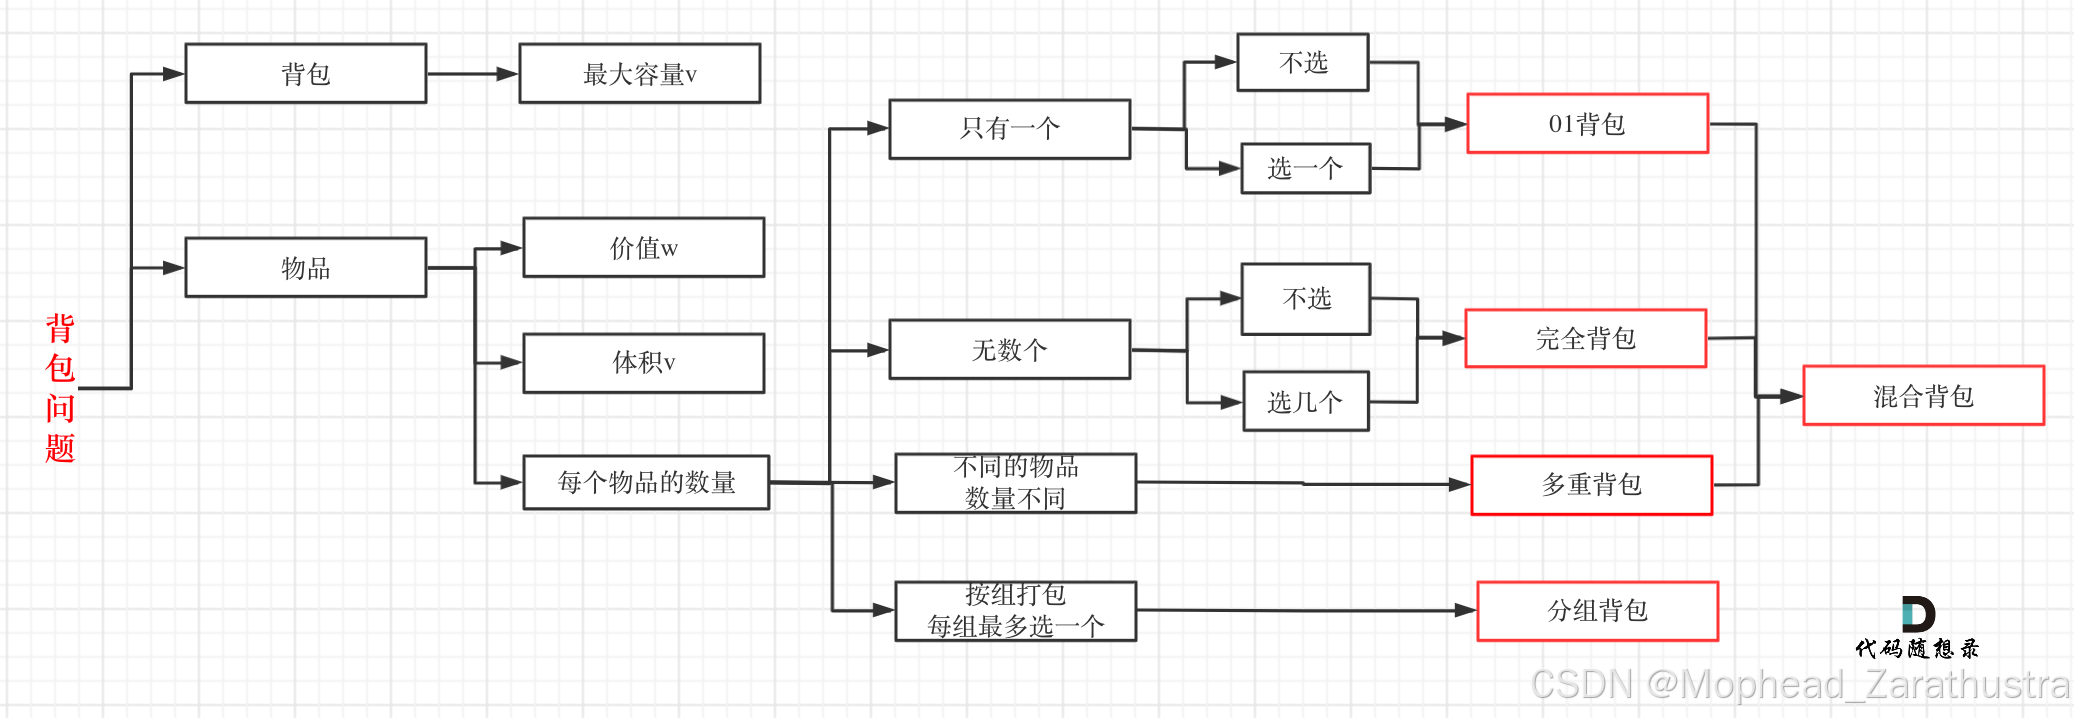
完全背包又是也是01背包稍作变化而来,即:完全背包的物品数量是无限的。
所以背包问题的理论基础重中之重是01背包,一定要理解透!
01 背包
-
有n件物品和一个最多能背重量为w 的背包。第i件物品的重量是weight[i],得到的价值是value[i] 。每件物品只能用一次,求解将哪些物品装入背包里物品价值总和最大。
这是标准的背包问题,以至于很多同学看了这个自然就会想到背包,甚至都不知道暴力的解法应该怎么解了。
这样其实是没有从底向上去思考,而是习惯性想到了背包,那么暴力的解法应该是怎么样的呢?
每一件物品其实只有两个状态,取或者不取,所以可以使用回溯法搜索出所有的情况,那么时间复杂度就是O(2^n),这里的n表示物品数量。
所以暴力的解法是指数级别的时间复杂度。进而才需要动态规划的解法来进行优化!
在下面的讲解中,我举一个例子:
背包最大重量为4。
物品为:
重量 价值 物品0 1 15 物品1 3 20 物品2 4 30 问背包能背的物品最大价值是多少?
以下讲解和图示中出现的数字都是以这个例子为例。
(为了方便表述,下面描述 统一用 容量为XX的背包,放下容量(重量)为XX的物品,物品的价值是XX)
二维dp数组01背包
-
依然动规五部曲分析一波。
1. 确定dp数组以及下标的含义
-
我们需要使用二维数组,为什么呢?
因为有两个维度需要分别表示:物品 和 背包容量
如图,二维数组为 dp[i][j]。
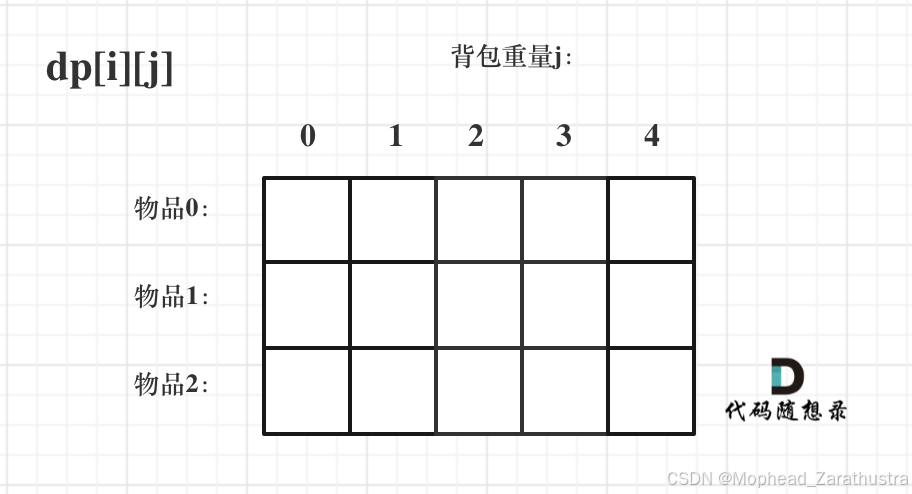
那么这里 i 、j、dp[i][j] 分别表示什么呢?
i 来表示物品、j表示背包容量。
(如果想用j 表示物品,i 表示背包容量 行不行? 都可以的,个人习惯而已)
我们来尝试把上面的 二维表格填写一下。
动态规划的思路是根据子问题的求解推导出整体的最优解。
我们先看把物品0 放入背包的情况:
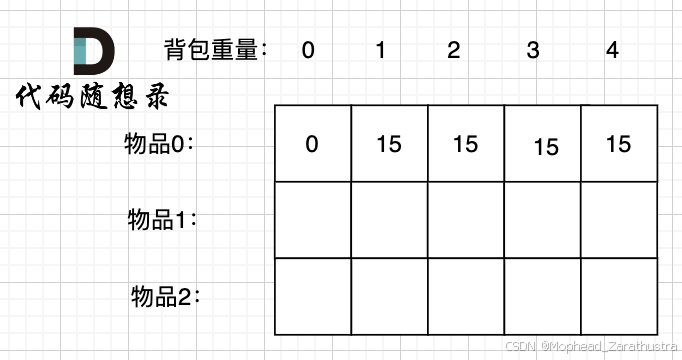
背包容量为0,放不下物品0,此时背包里的价值为0。
背包容量为1,可以放下物品0,此时背包里的价值为15.
背包容量为2,依然可以放下物品0 (注意 01背包里物品只有一个),此时背包里的价值为15。
以此类推。
再看把物品1 放入背包:
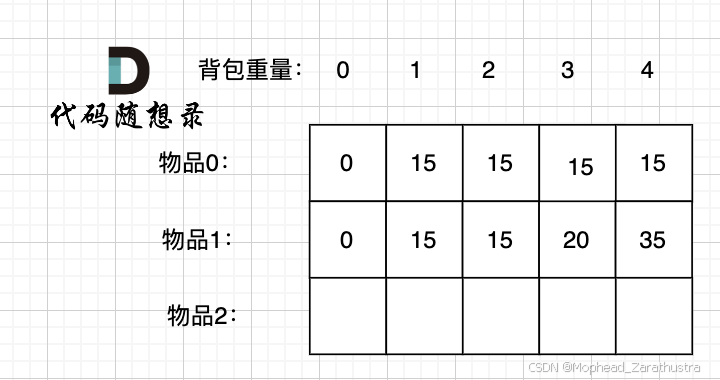
背包容量为 0,放不下物品0 或者物品1,此时背包里的价值为0。
背包容量为 1,只能放下物品0,背包里的价值为15。
背包容量为 2,只能放下物品0,背包里的价值为15。
背包容量为 3,上一行同一状态,背包只能放物品0,这次也可以选择物品1了,背包可以放物品1 或者 物品0,物品1价值更大,背包里的价值为20。
背包容量为 4,上一行同一状态,背包只能放物品0,这次也可以选择物品1了,背包可以放下物品0 和 物品1,背包价值为35。
以上举例,是比较容易看懂,我主要是通过这个例子,来帮助大家明确dp数组的含义。
上图中,我们看 dp[1][4] 表示什么意思呢。
任取 物品0,物品1 放进容量为4的背包里,最大价值是 dp[1][4]。
通过这个举例,我们来进一步明确dp数组的含义。
即dp[i][j] 表示从下标为[0-i]的物品里任意取,放进容量为j的背包,价值总和最大是多少。
要时刻记着这个dp数组的含义,下面的一些步骤都围绕这dp数组的含义进行的,如果哪里看懵了,就来回顾一下i代表什么,j又代表什么。
2. 确定递推公式
-
这里在把基本信息给出来:
重量 价值 物品0 1 15 物品1 3 20 物品2 4 30 对于递推公式,首先我们要明确有哪些方向可以推导出 dp[i][j]。
这里我们dp[1][4]的状态来举例:
求取 dp[1][4] 有两种情况:
- 放物品1
- 还是不放物品1
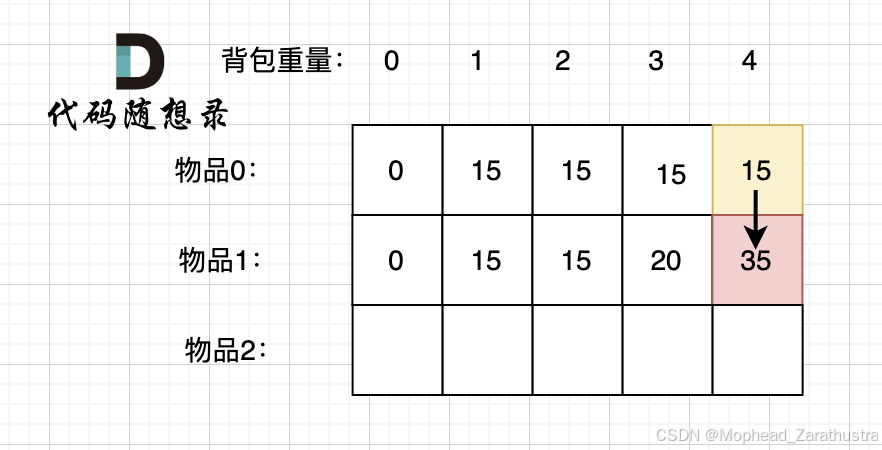
如果不放物品1, 那么背包的价值应该是 dp[0][4] 即 容量为4的背包,只放物品0的情况。
推导方向如图:
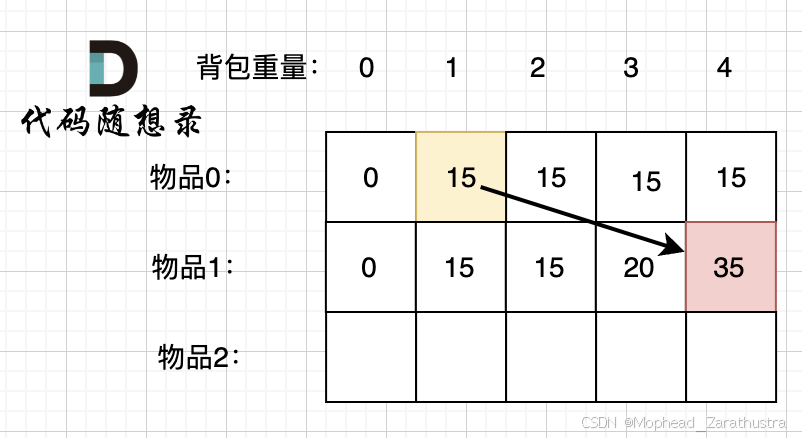
如果放物品1, 那么背包要先留出物品1的容量,目前容量是4,物品1 的容量(就是物品1的重量)为3,此时背包剩下容量为1。
容量为1,只考虑放物品0 的最大价值是 dp[0][1],这个值我们之前就计算过。
所以 放物品1 的情况 = dp[0][1] + 物品1 的价值,推导方向如图:
两种情况,分别是放物品1 和 不放物品1,我们要取最大值(毕竟求的是最大价值)
dp[1][4] = max(dp[0][4], dp[0][1] + 物品1 的价值)以上过程,抽象化如下:
- 不放物品i:背包容量为j,里面不放物品i的最大价值是dp[i - 1][j]。
- 放物品i:背包空出物品i的容量后,背包容量为j - weight[i],dp[i - 1][j - weight[i]] 为背包容量为j - weight[i]且不放物品i的最大价值,那么dp[i - 1][j - weight[i]] + value[i] (物品i的价值),就是背包放物品i得到的最大价值
递归公式:
dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i]);
3. dp数组如何初始化
-
关于初始化,一定要和dp数组的定义吻合,否则到递推公式的时候就会越来越乱。
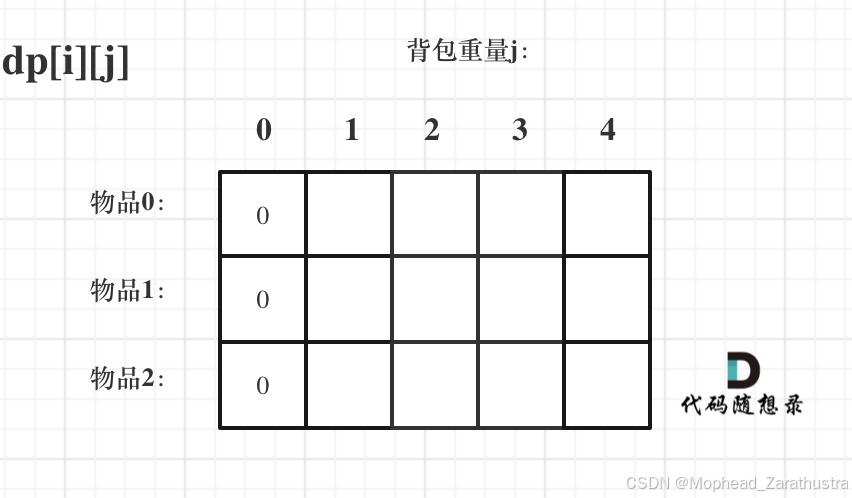
首先从dp[i][j]的定义出发,如果背包容量j为0的话,即dp[i][0],无论是选取哪些物品,背包价值总和一定为0。如图:
在看其他情况。
状态转移方程
dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i]); 可以看出i 是由 i-1 推导出来,那么i为0的时候就一定要初始化。dp[0][j],即:i为0,存放编号0的物品的时候,各个容量的背包所能存放的最大价值。
那么很明显当
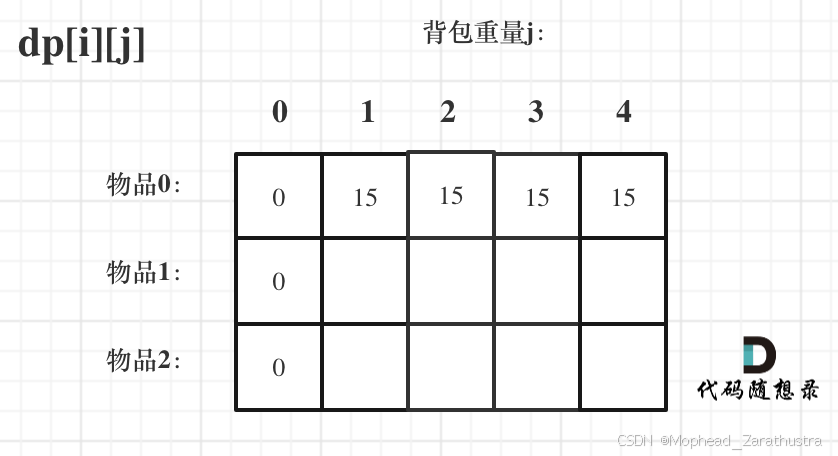
j < weight[0]的时候,dp[0][j] 应该是 0,因为背包容量比编号0的物品重量还小。当
j >= weight[0]时,dp[0][j] 应该是value[0],因为背包容量放足够放编号0物品。代码初始化如下:
for (int i = 1; i < weight.size(); i++) {  // 当然这一步,如果把dp数组预先初始化为0了,这一步就可以省略,但很多同学应该没有想清楚这一点。
    dp[i][0] = 0;
}
// 正序遍历
for (int j = weight[0]; j <= bagweight; j++) {
    dp[0][j] = value[0];
}
此时dp数组初始化情况如图所示:
dp[0][j] 和 dp[i][0] 都已经初始化了,那么其他下标应该初始化多少呢?
其实从递归公式: dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i]); 可以看出dp[i][j] 是由左上方数值推导出来了,那么 其他下标初始为什么数值都可以,因为都会被覆盖。
初始-1,初始-2,初始100,都可以!
但只不过一开始就统一把dp数组统一初始为0,更方便一些。
如图:
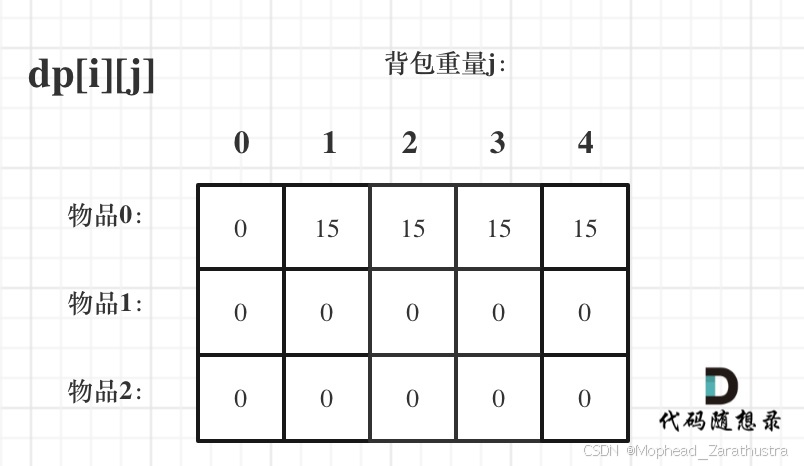
最后初始化代码如下:
// 初始化 dp vector<vector<int>> dp(weight.size(), vector<int>(bagweight + 1, 0)); for (int j = weight[0]; j <= bagweight; j++) { dp[0][j] = value[0]; }费了这么大的功夫,才把如何初始化讲清楚,相信不少同学平时初始化dp数组是凭感觉来的,但有时候感觉是不靠谱的。
4. 确定遍历顺序
-
在如下图中,可以看出,有两个遍历的维度:物品与背包重量
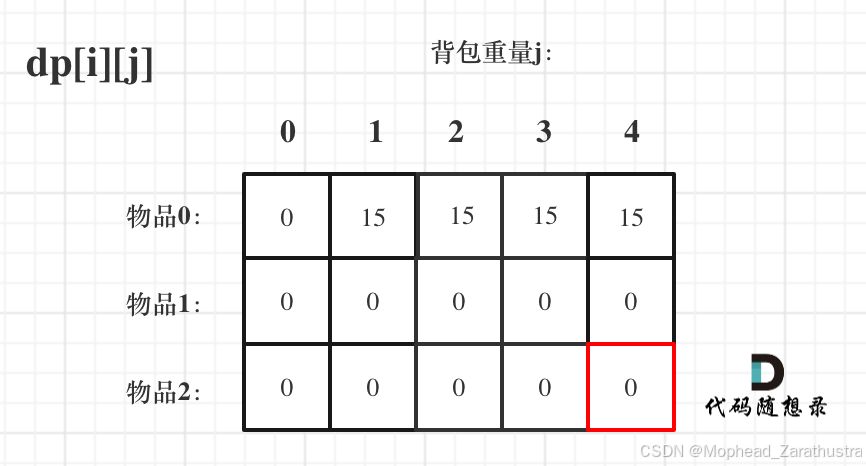
那么问题来了,先遍历 物品还是先遍历背包重量呢?
其实都可以!! 但是先遍历物品更好理解。
那么我先给出先遍历物品,然后遍历背包重量的代码。
// weight数组的大小 就是物品个数
for(int i = 1; i < weight.size(); i++) { // 遍历物品
    for(int j = 0; j <= bagweight; j++) { // 遍历背包容量
        if (j < weight[i]) dp[i][j] = dp[i - 1][j];
        else dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i]);

    }
}
先遍历背包,再遍历物品,也是可以的!(注意我这里使用的二维dp数组)
例如这样:
// weight数组的大小 就是物品个数
for(int j = 0; j <= bagweight; j++) { // 遍历背包容量
    for(int i = 1; i < weight.size(); i++) { // 遍历物品
        if (j < weight[i]) dp[i][j] = dp[i - 1][j];
        else dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i]);
    }
}
为什么也是可以的呢?
要理解递归的本质和递推的方向。
dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i]); 递归公式中可以看出dp[i][j]是靠dp[i-1][j]和dp[i - 1][j - weight[i]]推导出来的。dp[i-1][j]和dp[i - 1][j - weight[i]] 都在dp[i][j]的左上角方向(包括正上方向),那么先遍历物品,再遍历背包的过程如图所示:
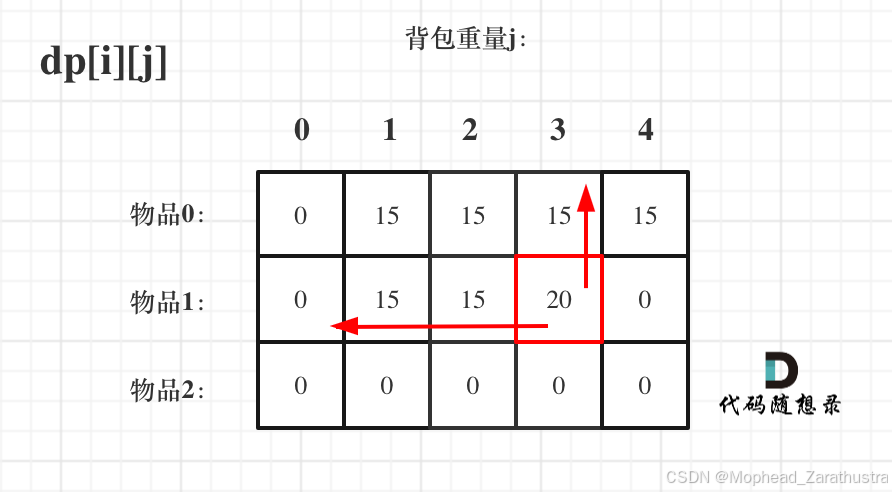
再来看看先遍历背包,再遍历物品呢,如图:
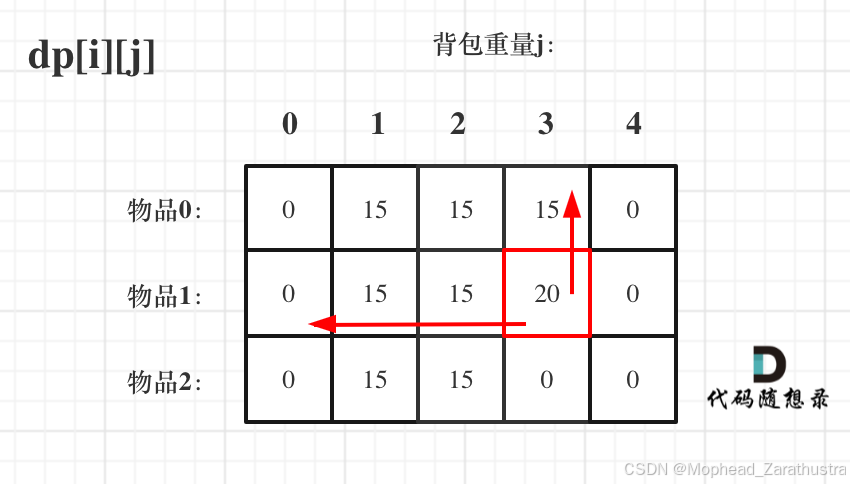
大家可以看出,虽然两个for循环遍历的次序不同,但是dp[i][j]所需要的数据就是左上角,根本不影响dp[i][j]公式的推导!
但先遍历物品再遍历背包这个顺序更好理解。
其实背包问题里,两个for循环的先后循序是非常有讲究的,理解遍历顺序其实比理解推导公式难多了。
5. 举例推导dp数组
来看一下对应的dp数组的数值,如图:
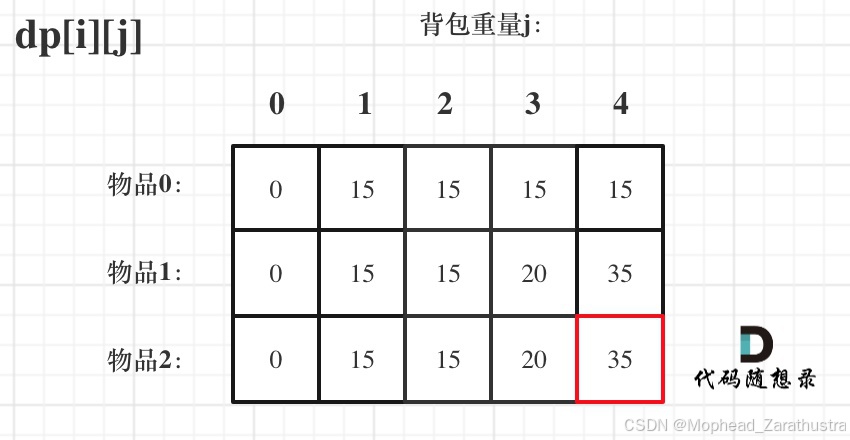
最终结果就是dp[2][4]。
建议大家此时自己在纸上推导一遍,看看dp数组里每一个数值是不是这样的。
做动态规划的题目,最好的过程就是自己在纸上举一个例子把对应的dp数组的数值推导一下,然后在动手写代码!
-
一维dp数组(滚动数组)
-
对于背包问题其实状态都是可以压缩的。
在使用二维数组的时候,递推公式:
dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i]);其实可以发现如果把
dp[i - 1] 那一层拷贝到dp[i] 上,表达式完全可以是:
dp[i][j] = max(dp[i][j], dp[i][j - weight[i]] + value[i]) ;与其把
dp[i - 1] 这一层拷贝到dp[i] 上,不如只用一个一维数组了,只用
dp[j](一维数组,也可以理解是一个滚动数组)。这就是滚动数组的由来,需要满足的条件是上一层可以重复利用,直接拷贝到当前层。
读到这里估计大家都忘了
dp[i][j]里的i和j表达的是什么了,i是物品,j是背包容量。
dp[i][j] 表示从下标为 [0-i] 的物品里任意取,放进容量为j的背包,价值总和最大是多少。一定要时刻记住这里
i和j的含义,要不然很容易看懵了。 -
动规五部曲分析如下:
-
确定dp数组的定义:
关于dp数组的定义,我在 01背包理论基础 (opens new window)有详细讲解
在一维dp数组中,
dp[j]表示:容量为j的背包,所背的物品价值可以最大为dp[j]。 -
一维dp数组的递推公式:
二维dp数组的递推公式为:
dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i]);公式是怎么来的 在这里 01背包理论基础 (opens new window)有详细讲解。
一维dp数组,其实就是由 上一层
dp[i-1] 拷贝到 这一层dp[i] 而来。所以在 上面递推公式的基础上,去掉
i这个维度就好。递推公式为:
dp[j] = max(dp[j], dp[j - weight[i]] + value[i]);GPT生成的解释: (关键点在于,能这样递推,是因为后面遍历顺序改变了,采用的是逆序遍历!)
在 01 背包问题的 一维 dp 数组优化 过程中,我们不需要考虑
dp[j - weight[i]] 是否在本轮迭代中被更新过,这是因为 遍历的顺序保证了正确性。以下是详细解释:1. 为什么可以这样做?
核心原因在于:
-
dp[j] = max(dp[j], dp[j - weight[i]] + value[i]) 这个公式的正确性依赖于 dp[j - weight[i]] 在更新 dp[j] 之前,仍然是“上一层”的值。 - 通过逆序遍历(从
j = bag_size 递减到j = weight[i]),我们确保dp[j - weight[i]] 在使用时,仍然是上一层的结果,而不会被当前物品的计算影响。
2. 为什么不需要担心
dp[j - weight[i]] 被更新的问题?如果我们采用 正序遍历(即
j 从0 增加到bag_size),在计算dp[j] 时,dp[j - weight[i]] 可能已经被本轮i 迭代的计算修改了,导致错误的状态传播。但我们使用 逆序遍历(从
j = bag_size 递减到j = weight[i]),这样dp[j - weight[i]] 在dp[j] 计算时,仍然保持着上一次 i-1 轮次的值,保证了递推公式的正确性。以下为分析:
dp[j]为 容量为j的背包所背的最大价值。
dp[j]可以通过dp[j - weight[i]]推导出来,dp[j - weight[i]]表示容量为j - weight[i]的背包所背的最大价值。
dp[j - weight[i]] + value[i] 表示 容量为[j - 物品i重量] 的背包 加上 物品i的价值。(也就是容量为j的背包,放入物品i了之后的价值即:dp[j])此时
dp[j]有两个选择,一个是取自己dp[j] 相当于 二维dp数组中的dp[i-1][j],即不放物品i,一个是取dp[j - weight[i]] + value[i],即放物品i,指定是取最大的,毕竟是求最大价值,所以递归公式为:
dp[j] = max(dp[j], dp[j - weight[i]] + value[i]);可以看出相对于二维dp数组的写法,就是把
dp[i][j]中i的维度去掉了。 -
-
一维dp数组如何初始化
关于初始化,一定要和dp数组的定义吻合,否则到递推公式的时候就会越来越乱。
dp[j]表示:容量为j的背包,所背的物品价值可以最大为dp[j],那么dp[0]就应该是0,因为背包容量为0所背的物品的最大价值就是0。那么dp数组除了下标0的位置,初始为0,其他下标应该初始化多少呢?
看一下递归公式:
dp[j] = max(dp[j], dp[j - weight[i]] + value[i]);dp数组在推导的时候一定是取价值最大的数,如果题目给的价值都是正整数那么非0下标都初始化为0就可以了。
这样才能让dp数组在递归公式的过程中取的最大的价值,而不是被初始值覆盖了。
那么我假设物品价值都是大于0的,所以dp数组初始化的时候,都初始为0就可以了。
-
一维dp数组遍历顺序:
代码如下:
for(int i = 0; i < weight.size(); i++) { // 遍历物品
    for(int j = bagWeight; j >= weight[i]; j--) { // 遍历背包容量
        dp[j] = max(dp[j], dp[j - weight[i]] + value[i]);

    }
}
这里大家发现和二维dp的写法中,遍历背包的顺序是不一样的!
二维dp遍历的时候,背包容量是从小到大,而一维dp遍历的时候,背包是从大到小。
为什么呢?
倒序遍历是为了保证物品i只被放入一次! 但如果一旦正序遍历了,那么物品0就会被重复加入多次!
举一个例子:物品0的重量
weight[0] = 1,价值value[0] = 15如果正序遍历
dp[1] = dp[1 - weight[0]] + value[0] = 15
dp[2] = dp[2 - weight[0]] + value[0] = 30此时
dp[2]就已经是30了,意味着物品0,被放入了两次,所以不能正序遍历。为什么倒序遍历,就可以保证物品只放入一次呢?
倒序就是先算
dp[2]
dp[2] = dp[2 - weight[0]] + value[0] = 15 (dp数组已经都初始化为0)
dp[1] = dp[1 - weight[0]] + value[0] = 15所以从后往前循环,每次取得状态不会和之前取得状态重合,这样每种物品就只取一次了。
那么问题又来了,为什么二维dp数组遍历的时候不用倒序呢?
因为对于二维dp,
dp[i][j]都是通过上一层即dp[i - 1][j]计算而来,本层的dp[i][j]并不会被覆盖!(如何这里读不懂,大家就要动手试一试了,空想还是不靠谱的,实践出真知!)
再来看看两个嵌套for循环的顺序,代码中是先遍历物品嵌套遍历背包容量,那可不可以先遍历背包容量嵌套遍历物品呢?
不可以!
因为一维dp的写法,背包容量一定是要倒序遍历(原因上面已经讲了),如果遍历背包容量放在上一层,那么每个
dp[j]就只会放入一个物品,即:背包里只放入了一个物品。所以一维dp数组的背包在遍历顺序上和二维其实是有很大差异的! ,这一点大家一定要注意。
一维dp 的01背包,要比二维简洁的多! 初始化 和 遍历顺序相对简单了。
所以我倾向于使用一维dp数组的写法,比较直观简洁,而且空间复杂度还降了一个数量级!
在后面背包问题的讲解中,我都直接使用一维dp数组来进行推导。
-
总结
-
以上的讲解可以开发一道面试题目(毕竟力扣上没原题)。
就是本文中的题目,要求先实现一个纯二维的01背包,如果写出来了,然后再问为什么两个for循环的嵌套顺序这么写?反过来写行不行?再讲一讲初始化的逻辑。
然后要求实现一个一维数组的01背包,最后再问,一维数组的01背包,两个for循环的顺序反过来写行不行?为什么?
注意以上问题都是在候选人把代码写出来的情况下才问的。
就是纯01背包的题目,都不用考01背包应用类的题目就可以看出候选人对算法的理解程度了。
相信大家读完这篇文章,应该对以上问题都有了答案!
此时01背包理论基础就讲完了,我用了两篇文章把01背包的dp数组定义、递推公式、初始化、遍历顺序从二维数组到一维数组统统深度剖析了一遍,没有放过任何难点。
大家可以发现其实信息量还是挺大的。
如果把动态规划:关于01背包问题,你该了解这些! (opens new window)和本篇的内容都理解了,后面我们在做01背包的题目,就会发现非常简单了。
不用再凭感觉或者记忆去写背包,而是有自己的思考,了解其本质,代码的方方面面都在自己的掌控之中。
即使代码没有通过,也会有自己的逻辑去debug,这样就思维清晰了。
-
下面摘录python中输入的处理方法(由claude生成)
在处理编程题时,有几种方法可以处理整个输入。我来详细解释如何在 Python 中接收并处理完整的输入。
方法一:逐行读取
这是最常见的方法,适用于知道具体有多少行输入的情况:
无论用户输入什么内容,input() 都会将其作为字符串返回。如果需要其他数据类型,必须进行显式转换
input() 会自动去除用户输入末尾的换行符(\n),所以不需要额外调用 .strip() 来移除换行符。
input() 是阻塞式的,这意味着程序会停止执行并等待用户输入。在需要非阻塞IO的情况下,可能需要使用其他技术(如多线程或异步IO)。
# 读取第一行
first_line = input().strip().split()
M, N = map(int, first_line)

# 读取第二行
space_line = input().strip().split()
spaces = list(map(int, space_line))

# 读取第三行
value_line = input().strip().split()
values = list(map(int, value_line))
方法二:使用 sys.stdin 读取所有输入
如果你想一次性读取所有输入然后再处理,可以使用 sys.stdin:
sys.stdin.readline() 比 input() 稍快一些,因为它不处理提示消息,且保留换行符。
import sys

# 读取所有输入行并存储在列表中
lines = sys.stdin.readlines()

# 处理第一行
first_line = lines[0].strip().split()
M, N = map(int, first_line)

# 处理第二行
space_line = lines[1].strip().split()
spaces = list(map(int, space_line))

# 处理第三行
value_line = lines[2].strip().split()
values = list(map(int, value_line))
方法三:使用 while 循环读取未知数量的输入行
当你不确定有多少行输入时:
import sys

lines = []
for line in sys.stdin:
    if line.strip() == "":  # 检测空行作为结束标志(可选)
        break
    lines.append(line.strip())

# 现在 lines 列表包含了所有输入行
# 处理第一行
first_line = lines[0].split()
M, N = map(int, first_line)

# 处理后续行
if len(lines) > 1:
    space_line = lines[1].split()
    spaces = list(map(int, space_line))

if len(lines) > 2:
    value_line = lines[2].split()
    values = list(map(int, value_line))
方法四:针对编程竞赛的快速输入
在比赛环境中,处理大量输入时可以使用更高效的方法:
import sys
input = sys.stdin.readline  # 更快的输入方法

# 读取输入
M, N = map(int, input().split())
spaces = list(map(int, input().split()))
values = list(map(int, input().split()))
更多推荐



 34
 0
- 0


 已为社区贡献2条内容

所有评论(0)