
mycat实现分库分表
1. 垂直拆分——分库
一个数据库由很多表的构成,每个表对应着不同的业务,垂直切分是指按照业务将表进行分类,分布到不同 的数据库上面,这样也就将数据或者说压力分担到不同的库上面,如下图:
 系统被切分成了,用户,订单交易,支付几个模块。
1.1. 如何划分
一个问题:在两台主机上的两个数据库中的表,能否关联查询?
答案:不可以关联查询。
分库的原则:有紧密关联关系的表应该在一个库里,相互没有关联关系的表可以分到不同的库里。
#客户表 rows:20万

CREATE TABLE customer(

  id INT AUTO_INCREMENT,

  NAME VARCHAR(200),

  PRIMARY KEY(id)

);

#订单表 rows:600万

CREATE TABLE orders(

  id INT AUTO_INCREMENT,

  order_type INT,

  customer_id INT,

  amount DECIMAL(10,2),

  PRIMARY KEY(id)

);

#订单详细表 rows:600万

CREATE TABLE orders_detail(

  id INT AUTO_INCREMENT,

  detail VARCHAR(2000),

  order_id INT,

  PRIMARY KEY(id)

);

#订单状态字典表 rows:20条

CREATE TABLE dict_order_type(

  id INT AUTO_INCREMENT,

  order_type VARCHAR(200),

  PRIMARY KEY(id)

);
以上四个表如何分库?客户表分在一个数据库,另外三张都需要关联查询,分在另外一个数据库。
1.2. 实现分库
1.2.1. 停止mycat**,****停止主从,**修改schema配置文件
<?xml version="1.0"?>
<!DOCTYPE mycat:schema SYSTEM "schema.dtd">
<mycat:schema xmlns:mycat="http://io.mycat/">

        <schema name="TESTDB" checkSQLschema="false" sqlMaxLimit="100"    dataNode="dn1"  >
<table name="customer" dataNode="dn2" ></table>
</schema>
        <!-- <dataNode name="dn1$0-743" dataHost="localhost1" database="db$0-743"
                /> -->
        <dataNode name="dn1" dataHost="host1" database="order" />
  <dataNode name="dn2" dataHost="host2" database="order" />

<dataHost name="host1" maxCon="1000" minCon="10" balance="0"
                          writeType="0" dbType="mysql" dbDriver="native" switchType="1"  slaveThreshold="100">
                <heartbeat>select user()</heartbeat>
                <!-- can have multi write hosts -->
                <writeHost host="hostM1" url="192.168.17.10:3306" user="root"
                                   password="123456">
                </writeHost>
        </dataHost>
<dataHost name="host2" maxCon="1000" minCon="10" balance="0"
                          writeType="0" dbType="mysql" dbDriver="native" switchType="1"  slaveThreshold="100">
                <heartbeat>select user()</heartbeat>
                <!-- can have multi write hosts -->
                <writeHost host="hostM2" url="192.168.17.102:3306" user="root"
                                   password="123456">
                </writeHost>
        </dataHost>

</mycat:schema>
在从机上执行 mysql> stop slave;
1.2.2. 新增两个空白库
分库操作不是在原来的老数据库上进行操作,需要准备两台机器分别安装新的数据库
#在数据节点dn1、dn2上分别创建数据库orders
CREATE DATABASE orders;
#四张表如何建立,建立在什么位置?
order 以及其他两张表建立dn1 ,customer dn2
1.2.3. 启动Mycat
./mycat console
1.2.4. 访问Mycat进行分库
#访问Mycat
mysql -umycat -p123456 -h 192.168.200.168 -P 8066
#切换到TESTDB
#创建4张表 执行上述创建表的sql 语句!
#查看表信息,可以看到成功分库
根据配置信息可以看到consumer被分配到了host2,其余的被分配到了host1
1. 水平拆分——分表
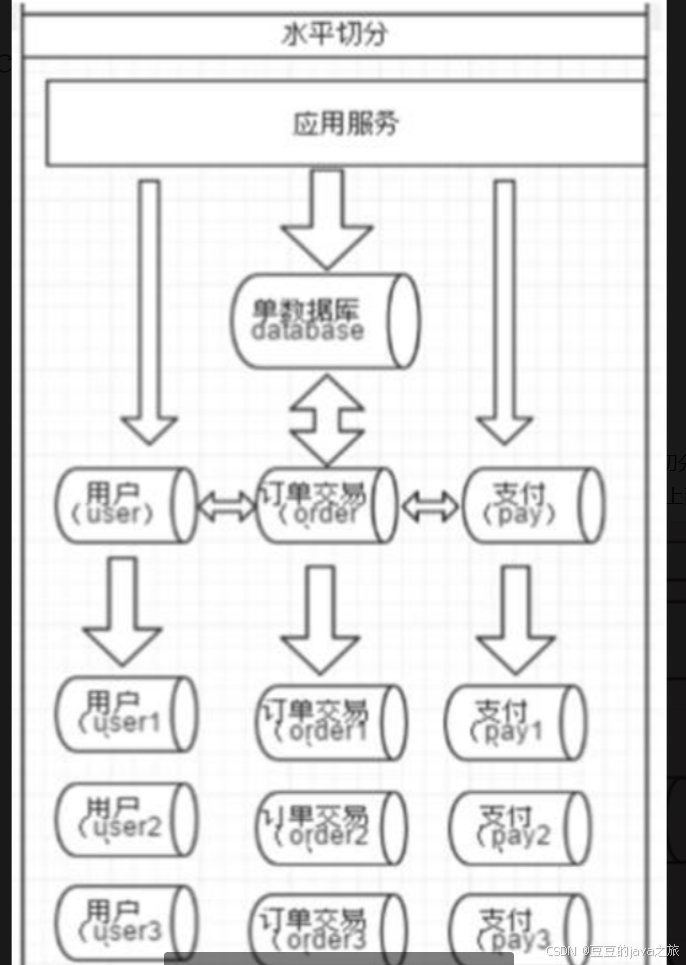
相对于垂直拆分,水平拆分不是将表做分类,而是按照某个字段的某种规则来分散到多个库之中,每个表中包含一部分数据。简单来说,我们可以将数据的水平切分理解为是按照数据行的切分,就是将表中的某些行切分 到一个数据库,而另外的某些行又切分到其他的数据库中,如图:
 1.1. 实现分表
1.1.1. 选择要拆分的表
MySQL单表存储数据条数是有瓶颈的,单表达到1000万条数据就达到了瓶颈,会影响查询效率,需要进行水平拆分(分表)进行优化。
例如:例子中的orders、orders_detail都已经达到600万行数据,需要进行分表优化。
1.1.2. 分表字段
以orders表为例,可以根据不同自字段进行分表
| 编号 | 分表字段 | 效果 |
| 1 | id,createtime (主键、或创建时间) | 查询订单注重时效,历史订单被查询的次数少,如此分片会造成一个节点访问多,一个访问少,不平均。 |
| 2 | customer_id(客户id) | 根据客户id去分,两个节点访问平均,一个客户的所有订单都在同一个节点 |
1.1.3. 停止mycat修改配置文件schema.xml
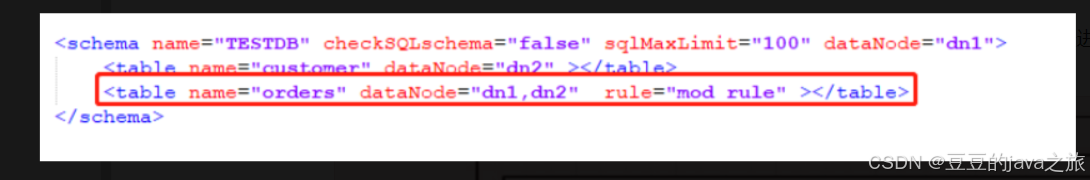
#为orders表设置数据节点为dn1、dn2,并指定分片规则为mod_rule(自定义的名字)
<table name="orders" dataNode="dn1,dn2" rule="mod_rule" ></table>
#如下图
 1.1.4. 停止mycat修改配置文件rule.xml
#在rule配置文件里新增分片规则mod_rule,并指定规则适用字段为customer_id,
#还有选择分片算法mod-long(对字段求模运算),customer_id对两个节点求模,根据结果分片
#新增配置算法mod-long参数count为2,两个节点
<tableRule name="mod_rule">

  <rule>

  <columns>customer_id</columns>

  <algorithm>mod-long</algorithm>

  </rule>

  </tableRule>
在原有的配置中将 3--->2即可!
<function name="mod-long" class="io.mycat.route.function.PartitionByMod">

  <!-- how many data nodes -->

  <property name="count">2</property>

  </function>
1.1.5. 在数据节点dn2上建orders表
CREATE TABLE orders(

  id INT AUTO_INCREMENT,

  order_type INT,

  customer_id INT,

  amount DECIMAL(10,2),

  PRIMARY KEY(id)

);
1.1.6. 重启Mycat配置生效**,**将配置文件重新导入
1.1.7. 访问Mycat灌数据****实现分片
#在mycat里向orders表插入数据,INSERT时字段不能省略
INSERT INTO orders(id,order_type,customer_id,amount) VALUES (1,101,100,100100);
INSERT INTO orders(id,order_type,customer_id,amount) VALUES(2,101,100,100300);
INSERT INTO orders(id,order_type,customer_id,amount) VALUES(3,101,101,120000);
INSERT INTO orders(id,order_type,customer_id,amount) VALUES(4,101,101,103000);
INSERT INTO orders(id,order_type,customer_id,amount) VALUES(5,102,101,100400);
INSERT INTO orders(id,order_type,customer_id,amount) VALUES(6,102,100,100020);
#在mycat、dn1、dn2中查看orders表数据,分表成功
1.2. Mycat 的分片“join”
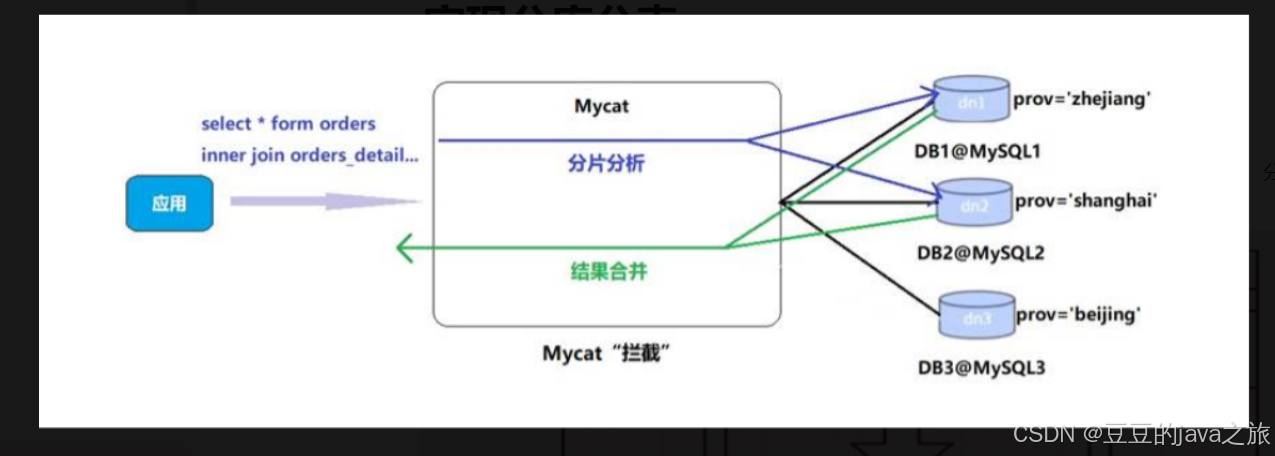
Orders订单表已经进行分表操作了,和它关联的orders_detail订单详情表如何进行join查询。
我们要对orders_detail也要进行分片操作。Join的原理如下图:
 1.2.1. E**-**R表
子表的记录与所关联的父表记录存放在同一个数据分片上
#修改schema.xml配置文件
<table name="orders" dataNode="dn1,dn2" rule="mod_rule" >

  <childTable name="orders_detail" primaryKey="id" joinKey="order_id" parentKey="id" />

</table>
#在dn2创建orders_detail表
CREATE TABLE orders_detail(

  id INT AUTO_INCREMENT,

  detail VARCHAR(2000),

  order_id INT,

  PRIMARY KEY(id)

);
#导入配置文件,重启Mycat
#访问Mycat向orders_detail表插入数据
INSERT INTO orders_detail(id,detail,order_id) VALUES(1,'detail1',1);
INSERT INTO orders_detail(id,detail,order_id) VALUES(2,'detail1',2);
INSERT INTO orders_detail(id,detail,order_id) VALUES(3,'detail1',3);
INSERT INTO orders_detail(id,detail,order_id) VALUES(4,'detail1',4);
INSERT INTO orders_detail(id,detail,order_id) VALUES(5,'detail1',5);
INSERT INTO orders_detail(id,detail,order_id) VALUES(6,'detail1',6);
#在mycat、dn1、dn2中运行两个表join语句
select o.*,od.detail from orders o inner join orders_detail od on o.id=od.order_id;
全局表
1.1.1. 全局表
在分片的情况下,当业务表因为规模而进行分片以后,业务表与这些附属的字典表之间的关联,就成了比较棘手的问题,考虑到字典表具有以下几个特性:
变动不频繁
数据量总体变化不大
数据规模不大,很少有超过数十万条记录
鉴于此,Mycat 定义了一种特殊的表,称之为“全局表”,全局表具有以下特性:
全局表的插入、更新操作会实时在所有节点上执行,保持各个分片的数据一致性
全局表的查询操作,只从一个节点获取
全局表可以跟任何一个表进行 JOIN 操作
将字典表或者符合字典表特性的一些表定义为全局表,则从另外一个方面,很好的解决了数据 JOIN 的难题。通过全局表+基于 E-R 关系的分片策略,Mycat 可以满足 80%以上的企业应用开发!
#修改schema.xml配置文件
<table name="orders" dataNode="dn1,dn2" rule="mod_rule" >

  <childTable name="orders_detail" primaryKey="id" joinKey="order_id" parentKey="id" />

</table>

<table name="dict_order_type" dataNode="dn1,dn2" type="global" ></table>
…
#在dn2创建dict_order_type表
CREATE TABLE dict_order_type(
id INT AUTO_INCREMENT,
order_type VARCHAR(200),
PRIMARY KEY(id)
);
#导入配置文件,重启Mycat
#访问Mycat向dict_order_type表插入数据
INSERT INTO dict_order_type(id,order_type) VALUES(101,'type1');
INSERT INTO dict_order_type(id,order_type) VALUES(102,'type2');
#在Mycat、dn1、dn2中查询表数据
更多推荐


 16
 0
- 0


 已为社区贡献3条内容

所有评论(0)