
吐血整理 | 肝翻linux内核常用数据结构汇总
在开源的广袤天地中,Linux 内核宛如一座神秘而深邃的奇幻森林,吸引着无数开发者探索其中的奥秘。这片森林中,每一棵树木、每一条溪流都蕴含着无尽的智慧与奥秘,而数据结构则是构建这座森林的魔法基石,如同森林中的神秘魔法道具,发挥着至关重要的作用。
数据结构作为计算机科学领域的核心概念,是组织、存储和管理数据的有效方式,直接关乎程序的性能与效率。在 Linux 内核这个庞大而复杂的生态系统中,数据结构更是扮演着灵魂角色,是内核高效运行、稳定工作的关键所在。从进程管理到内存分配,从文件系统到设备驱动,Linux 内核的每一个角落都活跃着数据结构的身影,它们协同工作,如同精密的齿轮,推动着整个内核系统的稳定运转。
倘若把 Linux 内核比作一台强大的超级计算机,那么数据结构就是这台计算机中不可或缺的电路和芯片,它们巧妙地组织和管理着各种数据,使得内核能够高效地处理各种任务,为用户提供稳定、可靠的服务。 因此,深入了解 Linux 内核中的数据结构,不仅能让我们领略到 Linux 内核的精妙设计,还能为我们的开发工作提供强大的技术支持,让我们在这片奇幻森林中自由穿梭,探索更多未知的奥秘。接下来,就让我们一起踏上这场充满惊喜与挑战的 Linux 内核数据结构探索之旅,揭开它们神秘的面纱吧!
一、Linux内核数据结构概述
1.1内核数据结构为何物?
在计算机科学的璀璨星空中,数据结构是一颗耀眼的明星,它是计算机存储、组织数据的巧妙方式,如同建筑中的蓝图,规划着数据的布局与管理。简单来说,数据结构就是相互之间存在一种或多种特定关系的数据元素的集合,它涵盖了数据的逻辑结构、物理结构以及相关的操作运算。数据结构主要分为线性结构和非线性结构。线性结构中的数据元素呈现出一对一的线性关系,如同一条整齐排列的队伍,数组、链表、栈和队列等都属于这一范畴;非线性结构则更为复杂,元素之间存在一对多或多对多的关系,像是一张错综复杂的关系网,树和图就是典型的非线性结构 。
当我们将目光聚焦到 Linux 内核这个庞大而精密的系统时,数据结构更是无处不在,发挥着不可替代的关键作用。它们就像是内核的神经脉络,用于组织和管理各种资源和信息,使得内核能够有条不紊地运行。在 Linux 内核中,数据结构的身影随处可见,从进程管理到内存分配,从文件系统到设备驱动,每一个功能模块都依赖于特定的数据结构来实现其功能。
例如,在进程管理中,task_struct结构体就像是进程的 “身份证”,记录了进程的状态、优先级、上下文等重要信息,内核通过它来对进程进行调度和管理;在内存管理中,mm_struct结构体描述了进程的内存空间,包括所有的内存段和内存映射,确保内存的合理分配和使用。这些数据结构相互协作,如同精密的齿轮,共同推动着 Linux 内核这个庞大的机器高效运转。
1.2它们为何如此重要?
Linux 内核数据结构的重要性不言而喻,它就像是内核的基石,支撑着整个系统的稳定运行。从内核管理进程、内存、设备等方面来看,数据结构的作用至关重要,每一个环节都离不开它的支持。
在进程管理方面,数据结构是内核调度和管理进程的关键。以task_struct结构体为例,它记录了进程的各种信息,如进程的状态(运行、就绪、阻塞等)、优先级、程序计数器、堆栈指针等。内核通过这些信息来决定哪个进程可以获得 CPU 资源,以及如何在不同进程之间进行切换。
当一个进程需要暂停执行时,内核会将其上下文信息(包括寄存器的值等)保存在task_struct中,以便在后续恢复执行时能够准确地回到暂停的位置。而进程调度算法则依赖于特定的数据结构来管理进程的状态和优先级,例如使用优先级队列来存储就绪态的进程,根据优先级的高低来决定哪个进程优先执行。这样,通过合理的数据结构设计,内核能够高效地管理大量的进程,确保系统的响应速度和资源利用率。
内存管理也是数据结构发挥重要作用的领域。在 Linux 系统中,内存资源的分配和管理是一个复杂而关键的任务。mm_struct结构体描述了进程的内存空间,包括代码段、数据段、堆栈段等各个内存段的信息,以及内存映射的情况。同时,内核还使用了其他数据结构,如页表(Page Table)来管理虚拟内存到物理内存的映射。页表是一种数据结构,它记录了虚拟页号到物理页号的映射关系,通过这种映射,内核能够实现虚拟内存的管理,使得每个进程都拥有独立的地址空间,同时提高内存的利用率。当一个进程需要分配内存时,内核会根据mm_struct中的信息以及页表的映射关系,为其分配合适的物理内存,并更新相关的数据结构。在内存回收时,内核也会根据这些数据结构来判断哪些内存可以被释放,从而确保内存的有效利用。
设备驱动方面,数据结构同样不可或缺。在 Linux 内核中,为了管理各种设备,使用了一系列的数据结构。例如,device结构体描述了设备的基本信息,包括设备的名称、类型、设备号等;device_driver结构体则表示设备驱动程序,它包含了驱动程序的入口函数、设备操作方法等信息。通过这些数据结构,内核能够实现设备与驱动程序之间的关联和通信。当一个设备插入到系统中时,内核会根据设备的信息查找对应的设备驱动程序,并通过device和device_driver结构体来建立它们之间的联系,从而实现设备的驱动和管理。此外,在设备驱动中还会使用到其他数据结构,如队列、链表等,来管理设备的 I/O 请求和数据传输,确保设备的高效运行。
二、链表:灵活的“数据链”
在 Linux 内核数据结构的大家庭中,链表就像是一位灵活多变的 “舞者”,以其独特的动态性和高效的插入删除操作,在众多数据结构中脱颖而出,备受青睐。
2.1链表的基本概念
链表,简单来说,是一种物理存储单元上非连续、非顺序的存储结构 ,数据元素的逻辑顺序是通过链表中的指针链接次序实现的。它由一系列的节点组成,每个节点包含两个部分:一个是存储数据元素的数据域,另一个是存储下一个节点地址的指针域。与数组这位 “严谨的士兵” 相比,链表显得更加灵活。数组在内存中是连续存储的,如同整齐排列的士兵方阵,一旦定义,其大小就固定下来,想要增加或删除元素,往往需要 “大动干戈”,移动大量的元素。而链表则不同,它的节点在内存中可以是分散存储的,就像一群自由组合的舞者,节点之间通过指针相互连接,形成一条灵活的 “数据链”。在插入和删除元素时,链表只需调整指针的指向,就能轻松完成操作,效率极高 。
为了更好地理解链表的结构,我们可以想象这样一个场景:有一家快递代收点,每天都有大量的快递包裹需要存放。如果使用数组来存放这些包裹,就需要一个连续的大空间,而且包裹的数量一旦超过数组的容量,就需要重新分配更大的空间,这无疑是一项繁琐的工作。而链表就像是一个个独立的快递柜,每个快递柜都有自己的编号(数据域)和指向相邻快递柜的指针。
当有新的包裹到来时,只需找到一个空闲的快递柜,将包裹放入,并调整指针指向,就能轻松完成存储;当有包裹被取走时,也只需调整指针,让相邻的快递柜相连即可,无需对其他快递柜进行大规模的调整。这样,链表就能够灵活地应对包裹数量的变化,高效地管理快递代收点的存储需求。
2.2Linux 内核中的链表实现
在 Linux 内核中,链表的实现采用了一种巧妙的设计,主要通过list_head结构体来实现双向循环链表。list_head结构体定义如下:
struct list_head {
    struct list_head *next, *prev;
};
这个结构体非常简洁,只包含两个指针next和prev,分别指向链表中的下一个和上一个元素 ,通过这两个指针,就能够构建出一个双向循环链表。
在实际使用中,通常会将list_head结构体嵌入到其他数据结构中,以实现对这些数据的链表管理。例如,假设我们有一个表示学生信息的数据结构student:
struct student {
    int id;
    char name[20];
    struct list_head list;
};
在这个结构体中,list字段就是一个list_head类型的结构体,通过它,我们可以将多个student结构体链接成一个链表。
接下来,我们看看链表的基本操作是如何实现的。首先是链表的初始化,内核提供了LIST_HEAD宏来创建并初始化一个新的链表头:
#define LIST_HEAD(name) \
    struct list_head name = { &(name), &(name) }
这个宏声明了一个类型为list_head的新变量,并将其next和prev指针初始化为指向自身,形成一个空的循环链表 。例如,我们可以这样初始化一个学生链表的头:
LIST_HEAD(student_list);
添加节点是链表操作中常用的功能,内核提供了list_add和list_add_tail函数来实现这一操作。list_add函数将一个新节点添加到指定节点之后,list_add_tail函数则将新节点添加到指定节点之前 。以list_add函数为例,其实现代码如下:
static inline void list_add(struct list_head *new, struct list_head *head) {
    __list_add(new, head, head->next);
}

static inline void __list_add(struct list_head *new, struct list_head *prev, struct list_head *next) {
    next->prev = new;
    new->next = next;
    new->prev = prev;
    prev->next = new;
}
假设我们有一个新的学生节点new_student,要将其添加到student_list链表中,可以这样操作:
struct student *new_student = kmalloc(sizeof(struct student), GFP_KERNEL);
new_student->id = 1;
strcpy(new_student->name, "Alice");
list_add(&new_student->list, &student_list);
删除节点的操作则通过list_del函数来实现,它会将指定节点从链表中删除,并将其next和prev指针设置为特殊值LIST_POISON1和LIST_POISON2,以防止对已删除节点的非法访问 。list_del函数的实现代码如下:
static inline void list_del(struct list_head *entry) {
    __list_del(entry->prev, entry->next);
    entry->next = LIST_POISON1;
    entry->prev = LIST_POISON2;
}

static inline void __list_del(struct list_head * prev, struct list_head * next) {
    next->prev = prev;
    prev->next = next;
}
如果要删除student_list链表中的某个学生节点del_student,可以这样做:
list_del(&del_student->list);
kfree(del_student);
通过这些基本操作,我们可以灵活地管理链表中的节点,实现对数据的高效组织和操作。
2.3链表在 Linux 内核中的应用场景
链表在 Linux 内核中有着广泛的应用场景,它就像是一条无形的纽带,将内核中的各个部分紧密地联系在一起,为内核的高效运行提供了有力的支持。
在进程管理方面,链表扮演着至关重要的角色。Linux 内核使用链表来管理进程队列,每个进程都有一个对应的task_struct结构体,其中包含一个list_head类型的字段,用于将进程链接到链表中 。通过这种方式,内核可以方便地对进程进行调度、管理和监控。例如,在进程调度算法中,就绪队列就是一个链表,其中的节点表示处于就绪状态的进程。
当 CPU 空闲时,调度器会从就绪队列中选择一个进程执行,而链表的高效插入和删除操作,使得进程的调度过程能够快速、准确地进行。 假设系统中有多个进程,当一个新的进程创建并进入就绪状态时,它会被添加到就绪队列链表的末尾;当一个进程执行完毕或被阻塞时,它会从链表中删除。这样,内核就能够通过链表轻松地管理进程的状态和执行顺序,确保系统的高效运行。
设备驱动也是链表的重要应用领域。在 Linux 系统中,设备驱动程序需要管理各种设备,而链表则为设备管理提供了一种高效的方式。例如,在设备驱动中,每个设备都有一个对应的设备结构体,其中包含一个list_head类型的字段,用于将设备链接到设备列表链表中 。
通过这个链表,内核可以方便地查找、操作和管理设备。当系统检测到一个新的设备插入时,设备驱动程序会创建一个对应的设备结构体,并将其添加到设备列表链表中;当设备被移除时,设备结构体则会从链表中删除。这样,链表就能够帮助内核有效地管理设备资源,实现设备与驱动程序之间的高效通信和协作。 此外,在文件系统、内存管理等其他内核模块中,链表也都发挥着不可或缺的作用,为 Linux 内核的稳定运行和高效性能提供了坚实的保障。
三、队列:有序的“等待队伍”
在 Linux 内核数据结构的舞台上,队列就像是一条井然有序的 “等待队伍”,以其独特的先进先出(FIFO)特性,在众多数据结构中独树一帜,发挥着不可或缺的重要作用。
3.1队列的基本概念
队列,是一种遵循先进先出原则的数据结构,就像我们日常生活中排队买票、排队上车的场景一样,先到的人排在前面,先接受服务,后到的人则依次排在后面等待 。在队列中,数据元素从队尾进入队列,从队首离开队列,这种有序的操作方式确保了数据处理的顺序性和公平性。 例如,在一个银行营业厅里,客户们按照到达的先后顺序排队等待办理业务。最先到达的客户会排在队列的最前面,当有空闲的服务窗口时,队首的客户会先被服务,办理完业务后离开队列;而新到达的客户则会排在队列的末尾,等待轮到自己。
这个过程完美地诠释了队列先进先出的特性,每一个客户都按照顺序依次接受服务,不会出现插队或混乱的情况。 队列的基本操作主要包括入队和出队。入队操作(Enqueue)是将一个元素添加到队列的末尾,就像新的客户加入到排队的队伍中;出队操作(Dequeue)则是从队列的前端移除一个元素,并返回该元素,如同队首的客户办理完业务后离开队伍 。此外,队列还常常支持获取队首元素、判断队列是否为空等操作,这些操作共同构成了队列的基本功能,使其能够灵活地应对各种数据处理需求。
3.2Linux 内核中的队列实现
在 Linux 内核中,队列的实现方式多种多样,其中基于链表的实现是一种常见且灵活的方式。通过链表,内核能够轻松地实现队列的各种操作,满足不同场景下的需求 。
基于链表实现队列时,通常会定义一个队列节点结构体和一个队列结构体。队列节点结构体用于存储数据元素以及指向下一个节点的指针,而队列结构体则包含指向队首和队尾节点的指针,以及队列的长度等信息 。以一个简单的整数队列为例,其结构体定义如下:
// 队列节点结构体
struct queue_node {
    int data;
    struct queue_node *next;
};

// 队列结构体
struct queue {
    struct queue_node *head;
    struct queue_node *tail;
    int size;
};
在这个实现中,queue_node结构体中的data字段用于存储整数数据,next指针则指向下一个队列节点,通过这些指针,节点们依次连接,形成了一个链表 。queue结构体中的head指针指向队首节点,tail指针指向队尾节点,size字段记录队列中元素的数量,通过这些信息,内核能够清晰地管理队列的状态和操作 。
接下来,让我们看看队列的入队和出队操作是如何实现的。入队操作是将一个新元素添加到队列的末尾,具体实现代码如下:
// 入队操作
void enqueue(struct queue *q, int data) {
    struct queue_node *new_node = (struct queue_node *)kmalloc(sizeof(struct queue_node), GFP_KERNEL);
    if (new_node == NULL) {
        return;
    }
    new_node->data = data;
    new_node->next = NULL;
    if (q->tail == NULL) {
        q->head = q->tail = new_node;
    } else {
        q->tail->next = new_node;
        q->tail = new_node;
    }
    q->size++;
}
在这段代码中,首先通过kmalloc函数分配一个新的队列节点内存空间,如果分配失败则直接返回 。然后,将新节点的数据字段设置为传入的数据,将其next指针设置为NULL,表示这是队列的最后一个节点 。接下来,判断队列是否为空,如果为空,则将head和tail都指向新节点;如果不为空,则将tail的next指针指向新节点,并更新tail指针,使其指向新的队尾节点 。最后,将队列的大小加 1,表示队列中增加了一个元素 。
出队操作是从队列的前端移除一个元素,并返回该元素的值,具体实现代码如下:
// 出队操作
int dequeue(struct queue *q) {
    if (q->head == NULL) {
        return -1; // 队列为空,返回一个特殊值表示错误
    }
    struct queue_node *tmp = q->head;
    int data = tmp->data;
    q->head = q->head->next;
    if (q->head == NULL) {
        q->tail = NULL;
    }
    kfree(tmp);
    q->size--;
    return data;
}
在这段代码中,首先判断队列是否为空,如果为空,则返回一个特殊值(这里为 - 1)表示队列为空,无法进行出队操作 。然后,保存队首节点的指针和数据,将head指针指向下一个节点 。如果此时head指针为空,说明队列中只剩下一个节点,出队后队列变为空,因此将tail指针也设置为NULL 。接着,通过kfree函数释放队首节点的内存空间,以避免内存泄漏 。最后,将队列的大小减 1,表示队列中减少了一个元素,并返回出队的数据 。
3.3队列在 Linux 内核中的应用场景
队列在 Linux 内核中有着广泛而重要的应用场景,它就像是一条无形的纽带,将内核中的各个部分紧密地联系在一起,为内核的高效运行提供了坚实的保障 。
在任务调度方面,队列发挥着关键作用。Linux 内核使用队列来管理进程的调度,其中就绪队列(Ready Queue)和睡眠队列(Sleep Queue)是两个重要的队列实例 。就绪队列用于存储所有准备好运行的进程,当 CPU 空闲时,调度器会从就绪队列中选择一个进程进行调度,让其获得 CPU 资源并执行 。睡眠队列则用于存储那些因为等待某些条件(如 I/O 操作完成、资源可用等)而暂时无法运行的进程,当条件满足时,这些进程会被从睡眠队列中唤醒,并重新加入到就绪队列中,等待调度 。
例如,在一个多任务操作系统中,有多个进程同时运行。当一个进程需要等待磁盘 I/O 操作完成时,它会被放入睡眠队列中,此时 CPU 可以调度其他处于就绪队列中的进程执行 。当磁盘 I/O 操作完成后,等待该操作的进程会被唤醒,并重新加入到就绪队列中,等待 CPU 的调度 。通过这种方式,队列能够有效地管理进程的状态和执行顺序,提高系统的整体性能和资源利用率 。
在网络数据接收中,队列同样扮演着不可或缺的角色。当网络设备接收到数据包时,这些数据包会被存储在数据缓冲队列中,等待上层协议栈进行处理 。数据缓冲队列的存在可以有效地解决网络数据传输速度与上层协议栈处理速度不匹配的问题,避免数据包的丢失 。例如,在一个网络服务器中,网络接口卡不断地接收来自网络的数据包 。这些数据包会被首先存储在数据缓冲队列中,然后由网络协议栈从队列中依次取出数据包进行处理 。
由于网络数据的传输速度可能会非常快,而协议栈的处理速度相对较慢,如果没有数据缓冲队列,很容易导致数据包的丢失 。通过使用队列,网络设备可以将接收到的数据包先存储起来,等待协议栈有足够的时间进行处理,从而确保网络数据的可靠传输 。 此外,队列在 Linux 内核的设备驱动、文件系统等其他模块中也有着广泛的应用,为内核的稳定运行和高效性能提供了有力的支持 。
四、哈希表:快速查找的“神器”
在 Linux 内核数据结构的神奇宝库中,哈希表宛如一件神秘而强大的 “神器”,以其无与伦比的快速查找能力,成为内核高效运行的得力助手,在众多复杂的数据处理场景中发挥着关键作用。
4.1哈希表的基本概念
哈希表,又称散列表,是一种根据关键码值(Key-Value)而直接进行访问的数据结构 ,它就像是一个神奇的魔法盒子,通过一个被称为哈希函数的神奇咒语,将输入的键(Key)映射到一个特定的位置,从而快速地找到与之对应的值(Value) 。简单来说,哈希函数就像是一把精准的钥匙,能够根据键迅速地打开对应的 “宝箱”,取出其中存储的值,这种直接访问的方式大大提高了数据查找的效率,使得哈希表在平均情况下能够以常数时间复杂度 O (1) 完成查找操作,远远优于其他需要遍历查找的数据结构 。
然而,哈希表的魔法并非完美无缺,当多个键通过哈希函数计算得到相同的哈希值时,就会发生哈希冲突 。这就好比有几把不同的钥匙,却都指向了同一个宝箱,导致数据存储和查找出现混乱。为了解决这个棘手的问题,人们想出了许多巧妙的方法,其中链地址法和开放地址法是两种最为常用的解决方案 。链地址法就像是在宝箱里安装了一个链表,当发生哈希冲突时,将冲突的元素依次链接在链表中,这样每个哈希值对应的位置就可以存储多个元素,避免了数据的丢失和覆盖 。开放地址法则是当冲突发生时,通过某种探测技术在哈希表中寻找下一个空闲的位置,将冲突的元素存储在那里,确保每个元素都能找到合适的 “归宿” 。
以图书馆的书籍管理为例,假设我们使用哈希表来管理图书馆的藏书,每本书的书名就是键,通过哈希函数计算出的哈希值就是书架上的位置。如果两本书的书名通过哈希函数计算得到了相同的哈希值,就发生了哈希冲突 。使用链地址法,我们可以在这个书架位置上挂一个链表,将这两本书的信息都记录在链表中;使用开放地址法,我们可以在书架上寻找下一个空闲的位置,将第二本书放在那里,并记录下它与第一本书的关联关系 。这样,无论是查找哪本书,我们都能通过哈希函数快速定位到大致的位置,然后再根据具体的解决冲突方法找到对应的书籍信息 。
4.2Linux 内核中的哈希表实现
在 Linux 内核中,哈希表的实现采用了一种高效且灵活的方式,主要通过hash_table结构体以及一系列相关的操作函数来实现 。hash_table结构体定义如下:
struct hash_table {
    struct hlist_head *buckets;
    unsigned int size;
    unsigned int shift;
};
在这个结构体中,buckets是一个指针数组,每个元素都是一个指向hlist_head结构体的指针,hlist_head结构体用于构建链表,以解决哈希冲突 。size表示哈希表的大小,即buckets数组的长度,shift则用于计算哈希值,它与size之间存在一定的关联,通过shift可以快速地将键映射到buckets数组中的相应位置 。
为了更直观地理解,我们可以将hash_table想象成一个大型的仓库,buckets数组就像是仓库中的一排排货架,每个货架上都可以存放多个物品(通过链表链接) 。size表示货架的数量,shift则像是一个神奇的导航仪,能够根据物品的特征(键)快速地找到对应的货架 。
在实际使用中,内核提供了一系列的操作函数来管理哈希表,例如hash_table_insert函数用于向哈希表中插入一个新的键值对,hash_table_lookup函数用于查找指定键对应的值,hash_table_delete函数用于删除指定键值对 。
以hash_table_insert函数为例,其实现过程大致如下:首先,根据键计算出哈希值,通过shift确定在buckets数组中的位置;然后,检查该位置的链表是否为空,如果为空,则直接创建一个新的节点并插入链表;如果链表不为空,则遍历链表,检查是否已经存在相同键的节点,如果存在则更新其值,否则将新节点插入链表头部 。这样,通过这些操作函数,内核能够高效地管理哈希表中的数据,实现快速的查找和插入删除操作 。
4.3哈希表在 Linux 内核中的应用场景
哈希表在 Linux 内核中有着广泛而重要的应用场景,它就像是一条无形的纽带,将内核中的各个部分紧密地联系在一起,为内核的高效运行提供了坚实的保障 。
在文件系统中,哈希表被广泛用于快速查找文件的 inode 节点 。inode 节点是文件系统中非常重要的数据结构,它存储了文件的元数据信息,如文件大小、创建时间、访问权限等 。当我们在文件系统中访问一个文件时,首先需要通过文件名查找对应的 inode 节点,然后才能获取文件的详细信息 。在 Linux 内核中,通过哈希表将文件名映射到 inode 节点,大大提高了查找效率 。
例如,在 ext4 文件系统中,使用了哈希表来管理目录项(dentry),每个目录项都包含文件名和对应的 inode 号,通过哈希表可以快速地根据文件名找到对应的 inode 号,进而获取 inode 节点信息 。这样,在处理大量文件的情况下,哈希表能够显著提高文件系统的访问速度,使得用户能够快速地打开、读取和修改文件 。
在网络协议栈中,哈希表同样发挥着不可或缺的作用 。在网络通信中,需要快速地查找路由表项,以确定数据包的转发路径 。Linux 内核使用哈希表来存储路由表项,根据目的 IP 地址计算哈希值,通过哈希表快速定位到相应的路由表项 。这样,当网络设备接收到一个数据包时,能够迅速地找到合适的路由,将数据包转发到正确的目的地,提高了网络通信的效率和速度 。
例如,在一个大型的企业网络中,有大量的主机和子网,网络设备需要根据数据包的目的 IP 地址快速地选择最佳的转发路径 。通过使用哈希表来存储路由表项,网络设备可以在短时间内找到对应的路由信息,实现数据包的快速转发,确保网络通信的顺畅进行 。 此外,哈希表在 Linux 内核的内存管理、设备驱动等其他模块中也有着广泛的应用,为内核的稳定运行和高效性能提供了有力的支持 。
五、红黑树:高效平衡的“搜索树”
在 Linux 内核数据结构的神秘世界中,红黑树宛如一位智慧而优雅的 “平衡大师”,以其独特的自平衡特性和高效的搜索能力,在众多数据结构中独领风骚,成为解决复杂数据管理问题的得力助手。
5.1红黑树的基本概念
红黑树,是一种自平衡二叉搜索树,它在计算机科学领域中占据着重要的地位,就像一座坚固的桥梁,连接着数据的存储与高效访问 。作为二叉搜索树家族的一员,红黑树继承了二叉搜索树的基本特性:左子树上所有节点的值均小于根节点的值,右子树上所有节点的值均大于根节点的值 。这一特性使得红黑树在数据查找时能够快速地缩小查找范围,就像在图书馆中根据分类索引查找书籍一样,大大提高了查找效率 。
然而,红黑树的独特之处在于它的自平衡机制。通过为每个节点添加一个颜色属性(红色或黑色),并遵循一系列严格的规则,红黑树能够在插入和删除节点时自动调整自身的结构,保持大致的平衡状态 。这些规则包括:根节点是黑色的;所有叶子节点(通常用 NULL 表示)都是黑色的;如果一个节点是红色的,那么它的两个子节点都是黑色的;从任意一个节点到其叶子节点的所有路径上,黑色节点的数量是相同的 。这些规则相互配合,就像一张紧密的安全网,确保了红黑树的平衡性和高效性 。
以一个简单的例子来说明红黑树的平衡原理。假设有一个红黑树,初始时只有一个根节点,颜色为黑色 。当我们插入一个新节点时,首先按照二叉搜索树的规则将其插入到合适的位置 。如果插入的节点导致了红黑树的性质被破坏,比如出现了两个连续的红色节点,红黑树就会通过旋转和颜色调整等操作来恢复平衡 。例如,当插入一个红色节点,其父节点也是红色时,红黑树会进行旋转操作,将红色节点旋转到合适的位置,并调整相关节点的颜色,使得红黑树重新满足所有的性质 。这样,红黑树就能始终保持平衡,为数据的查找、插入和删除操作提供高效的支持 。
5.2Linux 内核中的红黑树实现
在 Linux 内核中,红黑树的实现采用了一种高效且严谨的方式,主要通过rb_node和rb_root结构体以及一系列相关的操作函数来构建和管理红黑树 。rb_node结构体定义了红黑树的节点,其代码如下:
struct rb_node {
    unsigned long  __rb_parent_color;
    struct rb_node *rb_right;
    struct rb_node *rb_left;
} __attribute__((aligned(sizeof(long))));
在这个结构体中,__rb_parent_color字段既存储了父节点的指针,又通过最低位来表示节点的颜色,巧妙地节省了内存空间 。rb_right和rb_left指针分别指向节点的右子节点和左子节点,通过这些指针,节点之间相互连接,形成了红黑树的树形结构 。__attribute__((aligned(sizeof(long))))则确保了结构体按照long类型的大小进行对齐,提高了内存访问的效率 。
rb_root结构体则定义了红黑树的根节点,其代码如下:
struct rb_root {
    struct rb_node *rb_node;
};
rb_root结构体非常简洁,只有一个rb_node指针,指向红黑树的根节点 。通过这个指针,内核可以方便地访问和操作整个红黑树 。
接下来,我们看看 Linux 内核中红黑树的基本操作是如何实现的。插入操作是将一个新节点添加到红黑树中,其实现过程如下:首先,根据二叉搜索树的规则,从根节点开始,比较新节点的值与当前节点的值,确定新节点的插入位置 。如果新节点的值小于当前节点的值,则继续在当前节点的左子树中查找;如果新节点的值大于当前节点的值,则在右子树中查找 。当找到合适的叶子节点位置时,将新节点插入,并将其颜色设置为红色 。然后,检查插入操作是否破坏了红黑树的性质,如果破坏了,就需要进行旋转和颜色调整等操作来恢复平衡 。例如,当插入节点的父节点是红色时,就会出现两个连续的红色节点,违反了红黑树的性质 。此时,内核会通过旋转操作(左旋或右旋)以及颜色调整,将红色节点分散开,使得红黑树重新满足性质 。
删除操作则是将指定节点从红黑树中移除,其实现过程相对复杂一些 。首先,找到要删除的节点,如果该节点有两个子节点,通常会找到其右子树中的最小节点,将其值替换到要删除的节点中,然后删除这个最小节点 。如果要删除的节点只有一个子节点或者没有子节点,直接删除该节点,并调整红黑树的结构 。在删除操作完成后,同样需要检查红黑树的性质是否被破坏,如果被破坏,就进行相应的调整 。例如,当删除的节点是黑色时,可能会导致某些路径上的黑色节点数量减少,此时内核会通过旋转和颜色调整等操作,重新平衡红黑树 。
查找操作是在红黑树中查找指定值的节点,其实现过程比较简单 。从根节点开始,比较目标值与当前节点的值,如果目标值等于当前节点的值,则找到节点;如果目标值小于当前节点的值,则在左子树中继续查找;如果目标值大于当前节点的值,则在右子树中查找 。重复这个过程,直到找到目标节点或者到达叶子节点(表示未找到) 。由于红黑树的平衡性,查找操作的时间复杂度为O(log n),其中n是红黑树中节点的数量,这使得红黑树在大规模数据查找时具有很高的效率 。
5.3红黑树在 Linux 内核中的应用场景
红黑树在 Linux 内核中有着广泛而重要的应用场景,它就像是一把万能钥匙,能够解决内核中各种复杂的数据管理问题,为内核的高效运行提供了坚实的保障 。
在内存管理方面,红黑树发挥着关键作用。Linux 内核使用红黑树来管理虚拟内存区域(VM Area) 。每个进程都有自己的虚拟地址空间,其中包含多个虚拟内存区域,如代码段、数据段、堆、栈等 。内核通过vm_area_struct结构体来描述这些虚拟内存区域,并且使用红黑树来组织和管理这些结构体 。在红黑树中,节点按照虚拟内存区域的起始地址进行排序,这样可以快速地查找和管理内存区域 。当一个进程需要分配内存时,内核会在红黑树中查找合适的空闲内存区域,并进行分配 。如果没有合适的空闲区域,内核会根据需要进行内存的扩展或调整 。当进程释放内存时,内核会将释放的内存区域重新插入到红黑树中,以便后续的分配使用 。通过红黑树的高效管理,内核能够有效地利用内存资源,提高内存分配和释放的效率,确保系统的稳定运行 。
进程调度也是红黑树的重要应用领域。Linux 内核的完全公平调度器(CFS)使用红黑树来管理进程的调度队列 。在 CFS 中,每个进程都有一个虚拟运行时间(vruntime),表示该进程在 CPU 上的运行时间 。红黑树中的节点按照进程的虚拟运行时间进行排序,虚拟运行时间最小的进程位于红黑树的最左侧,也就是具有最高的调度优先级 。当 CPU 空闲时,CFS 会从红黑树中选择最左侧的节点(即虚拟运行时间最小的进程)进行调度,让其获得 CPU 资源并执行 。随着进程的运行,其虚拟运行时间会不断增加,当它的虚拟运行时间超过其他进程时,它会被移动到红黑树的右侧,降低其调度优先级 。
通过这种方式,CFS 能够实现对 CPU 时间的公平分配,确保每个进程都能在单位时间内获得公平的 CPU 时间,提高系统的响应性和资源利用率 。 例如,在一个多任务操作系统中,有多个进程同时运行 。CFS 通过红黑树来管理这些进程的调度,使得每个进程都能根据其虚拟运行时间获得相应的 CPU 时间 。对于交互式进程,由于其对响应时间要求较高,CFS 会给予它们较高的调度优先级,让它们能够快速地响应用户的操作 。对于后台进程,由于其对实时性要求较低,CFS 会适当降低它们的调度优先级,以便更好地利用系统资源 。这样,红黑树在进程调度中能够有效地平衡系统的性能和公平性,提高整个系统的运行效率 。 此外,红黑树在 Linux 内核的文件系统、设备驱动等其他模块中也有着广泛的应用,为内核的稳定运行和高效性能提供了有力的支持 。
六、位图(bitmap)
在驱动开发以及 Linux 内核源码中,位图都是一种常用的管理资源的方式。比如说,在对效率要求并非极其严苛的场景下,采用位图去管理资源会是个不错的选择,它简单且易于理解。像 cpumask 就是内核源码里使用位图的典型例子,其定义为 typedef struct cpumask { DECLARE_BITMAP(bits, NR_CPUS); } cpumask_t;。
位图管理资源的原理其实很简单,就是用 0 来表示资源处于可用的状态,而 1 则代表对应的资源已经被占用了,通过这样简单的 0 和 1 的设置,就能清晰地知晓资源的使用情况。更方便的是,Linux 内核已经贴心地为我们提供了众多位图操作的 API,我们在使用时,只需像 “拿来主义” 那样直接运用就好,这些 API 涵盖了位图的各种常见操作,为我们处理位图相关需求提供了极大的便利。
位图(Bitmap)在 Linux 内核中使用非常广泛,比如用来标识中断是否已安装处理程序(used_vectors)、处理器是否在线(cpumask)等等。内核中,位图相关的接口及实现主要在以下几个文件中:
include/linux/bitmap.h
lib/bitmap.c
lib/find_next_bit.c
include/linux/bitops.h
arch/x86/include/asm/bitops.h
其中头文件 arch/x86/include/asm/bitops.h 中,保存的是特定于 x86-64 架构的位图操作。
6.1位图相关汇编指令
在Linux内核中,位图(bitmap)是一种用于高效管理二进制状态的数据结构。与位图相关的汇编指令主要涉及对单个位或一组位的操作。以下是一些常见的汇编指令,可以用于实现位图的功能。
⑴设置位:SET 或 OR 指令可以用来设置特定位置为1。例如,使用 OR 操作将某个比特位置1。
; 假设 EAX 存储的是位图地址,EBX 存储的是要设置的比特位置
mov eax, [bitmap_address]
or byte ptr [eax], 1 << ebx ; 设置第 ebx 位
⑵清除位:CLEAR 或 AND 指令可以用来将特定位清零。例如,使用 AND 操作将某个比特位置0。
; 假设 EAX 存储的是位图地址,EBX 存储的是要清除的比特位置
mov eax, [bitmap_address]
and byte ptr [eax], ~(1 << ebx) ; 清除第 ebx 位
⑶读取位:TEST 指令可用于检查某个位是否被设置。
; 假设 EAX 存储的是位图地址,EBX 存储的是要检查的比特位置
mov eax, [bitmap_address]
test byte ptr [eax], 1 << ebx ; 检查第 ebx 位是否为1
jz not_set ; 如果为0则跳转到 not_set 标签
⑷翻转/切换位:XOR 指令可以用来切换某个位。
; 假设 EAX 存储的是位图地址,EBX 存储的是要翻转的比特位置
mov eax, [bitmap_address]
xor byte ptr [eax], 1 << ebx ; 翻转第 ebx 位
这些指令通常会在更复杂的函数和宏中使用,以提高代码可读性和效率。在Linux内核中,特别是在处理内存管理、任务调度等方面时,会频繁使用到这些低级操作。具体实现可能依赖于不同的平台和架构,因此具体细节可能会有所不同。
6.2位图Bitmap操作
(1)bit 位操作
在 Linux 内核中,有不少常用的 bit 位操作函数,下面为大家详细介绍一下它们的功能、参数定义及作用。
首先是 __set_bit 函数,其函数定义为 static inline void __set_bit(int nr, volatile unsigned long *addr) ,它的作用是用于在 bitmap 中将相应的 bit 位置 1。这里的参数 nr 代表的是 bit 索引,其取值范围属于 [0,bits-1];而 addr 则是一个指向存储位状态的内存地址,通过这个函数调用,就能把指定位置的二进制位设置为 1。
与 __set_bit 相反的是 __clear_bit 函数,定义为 static inline void __clear_bit(int nr, volatile unsigned long *addr),它的功能是将相应位置的 bit 清除为 0,其参数定义与 __set_bit 是一致的。
还有 __change_bit 函数,即 static inline void __change_bit(int nr, volatile unsigned long *addr),该函数能够将相应位置的值取反,也就是把 0 变为 1,1 变为 0。
另外,还有三个带 test 的对应的函数,分别是 test_and_set_bit、test_and_clear_bit、test_and_change_bit,它们相较于前面几个函数多了返回旧值的功能。
除此之外,还有 test_bit 函数,定义为 static inline int test_bit(int nr, const volatile unsigned long *addr),它主要用于测试对应位置是否置位,通过相应的运算逻辑来返回测试的结果,返回值为 1 表示对应位已置位,返回 0 则表示对应位未置位。
这些 bit 位操作函数在内核开发等场景中使用频繁,开发者可以根据具体需求灵活选用,实现对 bitmap 中 bit 位状态的各种操作。
(2)bit 位遍历
在 Linux 内核中,提供了多个用于 bit 位遍历的接口,接下来对它们进行逐一介绍。
find_first_zero_bit 函数,其原型为 unsigned long find_first_zero_bit(const unsigned long *addr, unsigned long size),它的功能是寻找 bitmap 中第一个为 0 的位序,并返回该位序。这里 addr 是一个指向无符号长整型数组的指针,表示要查找的位图;size 则是位图的大小,以位为单位。
find_next_zero_bit 函数,函数原型是 unsigned long find_next_zero_bit(const unsigned long *addr, unsigned long size, unsigned long offset),它从 offset 这个起始位置开始,在位图中寻找下一个为 0 的位序,并返回找到的位序。其中 offset 表示从哪个位开始查找下一个为 0 的位,其最小值为 0,最大值为 sizeof(unsigned long)*8 - 1(在 32 位系统中就是 0 到 255)。
find_first_bit 函数,用于寻找 bitmap 中第一个为 1 的位序,并返回相应位序,其参数情况与前面寻找 0 位序的函数类似,都是通过传入位图地址和位图大小来确定查找范围。
find_next_bit 函数,函数形式为 unsigned long find_next_bit(const unsigned long *addr, unsigned long size, unsigned long offset),它从 offset 位置开始,在位图中查找下一个为 1 的位序,并返回该位序。
还有像 for_each_set_bit 这个宏定义,形式如下:
#define for_each_set_bit(bit, addr, size) \\
for ((bit) = find_first_bit((addr), (size));\\
(bit) < (size);\\
(bit) = find_next_bit((addr), (size), (bit) +1))
它的作用是从 0 位序开始遍历到 size - 1,返回每一个置位 bit 的位序。
for_each_set_bit_from 宏定义与 for_each_set_bit 基本相同,不过它多了一个起始位,是从特定位置开始查找并返回置位 bit 的位序,其定义形式为:
#define for_each_set_bit_from(bit, addr, size) \\
for ((bit) = find_next_bit((addr), (size), (bit));\\
(bit) < (size);\\
(bit) = find_next_bit((addr), (size), (bit) +1))
for_each_clear_bit 宏定义,定义如下:
#define for_each_clear_bit(bit, addr, size) \\
for ((bit) = find_first_zero_bit((addr), (size));\\
(bit) < (size);\\
(bit) = find_next_zero_bit((addr), (size), (bit) +1))
它是从 0 位序开始遍历,返回每一个为 0 bit 的位序。
for_each_clear_bit_from 宏定义同样类似,也是从特定位置开始查找并返回为 0 bit 的位序,定义形式为:
#define for_each_clear_bit_from(bit, addr, size) \\
for ((bit) = find_next_zero_bit((addr), (size), (bit));\\
(bit) < (size);\\
(bit) = find_next_zero_bit((addr), (size), (bit) +1))
这些 bit 位遍历的接口,在处理位图相关的操作时,能够帮助开发者便捷地按照不同需求去遍历位图中的每一位,从而进行相应的逻辑处理。
6.3位图Bitmap的应用
位图在 Linux 内核中有诸多实用的应用场景,下面为大家详细介绍一些常见的应用情况以及相应的代码示例,帮助大家更好地理解其实际使用逻辑与效果。
(1)分配唯一 PID
在 Linux 系统中,需要为每个进程分配唯一的进程标识符(PID),同时还要对已经分配好的 PID 进行跟踪管理。这时,内核就巧妙地运用了位图来解决这个问题。内核会创建一个大的位图,其中每个 PID 由一个比特来标识。例如,PID 的值可通过对应比特在位图中的位置计算得出。
具体来说,分配一个空闲的 PID,本质上等同于在位图中寻找第一个值为 0 的比特,找到后将该比特设置为 1,便完成了 PID 的分配操作。以下是一个简单的代码示意,展示如何去寻找空闲 PID 并分配(这里只是示例逻辑,实际内核代码更复杂且涉及更多细节处理):
#include <linux/bitmap.h>
#include <linux/bitops.h>

// 假设我们有一个足够大的位图来表示PID,这里简单定义一个长度示例
#define PID_BITMAP_LEN 1024
DECLARE_BITMAP(pid_bitmap, PID_BITMAP_LEN);

// 函数用于分配一个空闲的PID
int allocate_pid() {
    int index = find_first_zero_bit(pid_bitmap, PID_BITMAP_LEN);
    if (index < PID_BITMAP_LEN) {
        // 找到空闲位,将其置为1,表示PID已被分配
        __set_bit(index, pid_bitmap);
        return index;
    }
    return -1; // 表示没有找到空闲的PID
}
而当要释放一个 PID 时,操作则相反,通过将对应的比特从 1 切换为 0 来实现,代码如下:
// 函数用于释放指定的PID
void release_pid(int pid) {
    if (pid >= 0 && pid < PID_BITMAP_LEN) {
        __clear_bit(pid, pid_bitmap);
    }
}
(2)内存管理的伙伴分配系统
在 Linux 内核的内存管理中,伙伴分配系统发挥着重要作用。伙伴系统主要用于管理系统中的物理内存页,它把两个物理地址相邻的内存页当作伙伴关系。而在伙伴分配系统的数据结构中有个关键的元素 —— 位图,其用于记录伙伴内存块的使用情况。
比如,在内存管理区数据结构中有个名为 free_area 类型为 free_area_t 的字段,它的作用就是用来管理内存管理区内的空闲物理内存页。free_area_t 结构中有个 map 字段,这个字段就是一个位图,每个位记录着一对伙伴内存块的使用情况。如果一对伙伴内存块中的某一个内存块在使用,那么对应的位就为 1,如果两个伙伴内存块都是空闲或者使用,那么对应的位就为 0。
以下是一段简单示意代码,展示在伙伴分配系统中利用位图判断伙伴内存块能否合并的逻辑(仅是示意,实际内核代码更复杂):
// 假设这里有个结构体表示内存管理区中的空闲区域相关信息
typedef struct free_area_struct {
    struct list_head free_list;
    unsigned int  *map;  // 这里就是记录伙伴内存块使用情况的位图指针
} free_area_t;

// 函数判断给定的一对伙伴内存块(这里假设通过内存块索引index来表示)能否合并
int can_merge_buddies(free_area_t *area, int index) {
    // 通过位运算等操作来获取对应位的状态,这里简化示意获取逻辑
    int bit_status = test_bit(index, area->map);
    if (bit_status == 0) {
        return 1;  // 对应位为0,说明两个伙伴内存块都空闲,可以合并
    }
    return 0;  // 对应位为1,说明有一个内存块在使用,不能合并
}
通过这样的位图记录,当释放内存块时,如果对应的位是 1 的话,那么说明另外一个伙伴内存块是空闲状态的,所以释放当前内存块可以跟其伙伴内存块合并成一个更大的内存块,从而高效地管理物理内存的分配与回收。
(3)调试场景
位图还可以用于调试相关的操作,方便开发人员查看资源的使用情况等信息。比如下面这段代码定义了一个长度为 128 的位图,代表 128 份的资源,1 表示不可用,0 表示可用,并且利用 sysfs 添加了位图的调试接口,方便查看资源使用以及进行相关设置操作:
#include <linux/bitmap.h>
#include <linux/bitops.h>
typedef   unsigned short uint16;
typedef   unsigned int   uint32;
#define BITMAP_LEN 128
DECLARE_BITMAP(Test, BITMAP_LEN);

// 获取可用资源索引的函数,用于调试查看
static ssize_t bitmap_debug_get_usable_index(struct device *dev,
                                              struct device_attribute *attr,
                                              char *buf) {
    uint16 index = 0;
    index = find_first_zero_bit(Test, 128);
    printk("\n   index:%d\r\n", index);
    return 0;
}

// 设置资源为已使用的函数,通过传入范围来设置相应位为1
static ssize_t bitmap_debug_set_used_index(struct device *dev,
                                            struct device_attribute *attr,
                                            const char *buf, size_t count) {
    uint32 start = 0;
    uint32 end   = 0;
    uint32 index = 0;
    uint32 old   = 0;
    sscanf(buf, "%u%u", &start, &end);
    if ( start > end) printk("index start input error\n\r");
    for (index = start; index <= end; index++)
        old = test_and_set_bit(index, Test);
    return count;
}

// 创建用于获取索引的设备属性
static  DEVICE_ATTR(get_index, S_IRUSR, bitmap_debug_get_usable_index,
                    NULL);
// 创建用于设置索引的设备属性
static  DEVICE_ATTR(set_index, S_IWUSR, NULL,
                    bitmap_debug_set_used_index);

struct attribute *bitmap_attrs[] = {
    &dev_attr_get_index.attr,
    &dev_attr_set_index.attr,
    NULL,
};

struct attribute_group bitmap_group = {
   .name  = "bitmap",
   .attrs  = bitmap_attrs,
};
从上述这些应用场景可以看出,位图在内核中的应用十分广泛,它以简洁高效的方式帮助内核完成了众多资源。
6.4位图接口在实际项目中的案例分析
在大型数据中心的设备管理系统里,有着众多的服务器、存储设备等硬件资源需要进行管理和调度。假设有一个数据中心拥有 1000 台服务器,使用位图来标记这些服务器的使用状态,每一位对应一台服务器,0 表示空闲,1 表示正在被使用。
通过 set_bit 接口,当某台服务器被分配任务开始工作时,就可以将对应位设置为 1;任务结束后,利用 clear_bit 接口将该位清零,标记为空闲状态。例如,当第 300 台服务器接收到任务开始运行,代码可以这样写:
#include <stdio.h>
#include <asm/types.h>

#define SERVER_COUNT 1000  // 总共1000台服务器
int main() {
    volatile unsigned long server_bitmap[SERVER_COUNT / (sizeof(unsigned long) * 8)] = {0};  // 初始化位图
    // 假设第300台服务器开始使用,设置对应位为1(注意要换算成正确的偏移量)
    set_bit(299, server_bitmap);
    // 这里可以添加其他相关操作代码,比如记录使用日志等
    return 0;
}
而在需要寻找空闲服务器进行新任务分配时,借助 find_first_zero_bit 接口,就能快速定位到第一个值为 0 的位,也就是找到第一台空闲的服务器,从而高效地进行资源分配。
这样做带来的效益是显著的,相比于传统的用数组或者链表等方式来记录服务器状态,位图极大地节省了内存空间。原本记录 1000 台服务器状态,如果用布尔值数组来表示,需要 1000 个字节的空间,而采用位图,只需要 1000 / (8 * sizeof (unsigned long)) 个 unsigned long 类型的空间,大大减少了内存占用。同时,通过接口操作位图来判断和更新设备状态,速度也很快,能快速响应对设备资源的调度需求,提升了整个数据中心设备管理的效率。
七、基数(radix)树
基数树是一种将指针与长整数键值相关联的机制,存储有效率且可快速查询,常用于指针与整数值的映射、内存管理等。它是一种多叉搜索树,叶子结点是实际的数据条目,每个结点有固定数量的指针指向子结点,并有一个指针指向父结点。
基数树,也被称为 PAT 位树(Patricia Trie or crit bit tree),是通用的字典类型数据结构。Linux 内核使用了数据类型 unsigned long 的固定长度输入的版本,每级代表了输入空间固定位数。
在 Linux 内核中,基数树有广泛的用途,比如用于内存管理。结构 address_space 通过 radix 树跟踪绑定到地址映射上的核心页,该 radix 树允许内存管理代码快速查找标识为 dirty 或 writeback 的页。
基数树为稀疏树提供了有效的存储,代替固定尺寸数组提供了键值到指针的快速查找。例如,Linux radix 树每个结点有 64 个 slot(当配置为每个结点有 2^6 = 64 个 slot 时),与数据类型 long 的位数相同。以一个有 3 级结点的 radix 树为例,每个数据条目可用 3 个 6 位的键值进行索引,键值从左到右分别代表第 1~3 层结点位置。没有孩子的结点在图中不出现。
对于数据量大的场景,比如存储和维护 100 亿个 url 及其属性,可考虑使用 radix 树。例如将 url 分配到多台机器中,每台机器可以将 url 直接放在内存,接将 url 组织成树状结构,对于字符串来说,最长使用的是 Trie tree,由于所占空间由最长 url 决定,在这里绝对不适用,再加上很多 url 拥有相同的属性(如路径等),这样,使用 trie tree 的一个变种 radix tree,相比会非常节省空间,并且不会影响效率。比如对 http://www.baidu.com 以及 http://www.12345.com 这种都可以按 3 - 5 - 3 作为基数树各层比较的前缀位数。
在 Redis 中,基数树被用来存储 stream 消息队列,消息队列中的每一个消息 ID 都是时间戳加序号,有了基数树就能根据 ID 快速定位到具体的消息。它还用来在 cluster 中定位槽和 key 的关系,此时 node 名是由槽位编号和 key 组合而成的,所以能快速找到对应槽位并遍历所有 key。
基数树与 Trie 树(字典树)的思想有点类似,甚至可以把 Trie 树看为一个基为 26 的 Radix 树。(也可以把 Radix 树看做是 Trie 树的变异)Trie 树一般用于字符串到对象的映射,Radix 树一般用于长整数到对象的映射。trie 树主要问题是树的层高,如果要索引的字的拼音很长很变态,我们也要建一个很高很变态的树么?radix 树能固定层高(对于较长的字符串,可以用数学公式计算出其特征值,再用 radix 树存储这些特征值)。Radix 树的原理实际上有点像多层 hash,每一层的 key 只不过是 key 的一段位范围的值,有点像页表映射的过程。
7.1基数树工作原理
内核基数树(Radix Tree)的工作原理主要体现在其数据结构和操作方法上。基数树是一种多叉搜索树,用于高效存储和检索键值对,特别适用于整数键值的映射。
基数树的核心数据结构包括节点和指针。每个节点最多有 2^n2n 个子节点(nn 为正整数),这意味着每个节点最多有 64 个子节点(当 n=6n=6 时)。这种结构使得基数树能够高效地管理稀疏的整数集合。每个节点包含一个指针数组,数组中的每个元素称为槽(slot),用于指向子节点。叶子节点包含实际的数据条目。
基数树的主要操作包括插入、查找和删除。插入操作时,根据键值的二进制表示逐位确定节点的位置,逐步向下遍历树直到达到叶子节点。查找操作类似,通过键值的二进制表示在树中遍历,直到找到匹配的叶子节点。删除操作则需要处理节点的引用计数和子节点的调整,确保树的完整性。
7.2基数树在内核的应用
(1)文件缓存页管理
早期内核用共同散列表管理文件页缓存,存在并发访问性能问题。在较早版本的内核中(比如 2.4.0),文件页缓存是通过共同的散列表 page_hash_table 组织的,根据缓存页对应的 index 进行 hash,虽然能较快地搜索到指定文件的指定页,且没有太多额外内存消耗,但所有访问文件都通过同一个散列表缓存页,查询时都通过自旋锁 pagecache_lock,降低了多进程的并发访问性能。
2.6 内核中用各文件地址空间自行管理缓存页,采用基数树管理文件页,提高了并发性能。Linux 2.6 内核的文件页是通过基数树管理的,页索引决定了其在树中的位置。文件地址空间对象的数据结构中,page_tree 即指向基数树的根,该指针指向 radix_tree_root 结构。radix_tree_root 中的 rnode 指向根节点,根节点是一个 radix_tree_node 结构,其中 height 为节点的高度,count 指示孩子节点数,slots 为子节点指针数组,对于叶节点则指向对应的页结构,tags 数组使用位图分别指示各子树是否包含有对应标志的页,如脏和写回标志。
(2)进程间通信 ipc 对象管理
较早内核中 ipc 对象用固定数组管理,存在性能问题。较早内核(如 2.6.11)中的 ipc 对象(比如共享内存对象 shm)是用固定数组管理的,对象 id 为数组的下标,当对象数量剧增,原有数组对象数不够时就要通过 grow_ary () 重新分配新的数组,然后进行新旧数组间的内容拷贝,当对象数量变化较大时就要面临数组的频繁分配和释放,这对性能不利。
2.6.24 中 ipc 对象改用基数树管理,提高了动态性能。在 2.6.24 中 ipc 对象改用基数树 idr 管理,虽然通过 idr 定位对象不像数组那么直接(时间复杂度为树的高度),但是换取了很好的动态性能,增加对象时不会面临大规模的内存分配,只需要创建一个或几个(扩展树时)树节点,并且获取空闲 id 的性能比数组要好,这直接影响了插入新对象的速度。idr 结构用于管理包含 ipc 对象的基数树,以对象 id 为索引,其中 idr_layer 是树节点结构,top 指向根节点,layers 是树的高度,id_free 维护一个临时的空闲节点链表,id_free_cnt 指示空闲链表中的节点数。
7.3如何理解基数树
作用解决长整型数据映射中 Hash 冲突和表大小设计问题。空间使用灵活,只有需要用到某节点时才创建。
对于长整型数据的映射,Hash 冲突和 Hash 表大小的设计常常让人头疼。基数树针对这种稀疏的长整型数据查找,能够快速且节省空间地完成映射。它可以根据一个长整型(比如一个长 ID)快速查找到其对应的对象指针,比用 hash 映射更简单、更节省空间。因为 hash 映射中 hash 函数难以设计,不恰当的 hash 函数可能增大冲突或浪费空间。
基数树的空间使用非常灵活,只有在需要用到某节点时才会去创建它。例如在 tcmalloc 的 pagemap(key 是释放内存的 pageid,value 是该 pageid 对应的 span)以及内核的页高速缓存中的基数树(key 是相对文件起始位置的第几页,value 是对应的页描述符)中都有所体现。
与 Trie 树的关系思想类似,Radix 树可看作 Trie 树的变种。Trie 树一般用于字符串到对象的映射,Radix 树一般用于长整数到对象的映射。
Radix 树与 Trie 树的思想有点类似,甚至可以把 Trie 树看为一个基为 26 的 Radix 树,也可以把 Radix 树看做是 Trie 树的变异。
Trie 树一般用于字符串到对象的映射,例如在字符串检索、文本预测、词频统计、排序以及字符串最长公共前缀。
八、跳表
跳表(slab allocator)是Linux内核中管理内存的一种机制,它用于分配和释放对象,是一种提高内存分配效率的技术。
在Linux内核中,跳表通常用于以下场景:
-
缓存常用的数据结构,如inode、dentry、task_struct等。
-
为了提高内存分配效率,通过预先分配一组对象,并通过一个特定的数据结构来管理这些对象,从而避免了频繁的内存分配调用。
以下是一个简单的示例,展示了如何在Linux内核中使用跳表(slab分配器)来分配和释放内存:
#include <linux/slab.h>

// 定义一个结构体
struct my_struct {
    int number;
    char *message;
};

void my_function() {
    struct my_struct *my_object;

    // 分配一个my_struct类型的对象
    my_object = kmalloc(sizeof(struct my_struct), GFP_KERNEL);
    if (!my_object) {
        // 如果分配失败,应该有适当的错误处理
        return;
    }

    // 使用my_object
    my_object->number = 123;
    my_object->message = "Hello, world!";

    // 当不再需要时,释放my_object占用的内存
    kfree(my_object);
}
在这个例子中,kmalloc 用于分配一个新的 struct my_struct 对象,kfree 用于释放之前通过 kmalloc 分配的内存。这里的 GFP_KERNEL 标志指示内存分配器在内核中使用,并且这是在进程上下文之外进行的。
跳表(slab分配器)是Linux内存管理中一个重要的部分,确保了内核可以有效地管理和分配内存,同时也提供了一种方式来缓存常用的数据结构,以提高系统性能。
九、时间轮
9.1时间轮算法基本思想
对于一个复杂的软件系统,定时器的对任务的管理和调度至关重要,通常定时器的管理已成为一个复杂系统的重要基础设施。
定时器有很多种,基于升序的定时器时间链表是一种最直接的实现方式:即按照定时器时间到的时间顺序依次存放在一个链表中进行管理。但是这种链表存在效率的不足,就是当插入定时器的时候时间复杂度是O(n). 因此需要一种更高效地管理定时器的数据结构和算法,这里结合Linux内核中基于时间轮的定时器管理器的具体实现,介绍一种基于时间轮的定时器管理算法。图1为时间轮的基本结构:
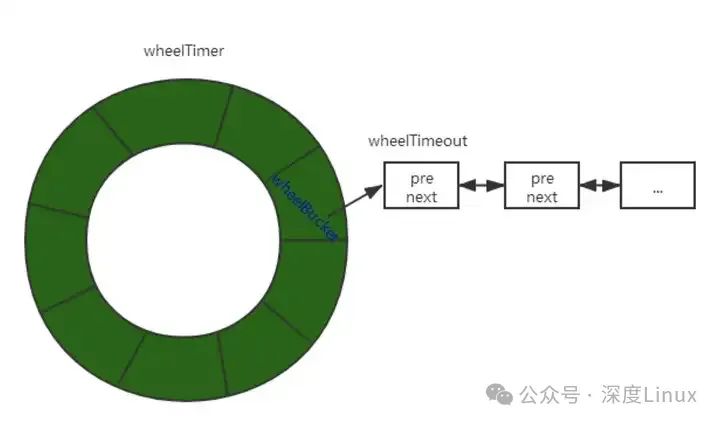
上面是一张时间轮的示意图,可以看到,这个时间轮就像一个钟表一样,它有刻度,图中画了9个格子,每个格子表示时间精度,比如每个格子表示1s,那么转一圈就是9s, 对于钟表上的秒针来说它的最小刻度是1s,秒针转一圈就是60s。时间轮上每个格子储存了一个双向链表,用于记录定时任务,当指针转到对应的格子的时候,会检查对应的任务 是否到期,如果到期就会执行链条上的任务。
9.2为什么使用时间轮?
我认为这个世界上任何事物的出现都有它的原因,只是大部分事物我们都无法找到它的原因而已,好在技术的出现是有一定规律的,要么是性能上的提高,要么就是易用性,时间 轮也不例外。假设给你一批任务,每个任务都有它的执行时间点,时间精确到秒,你会怎么去实现它?
启动一个线程,每秒轮询每个任务,用当前时间与任务的年,月,日,时,分,秒匹配,能匹配的扔到线程池中执行
优点:实现简单
缺点:每秒都要遍历所有的任务,对每个任务做匹配,对于很多还没有到时间的任务,做了无用功,当数据量大的时候会导致任务执行延时,对于这种情况也可以考虑多个 轮询线程分批执行的方案
根据执行时间采用小顶堆的排序算法
优点:无需轮询每个任务,只要取出第一个节点判断是否到期即可,如果时间未到期,线程wait
缺点:数据量大的时候,插入到一个已经排好序的小顶堆,时间复杂度为O(lgn),当然也还好,即使是2的30次方个数据,也就是30次,但是有一个与第一种方法相同的问题,那就是任务可能会导致延时,这种也可以通过分批来做优化。
上面的两种方式都有一个共同点,就是对任务没有分组,那我们给他们分个组,比如任务 里面有一个延时最大的任务的执行时间是100s,那么我们可以创建一个长度为100的数组,相同时间执行的任务放在一起,变成下面这样
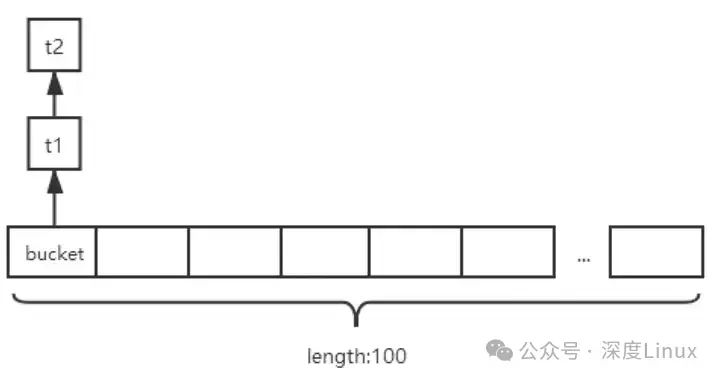
可以看到这个数组被分成了100个格子,每个格子表示1s,相同执行时间的任务被放在了一起,组成了一个链表,此时启动一个每秒执行的线程,每秒走一个格子,如果格子里有 任务那么扔到线程池中执行。那如果我最大的延时任务是上万秒以后,那是不是就得创建一个上万长度的数组啊?是的,这样的话就会导致一些问题,如果中间好多格子都没有 任务,着实挺浪费空间的,那么怎么改进呢?这个时候时间轮就呼之欲出了,下面就是时间轮的表演时间了
我们固定数组的长度为60个格子,每个格子的精度为1s,那么一圈就是60s,如果我有3个任务A、B、C,他们相对于启动轮询线程开始走第一个格子的时间差分 别为3s,50s,55s,那么其对应的格子为:
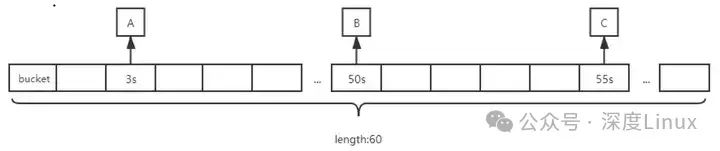
轮询线程只要走到对应A、B、C的格子就可以执行它们了,但是如果我有一个一万秒之后执行的任务D,该怎么办呢?首先我们可以计算下走一万秒,轮询线程需要走166圈,还余 40s,那么这个任务我们可以增加额外的属性用于记录圈数,任务存放在第40个格子上:
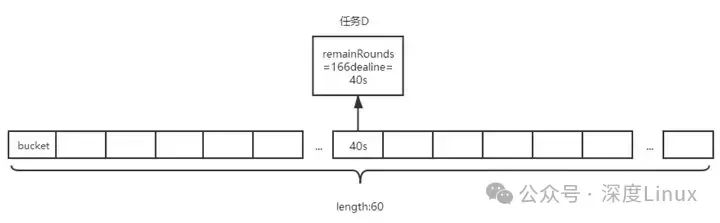
也就是说我这个轮询线程从第一个格子到达最后一个格子,再从第一个格子再到最后一个格子,周而复始,只要在第40个格子上遇见D任务167次就可以执行这个任务了。
看起来挺完美的,但是由于精度小,格子固定,当任务非常多的时候,每个格子上的链表将会变得很长,任务的执行将可能会延时,那怎么办?我们都知道,我们的钟表,除了 秒针之外,还有分针,时针。那么我们能不能再定义一个精度不同的时间轮呢?当然是可以的,假设我有一个任务E是在某点某分某秒执行,那么我们可以定义三个时间轮, 分别是秒时间轮,分时间轮,小时时间轮
秒时间轮:总共60个格子,每格1s 分时间轮:总共60个格子,每格1分钟 时时间轮:总共24个格子,每格1小时
现在假设上面三个时间轮启动时间都是startTime,用totalTick变量表示总格子数,tick表示当前指针走到的格子位置,tickDuration表示每个格子的精度,那么对于一个任务 怎么计算其圈数和所在下标的位置呢?计算方式如下:
    //计算任务执行点相对于时间轮启动时间的差值
    duration = 任务执行时间点 - 时间轮启动时间点startTime
    //计算从时间轮启动点到达执行点需要走多少格子
    needTicks = duration / tickDuration
    //减去已经走过的格子数,计算指针还需要走多少个格子
    remainTicks = duration / tickDuration - tick
    //计算还需要走多少圈
    remainRounds(圈数)= remainTicks / totalTick
    //如果提交的任务是过时的,比如我的任务执行点比当前时间点还小,那这种任务属于超时未执行任务,needTicks势必比tick小,那么需要尽早执行
    ticks = Math.max(needTicks, tick)
    //求余,计算存放任务的下标,ticks是一直往上递增的,为了性能考虑,这个totalTick会膨胀为2的指数次幂
    index = ticks % totalTick
假设上面三个时间轮启动的时间一样并且我们的任务E计算出来的duration为24小时30分20秒,那么首先这个任务E会存放在时时间轮的第24个格子上,等时时间轮走到第24个格子 后,会将这个任务E降级存放到分时间轮的第30个格子上,等分时间轮也走到第30个格子之后,又会把任务E存放到秒时间轮的第20个格子上,等秒时间轮走到第20个格子上之后 就会执行任务,我们管这种时间轮叫做层级时间轮。
9.3Netty中时间轮的实现
Netty 中实现的 HashedWheelTimer 是一种基于哈希表的时间轮,其基本结构包括:
-
槽数组:存储一组固定数量的“槽”。
-
指针:指向当前活动的槽,以便能够快速定位到下一个要处理的槽。
-
Tick Duration:每个“滴答”所代表的实际时间长度(例如,10 毫秒)。
HashedWheelTimer 的实现步骤:
public class HashedWheelTimer {
    private final long tickDuration; // 每个滴答代表多少毫秒
    private final int wheelSize; // 槽大小
    private final HashEntry[] wheel; // 槽数组
    private volatile long currentTick; // 当前滴答

    public HashedWheelTimer(long tickDuration, int wheelSize) {
        this.tickDuration = tickDuration;
        this.wheelSize = wheelSize;
        this.wheel = new HashEntry[wheelSize];

        // 启动定时器线程
        start();
    }

    private void start() {
        new Thread(() -> {
            while (true) {
                try {
                    Thread.sleep(tickDuration);
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                }
                advanceClock();
            }
        }).start();
    }

    private void advanceClock() {
        currentTick++;
        int index = (int) (currentTick % wheelSize);

        // 执行该索引上的所有任务
        executeTasks(wheel[index]);

        // 清理已完成任务
        wheel[index] = null;
    }

    public void schedule(Runnable task, long delay) {
        long ticksToDelay = delay / tickDuration;
        int index = (int) ((currentTick + ticksToDelay) % wheelSize);

        // 将任务添加到对应索引上
        addTask(wheel[index], task);
    }

    private void addTask(HashEntry entry, Runnable task) {
       if (entry == null) {
           wheel[index] = new HashEntry(task);
       } else {
           while(entry.next != null) {
               entry = entry.next;
           }
           entry.next = new HashEntry(task);
       }
   }

   static class HashEntry {
       Runnable task;
       HashEntry next;

       HashEntry(Runnable task) {
           this.task = task;
       }
   }

   private void executeTasks(HashEntry entry) {
      while(entry != null) {
          entry.task.run();
          entry = entry.next;
      }
   }
}
更多推荐



 38
 0
- 0


 已为社区贡献2条内容

所有评论(0)