
毕业设计:基于协同过滤的毕业生就业职位推荐系统
目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
选题指导:
大家好,这里是海浪学长毕设专题,本次分享的课题是
🎯结合协同过滤的大学毕业生就业推荐平台
课题背景和意义
随着高等教育的快速发展,大学毕业生数量逐年增加,面临的就业竞争愈发激烈。同时,企业对人才的需求也在不断变化,导致毕业生与招聘岗位之间的信息匹配问题日益突出。基于协同过滤的就业推荐系统,利用求职者的历史行为和其他用户的反馈,能够为毕业生提供个性化的职位推荐,帮助他们更有效地找到适合的工作。这种技术不仅提升了求职体验,还能提高企业招聘的效率,推动就业市场的健康发展。
实现技术思路
一、算法理论基础
1.1 协同过滤
协同过滤技术是一种用于推荐系统的重要算法,它基于用户行为和兴趣的相似性,以提供个性化的建议和推荐。这种技术的核心思想是通过分析大量用户的历史数据,如浏览记录、评分和购买历史等,来发现用户之间的相似性和关联性。协同过滤技术可以分为两大主要类型:用户协同过滤和物品协同过滤。用户协同过滤将用户与兴趣相似的其他用户进行比较,从他们的行为中提取潜在的兴趣点,然后向用户推荐这些相似用户喜欢的项目。物品协同过滤则是基于物品之间的相似性,根据用户以前的喜好来推荐类似于其以前喜欢的物品。
基于用户的协同过滤算法提供了高度个性化的推荐,侧重于用户之间的相似性,根据用户的历史行为和兴趣定制推荐内容,这有助于提高用户满意度。这种算法相对容易理解和实施,因为其核心思想是找到与目标用户相似的其他用户,并推荐他们喜欢的项目。它不需要项目的详细特征信息,只需用户的历史数据,因此适用于各种推荐场景。基于用户的协同过滤不受项目库快速增长的影响,主要依赖于用户之间的关联性,而不是项目之间的关联性,这使其在大规模和高维度数据上表现出色。因此,这种算法在提供个性化、可伸缩和易于实施的推荐方面具有明显的优势。
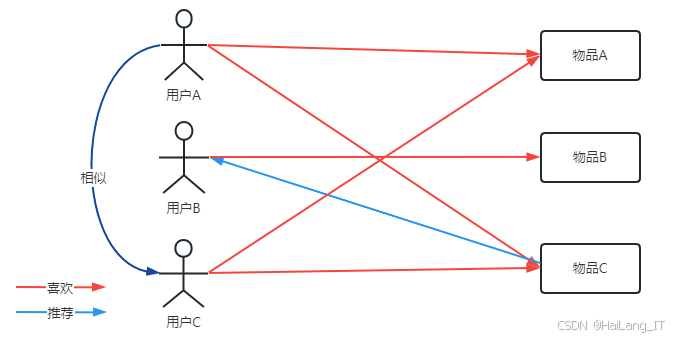
该算法基于用户以前的历史行为数据,通过分析这些数据来确定用户对商品的偏好,如购买、内容分享或评论,并据此计算目标用户的兴趣分数。此外,算法还会根据不同用户对商品的偏好计算他们之间的相似度,兴趣相近的用户说明相似度很高,相似的产品就会被推荐给目标用户。基于用户的协同过滤是一种推荐算法,它利用用户之间的相似性进行推荐。
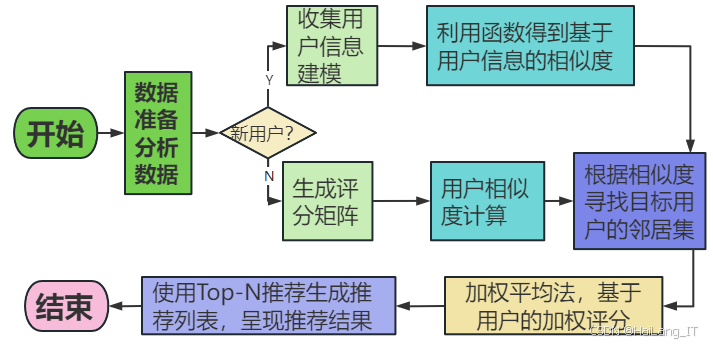
以下是基于用户的协同过滤推荐算法的流程:
- 数据准备:收集并准备用户和物品的互动数据,通常是一个用户-物品交互矩阵,其中行代表用户,列代表物品,每个元素表示用户对物品的互动(如评分、点击、浏览等)。
- 用户相似性计算:对用户之间的相似性进行计算,以确定哪些用户具有相似的兴趣。常用的相似度度量包括余弦相似度、皮尔逊相关系数和 Jaccard 相似度等。对于每对用户,计算一个相似度分数,表示它们之间的相似程度。
- 邻居选择:选择与目标用户最相似的用户作为邻居,涉及设置一个相似度阈值或选择固定数量的邻居用户。
- 物品推荐:利用邻居用户的互动数据预测目标用户对未互动物品的兴趣。可以通过加权平均法实现,对邻居用户的互动数据进行加权平均,权重通常是相似度的函数,以预测用户对未互动物品的评分。此外,也可以基于用户的加权评分实现,将邻居用户对未互动物品的评分加权平均,作为目标用户的预测评分。
- 推荐生成:生成推荐列表,根据预测评分排序的前 N 个物品,N 是一个固定的数字。
- 推荐结果呈现:将生成的推荐结果展示给用户,通过网页、应用程序或其他用户界面呈现。
基于物品的协同过滤的核心思想是通过分析用户的历史行为数据来发现物品之间的相似性,然后向用户推荐与他们以前喜欢的物品相似的其他物品。这一算法的运作方式是,首先创建一个物品之间的相似性矩阵,其中每个物品与其他物品之间的相似度得分被计算出来。然后,当用户表达对某一物品的兴趣或喜好时,系统会根据用户对该物品的评分或点击行为,查找与之相似的其他物品,并将这些相似的物品推荐给用户。这种方法充分考虑了物品之间的联系和用户的历史喜好,因此能够提供个性化、精准的推荐,适用于各种推荐场景,如电影推荐、电子商务和音乐推荐等。它的优势在于对新用户和物品有较好的扩展性,并不需要太多用户信息,只需物品的相似性信息和用户的历史行为数据。
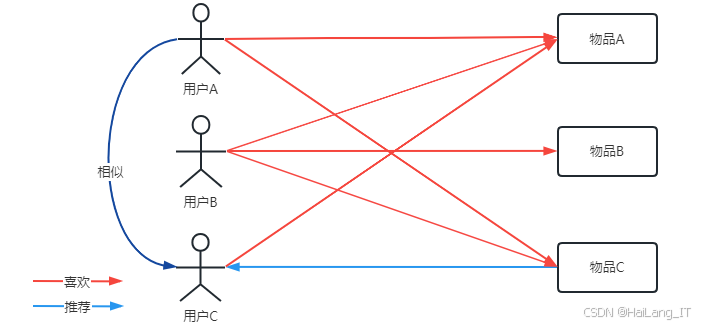
基于物品的协同过滤依赖于物品之间的相似性进行推荐。以下是基于物品的协同过滤推荐算法的流程:
- 数据准备:收集和准备用户和物品的互动数据,通常是一个用户-物品互动矩阵,其中行代表用户,列代表物品,每个元素表示用户对物品的互动(如评分、点击、购买等)。
- 物品相似性计算:计算物品之间的相似性,以确定哪些物品具有相似的用户互动模式。通常使用相似性度量,如余弦相似度、皮尔逊相关系数或 Jaccard 相似度。对于每对物品,计算一个相似度分数,表示它们之间的相似性。
- 相似物品选择:对于每个物品,选择与之相似度最高的一组其他物品。这些相似物品将用于生成推荐。
- 用户-物品矩阵转置:将用户-物品互动矩阵转置,以便可以在物品之间进行推荐,其中行代表物品,列代表用户。
- 物品推荐:利用相似物品的互动数据为每个用户生成推荐物品列表。可以通过基于物品的加权平均,对用户已经互动过的物品进行加权平均,权重通常是与目标物品的相似度相关的函数。也可以通过基于物品的加权评分,将用户对已互动物品的评分与目标物品的相似性相结合,以生成对未互动物品的预测评分。
- 推荐生成:为每个用户生成推荐列表,根据预测评分排序的前 N 个物品,其中 N 是一个固定的数字。
- 推荐结果呈现:将生成的推荐结果展示给用户,通过网页、应用程序或其他用户界面呈现。
1.2 推荐算法
就业推荐系统旨在为大学毕业生推荐最符合其就业标准的企业雇主,首先需要识别与学生要求相似的企业。该过程的第一步是找到特征最相似的毕业生,随后利用传统的协同过滤推荐系统对企业单位进行兴趣评分。通过计算相似度,找出相邻学生之间的评分接近程度,从而判断他们的就业偏好是否相似,进而为学生提供推荐。例如,如果学生 A 和学生 C 都选择了 A 公司和 C 公司,而学生 C 还选择了 D 公司,那么可以将 D 公司推荐给学生 A。这种基于相似性转移原则的方法有效地为学生提供了个性化的就业推荐。
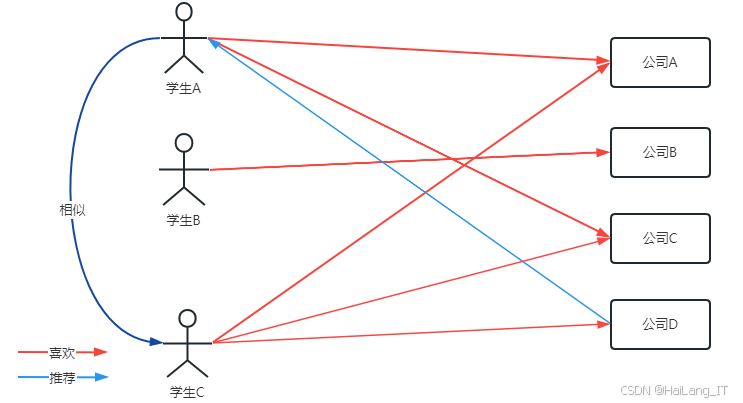
随机游走算法是一种用于优化和搜索问题的有效方法,其基本思想是在图中从一个节点开始,随机选择邻居节点并不断重复这一过程。该算法包括简单随机游走和周期性随机游走两种形式,前者在每次移动时随机选择邻居,而后者则考虑节点的周期性特征。随机游走算法能够解决一些难以用其他方法处理的问题,如最短路径和中心节点的寻找,具有简单易行的优点。通过分析往届学生的就业去向数据,可以发现毕业生的某项属性与企业招聘需求高度匹配时,其被录用的概率显著提高。用于计算企业的偏好系数。该算法的核心思想是根据不同企业对不同特征的选择次数,为原始二分图模型中的边设置不同的权重。如果某个毕业生的特征多次被某个企业选中,则该企业对该特征的偏好较高,表现为企业与该特征的联系边权重增加;反之,则权重降低。基于此设计理念,权重与毕业生特征被选中的次数成正比,且与企业偏好的特征种类次数成反比。
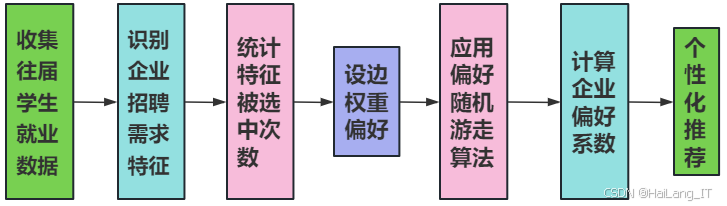
利用爬虫技术收集企业招聘岗位信息及往届求职人员信息,提取特征值并进行归一化处理,进而计算毕业生与企业单位的相似度。在此基础上,应用随机游走模型算法来计算企业单位的求职热度。
二、 数据集
采用爬虫技术对企业招聘岗位信息和以往求职人员的信息进行系统性收集。通过编写爬虫程序,能够自动化地访问各大招聘网站,提取出与岗位相关的关键信息,如岗位名称、工作地点、薪资待遇、所需技能、公司背景等。同时,还收集往届求职人员的简历数据,包括教育背景、工作经验、技能特长等。收集到的数据经过清洗和去重处理后,进行特征值的抽取,以提取出对就业推荐有意义的属性,如技能匹配度、经验年限等。
三、实验及结果分析
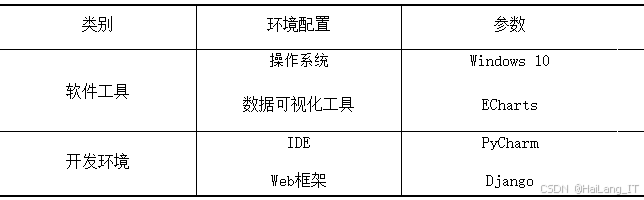
3.1 实验环境搭建
3.2 模型训练
从各大招聘网站和公司官网获取公开发布的职位信息。通过使用强大的网络爬虫技术,系统能够定期抓取大量职位数据,包括职位描述、公司信息、地理位置、薪资等关键信息。这不仅提高了数据的全面性,还确保了其时效性。此外,系统还会收集用户的个人信息、简历数据和过往职业经历,以深入了解用户的技能、兴趣和需求,从而提供更具个性化的职位推荐。在数据爬取的过程中,系统遵循数据隐私法规,确保用户数据的安全和隐私保护。
import requests
from bs4 import BeautifulSoup

def scrape_job_data(url):
    response = requests.get(url)
    soup = BeautifulSoup(response.text, 'html.parser')
    job_listings = []

    for job in soup.find_all('div', class_='job-listing'):
        title = job.find('h2').text
        company = job.find('div', class_='company').text
        location = job.find('div', class_='location').text
        salary = job.find('div', class_='salary').text
        job_listings.append({
            'title': title,
            'company': company,
            'location': location,
            'salary': salary
        })

    return job_listings

# 使用示例
url = 'https://example-job-website.com'
job_data = scrape_job_data(url)
通过图形和可视化方式呈现系统的推荐结果及相关数据,帮助用户和管理员更好地理解信息和趋势。该功能包括数据分析和报告,允许管理员监控系统性能、用户行为和推荐结果。用户界面提供各种图表和仪表板,以可视化展示推荐的职位及与用户偏好相关的信息。
import matplotlib.pyplot as plt

def visualize_job_recommendations(job_recommendations):
    titles = [job['title'] for job in job_recommendations]
    salaries = [job['salary'] for job in job_recommendations]

    plt.barh(titles, salaries)
    plt.xlabel('Salary')
    plt.title('Recommended Job Positions')
    plt.show()

# 使用示例
visualize_job_recommendations(cleaned_data.head(10).to_dict(orient='records'))
分析用户的历史行为,包括过往的职业经验、搜索历史和点击记录,以了解他们的需求和兴趣。通过协同过滤算法寻找与用户相似的其他用户,从而识别他们的共同兴趣。基于这些相似性,系统将推荐与用户的兴趣和需求高度匹配的职位,以提高匹配度。
from sklearn.metrics.pairwise import cosine_similarity

def recommend_jobs(user_vector, job_vectors):
    similarities = cosine_similarity(user_vector, job_vectors)
    recommended_indices = similarities.argsort()[0][-5:]  # 推荐最相似的5个职位
    return recommended_indices

# 示例用户向量和职位向量
user_vector = [[1, 0, 0, 1]]  # 假设用户对某些技能的偏好
job_vectors = [[1, 1, 0, 0], [0, 1, 1, 1], [1, 0, 1, 0], [0, 0, 1, 1]]  # 职位的技能向量
recommended_jobs = recommend_jobs(user_vector, job_vectors)
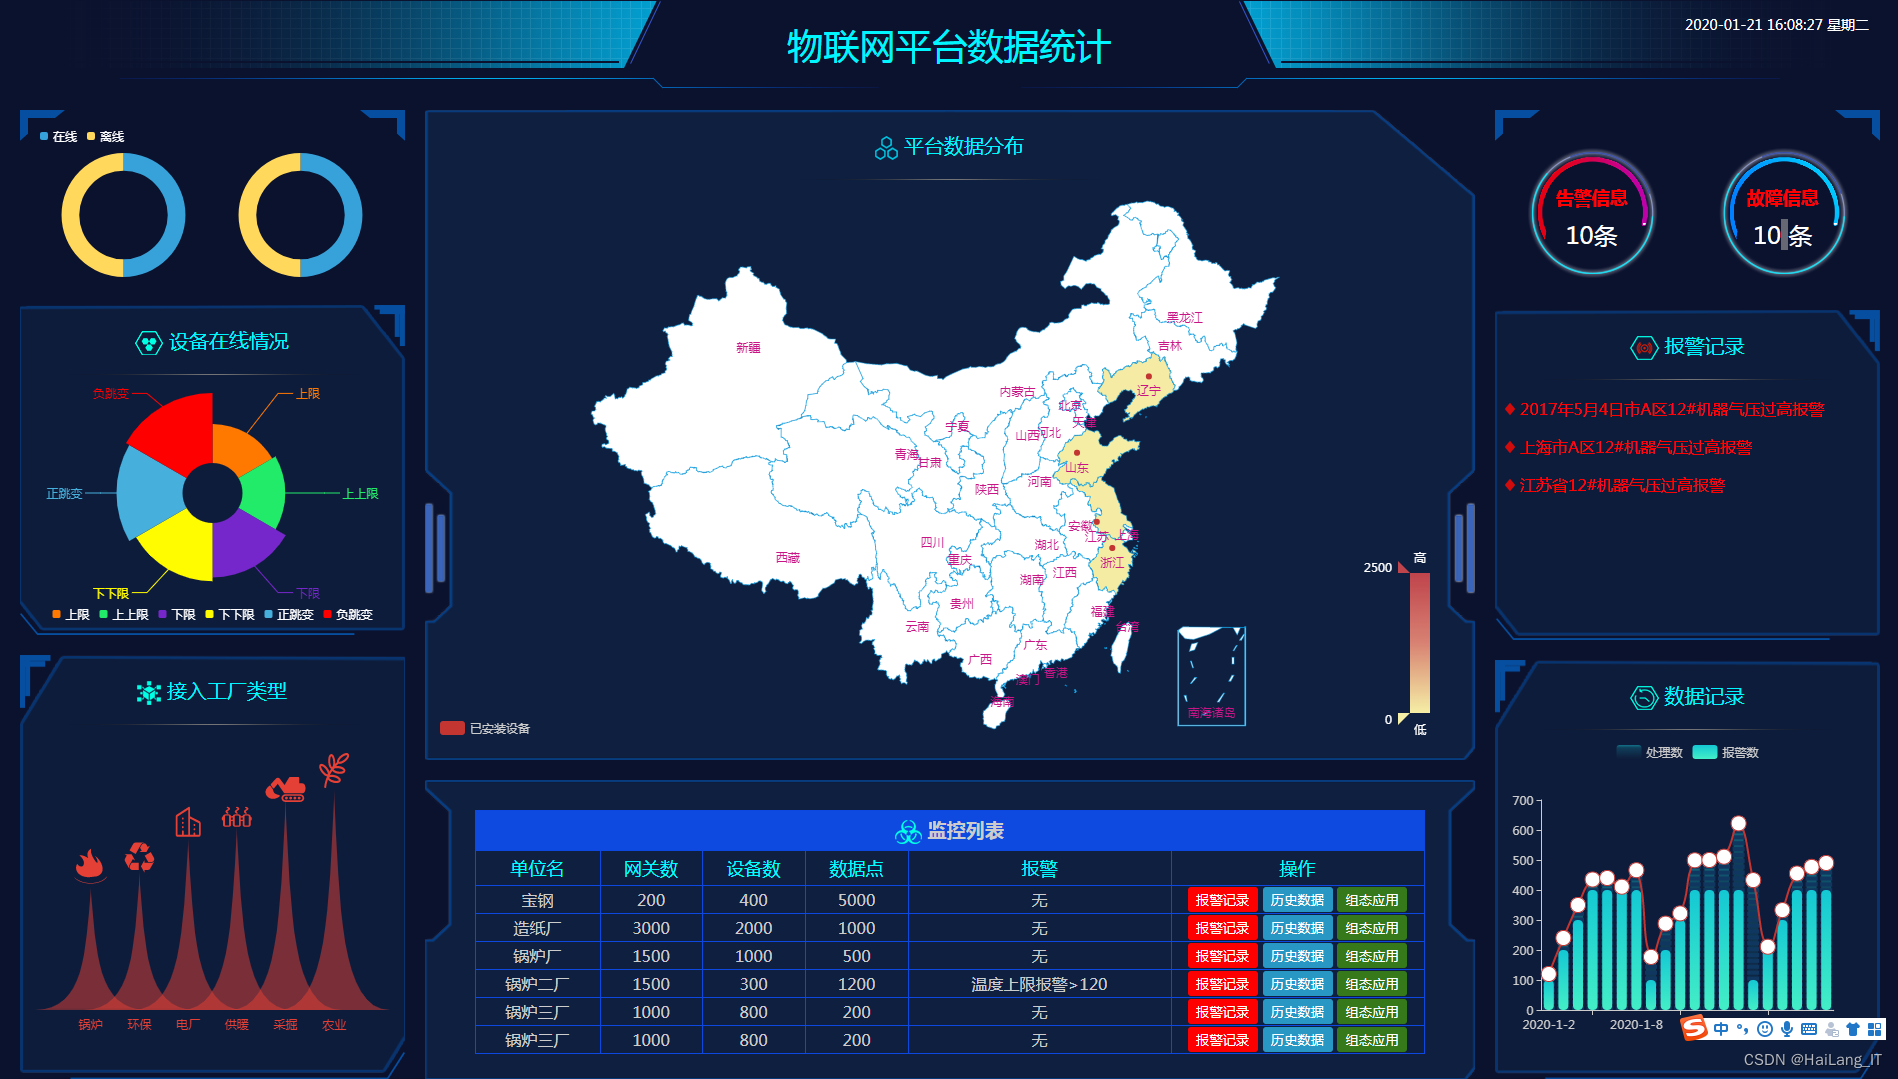
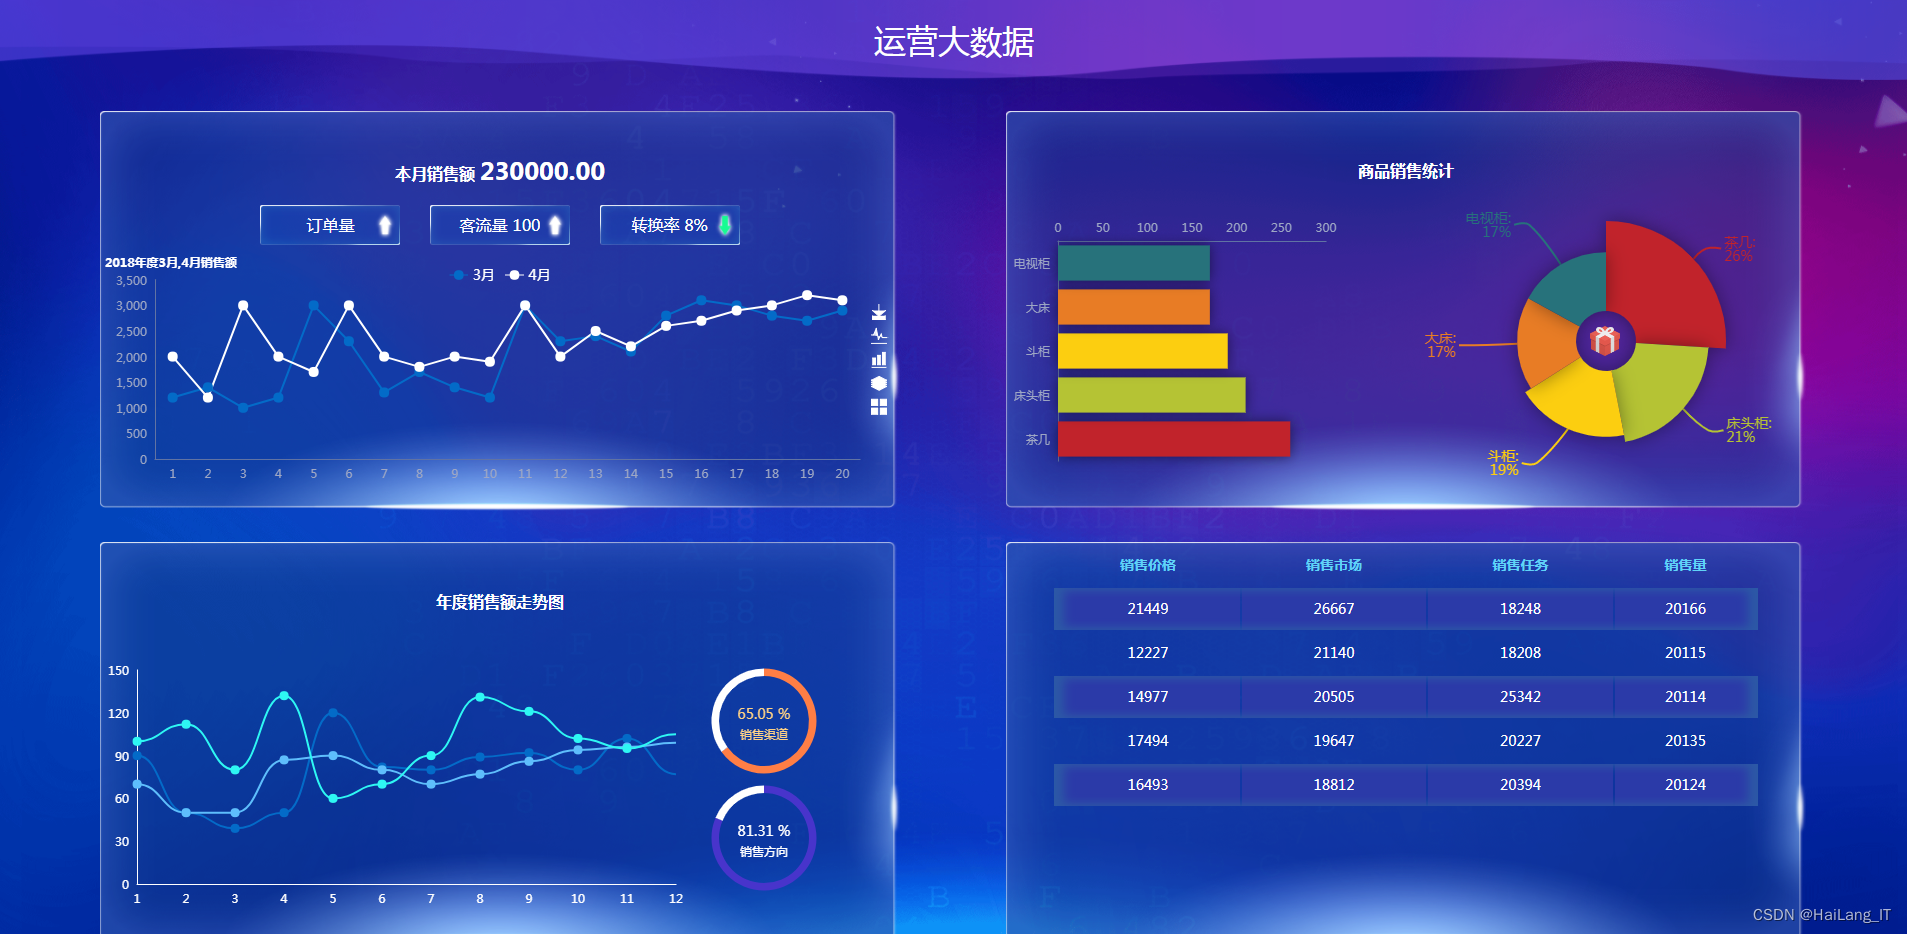
海浪学长项目示例:



最后
我是海浪学长,创作不易,欢迎点赞、关注、收藏。
毕设帮助,疑难解答,欢迎打扰!
更多推荐



 30
 0
- 0


 已为社区贡献11条内容

所有评论(0)