
【mycat2】读写分离配置
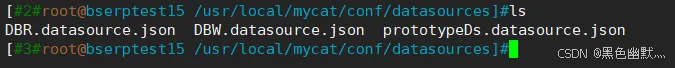
1. 配置真实数据源
登录DBeaver,连接到mycat库
1.1 查看当前数据源
/*+ mycat:showDataSources{} */
1.2 设置新数据源
创建DBW写入库
/*+ mycat:createDataSource{"name":"DBW","url":"jdbc:mysql://192.168.0.15:3307/kings?useSSL=false&characterEncoding=UTF-8&useJDBCCOMPliantTimezoneShift=true","user":"root", "password":"lyu888"} */
创建DBR只读库,指向集群中的slave服务,如果有多个从库,依次继续创建
/*+ mycat:createDataSource{"name":"DBW","url":"jdbc:mysql://192.168.0.15:3308/kings?useSSL=false&characterEncoding=UTF-8&useJDBCCOMPliantTimezoneShift=true","user":"root", "password":"lyu888"} */
2. 创建集群
2.1 更新集群信息
/*+ mycat:CREATECluster{"name":"WRSplitCluster","masters":["DBW"],"replicas":["DBR"]} */
将刚刚创建的数据源DBW与DBR更新到集群WRSplitCluster中
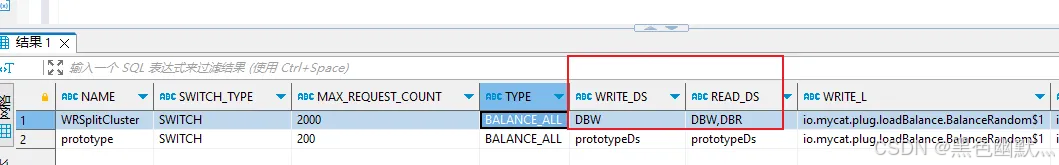
2.2 查看配置集群信息
/*+ mycat:showClusters{} */
3. 配置逻辑库
3.1 在mycat2服务端,声明一个逻辑库
**create** **database** wrdb
有了集群后,还需要在mycat2中配置一个逻辑库,指向这个集群。
这样客户端只需操作这个逻辑库,由mycat2去完成真实的读写分离逻辑。
3.2 修改wrdb逻辑库配置
vim wrdb.schema.json
 "customTables":{},
        "globalTables":{},
        "normalProcedures":{},
        "normalTables":{},
        "schemaName":"wrdb",
        "shardingTables":{},
        "tartgetName":"WRSplitCluster",  //修改这一行,指定目标集群
        "views":{}
通过wrdb库连接到WRSplitCluster集群
注:在服务器上手动修改的配置文件不会立即生效,需要重启服务
/usr/local/mycat/bin/mycat restart
4. 验证读写分离
4.1 创建测试表
create table demo(
    id int(11) primary key not null auto_increment,
    name varchar(50) not null,
    job varchar(10)
    )engine = innodb default charset =utf8mb4;

  #插入测试数据
  insert into demo(id,name,job) values(null,'刘备','打野'),(null,'关羽','上单'),(null,'张飞','辅助');
4.2 查询验证
**select** * **from** demo
在2.2图中,可以看到集群信息有只一个写入节点DBW,所以刚刚写入的测试数据就只在DBW(3307)中存在,DBR(3308)是没有数据的。
select查询会从两个读取节点中随机执行,所以有时会显示报错Unknown,就是从DBR中读取。
SQL 错误 [1049] [42000]: Unknown database 'wrdb’
更多推荐
 10
 0
- 0


 已为社区贡献1条内容

所有评论(0)