
深度解密:Facebook、Airbnb、YouTube和阿里巴巴如何用深度学习重塑推荐系统
目录
3、Airbnb 基于 Embedding 的实时搜索推荐系统
一、引言
推荐系统领域是深度学习落地最充分,产生商业价值最大的应用领域之--些最前沿的研究成果大多来自业界巨头的实践。从 Facebook 2014 年提出的GBDT+LR 组合模型引领特征工程模型化的方向,到2016 年微软提出 DeerCrossing 模型,谷歌发布 Wide&Deep 模型架构,以及 YouTube 公开其深度学习推荐系统,业界迎来了深度学习推荐系统应用的浪潮。时至今日,无论是阿里巴巴团队在商品推荐系统领域的持续创新,还是 Airbnb 在搜索推荐过程中对深度学习的前沿应用,深度学习己经成了推荐系统领域当之无愧的主流。
二、推荐系统业界实践
2.1、Facebook 的深度学习推荐系统
2014 年, Facebook 发表了广告推荐系统论文 Practical Lessons from Predicting Clicks on Ads at Fac book,提出 了经典的 GBDT+LR 的CTR 模型结 严格意义上讲, 这个模型结构不属于深度学习范畴,但在当时 ,利用 GBDT模型进行特征的自动组合和筛选,开启了特征工程模型化、自动化的新阶段那时起,诸如 Deep Crossing Embedding 等的深度学习手段被应用在特征工程上并逐渐过渡到全深度学习的网络 , 基于 GBDT+LR广告推荐系统成了连接传统机器学习推荐系统时代和深度学习推荐系统时代的桥梁.
2.1.1、GBDT+LR模型(2014年)
-
核心思想
-
结合传统机器学习与特征工程自动化,成为传统ML与深度学习间的桥梁。
- GBDT:自动完成特征组合与筛选,生成离散特征向量。
-
LR:接收GBDT输出特征,进行CTR预估,优化目标独立训练,无梯度回传问题。
-
-
关键优势
-
相比单一LR或GBDT,模型损失降低3%,提升显著。
- 工程实践:GBDT部分低频更新(数天一次),LR部分准实时更新,平衡实时性与复杂度。
-
-
数据流架构
- Online Data Joiner模块
实时整合曝光、点击数据,形成有标签样本。
- 技术细节:Waiting Window:设置合理时间窗(数十分钟)确保点击数据完整联结。负样本降采样:降低计算成本,通过权重校正保证预估无偏。
- Online Data Joiner模块
-
应用价值
开启了特征工程自动化、模型化趋势,推动后续Embedding、Deep Crossing等深度学习方法的应用。
2.1.2、DLRM模型(2019年)
2019 年, Facebook 又发布了最新的深度学习模型 DLRM[2j (Deep LearningRecommender Model) ,模型采用经典的深度学习模型架构,基于 CPU+GPU 的训练平台完成模型训练,是业界经典的深度学习推荐系统尝试.
-
模型结构
- 特征处理:
- 稀疏特征(如用户ID)通过Embedding映射为低维向量。
- 稠密特征(如年龄、收入)通过MLP转换并与Embedding统一维度。
- 特征交互:两两内积交叉,增强特征组合能力。
- 目标拟合:多层MLP融合交互结果,Sigmoid输出CTR。
- 特征处理:
-
训练策略
- 混合并行
- 模型并行
Embedding层参数分片存储,局部梯度更新。
- 数据并行
MLP层全量参数同步更新,AllReduce聚合梯度。
- 模型并行
- 硬件平台
基于Big Basin(CPU+GPU),优化计算效率。
- 混合并行
-
性能对比
-
与DCN(谷歌)对比,准确率略优(Adagrad优化下微幅提升)。
-
优势在于工程简洁性,适合海量数据场景下的快速落地。
-
-
工程启示
-
特征交互简单有效,无需复杂注意力机制。
-
模型设计以实用性为导向,强调工业可行性。
-
2.1.3、技术演进与核心经验
-
技术选型风格
- 务实主义
优先选择简单、可落地的模型(如GBDT+LR、DLRM),而非复杂创新。
- 工程优化
注重实时性(数据流架构)、训练效率(混合并行)、样本处理(降采样校正)。
- 务实主义
-
关键挑战与解决
- 数据实时性
通过Online Data Joiner实现准实时样本生成。
- 特征工程自动化
GBDT替代人工特征组合,DLRM进一步引入Embedding与交互层。
- 大规模训练
模型并行降低Embedding内存压力,数据并行加速MLP计算。
- 数据实时性
-
行业影响
-
GBDT+LR推动了特征工程模型化,DLRM成为深度学习推荐系统的标准实现之一。
-
技术思路(如特征交互、Embedding应用)被广泛借鉴,影响后续模型设计。
-
2.1.4、总结
Facebook的推荐系统技术演进体现了工程驱动与渐进式创新:
- GBDT+LR
通过自动化特征工程连接传统与深度学习时代。
- DLRM
标准化深度学习流程,平衡效果与计算效率。
- 核心经验
在海量数据场景下,简单模型+高效工程实现往往优于复杂算法。
3、Airbnb 基于 Embedding 的实时搜索推荐系统
2018年,Airbnb在KDD 上发表了论文 Real-time Personalization usingEmbeddings,for Search Ranking at Airbnb,并被评为当次会议的最佳论文。该义第一作者,Airbnb 的高级机器学习科学家 Mihailo 也在多个技术会议上分享过Airbnb 的搜索推荐系统。其中,Airbnb 对 Embedding 技术的应用尤为值得学习。
1.技术亮点:Airbnb利用Embedding技术,将用户和房源映射到同一向量空间,通过计算相似度实现个性化搜索推荐。系统结合短期和长期兴趣,生成多种Embedding特征,如点击、收藏、预订等相似度,为搜索排序模型提供丰富输入。
2.实时性与个性化:系统强调实时反馈,通过“最近点击房源相似度”等特征,使搜索结果能即时响应用户行为变化,提升用户体验。
3.数据稀疏性解决方案:针对预订数据稀疏问题,Airbnb通过聚合用户和房源属性(如国家、价格、设备类型等),生成新的预订序列,确保Embedding训练的有效性。
4.业务与算法结合:在Embedding训练中引入业务强相关的目标项(如预订信息),使算法改造与业务需求紧密结合,体现了工程实践与理论创新的平衡。
5.系统优势:该系统不仅提升了搜索结果的相关性和实时性,还为推荐系统在处理稀疏数据、融合多源信息等方面提供了有价值的实践经验,值得算法工程师学习借鉴。
4、YouTube 深度学习视频推荐系统
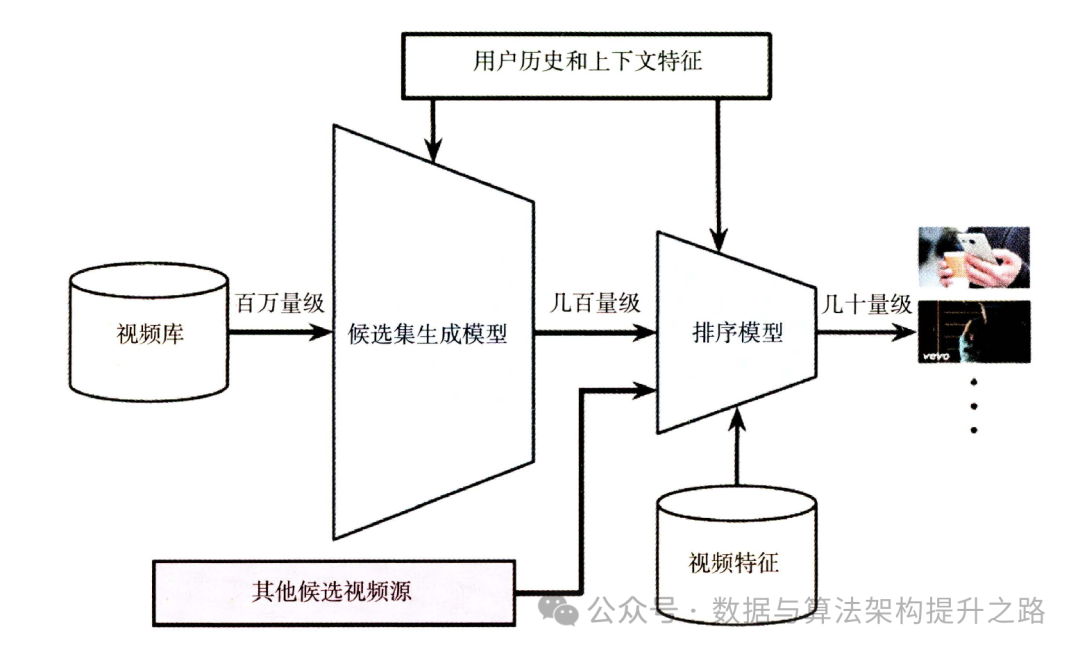
YouTube 视频基数巨大,这要求其推荐系统能在百万量级的视频规模下进行个性化推荐 考虑到在线系统的延迟问题,不宜用复杂网络直接对所有海量候选集进行排序,所以 YouTube 采用两级深度学习模型完成整个推荐过程(如图下所示)
-
候选生成模型:
-
使用用户观看历史、搜索词和视频内容的嵌入向量(Embedding)作为输入
-
包含用户地理位置、年龄、性别等人口统计学特征
-
采用ReLU激活函数的深度神经网络,输出层使用softmax
-
将问题视为多分类任务
-
-
模型服务:
-
为提高效率,使用最近邻搜索而非直接推断
-
视频嵌入向量从softmax层权重得出
-
用户嵌入向量来自最后一层ReLU的输出
-
-
排序模型:
-
使用更多特征对较小的候选集进行精细排序
-
特征包括当前视频嵌入、最近N个观看视频的平均嵌入、语言嵌入、上次观看同频道视频的时间间隔、曝光次数等
-
训练时使用加权逻辑回归,优化预期观看时长
-
服务时输出odds值(e^(Wx+b)),近似于每次曝光的预期观看时长
-
-
训练和测试:
-
使用负采样提高训练效率
-
每个用户提取等量样本,避免偏向高活跃用户
-
用最近N次观看作为测试集,避免引入未来信息
-
-
处理用户对新内容的偏好:
-
引入"Example Age"特征捕捉时间相关模式
-
帮助模型学习视频随时间的典型流行度曲线
-
-
工程实践:
-
YouTube推荐系统在特征工程和模型架构选择上主要考虑了效率、业务目标和数据特性。使用最近邻搜索提高服务效率,加权逻辑回归直接优化观看时长,引入特征捕捉时间相关模式。通过负采样和平衡样本处理数据偏差,在候选生成和排序阶段采用不同复杂度的模型以平衡效率和质量。
-
理解业务数据和用户行为对设计推荐系统非常重要
-
5、阿里巴巴深度学习推荐系统的进化

阿里巴巴深度学习推荐模型的进化过程
1.基础深度学习模型
基于经典的 Embedding+MLP 深度学习模型架构,将用户行为历史的Embedding 简单地通过加和池化操作叠加,再与其他用户特征、广告特征、场景特征连接后输入上层神经网络进行训练,模型结构如下图所示。

2.DIN 模型
利用注意力机制替换基础模型的 Sum Pooling操作,根据候选广告和用户历史行为之间的关系确定每个历史行为的权重,模型结构如下图所示。

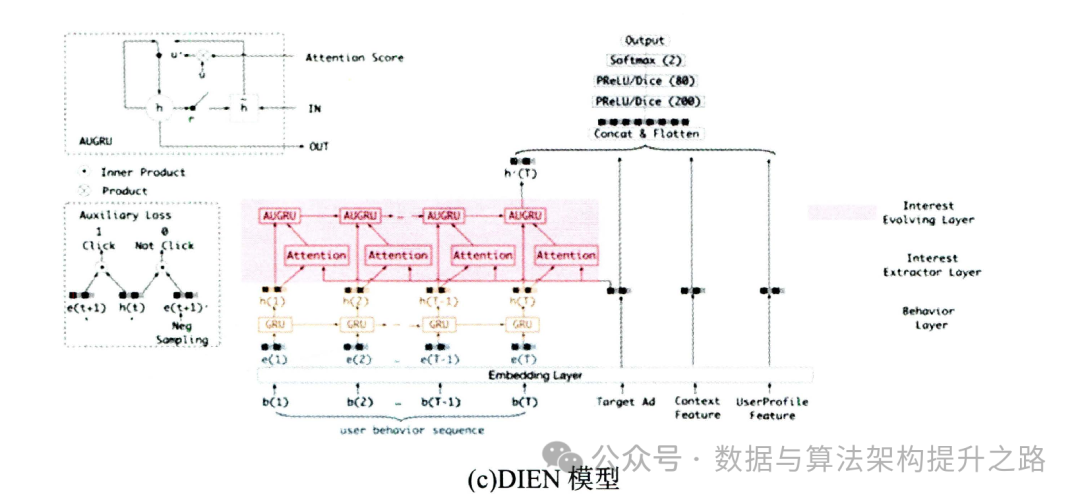
3.DIEN 模型
在 DIN 的基础上,进一步改进对用户行为历史的建模,使用序列模型在用户行为历史之上抽取用户兴趣并模拟用户兴趣的演化过程,模型结构如下图所示
4.MIMN 模型
在 DIEN 的基础上,将用户的兴趣细分为不同兴趣通道,进一步模拟用户在不同兴趣通道上的演化过程,生成不同兴趣通道的记忆向量,再利用注意力机制作用于多层神经网络,模型结构下图所示。
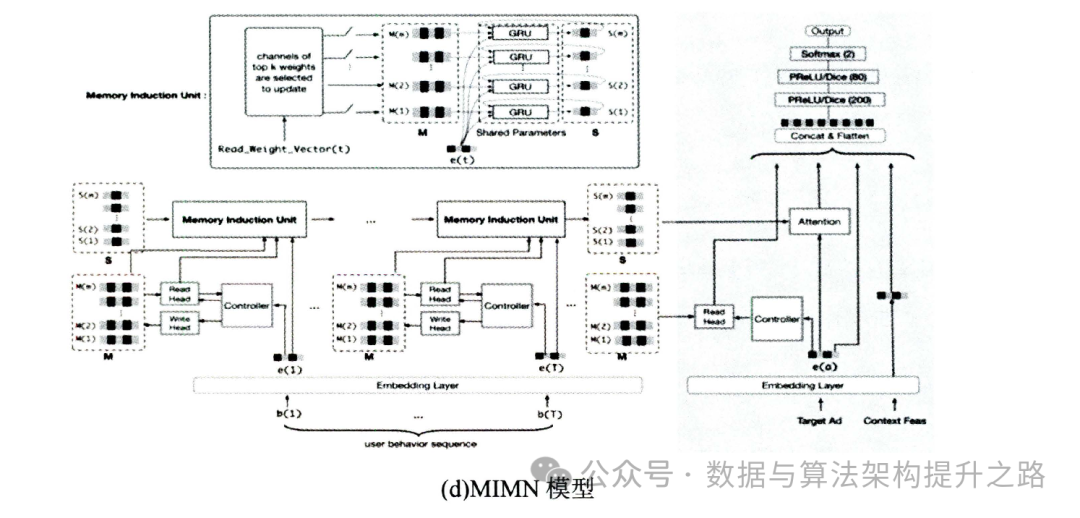
图 (a)是基础深度学习模型对待用户行为的办法,即一视同仁,不分重点:从图 (b)中可以看出,每个商品开始有了一个用进度条表示的权重,这个权重是基于该商品与候选商品的关系,通过注意力机制学习出来的。这就让模型具备了有重点地看待不同用户行为的能力;图 (c)中的用户行为有了时间维度行为历史按照时间轴被排列成了一个序列,DIEN 模型开始考虑用户行为和用户兴趣随时间变化的趋势,这让模型真正具备了下次购买的预测能力;图 (d)中的用户行为不仅被排成了序列,而且根据商品种类的不同被排列成了多个序列,这使得 MIMN 模型开始对用户多个“兴趣通道”进行建模,更精准地把握用户的兴趣变迁过程,避免不同兴趣之间相互干扰。
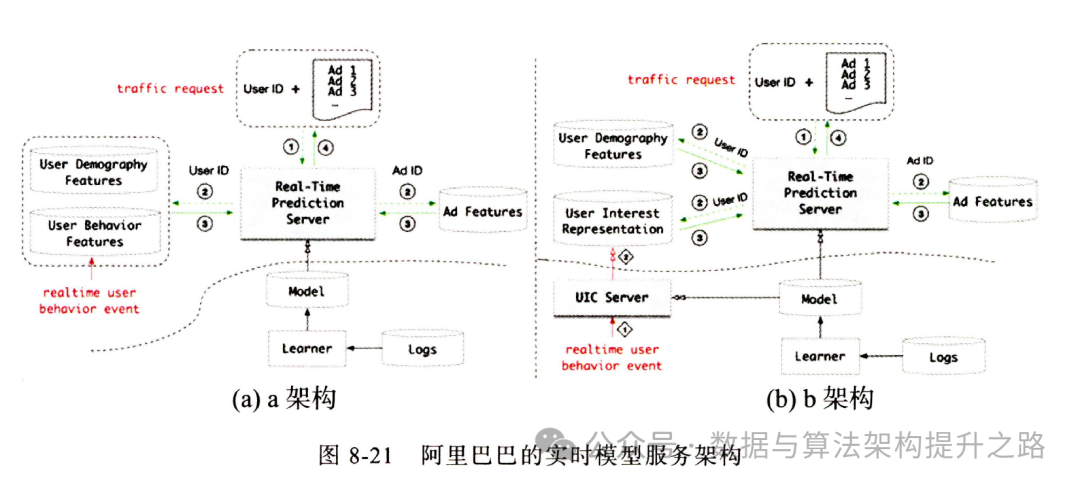
模型服务模块的技术架构
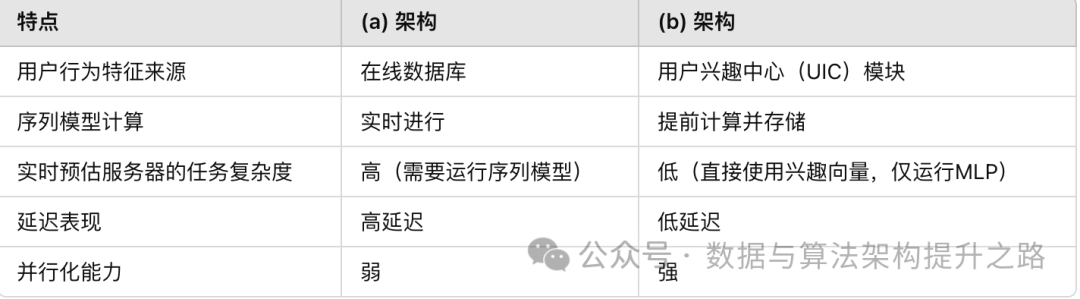
针对复杂模型,模型服务一直是业界的难点。使用一些近似的手段简化模型会让模型效果受损;端到端地将复杂模型搬到线上,使服务的延迟率居高不下影响用户体验。这一两难的问题同样困扰着阿里巴巴的工程师。对于 DIEN 和MIMN 这类带有序列结构的模型来说,这个问题尤为突出,因为模型中的序列结构意味着串行的推断过程,模型无法被并行加速,使得模型服务成了整个推荐过程的瓶颈。MIMN 的论文原文公开了相关的解决方案。
三、相关文章
更多推荐

 23
 0
- 0


 已为社区贡献4条内容

所有评论(0)