
数据结构与算法绪论
数据结构与算法绪论
数据结构与算法绪论
本部分主要解决以下几个问题:
- 什么是数据结构?
- 什么是算法?如何进行算法分析?
- 数据结构和算法之间具有怎样的关系?
1. 数据结构
1.1 数据的定义
- 数据(data)是描述客观事物的数值、字符等符号的总称,这些符号可以被计算机加工处理。
- 数据元素(data element)是数据的基本单位,在程序中作为一个整体处理。它可由一个或多个数据项(data item)构成,数据元素分为原子元素(不可再分)和结构元素。
- 数据对象(data object)是具有相同性质的数据元素的集合,是数据的一个子集。
1.2 数据结构的定义
数据结构是指具有特定关系的数据元素的集合,通常表示为一个二元组1:data_structure=(D,S)
- D 为数据元素的有限集。
- S 为在D上定义的关系的集合。
数据元素之间的关系称为结构(structure)。
数据结构包括数据元素的逻辑结构、存储结构和相适应的数据运算三个方面的内容。
1.2.1 逻辑结构
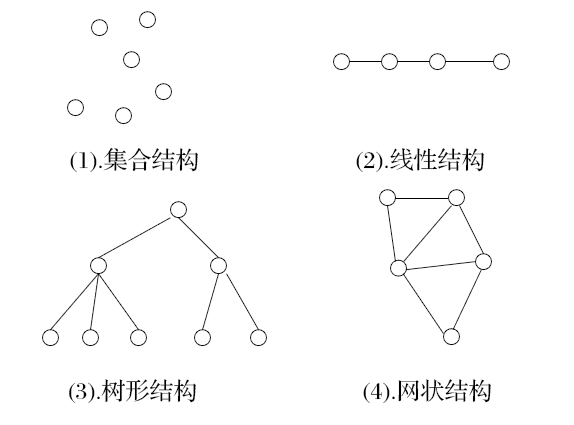
逻辑结构描述数据元素之间的逻辑关系,独立于计算机存储方式。逻辑结构主要分为:
- 集合结构:数据元素之间无直接关系。
- 线性结构:元素之间一对一的关系。
- 树形结构:元素之间一对多的关系。
- 图状结构:元素之间多对多的关系。
1.2.2 存储结构
存储结构指数据元素在计算机存储器中的表示方式(映像),包括:
- 顺序存储:元素在内存中连续存放,利用位置表示关系。
- 链式存储:使用指针表示元素之间的逻辑关系。
- 索引存储:通过索引表快速访问元素。
- 散列存储:通过散列函数确定存储位置。
一种逻辑结构可以有多种存储方式,如顺序和非顺序存储。
1.2.3 数据运算
数据运算是在数据逻辑结构上定义的操作,具体实现依赖于存储结构。常见的基本运算包括:
- 建立数据结构:创建和初始化数据结构。
- 检索数据元素:查找特定数据元素。
- 插入数据元素:指定位置插入数据元素。
- 删除数据元素:指定位置删除数据元素。
- 更新数据元素:修改结构中某指定位置元素的内容。
- 求长:计算数据元素个数。
- 读取运算:读取指定位置的元素。
- 排序运算:对数据进行排序。
1.3 数据类型
数据类型(data type)是一个值的集合及其上定义的操作集。
抽象数据类型(abstract data type)是数据类型概念的扩展,以数学模型和操作集合来定义。ADT可以表示为三元组:ADT=(D,R,P)
- D(Data):定义数据对象的集合和关系。
- 数据类型
- 数据属性
- 数据约束等
- R(Relationship):描述数据对象之间的逻辑关系和操作。
- 数据存取
- 数据修改
- 数据操作等
- P(Property):定义对数据对象的操作及其约束。
- 数据创建
- 数据销毁
- 数据查询
- 数据修改等
数据结构作为一种容器,可以封装对数据的增删改查等操作,提高代码的复用性和维护性。
2. 算法
2.1 算法定义
算法是解决问题或执行任务的一系列明确、有序的步骤集合。它提供了一个精确而抽象的计算过程指南,用以指导如何通过一系列操作从输入数据产生所需的输出结果。
算法具有以下关键特征:
- 明确性:每一步骤都必须清晰、精确地描述,避免歧义,确保任何人或机器都能理解和执行。
- 有限性:算法必须在有限的时间和空间内完成执行,即使面对大规模数据,也应能在有限时间内终止。
- 输入:算法接受零个或多个输入,这些输入可以是预定义的、用户提供的或从其他数据源获取的。
- 输出:算法产生一个或多个输出,根据问题的要求,这些输出可以是计算结果、修改后的数据或打印的信息等。
- 可行性:每个步骤都必须是可行的,即在有限的时间和资源内可以完成。
2.2 算法分析
算法分析旨在评估算法的效率,包括时间效率和空间效率:
- 时间效率:评估算法执行速度。
- 空间效率:评估算法在执行过程中所需的额外存储空间。
2.3 时间复杂度
2.3.1 渐近时间复杂度
渐近时间复杂度是一种分析方法,用于描述算法在输入规模趋于无穷大时的执行时间增长趋势,通常用大O符号(O)表示,代表算法在最坏情况下的时间复杂度。
下面给出O的形式化定义:
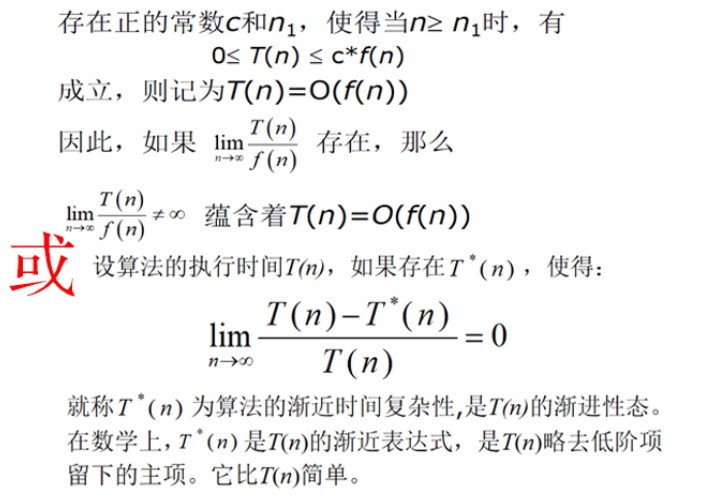
这个定义可以解释为:对于足够大的输入规模n,函数f(n)的增长速度不会超过函数g(n)的增长速度乘以一个常数c。这里的常数c可以理解为一个界限,表示函数f(n)的增长速度在最坏情况下不会超过函数g(n)的增长速度的c倍。
2.3.2 常见渐近时间复杂度
| 常见阶 | 非正式术语叫法 |
|---|---|
| O(1) | 常数阶 |
| O(n) | 线性阶 |
| O(n²) | 平方阶 |
| O(log₂n) | 对数阶 |
| O(nlog₂n) | 线性对数阶 |
| O(n³) | 立方阶 |
| O(2ⁿ) | 指数阶 |
| O(n!) | 阶乘阶 |
| O(n^k) | K次方阶 |
常用的时间复杂度所耗费的时间从小到大依次是:
O(1) < O(log n) < O(n) < O(nlog₂n) < O(n²) < O(n³) < O(2ⁿ) < O(n!) < O(nⁿ)
2.3.3 嵌套和并列
在分析算法时,常遇到嵌套和并列的情况:
- 嵌套时间复杂度(Nested Time Complexity):当一个算法的操作(如循环或递归)内包含另一个操作时,计算总时间复杂度时需要将内外操作的复杂度相乘:O(f(n) * g(n))
- 并列时间复杂度(Parallel Time Complexity):当算法的不同部分在同一层级并行执行时,取最耗时的部分作为总体复杂度:O(max(f(n), g(n)))
简而言之,嵌套时时间复杂度相乘,并列时取最大值。
2.3.4 实例分析
#include <stdio.h>

// O(1)
// 此函数演示常数时间复杂度,执行时间不随输入n的变化而变化
int constantTime(int n)
{
    int x = 5; // 常量
    int y = 10; // 常量
    int z = x + y; // 执行固定操作
    return z; // 返回结果
}

// O(n)
// 此函数演示线性时间复杂度,随着n的增大,执行时间呈线性增长
void linearTime(int n)
{
    for (int i = 0; i < n; i++) // 循环n次
    {
        printf("%d ", i); // 输出当前索引i
    }
    printf("\n"); // 输出换行
}

// O(log n)
// 此函数演示对数时间复杂度,每次迭代将问题规模减半
void logarithmicTime(int n)
{
    int i = 1;
    while (i < n) // 当i小于n时继续循环
    {
        printf("%d ", i); // 输出当前值i
        i *= 2; // 将i翻倍,逐步增大
    }
    printf("\n"); // 输出换行
}

// O(n^2)
// 此函数演示平方时间复杂度,嵌套循环导致执行时间随n的平方增长
void quadraticTime(int n)
{
    for (int i = 0; i < n; i++) // 外循环n次
    {
        for (int j = 0; j < n; j++) // 内循环n次
        {
            printf("%d ", i + j); // 输出i与j的和
        }
    }
    printf("\n"); // 输出换行
}

// O(2^n)
// 此函数演示指数时间复杂度,递归调用的数量随n的增加而急剧增加
int exponentialTime(int n)
{
    if (n <= 1) // 基础情况
    {
        return n; // 返回n本身
    }
    else
    {
        // 递归调用,计算前两个Fibonacci数
        return exponentialTime(n - 1) + exponentialTime(n - 2);
    }
}

int main()
{
    int n = 5; // 示例输入值
    printf("Constant Time: %d\n", constantTime(n));
    printf("Linear Time: ");
    linearTime(n);
    printf("Logarithmic Time: ");
    logarithmicTime(n);
    printf("Quadratic Time: ");
    quadraticTime(n);
    printf("Exponential Time: %d\n", exponentialTime(n)); // 注意:对于较大的n,输出可能会很慢
    return 0;
}
2.4 空间复杂度
空间复杂度是衡量算法在执行过程中所需的额外存储空间的指标。它描述了算法所需的存储空间量如何随输入规模的增长而变化。空间复杂度的计算方法与时间复杂度相似,也使用大O符号进行渐进表示。
影响空间复杂度的主要因素有以下三点:
-
输入输出数据所占用的存储空间:包括函数参数和返回值所需的空间。
-
存储算法本身所占用的存储空间:这包括算法代码的长度和可能存在的静态数据结构。
-
算法执行过程中临时占用的存储空间:这指的是在算法运行期间为了完成计算而临时使用的额外内存。
常见的空间复杂度级别与时间复杂度相同,如下所示:
| 复杂度阶 | 非正式名称 |
|---|---|
| O(1) | 常数空间 |
| O(n) | 线性空间 |
| O(n²) | 平方空间 |
| O(log₂n) | 对数空间 |
| O(nlog₂n) | 线性对数空间 |
| O(n³) | 立方空间 |
| O(2^n) | 指数空间 |
| O(n!) | 阶乘空间 |
| O(n^k) | k次方空间 |
在分析空间复杂度时,值得注意的是:
- 常数空间(O(1)):无论输入规模如何,算法使用固定的额外空间。
- 线性空间(O(n)):额外空间随输入规模线性增长。
- 对数空间(O(log n)):这种情况通常出现在使用递归或一些特定的数据结构如平衡树时。
- 线性对数空间(O(nlog n)):常见于一些排序算法,如归并排序。
- 更高阶的空间复杂度在实际应用中较少见,但对于极端情况或特定的问题可能出现。
算法在设计时,应尽量优化空间使用,避免不必要的内存占用,尤其是对于大规模数据处理或资源受限的环境中,空间效率显得尤为重要。
2.4.1 实例分析
#include <stdio.h>
#include <stdlib.h>  // 为malloc和free函数添加头文件

// O(1)
// 此函数演示常数空间复杂度,不使用额外的空间
void print()
{
    printf("O(1)\n"); // 打印时间复杂度
}

// O(n)
// 此函数演示线性空间复杂度,存储了输入数组的所有元素
int sum_arr(int arr[], int n)
{
    int sum = 0; // 存储总和的变量,占用O(1)空间
    for (int i = 0; i < n; i++)
    {
        sum += arr[i]; // 累加数组中的元素
    }
    return sum; // 返回总和
}

// O(log n)
// 此函数演示对数空间复杂度,递归调用栈的深度为log(n)
int binarySearch(int arr[], int low, int high, int target)
{
    if (low > high)
        return -1; // 如果未找到,返回-1
    int mid = (low + high) / 2; // 计算中间索引
    if (arr[mid] == target)
        return mid; // 找到目标值,返回索引
    else if (arr[mid] > target)
        return binarySearch(arr, low, mid - 1, target); // 在左半边继续搜索
    else
        return binarySearch(arr, mid + 1, high, target); // 在右半边继续搜索
}

// O(n^2)
// 此函数演示平方空间复杂度,假设矩阵是动态分配的
void print_matrix(int **matrix, int rows, int cols)
{
    for (int i = 0; i < rows; i++)
    {
        for (int j = 0; j < cols; j++)
        {
            printf("%d ", matrix[i][j]); // 输出矩阵元素
        }
        printf("\n"); // 输出换行
    }
}

int main()
{
    // 示例代码,演示不同函数的调用

    // 示例:常数空间复杂度
    print();

    // 示例:线性空间复杂度
    int arr[] = {1, 2, 3, 4, 5};
    int n = sizeof(arr) / sizeof(arr[0]);
    printf("Sum of array: %d\n", sum_arr(arr, n));

    // 示例:对数空间复杂度
    int sortedArr[] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
    int target = 5;
    int index = binarySearch(sortedArr, 0, n - 1, target);
    if (index != -1)
    {
        printf("Element %d found at index: %d\n", target, index);
    }
    else
    {
        printf("Element not found.\n");
    }

    // 示例:平方空间复杂度(动态分配矩阵)
    int rows = 3, cols = 3;
    int **matrix = (int **)malloc(rows * sizeof(int *)); // 分配行指针数组
    for (int i = 0; i < rows; i++)
    {
        matrix[i] = (int *)malloc(cols * sizeof(int)); // 为每一行分配列
        for (int j = 0; j < cols; j++)
        {
            matrix[i][j] = i + j; // 填充矩阵
        }
    }
    printf("Matrix:\n");
    print_matrix(matrix, rows, cols); // 打印矩阵

    // 释放动态分配的内存
    for (int i = 0; i < rows; i++)
    {
        free(matrix[i]); // 释放每一行
    }
    free(matrix); // 释放行指针数组

    return 0;
}
2.5 排序算法复杂度分析
下表展示了常见排序算法的时间和空间复杂度分析:
| 排序算法 | 最优时间复杂度 | 平均时间复杂度 | 最差时间复杂度 | 空间复杂度 | 稳定性 |
|---|---|---|---|---|---|
| 冒泡排序 | O(n) | O(n²) | O(n²) | O(1) | 稳定 |
| 选择排序 | O(n²) | O(n²) | O(n²) | O(1) | 不稳定 |
| 插入排序 | O(n) | O(n²) | O(n²) | O(1) | 稳定 |
| 希尔排序 | O(n log n) | O(n^(3/2)) 至 O(n log² n) | O(n²) | O(1) | 不稳定 |
| 归并排序 | O(n log n) | O(n log n) | O(n log n) | O(n) | 稳定 |
| 快速排序 | O(n log n) | O(n log n) | O(n²) | O(log n) | 不稳定 |
| 堆排序 | O(n log n) | O(n log n) | O(n log n) | O(1) | 不稳定 |
| 计数排序 | O(n + k) | O(n + k) | O(n + k) | O(k) | 稳定 |
| 桶排序 | O(n + k) | O(n + k) | O(n²) | O(n+k) | 稳定 |
| 基数排序 | O(nk) | O(nk) | O(nk) | O(n + k) | 稳定 |
说明:
- n 是待排序元素的数量
- k 是输入数据范围内的整数值的数量(对于计数排序、桶排序和基数排序)
- 时间复杂度表示算法在最好、平均和最坏情况下的运行时间
- 空间复杂度表示算法在执行过程中所需的额外存储空间
- 稳定性指的是在排序后,相等元素的相对顺序是否保持不变;稳定的排序算法能够保证相等的元素在排序前后的相对位置不变,不稳定的排序算法则可能改变这种相对位置
3. 数据结构与算法的关系
数据结构和算法是计算机科学中密不可分的两个概念,它们之间存在着紧密的关联和相互依赖的关系。
3.1 相互依存关系
-
算法依赖于数据结构:算法的设计和实现往往依赖于特定的数据结构。选择合适的数据结构可以使算法更加高效、简洁。例如,广度优先搜索算法通常依赖队列结构,深度优先搜索则依赖栈结构。
-
数据结构服务于算法:数据结构是为了更好地组织和存储数据,以便算法能够高效地处理这些数据。不同的数据结构支持不同类型的操作,这些操作的效率直接影响算法的整体性能。
-
相辅相成的设计:在解决实际问题时,数据结构和算法的选择往往是相互影响的。一个好的解决方案通常需要同时考虑两者,以达到时间和空间效率的平衡。
3.2 效率互补性
-
时间与空间的权衡:某些数据结构(如哈希表)可以提供O(1)的查找时间,但需要额外的空间开销;而其他结构(如二叉搜索树)可能在空间上更为紧凑,但操作时间可能为O(log n)。
-
不同应用场景的选择:根据具体问题的需求,可能需要优先考虑时间效率或空间效率,从而选择不同的数据结构和算法组合。
3.3 实例说明
-
排序算法与数据结构:
- 快速排序在链表上实现复杂,但在数组上效率高
- 归并排序适用于链表,空间复杂度较高
- 堆排序依赖于堆这一特殊的数据结构
-
搜索算法与数据结构:
- 二分查找需要有序数组
- 图的遍历算法(DFS、BFS)分别依赖于栈和队列
- 哈希查找依赖于哈希表结构
-
数据库索引设计:
- B树和B+树作为数据结构,支持高效的数据库索引查询算法
- 红黑树用于实现高效的自平衡搜索
3.4 设计准则
在实际应用中,数据结构与算法的选择应遵循以下准则:
-
问题导向:首先理解问题的本质和需求,然后选择合适的数据结构和算法。
-
操作频率考量:分析哪些操作(如查找、插入、删除)会频繁执行,选择在这些操作上表现最佳的数据结构。
-
数据规模评估:考虑数据量的大小和增长趋势,选择能够扩展的解决方案。
-
环境约束:考虑运行环境的限制,如内存大小、处理器性能等。
通过合理地选择和组合数据结构与算法,可以开发出既高效又可靠的软件系统。在计算机科学的学习和应用中,深入理解两者之间的关系是非常重要的。
二元组是数学中的一个概念,表示由两个元素组成的有序对。它是集合论和数理逻辑中的基本概念,常用于描述和表示两个对象之间的关系或组合。 ↩︎
更多推荐
 33
 0
- 0


 已为社区贡献5条内容

所有评论(0)