
全面数据结构练习题集

简介:数据结构是计算机科学的核心,涵盖了数据存储、检索和操作的高效方法。本压缩包含的习题集是学习和复习数据结构的重要资源,能够帮助提升对各类数据结构的理解并应对相关考试。习题内容包括基础数据结构如数组、链表、栈、队列、树、图和散列表,以及排序和查找算法。通过这些习题,学生可以深入掌握数据结构的操作和应用,并分析算法的时间与空间复杂度,从而提升编程和解决问题的能力。 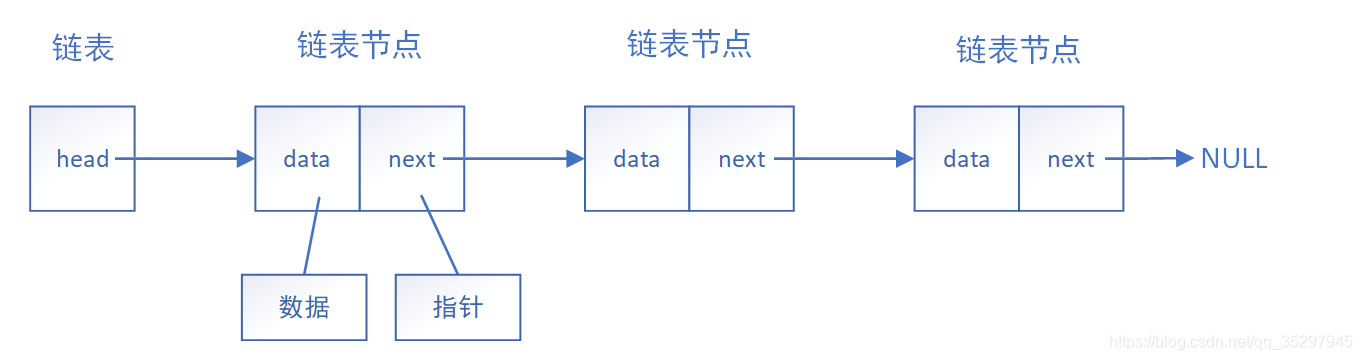
1. 数据结构基本概念和重要性
在信息技术领域,数据结构是支撑软件构造的基础之一,它们像是构建高楼大厦的砖块和钢筋,决定了程序的性能和效率。数据结构不仅包括数据的组织方式,也涵盖了如何高效地对数据执行各种操作,例如搜索、排序、插入和删除等。
1.1 数据结构的定义
数据结构可以被定义为一种特定方式存储和组织数据的集合,以便于访问和修改。在计算机科学中,数据结构允许程序员以有意义的方式,对大量的信息进行排序和分类。
1.2 数据结构的分类
数据结构主要分为两大类:线性结构和非线性结构。线性结构包括数组、链表、栈、队列等,它们在逻辑上可以表示为一连串的元素。非线性结构如树和图,更适合表示复杂的层次关系和网状关系。
1.3 数据结构的重要性
了解和应用合适的数据结构对于任何软件开发项目至关重要。正确的数据结构选择可以显著减少程序的运行时间,降低内存使用,并使程序设计更加灵活和高效。
在实际应用中,数据结构影响着软件的整体架构和性能,例如,在搜索引擎中运用树型数据结构来快速查找和排序信息,在网络通信中使用图结构来处理路由选择等。因此,数据结构是IT专业人士必须熟练掌握的核心概念之一。
2. ```
第二章:数组的定义和操作
2.1 数组的定义和基本操作
数组是一种线性数据结构,它包含一系列相同类型的数据项。数组中的每个数据项可以通过索引(通常从0开始)直接访问。数组提供了一种高效的访问数据的方式,但是其大小在初始化后不能改变。
2.1.1 数组的概念和特性
数组是最基本的数据结构之一,其主要特点包括:
- 类型一致性 :数组中的所有数据项类型必须相同。
- 随机访问 :可以实现常数时间复杂度的元素访问。
- 固定大小 :数组一旦创建,其大小就固定了,不能动态调整。
- 连续存储 :数组在内存中的存储是连续的,这使得CPU缓存可以有效地预取数据。
2.1.2 数组的初始化和声明
在大多数编程语言中,数组可以通过指定类型和大小来初始化。例如,在C语言中:
int numbers[10]; // 声明一个整型数组,大小为10
在Java中:
int[] numbers = new int[10]; // 声明并初始化一个整型数组,大小为10
2.1.3 数组元素的访问和赋值
数组的元素可以通过索引来访问或修改。以下示例展示了如何在Java中访问和赋值数组元素:
int[] numbers = new int[10];
numbers[0] = 1; // 将索引为0的元素赋值为1
int value = numbers[0]; // 访问索引为0的元素,并将值存储在变量value中
2.2 数组的高级操作
在实际编程中,数组的操作不仅限于基本的访问和赋值,还涉及到更复杂的数据处理。
2.2.1 多维数组的应用
多维数组是一种数组的数组,可以用来表示表格或其他具有行和列的数据结构。以下是在Java中声明和初始化一个二维数组的例子:
int[][] matrix = new int[3][4]; // 声明一个3行4列的二维数组
2.2.2 数组的排序和搜索算法
为了对数组中的元素进行排序,可以使用各种排序算法,如冒泡排序、快速排序或归并排序等。同时,数组也可以实现搜索算法,如线性搜索或二分搜索。二分搜索算法要求数组是有序的,并且可以有效地减少搜索时间复杂度。
2.2.3 数组的应用案例分析
数组在各种应用中扮演着重要角色。例如,在图像处理中,每个像素可以用一个二维数组表示,而在数据库管理系统中,数据记录可以用多维数组进行存储和管理。
在接下来的章节中,我们将深入探索数组的高级操作,并结合实例详细讨论多维数组的应用、排序和搜索算法的实际应用案例。
# 3. 链表的定义、类型和操作

链表作为一种灵活的数据结构,其核心思想在于通过指针链接数据元素,而非像数组那样在连续的内存空间存储数据。其结构允许动态的内存分配,提供高效的插入和删除操作。本章节将深入探讨链表的定义、类型、以及如何在各种场景下进行操作。

## 3.1 链表的基本概念

### 3.1.1 链表的定义和特点
链表是一种通过指针将一系列节点连接起来的线性数据结构,每个节点包含两部分:数据域和指向下一个节点的指针域。其核心优势在于:

- **动态内存分配**:链表可以灵活地进行大小调整。
- **高效的插入和删除**:在链表中插入和删除节点时,仅需要修改相关节点的指针,而不需要移动大量数据。

链表的这些特点使其成为处理不确定数据量和频繁变动数据的理想选择。然而,链表访问元素时需要从头节点开始遍历,所以它的访问时间复杂度是O(n),对于非首尾节点的查找需要依次通过每一个节点,效率较低。

### 3.1.2 单向链表的实现和操作
单向链表是最基础的链表类型,每个节点只有指向前一个节点的指针。以下是一个简单的单向链表节点的实现:

```python
class Node:
    def __init__(self, data):
        self.data = data  # 数据域
        self.next = None  # 指针域

class LinkedList:
    def __init__(self):
        self.head = None  # 链表的头节点

    def append(self, data):
        if not self.head:
            self.head = Node(data)
        else:
            current = self.head
            while current.next:
                current = current.next
            current.next = Node(data)
3.2 链表的高级类型和操作
3.2.1 双向链表和循环链表的特点与应用
除了单向链表外,还有其他类型的链表:
- 双向链表 :每个节点有两个指针,分别指向前一个节点和后一个节点。
- 循环链表 :最后一个节点指向链表的头节点,形成一个环。
双向链表适用于需要频繁进行插入和删除操作,特别是在链表中间位置进行操作的场景。循环链表则常用于实现如约瑟夫问题这样的循环结构问题。
3.2.2 链表的动态内存管理
在链表操作过程中,动态内存管理是一个重要的环节。当链表的节点被删除时,应确保及时释放内存以避免内存泄漏。这可以通过使用 del 语句或 free() 函数来实现,具体取决于编程语言。
3.2.3 链表的应用实例
链表广泛应用于各种场景,包括但不限于:
- 操作系统的内存管理 :空闲内存块通常被组织为链表。
- 浏览器的后退功能 :浏览器使用链表存储历史页面的地址,实现后退功能。
通过本章节的深入讨论,我们认识到了链表的多样性和复杂性。下一章节,我们将继续探讨栈和队列这两种特殊的线性数据结构。
4. 栈和队列的概念、操作和应用
4.1 栈的概念和操作
4.1.1 栈的定义和基本性质
栈是一种后进先出(Last In First Out, LIFO)的数据结构,它允许仅在栈顶进行插入和删除操作。也就是说,在任何时刻,只有最近一次添加的元素才是可访问的。这一特性使得栈在处理数据时非常高效,尤其适用于需要临时保存数据的场景,如函数调用的管理、括号匹配等。
栈的操作主要包含两个基本动作: - push :在栈顶添加一个元素。 - pop :移除并返回栈顶元素。 - peek 或 top :返回栈顶元素但不移除它。
在编程实现上,栈可以使用数组或链表这两种数据结构来完成。不过,在数组上实现栈时要注意固定大小可能导致的溢出问题。而链表实现栈则相对灵活,易于动态扩展。
4.1.2 栈的实现方法和操作过程
为了更好地理解栈的工作原理,我们以数组作为基础来实现一个简单的栈结构。以下是一个栈的类定义和基本操作方法的伪代码示例:
class Stack:
    def __init__(self):
        self.array = []
        self.count = 0
        self.capacity = 10

    def push(self, item):
        if self.count == self.capacity:
            self._resize(2 * self.capacity)
        self.array.append(item)
        self.count += 1

    def pop(self):
        if self.count == 0:
            raise IndexError("Pop from an empty stack")
        item = self.array.pop()
        self.count -= 1
        return item

    def peek(self):
        if self.count == 0:
            raise IndexError("Peek from an empty stack")
        return self.array[-1]

    def _resize(self, new_capacity):
        self.capacity = new_capacity
        new_array = [None] * self.capacity
        for i in range(self.count):
            new_array[i] = self.array[i]
        self.array = new_array
在这个示例中, Stack 类包含一个数组 array 用于存储栈内元素, count 用于追踪栈顶元素位置,以及 capacity 表示栈的容量。 push 方法添加元素到栈顶, pop 方法移除栈顶元素并返回它, peek 方法返回栈顶元素而不移除。
4.1.3 栈的典型应用案例
- 函数调用栈 :在大多数编程语言中,函数调用机制是通过栈实现的。每次函数调用都会生成一个帧(frame)压入调用栈,返回时帧被弹出。
- 括号匹配检查 :栈可以用来检查一段代码中的括号是否正确匹配。每当遇到一个开括号('(' 或 '{' 或 '['),就将其推入栈中;每当遇到一个闭括号,就从栈中弹出一个开括号并验证两者是否匹配。
- 表达式求值 :使用栈可以实现各种表达式的求值,如后缀表达式(逆波兰表示法)和中缀表达式的相互转换。
4.2 队列的概念和操作
4.2.1 队列的基本定义和性质
队列是一种先进先出(First In First Out, FIFO)的数据结构,与栈相反,在队列中,元素的添加发生在尾部,元素的移除发生在头部。队列的操作主要有以下两个: - enqueue :在队列尾部添加一个元素。 - dequeue :移除并返回队列头部元素。
队列的实现同样可以使用数组或链表,各有优劣。数组实现的队列有固定的容量限制,需要处理数组满时的情况。链表实现的队列则没有容量限制,但会消耗更多的内存资源。
4.2.2 队列的实现和基本操作
让我们也以数组为基础来实现一个简单的队列结构,并提供基本操作方法:
class Queue:
    def __init__(self):
        self.array = []
        self.front = 0
        self.rear = -1
        self.size = 0

    def enqueue(self, item):
        if self.size == len(self.array):
            self._resize(2 * len(self.array))
        self.rear = (self.rear + 1) % len(self.array)
        self.array[self.rear] = item
        self.size += 1

    def dequeue(self):
        if self.size == 0:
            raise IndexError("Dequeue from an empty queue")
        item = self.array[self.front]
        self.front = (self.front + 1) % len(self.array)
        self.size -= 1
        return item

    def _resize(self, new_size):
        new_array = [None] * new_size
        for i in range(self.size):
            new_array[i] = self.array[(self.front + i) % len(self.array)]
        self.array = new_array
        self.front = 0
        self.rear = self.size - 1
在这个示例中, Queue 类使用数组 array 存储队列元素, front 和 rear 分别指向队列头部和尾部, size 用于记录队列中元素的数量。 enqueue 方法将新元素添加到队列尾部, dequeue 方法从队列头部移除元素。
4.2.3 队列的应用实例和分析
- 任务调度 :操作系统中使用队列来调度执行任务,确保任务按照请求的顺序得到处理。
- 缓冲区管理 :在硬件设备中,缓冲区通常用队列来管理,保证数据按照到达顺序进行处理。
- 打印任务队列 :打印机中的打印任务通常以队列的形式存储,从而确保文档按照提交顺序打印。
在本节中,我们深入了解了栈和队列的基本概念、操作方法和典型应用场景。通过适当的实践和应用,可以有效利用这两种数据结构来解决实际问题。下一节我们将继续探讨链表、树和图等复杂数据结构。
5. ```
第五章:树的结构、类型和操作
树是一种非线性的数据结构,它模拟了一种层次关系,广泛应用于数据存储和检索系统中。在计算机科学中,树结构被用来模拟具有层级特性的数据组织,如文件系统的目录结构、数据库索引和HTML文档结构等。本章将深入探讨树的基本概念、类型和操作。
5.1 树的基本概念
5.1.1 树的定义和相关术语
树是由节点(Node)和边(Edge)组成的数据结构,其中节点可以有零个或多个子节点。在树结构中,只有一个特定的节点称为根节点(Root)。根节点没有父节点,但可以有任意数量的子节点。除根节点外,每个节点有且只有一个父节点。树的节点层级由根节点开始定义,最底层的节点被称为叶子节点(Leaf)。
术语总结如下:
- 节点(Node):树中的一个元素,包含数据部分和指向子节点的指针(可能还有指向父节点的指针)。
- 边(Edge):节点之间的连接线,表示父子关系。
- 根节点(Root):没有父节点的最顶层节点。
- 子节点(Child):与父节点直接相连的下一层节点。
- 叶子节点(Leaf):没有子节点的节点。
- 路径(Path):从一个节点到另一个节点的节点序列,路径长度等于序列中边的数量。
- 子树(Subtree):任何一个节点及该节点以下的所有节点。
5.1.2 树的基本操作和遍历算法
树的基本操作通常包括节点的创建、销毁、插入和删除等。树的遍历是树操作中重要的环节,它可以分为深度优先遍历(DFS)和广度优先遍历(BFS)。
- 深度优先遍历(DFS):沿着树的深度遍历树的节点,尽可能深地搜索树的分支。常见的DFS实现方式有递归和非递归(使用栈)。
- 广度优先遍历(BFS):按层次从上到下,从左到右遍历树的所有节点。BFS实现通常使用队列来完成。
代码块 - 树节点定义
下面是一个简单的树节点定义的代码示例,包含了节点的基本结构:
class TreeNode:
    def __init__(self, value):
        self.value = value  # 数据部分
        self.children = []  # 子节点列表
    def add_child(self, child_node):
        self.children.append(child_node)

# 实例化节点
root = TreeNode('root')
child1 = TreeNode('child1')
child2 = TreeNode('child2')
root.add_child(child1)
root.add_child(child2)
在上面的代码中,我们定义了一个TreeNode类来表示树的节点。每个节点包含一个值和一个子节点列表。通过add_child方法可以向节点添加子节点。
代码块 - 深度优先遍历(递归实现)
深度优先遍历的一种典型实现方法是递归:
def dfs(node):
    # 处理当前节点
    print(node.value)
    # 递归遍历子节点
    for child in node.children:
        dfs(child)

# 调用函数
dfs(root)
在这个递归实现中,我们首先处理当前节点,然后递归地对每一个子节点进行深度优先遍历。
表格 - 树节点操作比较
| 操作类型 | 描述 | 实现方法 | | --- | --- | --- | | 创建节点 | 创建一个带有特定值的树节点 | TreeNode(value) | | 插入子节点 | 将一个新节点添加为指定节点的子节点 | node.add_child(new_node) | | 深度优先遍历 | 从根节点开始,沿着树的深度遍历所有节点 | dfs(node) | | 广度优先遍历 | 从根节点开始,逐层从上到下遍历所有节点 | bfs(node) |
5.2 树的高级类型和应用
5.2.1 二叉树和二叉搜索树的特性
二叉树是每个节点最多有两个子节点的树,分别为左子节点和右子节点。二叉树的遍历算法包括前序遍历(根-左-右)、中序遍历(左-根-右)和后序遍历(左-右-根)。
二叉搜索树(BST)是一种特殊的二叉树,它具有以下性质: - 节点的左子树只包含小于当前节点的数。 - 节点的右子树只包含大于当前节点的数。 - 左右子树也必须分别是二叉搜索树。
在二叉搜索树中,查找、插入和删除操作的效率非常高,平均时间复杂度为O(log n)。
5.2.2 平衡树和AVL树的特点
平衡树是一种特殊的二叉搜索树,它保证了树的任何两个子树的高度差不超过1,从而保持了树的平衡,使得操作的效率稳定。AVL树是最早被发明的自平衡二叉搜索树之一,它通过在每个节点上维护平衡因子(左右子树的高度差)来保持树的平衡。
在AVL树中,每当进行插入或删除操作,可能需要通过旋转来重新平衡树。树的旋转操作包括单旋转和双旋转,用于调整树的平衡性。
5.2.3 树的应用场景和实例
树结构广泛应用于各种实际场景中,以下是一些典型的例子:
- 文件系统的目录结构 :在操作系统中,文件系统通常以树状结构来组织文件和目录。
- 数据库索引 :数据库索引常用B树或B+树来存储,它们都是平衡树,能够提供高效的查找和更新操作。
- HTML DOM结构 :在网页中,HTML元素构成的DOM树是树结构的典型应用,用于文档的布局和事件处理。
graph TD
    A[Root] -->|left| B[Child1]
    A -->|right| C[Child2]
    B -->|left| D[Grandchild1]
    B -->|right| E[Grandchild2]
    C -->|left| F[Grandchild3]
在本章节中,我们详细讨论了树的基本概念、类型和操作。通过代码块和表格,我们深入了解了树节点的定义和遍历算法。同时,我们探索了高级树类型如二叉搜索树和AVL树,并通过实际应用案例展示了树结构的多样性。这些知识为进一步学习更复杂的树结构和相关算法打下了坚实的基础。
# 6. 图的概念、分类和应用

图是数据结构中用来表达实体间复杂关系的一种重要模型。不同于线性数据结构,图由一组顶点(节点)以及连接这些顶点的边组成。图广泛应用于社交网络分析、网络路由、地图导航、资源分配以及图数据库等领域。

## 6.1 图的基本概念和分类

### 6.1.1 图的定义和表示方法

图(Graph)由顶点(Vertex)的非空集合V和边(Edge)的集合E组成,可以表示为G=(V, E)。在无向图中,边是由两个顶点组成的无序对,表示顶点之间无方向性的连接关系;而在有向图中,边则由顶点对组成的有序对来表示,表示从一个顶点到另一个顶点的有方向的连接关系。

图可以通过邻接矩阵或邻接表来表示。邻接矩阵是一个二维数组,其大小为顶点数的平方,其中的元素用来表示顶点之间的连接关系。邻接表则利用链表或数组来存储与每个顶点相邻的顶点,适用于稀疏图的表示。

### 6.1.2 图的基本术语和分类

图的基本术语包括:

- 度(Degree):对于无向图中的顶点,其度是与该顶点相连的边的数量。对于有向图,有入度(进入顶点的边数)和出度(从顶点出去的边数)之分。
- 路径(Path):顶点的一个序列,其中每对相邻顶点之间都由边相连。
- 环(Cycle):图中的一个环是指路径的起始顶点和终止顶点是相同的,并且路径上除了第一个顶点外没有重复顶点或边。
- 连通图(Connected Graph):在无向图中,如果任意两个顶点都连通,则称该图为连通图。
- 强连通分量(Strongly Connected Component, SCC):在有向图中,如果两个顶点相互可达(即可以从任一顶点出发到达另一顶点),则它们属于同一个强连通分量。
- 有向无环图(Directed Acyclic Graph, DAG):不包含任何环的有向图。

## 6.2 图的算法和应用

### 6.2.1 图的遍历算法(深度优先搜索和广度优先搜索)

图的遍历算法包括深度优先搜索(DFS)和广度优先搜索(BFS),它们用于访问图中的所有顶点。

- 深度优先搜索(DFS)使用递归或栈来进行回溯,探索尽可能深的路径。
- 广度优先搜索(BFS)则从一个顶点开始,访问所有与该顶点相邻的顶点,然后依次访问这些顶点相邻的未访问顶点。

这两种算法的伪代码如下:

```plaintext
// DFS 伪代码
DFS(v):
  visited[v] = true
  for each vertex u that is adjacent to v:
    if not visited[u]:
      DFS(u)

// BFS 伪代码
BFS(v):
  queue = empty queue
  visited[v] = true
  queue.enqueue(v)
  while queue is not empty:
    v = queue.dequeue()
    for each vertex u that is adjacent to v:
      if not visited[u]:
        visited[u] = true
        queue.enqueue(u)
6.2.2 最短路径和最小生成树算法
- 最短路径算法用于在加权图中找出两顶点间的最短路径。迪杰斯特拉(Dijkstra)算法和贝尔曼-福特(Bellman-Ford)算法是两种常见的最短路径算法。
- 最小生成树算法用于找出连接图中所有顶点的边的集合,使得总权重最小。普里姆(Prim)算法和克鲁斯卡尔(Kruskal)算法可以用来构造最小生成树。
6.2.3 图的应用实例和案例分析
图的应用例子包括社交网络中的朋友关系,搜索引擎中的页面排名(PageRank算法),以及计算机网络中的路由算法。
例如,在社交网络中,每个用户可以看作是一个顶点,而用户之间的朋友关系可以表示为边。利用图的算法,可以找到社交圈子中的关键人物(即高影响力节点),分析社区结构,甚至预测可能的流行趋势。
通过图结构和算法的应用,我们能够处理并解决现实世界中的复杂问题,从简单的数据关系到庞大网络系统中的信息传递,图的数据结构都发挥着至关重要的作用。
简介:数据结构是计算机科学的核心,涵盖了数据存储、检索和操作的高效方法。本压缩包含的习题集是学习和复习数据结构的重要资源,能够帮助提升对各类数据结构的理解并应对相关考试。习题内容包括基础数据结构如数组、链表、栈、队列、树、图和散列表,以及排序和查找算法。通过这些习题,学生可以深入掌握数据结构的操作和应用,并分析算法的时间与空间复杂度,从而提升编程和解决问题的能力。
更多推荐



 24
 0
- 0


 已为社区贡献10条内容

所有评论(0)