
【数据结构OJ】前K个高频单词


目录
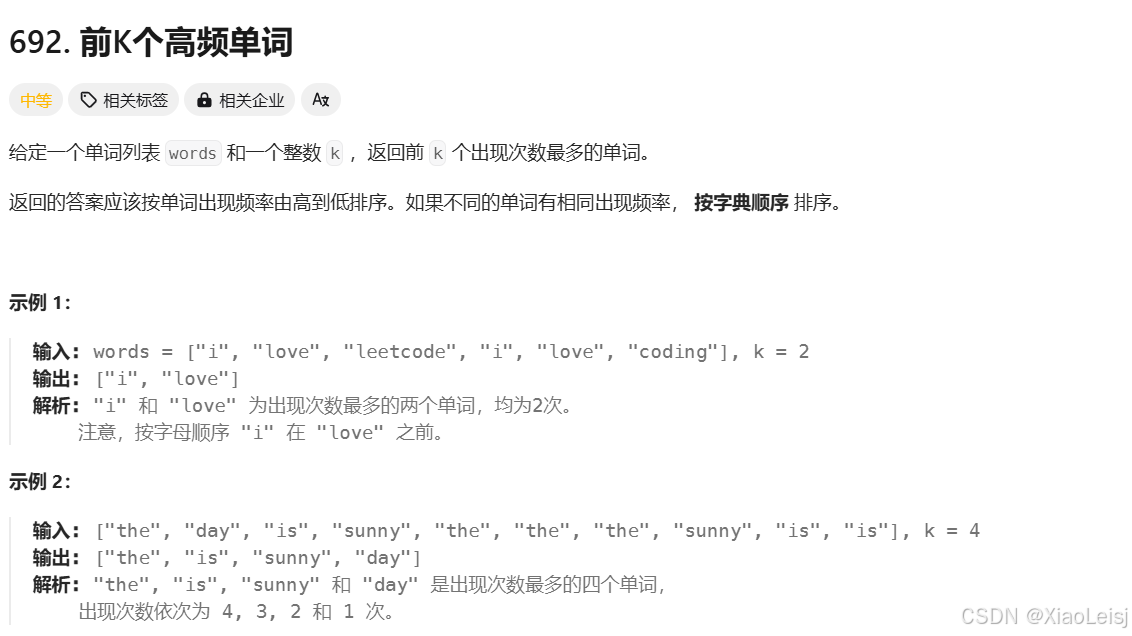
前K个高频单词
1. 建立map
通过问题的描述,我们可以看出,这是一个Top-K问题:
要在单词数组中,找到出现频率最高的前k个单词,所以我们要建立一个小根堆,通过Top-K的思想,来解决问题。
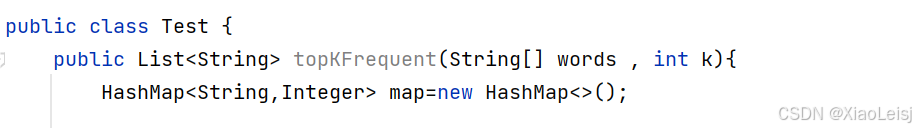
对于该题,我们可以HashMap,记录每个单词和单词出现的次数。
对于传入topKFrequent()的参数,我们传入要排序的字符串数组,和k的值。
通过topKFrequent(),我们已经找到了存放出现频率最高的前k个单词,topKFrequent()返回
存放这些单词的集合List。
因此topKFrequent()的返回类型是 List<String>.。
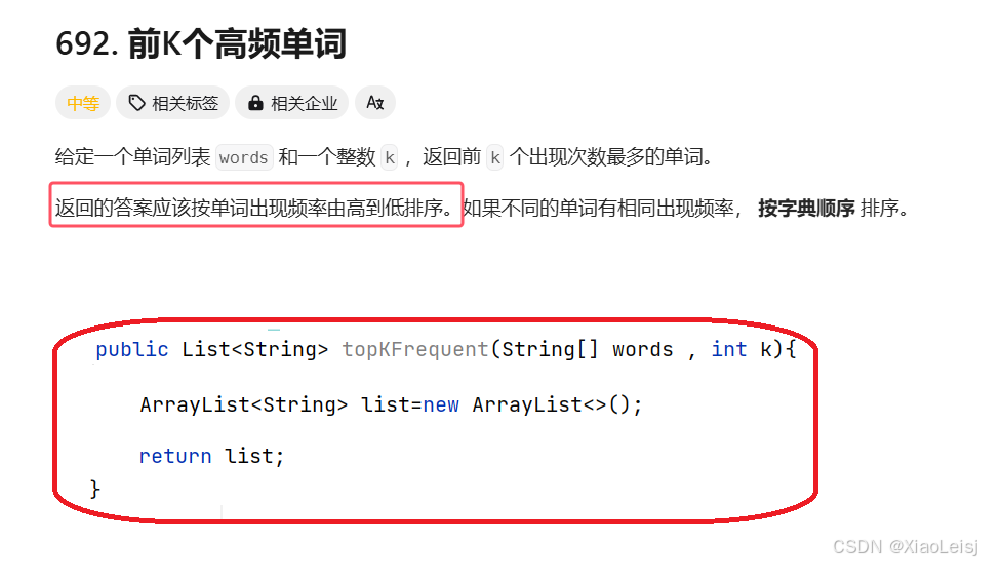
通过上面的要点,我们可以初步写出 topKFrequent()的框架:
2. 用哈希表统计单词出现的频率
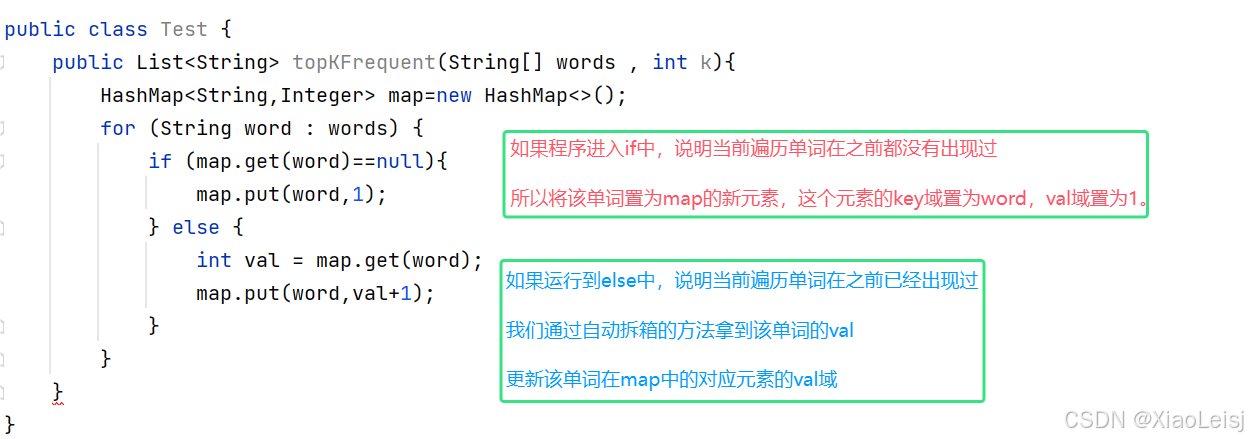
接下来,我们需要遍历传入的字符串数组,拿到每一个单词,并且将这些单词放入map中,通过map,记录这些单词的出现频率:
3. 建立小根堆
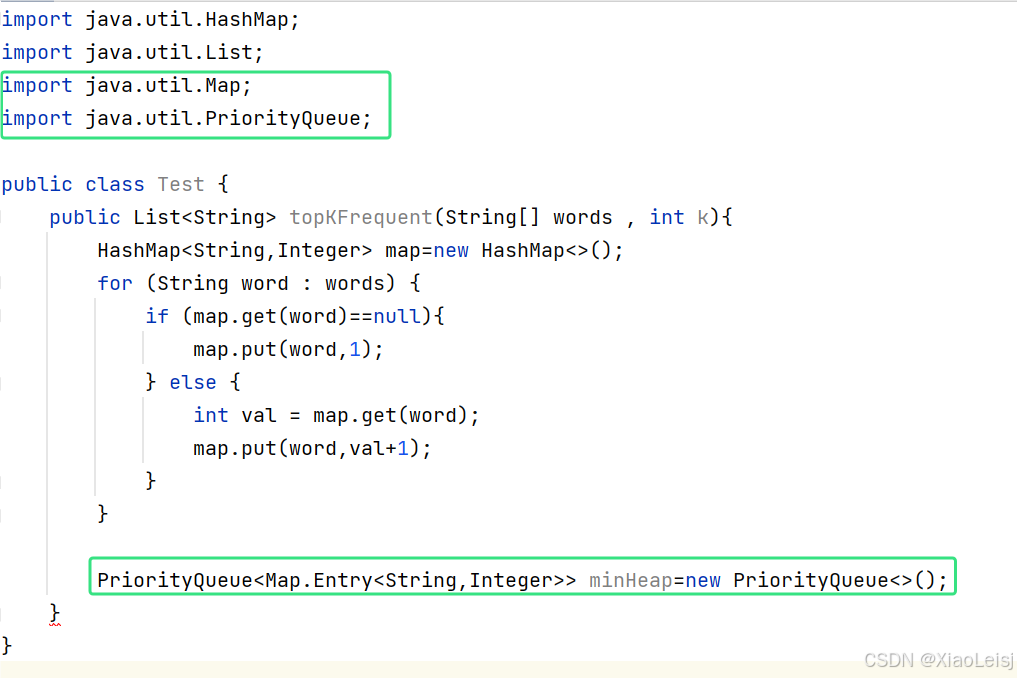
要记录前K个出现次数最多的单词,我们要建立一个小根堆,就会用到PriorityQueue。
那么PriorityQueue的泛型参数是什么呢?
参数应该是Map中的元素Entry的类型。
虽然是通过单词的出现频率val,来创建小根堆,但是不可能只拿Entry的val值作为PriorityQueue的参数,因为我们要通过key确定这个单词,再通过val值确定出现的次数。
要通过Map拿到里面的元素Entry,和PriorityQueue,我们可以通过编译器,导入对应的包。
4. 遍历map,依次向堆加入元素
我们要通过foreach,来遍历map中的每一个元素entry。
对于Top-K问题,找出现次数最高的前k个元素,我们通过创建小根堆,来解决问题。
因此,在循环过程中,我们把遍历到的前k个元素,先依次放入我们第三步创建的小根堆minHeap中。
然后拿剩余的元素依次和小根堆的堆顶元素进行比较。
如果在map中的剩余size-k个元素里,遍历到的当前元素比堆顶元素大,那么说明,此时堆顶元素一定不是前k个出现频率最高的。
我们poll出堆顶元素,再将当前遍历的元素offer到minHeap当中,通过PriorityQueue,编译器会再次自行调整所有元素成一个新的小根堆
如何获取entry呢?
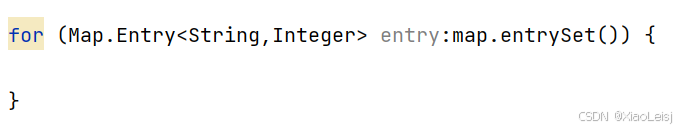
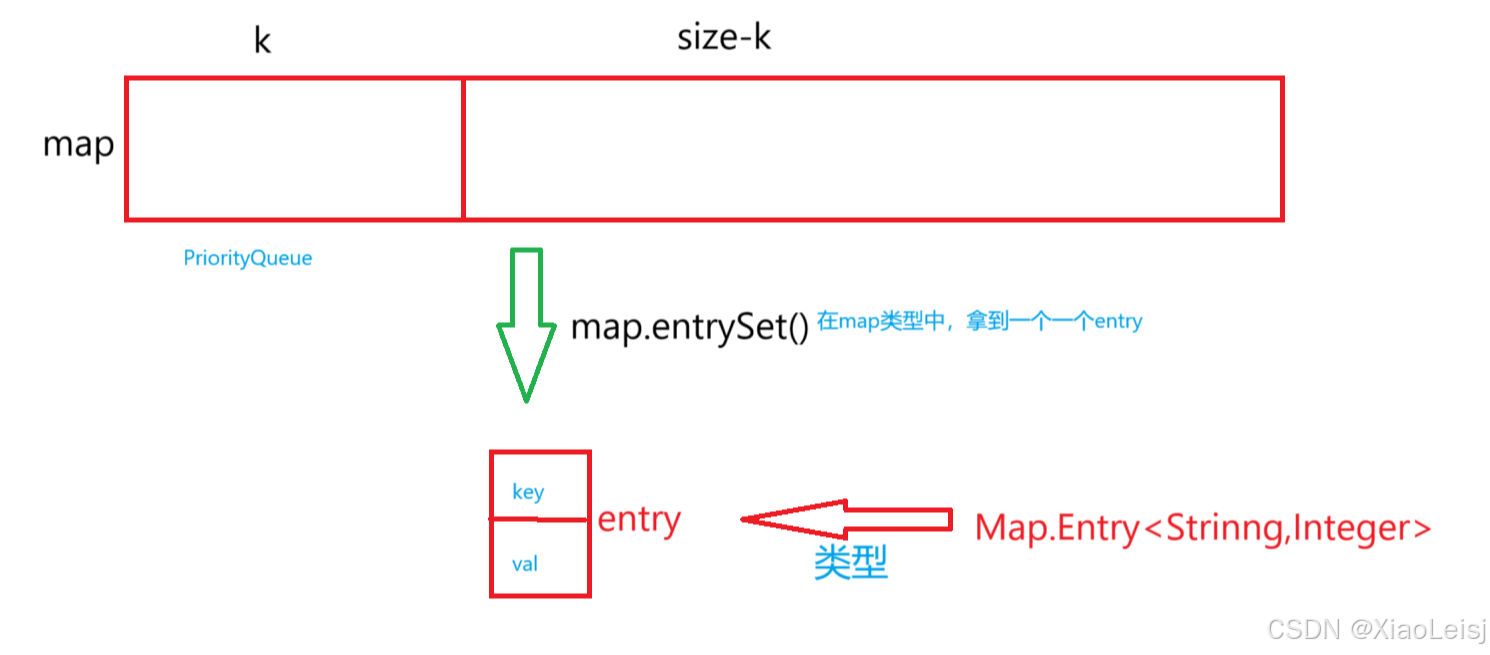
在拿到 map 中的各个元素entry后,我们开始遍历map,将前k个元素创建成小根堆;
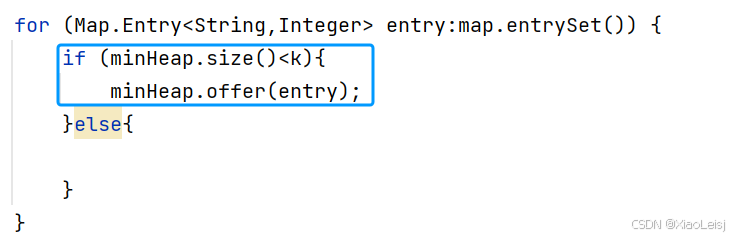
然后再将剩余的size-k个元素依次与堆顶元素比较,遍历到的当前元素比堆顶元素大,再将当前遍历的元素offer入minHeap,不断调整小根堆,直到遍历完map:
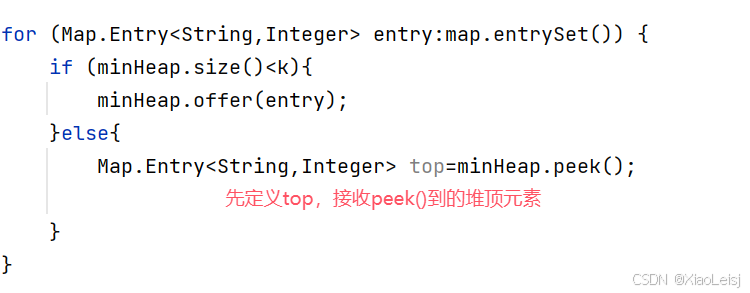
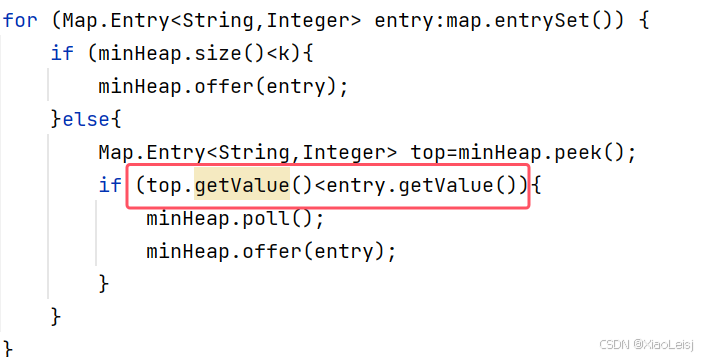
在写前k个元素和剩余的siez-k个元素比较时,会有一个特别容易出错的地方,那就是getValue()方法的返回值类型是引用类型,不能直接比较top和entry的值。比较引用类型,需要使用compareTo.
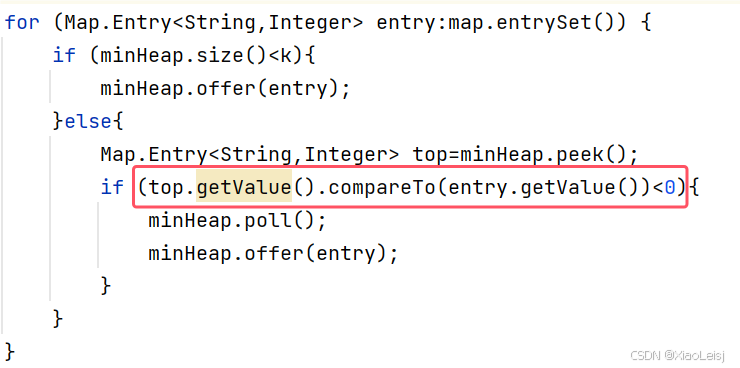
写到这,还不能完全囊括前k个元素和剩余的siez-k个元素的所有比较情况:
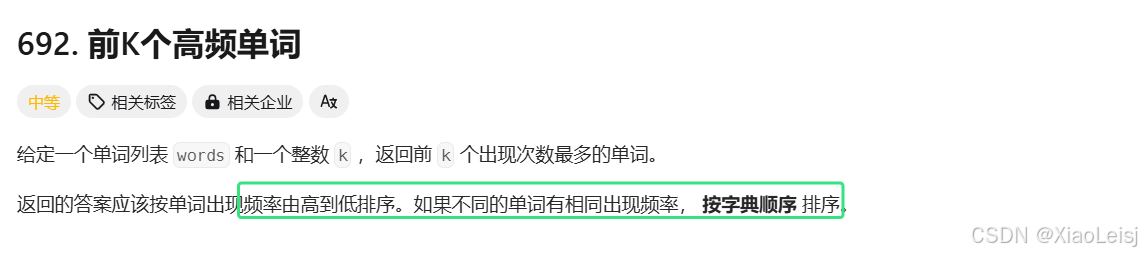
对于频率相同,但是单词字母不同,就比较两个单词(String是可比较类型):
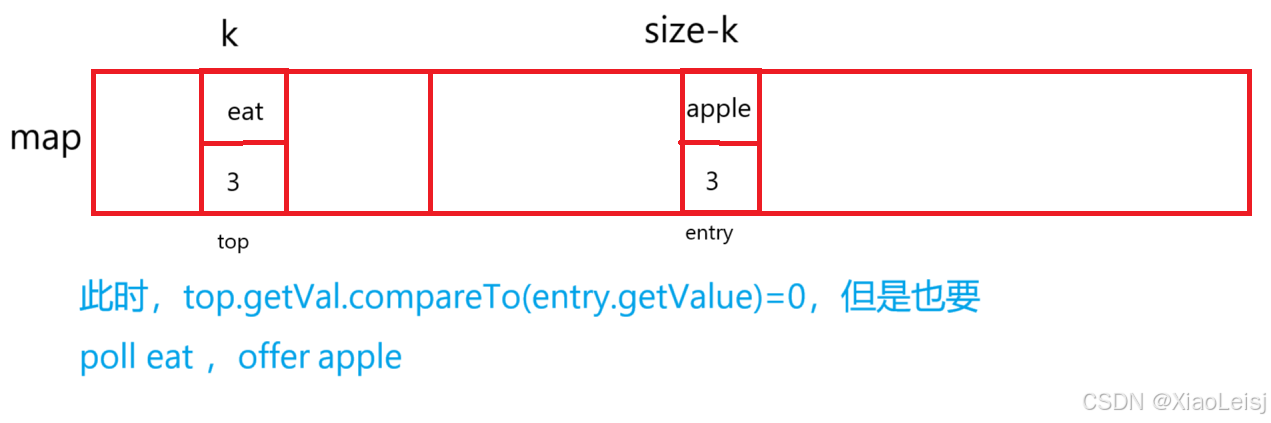
所以,我们需要进一步完善调整小根堆的代码,在val相同时,按字典顺序排序:
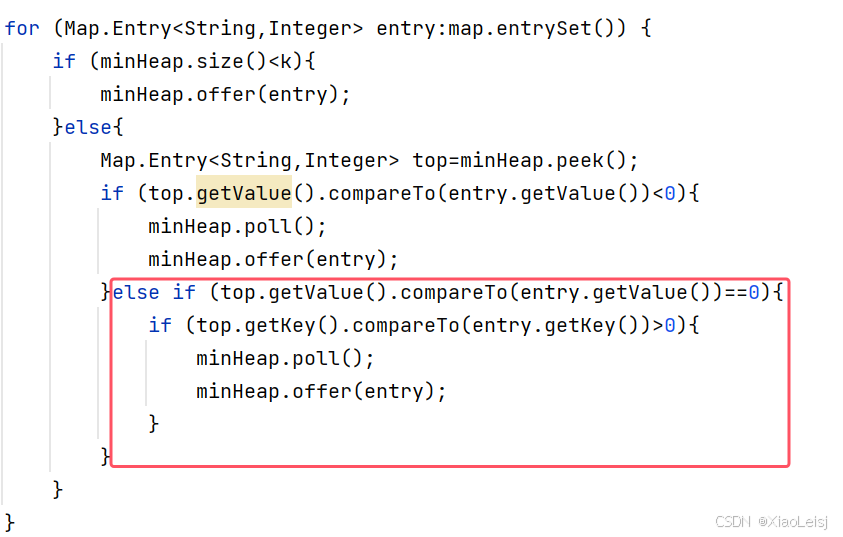 top.getKey().compareTo(entry.getKey())>0,说明top.key比entry.key更靠后。
5. 依次弹出堆中的 K 个元素,放入结果集合中
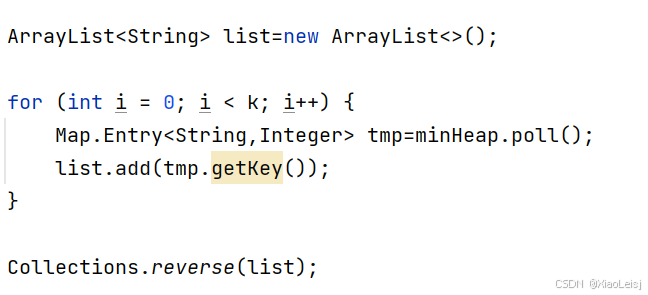
在遍历完整个words数组后,得到最终小根堆。这时候,我们需要创建一个ArrayList类型的集合list,用于接收依次poll小根堆的String类型的单词:
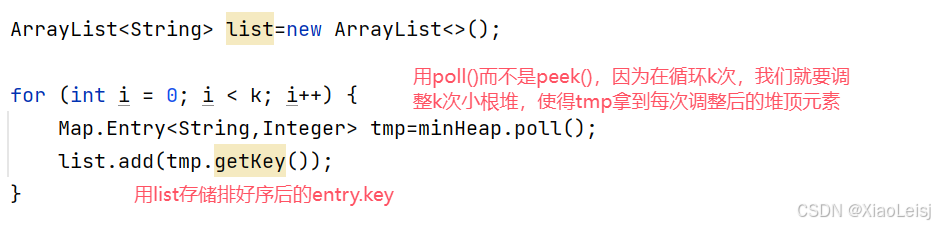
但是,list中的单词元素顺序,是不符合题目要求的:
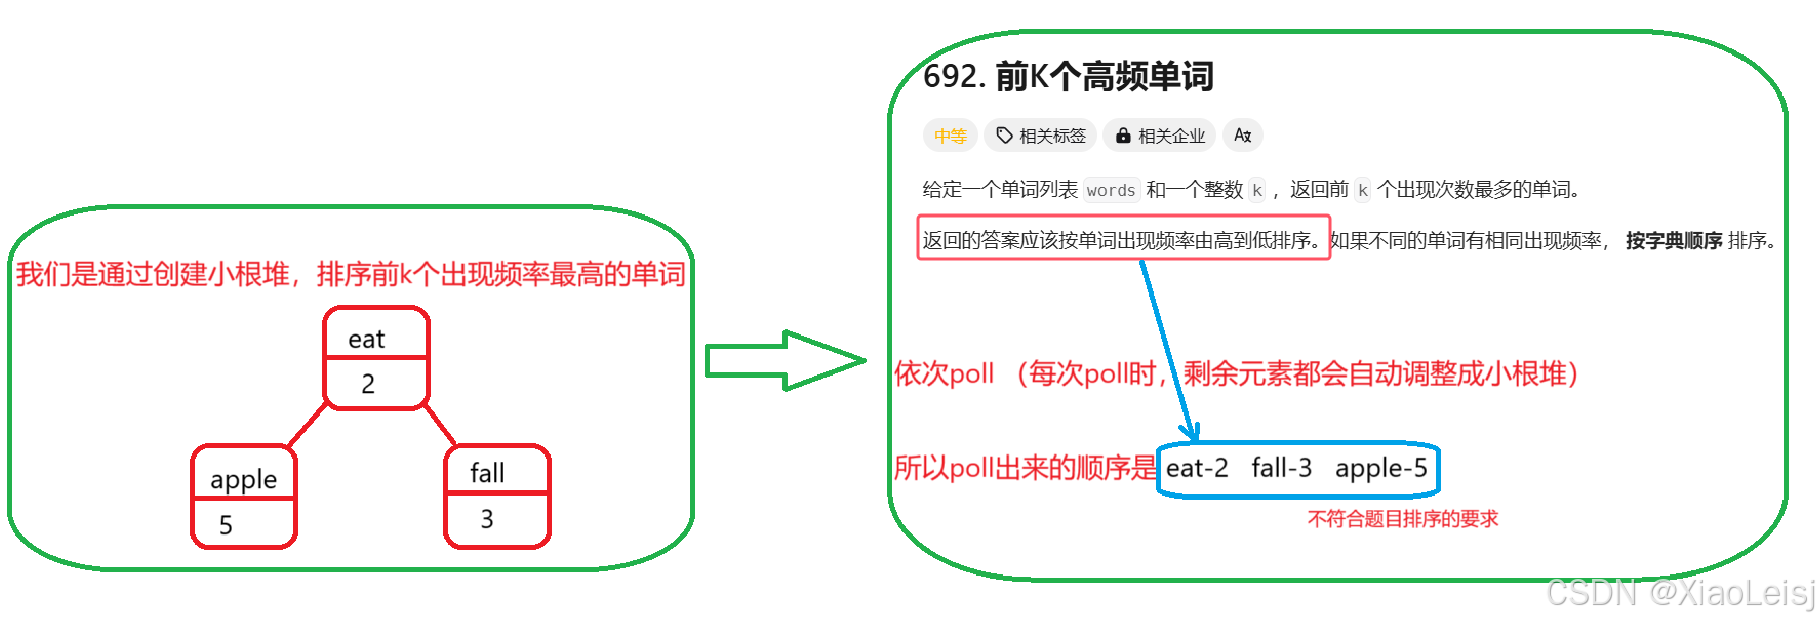
因此,我们需要调用Collections类底下的reverse()方法,对集合中的所有元素进行逆置。
值得一提:Collections类底下的方法用于操作集合,Arrays类底下的方法用于操作数组。
最后,我们根据这个方法的返回类型,设置返回值:
6. 完善PriorityQueue比较器
创建好优先级队列后,是根据entry中的key创建小根堆呢?还是根据 val创建小根堆呢?因此,我们在实例化优先级队列后,要根据实际的需求,为PriorityQueue传入比较器Comparator:
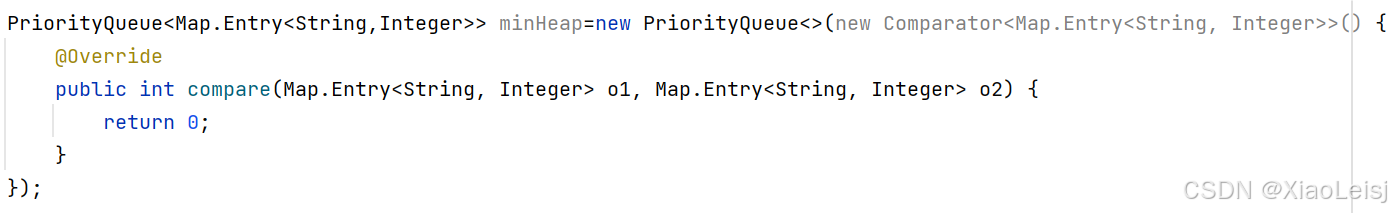
我们再次读题,根据题目的需求,来合理的完善比较器的构造方法:
因为我们是根据entry中的key来创建小根堆的,这个key是引用类型,并不是简单数据类型,所以,我们通过getvalue()获取entry的val,再通过compareTo ()比较entry的key。
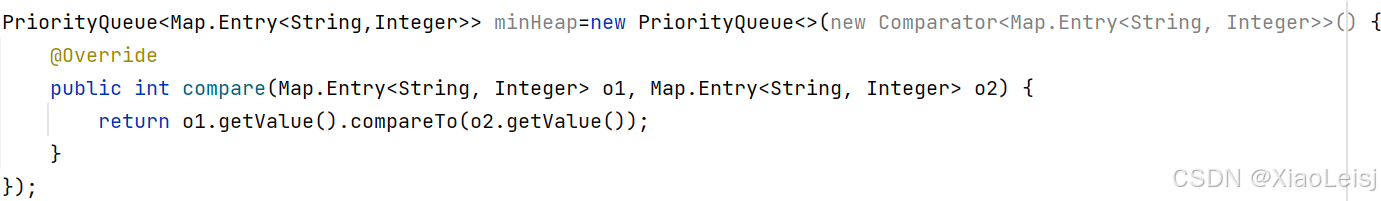
值得一提,通过compareTo ()比较o1.val 和o2.val,来获取(o1.val - o2.val)的值,是创建小根堆,反之,则是创建大根堆。
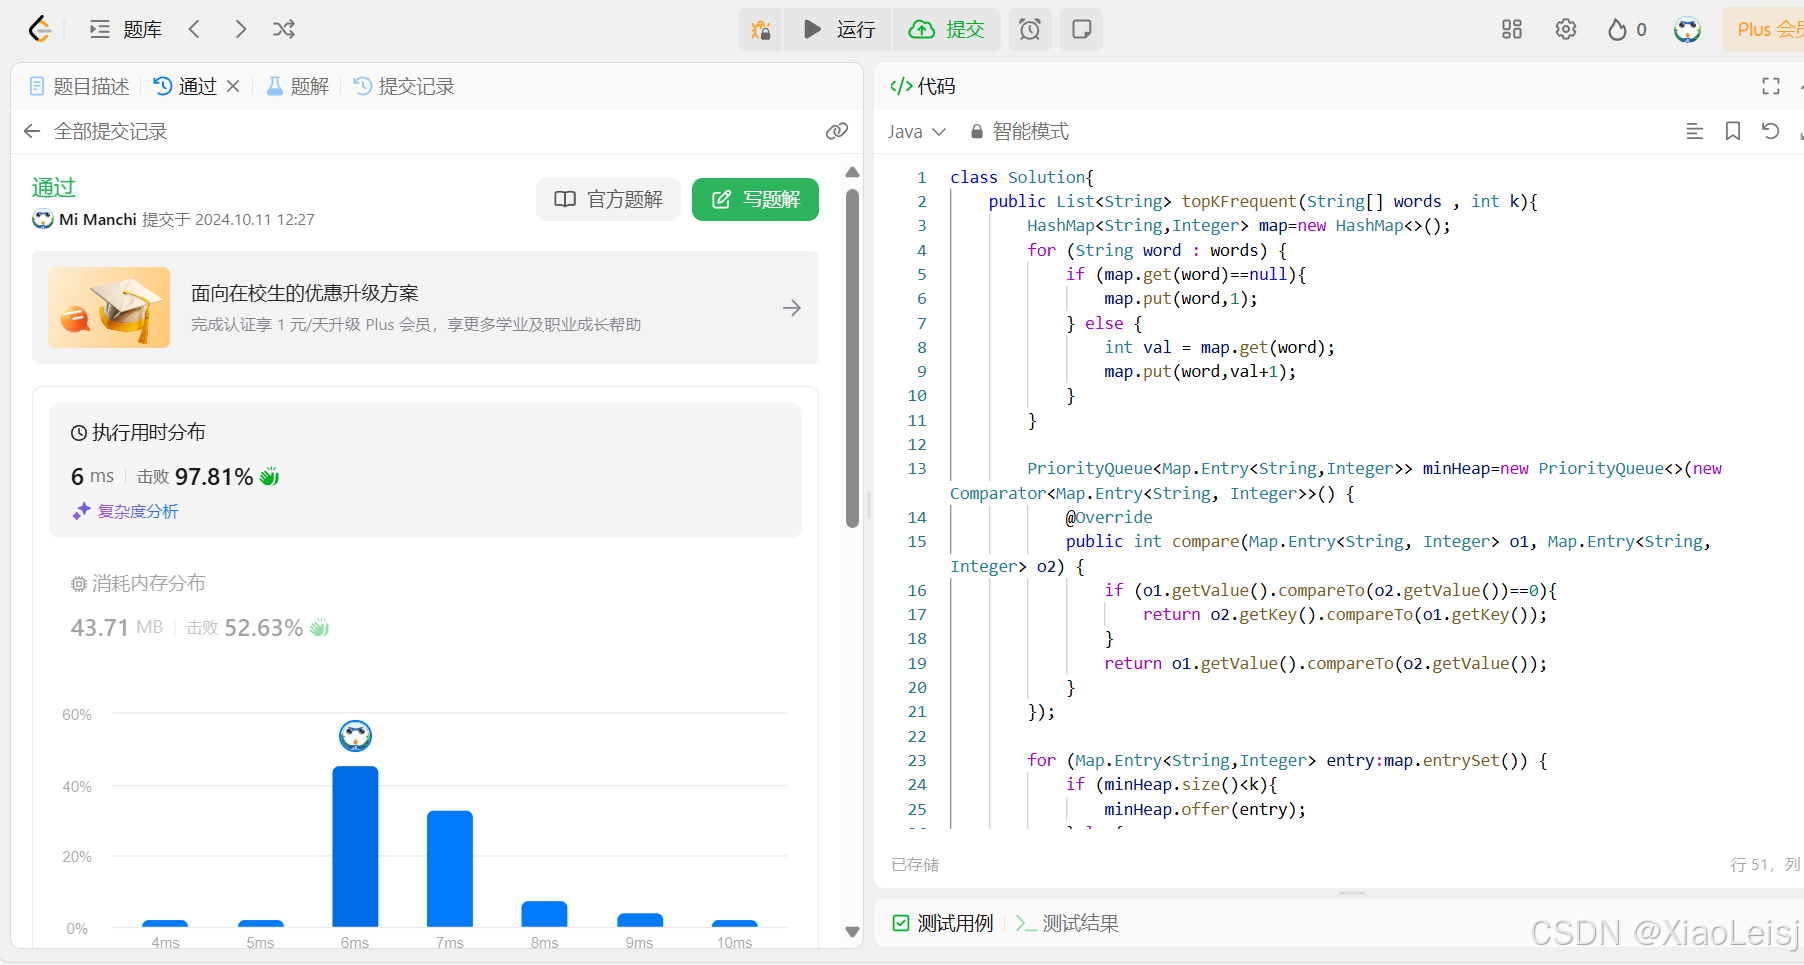
但是,仅仅只是比较各个entry中的val,仍然不能通过全部测试案例:
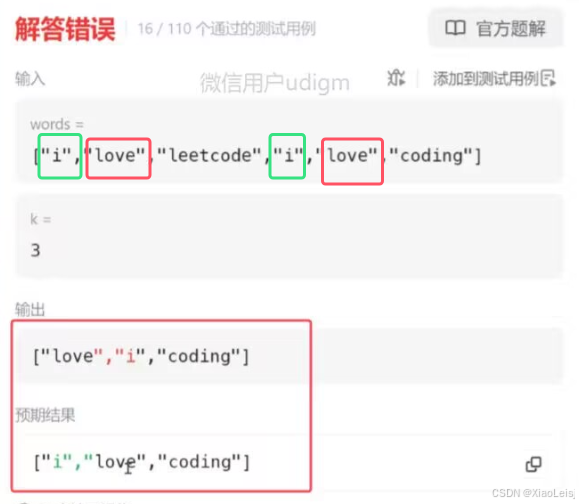
错误原因:
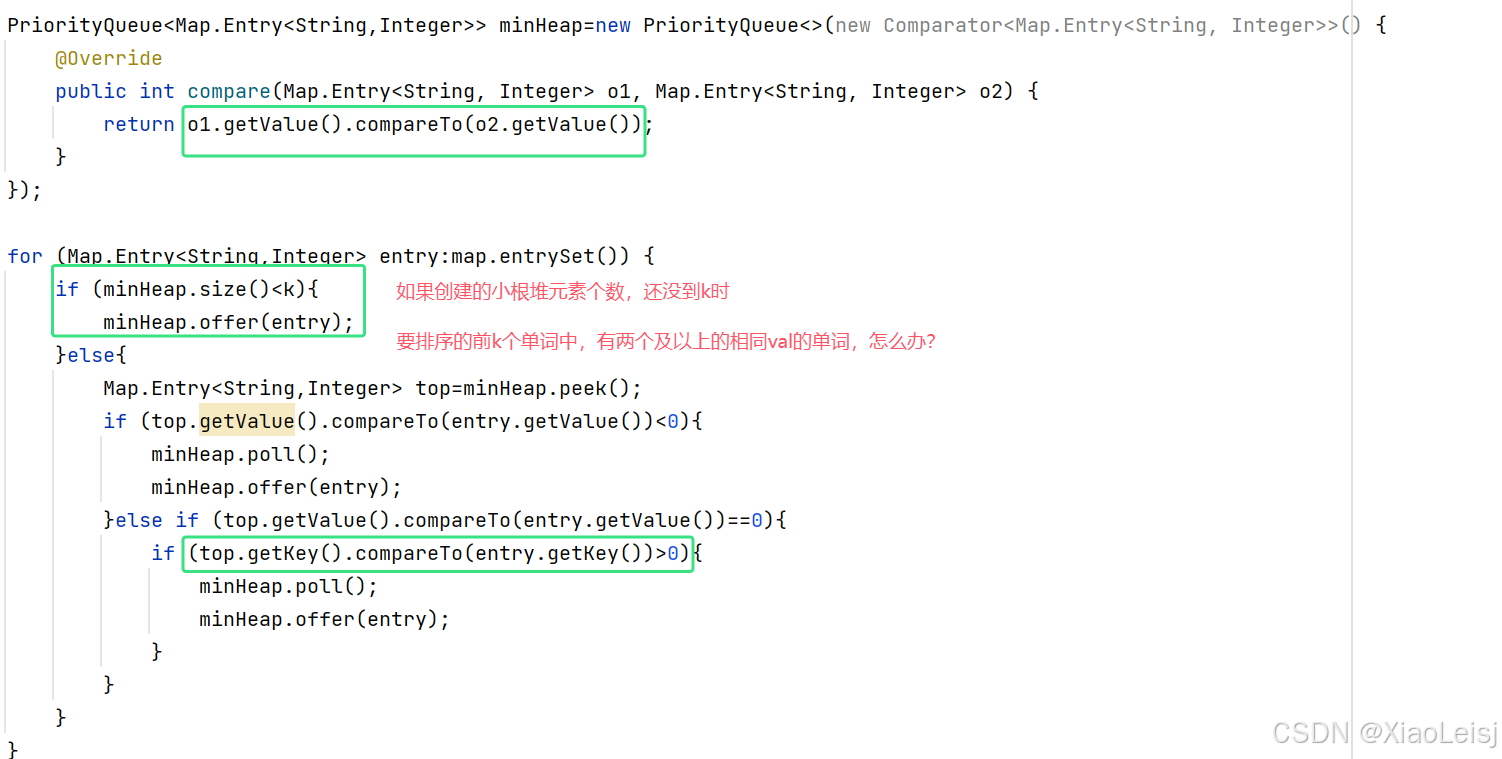
这时候,程序执行到第一个if语句,还在不停的将前k个entry offer到minHeap中,出现相同val的entry,在key不同时,这几个entry是没有得到妥善地排序的。
这时候会出现两种及以上不同的情况:
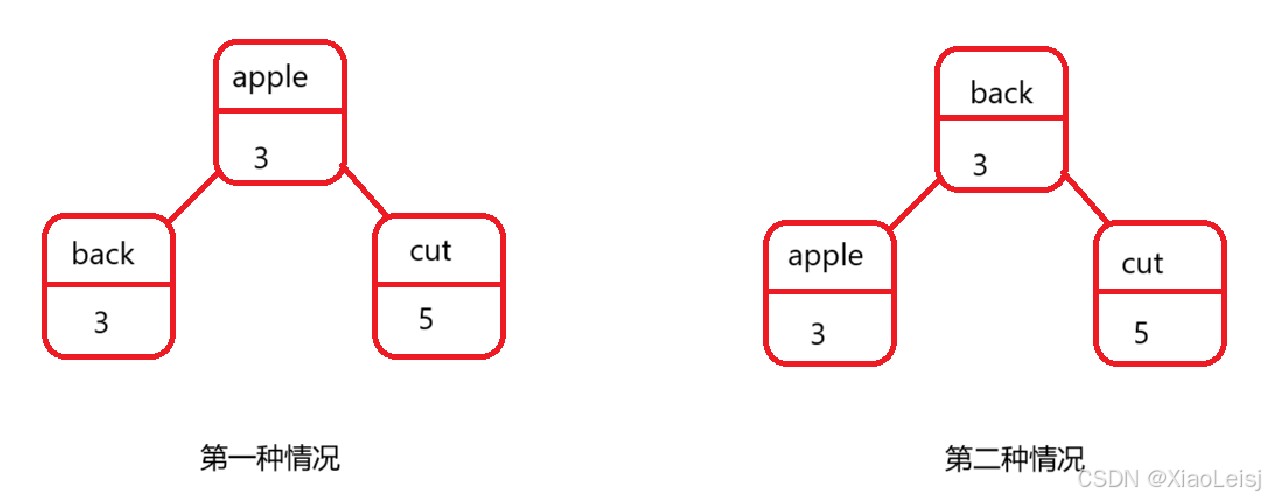
以两种不同的情况为例,在 minHeap.size()<k 时 ,不会因为key的不同而被调整,如果都保留到了最后,poll到list时,两者在list中存放的先后顺序,会因此产生差异。
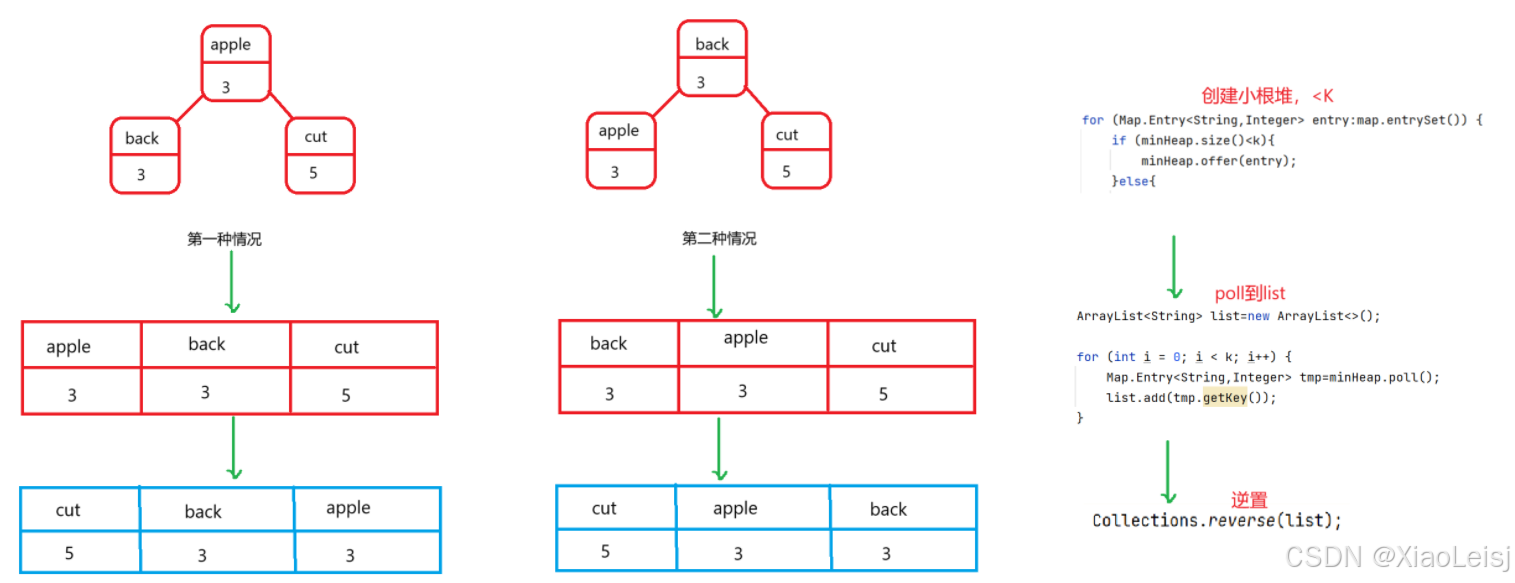
所以,问题出在,在创建小根堆时,在minHeap.size()<k时,在小根堆中的entry.val相同,但是key不一样,在比较器中没有写入这种情况的调整方法。
对于上图的两种情况,第二种情况的小根堆,在一系列后续操作后,得到的最终结果是是符合题目要求的排序条件的:
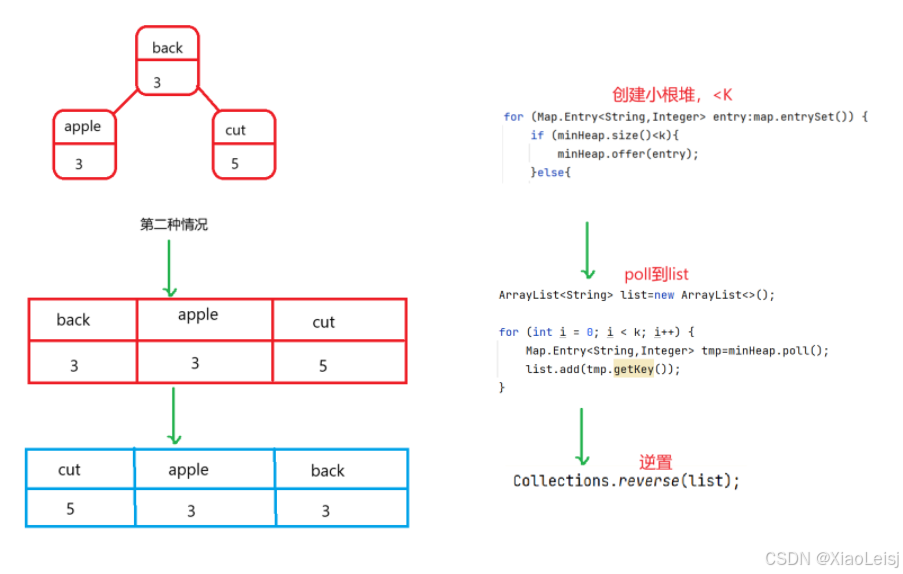
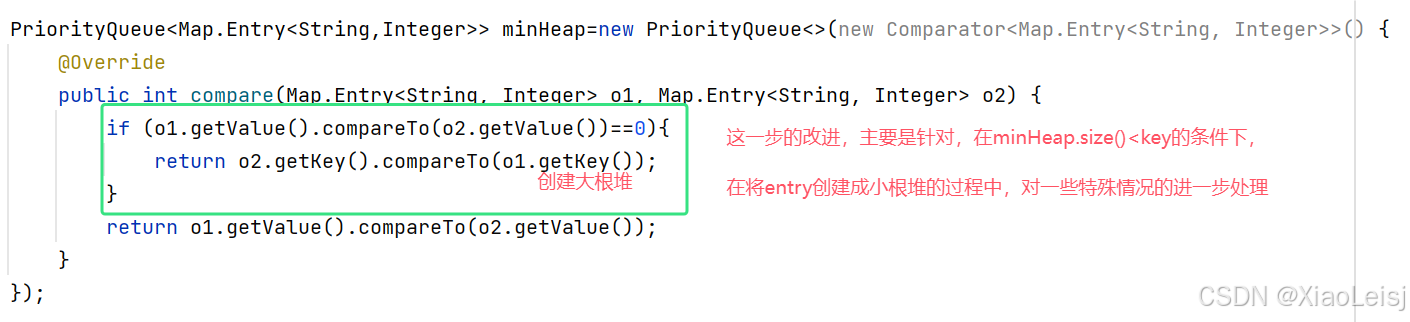
所以,在minHeap.size()<k,在小根堆中的entry.val相同,但是key不一样的时候,我们对entry的key排序,创建大根堆。
因此,我们可以进一步修改传给PriorityQueue的比较器的构造方法:
以上,就是解决前K个高频单词问题的全部内容!
7. 完整代码
public class Test {
    public List<String> topKFrequent(String[] words , int k){
        HashMap<String,Integer> map=new HashMap<>();
        for (String word : words) {
            if (map.get(word)==null){
                map.put(word,1);
            } else {
                int val = map.get(word);
                map.put(word,val+1);
            }
        }

        PriorityQueue<Map.Entry<String,Integer>> minHeap=new PriorityQueue<>(new Comparator<Map.Entry<String, Integer>>() {
            @Override
            public int compare(Map.Entry<String, Integer> o1, Map.Entry<String, Integer> o2) {
                if (o1.getValue().compareTo(o2.getValue())==0){
                    return o2.getKey().compareTo(o1.getKey());
                }
                return o1.getValue().compareTo(o2.getValue());
            }
        });

        for (Map.Entry<String,Integer> entry:map.entrySet()) {
            if (minHeap.size()<k){
                minHeap.offer(entry);
            }else{
                Map.Entry<String,Integer> top=minHeap.peek();
                if (top.getValue().compareTo(entry.getValue())<0){
                    minHeap.poll();
                    minHeap.offer(entry);
                }else if (top.getValue().compareTo(entry.getValue())==0){
                    if (top.getKey().compareTo(entry.getKey())>0){
                        minHeap.poll();
                        minHeap.offer(entry);
                    }
                }
            }
        }

        ArrayList<String> list=new ArrayList<>();

        for (int i = 0; i < k; i++) {
            Map.Entry<String,Integer> tmp=minHeap.poll();
            list.add(tmp.getKey());
        }

        Collections.reverse(list);

        return list;
    }
更多推荐



 42
 0
- 0


 已为社区贡献6条内容

所有评论(0)