
殷人昆数据结构课后习题详解

简介:本资源提供了《殷人昆数据结构》课程第1至第10章课后习题的详尽解答,帮助学生深入理解数据结构的基础知识和应用。涵盖了数组、链表、栈、队列、树形结构、图结构、查找与排序算法等关键数据结构知识点,以及动态数据结构和高级数据结构等内容。通过解答习题,学生能够巩固理论知识,提升编程中的问题解决能力。 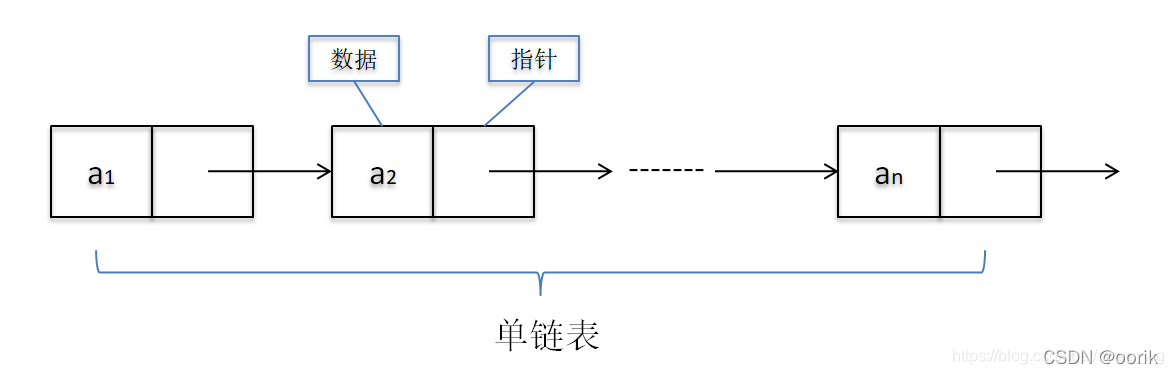
1. 数据结构基础概念解答
在深入探讨数据结构之前,有必要先理解什么是数据结构。数据结构是计算机存储、组织数据的方式,它旨在能够高效地对数据进行处理。数据结构不仅包括数据的逻辑结构,也包括操作数据的方法和访问数据的函数。
1.1 数据结构的分类
数据结构通常被分为以下几类:
- 线性结构:数组、链表、栈和队列都是典型的线性结构,它们以一种顺序的方式组织数据,便于线性访问。
- 树形结构:树和图结构为非线性数据结构,用于处理具有层次或网络关系的数据。例如,二叉树广泛用于文件系统和数据库。
- 图形结构:图形结构用于描述对象间的复杂关系,例如社交网络和互联网。
1.2 数据结构的重要性
学习数据结构对于任何计算机科学领域的专业人士都至关重要。它不仅能够提升解决复杂问题的能力,而且在处理大数据、算法设计、软件开发等实际应用中占有核心地位。掌握合适的数据结构,可以在很多情况下优化性能,提高资源利用率。
例如,在设计一个Web搜索引擎时,会使用到多种数据结构来存储、索引和检索大量信息。树形结构用于快速查找,图结构用于分析网页间的关系等。因此,对数据结构的理解和应用,是构建高效、复杂系统的基础。
2. 线性结构详解
2.1 数组和链表的原理及应用
2.1.1 数组和链表的区别与联系
数组和链表是两种常见的线性数据结构,它们在内存中的存储方式、访问速度以及增删元素的操作等方面都有着本质的区别,但它们也有一些联系。
区别:
- 内存分布: 数组在内存中是连续存放的,每个元素占用相同大小的存储空间。链表则不同,它的元素(节点)在内存中分散存放,每个节点包含存储数据的单元和一个指向下一个元素的指针。
-
访问速度: 数组的访问速度非常快,可以直接通过下标访问元素,时间复杂度为O(1)。链表的访问则需要从头开始,逐个遍历到目标元素,时间复杂度为O(n)。
-
插入和删除: 在数组中进行插入和删除操作可能需要移动大量元素,特别是在非数组末尾的操作,效率较低。而链表的插入和删除只需要改变相应节点的指针即可,不需要移动元素。
联系:
- 线性结构: 它们都是线性结构,元素之间是一对一的关系。
- 操作复杂度: 对于数组,其时间复杂度是均匀的,即除了访问元素外,其他操作的时间复杂度都为O(n)。链表在访问元素时性能不佳,但在插入和删除元素时,除了头尾操作时间复杂度为O(1)外,其他位置的时间复杂度为O(n)。
2.1.2 数组和链表在不同场景下的选择
选择使用数组还是链表取决于具体的应用场景和需求。
数组适用场景:
- 当需要快速访问元素,并且元素大小固定且数量不多时,使用数组较为合适。
- 数组更适合于内存缓存密集型的操作,如缓存一定数量的用户信息。
- 如果问题中需要频繁的随机访问,那么数组是更好的选择。
链表适用场景:
- 当元素大小不固定、数量庞大或者频繁进行插入和删除操作时,使用链表更为合适。
- 链表更适合于实现队列、栈等数据结构。
- 对于内存使用不是特别密集,且需要动态扩展数据容量的场景,链表是一个较好的选择。
2.2 栈和队列的实现与特性
2.2.1 栈和队列的基本操作
栈和队列都是操作受限的线性数据结构,它们的操作和特性有着明显的区别。
栈的特点:
- 后进先出(LIFO)。
- 栈的操作主要有:push(入栈)、pop(出栈)、peek(查看栈顶元素)。
class Stack:
    def __init__(self):
        self.stack = []
    def push(self, value):
        self.stack.append(value)
    def pop(self):
        if not self.is_empty():
            return self.stack.pop()
    def peek(self):
        if not self.is_empty():
            return self.stack[-1]
    def is_empty(self):
        return len(self.stack) == 0
队列的特点:
- 先进先出(FIFO)。
- 队列的操作主要有:enqueue(入队)、dequeue(出队)、peek(查看队首元素)。
class Queue:
    def __init__(self):
        self.queue = []
    def enqueue(self, value):
        self.queue.append(value)
    def dequeue(self):
        if not self.is_empty():
            return self.queue.pop(0)
    def peek(self):
        if not self.is_empty():
            return self.queue[0]
    def is_empty(self):
        return len(self.queue) == 0
2.2.2 栈和队列在算法中的使用实例
在算法中,栈和队列的应用非常广泛,它们常常用于实现各种算法的辅助结构。
栈的使用实例:
- 用于解决括号匹配问题。
- 在深度优先搜索(DFS)算法中用来存储访问路径。
- 在回溯算法中,栈用于保存当前状态。
队列的使用实例:
- 广度优先搜索(BFS)算法中,队列用于存储待访问节点。
- 在实现缓存机制时,队列用于按照访问顺序来淘汰旧元素。
在理解了栈和队列的操作之后,接下来的章节将会继续探讨树形结构的应用、图结构的学习,以及查找与排序技术等更加深入的数据结构主题。
3. 树形结构应用
树形结构是数据结构中非常重要的一部分,其应用广泛,包括但不限于数据库的索引、文件系统的目录结构、搜索引擎的关键字查找等。树结构的一个显著优点是它能够快速定位信息,即使在庞大的数据集上也能保持高效率。接下来的章节中,我们将深入了解二叉树及其扩展结构,以及树形结构在高级应用中的实践案例。
3.1 二叉树及其扩展结构
3.1.1 二叉树的遍历算法
二叉树是每个节点最多有两个子树的树结构,通常子树被称作“左子树”和“右子树”。在树形结构中,二叉树的遍历尤其重要,它是指按照某种顺序访问树中的所有节点,并且每个节点只被访问一次。常见的遍历方法有前序遍历、中序遍历、后序遍历和层序遍历。
在前序遍历中,我们首先访问根节点,然后递归地访问左子树,最后递归地访问右子树。中序遍历则先访问左子树,然后是根节点,最后是右子树。后序遍历的顺序则相反,先访问右子树,然后是根节点,最后是左子树。层序遍历则是逐层从上到下,从左到右访问每个节点。
代码块展示一个递归前序遍历的实现:
class TreeNode:
    def __init__(self, value=0, left=None, right=None):
        self.val = value
        self.left = left
        self.right = right

def preorder_traversal(root):
    if root:
        print(root.val)          # 访问根节点
        preorder_traversal(root.left)   # 递归左子树
        preorder_traversal(root.right)  # 递归右子树

# 示例树:
#    1
#   / \
#  2   3
#     / \
#    4   5
preorder_traversal(TreeNode(1, TreeNode(2), TreeNode(3, TreeNode(4), TreeNode(5))))
输出结果将是根节点和其左右子树节点的顺序:1 → 2 → 3 → 4 → 5。
3.1.2 平衡树和堆的特性及应用
平衡树是一种特殊的二叉树,它保证任何节点的两个子树的高度差不会超过 1。平衡树的特点使得它在增删查等操作中都能保持 O(log n) 的时间复杂度,这使得它在实现关联数组等数据结构时非常有效率。常见的平衡树有 AVL 树、红黑树等。
堆是一种特殊的完全二叉树,它满足父节点的值总是大于或等于子节点的值(最大堆),或者父节点的值总是小于或等于子节点的值(最小堆)。堆通常用于实现优先队列,一个典型的应用是优先级调度算法。
一个最大堆的性质可以通过代码块来验证:
def is_max_heap(heap):
    n = len(heap)
    for i in range(n // 2):
        if 2 * i + 1 < n and heap[i] < heap[2 * i + 1]:
            return False
        if 2 * i + 2 < n and heap[i] < heap[2 * i + 2]:
            return False
    return True

# 示例最大堆: [9, 7, 8, 5, 6]
print(is_max_heap([9, 7, 8, 5, 6])) # 输出:True
堆的实现经常用于处理动态集合中的最大元素查找问题,如优先队列或堆排序。
3.2 树形结构的高级应用
3.2.1 二叉树的优化问题
二叉树在应用中可能会遇到一些优化问题。例如,在构建二叉搜索树(BST)时,如果输入数据已经有序,那么会形成一个偏斜树(skewed tree),这种情况下的BST与链表无异,查找操作退化为 O(n)。为了避免这种情况,我们可以采用随机化输入数据来构建BST,或者采用如AVL树、红黑树这样的自平衡二叉搜索树。
3.2.2 树形结构在实际编程中的运用
在实际编程中,树形结构有多种应用。例如,文件系统的目录结构可以用树来表示,每个目录对应一个节点,其子目录或文件作为子节点。在数据库中,索引的实现通常用B树或B+树来组织数据。搜索算法如深度优先搜索(DFS)和广度优先搜索(BFS)可以用来解决网络爬虫的路径搜索,或者社交网络中的关系网分析。
树形结构在编程语言中也被广泛应用,如在Python的解释器中,表达式树(AST)是编译过程的核心部分。在各种算法问题中,例如动态规划问题,树形结构经常被用来存储和优化计算。
通过以上内容,我们可以看到树形结构不仅理论基础丰富,而且在解决实际问题中发挥着重要作用。下一章节,我们将继续探讨树形结构的高级应用,及其在多种编程环境中的具体运用。
4. 图结构学习
图是一种复杂的数据结构,它由节点(也称为顶点)和连接节点的边组成。图可以用于描述网络、社交关系、运输路线等现实世界中的许多关系。在本章节中,我们将深入探讨图结构的表示方法、遍历技术以及图结构的特殊问题分析。
4.1 图的表示方法和遍历技术
图的表示和遍历是图结构学习的基础,对于理解图的结构和解决图相关问题至关重要。
4.1.1 图的存储表示:邻接矩阵与邻接表
在图的表示方法中,最常用的有两种:邻接矩阵和邻接表。
邻接矩阵 是一种二维数组表示图的方法,如果顶点i到顶点j之间有边,则matrix[i][j]为1,否则为0。邻接矩阵的优点是实现简单,便于判断任意两个顶点之间是否相连,同时支持快速的矩阵运算。缺点是空间复杂度较高,尤其是当图稀疏时,会造成空间的浪费。
int matrix[MAX_VERTICES][MAX_VERTICES]; // MAX_VERTICES是顶点数上限
// 初始化矩阵,假设图的顶点编号从0到MAX_VERTICES-1
for (int i = 0; i < MAX_VERTICES; i++) {
    for (int j = 0; j < MAX_VERTICES; j++) {
        matrix[i][j] = 0; // 全部初始化为0
    }
}
// 添加边操作示例
void addEdge(int start, int end) {
    matrix[start][end] = 1;
    matrix[end][start] = 1; // 若为无向图则双向都要添加
}
邻接表 是一种通过链表来表示图的方法,每个顶点对应一个链表,链表中的节点表示与该顶点相邻的其他顶点。邻接表的优点是空间效率高,尤其适合表示稀疏图;缺点是判断两个顶点是否相连需要遍历链表,因此时间复杂度较高。
// 图的顶点和边结构
typedef struct Vertex {
    int data; // 顶点数据
    struct AdjListNode *firstEdge; // 指向第一条依附于该顶点的边
} AdjList[MAX_VERTICES];

typedef struct AdjListNode {
    int adjvex; // 邻接点域,存储该顶点对应的下标
    struct AdjListNode *next; // 链域,指向下一个邻接点
} AdjListNode;

// 初始化邻接表
void initGraph(AdjList graph, int numVertices) {
    for (int i = 0; i < numVertices; i++) {
        graph[i].data = i; // 初始化顶点数据
        graph[i].firstEdge = NULL; // 初始化邻接表头指针
    }
}

// 添加边
void addEdge(AdjList graph, int start, int end) {
    // 添加从start到end的边
    AdjListNode *newNode = (AdjListNode *)malloc(sizeof(AdjListNode));
    newNode->adjvex = end;
    newNode->next = graph[start].firstEdge;
    graph[start].firstEdge = newNode;

    // 如果是无向图,还需要添加从end到start的边
    newNode = (AdjListNode *)malloc(sizeof(AdjListNode));
    newNode->adjvex = start;
    newNode->next = graph[end].firstEdge;
    graph[end].firstEdge = newNode;
}
4.1.2 图的深度优先搜索和广度优先搜索
遍历图的目的在于访问图中每个顶点恰好一次。深度优先搜索(DFS)和广度优先搜索(BFS)是两种常用的图遍历算法。
深度优先搜索 通过递归的方式,从一个顶点开始,沿着一条路径深入探索直到路径的末端,然后回溯到上一个分叉点继续探索。实现时通常使用栈来保存路径。
void DFSUtil(int v, bool visited[], AdjList graph, int numVertices) {
    visited[v] = true;
    printf("%d ", v); // 输出顶点或处理顶点数据

    AdjListNode *nodePtr;
    for (nodePtr = graph[v].firstEdge; nodePtr != NULL; nodePtr = nodePtr->next) {
        int connectedVertex = nodePtr->adjvex;
        if (!visited[connectedVertex]) {
            DFSUtil(connectedVertex, visited, graph, numVertices);
        }
    }
}

void DFS(AdjList graph, int numVertices) {
    // 初始化所有顶点为未访问
    bool *visited = (bool *)malloc(numVertices * sizeof(bool));
    memset(visited, 0, numVertices * sizeof(bool));

    // 对每个未访问的顶点调用递归辅助函数
    for (int i = 0; i < numVertices; i++) {
        if (!visited[i]) {
            DFSUtil(i, visited, graph, numVertices);
        }
    }
    free(visited);
}
广度优先搜索 从一个顶点开始,访问其所有邻接点,然后再对这些邻接点的未访问邻接点进行访问,以此类推。实现时通常使用队列。
void BFS(AdjList graph, int numVertices) {
    // 初始化所有顶点为未访问
    bool visited[MAX_VERTICES];
    memset(visited, 0, numVertices * sizeof(bool));

    // 创建一个队列用于BFS
    Queue q = createQueue(numVertices);
    // 从第一个顶点开始遍历图
    for (int i = 0; i < numVertices; ++i) {
        if (visited[i] == false) {
            // 将当前顶点标记为已访问并入队
            visited[i] = true;
            enqueue(q, i);
            while (!isEmpty(q)) {
                // 出队一个顶点并访问
                int curr = dequeue(q);
                printf("%d ", curr);

                // 获取所有邻接顶点
                AdjListNode *nodePtr = graph[curr].firstEdge;
                while (nodePtr) {
                    int adj = nodePtr->adjvex;
                    if (!visited[adj]) {
                        visited[adj] = true;
                        enqueue(q, adj);
                    }
                    nodePtr = nodePtr->next;
                }
            }
        }
    }
    // 释放队列空间
    freeQueue(q);
}
4.2 图结构的特殊问题分析
图结构的特殊问题分析包括图中路径寻找、最优化路径计算等问题,例如最短路径问题和网络流问题。
4.2.1 最短路径问题和网络流问题
最短路径问题 的目标是在加权图中找到两个顶点之间的最短路径,常用的算法有Dijkstra算法和Floyd算法。
// Dijkstra算法的伪代码
function Dijkstra(Graph, source):
    create vertex set Q

    for each vertex v in Graph:
        dist[v] ← INFINITY
        prev[v] ← UNDEFINED
        add v to Q
    dist[source] ← 0
    while Q is not empty:
        u ← vertex in Q with min dist[u]
        remove u from Q
        for each neighbor v of u:           // only v that are still in Q
            alt ← dist[u] + length(u, v)
            if alt < dist[v]:
                dist[v] ← alt
                prev[v] ← u

    return dist[], prev[]
网络流问题 关注的是在一个网络中如何分配流量,以满足特定条件,例如流量的最大化。解决这类问题的算法包括Ford-Fulkerson算法和Dinic算法。
4.2.2 图论中的经典算法及其应用
图论中的许多经典算法都与网络设计、路径规划等领域紧密相关。除了Dijkstra算法和Floyd算法,还有如A*搜索算法、Prim和Kruskal算法等,这些算法在解决实际问题中有着广泛的应用。
A*搜索算法是一种启发式搜索算法,在路径查找中应用广泛,特别是在游戏开发和机器人导航中,它能够帮助找到从起点到终点的最短路径。
Prim和Kruskal算法主要用于最小生成树的构造,即在加权连通图中找到一棵包含所有顶点的树,其总边的权值尽可能小。最小生成树在诸如电路设计、网络设计等领域有着重要的应用。
在本章节中,我们详细介绍了图的存储表示方法、图的遍历技术以及图结构的特殊问题分析,展示了图结构的复杂性和多样性。通过理解图的表示方法和遍历技术,我们可以有效地分析图结构,并通过应用图论中的经典算法解决实际问题。
5. 查找与排序技术
查找和排序是数据结构与算法中不可或缺的两个主题,它们是解决日常编程问题的基础工具。在本章节中,我们将深入了解查找技术的实现与优化,以及对排序算法的原理和性能进行分析。
5.1 查找技术的实现与优化
5.1.1 顺序查找和二分查找的原理
顺序查找是最基础的查找技术,它简单地遍历数据集中的每个元素,直到找到目标值。其时间复杂度为O(n),在最坏的情况下,需要遍历整个数据集。
顺序查找伪代码:
for i from 0 to n-1:
    if data[i] == target:
        return i
return -1
与顺序查找相比,二分查找大幅提高了查找效率。二分查找要求数据集已经是排序状态,通过不断地将待查找区间分成两半,直到找到目标值或区间为空。二分查找的时间复杂度为O(log n)。
二分查找伪代码:
left = 0
right = n - 1
while left <= right:
    mid = (left + right) / 2
    if data[mid] == target:
        return mid
    if data[mid] < target:
        left = mid + 1
    else:
        right = mid - 1
return -1
5.1.2 哈希表查找的机制与应用
哈希表通过哈希函数将关键字映射到表中的位置。在理想情况下,哈希表的查找时间复杂度为O(1),这是因为关键字的存储位置和它的值直接相关。哈希表在处理大量数据时表现出色,尤其是在数据库和搜索引擎的应用中。
哈希表的查找过程: 1. 应用哈希函数,计算关键字的哈希值。 2. 根据哈希值定位到哈希表中的索引位置。 3. 在该位置及其附近查找实际存储的关键字。
然而,哈希表也面临哈希冲突的问题。解决哈希冲突的方法有链地址法和开放地址法等。
5.2 排序算法的原理与性能分析
5.2.1 常见排序算法:冒泡排序、快速排序
冒泡排序是一种简单的排序算法,它重复地遍历要排序的数列,一次比较两个元素,如果它们的顺序错误就把它们交换过来。重复进行直到没有再需要交换,也就是数列已经排序完成。冒泡排序的时间复杂度为O(n^2),适用于小规模数据。
冒泡排序伪代码:
for i from 0 to n-1:
    for j from 0 to n-i-2:
        if data[j] > data[j+1]:
            swap(data[j], data[j+1])
快速排序则是现代算法竞赛和编程中广泛使用的一种高效排序算法。它选择一个元素作为基准点(pivot),通过一趟排序将待排序的数据分割成独立的两部分,其中一部分的所有数据都比另一部分的所有数据要小,然后再按此方法对这两部分数据分别进行快速排序,整个排序过程可以递归进行。
快速排序伪代码:
quickSort(data, low, high):
    if low < high:
        pivot_index = partition(data, low, high)
        quickSort(data, low, pivot_index - 1)
        quickSort(data, pivot_index + 1, high)

partition(data, low, high):
    pivot = data[high]
    i = low - 1
    for j from low to high-1:
        if data[j] <= pivot:
            i = i + 1
            swap(data[i], data[j])
    swap(data[i + 1], data[high])
    return i + 1
5.2.2 各排序算法的性能比较与应用场景
不同的排序算法有着各自的优势和局限性。例如,冒泡排序和插入排序在小数据量上表现不错,但不适合大数据集;快速排序在平均情况下有很好的性能,但在最坏情况下会退化到O(n^2);归并排序和堆排序在所有情况下都能保持稳定的O(n log n)时间复杂度,适合大数据集的排序。
下面是一个性能比较的表格:
| 排序算法 | 最好时间复杂度 | 平均时间复杂度 | 最坏时间复杂度 | 空间复杂度 | | --------- | -------------- | -------------- | -------------- | ---------- | | 冒泡排序 | O(n) | O(n^2) | O(n^2) | O(1) | | 快速排序 | O(n log n) | O(n log n) | O(n^2) | O(log n) | | 归并排序 | O(n log n) | O(n log n) | O(n log n) | O(n) | | 堆排序 | O(n log n) | O(n log n) | O(n log n) | O(1) |
对于应用场景而言,如果对稳定性有要求,则应选择归并排序;如果对空间复杂度有要求,则应选择快速排序或堆排序;如果是小规模数据集,则可以考虑冒泡排序或插入排序。
总结来说,不同的查找和排序算法有其不同的使用场景,选择合适的算法可以极大提高程序的效率和响应速度。在实际开发中,合理运用这些技术,可以帮助开发者构建更高效、更健壮的应用程序。
简介:本资源提供了《殷人昆数据结构》课程第1至第10章课后习题的详尽解答,帮助学生深入理解数据结构的基础知识和应用。涵盖了数组、链表、栈、队列、树形结构、图结构、查找与排序算法等关键数据结构知识点,以及动态数据结构和高级数据结构等内容。通过解答习题,学生能够巩固理论知识,提升编程中的问题解决能力。
更多推荐

 17
 0
- 0


 已为社区贡献8条内容

所有评论(0)