
ShardingSphere5分库分表(详细)
学习
ShardingSphere-ShardingSphere基本介绍及核心概念
【SpringBoot高级篇】SpringBoot集成Sharding-JDBC分库分表
文章目录
- 学习
- 第01章 高性能架构模式
- 第02章 ShardingSphere
- 安装Docker环境(前置)
- 第03章 MySQL主从同步
- 第04章 ShardingSphere-JDBC读写分离
- 第05章 ShardingSphere-JDBC垂直分片
- 第06章 ShardingSphere-JDBC水平分片
- 第07章 启动ShardingSphere-Proxy
- 第08章 ShardingSphere-Proxy读写分离
- 第09章 ShardingSphere-Proxy垂直分片
- 第10章 ShardingSphere-Proxy水平分片
第01章 高性能架构模式
互联网业务兴起之后,海量用户加上海量数据的特点,单个数据库服务器已经难以满足业务需要,必须考虑数据库集群的方式来提升性能。
高性能数据库集群的第一种方式是“读写分离”,第二种方式是“数据库分片”。
1、读写分离架构
读写分离原理
读写分离的基本原理是将数据库读写操作分散到不同的节点上,下面是其基本架构图:

读写分离的基本实现
主库负责处理事务性的增删改操作,从库负责处理查询操作,能够有效的避免由数据更新导致的行锁,使得整个系统的查询性能得到极大的改善。- 读写分离是
根据 SQL 语义的分析,将读操作和写操作分别路由至主库与从库。 - 通过
一主多从的配置方式,可以将查询请求均匀的分散到多个数据副本,能够进一步的提升系统的处理能力。 - 使用
多主多从的方式,不但能够提升系统的吞吐量,还能够提升系统的可用性,可以达到在任何一个数据库宕机,甚至磁盘物理损坏的情况下仍然不影响系统的正常运行。
下图展示了根据业务需要,将用户表的写操作和读操路由到不同的数据库的方案:

CAP 理论
CAP 定理(CAP theorem)又被称作布鲁尔定理(Brewer’s theorem),是加州大学伯克利分校的计算机科学家埃里克·布鲁尔(Eric Brewer)在 2000 年的 ACM PODC 上提出的一个猜想。对于设计分布式系统的架构师来说,CAP 是必须掌握的理论。
在一个分布式系统中,当涉及读写操作时,只能保证一致性(Consistence)、可用性(Availability)、分区容错性(Partition Tolerance)三者中的两个,另外一个必须被牺牲。
- C 一致性(Consistency):对某个指定的客户端来说,读操作保证能够返回最新的写操作结果
- A 可用性(Availability):非故障的节点在合理的时间内返回合理的响应
(不是错误和超时的响应) - P 分区容忍性(Partition Tolerance):当出现网络分区后
(可能是丢包,也可能是连接中断,还可能是拥塞),系统能够继续“履行职责”
CAP特点
-
在实际设计过程中,每个系统不可能只处理一种数据,而是包含多种类型的数据,
有的数据必须选择 CP,有的数据必须选择 AP,分布式系统理论上不可能选择 CA 架构。- CP:如下图所示,
为了保证一致性,当发生分区现象后,N1 节点上的数据已经更新到 y,但由于 N1 和 N2 之间的复制通道中断,数据 y 无法同步到 N2,N2 节点上的数据还是 x。这时客户端 C 访问 N2 时,N2 需要返回 Error,提示客户端 C“系统现在发生了错误”,这种处理方式违背了可用性(Availability)的要求,因此 CAP 三者只能满足 CP。

- AP:如下图所示,
为了保证可用性,当发生分区现象后,N1 节点上的数据已经更新到 y,但由于 N1 和 N2 之间的复制通道中断,数据 y 无法同步到 N2,N2 节点上的数据还是 x。这时客户端 C 访问 N2 时,N2 将当前自己拥有的数据 x 返回给客户端 C 了,而实际上当前最新的数据已经是 y 了,这就不满足一致性(Consistency)的要求了,因此 CAP 三者只能满足 AP。注意:这里 N2 节点返回 x,虽然不是一个“正确”的结果,但是一个“合理”的结果,因为 x 是旧的数据,并不是一个错乱的值,只是不是最新的数据而已。
- CP:如下图所示,

-
CAP 理论中的
C 在实践中是不可能完美实现的,在数据复制的过程中,节点N1 和节点 N2 的数据并不一致(强一致性)。即使无法做到强一致性,但应用可以采用适合的方式达到最终一致性。具有如下特点:- 基本可用(Basically Available):分布式系统在出现故障时,允许损失部分可用性,即保证核心可用。
- 软状态(Soft State):允许系统存在中间状态,而该中间状态不会影响系统整体可用性。这里的中间状态就是 CAP 理论中的数据不一致。
最终一致性(Eventual Consistency):系统中的所有数据副本经过一定时间后,最终能够达到一致的状态。
2、数据库分片架构
读写分离的问题:
读写分离分散了数据库读写操作的压力,但没有分散存储压力,为了满足业务数据存储的需求,就需要将存储分散到多台数据库服务器上。
数据分片:
将存放在单一数据库中的数据分散地存放至多个数据库或表中,以达到提升性能瓶颈以及可用性的效果。 数据分片的有效手段是对关系型数据库进行分库和分表。数据分片的拆分方式又分为垂直分片和水平分片。
2.1、垂直分片
垂直分库
按照业务拆分的方式称为垂直分片,又称为纵向拆分,它的核心理念是专库专用。 在拆分之前,一个数据库由多个数据表构成,每个表对应着不同的业务。而拆分之后,则是按照业务将表进行归类,分布到不同的数据库中,从而将压力分散至不同的数据库。

下图展示了根据业务需要,将用户表和订单表垂直分片到不同的数据库的方案:

垂直拆分可以缓解数据量和访问量带来的问题,但无法根治。如果垂直拆分之后,表中的数据量依然超过单节点所能承载的阈值,则需要水平分片来进一步处理。
垂直分表
垂直分表适合将表中某些不常用的列,或者是占了大量空间的列拆分出去。
假设我们是一个婚恋网站,用户在筛选其他用户的时候,主要是用 age 和 sex 两个字段进行查询,而 nickname 和 description 两个字段主要用于展示,一般不会在业务查询中用到。description 本身又比较长,因此我们可以将这两个字段独立到另外一张表中,这样在查询 age 和 sex 时,就能带来一定的性能提升。
垂直分表引入的复杂性主要体现在表操作的数量要增加。例如,原来只要一次查询就可以获取 name、age、sex、nickname、description,现在需要两次查询,一次查询获取 name、age、sex,另外一次查询获取 nickname、description。

水平分表适合表行数特别大的表,水平分表属于水平分片。
2.2、水平分片
水平分片又称为横向拆分。 相对于垂直分片,它不再将数据根据业务逻辑分类,而是通过某个字段(或某几个字段),根据某种规则将数据分散至多个库或表中,每个分片仅包含数据的一部分。 例如:根据主键分片,偶数主键的记录放入 0 库(或表),奇数主键的记录放入 1 库(或表),如下图所示。

单表进行切分后,是否将多个表分散在不同的数据库服务器中,可以根据实际的切分效果来确定。
水平分表
单表切分为多表后,新的表即使在同一个数据库服务器中,也可能带来可观的性能提升,如果性能能够满足业务要求,可以不拆分到多台数据库服务器,毕竟业务分库也会引入很多复杂性(比如事务控制);
水平分库
如果单表拆分为多表后,单台服务器依然无法满足性能要求,那就需要将多个表分散在不同的数据库服务器中。
阿里巴巴Java开发手册:
【推荐】单表行数超过 500 万行或者单表容量超过 2GB,才推荐进行分库分表。
说明:如果预计三年后的数据量根本达不到这个级别,
请不要在创建表时就分库分表。
3、读写分离和数据分片架构
下图展现了将数据分片与读写分离一同使用时,应用程序与数据库集群之间的复杂拓扑关系。

4、实现方式
读写分离和数据分片具体的实现方式一般有两种: 程序代码封装和中间件封装。
程序代码封装
程序代码封装指在代码中抽象一个数据访问层(或中间层封装),实现读写操作分离和数据库服务器连接的管理。
**其基本架构是:**以读写分离为例

中间件封装
中间件封装指的是独立一套系统出来,实现读写操作分离和数据库服务器连接的管理。对于业务服务器来说,访问中间件和访问数据库没有区别,在业务服务器看来,中间件就是一个数据库服务器。
**基本架构是:**以读写分离为例

常用解决方案
Apache ShardingSphere(程序级别和中间件级别)
MyCat(数据库中间件)
第02章 ShardingSphere
1、简介
官网:https://shardingsphere.apache.org/index_zh.html
文档:https://shardingsphere.apache.org/document/5.1.1/cn/overview/
Apache ShardingSphere 由 JDBC、Proxy 和 Sidecar(规划中)这 3 款既能够独立部署,又支持混合部署配合使用的产品组成。
2、ShardingSphere-JDBC
程序代码封装
定位为轻量级 Java 框架,在 Java 的 JDBC 层提供的额外服务。 它使用客户端直连数据库,以 jar 包形式提供服务,无需额外部署和依赖,可理解为增强版的 JDBC 驱动,完全兼容 JDBC 和各种 ORM 框架。

3、ShardingSphere-Proxy
中间件封装
定位为透明化的数据库代理端,提供封装了数据库二进制协议的服务端版本,用于完成对异构语言的支持。 目前提供 MySQL 和 PostgreSQL版本,它可以使用任何兼容 MySQL/PostgreSQL 协议的访问客户端(如:MySQL Command Client, MySQL Workbench, Navicat 等)操作数据,对 DBA 更加友好。

安装Docker环境(前置)
一、安装准备
1、前提条件
-
Docker可以运行在Windows、Mac、CentOS、Ubuntu等操作系统上
-
Docker支持以下的CentOS版本:
-
- CentOS 7 (64-bit)
- CentOS 6.5 (64-bit) 或更高的版本
-
目前,CentOS 仅发行版本中的内核支持 Docker
-
- Docker 运行在 CentOS 7 上,要求系统为64位、系统内核版本为 3.10 以上。
- Docker 运行在 CentOS-6.5 或更高的版本的 CentOS 上,要求系统为64位、系统内核版本为 2.6.32-431 或者更高版本。
2、查看系统内核
uname命令用于打印当前系统相关信息(内核版本号、硬件架构、主机名称和操作系统类型等)。
uname -r
3、查看已安装的CentOS版本信息
cat /etc/redhat-release
二、CentOS7安装docker
官网:http://www.docker.com
安装手册:https://docs.docker.com/install/linux/docker-ce/centos(CE-社区版)
1、安装需要的软件包
yy -utils提供了yy-config-manager相关功能,device-mapper-persistent-data和lvm2是设备映射器驱动程序所需要的。
yum install -y yum-utils \
               device-mapper-persistent-data \
               lvm2
2、设置docker下载镜像
推荐阿里云下载地址
yum-config-manager --add-repo http://mirrors.aliyun.com/docker-ce/linux/centos/docker-ce.repo
3、更新yum软件包索引
我们在更新或配置yum源之后,通常都会使用yum makecache 生成缓存,这个命令是将软件包信息提前在本地缓存一份,用来提高搜索安装软件的速度
yum makecache fast
4、安装docker ce
yum install -y docker-ce
5、启动docker
systemctl start docker
6、版本验证
docker version
7、设置开机启动
#查看服务是否自动启动(是:enabled | 否:disabled)
systemctl list-unit-files|grep docker.service

#设置开机启动:如不是enabled可以运行如下命令设置自启动
systemctl enable docker

#重新加载服务配置
systemctl daemon-reload

#如果希望不进行自启动,运行如下命令设置
systemctl disable docker

#重新加载服务配置
systemctl daemon-reload
三、卸载
systemctl stop docker
yum remove -y docker-ce
rm -rf /var/lib/docker
第03章 MySQL主从同步
1、MySQL主从同步原理

基本原理
slave会从master读取binlog来进行数据同步
具体步骤
step1:master将数据改变记录到二进制日志(binary log)中。step2:当slave上执行start slave命令之后,slave会创建一个IO 线程用来连接master,请求master中的binlog。step3:当slave连接master时,master会创建一个log dump 线程,用于发送 binlog 的内容。在读取 binlog 的内容的操作中,会对主节点上的 binlog 加锁,当读取完成并发送给从服务器后解锁。step4:IO 线程接收主节点 binlog dump 进程发来的更新之后,保存到中继日志(relay log)中。step5:slave的SQL线程,读取relay log日志,并解析成具体操作,从而实现主从操作一致,最终数据一致。
2、一主多从配置
服务器规划:使用docker方式创建,主从服务器IP一致,端口号不一致

- 主服务器:容器名
atguigu-mysql-master,端口3306 - 从服务器:容器名
atguigu-mysql-slave1,端口3307 - 从服务器:容器名
atguigu-mysql-slave2,端口3308
**注意:**如果此时防火墙是开启的,则先关闭防火墙,并重启docker,否则后续安装的MySQL无法启动
#关闭docker
systemctl stop docker

#关闭防火墙
systemctl stop firewalld

#启动docker
systemctl start docker
2.1、准备主服务器
- step1:在docker中创建并启动MySQL主服务器:
端口3306
docker run -d \
-p 3306:3306 \
-v /atguigu/mysql/master/conf:/etc/mysql/conf.d \
-v /atguigu/mysql/master/data:/var/lib/mysql \
-e MYSQL_ROOT_PASSWORD=123456 \
--name atguigu-mysql-master \
mysql:8.0.29
(遇到的问题:这个镜像拉不下来,就使用的docker pull mysql:5.7,其它的命令都与上面相同)
- step2:创建MySQL主服务器配置文件:
默认情况下MySQL的binlog日志是自动开启的,可以通过如下配置定义一些可选配置
vim /atguigu/mysql/master/conf/my.cnf
配置如下内容
[mysqld]
# 服务器唯一id,默认值1
server-id=1
# 设置日志格式,默认值ROW
binlog_format=STATEMENT
# 二进制日志名,默认binlog
log-bin=binlog
# 设置需要复制的数据库,默认复制全部数据库
#binlog-do-db=mytestdb
# 设置不需要复制的数据库
#binlog-ignore-db=mysql
#binlog-ignore-db=infomation_schema
重启MySQL容器
docker restart atguigu-mysql-master
binlog格式说明:
- binlog_format=STATEMENT:日志记录的是主机数据库的
写指令,性能高,但是now()之类的函数以及获取系统参数的操作会出现主从数据不同步的问题。 - binlog_format=ROW(默认):日志记录的是主机数据库的
写后的数据,批量操作时性能较差,解决now()或者 user()或者 @@hostname 等操作在主从机器上不一致的问题。 - binlog_format=MIXED:是以上两种level的混合使用,有函数用ROW,没函数用STATEMENT,但是无法识别系统变量
binlog-ignore-db和binlog-do-db的优先级问题:

- step3:使用命令行登录MySQL主服务器:
#进入容器:env LANG=C.UTF-8 避免容器中显示中文乱码
docker exec -it atguigu-mysql-master env LANG=C.UTF-8 /bin/bash

#进入容器内的mysql命令行
mysql -uroot -p

#修改默认密码校验方式
ALTER USER 'root'@'%' IDENTIFIED WITH mysql_native_password BY '123456';
- step4:主机中创建slave用户:
-- 创建slave用户
CREATE USER 'atguigu_slave'@'%';

-- 设置密码
ALTER USER 'atguigu_slave'@'%' IDENTIFIED WITH mysql_native_password BY '123456';

-- 授予复制权限
GRANT REPLICATION SLAVE ON *.* TO 'atguigu_slave'@'%';

-- 刷新权限
FLUSH PRIVILEGES;
- step5:主机中查询master状态:
执行完此步骤后不要再操作主服务器MYSQL,防止主服务器状态值变化
SHOW MASTER STATUS;
记下File和Position的值。执行完此步骤后不要再操作主服务器MYSQL,防止主服务器状态值变化。

(这里遇到的问题:mysql show master status 显示empty set,解决方法:https://blog.csdn.net/m0_61986612/article/details/126659483,my.cnf文件添加log-bin=mysql-bin,来开启binlog日志,然后重启容器)
2.2、准备从服务器
可以配置多台从机slave1、slave2…,这里以配置slave1为例
- step1:在docker中创建并启动MySQL从服务器:
端口3307
docker run -d \
-p 3307:3306 \
-v /atguigu/mysql/slave1/conf:/etc/mysql/conf.d \
-v /atguigu/mysql/slave1/data:/var/lib/mysql \
-e MYSQL_ROOT_PASSWORD=123456 \
--name atguigu-mysql-slave1 \
mysql:8.0.29
- step2:创建MySQL从服务器配置文件:
vim /atguigu/mysql/slave1/conf/my.cnf
配置如下内容:
[mysqld]
# 服务器唯一id,每台服务器的id必须不同,如果配置其他从机,注意修改id
server-id=2
# 中继日志名,默认xxxxxxxxxxxx-relay-bin
relay-log=relay-bin
重启MySQL容器
docker restart atguigu-mysql-slave1
- step3:使用命令行登录MySQL从服务器:
#进入容器:
docker exec -it atguigu-mysql-slave1 env LANG=C.UTF-8 /bin/bash

#进入容器内的mysql命令行
mysql -uroot -p

#修改默认密码校验方式
ALTER USER 'root'@'%' IDENTIFIED WITH mysql_native_password BY '123456';
- step4:在从机上配置主从关系:
在从机上执行以下SQL操作
CHANGE MASTER TO MASTER_HOST='192.168.100.201',
MASTER_USER='atguigu_slave',MASTER_PASSWORD='123456', MASTER_PORT=3306,
MASTER_LOG_FILE='binlog.000003',MASTER_LOG_POS=1357;
2.3、启动主从同步
启动从机的复制功能,执行SQL:
START SLAVE;
-- 查看状态(不需要分号)
SHOW SLAVE STATUS\G
**两个关键进程:**下面两个参数都是Yes,则说明主从配置成功!

2.4、实现主从同步
在主机中执行以下SQL,在从机中查看数据库、表和数据是否已经被同步
CREATE DATABASE db_user;
USE db_user;
CREATE TABLE t_user (
 id BIGINT AUTO_INCREMENT,
 uname VARCHAR(30),
 PRIMARY KEY (id)
);
INSERT INTO t_user(uname) VALUES('zhang3');
INSERT INTO t_user(uname) VALUES(@@hostname);
2.5、停止和重置
需要的时候,可以使用如下SQL语句
-- 在从机上执行。功能说明:停止I/O 线程和SQL线程的操作。
stop slave;

-- 在从机上执行。功能说明:用于删除SLAVE数据库的relaylog日志文件,并重新启用新的relaylog文件。
reset slave;

-- 在主机上执行。功能说明:删除所有的binglog日志文件,并将日志索引文件清空,重新开始所有新的日志文件。
-- 用于第一次进行搭建主从库时,进行主库binlog初始化工作;
reset master;
2.6、常见问题
问题1
启动主从同步后,常见错误是Slave_IO_Running: No 或者 Connecting 的情况,此时查看下方的 Last_IO_ERROR错误日志,根据日志中显示的错误信息在网上搜索解决方案即可

典型的错误例如:Last_IO_Error: Got fatal error 1236 from master when reading data from binary log: 'Client requested master to start replication from position > file size'
解决方案:
-- 在从机停止slave
SLAVE STOP;

-- 在主机查看mater状态
SHOW MASTER STATUS;
-- 在主机刷新日志
FLUSH LOGS;
-- 再次在主机查看mater状态(会发现File和Position发生了变化)
SHOW MASTER STATUS;
-- 修改从机连接主机的SQL,并重新连接即可
问题2
启动docker容器后提示 WARNING: IPv4 forwarding is disabled. Networking will not work.

此错误,虽然不影响主从同步的搭建,但是如果想从远程客户端通过以下方式连接docker中的MySQL则没法连接
C:\Users\administrator>mysql -h 192.168.100.201 -P 3306 -u root -p
解决方案:
#修改配置文件:
vim /usr/lib/sysctl.d/00-system.conf
#追加
net.ipv4.ip_forward=1
#接着重启网络
systemctl restart network
主从复制成功

第04章 ShardingSphere-JDBC读写分离
简述
现有master,slave1,slave2三个mysql节点,master是主节点,slave1和slave2都配置为master的从节点,并开启了主从同步,写操作都路由到主节点,读操作分摊到从节点(可开启事务强制走主节点)
1、创建SpringBoot程序
1.1、创建项目
项目类型:Spring Initializr
SpringBoot脚手架:http://start.aliyun.com
项目名:sharding-jdbc-demo
SpringBoot版本:2.3.7.RELEASE
1.2、添加依赖
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0
                             http://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>

    <groupId>com.zzhua</groupId>
    <artifactId>demo-shardingsphere-jdbc</artifactId>
    <version>1.0-SNAPSHOT</version>

    <properties>
        <java.version>1.8</java.version>
        <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
        <project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding>
        <spring-boot.version>2.3.7.RELEASE</spring-boot.version>
    </properties>

    <dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>

        <dependency>
            <groupId>org.apache.shardingsphere</groupId>
            <artifactId>shardingsphere-jdbc-core-spring-boot-starter</artifactId>
            <version>5.1.1</version>
        </dependency>

        <dependency>
            <groupId>mysql</groupId>
            <artifactId>mysql-connector-java</artifactId>
            <scope>runtime</scope>
        </dependency>

        <dependency>
            <groupId>com.baomidou</groupId>
            <artifactId>mybatis-plus-boot-starter</artifactId>
            <version>3.3.1</version>
        </dependency>

        <dependency>
            <groupId>org.projectlombok</groupId>
            <artifactId>lombok</artifactId>
            <optional>true</optional>
        </dependency>

        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-test</artifactId>
            <scope>test</scope>
            <exclusions>
                <exclusion>
                    <groupId>org.junit.vintage</groupId>
                    <artifactId>junit-vintage-engine</artifactId>
                </exclusion>
            </exclusions>
        </dependency>

    </dependencies>


    <dependencyManagement>
        <dependencies>
            <dependency>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-dependencies</artifactId>
                <version>${spring-boot.version}</version>
                <type>pom</type>
                <scope>import</scope>
            </dependency>
        </dependencies>
    </dependencyManagement>

    <build>
        <plugins>
            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-compiler-plugin</artifactId>
                <version>3.8.1</version>
                <configuration>
                    <source>1.8</source>
                    <target>1.8</target>
                    <encoding>UTF-8</encoding>
                </configuration>
            </plugin>
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maven-plugin</artifactId>
                <version>2.3.7.RELEASE</version>
                <configuration>
                    <mainClass>com.zzhua.ShardingsphereApp</mainClass>
                </configuration>
                <executions>
                    <execution>
                        <id>repackage</id>
                        <goals>
                            <goal>repackage</goal>
                        </goals>
                    </execution>
                </executions>
            </plugin>
        </plugins>
    </build>


</project>
1.3、创建实体类
package com.atguigu.shardingjdbcdemo.entity;

@TableName("t_user")
@Data
public class User {
    @TableId(type = IdType.AUTO)
    private Long id;
    private String uname;
}
1.4、创建Mapper
package com.atguigu.shardingjdbcdemo.mapper;

@Mapper
public interface UserMapper extends BaseMapper<User> {
}
1.5、配置读写分离
application.properties:
# 应用名称
spring.application.name=demo-shardingsphere-jdbc
# 开发环境设置
spring.profiles.active=dev
# 运行模式, 此处选择内存模式
spring.shardingsphere.mode.type=Memory

# 配置真实数据源
spring.shardingsphere.datasource.names=master,slave1,slave2

# 配置第 1 个数据源
spring.shardingsphere.datasource.master.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.master.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.master.jdbc-url=jdbc:mysql://119.23.61.24:3306/db_user?useUnicode=true&characterEncoding=UTF-8
spring.shardingsphere.datasource.master.username=root
spring.shardingsphere.datasource.master.password=123456

# 配置第 2 个数据源
spring.shardingsphere.datasource.slave1.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.slave1.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.slave1.jdbc-url=jdbc:mysql://119.23.61.24:3307/db_user?useUnicode=true&characterEncoding=UTF-8
spring.shardingsphere.datasource.slave1.username=root
spring.shardingsphere.datasource.slave1.password=123456

# 配置第 3 个数据源
spring.shardingsphere.datasource.slave2.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.slave2.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.slave2.jdbc-url=jdbc:mysql://119.23.61.24:3308/db_user?useUnicode=true&characterEncoding=UTF-8
spring.shardingsphere.datasource.slave2.username=root
spring.shardingsphere.datasource.slave2.password=123456

# 读写分离类型,如: Static,Dynamic
spring.shardingsphere.rules.readwrite-splitting.data-sources.myds.type= Static
# 写数据源名称
spring.shardingsphere.rules.readwrite-splitting.data-sources.myds.props.write-data-source-name=master
# 读数据源名称,多个从数据源用逗号分隔
spring.shardingsphere.rules.readwrite-splitting.data-sources.myds.props.read-data-source-names=slave1,slave2

# 负载均衡算法名称(在此处切换下面配置的算法名称即可)
spring.shardingsphere.rules.readwrite-splitting.data-sources.myds.load-balancer-name=alg_round

# 负载均衡算法配置
# 负载均衡算法类型
spring.shardingsphere.rules.readwrite-splitting.load-balancers.alg_round.type=ROUND_ROBIN
spring.shardingsphere.rules.readwrite-splitting.load-balancers.alg_random.type=RANDOM
spring.shardingsphere.rules.readwrite-splitting.load-balancers.alg_weight.type=WEIGHT
spring.shardingsphere.rules.readwrite-splitting.load-balancers.alg_weight.props.slave1=1
spring.shardingsphere.rules.readwrite-splitting.load-balancers.alg_weight.props.slave2=2


# 打印SQl
spring.shardingsphere.props.sql-show=true
2、测试
2.1、读写分离测试
package com.atguigu.shardingjdbcdemo;

@SpringBootTest(classes = ShardingsphereApp.class)
class ReadwriteTest {

    @Autowired
    private UserMapper userMapper;

    /**
     * 读写分离:写入数据的测试
     */
    @Test
    public void testInsert(){

        User user = new User();
        user.setUname("张三丰");
        userMapper.insert(user);
    }

}
可以从日志中看到插入的实际数据库为master主节点,然后数据会同步到mysql从节点

2.2、事务测试
为了保证主从库间的事务一致性,避免跨服务的分布式事务,ShardingSphere-JDBC的主从模型中,事务中的数据读写均用主库。
- 不添加@Transactional:insert对主库操作,select对从库操作
- 添加@Transactional:则insert和select均对主库操作
- 所以可以加@Transactional注解来强制走主库
/**
  * 读写分离:事务测试
  */
@Transactional//开启事务
@Test
public void testTrans(){

    User user = new User();
    user.setUname("铁锤");
    userMapper.insert(user);

    List<User> users = userMapper.selectList(null);
}
测试1结果:

测试2结果(**注意个小问题:**在JUnit环境下的@Transactional注解,默认情况下就会对事务进行回滚(即使在没加注解@Rollback,也会对事务回滚)):

2.3、负载均衡测试
/**
  * 读写分离:负载均衡测试
  */
@Test
public void testSelectAll(){
    List<User> users = userMapper.selectList(null);
    List<User> users = userMapper.selectList(null);
    List<User> users = userMapper.selectList(null);
    List<User> users = userMapper.selectList(null);
}

也可以在web请求中测试负载均衡
package com.atguigu.shardingjdbcdemo.controller;

@RestController
@RequestMapping("/userController")
public class UserController {

    @Autowired
    private UserMapper userMapper;

    /**
     * 测试负载均衡策略
     */
    @GetMapping("selectAll")
    public void selectAll(){
        List<User> users = userMapper.selectList(null);
        users.forEach(System.out::println);
    }
}
第05章 ShardingSphere-JDBC垂直分片
简述
t_user表在db_user库,t_order在db_order库,现在使用shardingsphere的配置,当对这2张表的sql操作都路由到正确的库中
1、准备服务器
服务器规划:使用docker方式创建如下容器

-
服务器:容器名
server-user,端口3301 -
服务器:容器名
server-order,端口3302
1.1、创建server-user容器
- step1:创建容器:
docker run -d \
-p 3301:3306 \
-v /atguigu/server/user/conf:/etc/mysql/conf.d \
-v /atguigu/server/user/data:/var/lib/mysql \
-e MYSQL_ROOT_PASSWORD=123456 \
--name server-user \
mysql:8.0.29
- step2:登录MySQL服务器:
#进入容器:
docker exec -it server-user env LANG=C.UTF-8 /bin/bash

#进入容器内的mysql命令行
mysql -uroot -p

#修改默认密码插件
ALTER USER 'root'@'%' IDENTIFIED WITH mysql_native_password BY '123456';
- step3:创建数据库:
CREATE DATABASE db_user;
USE db_user;
CREATE TABLE t_user (
 id BIGINT AUTO_INCREMENT,
 uname VARCHAR(30),
 PRIMARY KEY (id)
);
1.2、创建server-order容器
- step1:创建容器:
docker run -d \
-p 3302:3306 \
-v /atguigu/server/order/conf:/etc/mysql/conf.d \
-v /atguigu/server/order/data:/var/lib/mysql \
-e MYSQL_ROOT_PASSWORD=123456 \
--name server-order \
mysql:8.0.29
- step2:登录MySQL服务器:
#进入容器:
docker exec -it server-order env LANG=C.UTF-8 /bin/bash

#进入容器内的mysql命令行
mysql -uroot -p

#修改默认密码插件
ALTER USER 'root'@'%' IDENTIFIED WITH mysql_native_password BY '123456';
- step3:创建数据库:
CREATE DATABASE db_order;
USE db_order;
CREATE TABLE t_order (
  id BIGINT AUTO_INCREMENT,
  order_no VARCHAR(30),
  user_id BIGINT,
  amount DECIMAL(10,2),
  PRIMARY KEY(id)
);
2、程序实现
2.1、创建实体类
package com.atguigu.shardingjdbcdemo.entity;

@TableName("t_order")
@Data
public class Order {
    @TableId(type = IdType.AUTO)
    private Long id;
    private String orderNo;
    private Long userId;
    private BigDecimal amount;
}
2.2、创建Mapper
package com.atguigu.shardingjdbcdemo.mapper;

@Mapper
public interface OrderMapper extends BaseMapper<Order> {
}
2.3、配置垂直分片
# 应用名称
spring.application.name=sharding-jdbc-demo
# 环境设置
spring.profiles.active=dev

# 配置真实数据源
spring.shardingsphere.datasource.names=server-user,server-order

# 配置第 1 个数据源
spring.shardingsphere.datasource.server-user.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-user.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-user.jdbc-url=jdbc:mysql://192.168.100.201:3301/db_user
spring.shardingsphere.datasource.server-user.username=root
spring.shardingsphere.datasource.server-user.password=123456

# 配置第 2 个数据源
spring.shardingsphere.datasource.server-order.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order.jdbc-url=jdbc:mysql://192.168.100.201:3302/db_order
spring.shardingsphere.datasource.server-order.username=root
spring.shardingsphere.datasource.server-order.password=123456

# 标准分片表配置(数据节点)
# spring.shardingsphere.rules.sharding.tables.<table-name>.actual-data-nodes=值
# 值由数据源名 + 表名组成,以小数点分隔。
# <table-name>:逻辑表名
spring.shardingsphere.rules.sharding.tables.t_user.actual-data-nodes=server-user.t_user
spring.shardingsphere.rules.sharding.tables.t_order.actual-data-nodes=server-order.t_order


# 打印SQL
spring.shardingsphere.props.sql-show=true
3、测试垂直分片
package com.atguigu.shardingjdbcdemo;

@SpringBootTest
public class ShardingTest {


    @Autowired
    private UserMapper userMapper;

    @Autowired
    private OrderMapper orderMapper;

    /**
     * 垂直分片:插入数据测试
     */
    @Test
    public void testInsertOrderAndUser(){

        User user = new User();
        user.setUname("强哥");
        userMapper.insert(user);

        Order order = new Order();
        order.setOrderNo("ATGUIGU001");
        order.setUserId(user.getId());
        order.setAmount(new BigDecimal(100));
        orderMapper.insert(order);

    }

    /**
     * 垂直分片:查询数据测试
     */
    @Test
    public void testSelectFromOrderAndUser(){
        User user = userMapper.selectById(1L);
        Order order = orderMapper.selectById(1L);
    }
}


常见错误

ShardingSphere-JDBC远程连接的方式默认的密码加密规则是:mysql_native_password
因此需要在服务器端修改服务器的密码加密规则,如下:
ALTER USER 'root'@'%' IDENTIFIED WITH mysql_native_password BY '123456';
第06章 ShardingSphere-JDBC水平分片
简介
t_user表在3301端口mysql的db_user库(这个表沿用前面创建的),
t_order0和t_order1在3310端口的mysql的db_order库,
t_order0和t_order1在3311端口的mysql的db_order库(也就是说t_order表实际上被拆成了4张表,这些表分别分布在2个库的2张表中)。
1、准备服务器
服务器规划:使用docker方式创建如下容器
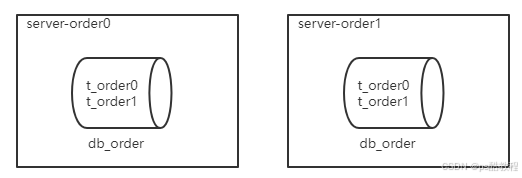
-
服务器:容器名
server-order0,端口3310 -
服务器:容器名
server-order1,端口3311
1.1、创建server-order0容器
- step1:创建容器:
docker run -d \
-p 3310:3306 \
-v /atguigu/server/order0/conf:/etc/mysql/conf.d \
-v /atguigu/server/order0/data:/var/lib/mysql \
-e MYSQL_ROOT_PASSWORD=123456 \
--name server-order0 \
mysql:8.0.29
- step2:登录MySQL服务器:
#进入容器:
docker exec -it server-order0 env LANG=C.UTF-8 /bin/bash

#进入容器内的mysql命令行
mysql -uroot -p

#修改默认密码插件
ALTER USER 'root'@'%' IDENTIFIED WITH mysql_native_password BY '123456';
- step3:创建数据库:
注意:水平分片的id需要在业务层实现,不能依赖数据库的主键自增
CREATE DATABASE db_order;
USE db_order;
CREATE TABLE t_order0 (
  id BIGINT,
  order_no VARCHAR(30),
  user_id BIGINT,
  amount DECIMAL(10,2),
  PRIMARY KEY(id)
);
CREATE TABLE t_order1 (
  id BIGINT,
  order_no VARCHAR(30),
  user_id BIGINT,
  amount DECIMAL(10,2),
  PRIMARY KEY(id)
);
1.2、创建server-order1容器
- step1:创建容器:
docker run -d \
-p 3311:3306 \
-v /atguigu/server/order1/conf:/etc/mysql/conf.d \
-v /atguigu/server/order1/data:/var/lib/mysql \
-e MYSQL_ROOT_PASSWORD=123456 \
--name server-order1 \
mysql:8.0.29
- step2:登录MySQL服务器:
#进入容器:
docker exec -it server-order1 env LANG=C.UTF-8 /bin/bash

#进入容器内的mysql命令行
mysql -uroot -p

#修改默认密码插件
ALTER USER 'root'@'%' IDENTIFIED WITH mysql_native_password BY '123456';
- **step3:创建数据库:**和server-order0相同
注意:水平分片的id需要在业务层实现,不能依赖数据库的主键自增
CREATE DATABASE db_order;
USE db_order;
CREATE TABLE t_order0 (
  id BIGINT,
  order_no VARCHAR(30),
  user_id BIGINT,
  amount DECIMAL(10,2),
  PRIMARY KEY(id)
);
CREATE TABLE t_order1 (
  id BIGINT,
  order_no VARCHAR(30),
  user_id BIGINT,
  amount DECIMAL(10,2),
  PRIMARY KEY(id)
);
2、基本水平分片
2.1、基本配置
#========================基本配置
# 应用名称
spring.application.name=sharging-jdbc-demo
# 开发环境设置
spring.profiles.active=dev
# 内存模式
spring.shardingsphere.mode.type=Memory
# 打印SQl
spring.shardingsphere.props.sql-show=true
2.2、数据源配置
#========================数据源配置
# 配置真实数据源
spring.shardingsphere.datasource.names=server-user,server-order0,server-order1

# 配置第 1 个数据源
spring.shardingsphere.datasource.server-user.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-user.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-user.jdbc-url=jdbc:mysql://119.23.61.24:3301/db_user
spring.shardingsphere.datasource.server-user.username=root
spring.shardingsphere.datasource.server-user.password=123456

# 配置第 2 个数据源
spring.shardingsphere.datasource.server-order.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order.jdbc-url=jdbc:mysql://119.23.61.24:3310/db_order
spring.shardingsphere.datasource.server-order.username=root
spring.shardingsphere.datasource.server-order.password=123456

# 配置第 3 个数据源
spring.shardingsphere.datasource.server-order.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order.jdbc-url=jdbc:mysql://119.23.61.24:3311/db_order
spring.shardingsphere.datasource.server-order.username=root
spring.shardingsphere.datasource.server-order.password=123456
2.3、标椎分片表配置
#========================标准分片表配置(数据节点配置)
# spring.shardingsphere.rules.sharding.tables.<table-name>.actual-data-nodes=值
# 值由数据源名 + 表名组成,以小数点分隔。多个表以逗号分隔,支持 inline 表达式。
# <table-name>:逻辑表名
spring.shardingsphere.rules.sharding.tables.t_user.actual-data-nodes=server-user.t_user
spring.shardingsphere.rules.sharding.tables.t_order.actual-data-nodes=server-order0.t_order0,server-order0.t_order1,server-order1.t_order0,server-order1.t_order1
修改Order实体类的主键策略:
//@TableId(type = IdType.AUTO)//依赖数据库的主键自增策略
@TableId(type = IdType.ASSIGN_ID)//分布式id
测试:保留上面配置中的一个分片表节点分别进行测试,检查每个分片节点是否可用(比如配置成:spring.shardingsphere.rules.sharding.tables.t_order.actual-data-nodes=server-order0.t_order1,当插入数据到t_order表时,会插入到server-order0库的t_order1表中)
/**
     * 水平分片:插入数据测试
     */
@Test
public void testInsertOrder(){

    Order order = new Order();
    order.setOrderNo("ATGUIGU001");
    order.setUserId(1L);
    order.setAmount(new BigDecimal(100));
    orderMapper.insert(order);
}
2.4、行表达式
优化上一步的分片表配置
https://shardingsphere.apache.org/document/5.1.1/cn/features/sharding/concept/inline-expression/
#========================标准分片表配置(数据节点配置)
# spring.shardingsphere.rules.sharding.tables.<table-name>.actual-data-nodes=值
# 值由数据源名 + 表名组成,以小数点分隔。多个表以逗号分隔,支持 inline 表达式。
# <table-name>:逻辑表名
spring.shardingsphere.rules.sharding.tables.t_user.actual-data-nodes=server-user.t_user

# 这样配置等价于如下:
# spring.shardingsphere.rules.sharding.tables.t_order.actual-data-nodes=server-order0.t_order0,server-order0.t_order1,server-order1.t_order0,server-order1.t_order1
spring.shardingsphere.rules.sharding.tables.t_order.actual-data-nodes=server-order$->{0..1}.t_order$->{0..1}
行表达式说明
-
${begin..end}表示范围区间 -
${[unit1, unit2, unit_x]}表示枚举值 -
行表达式中如果出现连续多个
${ expression }或$->{ expression }表达式,整个表达式最终的结果将会根据每个子表达式的结果进行笛卡尔组合。
示例1
例如,以下行表达式:
${['online', 'offline']}_table${1..3}
最终会解析为:
online_table1, online_table2, online_table3, offline_table1, offline_table2, offline_table3
示例2
对于均匀分布的数据节点,如果数据结构如下:
db0
  ├── t_order0
  └── t_order1
db1
  ├── t_order0
  └── t_order1
用行表达式可以简化为:
db$->{0..1}.t_order$->{0..1}
示例3
对于自定义的数据节点,如果数据结构如下:
db0
  ├── t_order0
  └── t_order1
db1
  ├── t_order2
  ├── t_order3
  └── t_order4
用行表达式可以简化为:
db0.t_order$->{0..1},db1.t_order$->{2..4}
示例4
对于自定义的数据节点,如果数据结构如下:
db0
  ├── t_order_00
  ├── t_order_01
  ├── t_order_02
  ├── t_order_03
  ├── t_order_04
  ├── t_order_05
  ├── t_order_06
  ├── t_order_07
  ├── t_order_08
  ├── t_order_09
  ├── t_order_10
  ├── t_order_11
  ├── t_order_12
  ├── t_order_13
  ├── t_order_14
  ├── t_order_15
  ├── t_order_16
  ├── t_order_17
  ├── t_order_18
  ├── t_order_19
  └── t_order_20
db1
  ├── t_order_00
  ├── t_order_01
  ├── t_order_02
  ├── t_order_03
  ├── t_order_04
  ├── t_order_05
  ├── t_order_06
  ├── t_order_07
  ├── t_order_08
  ├── t_order_09
  ├── t_order_10
  ├── t_order_11
  ├── t_order_12
  ├── t_order_13
  ├── t_order_14
  ├── t_order_15
  ├── t_order_16
  ├── t_order_17
  ├── t_order_18
  ├── t_order_19
  └── t_order_20
用行表达式可以简化为:
db$->{0..1}.t_order_0$->{0..9}, db$->{0..1}.t_order_$->{10..20}
2.5、分片算法配置
水平分库
分片规则:order表中user_id为偶数时,数据插入server-order0服务器,user_id为奇数时,数据插入server-order1服务器。这样分片的好处是,同一个用户的订单数据,一定会被插入到同一台服务器上,查询一个用户的订单时效率较高。
#------------------------分库策略
# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-column=user_id
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-algorithm-name=alg_inline_userid

#------------------------分片算法配置
# 行表达式分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.type=INLINE
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.props.algorithm-expression=server-order$->{user_id % 2}

# 取模分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_mod.type=MOD
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_mod.props.sharding-count=2
为了方便测试,先设置只在 t_order0表上进行测试
xxx.actual-data-nodes=server-order$->{0..1}.t_order0
行表达式分片算法测试
即现在的配置文件如下:
#------------------------基本配置
# 应用名称
spring.application.name=sharding-jdbc-demo
# 开发环境设置
spring.profiles.active=dev
# 内存模式
spring.shardingsphere.mode.type=Memory
# 打印SQl
spring.shardingsphere.props.sql-show=true

#------------------------数据源配置
# 配置真实数据源
spring.shardingsphere.datasource.names=server-user,server-order0,server-order1

# 配置第 1 个数据源
spring.shardingsphere.datasource.server-user.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-user.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-user.jdbc-url=jdbc:mysql://119.23.61.24:3301/db_user
spring.shardingsphere.datasource.server-user.username=root
spring.shardingsphere.datasource.server-user.password=123456

# 配置第 2 个数据源
spring.shardingsphere.datasource.server-order0.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order0.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order0.jdbc-url=jdbc:mysql://119.23.61.24:3310/db_order
spring.shardingsphere.datasource.server-order0.username=root
spring.shardingsphere.datasource.server-order0.password=123456

# 配置第 3 个数据源
spring.shardingsphere.datasource.server-order1.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order1.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order1.jdbc-url=jdbc:mysql://119.23.61.24:3311/db_order
spring.shardingsphere.datasource.server-order1.username=root
spring.shardingsphere.datasource.server-order1.password=123456

#------------------------标准分片表配置(数据节点配置,一张真实的数据库表就代表1个标准分片)
# 由数据源名 + 表名组成,以小数点分隔。多个表以逗号分隔,支持 inline 表达式。
# 缺省表示使用已知数据源与逻辑表名称生成数据节点,用于广播表(即每个库中都需要一个同样的表用于关联查询,多为字典表)或只分库不分表且所有库的表结构完全一致的情况
spring.shardingsphere.rules.sharding.tables.t_user.actual-data-nodes=server-user.t_user
# server-order0.t_order0,server-order0.t_order1,server-order1.t_order0,server-order1.t_order1
spring.shardingsphere.rules.sharding.tables.t_order.actual-data-nodes=server-order$->{0..1}.t_order0

#------------------------分库策略,缺省表示使用默认分库策略,以下的分片策略只能选其一
# 用于单分片键的标准分片场景
# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-column=user_id
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-algorithm-name=alg_inline_userid

#------------------------分片算法配置
# 行表达式分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.type=INLINE
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.props.algorithm-expression=server-order$->{user_id % 2}
测试:可以分别测试行表达式分片算法
/**
  * 水平分片:分库插入数据测试
  */
@Test
public void testInsertOrderDatabaseStrategy(){

    for (long i = 0; i < 4; i++) {
        Order order = new Order();
        order.setOrderNo("ATGUIGU001");
        order.setUserId(i + 1);
        order.setAmount(new BigDecimal(100));
        orderMapper.insert(order);
    }

}
测试结果如下:
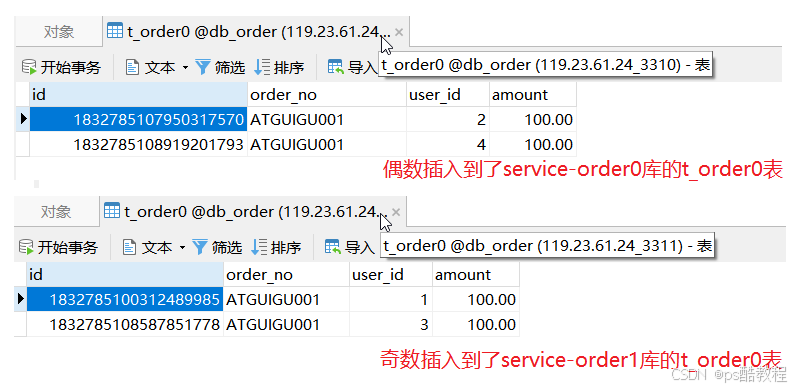
取模分片算法测试
即现在的配置文件如下(在上面的配置文件的基础上,添加取模分片算法的配置,并且修改分片算法为取模分片算法):
#------------------------基本配置
# 应用名称
spring.application.name=sharding-jdbc-demo
# 开发环境设置
spring.profiles.active=dev
# 内存模式
spring.shardingsphere.mode.type=Memory
# 打印SQl
spring.shardingsphere.props.sql-show=true

#------------------------数据源配置
# 配置真实数据源
spring.shardingsphere.datasource.names=server-user,server-order0,server-order1

# 配置第 1 个数据源
spring.shardingsphere.datasource.server-user.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-user.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-user.jdbc-url=jdbc:mysql://119.23.61.24:3301/db_user
spring.shardingsphere.datasource.server-user.username=root
spring.shardingsphere.datasource.server-user.password=123456

# 配置第 2 个数据源
spring.shardingsphere.datasource.server-order0.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order0.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order0.jdbc-url=jdbc:mysql://119.23.61.24:3310/db_order
spring.shardingsphere.datasource.server-order0.username=root
spring.shardingsphere.datasource.server-order0.password=123456

# 配置第 3 个数据源
spring.shardingsphere.datasource.server-order1.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order1.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order1.jdbc-url=jdbc:mysql://119.23.61.24:3311/db_order
spring.shardingsphere.datasource.server-order1.username=root
spring.shardingsphere.datasource.server-order1.password=123456

#------------------------标准分片表配置(数据节点配置,一张真实的数据库表就代表1个标准分片)
# 由数据源名 + 表名组成,以小数点分隔。多个表以逗号分隔,支持 inline 表达式。
# 缺省表示使用已知数据源与逻辑表名称生成数据节点,用于广播表(即每个库中都需要一个同样的表用于关联查询,多为字典表)或只分库不分表且所有库的表结构完全一致的情况
spring.shardingsphere.rules.sharding.tables.t_user.actual-data-nodes=server-user.t_user
# server-order0.t_order0,server-order0.t_order1,server-order1.t_order0,server-order1.t_order1
spring.shardingsphere.rules.sharding.tables.t_order.actual-data-nodes=server-order$->{0..1}.t_order0

#------------------------分库策略,缺省表示使用默认分库策略,以下的分片策略只能选其一
# 用于单分片键的标准分片场景
# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-column=user_id
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-algorithm-name=alg_mod

#------------------------分片算法配置
# 行表达式分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.type=INLINE
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.props.algorithm-expression=server-order$->{user_id % 2}

# 取模分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_mod.type=MOD
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_mod.props.sharding-count=2
测试:可以分别测试行表达式分片算法
/**
  * 水平分片:分库插入数据测试
  */
@Test
public void testInsertOrderDatabaseStrategy(){

    for (long i = 4; i < 8; i++) {
        Order order = new Order();
        order.setOrderNo("ATGUIGU001");
        order.setUserId(i + 1);
        order.setAmount(new BigDecimal(100));
        orderMapper.insert(order);
    }

}
测试结果如下:
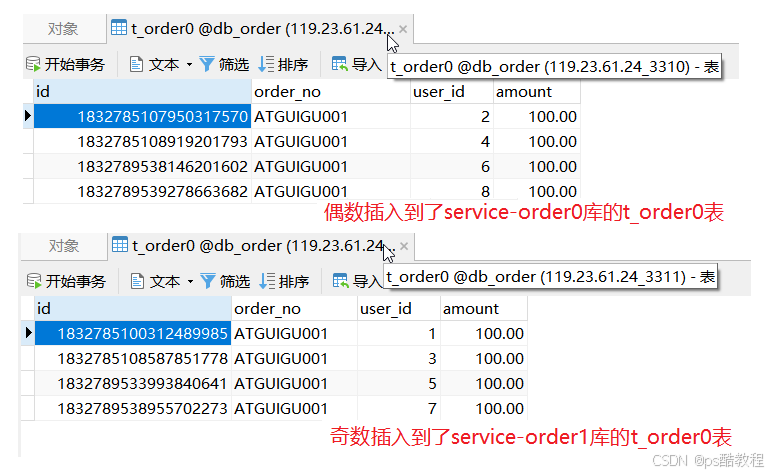
水平分表
分片规则:order表中order_no的哈希值为偶数时,数据插入对应服务器的t_order0表,order_no的哈希值为奇数时,数据插入对应服务器的t_order1表。因为order_no是字符串形式,因此不能直接取模。
#------------------------分表策略
# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order.table-strategy.standard.sharding-column=order_no
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order.table-strategy.standard.sharding-algorithm-name=alg_hash_mod


#------------------------分片算法配置
# 哈希取模分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_hash_mod.type=HASH_MOD
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_hash_mod.props.sharding-count=2
测试前不要忘记将如下节点改回原来的状态
xxx.actual-data-nodes=server-order$->{0..1}.t_order$->{0..1}
哈希分片算法测试
即现在的配置文件如下:
#------------------------基本配置
# 应用名称
spring.application.name=sharding-jdbc-demo
# 开发环境设置
spring.profiles.active=dev
# 内存模式
spring.shardingsphere.mode.type=Memory
# 打印SQl
spring.shardingsphere.props.sql-show=true

#------------------------数据源配置
# 配置真实数据源
spring.shardingsphere.datasource.names=server-user,server-order0,server-order1

# 配置第 1 个数据源
spring.shardingsphere.datasource.server-user.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-user.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-user.jdbc-url=jdbc:mysql://119.23.61.24:3301/db_user
spring.shardingsphere.datasource.server-user.username=root
spring.shardingsphere.datasource.server-user.password=123456

# 配置第 2 个数据源
spring.shardingsphere.datasource.server-order0.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order0.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order0.jdbc-url=jdbc:mysql://119.23.61.24:3310/db_order
spring.shardingsphere.datasource.server-order0.username=root
spring.shardingsphere.datasource.server-order0.password=123456

# 配置第 3 个数据源
spring.shardingsphere.datasource.server-order1.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order1.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order1.jdbc-url=jdbc:mysql://119.23.61.24:3311/db_order
spring.shardingsphere.datasource.server-order1.username=root
spring.shardingsphere.datasource.server-order1.password=123456

#------------------------标准分片表配置(数据节点配置,一张真实的数据库表就代表1个标准分片)
# 由数据源名 + 表名组成,以小数点分隔。多个表以逗号分隔,支持 inline 表达式。
# 缺省表示使用已知数据源与逻辑表名称生成数据节点,用于广播表(即每个库中都需要一个同样的表用于关联查询,多为字典表)或只分库不分表且所有库的表结构完全一致的情况
spring.shardingsphere.rules.sharding.tables.t_user.actual-data-nodes=server-user.t_user
# server-order0.t_order0,server-order0.t_order1,server-order1.t_order0,server-order1.t_order1
spring.shardingsphere.rules.sharding.tables.t_order.actual-data-nodes=server-order$->{0..1}.t_order$->{0..1}

#------------------------分库策略,缺省表示使用默认分库策略,以下的分片策略只能选其一
# 用于单分片键的标准分片场景
# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-column=user_id
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-algorithm-name=alg_mod


#------------------------分表策略
# 用于单分片键的标准分片场景
# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order.table-strategy.standard.sharding-column=order_no
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order.table-strategy.standard.sharding-algorithm-name=alg_hash_mod


#------------------------分片算法配置
# 行表达式分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.type=INLINE
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.props.algorithm-expression=server-order$->{user_id % 2}

# 取模分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_mod.type=MOD
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_mod.props.sharding-count=2

# 哈希取模分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_hash_mod.type=HASH_MOD
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_hash_mod.props.sharding-count=2
测试(针对t_order表的user_id字段作分库,针对t_order表的order_no作哈希取模来分表)
/**
  * 水平分片:分表插入数据测试
  */
@Test
public void testInsertOrderTableStrategy(){

    for (long i = 1; i < 5; i++) {

        Order order = new Order();
        order.setOrderNo("ATGUIGU" + i);
        order.setUserId(1L);
        order.setAmount(new BigDecimal(100));
        orderMapper.insert(order);
    }

    for (long i = 5; i < 9; i++) {

        Order order = new Order();
        order.setOrderNo("ATGUIGU" + i);
        order.setUserId(2L);
        order.setAmount(new BigDecimal(100));
        orderMapper.insert(order);
    }
}

/**
  * 测试哈希取模
  */
@Test
public void testHash(){

    //注意hash取模的结果是整个字符串hash后再取模,和数值后缀是奇数还是偶数无关
    System.out.println("ATGUIGU001".hashCode() % 2);
    System.out.println("ATGUIGU0011".hashCode() % 2);
}
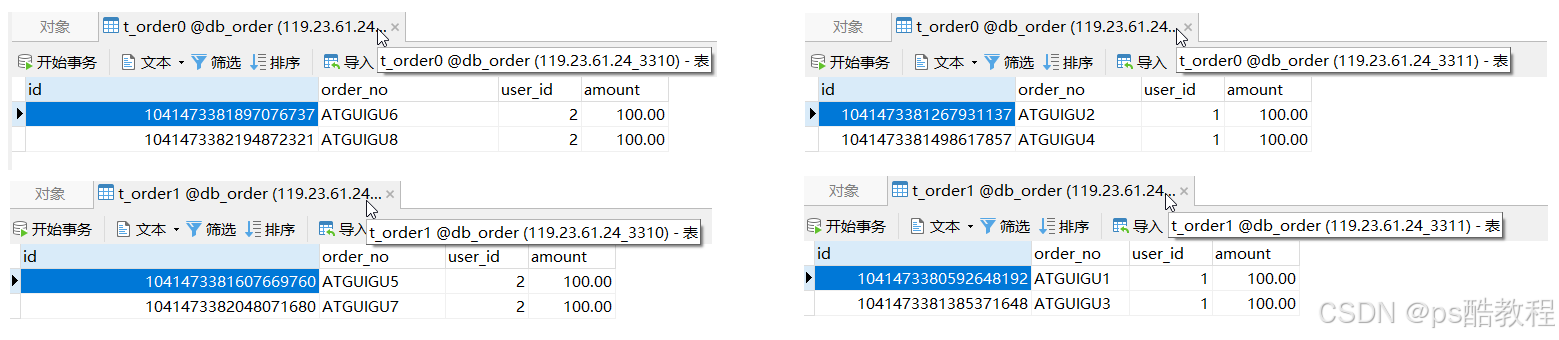
测试结果如下(实现了对t_order订单数据的分库和分表):
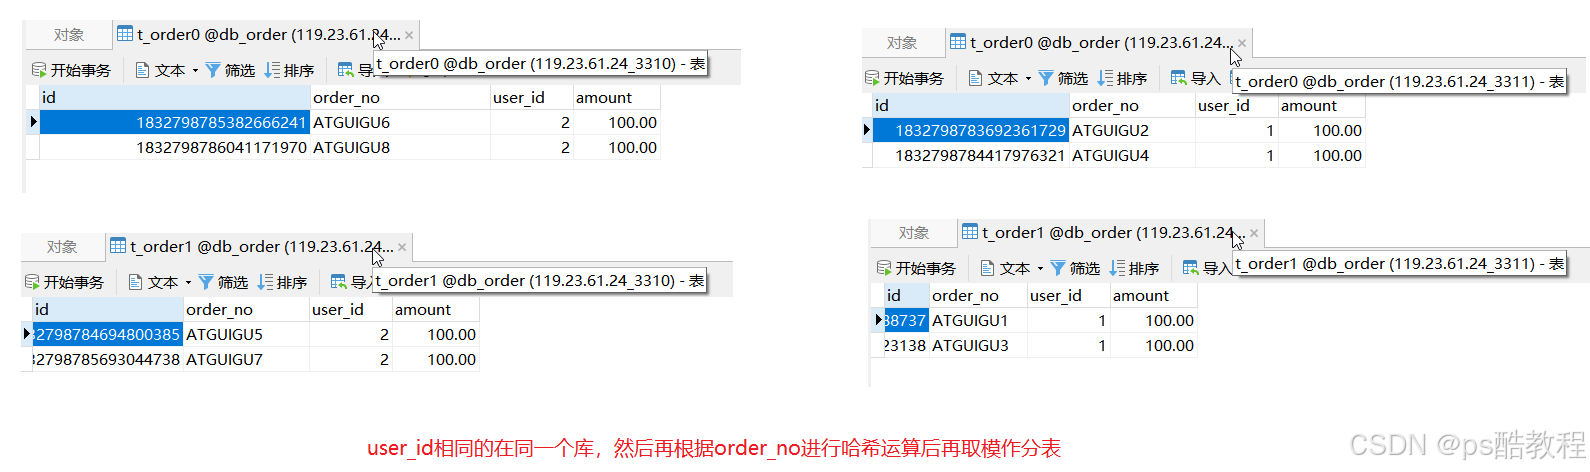
查询测试
测试1
在上面哈希分片算法测试结果的基础上作查询
/**
  * 水平分片:查询所有记录
  * 查询了两个数据源,每个数据源中使用UNION ALL连接两个表
  */
@Test
public void testShardingSelectAll(){
    List<Order> orders = orderMapper.selectList(null);
    orders.forEach(System.out::println);
}
输出日志如下:
2024-09-08 INFO 17988 --- [           main] ShardingSphere-SQL                       : Logic SQL: SELECT  id,order_no,user_id,amount  FROM t_order
2024-09-08 INFO 17988 --- [           main] ShardingSphere-SQL                       : SQLStatement: MySQLSelectStatement(table=Optional.empty, limit=Optional.empty, lock=Optional.empty, window=Optional.empty)
2024-09-08 INFO 17988 --- [           main] ShardingSphere-SQL                       : Actual SQL: server-order0 ::: SELECT  id,order_no,user_id,amount  FROM t_order0 UNION ALL SELECT  id,order_no,user_id,amount  FROM t_order1
2024-09-08 INFO 17988 --- [           main] ShardingSphere-SQL                       : Actual SQL: server-order1 ::: SELECT  id,order_no,user_id,amount  FROM t_order0 UNION ALL SELECT  id,order_no,user_id,amount  FROM t_order1
Order(id=1832798785382666241, orderNo=ATGUIGU6, userId=2, amount=100.00)
Order(id=1832798786041171970, orderNo=ATGUIGU8, userId=2, amount=100.00)
Order(id=1832798784694800385, orderNo=ATGUIGU5, userId=2, amount=100.00)
Order(id=1832798785693044738, orderNo=ATGUIGU7, userId=2, amount=100.00)
Order(id=1832798783692361729, orderNo=ATGUIGU2, userId=1, amount=100.00)
Order(id=1832798784417976321, orderNo=ATGUIGU4, userId=1, amount=100.00)
Order(id=1832798779401588737, orderNo=ATGUIGU1, userId=1, amount=100.00)
Order(id=1832798784015323138, orderNo=ATGUIGU3, userId=1, amount=100.00)
测试2
/**
  * 水平分片:根据user_id查询记录
  * 查询了一个数据源,每个数据源中使用UNION ALL连接两个表
  */
@Test
public void testShardingSelectByUserId(){
    QueryWrapper<Order> orderQueryWrapper = new QueryWrapper<>();
    orderQueryWrapper.eq("user_id", 1L);
    List<Order> orders = orderMapper.selectList(orderQueryWrapper);
    orders.forEach(System.out::println);
}
输出日志如下(可以看到只查询了service-order1库中的t_order0和t_order1这2张表中的数据,因为用户id为1的数据按照分库策略来说,只会存在于service-order1库中):
2024-09-08 INFO 11812 --- [           main] ShardingSphere-SQL                       : Logic SQL: SELECT  id,order_no,user_id,amount  FROM t_order

 WHERE (user_id = ?)
2024-09-08 INFO 11812 --- [           main] ShardingSphere-SQL                       : SQLStatement: MySQLSelectStatement(table=Optional.empty, limit=Optional.empty, lock=Optional.empty, window=Optional.empty)
2024-09-08 INFO 11812 --- [           main] ShardingSphere-SQL                       : Actual SQL: server-order1 ::: SELECT  id,order_no,user_id,amount  FROM t_order0

 WHERE (user_id = ?) UNION ALL SELECT  id,order_no,user_id,amount  FROM t_order1

 WHERE (user_id = ?) ::: [1, 1]
Order(id=1832798783692361729, orderNo=ATGUIGU2, userId=1, amount=100.00)
Order(id=1832798784417976321, orderNo=ATGUIGU4, userId=1, amount=100.00)
Order(id=1832798779401588737, orderNo=ATGUIGU1, userId=1, amount=100.00)
Order(id=1832798784015323138, orderNo=ATGUIGU3, userId=1, amount=100.00)
2.6、分布式序列算法
雪花算法:
https://shardingsphere.apache.org/document/5.1.1/cn/features/sharding/concept/key-generator/
水平分片需要关注全局序列,因为不能简单的使用基于数据库的主键自增。
这里有两种方案:一种是基于MyBatisPlus的id策略;一种是ShardingSphere-JDBC的全局序列配置。
基于MyBatisPlus的id策略
基于MyBatisPlus的id策略:将Order类的id设置成如下形式
@TableId(type = IdType.ASSIGN_ID)
private Long id;
基于ShardingSphere-JDBC的全局序列
基于ShardingSphere-JDBC的全局序列配置:和前面的MyBatisPlus的策略二选一
#------------------------分布式序列策略配置
# 分布式序列列名称
spring.shardingsphere.rules.sharding.tables.t_order.key-generate-strategy.column=id
# 分布式序列算法名称
spring.shardingsphere.rules.sharding.tables.t_order.key-generate-strategy.key-generator-name=alg_snowflake

# 分布式序列算法配置
# 分布式序列算法类型
spring.shardingsphere.rules.sharding.key-generators.alg_snowflake.type=SNOWFLAKE
# 分布式序列算法属性配置
#spring.shardingsphere.rules.sharding.key-generators.alg_snowflake.props.xxx=
此时,需要将实体类中的id策略修改成以下形式:
// IdType.AUTO的含义:
//   当配置了shardingsphere-jdbc的分布式序列时,自动使用shardingsphere-jdbc的分布式序列;
//	 当没有配置shardingsphere-jdbc的分布式序列时,自动依赖数据库的主键自增策略;
@TableId(type = IdType.AUTO)
测试
配置如下:
#------------------------基本配置
# 应用名称
spring.application.name=sharding-jdbc-demo
# 开发环境设置
spring.profiles.active=dev
# 内存模式
spring.shardingsphere.mode.type=Memory
# 打印SQl
spring.shardingsphere.props.sql-show=true

#------------------------数据源配置
# 配置真实数据源
spring.shardingsphere.datasource.names=server-user,server-order0,server-order1

# 配置第 1 个数据源
spring.shardingsphere.datasource.server-user.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-user.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-user.jdbc-url=jdbc:mysql://119.23.61.24:3301/db_user
spring.shardingsphere.datasource.server-user.username=root
spring.shardingsphere.datasource.server-user.password=123456

# 配置第 2 个数据源
spring.shardingsphere.datasource.server-order0.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order0.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order0.jdbc-url=jdbc:mysql://119.23.61.24:3310/db_order
spring.shardingsphere.datasource.server-order0.username=root
spring.shardingsphere.datasource.server-order0.password=123456

# 配置第 3 个数据源
spring.shardingsphere.datasource.server-order1.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order1.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order1.jdbc-url=jdbc:mysql://119.23.61.24:3311/db_order
spring.shardingsphere.datasource.server-order1.username=root
spring.shardingsphere.datasource.server-order1.password=123456

#------------------------标准分片表配置(数据节点配置,一张真实的数据库表就代表1个标准分片)
# 由数据源名 + 表名组成,以小数点分隔。多个表以逗号分隔,支持 inline 表达式。
# 缺省表示使用已知数据源与逻辑表名称生成数据节点,用于广播表(即每个库中都需要一个同样的表用于关联查询,多为字典表)或只分库不分表且所有库的表结构完全一致的情况
spring.shardingsphere.rules.sharding.tables.t_user.actual-data-nodes=server-user.t_user
# server-order0.t_order0,server-order0.t_order1,server-order1.t_order0,server-order1.t_order1
spring.shardingsphere.rules.sharding.tables.t_order.actual-data-nodes=server-order$->{0..1}.t_order$->{0..1}

#------------------------分库策略,缺省表示使用默认分库策略,以下的分片策略只能选其一
# 用于单分片键的标准分片场景
# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-column=user_id
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-algorithm-name=alg_mod


#------------------------分表策略
# 用于单分片键的标准分片场景
# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order.table-strategy.standard.sharding-column=order_no
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order.table-strategy.standard.sharding-algorithm-name=alg_hash_mod


#------------------------分片算法配置
# 行表达式分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.type=INLINE
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.props.algorithm-expression=server-order$->{user_id % 2}

# 取模分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_mod.type=MOD
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_mod.props.sharding-count=2

# 哈希取模分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_hash_mod.type=HASH_MOD
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_hash_mod.props.sharding-count=2

#------------------------分布式序列策略配置
# 分布式序列列名称
spring.shardingsphere.rules.sharding.tables.t_order.key-generate-strategy.column=id
# 分布式序列算法名称
spring.shardingsphere.rules.sharding.tables.t_order.key-generate-strategy.key-generator-name=alg_snowflake


#------------------------分布式序列算法配置
# 分布式序列算法类型
spring.shardingsphere.rules.sharding.key-generators.alg_snowflake.type=SNOWFLAKE
# 分布式序列算法属性配置
#spring.shardingsphere.rules.sharding.key-generators.alg_snowflake.props.xxx=
测试代码:
@TableName("t_order")//逻辑表名
@Data
public class Order {

    @TableId(type = IdType.AUTO)
    // @TableId(type = IdType.ASSIGN_ID)
    private Long id;

    private String orderNo;//自动映射数据库表中的order_no字段

    private Long userId;//user_id

    private BigDecimal amount;
}
/**
 * 水平分片:分表插入数据测试
 */
@Test
public void testInsertOrderTableStrategy(){

    for (long i = 1; i < 5; i++) {

        Order order = new Order();
        order.setOrderNo("ATGUIGU" + i);
        order.setUserId(1L);
        order.setAmount(new BigDecimal(100));
        orderMapper.insert(order);
    }

    for (long i = 5; i < 9; i++) {

        Order order = new Order();
        order.setOrderNo("ATGUIGU" + i);
        order.setUserId(2L);
        order.setAmount(new BigDecimal(100));
        orderMapper.insert(order);
    }
}
测试结果如下(id是由shardingjdbc设置的雪花算法生成的):
3、多表关联
简介
当前3301数据库中有db_user库(该库中有t_user表)
当前3310数据库中有db_order库(该库中有t_order0表、t_order1表,t_order_item0表、t_order_item1表)
当前3311数据库中有db_order库(该库中有t_order0表、t_order1表,t_order_item0表、t_order_item1表)
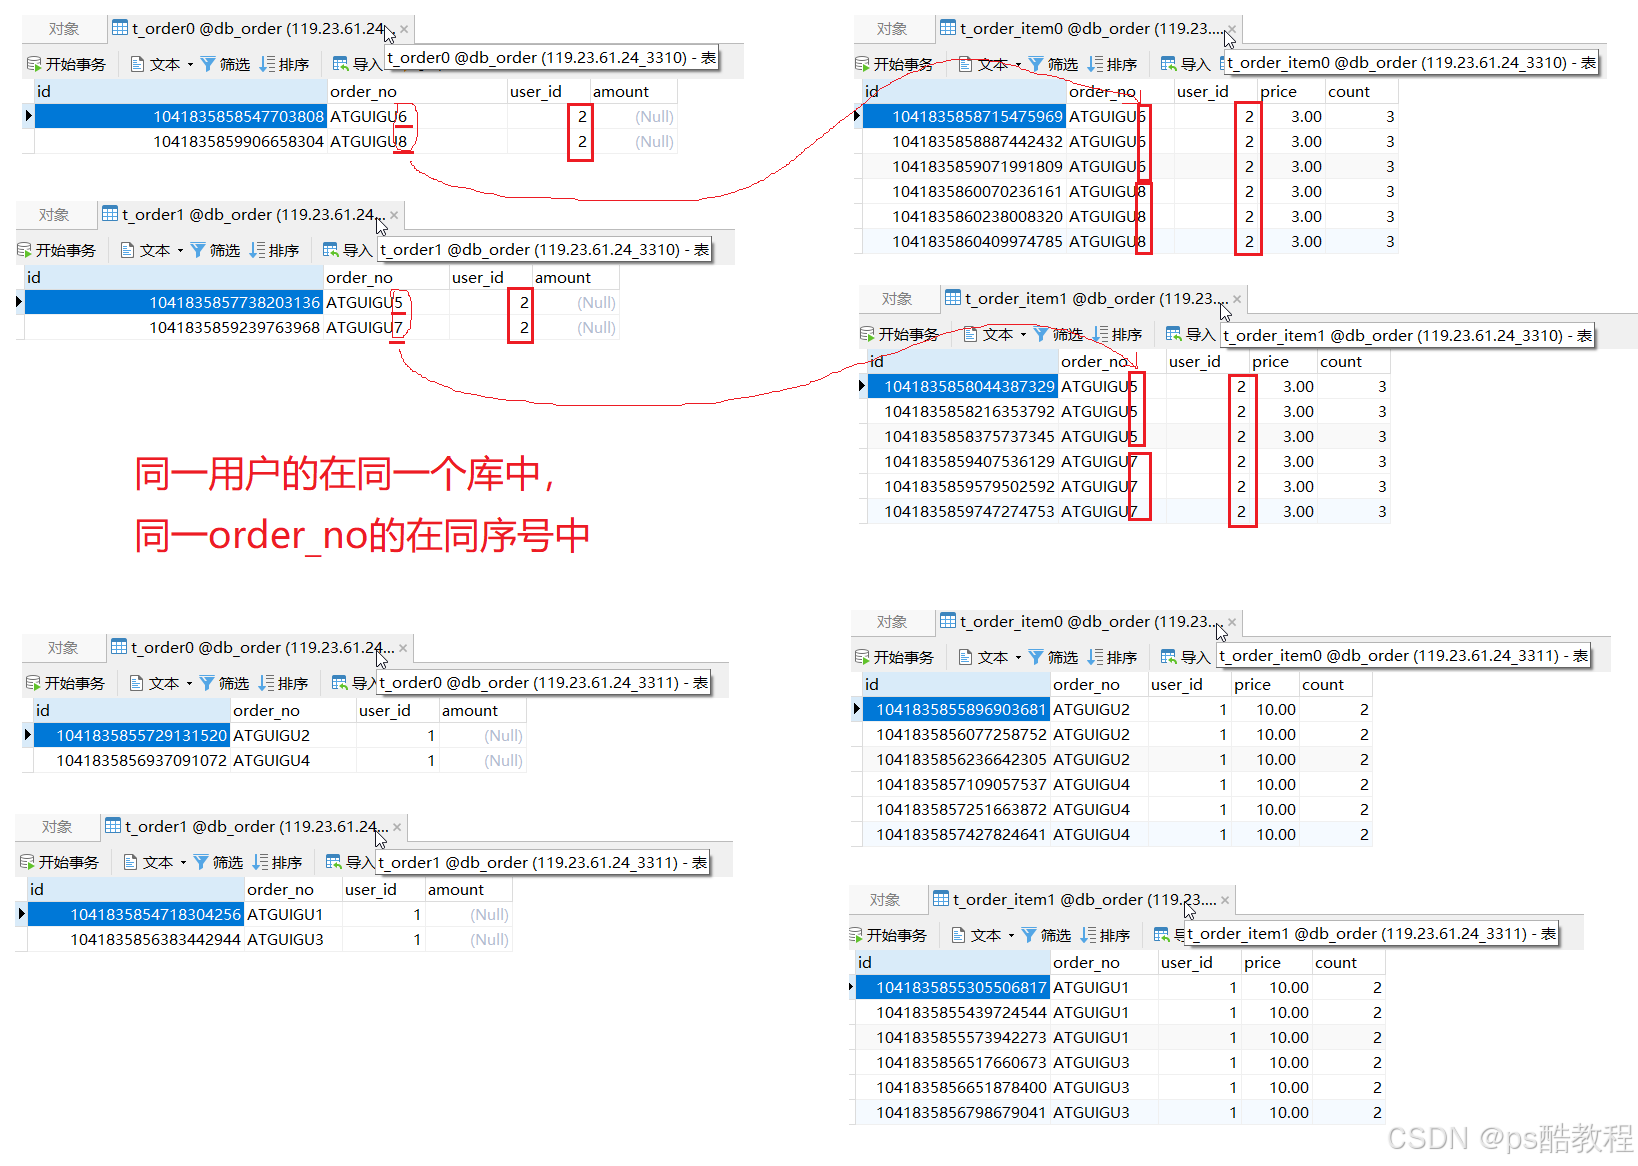
现在:订单表和订单详情表被分库且分表了,但是设置分片规则中分库策略是:同1个用户的订单和订单详情是在同一个库中;设置的分片规则中分表策略是:按照订单的order_no进行哈希取模从而将同一order_no的订单数据和同一order_no的订单详情数据放入到同一张表中;
3.1、创建关联表
在server-order0、server-order1服务器中分别创建两张订单详情表t_order_item0、t_order_item1
我们希望同一个用户的订单表和订单详情表中的数据都在同一个数据源中,避免跨库关联,因此这两张表我们使用相同的分片策略。(根据user_id决定将该用户的订单数据和该用户的订单详情数据根据设定的分库规则分入到同1个数据库中,这样查询单个用户的订单和订单详情时就不用跨库关联了)
那么在t_order_item中我们也需要创建order_no和user_id这两个分片键
CREATE TABLE `t_order_item0` (
  `id` bigint(20) NOT NULL,
  `order_no` varchar(30) DEFAULT NULL,
  `user_id` bigint(20) DEFAULT NULL,
  `price` decimal(10,2) DEFAULT NULL,
  `count` int(11) DEFAULT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

CREATE TABLE `t_order_item1` (
  `id` bigint(20) NOT NULL,
  `order_no` varchar(30) DEFAULT NULL,
  `user_id` bigint(20) DEFAULT NULL,
  `price` decimal(10,2) DEFAULT NULL,
  `count` int(11) DEFAULT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
3.2、创建实体类
package com.atguigu.shardingjdbcdemo.entity;

@TableName("t_order_item")
@Data
public class OrderItem {

    //当配置了shardingsphere-jdbc的分布式序列时,自动使用shardingsphere-jdbc的分布式序列
    @TableId(type = IdType.AUTO)
    private Long id;

    private String orderNo;

    private Long userId;

    private BigDecimal price;

    private Integer count;
}
3.3、创建Mapper
package com.atguigu.shargingjdbcdemo.mapper;

@Mapper
public interface OrderItemMapper extends BaseMapper<OrderItem> {

}
3.4、配置关联表
t_order_item的分片表、分片策略、分布式序列策略和t_order一致
#------------------------基本配置
# 应用名称
spring.application.name=sharging-jdbc-demo
# 开发环境设置
spring.profiles.active=dev
# 内存模式
spring.shardingsphere.mode.type=Memory
# 打印SQl
spring.shardingsphere.props.sql-show=true

#------------------------数据源配置
# 配置真实数据源
spring.shardingsphere.datasource.names=server-user,server-order0,server-order1

# 配置第 1 个数据源
spring.shardingsphere.datasource.server-user.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-user.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-user.jdbc-url=jdbc:mysql://119.23.61.24:3301/db_user
spring.shardingsphere.datasource.server-user.username=root
spring.shardingsphere.datasource.server-user.password=123456

# 配置第 2 个数据源
spring.shardingsphere.datasource.server-order0.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order0.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order0.jdbc-url=jdbc:mysql://119.23.61.24:3310/db_order
spring.shardingsphere.datasource.server-order0.username=root
spring.shardingsphere.datasource.server-order0.password=123456

# 配置第 3 个数据源
spring.shardingsphere.datasource.server-order1.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order1.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order1.jdbc-url=jdbc:mysql://119.23.61.24:3311/db_order
spring.shardingsphere.datasource.server-order1.username=root
spring.shardingsphere.datasource.server-order1.password=123456

#------------------------标准分片表配置(数据节点配置)
# 由数据源名 + 表名组成,以小数点分隔。多个表以逗号分隔,支持 inline 表达式。
# 缺省表示使用已知数据源与逻辑表名称生成数据节点,用于广播表(即每个库中都需要一个同样的表用于关联查询,多为字典表)或只分库不分表且所有库的表结构完全一致的情况
spring.shardingsphere.rules.sharding.tables.t_user.actual-data-nodes=server-user.t_user
# server-order0.t_order0,server-order0.t_order1,server-order1.t_order0,server-order1.t_order1
spring.shardingsphere.rules.sharding.tables.t_order.actual-data-nodes=server-order$->{0..1}.t_order$->{0..1}
spring.shardingsphere.rules.sharding.tables.t_order_item.actual-data-nodes=server-order$->{0..1}.t_order_item$->{0..1}

#------------------------分库策略,缺省表示使用默认分库策略,以下的分片策略只能选其一
# 用于单分片键的标准分片场景
# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-column=user_id
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-algorithm-name=alg_mod


# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order_item.database-strategy.standard.sharding-column=user_id
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order_item.database-strategy.standard.sharding-algorithm-name=alg_mod


#------------------------分表策略
# 用于单分片键的标准分片场景
# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order.table-strategy.standard.sharding-column=order_no
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order.table-strategy.standard.sharding-algorithm-name=alg_hash_mod

# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order_item.table-strategy.standard.sharding-column=order_no
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order_item.table-strategy.standard.sharding-algorithm-name=alg_hash_mod


#------------------------分片算法配置
# 行表达式分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.type=INLINE
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.props.algorithm-expression=server-order$->{user_id % 2}

# 取模分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_mod.type=MOD
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_mod.props.sharding-count=2


# 哈希取模分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_hash_mod.type=HASH_MOD
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_hash_mod.props.sharding-count=2

#------------------------分布式序列策略配置
# 分布式序列列名称
spring.shardingsphere.rules.sharding.tables.t_order.key-generate-strategy.column=id
# 分布式序列算法名称
spring.shardingsphere.rules.sharding.tables.t_order.key-generate-strategy.key-generator-name=alg_snowflake

# 分布式序列列名称
spring.shardingsphere.rules.sharding.tables.t_order_item.key-generate-strategy.column=id
# 分布式序列算法名称
spring.shardingsphere.rules.sharding.tables.t_order_item.key-generate-strategy.key-generator-name=alg_snowflake


#------------------------分布式序列算法配置
# 分布式序列算法类型
spring.shardingsphere.rules.sharding.key-generators.alg_snowflake.type=SNOWFLAKE
# 分布式序列算法属性配置
#spring.shardingsphere.rules.sharding.key-generators.alg_snowflake.props.xxx=
3.5、测试插入数据
同一个用户的订单表和订单详情表中的数据都在同一个数据源中,避免跨库关联
/**
 * 测试关联表的插入
 */
@Test
public void testInsertOrderAndOrderItem(){

    // 给user_id为1的用户添加订单数据、订单详情数据
    //(注意:Order和OrderItem都未主动设置id值, 它们都是设置的IdType.AUTO,
    //       因为配置了shardingsphere的分布式id算法,因此会设置进去)
    for (long i = 1; i < 5; i++) {

        Order order = new Order();
        order.setOrderNo("ATGUIGU" + i);
        order.setUserId(1L);
        orderMapper.insert(order);

        for (int j = 0; j < 3; j++) {
            OrderItem orderItem = new OrderItem();
            orderItem.setOrderNo("ATGUIGU" + i);
            orderItem.setUserId(1L);
            orderItem.setPrice(new BigDecimal(10));
            orderItem.setCount(2);
            orderItemMapper.insert(orderItem);
        }
    }

    // 给user_id为2的用户添加订单数据、订单详情数据
    //(注意:Order和OrderItem都未主动设置id值, 它们都是设置的IdType.AUTO,
    //      因为配置了shardingsphere的分布式id算法,因此会设置进去)
    for (long i = 5; i < 9; i++) {

        Order order = new Order();
        order.setOrderNo("ATGUIGU" + i);
        order.setUserId(2L);
        orderMapper.insert(order);

        for (int j = 0; j < 3; j++) {
            OrderItem orderItem = new OrderItem();
            orderItem.setOrderNo("ATGUIGU" + i);
            orderItem.setUserId(2L);
            orderItem.setPrice(new BigDecimal(3));
            orderItem.setCount(3);
            orderItemMapper.insert(orderItem);
        }
    }
}
测试多表关联数据插入
按照如上设置,结果如下:
测试多表关联数据查询
需求: 查询每个订单的订单号和总订单金额
上面插入了用户对应的订单和订单详情数据,并且根据设置的分片规则,将同一用户的订单和订单详情数据插入到了同一个库中。现在需求是查询所有订单和这些订单的分别总额,我们的步骤如下:
编写OrderMapper的sql如下:
@Mapper
public interface OrderMapper extends BaseMapper<Order> {

    // 这里要写逻辑表名, 并不是实际的表名
    @Select({"SELECT o.order_no, SUM(i.price * i.count) AS amount",
            "FROM t_order o JOIN t_order_item i ON o.order_no = i.order_no",
            "GROUP BY o.order_no"})
    List<OrderVo> getOrderAmount();

}
测试代码如下:
/**
  * 测试关联表查询
  */
@Test
public void testGetOrderAmount(){
    List<OrderVo> orderAmountList = orderMapper.getOrderAmount();
    orderAmountList.forEach(System.out::println);
}
日志输出如下(可以看到具体的过程是采用了笛卡儿积式的方式在查询所有的订单,但是我们知道:根据我们设置的分片规则来说,同一订单存在于t_order0表中,那么对应的订单详情数据一定存在于t_order_item0表,而不存在于t_order_item1表中,这样来说,把t_order0表与t_order_item1表连接起来查询是肯定没有数据的,也是这样的连接查询是在浪费性能):
22:40:31.898  INFO 8884 --- [           main] ShardingSphere-SQL                       : Logic SQL: SELECT o.order_no, SUM(i.price * i.count) AS amount FROM t_order o JOIN t_order_item i ON o.order_no = i.order_no GROUP BY o.order_no
22:40:31.898  INFO 8884 --- [           main] ShardingSphere-SQL                       : SQLStatement: MySQLSelectStatement(table=Optional.empty, limit=Optional.empty, lock=Optional.empty, window=Optional.empty)
22:40:31.898  INFO 8884 --- [           main] ShardingSphere-SQL                       : Actual SQL: server-order1 ::: SELECT o.order_no, SUM(i.price * i.count) AS amount FROM t_order0 o JOIN t_order_item0 i ON o.order_no = i.order_no GROUP BY o.order_no ORDER BY o.order_no ASC
22:40:31.898  INFO 8884 --- [           main] ShardingSphere-SQL                       : Actual SQL: server-order1 ::: SELECT o.order_no, SUM(i.price * i.count) AS amount FROM t_order1 o JOIN t_order_item0 i ON o.order_no = i.order_no GROUP BY o.order_no ORDER BY o.order_no ASC
22:40:31.898  INFO 8884 --- [           main] ShardingSphere-SQL                       : Actual SQL: server-order1 ::: SELECT o.order_no, SUM(i.price * i.count) AS amount FROM t_order0 o JOIN t_order_item1 i ON o.order_no = i.order_no GROUP BY o.order_no ORDER BY o.order_no ASC
22:40:31.898  INFO 8884 --- [           main] ShardingSphere-SQL                       : Actual SQL: server-order1 ::: SELECT o.order_no, SUM(i.price * i.count) AS amount FROM t_order1 o JOIN t_order_item1 i ON o.order_no = i.order_no GROUP BY o.order_no ORDER BY o.order_no ASC
22:40:31.898  INFO 8884 --- [           main] ShardingSphere-SQL                       : Actual SQL: server-order0 ::: SELECT o.order_no, SUM(i.price * i.count) AS amount FROM t_order0 o JOIN t_order_item0 i ON o.order_no = i.order_no GROUP BY o.order_no ORDER BY o.order_no ASC
22:40:31.898  INFO 8884 --- [           main] ShardingSphere-SQL                       : Actual SQL: server-order0 ::: SELECT o.order_no, SUM(i.price * i.count) AS amount FROM t_order1 o JOIN t_order_item0 i ON o.order_no = i.order_no GROUP BY o.order_no ORDER BY o.order_no ASC
22:40:31.898  INFO 8884 --- [           main] ShardingSphere-SQL                       : Actual SQL: server-order0 ::: SELECT o.order_no, SUM(i.price * i.count) AS amount FROM t_order0 o JOIN t_order_item1 i ON o.order_no = i.order_no GROUP BY o.order_no ORDER BY o.order_no ASC
22:40:31.898  INFO 8884 --- [           main] ShardingSphere-SQL                       : Actual SQL: server-order0 ::: SELECT o.order_no, SUM(i.price * i.count) AS amount FROM t_order1 o JOIN t_order_item1 i ON o.order_no = i.order_no GROUP BY o.order_no ORDER BY o.order_no ASC
OrderVo(orderNo=ATGUIGU1, amount=60.00)
OrderVo(orderNo=ATGUIGU2, amount=60.00)
OrderVo(orderNo=ATGUIGU3, amount=60.00)
OrderVo(orderNo=ATGUIGU4, amount=60.00)
OrderVo(orderNo=ATGUIGU5, amount=27.00)
OrderVo(orderNo=ATGUIGU6, amount=27.00)
OrderVo(orderNo=ATGUIGU7, amount=27.00)
OrderVo(orderNo=ATGUIGU8, amount=27.00)
绑定表
配置绑定表
在上面水平分片配置的基础上添加如下配置:
#------------------------绑定表
spring.shardingsphere.rules.sharding.binding-tables[0]=t_order,t_order_item
配置完绑定表后再次进行关联查询的测试:
-
**如果不配置绑定表:测试的结果为8个SQL。**多表关联查询会出现笛卡尔积关联。
-
如果配置绑定表:测试的结果为4个SQL。 多表关联查询不会出现笛卡尔积关联,关联查询效率将大大提升。
绑定表:指分片规则一致的一组分片表。 使用绑定表进行多表关联查询时,必须使用分片键进行关联,否则会出现笛卡尔积关联或跨库关联,从而影响查询效率。
测试
现在配置如下:
#------------------------基本配置
# 应用名称
spring.application.name=sharging-jdbc-demo
# 开发环境设置
spring.profiles.active=dev
# 内存模式
spring.shardingsphere.mode.type=Memory
# 打印SQl
spring.shardingsphere.props.sql-show=true

#------------------------数据源配置
# 配置真实数据源
spring.shardingsphere.datasource.names=server-user,server-order0,server-order1

# 配置第 1 个数据源
spring.shardingsphere.datasource.server-user.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-user.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-user.jdbc-url=jdbc:mysql://119.23.61.24:3301/db_user
spring.shardingsphere.datasource.server-user.username=root
spring.shardingsphere.datasource.server-user.password=123456

# 配置第 2 个数据源
spring.shardingsphere.datasource.server-order0.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order0.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order0.jdbc-url=jdbc:mysql://119.23.61.24:3310/db_order
spring.shardingsphere.datasource.server-order0.username=root
spring.shardingsphere.datasource.server-order0.password=123456

# 配置第 3 个数据源
spring.shardingsphere.datasource.server-order1.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order1.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order1.jdbc-url=jdbc:mysql://119.23.61.24:3311/db_order
spring.shardingsphere.datasource.server-order1.username=root
spring.shardingsphere.datasource.server-order1.password=123456

#------------------------标准分片表配置(数据节点配置)
# 由数据源名 + 表名组成,以小数点分隔。多个表以逗号分隔,支持 inline 表达式。
# 缺省表示使用已知数据源与逻辑表名称生成数据节点,用于广播表(即每个库中都需要一个同样的表用于关联查询,多为字典表)或只分库不分表且所有库的表结构完全一致的情况
spring.shardingsphere.rules.sharding.tables.t_user.actual-data-nodes=server-user.t_user
# server-order0.t_order0,server-order0.t_order1,server-order1.t_order0,server-order1.t_order1
spring.shardingsphere.rules.sharding.tables.t_order.actual-data-nodes=server-order$->{0..1}.t_order$->{0..1}
spring.shardingsphere.rules.sharding.tables.t_order_item.actual-data-nodes=server-order$->{0..1}.t_order_item$->{0..1}

#------------------------分库策略,缺省表示使用默认分库策略,以下的分片策略只能选其一
# 用于单分片键的标准分片场景
# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-column=user_id
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-algorithm-name=alg_mod


# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order_item.database-strategy.standard.sharding-column=user_id
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order_item.database-strategy.standard.sharding-algorithm-name=alg_mod


#------------------------分表策略
# 用于单分片键的标准分片场景
# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order.table-strategy.standard.sharding-column=order_no
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order.table-strategy.standard.sharding-algorithm-name=alg_hash_mod

# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order_item.table-strategy.standard.sharding-column=order_no
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order_item.table-strategy.standard.sharding-algorithm-name=alg_hash_mod


#------------------------分片算法配置
# 行表达式分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.type=INLINE
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.props.algorithm-expression=server-order$->{user_id % 2}

# 取模分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_mod.type=MOD
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_mod.props.sharding-count=2


# 哈希取模分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_hash_mod.type=HASH_MOD
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_hash_mod.props.sharding-count=2

#------------------------分布式序列策略配置
# 分布式序列列名称
spring.shardingsphere.rules.sharding.tables.t_order.key-generate-strategy.column=id
# 分布式序列算法名称
spring.shardingsphere.rules.sharding.tables.t_order.key-generate-strategy.key-generator-name=alg_snowflake

# 分布式序列列名称
spring.shardingsphere.rules.sharding.tables.t_order_item.key-generate-strategy.column=id
# 分布式序列算法名称
spring.shardingsphere.rules.sharding.tables.t_order_item.key-generate-strategy.key-generator-name=alg_snowflake


#------------------------分布式序列算法配置
# 分布式序列算法类型
spring.shardingsphere.rules.sharding.key-generators.alg_snowflake.type=SNOWFLAKE
# 分布式序列算法属性配置
#spring.shardingsphere.rules.sharding.key-generators.alg_snowflake.props.xxx=

#------------------------绑定表配置
# 绑定表规则列表
spring.shardingsphere.rules.sharding.binding-tables[0]=t_order,t_order_item
测试代码不变
/**
 * 测试关联表查询
 */
@Test
public void testGetOrderAmount(){
    List<OrderVo> orderAmountList = orderMapper.getOrderAmount();
    orderAmountList.forEach(System.out::println);
}
查询语句仍然不变
@Mapper
public interface OrderMapper extends BaseMapper<Order> {

    // 这里要写逻辑表名, 并不是实际的表名
    @Select({"SELECT o.order_no, SUM(i.price * i.count) AS amount",
            "FROM t_order o JOIN t_order_item i ON o.order_no = i.order_no",
            "GROUP BY o.order_no"})
    List<OrderVo> getOrderAmount();

}
日志输出如下(可以显然看到实际执行的查询语句减少了;注意下:上面查询的语句中一定要使用到分片键order_no作为连接条件,如果采用分片键如order_id,则还是会形成笛卡儿积式的查询):
Logic SQL: SELECT o.order_no, SUM(i.price * i.count) AS amount FROM t_order o JOIN t_order_item i ON o.order_no = i.order_no GROUP BY o.order_no
SQLStatement: MySQLSelectStatement(table=Optional.empty, limit=Optional.empty, lock=Optional.empty, window=Optional.empty)
Actual SQL: server-order0 ::: SELECT o.order_no, SUM(i.price * i.count) AS amount FROM t_order0 o JOIN t_order_item0 i ON o.order_no = i.order_no GROUP BY o.order_no ORDER BY o.order_no ASC
Actual SQL: server-order0 ::: SELECT o.order_no, SUM(i.price * i.count) AS amount FROM t_order1 o JOIN t_order_item1 i ON o.order_no = i.order_no GROUP BY o.order_no ORDER BY o.order_no ASC
Actual SQL: server-order1 ::: SELECT o.order_no, SUM(i.price * i.count) AS amount FROM t_order0 o JOIN t_order_item0 i ON o.order_no = i.order_no GROUP BY o.order_no ORDER BY o.order_no ASC
Actual SQL: server-order1 ::: SELECT o.order_no, SUM(i.price * i.count) AS amount FROM t_order1 o JOIN t_order_item1 i ON o.order_no = i.order_no GROUP BY o.order_no ORDER BY o.order_no ASC
OrderVo(orderNo=ATGUIGU1, amount=60.00)
OrderVo(orderNo=ATGUIGU2, amount=60.00)
OrderVo(orderNo=ATGUIGU3, amount=60.00)
OrderVo(orderNo=ATGUIGU4, amount=60.00)
OrderVo(orderNo=ATGUIGU5, amount=27.00)
OrderVo(orderNo=ATGUIGU6, amount=27.00)
OrderVo(orderNo=ATGUIGU7, amount=27.00)
OrderVo(orderNo=ATGUIGU8, amount=27.00)
5、广播表
4.1、什么是广播表
指所有的分片数据源中都存在的表,表结构及其数据在每个数据库中均完全一致。 适用于数据量不大且需要与海量数据的表进行关联查询的场景,例如:字典表。
广播具有以下特性:
(1)插入、更新操作会实时在所有节点上执行,保持各个分片的数据一致性
(2)查询操作,只从一个节点获取
(3)可以跟任何一个表进行 JOIN 操作
4.2、创建广播表
在server-order0、server-order1和server-user服务器中分别创建t_dict表
CREATE TABLE `t_dict` (
  `id` bigint(20) NOT NULL,
  `dict_type` varchar(20) DEFAULT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
4.3、程序实现
4.3.1、创建实体类
package com.atguigu.shardingjdbcdemo.entity;

@TableName("t_dict")
@Data
public class Dict {
    //可以使用MyBatisPlus的雪花算法
    @TableId(type = IdType.ASSIGN_ID)
    private Long id;
    private String dictType;
}
4.3.2、创建Mapper
package com.atguigu.shardingjdbcdemo.mapper;

@Mapper
public interface DictMapper extends BaseMapper<Dict> {
}
4.3.3、配置广播表
#数据节点可不配置,默认情况下,向所有数据源广播
spring.shardingsphere.rules.sharding.tables.t_dict.actual-data-nodes=server-user.t_dict,server-order$->{0..1}.t_dict

# 广播表
spring.shardingsphere.rules.sharding.broadcast-tables[0]=t_dict
4.4、测试广播表
现配置如下
#------------------------基本配置
# 应用名称
spring.application.name=sharging-jdbc-demo
# 开发环境设置
spring.profiles.active=dev
# 内存模式
spring.shardingsphere.mode.type=Memory
# 打印SQl
spring.shardingsphere.props.sql-show=true

#------------------------数据源配置
# 配置真实数据源
spring.shardingsphere.datasource.names=server-user,server-order0,server-order1

# 配置第 1 个数据源
spring.shardingsphere.datasource.server-user.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-user.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-user.jdbc-url=jdbc:mysql://119.23.61.24:3301/db_user
spring.shardingsphere.datasource.server-user.username=root
spring.shardingsphere.datasource.server-user.password=123456

# 配置第 2 个数据源
spring.shardingsphere.datasource.server-order0.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order0.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order0.jdbc-url=jdbc:mysql://119.23.61.24:3310/db_order
spring.shardingsphere.datasource.server-order0.username=root
spring.shardingsphere.datasource.server-order0.password=123456

# 配置第 3 个数据源
spring.shardingsphere.datasource.server-order1.type=com.zaxxer.hikari.HikariDataSource
spring.shardingsphere.datasource.server-order1.driver-class-name=com.mysql.jdbc.Driver
spring.shardingsphere.datasource.server-order1.jdbc-url=jdbc:mysql://119.23.61.24:3311/db_order
spring.shardingsphere.datasource.server-order1.username=root
spring.shardingsphere.datasource.server-order1.password=123456

#------------------------标准分片表配置(数据节点配置)
# 由数据源名 + 表名组成,以小数点分隔。多个表以逗号分隔,支持 inline 表达式。
# 缺省表示使用已知数据源与逻辑表名称生成数据节点,用于广播表(即每个库中都需要一个同样的表用于关联查询,多为字典表)或只分库不分表且所有库的表结构完全一致的情况
spring.shardingsphere.rules.sharding.tables.t_user.actual-data-nodes=server-user.t_user
# server-order0.t_order0,server-order0.t_order1,server-order1.t_order0,server-order1.t_order1
spring.shardingsphere.rules.sharding.tables.t_order.actual-data-nodes=server-order$->{0..1}.t_order$->{0..1}
spring.shardingsphere.rules.sharding.tables.t_order_item.actual-data-nodes=server-order$->{0..1}.t_order_item$->{0..1}
spring.shardingsphere.rules.sharding.tables.t_dict.actual-data-nodes=server-order$->{0..1}.t_dict,server-user.t_dict

#------------------------分库策略,缺省表示使用默认分库策略,以下的分片策略只能选其一
# 用于单分片键的标准分片场景
# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-column=user_id
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order.database-strategy.standard.sharding-algorithm-name=alg_mod


# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order_item.database-strategy.standard.sharding-column=user_id
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order_item.database-strategy.standard.sharding-algorithm-name=alg_mod


#------------------------分表策略
# 用于单分片键的标准分片场景
# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order.table-strategy.standard.sharding-column=order_no
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order.table-strategy.standard.sharding-algorithm-name=alg_hash_mod

# 分片列名称
spring.shardingsphere.rules.sharding.tables.t_order_item.table-strategy.standard.sharding-column=order_no
# 分片算法名称
spring.shardingsphere.rules.sharding.tables.t_order_item.table-strategy.standard.sharding-algorithm-name=alg_hash_mod


#------------------------分片算法配置
# 行表达式分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.type=INLINE
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_inline_userid.props.algorithm-expression=server-order$->{user_id % 2}

# 取模分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_mod.type=MOD
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_mod.props.sharding-count=2


# 哈希取模分片算法
# 分片算法类型
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_hash_mod.type=HASH_MOD
# 分片算法属性配置
spring.shardingsphere.rules.sharding.sharding-algorithms.alg_hash_mod.props.sharding-count=2

#------------------------分布式序列策略配置
# 分布式序列列名称
spring.shardingsphere.rules.sharding.tables.t_order.key-generate-strategy.column=id
# 分布式序列算法名称
spring.shardingsphere.rules.sharding.tables.t_order.key-generate-strategy.key-generator-name=alg_snowflake

# 分布式序列列名称
spring.shardingsphere.rules.sharding.tables.t_order_item.key-generate-strategy.column=id
# 分布式序列算法名称
spring.shardingsphere.rules.sharding.tables.t_order_item.key-generate-strategy.key-generator-name=alg_snowflake


#------------------------分布式序列算法配置
# 分布式序列算法类型
spring.shardingsphere.rules.sharding.key-generators.alg_snowflake.type=SNOWFLAKE
# 分布式序列算法属性配置
#spring.shardingsphere.rules.sharding.key-generators.alg_snowflake.props.xxx=

#------------------------绑定表配置
# 绑定表规则列表
spring.shardingsphere.rules.sharding.binding-tables[0]=t_order,t_order_item

#------------------------广播表配置
# 广播表规则列表
spring.shardingsphere.rules.sharding.broadcast-tables[0]=t_dict
测试插入数据到广播表
代码如下:
/**
  * 广播表:每个服务器中的t_dict同时添加了新数据
  */
@Test
public void testBroadcast(){

    Dict dict = new Dict();
    dict.setDictType("type1");
    dictMapper.insert(dict);
}
日志输出如下(可以看到,当向广播表中插入数据时,会同时向3张表中插入数据):
Logic SQL: INSERT INTO t_dict  ( id,dict_type )  VALUES  ( ?,? )
SQLStatement: MySQLInsertStatement(setAssignment=Optional.empty, onDuplicateKeyColumns=Optional.empty)
Actual SQL: server-user ::: INSERT INTO t_dict  ( id,dict_type )  VALUES  (?, ?) ::: [1834973772940050434, type1]
Actual SQL: server-order0 ::: INSERT INTO t_dict  ( id,dict_type )  VALUES  (?, ?) ::: [1834973772940050434, type1]
Actual SQL: server-order1 ::: INSERT INTO t_dict  ( id,dict_type )  VALUES  (?, ?) ::: [1834973772940050434, type1]
测试查询广播表中的数据
现在测试查询广播表中的数据
@Test
public void testSelectBroadcast(){

    List<Dict> dictList = dictMapper.selectList(null);
    dictMapper.selectList(null);
    dictMapper.selectList(null);
    dictMapper.selectList(null);
    dictMapper.selectList(null);
    dictMapper.selectList(null);
    dictList.forEach(System.out::println);
}
日志输出如下(可以看到一共查询了6次,其中有1次是从server-order1的t_dict表中查询到的,其它5次都是从service-order0的t_dict表中查询的):
Logic SQL: SELECT  id,dict_type  FROM t_dict
SQLStatement: MySQLSelectStatement(table=Optional.empty, limit=Optional.empty, lock=Optional.empty, window=Optional.empty)
Actual SQL: server-order0 ::: SELECT  id,dict_type  FROM t_dict
Logic SQL: SELECT  id,dict_type  FROM t_dict
SQLStatement: MySQLSelectStatement(table=Optional.empty, limit=Optional.empty, lock=Optional.empty, window=Optional.empty)
Actual SQL: server-order0 ::: SELECT  id,dict_type  FROM t_dict
Logic SQL: SELECT  id,dict_type  FROM t_dict
SQLStatement: MySQLSelectStatement(table=Optional.empty, limit=Optional.empty, lock=Optional.empty, window=Optional.empty)
Actual SQL: server-order0 ::: SELECT  id,dict_type  FROM t_dict
Logic SQL: SELECT  id,dict_type  FROM t_dict
SQLStatement: MySQLSelectStatement(table=Optional.empty, limit=Optional.empty, lock=Optional.empty, window=Optional.empty)
Actual SQL: server-order0 ::: SELECT  id,dict_type  FROM t_dict
Logic SQL: SELECT  id,dict_type  FROM t_dict
SQLStatement: MySQLSelectStatement(table=Optional.empty, limit=Optional.empty, lock=Optional.empty, window=Optional.empty)
Actual SQL: server-order1 ::: SELECT  id,dict_type  FROM t_dict
Logic SQL: SELECT  id,dict_type  FROM t_dict
SQLStatement: MySQLSelectStatement(table=Optional.empty, limit=Optional.empty, lock=Optional.empty, window=Optional.empty)
Actual SQL: server-order0 ::: SELECT  id,dict_type  FROM t_dict
Dict(id=1834973772940050434, dictType=type1)
第07章 启动ShardingSphere-Proxy
1、获取
目前 ShardingSphere-Proxy 提供了 3 种获取方式:
2、使用二进制发布包安装
二进制包既可以Linux系统运行,又可以在windows系统运行
step1:解压二进制包
apache-shardingsphere-5.1.1-shardingsphere-proxy-bin.tar.gz
windows:使用解压软件解压文件(使用WinRAR解压上述这个文件即可)
Linux:将文件上传至/opt目录,并解压(使用如下命令解压上述这个文件即可)
tar -zxvf apache-shardingsphere-5.1.1-shardingsphere-proxy-bin.tar.gz
step2:MySQL驱动
mysql-connector-java-8.0.22.jar
将MySQl驱动放至解压目录中的ext-lib目录(在上述已经解压的目录下创建ext-lib目录,并将MySQL驱动放入此ext-lib目录,此ext-lib目录与解压后的bin/,conf/,lib/,license/等目录在同一级目录下)
spte3:修改配置conf/server.yaml
rules:
  - !AUTHORITY
    users:
      - root@%:root
    provider:
      type: ALL_PRIVILEGES_PERMITTED

props:
  sql-show: true
(如下放开图示中的注释)
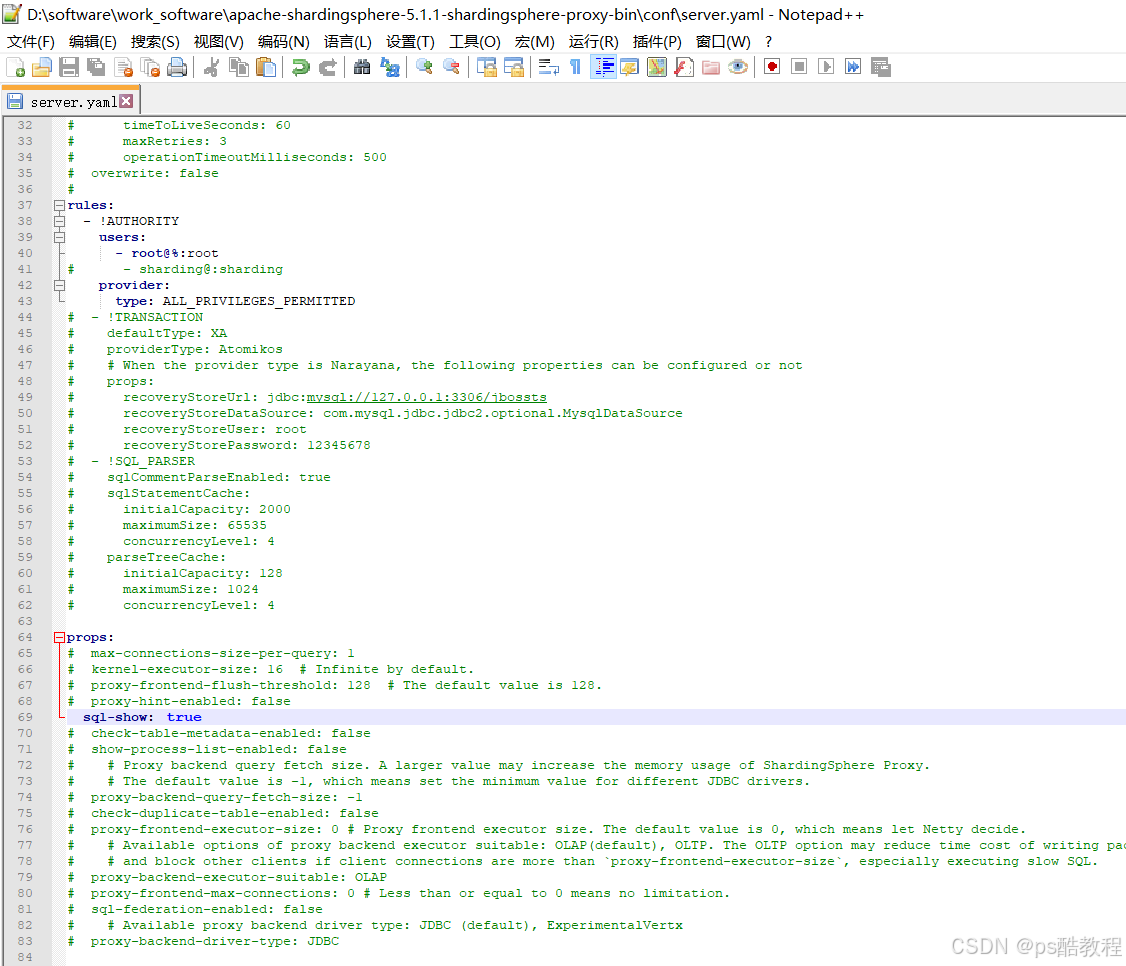
spte4:启动ShardingSphere-Proxy
Linux 操作系统请运行 bin/start.sh
Windows 操作系统请运行 bin/start.bat
指定端口号和配置文件目录:bin/start.bat ${proxy_port} ${proxy_conf_directory}
(如下window启动ShardingSphere-Proxy,如果不指定端口,默认端口为3307,可如下指定端口为3321)
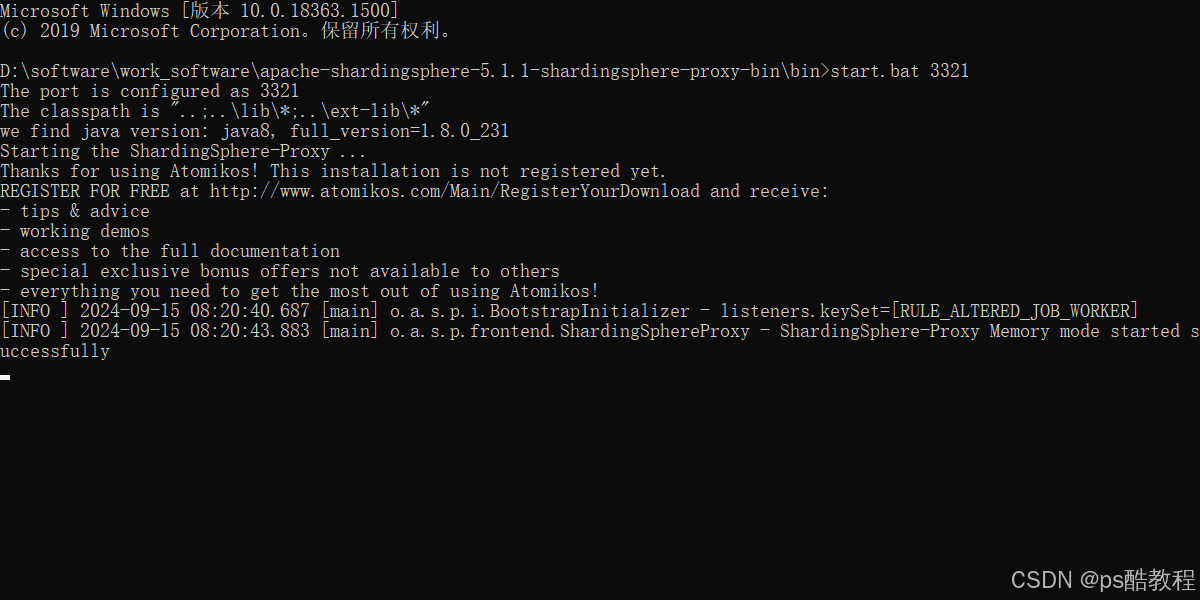
step5:远程连接ShardingSphere-Proxy
远程访问
mysql -h192.168.100.1 -P3307 -uroot -p
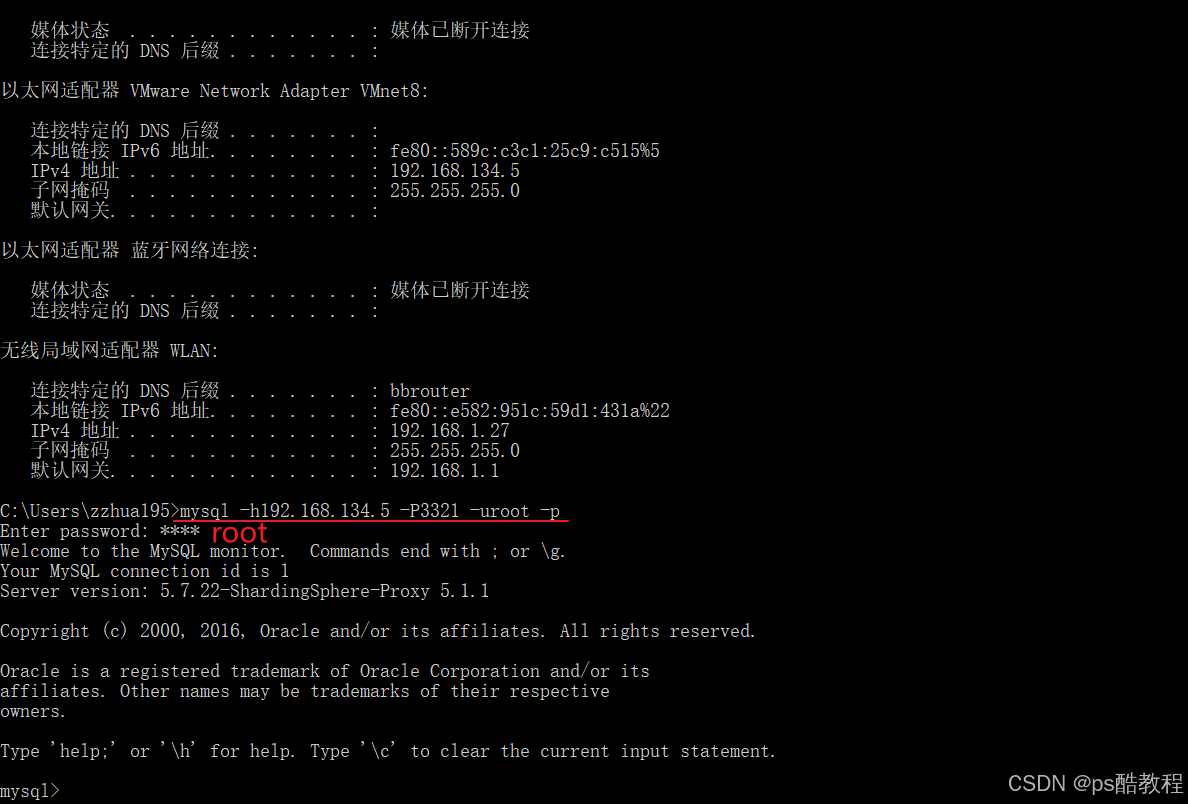
step6:访问测试
show databases;
(如下使用mysql命令连接到shardingsphere的数据库中间件代理,此时可能无法使用高级客户端连接此shardingsphere数据库中间件代理,用命令行即可)
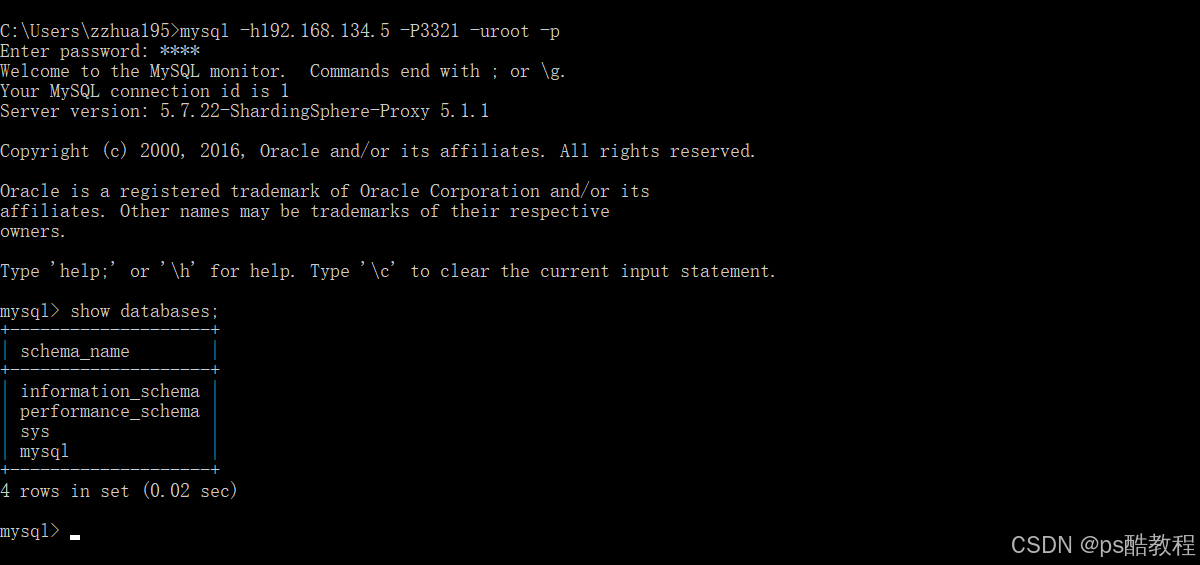
测试连接是成功的
但是双击会报错,所以用命令行就好了
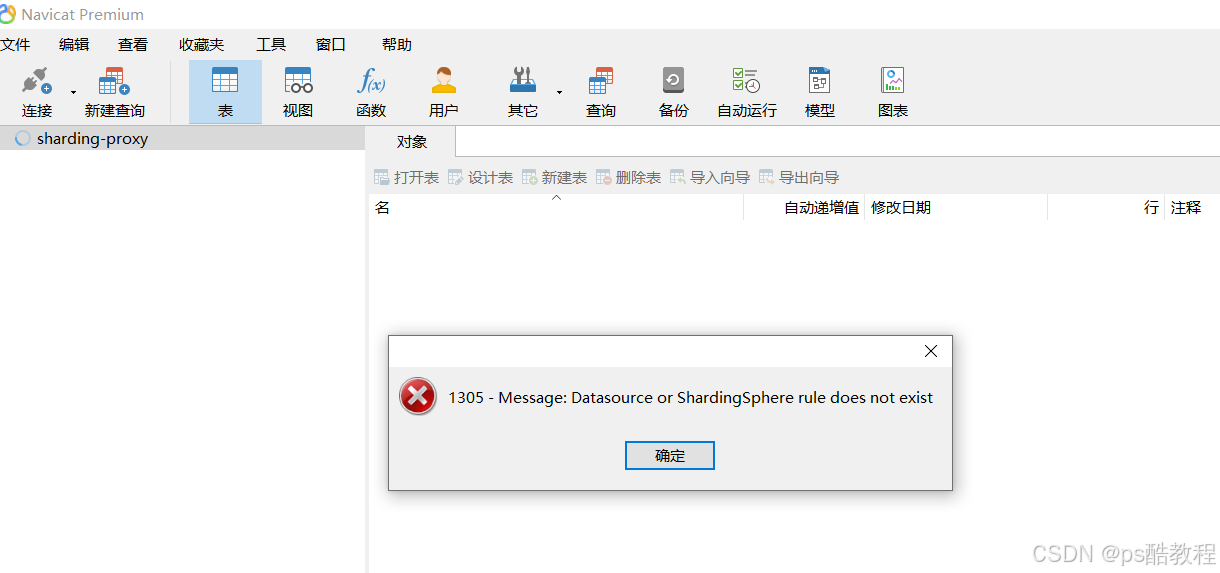
3、使用Docker安装
step1:启动Docker容器
docker run -d \
-v /atguigu/server/proxy-a/conf:/opt/shardingsphere-proxy/conf \
-v /atguigu/server/proxy-a/ext-lib:/opt/shardingsphere-proxy/ext-lib \
-e ES_JAVA_OPTS="-Xmx256m -Xms256m -Xmn128m" \
-p 3321:3307 \
--name server-proxy-a \
apache/shardingsphere-proxy:5.1.1
step2:上传MySQL驱动
将MySQl驱动上传至/atguigu/server/proxy-a/ext-lib目录
spte3:修改配置server.yaml
rules:
  - !AUTHORITY
    users:
      - root@%:root
    provider:
      type: ALL_PRIVILEGES_PERMITTED

props:
  sql-show: true
将配置文件上传至/atguigu/server/proxy-a/conf目录
spte4:重启容器
docker restart server-proxy-a
step5:远程连接ShardingSphere-Proxy
ShardingSphere-Proxy容器中默认情况下没有mysql命令行客户端的安装,因此需要远程访问
mysql -h192.168.100.201 -P3321 -uroot -p
step6:访问测试
show databases;
常见问题:docker容器无法远程连接
容器可以成功的创建并启动,但是无法远程连接。排除防火墙和网络等问题后,看看是不是因为容器内存不足导致。
原因:容器可分配内存不足
查看办法:进入容器后查看ShardingSphere-Proxy的日志,如有有cannot allocate memory,则说明容器内存不足
docker exec -it server-proxy-a env LANG=C.UTF-8 /bin/bash
cd /opt/shardingsphere-proxy/logs
tail stdout.log
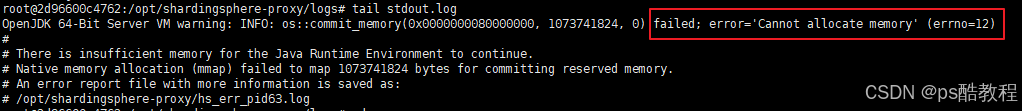
解决方案:创建容器的时候使用JVM参数
-e ES_JAVA_OPTS="-Xmx256m -Xms256m -Xmn128m"
第08章 ShardingSphere-Proxy读写分离
1、修改配置文件
修改配置config-readwrite-splitting.yaml
(默认该文件的所有内容都被注释掉了,只需要放开对应的配置就行)
schemaName: readwrite_splitting_db

dataSources:
  write_ds:
    url: jdbc:mysql://119.23.61.24:3306/db_user?serverTimezone=UTC&useSSL=false
    username: root
    password: 123456
    connectionTimeoutMilliseconds: 30000
    idleTimeoutMilliseconds: 60000
    maxLifetimeMilliseconds: 1800000
    maxPoolSize: 50
    minPoolSize: 1
  read_ds_0:
    url: jdbc:mysql://119.23.61.24:3307/db_user?serverTimezone=UTC&useSSL=false
    username: root
    password: 123456
    connectionTimeoutMilliseconds: 30000
    idleTimeoutMilliseconds: 60000
    maxLifetimeMilliseconds: 1800000
    maxPoolSize: 50
    minPoolSize: 1
  read_ds_1:
    url: jdbc:mysql://119.23.61.24:3308/db_user?serverTimezone=UTC&useSSL=false
    username: root
    password: 123456
    connectionTimeoutMilliseconds: 30000
    idleTimeoutMilliseconds: 60000
    maxLifetimeMilliseconds: 1800000
    maxPoolSize: 50
    minPoolSize: 1

rules:
- !READWRITE_SPLITTING
  dataSources:
    readwrite_ds:
      type: Static
      props:
        write-data-source-name: write_ds
        read-data-source-names: read_ds_0,read_ds_1
将配置文件上传至/atguigu/server/proxy-a/conf目录
重启容器
docker restart server-proxy-a
2、实时查看日志
可以通过这种方式查看服务器中输出的SQL语句
docker exec -it server-proxy-a env LANG=C.UTF-8 /bin/bash
tail -f /opt/shardingsphere-proxy/logs/stdout.log
3、远程访问测试
mysql> show databases;
mysql> use readwrite_splitting_db;
mysql> show tables;
mysql> select * from t_user;
mysql> select * from t_user;
mysql> insert into t_user(uname) values('wang5');
测试:本地windows启动shardingsphere-proxy
按照第03章的配置,搭建3306的主节点,搭建3307、3308的从节点,并实现主从同步,并且主从节点中都有db_user库,并再db_user库中都有t_user表。
由于阿里云主机老是拉取不到镜像,所以还是使用本地的shardsphere-proxy来测试(
第一步:同第07章启动shardingsphere-proxy先修改conf/server.yaml;
第二步:再修改conf/config-readwrite-splitting.yaml文件,此时相当于conf下只有server.yaml和config-readwrite-splitting.yaml文件中是有内容的,其它的文件默认都被注释了;
第三步:启动windows本地的shardingsphere-proxy,启动命令是start.bat 3321)
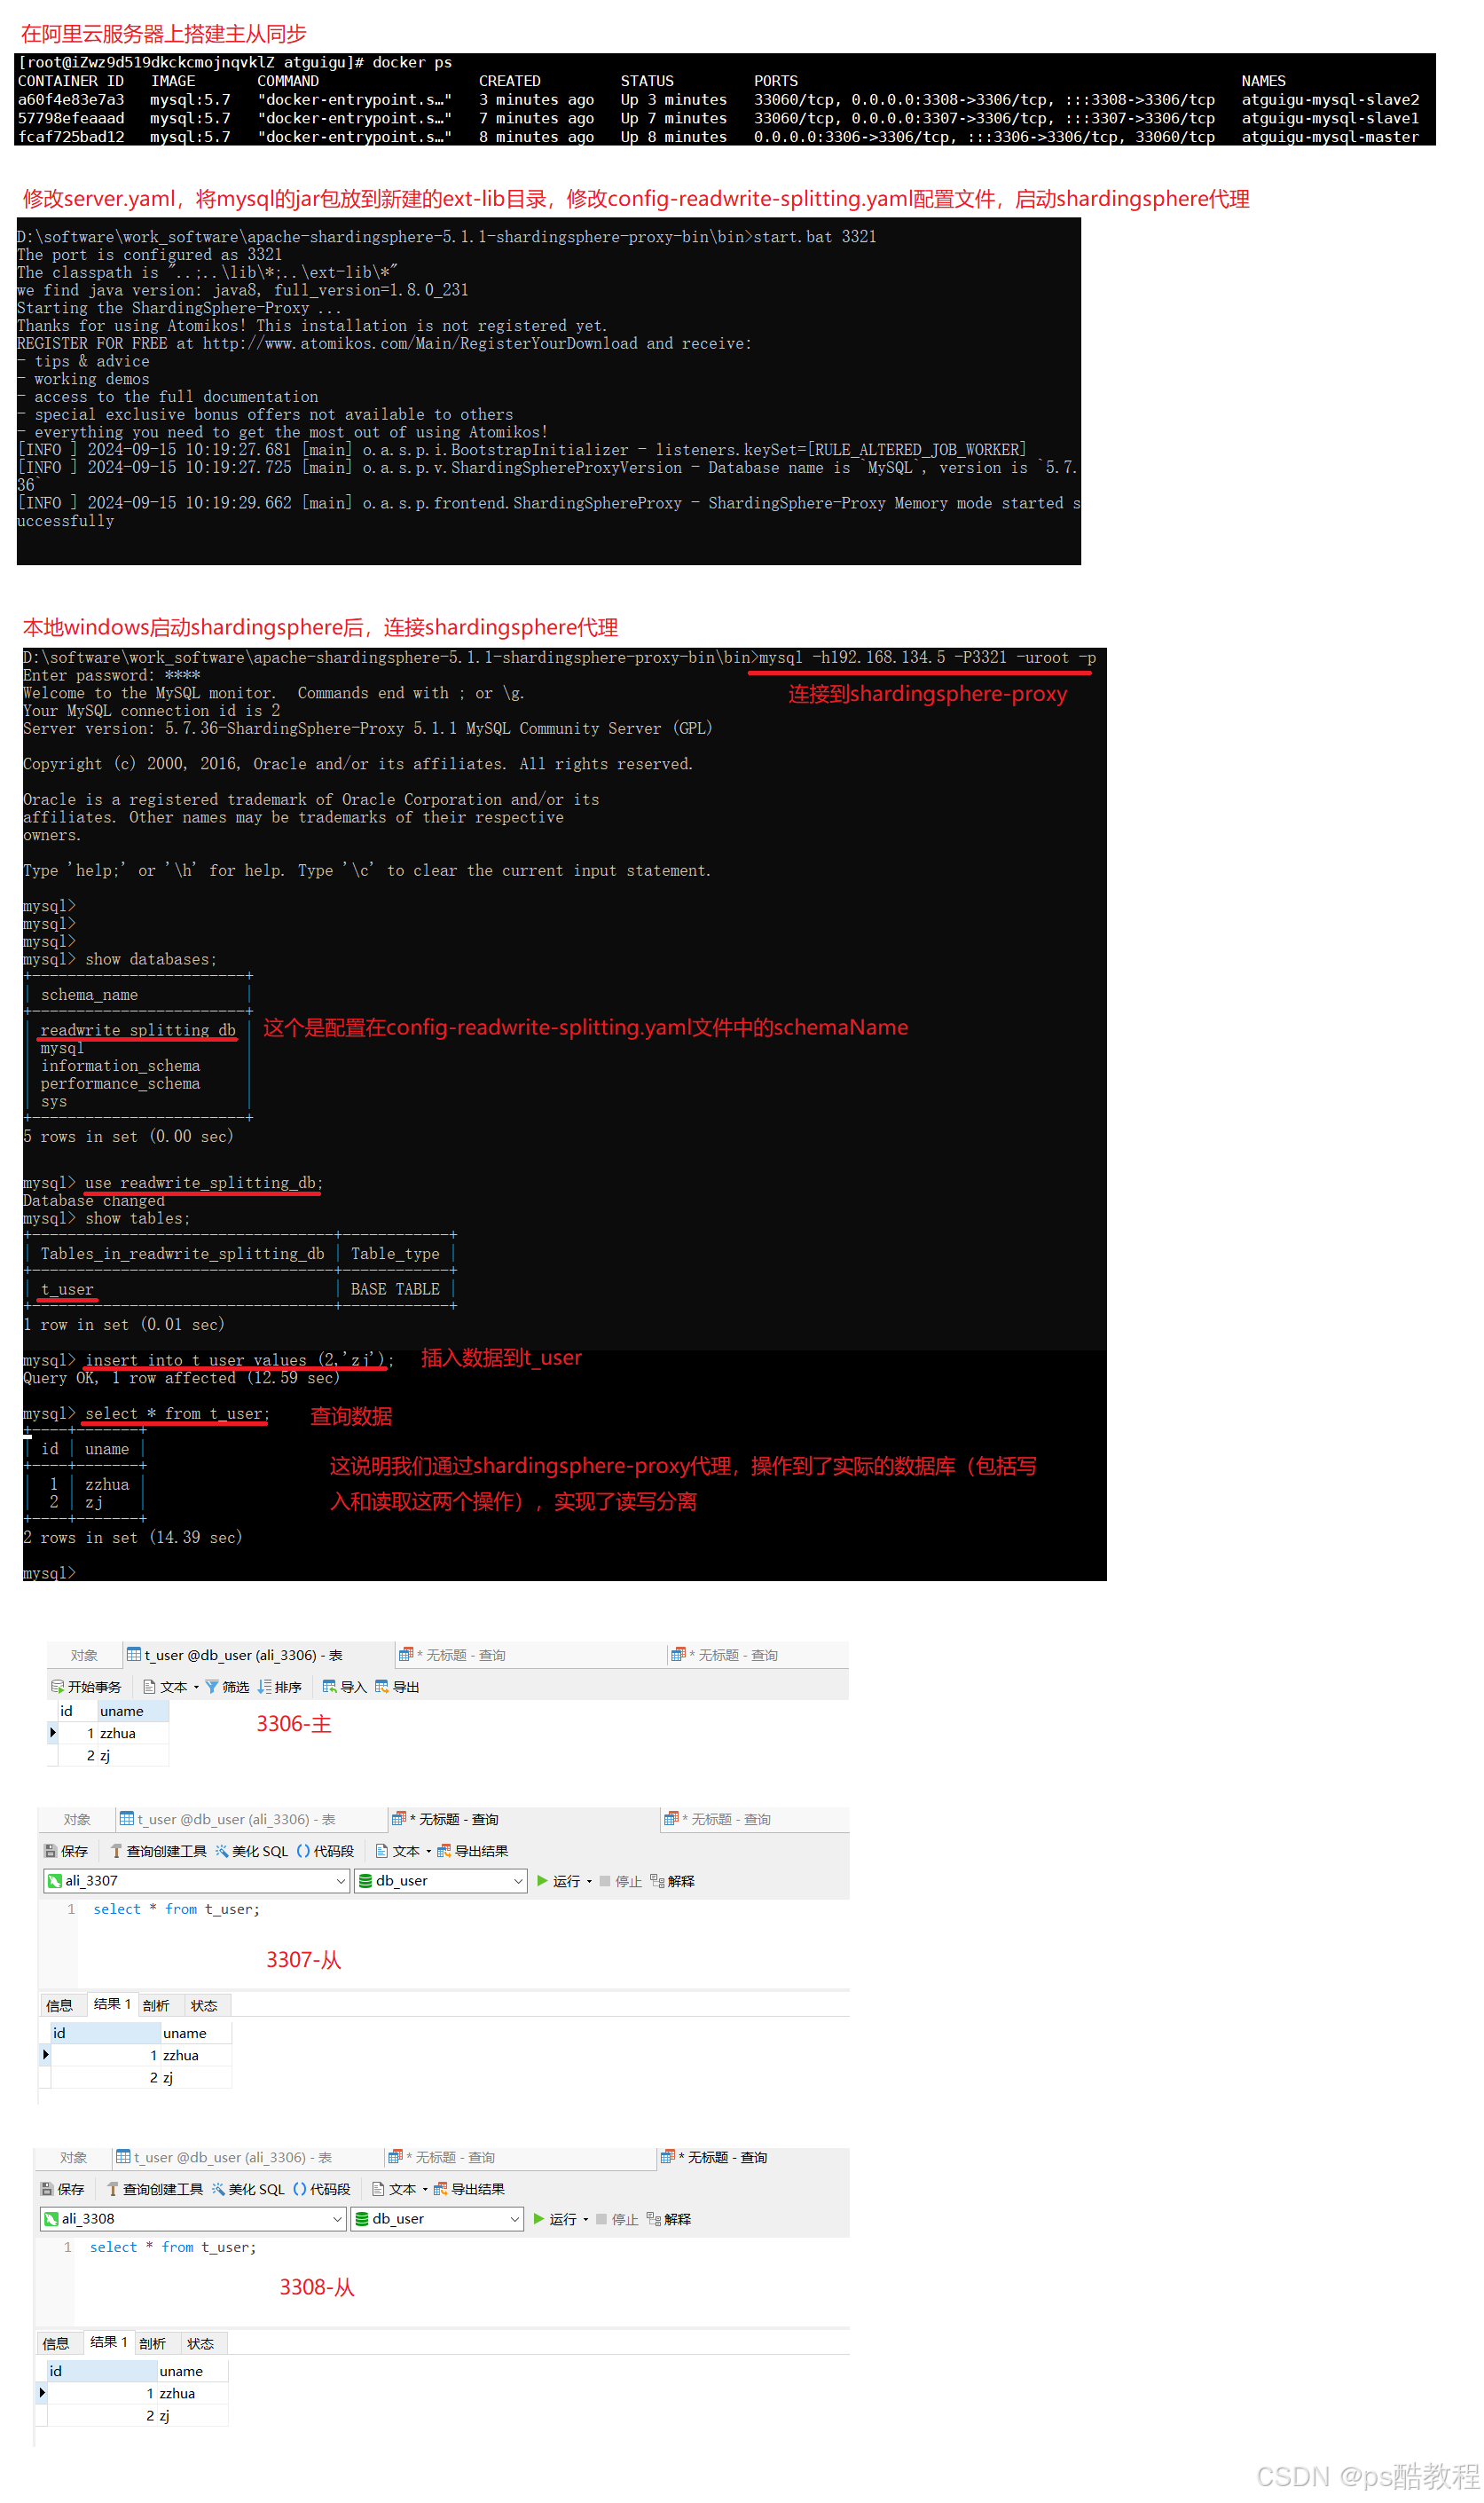
观察日志(步骤在下面图示中)
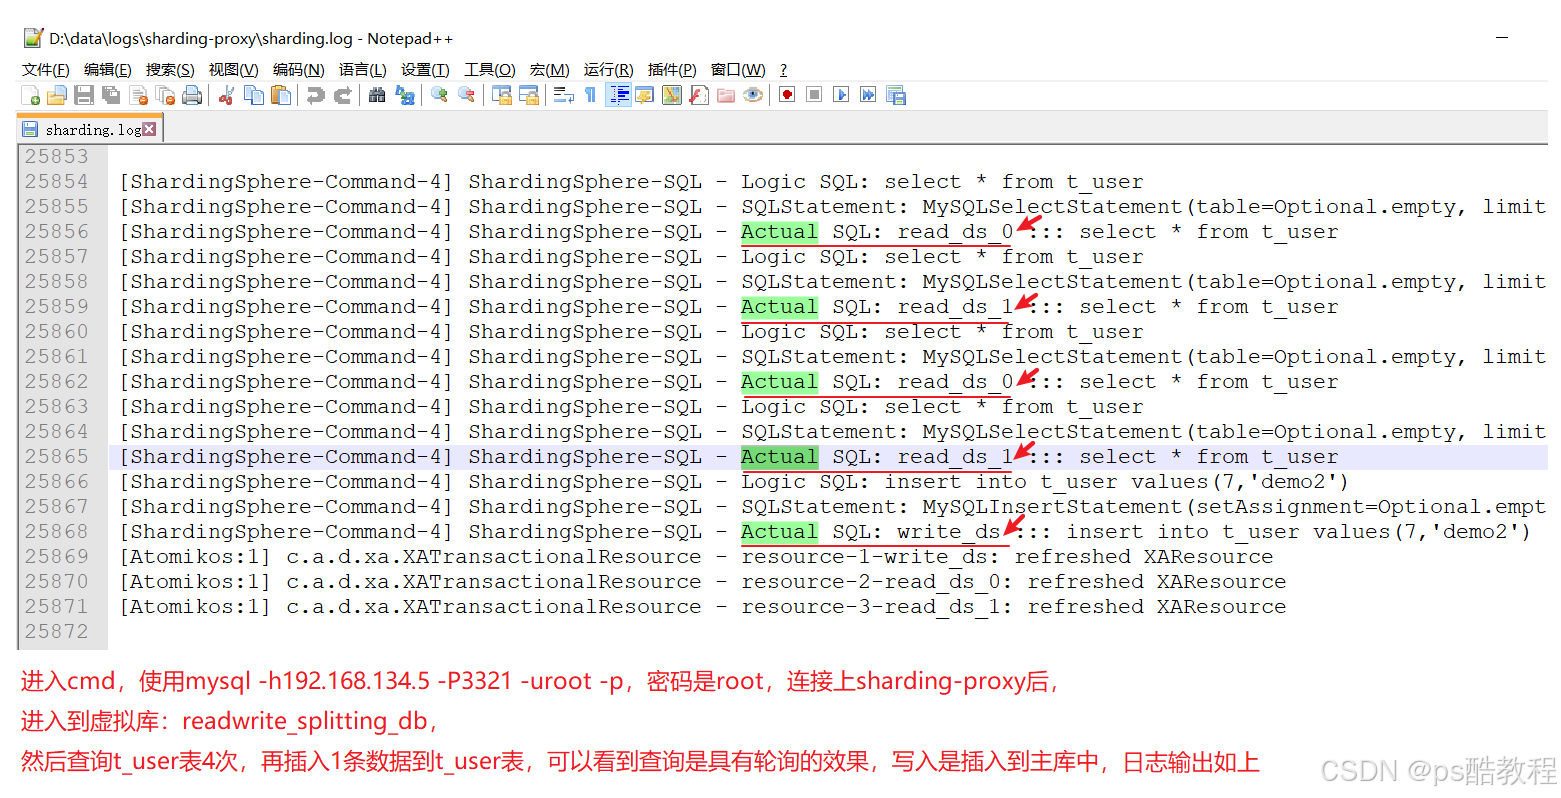
4、应用程序访问Proxy
4.1、创建项目
项目类型:Spring Initializr
SpringBoot脚手架:http://start.aliyun.com
项目名:sharding-proxy-demo
SpringBoot版本:2.3.7.RELEASE
4.2、添加依赖
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0
                             https://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>
    <groupId>com.atguigu</groupId>
    <artifactId>sharding-proxy-demo</artifactId>
    <version>0.0.1-SNAPSHOT</version>
    <name>sharding-proxy-demo</name>
    <description>Demo project for Spring Boot</description>

    <properties>
        <java.version>1.8</java.version>
        <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
        <project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding>
        <spring-boot.version>2.3.7.RELEASE</spring-boot.version>
    </properties>

    <dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>

        <dependency>
            <groupId>mysql</groupId>
            <artifactId>mysql-connector-java</artifactId>
            <scope>runtime</scope>
        </dependency>

        <dependency>
            <groupId>com.baomidou</groupId>
            <artifactId>mybatis-plus-boot-starter</artifactId>
            <version>3.3.1</version>
        </dependency>

        <dependency>
            <groupId>org.projectlombok</groupId>
            <artifactId>lombok</artifactId>
            <optional>true</optional>
        </dependency>

        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-test</artifactId>
            <scope>test</scope>
            <exclusions>
                <exclusion>
                    <groupId>org.junit.vintage</groupId>
                    <artifactId>junit-vintage-engine</artifactId>
                </exclusion>
            </exclusions>
        </dependency>
    </dependencies>

    <dependencyManagement>
        <dependencies>
            <dependency>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-dependencies</artifactId>
                <version>${spring-boot.version}</version>
                <type>pom</type>
                <scope>import</scope>
            </dependency>
        </dependencies>
    </dependencyManagement>

    <build>
        <plugins>
            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-compiler-plugin</artifactId>
                <version>3.8.1</version>
                <configuration>
                    <source>1.8</source>
                    <target>1.8</target>
                    <encoding>UTF-8</encoding>
                </configuration>
            </plugin>
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maven-plugin</artifactId>
                <version>2.3.7.RELEASE</version>
                <configuration>
                    <mainClass>com.atguigu.shardingproxydemo.ShardingProxyDemoApplication</mainClass>
                </configuration>
                <executions>
                    <execution>
                        <id>repackage</id>
                        <goals>
                            <goal>repackage</goal>
                        </goals>
                    </execution>
                </executions>
            </plugin>
        </plugins>
    </build>

</project>
4.3、创建实体类
package com.atguigu.shardingproxydemo.entity;

@TableName("t_user")
@Data
public class User {

    @TableId(type = IdType.AUTO)
    private Long id;

    private String uname;
}
4.4、创建Mapper
package com.atguigu.shardingproxydemo.mapper;

@Mapper
public interface UserMapper extends BaseMapper<User> {
}
4.5、配置数据源
(这里直接填shardingsphere-proxy代理的地址,并且用户名和密码默认都是root)
# 应用名称
spring.application.name=sharding-proxy-demo
# 开发环境设置
spring.profiles.active=dev

#mysql数据库连接(proxy)
spring.datasource.driver-class-name=com.mysql.jdbc.Driver
spring.datasource.url=jdbc:mysql://192.168.134.5:3321/readwrite_splitting_db?serverTimezone=GMT%2B8&useSSL=false
spring.datasource.username=root
spring.datasource.password=root

#mybatis日志
mybatis-plus.configuration.log-impl=org.apache.ibatis.logging.stdout.StdOutImpl
4.6、测试
package com.atguigu.shardingproxydemo;

@SpringBootTest
class ShardingProxyDemoApplicationTests {

    @Autowired
    private UserMapper userMapper;

    /**
     * 读数据测试
     */
    @Test
    public void testSelectAll(){
        List<User> users = userMapper.selectList(null);
        users.forEach(System.out::println);
    }
}
日志输出如下(这里只是大概看一下日志而已)
Creating a new SqlSession
SqlSession [org.apache.ibatis.session.defaults.DefaultSqlSession@4ce94d2f] was not registered for synchronization because synchronization is not active
INFO 1712 --- [           main] com.zaxxer.hikari.HikariDataSource       : HikariPool-1 - Starting...
WARN 1712 --- [           main] com.zaxxer.hikari.util.DriverDataSource  : Registered driver with driverClassName=com.mysql.jdbc.Driver was not found, trying direct instantiation.
INFO 1712 --- [           main] com.zaxxer.hikari.HikariDataSource       : HikariPool-1 - Start completed.
JDBC Connection [HikariProxyConnection@1829440934 wrapping com.mysql.cj.jdbc.ConnectionImpl@4779aae6] will not be managed by Spring
==>  Preparing: SELECT id,uname FROM t_user
==> Parameters:
<==    Columns: id, uname
<==        Row: 1, zzhua
<==        Row: 2, zj
<==        Row: 3, zengjian
<==        Row: 4, zengjian2
<==        Row: 5, zengjian3
<==        Row: 6, demo
<==      Total: 6
Closing non transactional SqlSession [org.apache.ibatis.session.defaults.DefaultSqlSession@4ce94d2f]
User(id=1, uname=zzhua)
User(id=2, uname=zj)
User(id=3, uname=zengjian)
User(id=4, uname=zengjian2)
User(id=5, uname=zengjian3)
User(id=6, uname=demo)
第09章 ShardingSphere-Proxy垂直分片
简述
t_user表在server-user:3301的db_user库,t_order表在server-order:3302的db_order库,现在使用shardingsphere-proxy并启动,当使用mysql命令连接到shardingsphere-proxy数据库中间件代理后,对这2张表的sql操作都路由到正确的库中
1、修改配置文件
修改配置config-sharding.yaml
(这里在上面的基础上注释掉其它的文件,因为这里仅测试垂直分片,所有注释掉了前面的config-readwrite-splitting.yaml配置文件,仅有server.yaml和config-sharding.yaml的配置)
schemaName: sharding_db

dataSources:
  ds_0:
    url: jdbc:mysql://119.23.61.24:3301/db_user?serverTimezone=UTC&useSSL=false
    username: root
    password: 123456
    connectionTimeoutMilliseconds: 30000
    idleTimeoutMilliseconds: 60000
    maxLifetimeMilliseconds: 1800000
    maxPoolSize: 50
    minPoolSize: 1
  ds_1:
    url: jdbc:mysql://119.23.61.24:3302/db_order?serverTimezone=UTC&useSSL=false
    username: root
    password: 123456
    connectionTimeoutMilliseconds: 30000
    idleTimeoutMilliseconds: 60000
    maxLifetimeMilliseconds: 1800000
    maxPoolSize: 50
    minPoolSize: 1

rules:
- !SHARDING
  tables:
    t_user:
      actualDataNodes: ds_0.t_user  # 设定t_user表操作的是ds_0数据源的t_user表
    t_order:
      actualDataNodes: ds_1.t_order # 设定t_order表操作的是ds_1数据源的t_order表
2、实时查看日志
可以通过这种方式查看服务器中输出的SQL语句
docker exec -it server-proxy-a env LANG=C.UTF-8 /bin/bash
tail -f /opt/shardingsphere-proxy/logs/stdout.log
3、远程访问测试
mysql> show databases;
mysql> use sharding_db;
mysql> show tables;
mysql> select * from t_order;
mysql> select * from t_user;
测试
当按照如上配置好后,依然是在本地启动shardingsphere-proxy数据库中间件代理,然后再使用本地cmd连接到数据库中间件代理,当在这个cmd窗口分别查询t_user和t_order表时,从数据库中间件代理的日志中可以看到路由到了正确的表中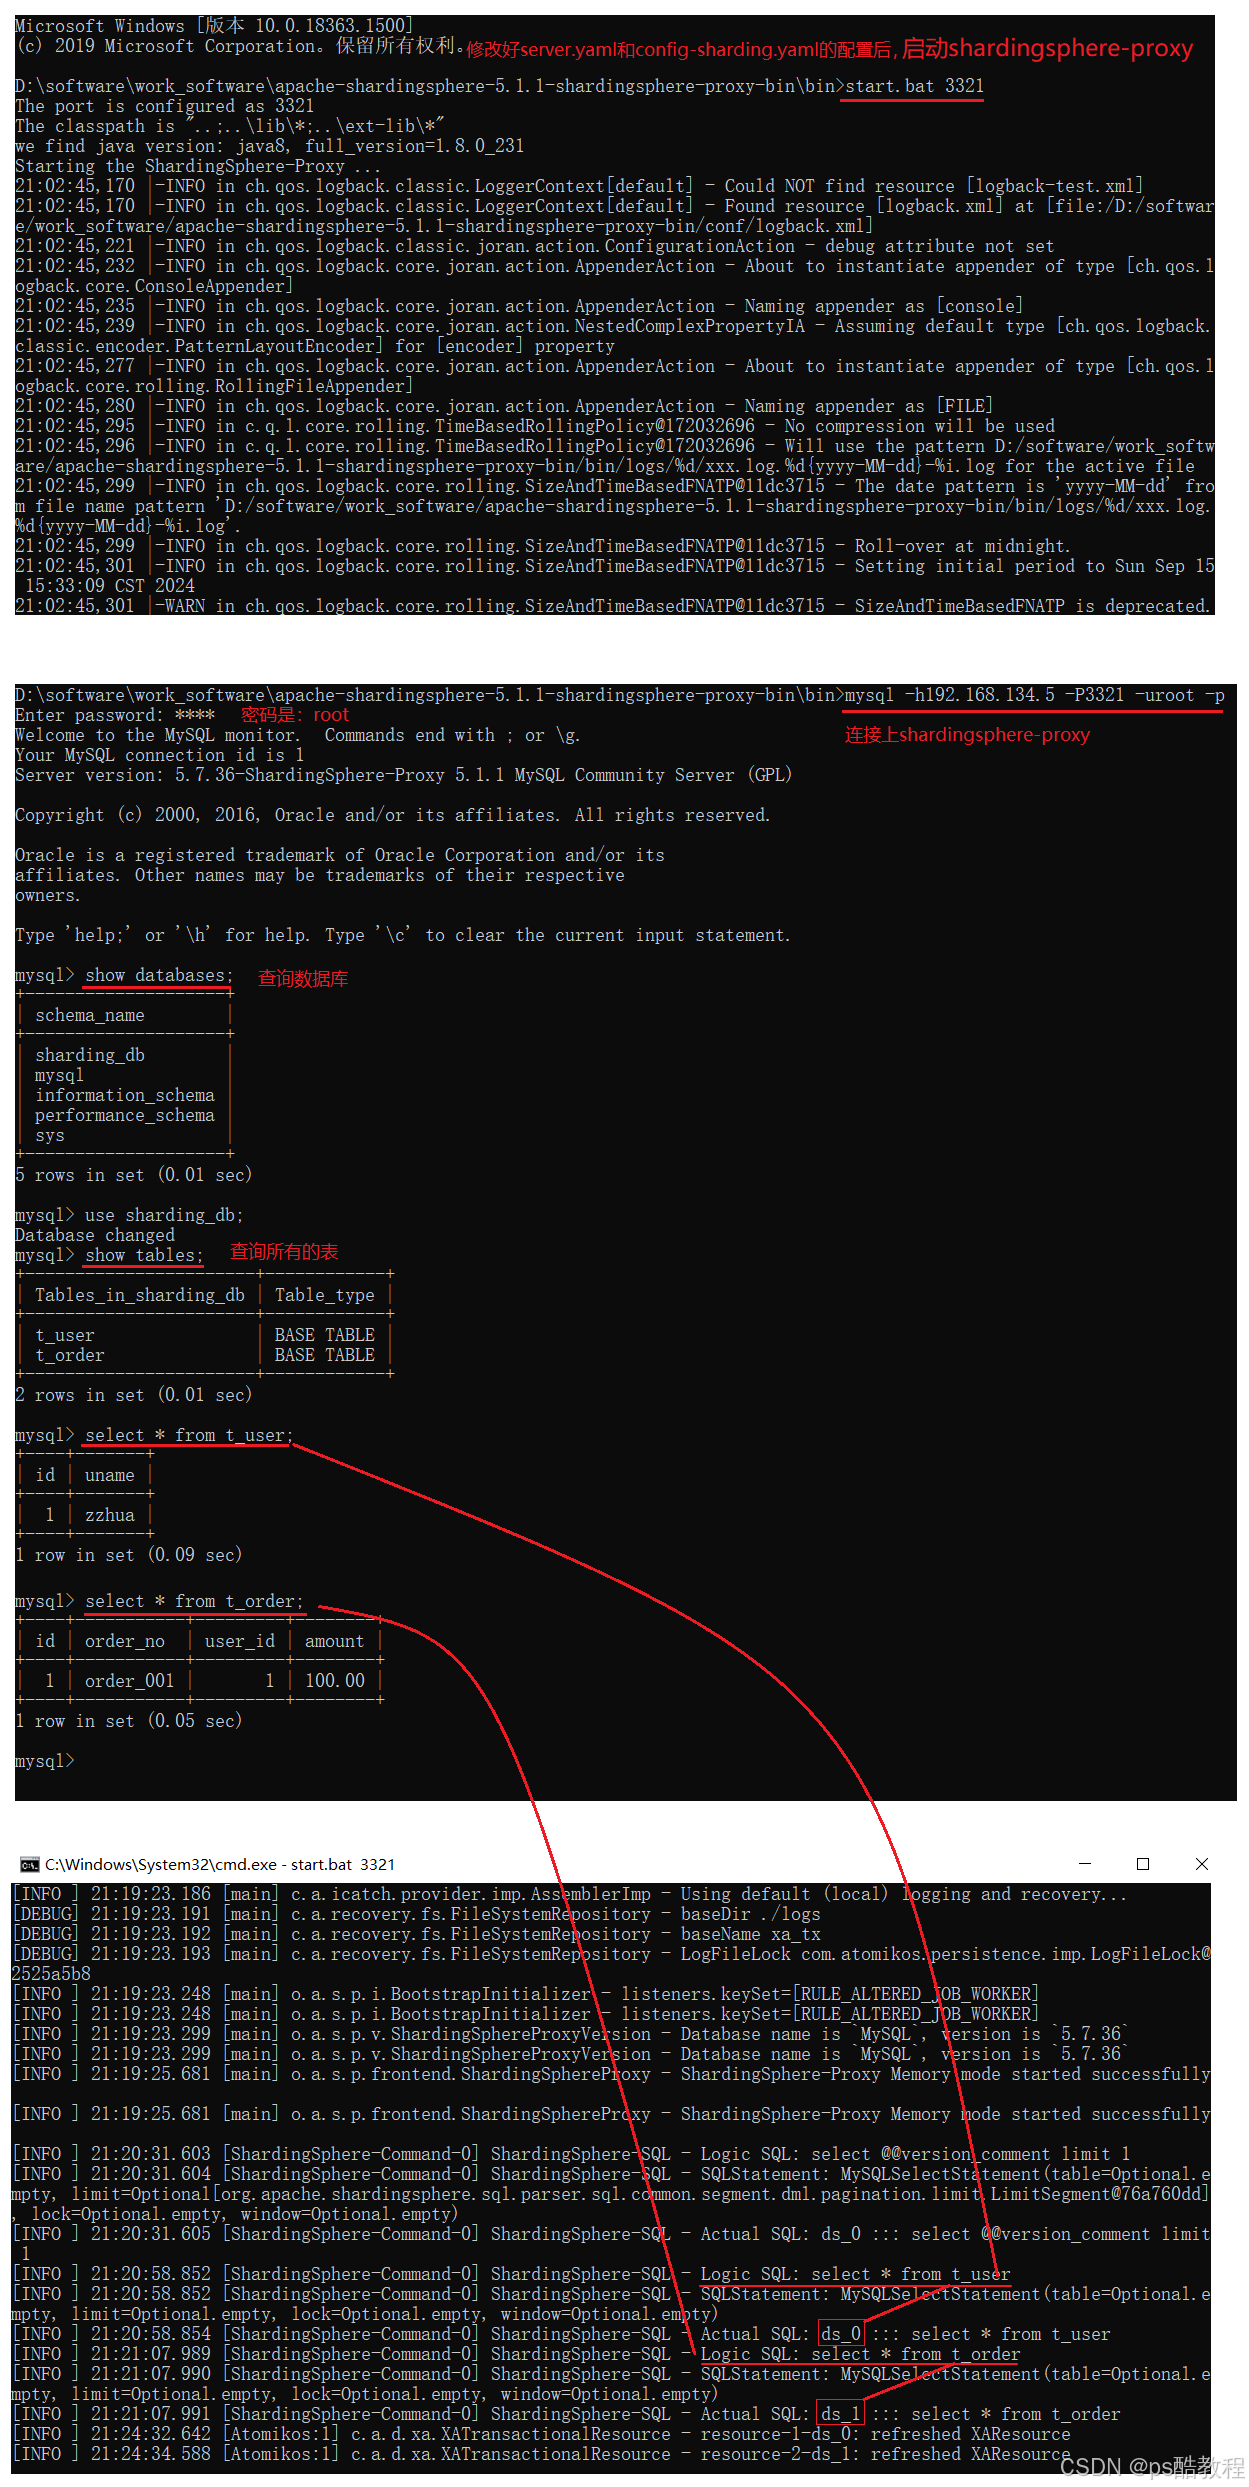
第10章 ShardingSphere-Proxy水平分片
1、修改配置文件
修改配置config-sharding.yaml
schemaName: sharding_db

dataSources:
  ds_user:
    url: jdbc:mysql://119.23.61.24:3301/db_user?serverTimezone=UTC&useSSL=false
    username: root
    password: 123456
    connectionTimeoutMilliseconds: 30000
    idleTimeoutMilliseconds: 60000
    maxLifetimeMilliseconds: 1800000
    maxPoolSize: 50
    minPoolSize: 1
  ds_order0:
    url: jdbc:mysql://119.23.61.24:3310/db_order?serverTimezone=UTC&useSSL=false
    username: root
    password: 123456
    connectionTimeoutMilliseconds: 30000
    idleTimeoutMilliseconds: 60000
    maxLifetimeMilliseconds: 1800000
    maxPoolSize: 50
    minPoolSize: 1
  ds_order1:
    url: jdbc:mysql://119.23.61.24:3311/db_order?serverTimezone=UTC&useSSL=false
    username: root
    password: 123456
    connectionTimeoutMilliseconds: 30000
    idleTimeoutMilliseconds: 60000
    maxLifetimeMilliseconds: 1800000
    maxPoolSize: 50
    minPoolSize: 1

rules:
- !SHARDING
  tables:
    t_user:
      actualDataNodes: ds_user.t_user

    t_order:
      actualDataNodes: ds_order${0..1}.t_order${0..1}
      tableStrategy:
        standard:
          shardingColumn: order_no
          shardingAlgorithmName: alg_hash_mod
      databaseStrategy:
        standard:
          shardingColumn: user_id
          shardingAlgorithmName: alg_mod
      keyGenerateStrategy:
        column: id
        keyGeneratorName: snowflake

    t_order_item:
      actualDataNodes: ds_order${0..1}.t_order_item${0..1}
      tableStrategy:
        standard:
          shardingColumn: order_no
          shardingAlgorithmName: alg_hash_mod
      databaseStrategy:
        standard:
          shardingColumn: user_id
          shardingAlgorithmName: alg_mod
      keyGenerateStrategy:
        column: id
        keyGeneratorName: snowflake

  bindingTables:
    - t_order,t_order_item


  broadcastTables:
    - t_dict

  shardingAlgorithms:
    alg_mod:
      type: MOD
      props:
        sharding-count: 2
    alg_hash_mod:
      type: HASH_MOD
      props:
        sharding-count: 2

  keyGenerators:
    snowflake:
      type: SNOWFLAKE
2、实时查看日志
可以通过这种方式查看服务器中输出的SQL语句
docker exec -it server-proxy-a env LANG=C.UTF-8 /bin/bash
tail -f /opt/shardingsphere-proxy/logs/stdout.log
3、远程访问测试
mysql> show databases;
mysql> use sharding_db;
mysql> show tables;
mysql> select * from t_order; --测试水平分片
mysql> select * from t_dict; --测试广播表
测试
启动的数据源如下

配置好server.yaml和configSharding.yaml这2个配置文件,然后启动sharding-proxy,之后访问数据库代理,观察数据库代理的日志输出
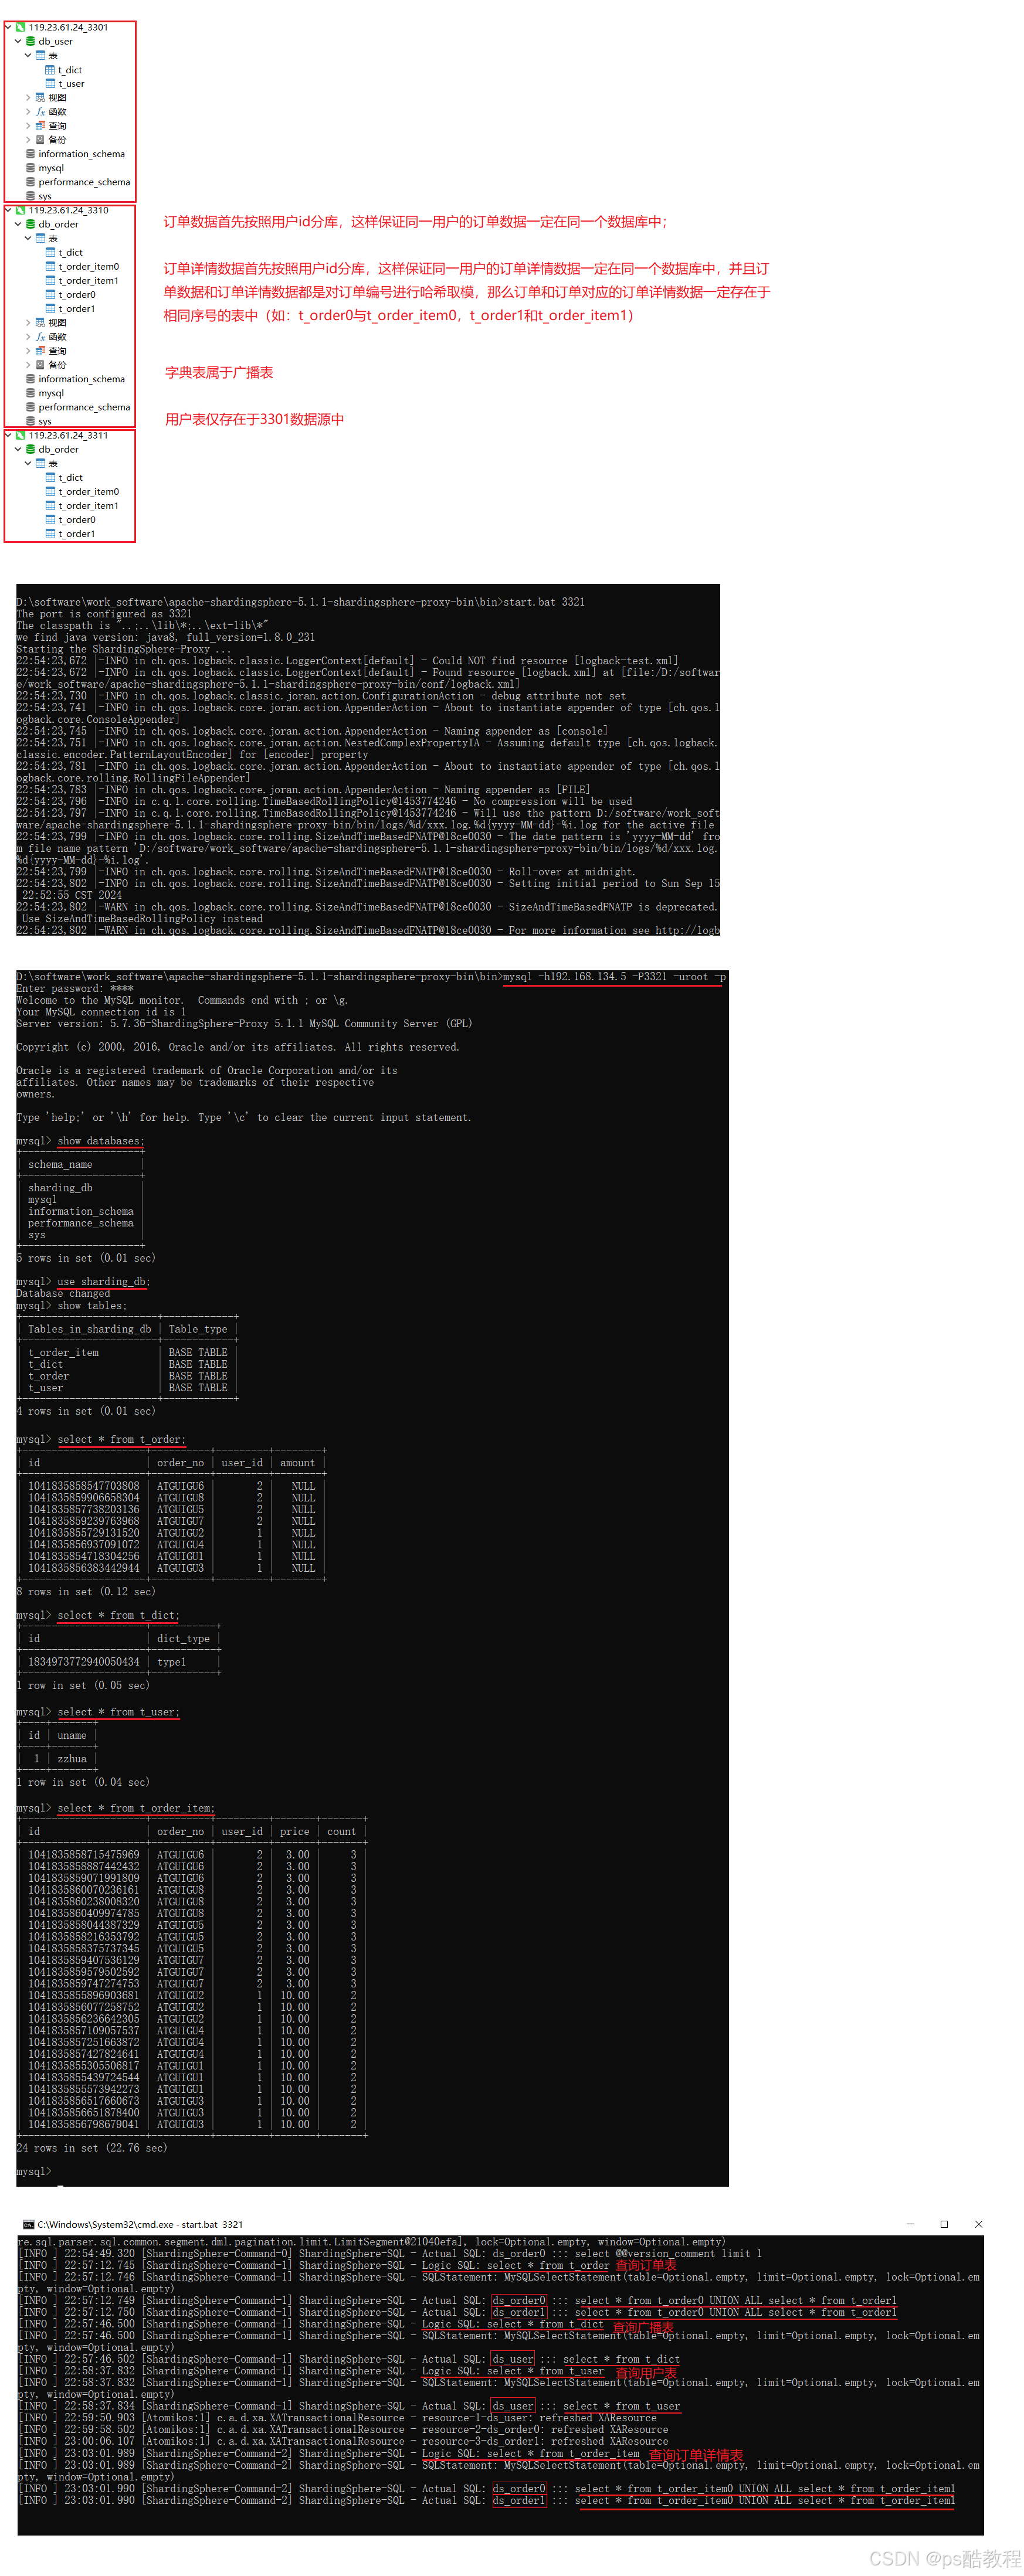
更多推荐



 18
 0
- 0


 已为社区贡献6条内容

所有评论(0)