
TIGER:基于生成式检索的推荐系统
现代推荐系统主要是通过在同一空间中构建查询emb和item的emb,然后通过大规模检索,在给定查询emb的情况下进行近似近邻搜索以选择最佳item。本文提出了一种新的生成检索方法Transformer Index for GEnerative Recommenders (TIGER) ,其中检索模型对目标item的标识符进行自回归解码。为此,作者构建了具有语义意义的码字(codeword)元组,作为每个item的语义ID。给定用户会话中item的语义ID,训练基于Transformer的seq-to-seq模型来预测用户将与之交互的下一个item的语义标识。
本文提出的TIGER主要分为两步:
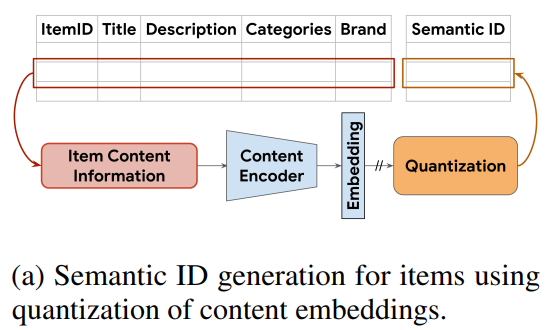
假设每个item都有相关的内容特征,这些特征捕捉有用的语义信息(例如标题或描述或图像)。采用预训练的内容编码器来生成语义emb
,比如采用BERT,转换item的文本特征,以获得语义emb。然后对语义emb进行量化,以生成每个item的语义ID,如图a所示。
将语义ID为长度为m的码字元组。元组中的每个码字都来自不同的码本。语义ID可以唯一表示的item的数量,因此码本大小的乘积等于item集合的大小。虽然生成语义ID的不同技术导致ID具有不同的语义属性,但它们得有以下属性:相似的item(具有相似内容特征或语义emb紧密的item)应该具有重叠的语义ID。例如,与语义ID为(10,23,32)的item相比,具有语义ID(10,21,35)的item应该更类似于具有语义ID的项目(10,21,40)。即相似的item的语义ID重叠度应该较高。
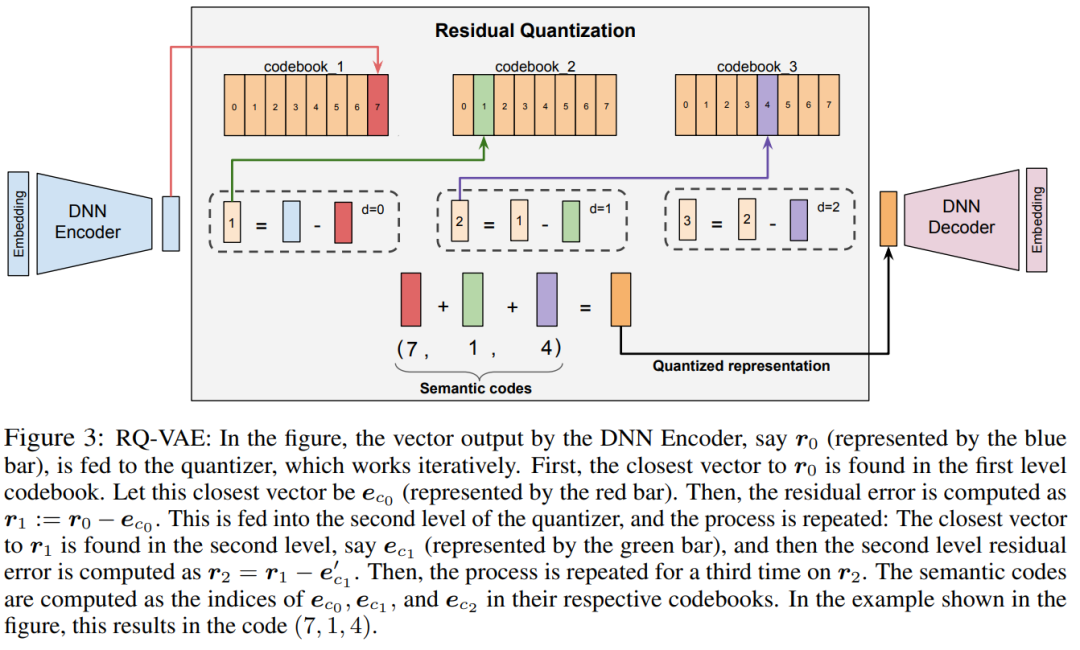
残差量化变分自动编码器(RQ-VAE)是一种多级向量量化器,在残差上进行量化来生成码字元组(语义ID)。通过更新量化码本和DNN编码器-解码器参数来联合训练自动编码器。具体流程如上面图3所示。
是解码器的输出,sg表示停止梯度运算(stop gradient)。共同训练编码器、解码器和码本。
为了防止RQ-VAE发生码本崩溃(大多数输入仅映射到少数码本向量),使用k均值聚类来初始化码本,将k-means算法应用于第一个训练批次(first training batch),并使用质心作为初始化。当然除了使用RQ-VAE,也可以使用其他的向量化方法,如LSH等
碰撞就是发生语义冲突了,多个item映射到同一个码字上了。为了消除冲突,本文在有序语义码字的末尾添加了一个额外的标记,以使它们具有唯一性。例如,如果两个项目共享语义ID(12,24,52),附加额外的令牌来区分它们,将这两个项目表示为(12,24,52,0)和(12,24,52,1)。为了检测冲突,需要维护一个将语义ID映射到相应item的查找表。
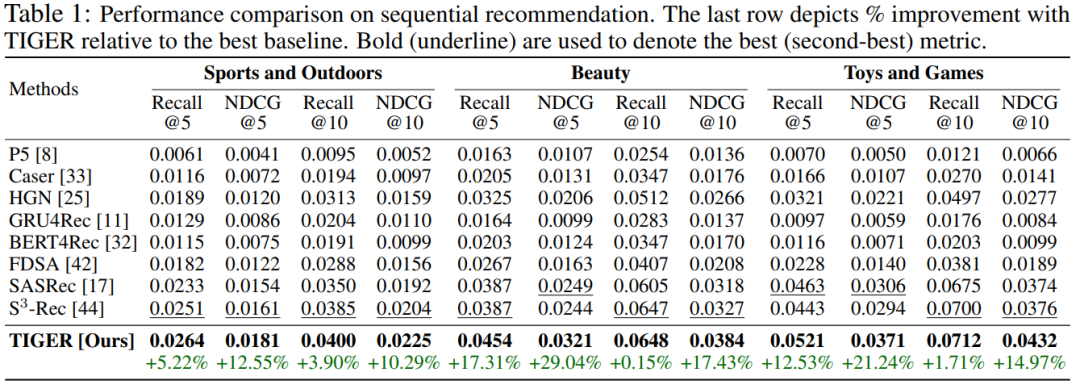
不同量化方法对比
更多推荐
 0
 0
- 0


 已为社区贡献4条内容

所有评论(0)