
数据结构与算法分析:(十一)散列表(上)
public static int hash(String key, int tableSize) {
int hashVal = 0;
for (int i = 0; i < key.length(); i++) {
hashVal = 27 * hashVal + key.charAt(i);
}
hashVal %= tableSize;
if (hashVal < 0) hashVal += tableSize;
return hashVal;
}
这个散列函数涉及关键字中所有字符,并且一般可以分布的很好,它计算下面这个公式,并将结果限制在适当的范围内。
∑ i = 0 K e y S i z e − 1 K e y [ K e y S i z e − i − 1 ] ∗ 2 7 i \displaystyle\sum_{i=0}^{KeySize-1} Key[KeySize - i- 1] * 27^i i=0∑KeySize−1Key[KeySize−i−1]∗27i
程序这里根据 Horner 法则计算一个(27的)多项式函数。例如:
计算 h k = h 0 + 27 k 1 + 2 7 2 k 2 h_k = h_0 + 27k_1 + 27^2k_2 hk=h0+27k1+272k2 是借助公式 h k = ( ( k 2 ) ∗ 27 + k 1 ) ∗ 27 + k 0 h_k = ((k_2) * 27 + k_1)* 27 + k_0 hk=((k2)∗27+k1)∗27+k0 进行。 Horner 法则将其扩展到用于 n 次多项式。
这个散列函数利用到事实:允许溢出。这可能会引进负的数,因此在代码后面做了兼容。
上面这个散列函数未必是最好的,但却是具有极其简单的优点而且速度也很快。如果关键字特别长,那么散列函数计算将会花费过多的时间。有些程序设计人员通过只使用奇数位置上的字符来实现它们的散列函数。这里有这么一层想法:用计算散列函数节省下的时间来补偿由此产生的对均匀分布的函数的轻微干扰。
剩下的主要编程细节是解决冲突的消除问题。如果当一个元素被插入时与一个已经插入的元素散列到相同的值,那么就产生一个冲突,这个冲突需要消除。解决这种冲突的方法有几种,我们将讨论其中最简单的两种:分离链接法和开放定址法。
1、分离链接法
分离链接法是一种更加常用的散列冲突解决办法,相比开放寻址法,它要简单很多。我们来看下面我画的图,在散列表中,每个桶(bucket)或槽(slot)会对应一条链表,所有散列值相同的元素我们都放到相同槽位对应的链表中。我这里是 hash(x) = x mod 4举的例子。
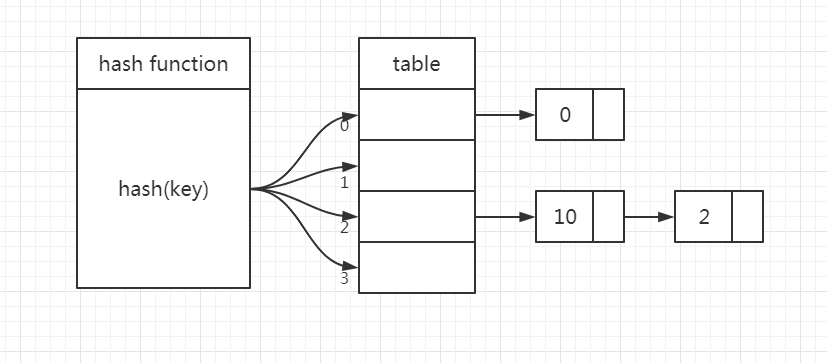
当查找、删除一个元素时,我们同样通过散列函数计算出对应的槽,然后遍历链表查找或者删除。实际上,这两个操作的时间复杂度跟链表的长度 k 成正比,也就是 O(k)。对于散列比较均匀的散列函数来说,理论上讲,k=n/m,其中 n 表示散列中数据的个数,m 表示散列表中“槽”的个数。
当插入的时候,我们只需要通过散列函数计算出对应的散列槽位,将其插入到对应链表中即可,所以插入的时间复杂度是 O(1)。这里需要注意一下:如果允许插入重复元素,那么通常要留出一个额外的域,这个域出现匹配事件时增1;如果这个元素是新元素,那么它将被插入到链表的前端,这不仅因为方便,还因为常常发生这样的事实:新近插入的元素最有可能不久又被访问。
分离链接法散列表的代码供小伙伴们参考:
import java.util.LinkedList;
import java.util.List;
public class SeparateChainingHashTable {
private static final int DEFAULT_TABLE_SIZE = 101;
private List[] theLists;
private int currentSize;
public SeparateChainingHashTable() {
this(DEFAULT_TABLE_SIZE);
}
public SeparateChainingHashTable(int size) {
theLists = new LinkedList[nextPrime(size)];
for (int i = 0; i < theLists.length; i++) {
theLists[i] = new LinkedList<>();
}
}
public void insert(AnyType x) {
List whichList = theLists[myhash(x)];
if (!whichList.contains(x)) {
whichList.add(x);
if (++currentSize > theLists.length) {
rehash();
}
}
}
public void remove(AnyType x) {
List whichList = theLists[myhash(x)];
if (whichList.contains(x)) {
whichList.remove(x);
currentSize–;
}
}
public boolean contains(AnyType x) {
List whichList = theLists[myhash(x)];
return whichList.contains(x);
}
public void makeEmpty() {
for (int i = 0; i < theLists.length; i++) {
theLists[i].clear();
}
}
private void rehash() {
List[] oldLists = theLists;
// Create new double-sized, empty table
theLists = new List[nextPrime(2 * theLists.length )];
for(int j = 0; j < theLists.length; j++) {
theLists[j] = new LinkedList<>();
}
// Copy table over
currentSize = 0;
for(List list : oldLists) {
for(AnyType item : list) {
insert(item);
}
}
}
private int myhash(AnyType x) {
int hashVal = x.hashCode();
hashVal %= theLists.length;
if (hashVal < 0) {
hashVal += theLists.length;
}
return hashVal;
}
private static int nextPrime(int n) {
if(n % 2 == 0) n++;
for(; !isPrime(n); n += 2) {
;
}
return n;
}
private static boolean isPrime(int n) {
if(n == 2 || n == 3) return true;
if(n == 1 || n % 2 == 0) return false;
for(int i = 3; i * i <= n; i += 2) {
if(n % i == 0) return false;
}
return true;
自我介绍一下,小编13年上海交大毕业,曾经在小公司待过,也去过华为、OPPO等大厂,18年进入阿里一直到现在。
深知大多数Java工程师,想要提升技能,往往是自己摸索成长或者是报班学习,但对于培训机构动则几千的学费,着实压力不小。自己不成体系的自学效果低效又漫长,而且极易碰到天花板技术停滞不前!
因此收集整理了一份《2024年Java开发全套学习资料》,初衷也很简单,就是希望能够帮助到想自学提升又不知道该从何学起的朋友,同时减轻大家的负担。
既有适合小白学习的零基础资料,也有适合3年以上经验的小伙伴深入学习提升的进阶课程,基本涵盖了95%以上Java开发知识点,真正体系化!
由于文件比较大,这里只是将部分目录截图出来,每个节点里面都包含大厂面经、学习笔记、源码讲义、实战项目、讲解视频,并且会持续更新!
如果你觉得这些内容对你有帮助,可以扫码获取!!(备注Java获取)
Kafka进阶篇知识点
Kafka高级篇知识点
44个Kafka知识点(基础+进阶+高级)解析如下
由于篇幅有限,小编已将上面介绍的**《Kafka源码解析与实战》、Kafka面试专题解析、复习学习必备44个Kafka知识点(基础+进阶+高级)都整理成册,全部都是PDF文档**
《一线大厂Java面试题解析+核心总结学习笔记+最新讲解视频+实战项目源码》,点击传送门即可获取!
g-jDKYfkrX-1712448660657)]
44个Kafka知识点(基础+进阶+高级)解析如下
[外链图片转存中…(img-dShTXh4f-1712448660658)]
由于篇幅有限,小编已将上面介绍的**《Kafka源码解析与实战》、Kafka面试专题解析、复习学习必备44个Kafka知识点(基础+进阶+高级)都整理成册,全部都是PDF文档**
《一线大厂Java面试题解析+核心总结学习笔记+最新讲解视频+实战项目源码》,点击传送门即可获取!
更多推荐

 24
 0
- 0


 已为社区贡献1条内容

所有评论(0)