
R语言贝叶斯模型预测电影评分数据可视化分析
全文链接:https://tecdat.cn/?p=34421
本文使用R语言帮助客户进行了贝叶斯模型预测电影评分,并对数据进行了可视化和分析(点击文末“阅读原文”获取完整代码数据)。
相关视频
文章创建了五个新的特征变量,包括电影类型、导演获奖情况、电影票房、评论数量和影评人数量等,并分析了这些变量对电影评分的影响。通过模型预测和系数解释,发现imdb_rating具有最高的后验概率,且截距和运行时对观众评分有积极影响,而评论数量和影评人数量对观众评分的影响较小。文章还提供了对数据的探索性分析,并得出了某些见解,如舞蹈电影更受欢迎,较长的电影通常会让观众感到无聊等。
读取数据
load("e1fevies.Rdata")数据
数据概述
数据集电影包括2016年之前发布的651个随机取样的电影,包括蕃茄和IMDb的信息。
范围
数据集为回顾性观察性研究的结果,该研究使用随机抽样方法从电影获得代表性样本。由于随机抽样方法被应用于数据收集,结果应该可以推广到目标人群。
数据预处理
创建五个新的特征变量。
mr(ifelse(title_type=='Feature Film', 'yes', 'no')))
mor(ifelse(genre=='Drama', 'yes', 'no')))
movies <- mutate(movies,ating=='R
数据探索分析
因为响应变总是audience_score,所以我们希望y轴看到所有变量的比较。因此,我们可以使用tidyr包的collect函数将所有5个新创建的变量放到单个列中。
movies_ed <- gath7)然后我们创建一个箱线图。
ggplot(moviegag)) + geom_bxplot()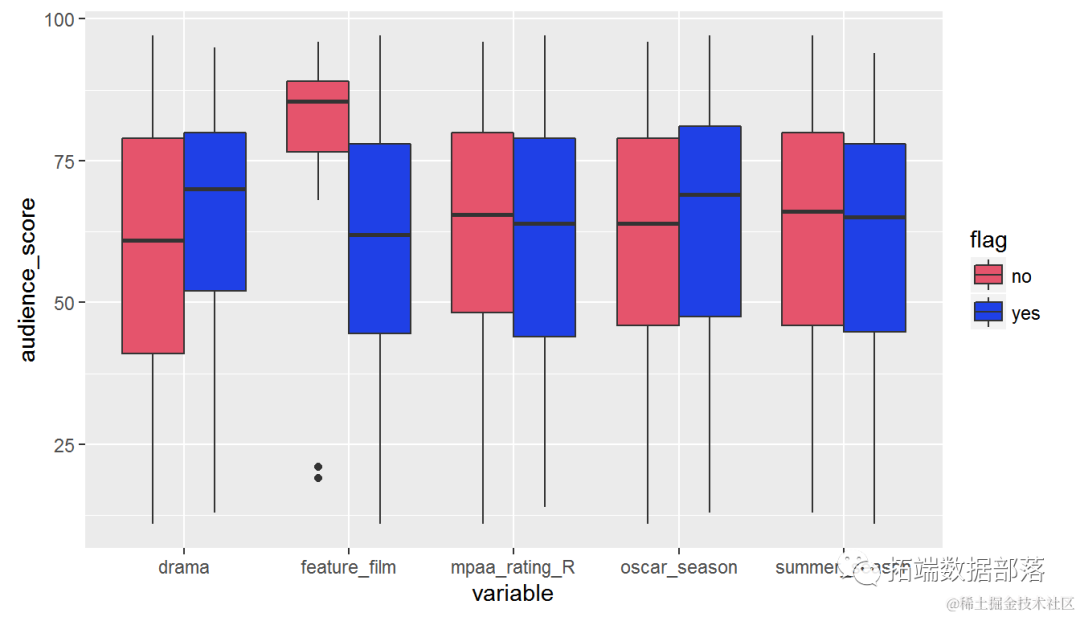
进行数据摘要统计。
点击标题查阅往期内容
R语言贝叶斯MCMC:GLM逻辑回归、Rstan线性回归、Metropolis Hastings与Gibbs采样算法实例
左右滑动查看更多
01
02
03
04
summarise(mean=mean(audience_scoence_score))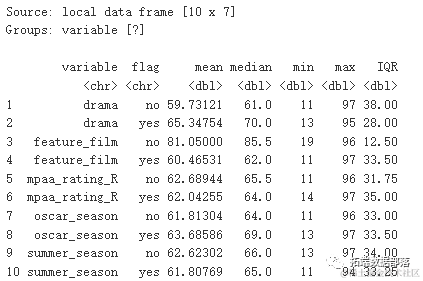
很明显,从剧情和摘要来看,戏剧电影往往具有比其他类型更高的分数。feature films 电影比 non-feature电影电影的得分低得多。然而,其他变量似乎对分数没有任何显著影响。
贝叶斯模型
现在进行贝叶斯模型的建立。
model <- bam(datdienc_score ~ feature_film + drama + runtime +
......
               + best_dir_win + top200_box, prior = 'BIC', mo
让我们为每个变量输出边际后验概率。
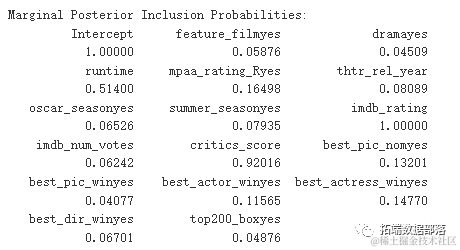
我们可以看到imdb_rating具有1.00的后验概率,这在电影工业的背景下听起来很合理。同时critics_score和runtime也有很高的概率。
然后让我们看看模型的总结。
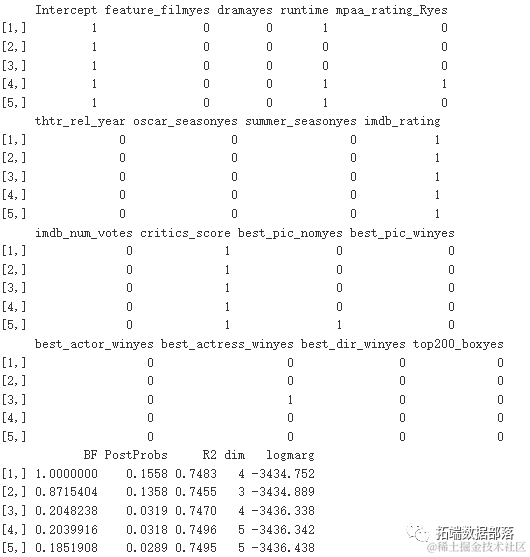
我们看到,最好的模型包括截距,运行时的imdb_rating和critics_score是与上述发现一致。
我们拟合最好的模型并解释它的系数。
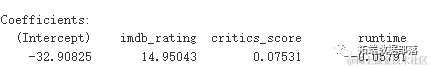
我们看到imdb_rating具有14.95的系数,意味着对于imdb_rating的每增加1个额外的分数,我们期望audience_score会增加14.95。由于IMDB得分以0到10的衡量量表给出,并且audience_score以0到100的衡量量表给出,并且考虑截距= -32.90,这个结论是有道理的。
类似地,对于critics_score上的每增加1个额外得分,我们期望audience_score会增加0.075。显然,这不像imdb_rating那样有影响力。
最后,对于电影运行时间每增加一分钟,我们预计在audience_score中将减少0.058。这意味着一般来说,人们不喜欢冗长的电影。
预测
现在使用我们的最终模型来预测X-MEN的观众分数 。
predict(finew_movie)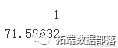
该模型预测观众分数为71.5,接近真实值71。
结论
事实上,imdb_rating具有最高的后验概率,并且我们五个新创建的变量中有两个不包括在最佳模型中,这是需要改进的。因为IMDB评级与观众分数有些同步,因此事先来预测变量是欠妥的,critics_score也是同样道理。
然而,我们确实有一些见解可能是有用的。舞蹈电影更受欢迎; 特征/非特征电影在观众分数方面具有突出的优势; 较长的电影通常会让观众感到无聊等。

本文中分析的数据分享到会员群,扫描下面二维码即可加群!
点击文末“阅读原文”
获取全文完整代码数据资料。
本文选自《R语言贝叶斯模型预测电影评分数据可视化分析》。

点击标题查阅往期内容
R语言逻辑回归、Naive Bayes贝叶斯、决策树、随机森林算法预测心脏病
PYTHON银行机器学习:回归、随机森林、KNN近邻、决策树、高斯朴素贝叶斯、支持向量机SVM分析营销活动数据|数据分享
PYTHON用户流失数据挖掘:建立逻辑回归、XGBOOST、随机森林、决策树、支持向量机、朴素贝叶斯和KMEANS聚类用户画像
R语言中贝叶斯网络(BN)、动态贝叶斯网络、线性模型分析错颌畸形数据
python贝叶斯随机过程:马尔可夫链Markov-Chain,MC和Metropolis-Hastings,MH采样算法可视化
Python贝叶斯推断Metropolis-Hastings(M-H)MCMC采样算法的实现
Metropolis Hastings采样和贝叶斯泊松回归Poisson模型
贝叶斯分位数回归、lasso和自适应lasso贝叶斯分位数回归分析免疫球蛋白、前列腺癌数据
R语言RSTAN MCMC:NUTS采样算法用LASSO 构建贝叶斯线性回归模型分析职业声望数据
R语言STAN贝叶斯线性回归模型分析气候变化影响北半球海冰范围和可视化检查模型收敛性
PYTHON用户流失数据挖掘:建立逻辑回归、XGBOOST、随机森林、决策树、支持向量机、朴素贝叶斯和KMEANS聚类用户画像
贝叶斯分位数回归、lasso和自适应lasso贝叶斯分位数回归分析免疫球蛋白、前列腺癌数据
R语言Metropolis Hastings采样和贝叶斯泊松回归Poisson模型
Python决策树、随机森林、朴素贝叶斯、KNN(K-最近邻居)分类分析银行拉新活动挖掘潜在贷款客户
R语言贝叶斯MCMC:用rstan建立线性回归模型分析汽车数据和可视化诊断
R语言贝叶斯MCMC:GLM逻辑回归、Rstan线性回归、Metropolis Hastings与Gibbs采样算法实例
R语言贝叶斯Poisson泊松-正态分布模型分析职业足球比赛进球数
R语言逻辑回归、Naive Bayes贝叶斯、决策树、随机森林算法预测心脏病
R语言用Rcpp加速Metropolis-Hastings抽样估计贝叶斯逻辑回归模型的参数
R语言中的block Gibbs吉布斯采样贝叶斯多元线性回归
R语言实现贝叶斯分位数回归、lasso和自适应lasso贝叶斯分位数回归分析
R语言用WinBUGS 软件对学术能力测验建立层次(分层)贝叶斯模型
R语言和STAN,JAGS:用RSTAN,RJAG建立贝叶斯多元线性回归预测选举数据
R语言贝叶斯推断与MCMC:实现Metropolis-Hastings 采样算法示例
R语言使用Metropolis-Hastings采样算法自适应贝叶斯估计与可视化
R语言随机搜索变量选择SSVS估计贝叶斯向量自回归(BVAR)模型
R语言实现MCMC中的Metropolis–Hastings算法与吉布斯采样
R语言贝叶斯推断与MCMC:实现Metropolis-Hastings 采样算法示例
R语言使用Metropolis-Hastings采样算法自适应贝叶斯估计与可视化
R语言MCMC:Metropolis-Hastings采样用于回归的贝叶斯估计

更多推荐

 16
 0
- 0


 已为社区贡献6条内容

所有评论(0)