
毕业设计--基于neo4j的股票筛选系统
项目介绍
通过对东方财富网的盈利预测板块爬虫,拿到股票的每股盈利预测,结合该股的现市值,就可算出股票的预测市盈率,从而帮助我们筛选股票。而neo4j是一个图形数据库,我们将股票信息存入neo4j中并且以知识图谱的形式展现出来。
开发日志
4.9及之前
首先我们要完成对东方财富的爬虫工作,一开始打算爬的是个股研报板块,因为市盈率他帮你计算好了,选用jsoup,jsoup的大致流程是创建一个httpclient-->创建get或者post请求-->获取响应-->获取页面内容
public void testJsoup() throws Exception {
        // 创建HttpClient
        CloseableHttpClient httpClient = HttpClients.createDefault();

        // 创建GET请求
        HttpGet httpGet = new HttpGet("https://reportapi.eastmoney.com/report/list?cb=datatable8079493&industryCode=*&pageSize=50&industry=*&rating=&ratingChange=&beginTime=2020-12-24&endTime=2022-12-24&pageNo=5&fields=&qType=0&orgCode=&code=*&rcode=&p=5&pageNum=5&pageNumber=5&_=1671854592251");
        httpGet.setHeader("User-Agent", "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36");

        // 获取响应
        CloseableHttpResponse response = httpClient.execute(httpGet);

        // 获取页面内容
        if (response.getStatusLine().getStatusCode() == 200) {
            String html = EntityUtils.toString(response.getEntity(), "UTF-8");

            // 创建Document对象
            Document document = Jsoup.parse(html);
            Element element=document.body();
            StringBuffer stringBuffer=new StringBuffer();
//            System.out.println(element.text());
//            String strReg="datatable.?[(]";
            String json=element.text().substring(17);//前17位无用
            JSONObject jObject1=new JSONObject(json);
            //获取对象中的数组
            JSONArray data = jObject1.getJSONArray("data");
            for(int i=0;i<data.length();i++){
                JSONObject jObject2=data.getJSONObject(i);
                String stockName=jObject2.getString("stockName");
                String stockCode=jObject2.getString("stockCode");
                String predictNextTwoYearEps=jObject2.getString("predictNextTwoYearEps");
                String predictNextTwoYearPe=jObject2.getString("predictNextTwoYearPe");
                String predictNextYearEps=jObject2.getString("predictNextYearEps");
                String predictNextYearPe=jObject2.getString("predictNextYearPe");
                String predictThisYearEps=jObject2.getString("predictThisYearEps");
                String predictThisYearPe=jObject2.getString("predictThisYearPe");
              stringBuffer
//                      .append(stockName).append(",")
                        .append(stockCode).append(",")
                        .append(predictNextTwoYearEps).append(",")
                        .append(predictNextTwoYearPe).append(",")
                        .append(predictNextYearEps).append(",")
                        .append(predictNextYearPe).append(",")
                        .append(predictThisYearEps).append(",")
                        .append(predictThisYearPe).append(",")
                        .append("\n");
            }
            File newfile=new File("D:\\个股研报\\test.csv");//待写入文件
            BufferedWriter bufferedWriter=new BufferedWriter(new OutputStreamWriter(new FileOutputStream(newfile),"UTF-8"));

            bufferedWriter.write(stringBuffer.toString());
            bufferedWriter.close();
            System.out.println("文件写入内容完成");


            response.close();
            httpClient.close();
        }

    }
很快遇到了第一个问题:为什么打印出的html内容没数据?经过F12检查network发现该网页的数据是通过js获取的,请求的url是这样的
https://reportapi.eastmoney.com/report/list?cb=datatable8079493&industryCode=*&pageSize=50&industry=*&rating=&ratingChange=&beginTime=2020-12-24&endTime=2022-12-24&pageNo=5&fields=&qType=0&orgCode=&code=*&rcode=&p=5&pageNum=5&pageNumber=5&_=1671854592251
response就是一个名为datatable8079493的json,这下又犯难了,一个是url末尾的_=1671854592251和datatable8079493不知道规律,那就不能写出下一面的url;还有一个问题是response的datatable8079493长度不定,也就不好把他从数据中剥离出来。好消息是response有比html上显示的更多的预测内容,它有预测到后两年的市盈率,而html中只有今年和明年的。
此时我又了解到另一个工具包htmlunit,它可以完成浏览器行为的模拟,例如点击。于是我开始使用htmlunit进行爬虫,它的工作流程是创建一个webclient-->拿htmlpage-->处理内容
public void UnitTest() throws Exception{

        WebClient webClient=new WebClient();
        //禁止css加载
        webClient.getOptions().setCssEnabled(false);//禁止css
        webClient.getOptions().setJavaScriptEnabled(true);//允许js
        HtmlPage page=webClient.getPage("https://data.eastmoney.com/report/profitforecast.jshtml");
        webClient.waitForBackgroundJavaScript(2000);
         System.out.print(firstPage.asXml());

    }
因为htmlunit对css和js的兼容比较差,所以一般来说都要关闭,但是我们的数据是通过js获取的,当然不能关,还有要等待js完成,所以有
webClient.waitForBackgroundJavaScript(2000);
也就是等待两千毫秒。
页面成功拿到了,问题又出现了。
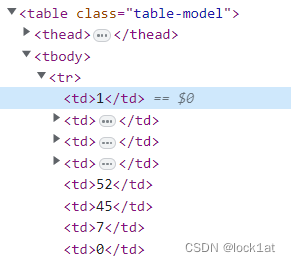
这个table表没id啊,htmlunit官方文档里对table只有通过id获取,相当难办。
4.10
今天灵机一动,既然jsoup的document对象是用html的String类作为参数创建,而jsoup可以通过类名来查询,那我们不是可以用htmlunit来完成跳转下一面,再返回html页面给jsoup处理吗?所以今天就完成htmlunit跳转测试。
跳转就是找到对应的a标签并点击。
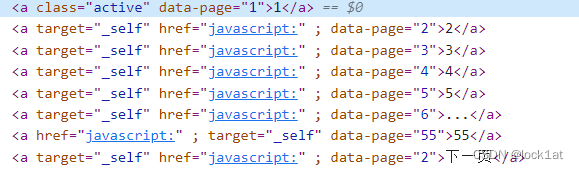
List<HtmlAnchor> ao = index.getByXPath("//a");
HtmlAnchor which = null;
for(HtmlAnchor h :ao) {
    String href = h.getAttribute("data-page").toString();//拿到datapage属性
    if(href.equals("2")) {//如果datapage等于2
//      System.out.println(href);
        which = h;
        break;
    }
}

//点击跳转到第二面
HtmlPage index2 = which.click();
4.11
今天完成跳转到下一面并把每一面的html内容放入集合容器中。
1.选集合容器
我们的需求是有序且不重复,所以选linkedhashset。为什么linkedhashset有序?因为它是继承hashset的,而hashset是用hashmap实现的,底层是数组加链表和红黑树。
public class HashSet<E> extends AbstractSet<E> implements Set<E>, Cloneable, Serializable {
    static final long serialVersionUID = -5024744406713321676L;
    private transient HashMap<E, Object> map;
    private static final Object PRESENT = new Object();
hashset在添加元素时用的是hashmap的put方法,它把元素作为key,把PRESENT作为value,当key相同时,value也相同,此时就会用新的value替换旧value,也就达到了不重复的要求。
2.如何判断哪个超链接是下一页?
声明一个pageNum的整型变量代表当前页面值,在if的判断条件中将data-page转成整型来比对当前页面值加1。
Integer.parseInt(href) == pageNum+1运行报错:href为"",也就是说在某次循环中,href为空串,说明有的datapage的值是空值,虽然按理来说datapage的值只会是数字或者空值,但是为了程序的复用性更好,我们用正则表达式判断href的值是否为数字。
Pattern p=Pattern.compile("^[0-9]{1,2}$");
                if (p.matcher(href).matches() && Integer.parseInt(href) == pageNum+1) {
3.我们找到了下一面但是如何让这一过程重复下去呢?
双层循环
我们先将我们当前页面的html传入容器中,再跳到下一面,将HtmlPage的值指向我们当前这一面且pageNum加一。但是什么时候停止呢?就是到最后一面嘛。可是什么时候到最后一面?也就是说我们要找到最大页码值,当当前页码值等于最大页码值就可以了。
如何取得最大页码值?
1.取得list的倒数第二个
可以看到a标签倒数第二个就是最大页码,但是谁能保证它是不是倒数第二呢?html中有很多很多超链接,随便加些a标签就会使这个方法失效。不可取
2.写一个getmax的方法,将list中的字符串转换成整数并判断大小
我们可以拿出所有的data-page比大小嘛,找出最大的data-page就好啦,但是有点麻烦。
3.判断data-page是否是pageNum+1,是的就跳转并break;加一个理想page值,值为当前page值+1,当出循环时,若page不是理想page值时,就break结束循环。
因为pageNum是当前页码,我们想要datapage为pageNum加一的超链接,我们希望每次出循环时我们都完成了跳转,pageNum是之前的加一,但是到最后一面的时候,并没有这个datapage,因为此时pageNum最大,我们没有跳转,也就是说与我们的期望值不符。
这个期望值是借鉴快速失败机制
快速失败也就是在迭代容器时,不允许改变其内容,否则就会抛出ConcurrentModificationException异常。
其原理就是迭代器在迭代的时候有一个modCount值以及一个expectedModCount值,当访问下一个元素前,迭代器会检查modCount值是否和expextedModCount值相等,如果不等就会报错。
public void UnitTest() throws Exception{
        LinkedHashSet<String> pageSet = new LinkedHashSet<String>();
        //当前页码
        int pageNum=1;
        //理想页码
        int expPageNum=pageNum+1;
        WebClient webClient=new WebClient();
        //禁止css加载
        webClient.getOptions().setCssEnabled(false);
        webClient.getOptions().setJavaScriptEnabled(true);
        HtmlPage page=webClient.getPage("https://data.eastmoney.com/report/profitforecast.jshtml");
        webClient.waitForBackgroundJavaScript(2000);
//        System.out.print(firstPage.asXml());
        pageSet.add(page.asXml());
        while(true) {
            List<HtmlAnchor> ao = page.getByXPath("//a");
            for (HtmlAnchor h : ao) {
                String href = h.getAttribute("data-page").toString();
                //需要正则判断href是否是数字,不然转不了integer
                 Pattern p=Pattern.compile("^[0-9]{1,2}$");
                if (p.matcher(href).matches() && Integer.parseInt(href) == pageNum+1) {
                    pageNum=pageNum+1;
                    System.out.println(href);
                    // 点链接
                    page = h.click();
                    webClient.waitForBackgroundJavaScript(2000);
                    String html = page.asXml();
                    pageSet.add(html);
                    break;
                }
            }
            if(pageNum!=expPageNum)
                break;
            expPageNum=expPageNum+1;
        }


    }
4.12
今天的开发内容是将htmlunit解析出的html页面以String的形式传给jsoup处理。
首先我们先写一个htmlunit的单个页面解析方法,先做一个页面的试试,多个页面的处理也不过是一个页面的多次处理。
public String getHtml(String html) throws Exception{
        WebClient webClient=new WebClient();
        //禁止css加载
        webClient.getOptions().setCssEnabled(false);
        webClient.getOptions().setJavaScriptEnabled(true);
        HtmlPage page=webClient.getPage(html);
        webClient.waitForBackgroundJavaScript(2000);
        webClient.close();
        return page.asXml();
    }
然后开始写jsoup,本来jsoup正常获取一个页面的过程是创建一个httpclient-->创建get或者post请求-->获取响应-->获取页面内容 ,但是这里的获取页面内容我们现在可以直接从getHtml方法里拿了,所以我们直接声明一个document对象
Document document = Jsoup.parse(html);有了document我们就可以通过类名、id、标签类型找标签了
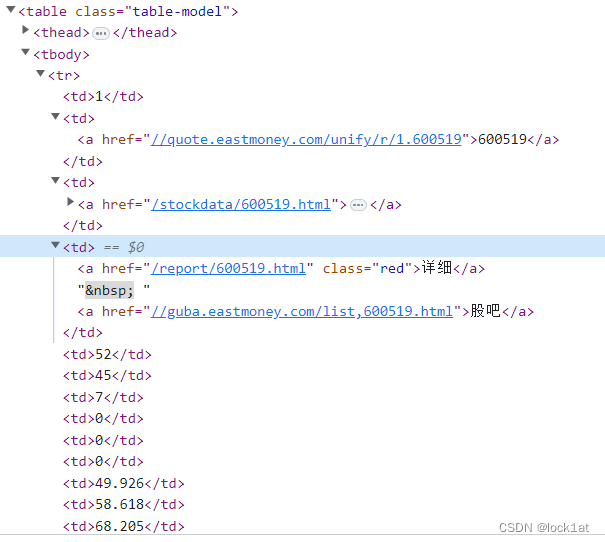
 Element table = document.body().getElementsByClass("table-model").get(1);
 Element tbody = table.getElementsByTag("tbody").get(0);
 Elements tdList = tbody.getElementsByTag("td");
关于Element类的get方法
    public E get(int var1) {
        this.rangeCheck(var1);
        return this.elementData(var1);
    }
private void rangeCheck(int var1) {
if (var1 >= this.size) {
throw new IndexOutOfBoundsException(this.outOfBoundsMsg(var1));
}
} E elementData(int var1) {
return this.elementData[var1];
} transient Object[] elementData;get其实就是拿element对象的内部类,这个内部类对于table来说就是它的thead和tbody标签,调用get方法的时候会先看你输入的下标是否超过或等于该内部类数组的长度,超过了就会抛出索引越界异常。
为什么能从tbody里直接拿td标签?
td属于tbody的children,debug下就知道。具体原理的话:element类中有该成员变量
List<Node> childNodes;
当执行getElementsByTag方法时,会在childNodes里找。
tdList拿到了,我们只需要用迭代器就可以拿到每个td标签的内容,这时我们需要考虑文件io的问题了,我选用的是StringBuilder,准备写的是csv格式。
初始化,把之后的数据类别都写好
StringBuilder stringBuilder=new StringBuilder();
//初始化
        stringBuilder.append("序号").append(",")
                .append("网站").append(",")
                .append("代码").append(",")
                .append("名称").append(",")
                .append("研报数").append(",")
                .append("买入").append(",")
                .append("增持").append(",")
                .append("中性").append(",")
                .append("减持").append(",")
                .append("卖出").append(",")
                .append("2022每股收益").append(",")
                .append("2023每股收益").append(",")
                .append("2024每股收益").append(",")
                .append("2025每股收益")
                .append("\n");
考虑到可能想要具体了解某只股票,所以我加了个股票网址的字段。
因为td是有规律性的,如下图
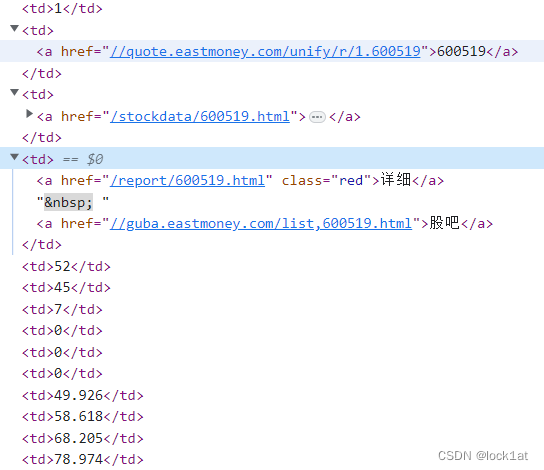
所以我声明了个count变量代表当前td是第几行来控制 ,不得不说东方财富的反爬挺离谱的,可以看到股票代码的超链接标签的href末尾有个1.,其实还有个0.,区别就在于1.的网址是这样的:http://quote.eastmoney.com/sh600519.html
而0.的网址是这样的:
http://quote.eastmoney.com/sz300957.html
一个是sh,一个是sz。
于是我选用的是股票名称的超链接
https://data.eastmoney.com/stockdata/600519.html
for (Element td : tdList) {
                if(count==1){
                    stockHtml = "https://data.eastmoney.com/stockdata/"+td.text()+".html";
                    stringBuilder.append(stockHtml).append(",")//网址
                            .append(td.text()).append(",");//股票代码
                    count++;
                    continue;
                }
                if(count==3){//股吧,不需要
                    count++;
                    continue;
                }

                if(count==13){//最后一行
                    stringBuilder.append(td.text());
                    stringBuilder.append("\n");
                    count=0;
                    continue;
                }
                stringBuilder.append(td.text()).append(",");
                count++;
            }
td.text方法可以拿到标签夹着的文本,要想拿到标签属性值的话,用attr(属性名)就可以。
最后输出到指定文件夹就可以
        Date date =new Date();
        SimpleDateFormat ft = new SimpleDateFormat ("yyyy-MM-dd");
        File newfile=new File("D:\\盈利预测\\"+ft.format(date)+".csv");//待写入文件
        BufferedWriter bufferedWriter=new BufferedWriter(new OutputStreamWriter(new                         FileOutputStream(newfile),"UTF-8"));

        bufferedWriter.write(stringBuilder.toString());
        bufferedWriter.close();
        System.out.println("文件写入内容完成");
Date,是希望不重名。
SimpleDateFormat能用指定形式输出Date。
最后文件长这样
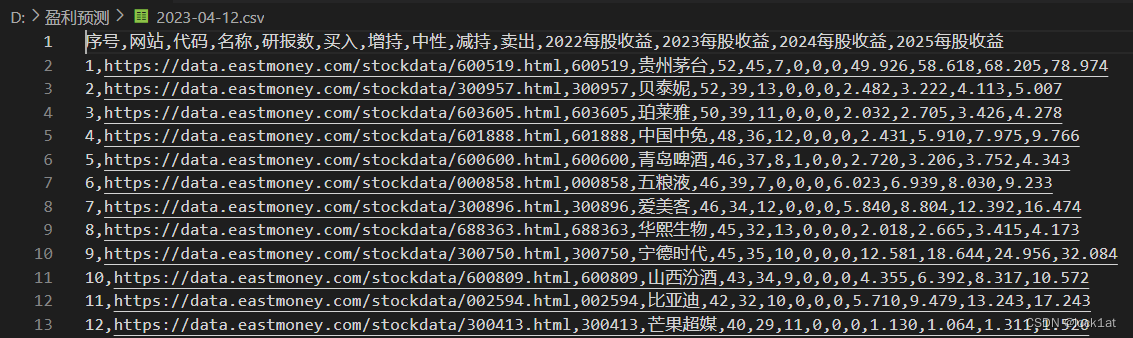
可能看起来还是有些乱,我们放到excel里看看
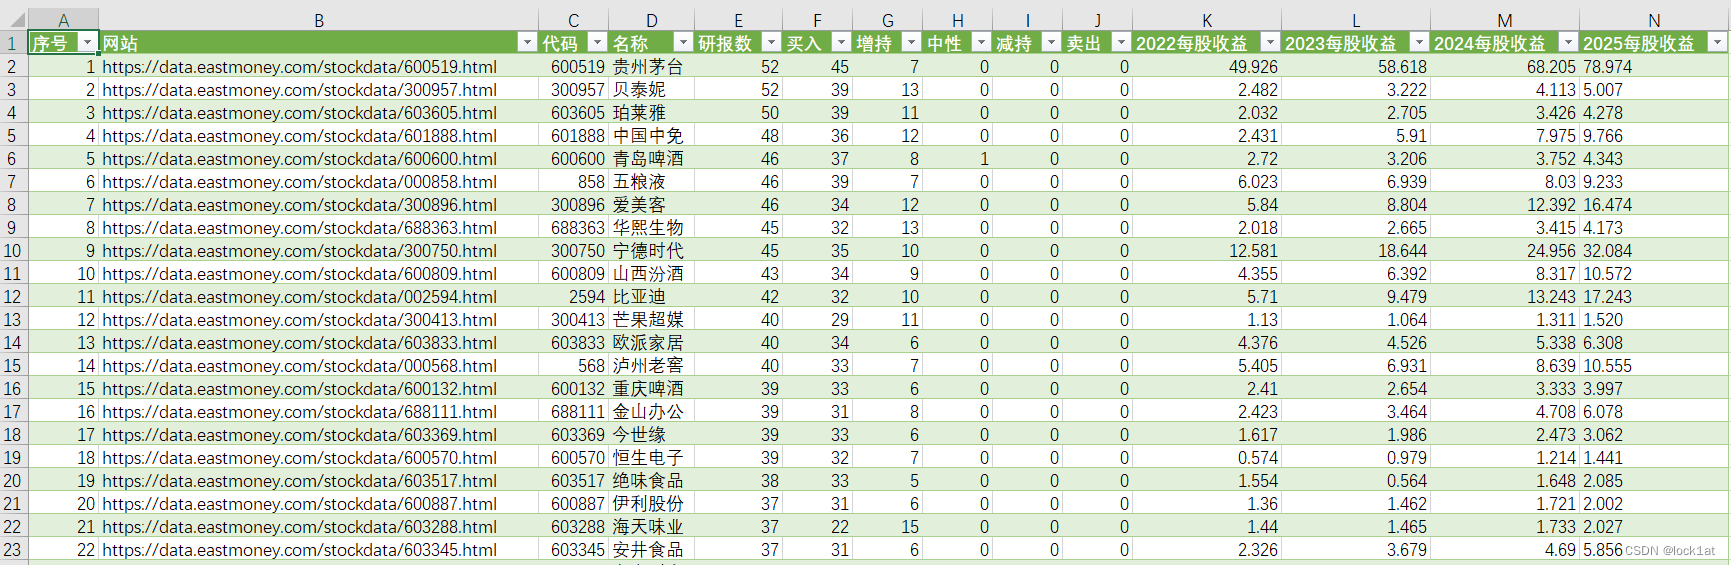
股票代码如果以0开头,就会消失,如果读者有解决办法,烦请私信我,不胜感激。
好啦,单个页面完成了,剩下的就是多页面了。
将之前htmlunit解析的内容取得
LinkedHashSet<String> pageSet = UnitTest();
初始化和声明变量
        int count=0;//标记是第几行tr
        String stockHtml;
        String html;
        Document document;
        Element table;
        Element tbody;
        Elements tdList;
        StringBuilder stringBuilder=new StringBuilder();//内容写到stringbuilder中
        //初始化
        stringBuilder.append("序号").append(",")
                .append("网站").append(",")
                .append("代码").append(",")
                .append("名称").append(",")
                .append("研报数").append(",")
                .append("买入").append(",")
                .append("增持").append(",")
                .append("中性").append(",")
                .append("减持").append(",")
                .append("卖出").append(",")
                .append("2022每股收益").append(",")
                .append("2023每股收益").append(",")
                .append("2024每股收益").append(",")
                .append("2025每股收益")
                .append("\n");
将数据存入stringbiulder中
        for(String page:pageSet){
            html=page;
            document = Jsoup.parse(html);
            table = document.body().getElementsByClass("table-model").get(1);
            tbody = table.getElementsByTag("tbody").get(0);
            tdList = tbody.getElementsByTag("td");

            for (Element td : tdList) {
                if(count==1){
                    stockHtml = "https://data.eastmoney.com/stockdata/"+td.text()+".html";
                    stringBuilder.append(stockHtml).append(",")//网址
                            .append(td.text()).append(",");//股票代码
                    count++;
                    continue;
                }
                if(count==3){//股吧,不需要
                    count++;
                    continue;
                }

                if(count==13){//最后一行
                    stringBuilder.append(td.text());
                    stringBuilder.append("\n");
                    count=0;
                    continue;
                }
                stringBuilder.append(td.text()).append(",");
                count++;
            }

        }
写入文件
        Date date =new Date();
        SimpleDateFormat ft = new SimpleDateFormat ("yyyy-MM-dd");
        File newfile=new File("D:\\盈利预测\\"+ft.format(date)+".csv");//待写入文件
        BufferedWriter bufferedWriter=new BufferedWriter(new OutputStreamWriter(new FileOutputStream(newfile),"UTF-8"));

        bufferedWriter.write(stringBuilder.toString());
        bufferedWriter.close();
        System.out.println("文件写入内容完成");
运行有点久,因为每个页面要等2s
明天的任务是将股票的价格写入到文件中,今天有过尝试,但是因为htmlunit对js的兼容差,所以股票详细的网页都没法打开。
4.13
今天尝试了写入股票价格,我猜只是有部分的js是htmlunit不支持的,我只需要获得股价的js执行就好,所以我把htmlunit对js执行错的抛出异常关闭了,最后也能拿到股价。
    public String getHtmlTest() throws Exception{

        WebClient webClient=new WebClient();
        webClient.getOptions().setThrowExceptionOnScriptError(false);//当JS执行出错的时候是否抛出异常, 这里选择不需要
        //禁止css加载
        webClient.getOptions().setCssEnabled(false);
        webClient.getOptions().setJavaScriptEnabled(true);
        HtmlPage page=webClient.getPage("https://data.eastmoney.com/stockdata/600519.html");
        webClient.waitForBackgroundJavaScript(500);
        webClient.close();
        String html=page.asXml();
        return html;
    }

@Test
    public void jsoupGetPrice()throws Exception{
        String html=getHtmlTest();
        Document document = Jsoup.parse(html);
        Element text = document.getElementById("price9");
        System.out.print(text.text());
    }
可是执行时间相当长,有15s
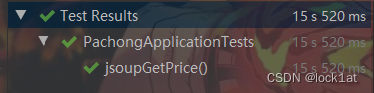
一个价格就15s,一共有2707个股票价格要爬,效率实在低下。而如果是爬盈利预测的网页的话,6s就能爬完。说明可能是未成功执行的js的问题,所以现在解决方案有
1.换个网页,爬取点击股票代码跳转的页面需要10s。
2.上分布式,多设备爬。
3.换个能爬动态获取数据的工具。
4.重写抛异常的方法(我猜测可能是抛异常的方法在拖后腿)
4.14
今天先缓缓爬虫的开发,偷下懒,搭建下项目,写实体。
先file->new project
选spring initializr
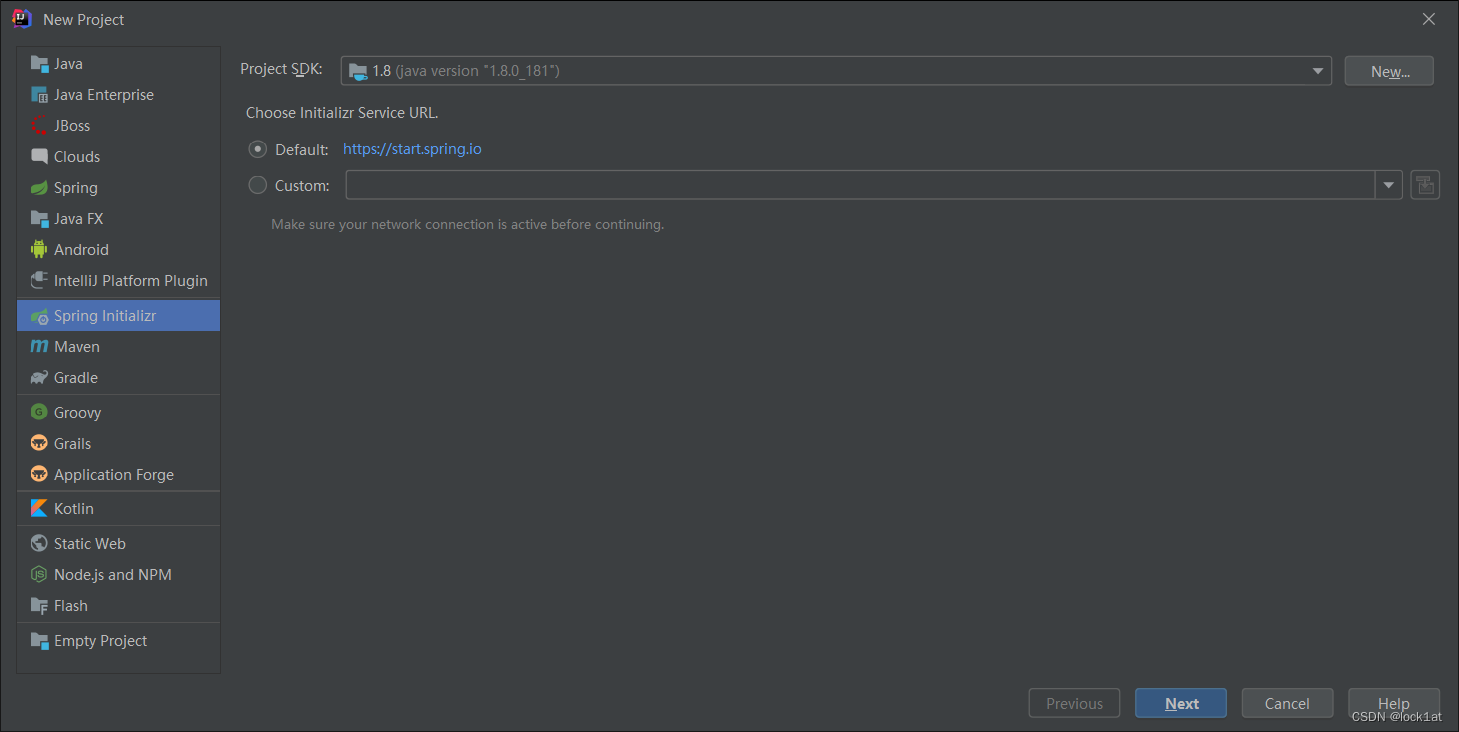
名字随便取,选java 8和maven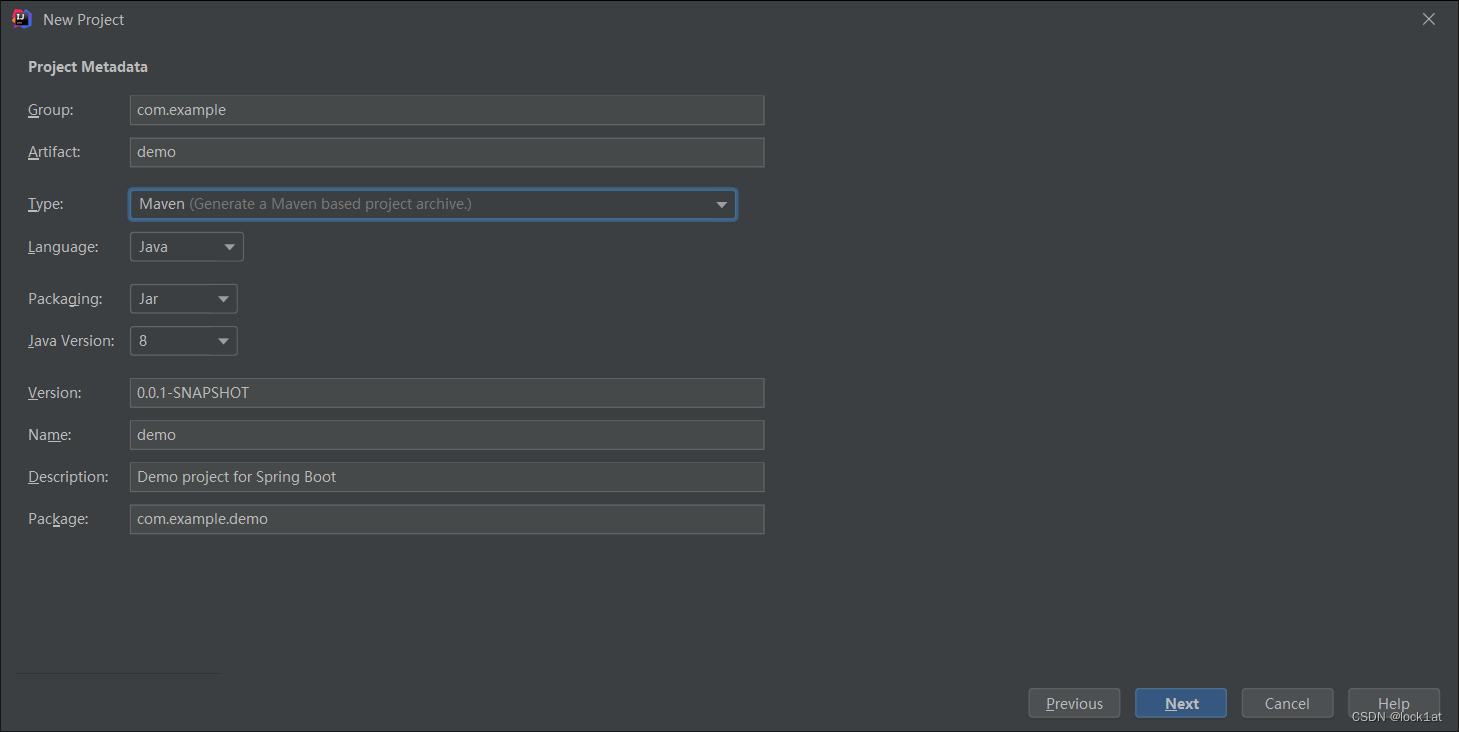
web勾上spring web
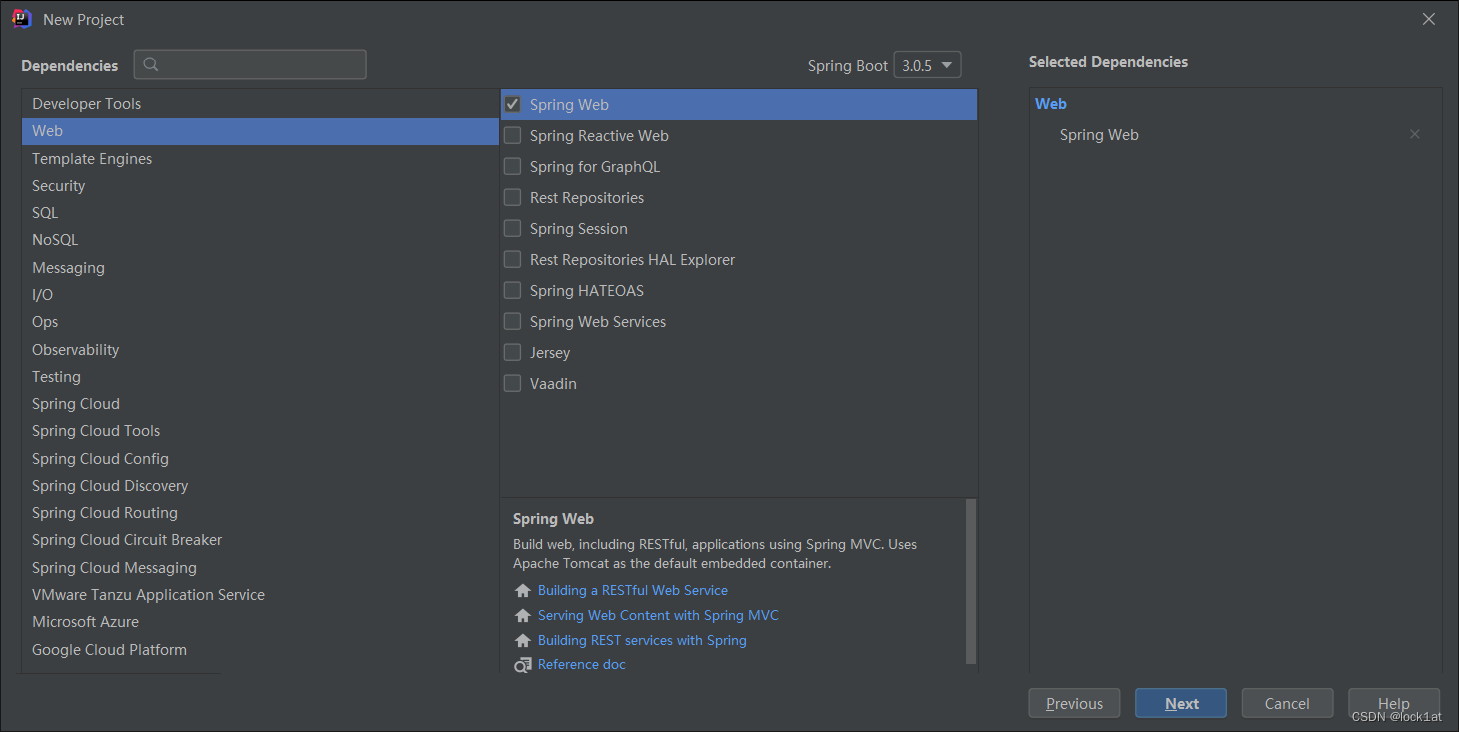
NoSQL 勾上Neo4j
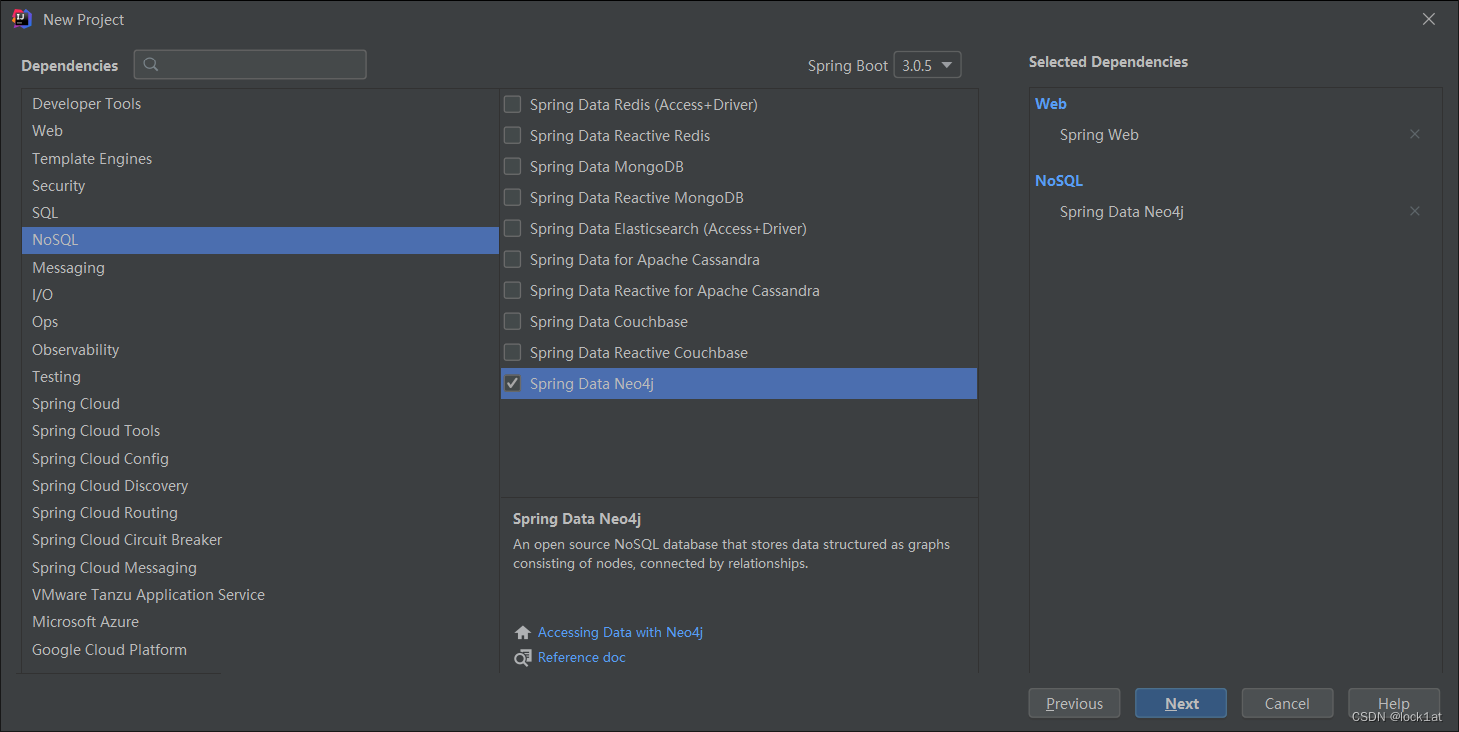
springboot的版本改下,如果是3.0,就运行不了,可能是java8 不适合。
还有java版本改成1.8
    <parent>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-parent</artifactId>
        <version>2.7.4</version>
        <relativePath/> <!-- lookup parent from repository -->
    </parent>
    <groupId>com.jimei</groupId>
    <artifactId>stock</artifactId>
    <version>0.0.1-SNAPSHOT</version>
    <name>stock</name>
    <description>Demo project for Spring Boot</description>
    <properties>
        <java.version>1.8</java.version>
    </properties>
这里是爬虫依赖
        <dependency>
            <groupId>org.apache.httpcomponents</groupId>
            <artifactId>httpclient</artifactId>
            <version>${httpclient.version}</version>
        </dependency>

        <dependency>
            <groupId>org.jsoup</groupId>
            <artifactId>jsoup</artifactId>
            <version>1.14.3</version>
        </dependency>

        <dependency>
            <groupId>net.sourceforge.htmlunit</groupId>
            <artifactId>htmlunit</artifactId>
            <version>2.68.0</version>
        </dependency>
    </dependencies>
build里加上这些,resources里是配置文件,配置neo4j数据源
 <build>
        <plugins>
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maven-plugin</artifactId>
            </plugin>
        </plugins>

        <resources>
            <resource>
                <directory>src/main/java</directory>
                <includes>
                    <include>**/*.yml</include>
                    <include>**/*.properties</include>
                    <include>**/*.xml</include>
                </includes>
                <filtering>false</filtering>
            </resource>
            <resource>
                <directory>src/main/resources</directory>
                <includes>
                    <include>**/*.yml</include>
                    <include>**/*.properties</include>
                    <include>**/*.xml</include>
                </includes>
                <filtering>false</filtering>
            </resource>
        </resources>

    </build>
根据我们上面配的路径
我们在application.properties里配置数据源
格式是
spring.neo4j.uri=bolt://localhost:11003  //这里的端口根据你neo4j里给的端口写,不是一定的。
spring.neo4j.authentication.username=
spring.neo4j.authentication.password=
在启动类里加如下注解,第一个是持久层扫描,第二个是实体类扫描,属性根据你自己的来写
@EnableNeo4jRepositories(basePackages ="com.jimei.dao")
@EntityScan(basePackages = "com.jimei.pojo")
@SpringBootApplication(scanBasePackages = {"com.jimei.*"})
设计实体类
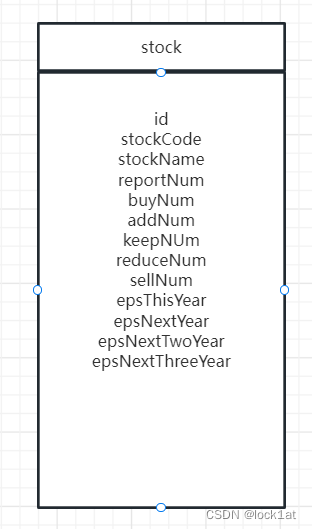
接下来建存放实体类的包和实体类,内容如下
@Node(labels="stock")//节点,labels是节点名称
public class Stock {

       @Id//实体主键
       @GeneratedValue//自增
       private String id;
       @Property//属性
       private String stockCode;
       @Property
       private String stockName;
       @Property
       private String reportNum;
       @Property
       private String buyName;
       @Property
       private String addNum;
       @Property
       private String keepNum;
       @Property
       private String reduceNum;
       @Property
       private String sellNum;
       @Property
       private String espThisYear;
       @Property
       private String epsNextYear;
       @Property
       private String epsNextTwoYear;
       @Property
       private String epsNextThreeYear;
今天的分享就到这里,如果有什么错误,欢迎指正。
4.15
今天休息。对数据持久层做了基本的计划,起码要一个拿所有节点的功能,根据输入的参数选股(具体的还要去查下或者问下),还要有个添加节点的方法(数据从爬虫拿),之前爬虫方法是循环往stringBuilder里放数据,现在就改成往对象里放,然后通过传参写入数据。明天加油。
4.16
今天在做工具类,里面放爬虫工具。今天有个大发现,东方财富盈利预测板块股票是有重复的,原本excel里是2705支股票,通过股票代码和名字查重,发现只有1285支股票了,当然,其他的数据也是相同的。这就大大降低了爬股票股价的时间,按一支股票15s的时间来算,也只需要5.35小时,这是完全可以接受的。更何况,一只股票算上htmlunit的js缓存以及springboot的部署时间,实际时间肯定是没有15s的,差不多在10s左右,最后只需要3.56小时左右就能完成爬虫。
那么今天工具类的开发首要任务就是完成股票的去重,因为neo4j的主键,也就是我们设置的id成员变量,我们加了注解,就不需要为股票对象写入id变量,它是自动增长的。为了数据库里序号和爬到的序号的一致性,我们还是使用LinkedHashSet集合来存储Stock对象。为了达到去重的目的,我们要重写Stock类的hashcode和equals方法,具体理由大家可以自行搜索。
    @Override
    public int hashCode() {
        return stockCode.hashCode();
    }

    @Override
    public boolean equals(Object o) {
        return stockCode.equals(o);
    }
我们只需要通过股票代码去重即可。
就像昨天说的那样,我们现在不用写入文件了,我们直接向stock对象赋值即可。方法有
1.用Stock类的get和set方法。
2.写一个Stock的构造方法。
我用的第二种,我觉得调用一次方法肯定比调用多次方法效率高。
    public Stock(String stockCode,String stockPrice,String stockName,String reportNum,String buyNum,String addNum,String keepNum,String reduceNum,String sellNum,String epsThisYear,String epsNextYear,String epsNextTwoYear,String epsNextThreeYear){
        this.stockCode=stockCode;
        this.stockPrice=stockPrice;
        this.stockName=stockName;
        this.reportNum=reportNum;
        this.buyNum=buyNum;
        this.addNum=addNum;
        this.keepNum=keepNum;
        this.reduceNum=reduceNum;
        this.sellNum=sellNum;
        this.epsThisYear=epsThisYear;
        this.epsNextYear=epsNextYear;
        this.epsNextTwoYear=epsNextTwoYear;
        this.epsNextThreeYear=epsNextThreeYear;

    }
以下是我对之前爬虫测试方法的改动,就不一一介绍了。
package com.jimei.stock.util;

import com.gargoylesoftware.htmlunit.WebClient;
import com.gargoylesoftware.htmlunit.html.HtmlAnchor;
import com.gargoylesoftware.htmlunit.html.HtmlPage;
import com.jimei.stock.node.Stock;
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;
import org.jsoup.nodes.Element;
import org.jsoup.select.Elements;

import java.util.LinkedHashSet;
import java.util.List;
import java.util.regex.Pattern;

public class Spider {
    private LinkedHashSet<Stock> stocks = new LinkedHashSet<Stock>();
    private LinkedHashSet<String> htmlSet = new LinkedHashSet<String>();
    private WebClient webClient = new WebClient();
    private String html;//html页面
    //常量
    private static final long getHtml_TimeWait = 500l;//getHtml等待js时间
    private static final long getPageSet_timeWait = 2000l;//getPageSet等待js时间
    private static final Pattern p = Pattern.compile("^[0-9]{1,2}$");//正则表达式判断超链接文本是否是数字
    private static final String URL = "https://data.eastmoney.com/report/profitforecast.jshtml";//东方财富盈利预测板块

    //拿html页面内容
    public String getHtml(String html) throws Exception {
        webClient.getOptions().setThrowExceptionOnScriptError(false);//当JS执行出错的时候是否抛出异常, 这里选择不需要
//        webClient.getOptions().setThrowExceptionOnFailingStatusCode(false);//当HTTP的状态非200时是否抛出异常, 这里选择不需要
        // 禁止css加载
        webClient.getOptions().setCssEnabled(false);
        webClient.getOptions().setJavaScriptEnabled(true);
        HtmlPage page = webClient.getPage(html);
        webClient.waitForBackgroundJavaScript(getHtml_TimeWait);
        webClient.close();
        return page.asXml();
    }

    //拿到所有股票价格
    public LinkedHashSet<Stock> setStockPrice(LinkedHashSet<Stock> stocks) throws Exception {
        for (Stock stock : stocks) {
            String stockHtml = "https://data.eastmoney.com/stockdata/" + stock.getStockCode() + ".html";
            html = getHtml(stockHtml);
            Document document = Jsoup.parse(html);
            Element stockPrice = document.getElementById("price9");//股价
            stock.setStockPrice(stockPrice.text());
        }
        return stocks;
    }

    //盈利预测板块的html集合
    public LinkedHashSet<String> getPageSet(String URL) throws Exception {
        //当前页码
        int pageNum = 1;
        //理想页码
        int expPageNum = pageNum + 1;
        //禁止css加载
        webClient.getOptions().setCssEnabled(false);
        webClient.getOptions().setJavaScriptEnabled(true);
        HtmlPage page = webClient.getPage(URL);
        webClient.waitForBackgroundJavaScript(getPageSet_timeWait);
//        System.out.print(firstPage.asXml());
        htmlSet.add(page.asXml());
        while (true) {
            List<HtmlAnchor> ao = page.getByXPath("//a");
            for (HtmlAnchor h : ao) {
                String href = h.getAttribute("data-page").toString();
                //需要正则判断href是否是数字,不然转不了integer
                if (p.matcher(href).matches() && Integer.parseInt(href) == pageNum + 1) {
                    pageNum = pageNum + 1;
                    System.out.println(href);
                    // 点链接
                    page = h.click();
                    webClient.waitForBackgroundJavaScript(getPageSet_timeWait);
                    html = page.asXml();
                    htmlSet.add(html);
                    break;
                }
            }
            if (pageNum != expPageNum)
                break;
            expPageNum = expPageNum + 1;
        }

        return htmlSet;

    }

    //拿到所有股票预测信息(除了股价)去重
    public LinkedHashSet<Stock> jsoup() throws Exception {
        String stockCode = "";
        String stockName = "";
        String reportNum = "";
        String buyNum = "";
        String addNum = "";
        String keepNum = "";
        String reduceNum = "";
        String sellNum = "";
        String epsThisYear = "";
        String epsNextYear = "";
        String epsNextTwoYear = "";
        String epsNextThreeYear = "";

        htmlSet = getPageSet(URL);
        int count = 0;//标记是第几行tr
        Document document;
        Element table;
        Element tbody;
        Elements tdList;
        //初始化

        for (String page : htmlSet) {
            html = page;
            document = Jsoup.parse(html);
            table = document.body().getElementsByClass("table-model").get(1);
            tbody = table.getElementsByTag("tbody").get(0);
            tdList = tbody.getElementsByTag("td");

            for (Element td : tdList) {
                switch (count) {
                    case 1:
//                    stockHtml = "https://data.eastmoney.com/stockdata/"+td.text()+".html";
//                    html=getHtml(stockHtml);
//                    document=Jsoup.parse(html);
//                    Element stockPrice =document.getElementById("price9");//股价

                        stockCode = td.text();//股票代码
                        count++;
                        break;

                    case 2:
                        stockName = td.text();
                        count++;
                        break;
                    case 3:
                        count++;
                        break;
                    case 4:
                        reportNum = td.text();
                        count++;
                        break;
                    case 5:
                        buyNum = td.text();
                        count++;
                        break;
                    case 6:
                        addNum = td.text();
                        count++;
                        break;
                    case 7:
                        keepNum = td.text();
                        count++;
                        break;
                    case 8:
                        reduceNum = td.text();
                        count++;
                        break;
                    case 9:
                        sellNum = td.text();
                        count++;
                        break;
                    case 10:
                        epsThisYear = td.text();
                        count++;
                        break;
                    case 11:
                        epsNextYear = td.text();
                        count++;
                        break;
                    case 12:
                        epsNextTwoYear = td.text();
                        count++;
                        break;
                    case 13:
                        epsNextThreeYear = td.text();
                        count = 0;
                        Stock stock = new Stock(stockCode, "0", stockName, reportNum, buyNum, addNum, keepNum, reduceNum, sellNum, epsThisYear, epsNextYear, epsNextTwoYear, epsNextThreeYear);
                        stocks.add(stock);
                        break;

                }

            }


        }
        setStockPrice(stocks);
        return stocks;
    }


}
如有错误,欢迎指正,多谢您的细心阅读^_^
4.17
今天发现之前的内容有许多错误,以下是指正。
1.neo4j的实体类主键id必须是Long类型,所以实体类和持久层都要改。
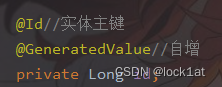

2.工具类里的方法应该是静态的,静态方法里不许用非静态变量和方法,这是因为静态方法比成员变量先(和类加载有关)。这样我们就只用类名.方法名就可以使用了,不需要实例化。
主要的错误就是这两个,还有对实体类的改动,实体类中我加入了市盈率和三年的平均增长率和两年的平均增长率作为属性,因为市盈率是用股价除以每股盈利,三年平均增长率是预测3年后的每股盈利除以当前的每股盈利减一,两年同理,所以我将股票价格,每股盈利,预测2年后每股盈利,预测3年后每股盈利和新加的属性都设置成了Double类型,方便计算。只是用来展示的属性就都是String。
然后我把平均增长率的设置放在了构造函数中,再设了get方法,没设set方法,市盈率是用set方法设置的,因为他需要价格,而价格是后面通过股票代码获取的,所以不能放在构造函数中。
 @Property
    private Double stockPe; //市盈率
    @Property
    private Double AGR_3years;//3年的年均增长率
    @Property
    private Double AGR_2years;//2年的年均增长率

    public Stock(String stockCode, Double stockPrice, String stockName, String reportNum, String buyNum, String addNum, String keepNum, String reduceNum, String sellNum, Double epsThisYear, String epsNextYear, Double epsNextTwoYear, Double epsNextThreeYear) {
        this.stockCode = stockCode;
        this.stockPrice = stockPrice;
        this.stockName = stockName;
        this.reportNum = reportNum;
        this.buyNum = buyNum;
        this.addNum = addNum;
        this.keepNum = keepNum;
        this.reduceNum = reduceNum;
        this.sellNum = sellNum;
        this.epsThisYear = epsThisYear;
        this.epsNextYear = epsNextYear;
        this.epsNextTwoYear = epsNextTwoYear;
        this.epsNextThreeYear = epsNextThreeYear;
        this.AGR_2years = Math.pow(Math.E, Math.exp(epsNextTwoYear) / 2.0)-1;
        this.AGR_3years = Math.pow(Math.E, Math.exp(epsNextThreeYear) / 3.0)-1;
    }
这里小提一下,求平均增长率其实是求底数,而Math中好像是没有求底的公式的,只有求以自然数为底的对数的函数,所以这里我用了一点高中知识(换底公式),以求平均三年增长率为例。
换底公式

例子
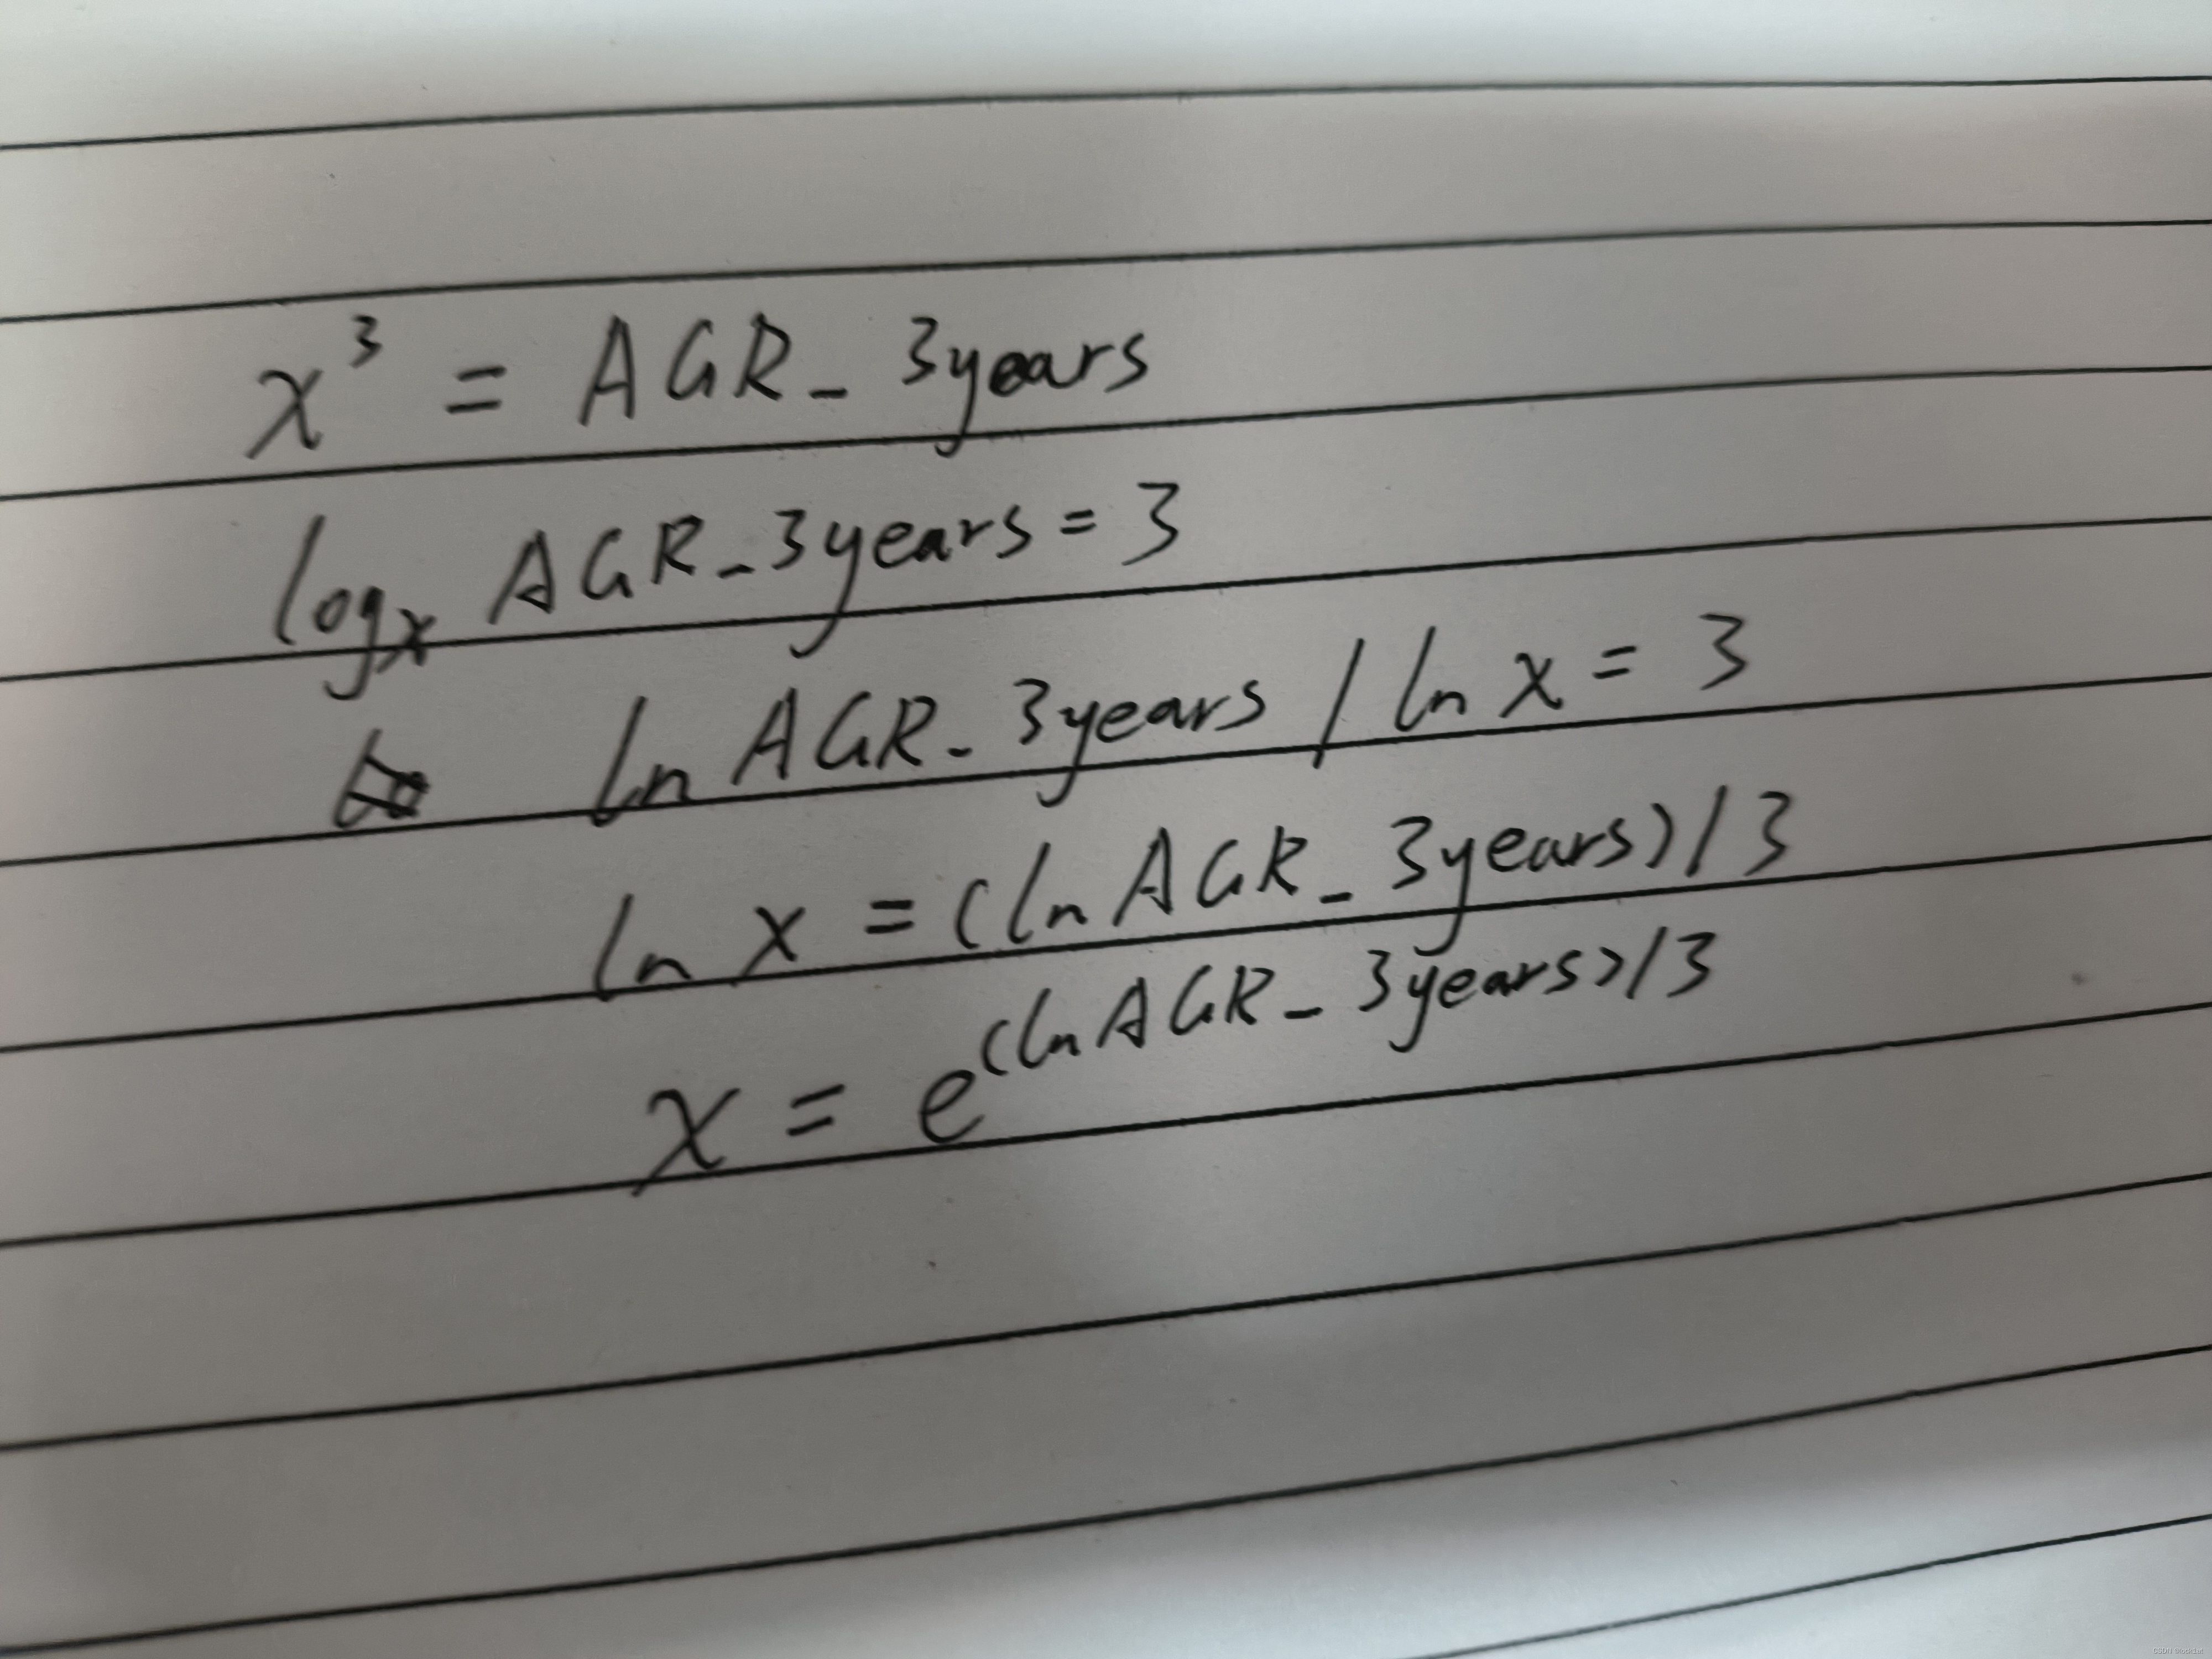
Math.pow(Double)是幂函数
Math.exp(Double)是求对数的函数。
市盈率的set
    public void setStockPe() {
        this.stockPe = this.stockPrice / this.epsThisYear;
    }
工具类的改动
因为发现有的股票3年后或2年后的盈利预测是空的或者是“-”,这两种都没办法转成浮点数,所以加了个判断数字的正则表达式,如果不是数字就设置成0。
private static final Pattern Num = Pattern.compile("^-?\\d+(\\.\\d+)?$");//判断数字
  case 12:
     if (Num.matcher(td.text()).matches())
        epsNextTwoYear = Double.parseDouble(td.text());
     else
        epsNextTwoYear = 0.0;
     count++;
     break;
  case 13:
     if (Num.matcher(td.text()).matches())
        epsNextThreeYear = Double.parseDouble(td.text());
      else
        epsNextThreeYear = 0.0;
        count = 0;
        Stock stock = new Stock(stockCode, 0.0, stockName, reportNum, buyNum, addNum, keepNum, reduceNum, sellNum, epsThisYear, epsNextYear, epsNextTwoYear, epsNextThreeYear);
        stocks.add(stock);
        break;
以及拿到股票价格,设置完价格,设置市盈率,还加了一点可视性,不然爬取的时候都不知道进度。
   //拿到所有股票价格
    public static LinkedHashSet<Stock> setStockPrice(LinkedHashSet<Stock> stocks) throws Exception {
        Double stockPrice = 0.0;
        int i=1;
        String html;
        for (Stock stock : stocks) {
            String stockHtml = "https://data.eastmoney.com/stockdata/" + stock.getStockCode() + ".html";
            html = getHtml(stockHtml);
            Document document = Jsoup.parse(html);
            Element stockPriceTxT = document.getElementById("price9");//股价
            stockPrice = Double.parseDouble(stockPriceTxT.text());
            stock.setStockPrice(stockPrice);
            stock.setStockPe();
            System.out.println("正在爬取第"+i+"支股票的价格");
            i++;
        }
        return stocks;
    }
Mapper
//查询所有股票
    @Query("MATCH (n) RETURN n")
    List<Stock> getStocks();

    //通过股票代码或股票名字找股票
    Stock getStockByStockCodeOrStockName(String stockCode, String stockName);

    //添加股票节点
    @Query("create(:Stock{stockCode:$stockCode,stockPrice:$stockPrice,stockName:$stockName,reportNum:$reportNum,buyNum:$buyNum,addNum:$addNum,keepNum:$keepNum,reduceNum:$reduceNum,sellNum:$sellNum,epsThisYear:$epsThisYear,epsNextYear:$epsNextYear,epsNextTwoYear:$epsNextTwoYear,epsNextThreeYear:$epsNextThreeYear,stockPe:$stockPe,AGR_3years:$AGR_3years,AGR_2years:$AGR_2years})")
    Boolean addStock(@Param("stockCode") String stockCode, @Param("stockPrice") Double stockPrice, @Param("stockName") String stockName, @Param("reportNum") String reportNum, @Param("buyNum") String buyNum, @Param("addNum") String addNum, @Param("keepNum") String keepNum, @Param("reduceNum") String reduceNum, @Param("sellNum") String sellNum, @Param("epsThisYear") Double epsThisYear, @Param("epsNextYear") String epsNextYear, @Param("epsNextTwoYear") Double epsNextTwoYear, @Param("epsNextThreeYear") Double epsNextThreeYear, @Param("stockPe") Double stockPe, @Param("AGR_3years") Double AGR_3years, @Param("AGR_2years") Double AGR_2years);
像通过节点属性查找节点这种方法是不需要自己写的,neo4jRepository会给。
Service
public interface StockService {
    List<Stock> getStocks();

    Stock getStock(String stockCode, String stockName);

    Boolean addStock(String stockCode, Double stockPrice, String stockName, String reportNum, String buyNum, String addNum, String keepNum, String reduceNum, String sellNum, Double epsThisYear, String epsNextYear, Double epsNextTwoYear, Double epsNextThreeYear, Double stockPe, Double AGR_3years, Double AGR_2years);
}
实现类
@Service
public class StockServiceImpl implements StockService {

    @Autowired
    private StockMapper stockMapper;

    @Override
    public List<Stock> getStocks() {
        return stockMapper.getStocks();
    }

    @Override
    public Stock getStock(String stockCode, String stockName) {
        return stockMapper.getStockByStockCodeOrStockName(stockCode, stockName);
    }

    @Override
    public Boolean addStock(String stockCode, Double stockPrice, String stockName, String reportNum, String buyNum, String addNum, String keepNum, String reduceNum, String sellNum, Double epsThisYear, String epsNextYear, Double epsNextTwoYear, Double epsNextThreeYear, Double stockPe, Double AGR_3years, Double AGR_2years) {
        return stockMapper.addStock(stockCode, stockPrice, stockName, reportNum, buyNum, addNum, keepNum, reduceNum, sellNum, epsThisYear, epsNextYear, epsNextTwoYear, epsNextThreeYear, stockPe, AGR_3years, AGR_2years);
    }
}
Controller
@RestController
@RequestMapping("/stock")
public class StockController {

    @Autowired
    private StockService stockService;

    @RequestMapping(value="/getStocks")
    public List<Stock> getStocks(){
        return stockService.getStocks();
    }

    @RequestMapping(value = "/getStock")
    public Stock getStock(String stockCode, String stockName){
        return stockService.getStock(stockCode,stockName);
    }

    @RequestMapping(value="/addStocks")
    public Map<String,String> addStocks(){
        LinkedHashSet<Stock> stocks =new LinkedHashSet<Stock>();
        Map<String,String> map =new HashMap<String, String>();
        String code="200";
        String msg="ok";
        try {
            stocks= Spider.jsoup();
            for(Stock stock:stocks){
                stockService.addStock(stock.getStockCode(), stock.getStockPrice(), stock.getStockName(), stock.getReportNum(), stock.getBuyNum(), stock.getAddNum(), stock.getKeepNum(), stock.getReduceNum(), stock.getSellNum(), stock.getEpsThisYear(), stock.getEpsNextYear(), stock.getEpsNextTwoYear(), stock.getEpsNextThreeYear(), stock.getStockPe(), stock.getAGR_3years(), stock.getAGR_2years());
            }
        } catch (Exception e) {
            e.printStackTrace();
            code="500";
            msg="内部服务器错误";
        }finally {
            map.put("code",code);
            map.put("msg",msg);
            return map;
        }
    }
}
restcontroller相当于controller加responsebody。
更多推荐
 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)