
第二部分 数据结构-树
逻辑结构
树结构: 非线性的,由N个结点组成的有限集,在各个结点间具备树状的逻辑结构关系;
当N=0时,该树是空树;
当N>0时,该树是非空树,而树中有且只有一个根节点,其余结点组成M个有限集亦是树结构,称为根的子树;
树结构名词解释:
-
根结点:树状逻辑结构中唯一的,没有双亲结点的结点;
-
内部结点:树状逻辑结构中具有双亲结点也包含子结点的结点;
-
叶结点或终端节点:树状逻辑结构中具有双亲结点但是不具有子结点或子树的结点;
-
树的度:树状结构中拥有子结点或子树的最大值;
-
树的深度:从根节点开始,往下一个子结点为一层,依次到底,树能伸展的最大深度;
-
兄弟节点:具有相同父节点的节点互称为兄弟节点;
-
节点的层次:从根开始定义起,根为第
1层,根的子节点为第2层,依次递增; -
堂兄弟节点:双亲在同一层的节点互为堂兄弟
树的表示法
双亲表示法
取一块连续的内存空间,在存储每个结点的同时,各自都附加一个记录其父结点位置的变量。需要在树结构中频繁地查找某结点的父结点时,使用双亲表示法比较合适。
#define nodeNum 50
typedef struct PNode{
int _data; //树中结点的数据类型
int _parent; //结点的父结点在数组中的位置下标
}PNode;
typedef struct
{
PNode _node[nodeNum]; //存放树中所有结点
int _r, _n; //根的位置下标和结点数
}Tree;
孩子表示法
把每个孩子结点排列起来,以单链表作存储结构,则n个结点有n个孩子链表,然后把n个单链表的头指针组成一个线性表(顺序结构存储,放在一个数组中)。如果是叶子结点则单链表为空
#define nodeNum 50
//孩子表示法
typedef struct CNode{
  int _child;  //链表中每个结点存储的是数据在数组中存储的位置下标
  struct CNode *_next;
}*Child;
typedef struct {
  int _data;  //结点的数据
  Child _childptr;  //孩子链表的头指针(指向其父节点)
}CBox;
typedef struct{
  CBox nodes[nodeNum];  //存储结点的数组
  int n, r;  //结点数量和根的位置
}CTree;

孩子表示法存储示意图: 
孩子兄弟表示法
使用链式存储结构存储普通树。链表中每个结点由 3 部分组成: 一个数据域和两个指针域,如下图所示:
其中孩子指针域,表示指向当前结点的第一个孩子结点,兄弟结点表示指向当前结点的下一个兄弟结点。

typedef int DataType;
struct Node
{
struct Node* _firstChild1; // 第一个孩子结点
struct Node* _pNextBrother; // 指向其下一个兄弟结点
DataType _data; // 结点中的数据域
};
总结:树的三种表示方法中,双亲表示法常用于解决查找某结点的父结点,而孩子表示法常用于查找某结点的孩子结点。孩子兄弟表示法可以将普通树转化成二叉树存储.
二叉树
定义以及性质
-
度最大为2的树
-
有左右之分,左边为左孩子,右边为右孩子
-
二叉树的
i行最多有2^(h-1)个节点 -
深度为
h的二叉树,节点数最多有2^h -1 -
对任何一棵二叉树, 如果度为
0其叶结点个数为n0, 度为2的分支结点个数为n2,则n0=n2+1(根节点不消耗度) -
若规定根节点的层数为1,具有n个结点的满二叉树的深度为
log2(n + 1) -
父亲序号为i,找左右孩子
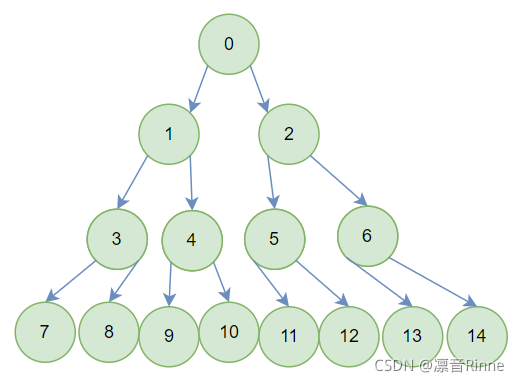
可以看出左孩子序号是父亲序号的
2倍 + 1可以看出右孩子序号是父亲序号的
2倍 + 2
-
孩子序号为i,找父亲,反之就行,父亲为 (i - 1)/2
二叉树的构建
拓展二叉树的先序建立
仅由先序序列无法确定一棵二叉树,但是我们可以由拓展二叉树的先序序列可以唯一确定一棵二叉树。 拓展二叉树:将原二叉树每个结点的空指针都引出一个“虚结点”,令其值为 ‘#’,表示为空结点,这样处理的二叉树称为原二叉树的拓展二叉树。
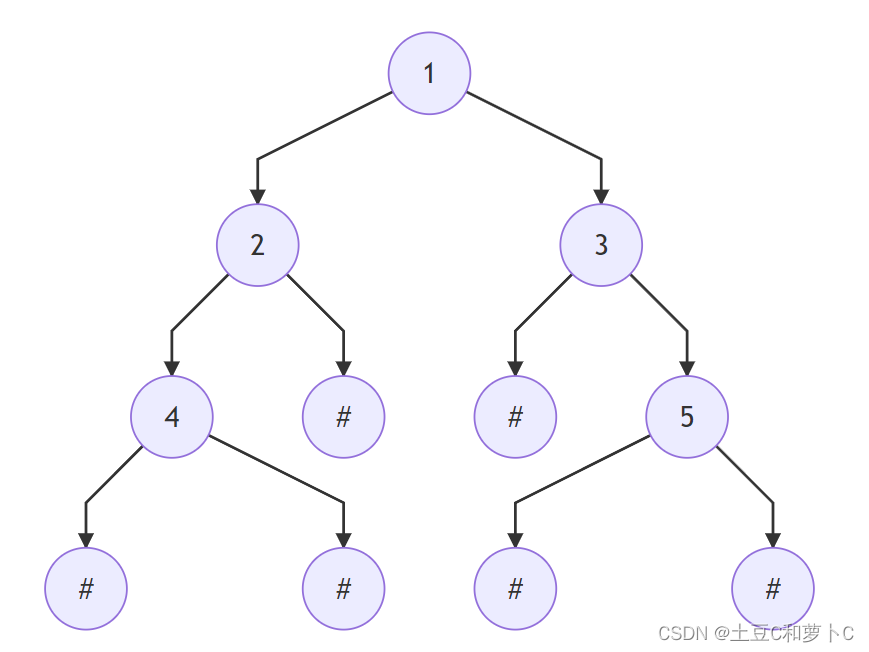
拓展二叉树的先序序列:"124###3#5##"
代码:
#include <stdio.h>
#include<stdlib.h>
//拓展二叉树的先序建立
//仅由先序序列无法确定一棵二叉树,但是我们可以由拓展二叉树的先序序列可以唯一确定一棵二叉树。
//拓展二叉树:将原二叉树每个结点的空指针都引出一个“虚结点”,令其值为 ‘#’,表示为空结点,这样处理的二叉树称为原二叉树的拓展二叉树。
typedef struct Node{
int data;
struct Node *LChildren , *RChildren;
}Node,*LinkNode;
typedef struct Tree{
LinkNode root; //根节点
int n; //节点数
}Tree;
extern int index=0; //已经取到的数组下标
//根据序列生成树
void CreateTree(char nodes[],Node *node){
char ch = nodes[index++];
if(ch=='#')
node=NULL;
else{
if(node) {
node->data=ch-'0';
Node *lch;
lch=(Node*)malloc(sizeof(Node));
node->LChildren = lch;
CreateTree(nodes,lch);
Node *rch;
rch=(Node*)malloc(sizeof(Node));
node->RChildren = rch;
CreateTree(nodes,rch);
}
}
}
int main(){
char nodes[] = {'1','2','4','#','#','#','3','#','5','#','#'};
Node *root; //根节点
root=(Node*)malloc(sizeof(Node));
Tree *tree;
tree = (Tree*)malloc(sizeof(tree));
tree->n=0;
tree->root = root;
CreateTree(nodes,root);
printf("%d",tree->root->RChildren->RChildren->data);
}
前序 + 中序
/*--------------------------先序和中序构造二叉树--------------------------*/
/*  a是先序序列
    b是中序序列
    i是先序序列首字符在a[]中的位置
    j是中序序列首字符在b[]中的位置
    len是子树的字符长度
*/
Node* FMCreatTree(char a[], char b[], int i,int j, int len)
{
    Node *root; //二叉树的根结点
    root = (Node*)malloc(sizeof(Node));
    if (len > 0){
        root->data = a[i];
        char *p = b;
        for (p = b; p != NULL; p++) //在b中找到a[i]
        {
            if (*p == a[i]) break;
        }
        int m = p - b;  //计算该结点在b中的下标
        root->LChildren = FMCreatTree(a, b, i + 1, j, m - j);   //左孩子
        root->RChildren = FMCreatTree(a, b, i + (m - j) + 1, m + 1, len - 1 - (m - j)); //右孩子
        return root;    //返回二叉树的根
    }
}
后序 + 中序
/*--------------------------后序和中序构造二叉树--------------------------*/
//b是中序
//c是后续
Node*  EMCreateTree(char b[],char c[],int i,int j,int len){
    Node *root;     //根节点
    root = (Node*)malloc(sizeof(Node));
    if(len>0){
        root->data = c[j+len-1];
        char *p = b;
        for(;p!=NULL;p++){
            if(*p == c[j+len-1]){
                break;
            }
        }
        int m = p-b;    //获取根节点在b中的下标
        root->LChildren = EMCreateTree(b,c,i,j,m-i);
        root->RChildren = EMCreateTree(b,c,m+1,m+j-i,len-(m-i)-1);
        return root;
    }
}
二叉树遍历
先序遍历
-
递归思路:将一整棵数分为左孩子、根节点、右孩子,先序遍历先将访问根节点,再访问左孩子,最后右孩子,在访问孩子树的时候同样遵循这个顺序。
-
非递归思路:先将根节点入栈,然后在以后的出栈操作的同时,依次将其右左孩子节点入栈(访问次序为左右),然后在出栈,以此类推。
/*--------------------------先序遍历二叉树--------------------------*/
//递归
void Prerequisite(Node *root){
    if(root != NULL){
        printf("%c ",root->data);
        Prerequisite(root->LChildren);
        Prerequisite(root->RChildren);
    }
}
//非递归
void N_Prerequisite(Node *root){
    Node* stack[10];        //节点指针数组
    int top=0;
    stack[0] = root;
    while(top>-1){
        Node *temp = stack[top--];
        printf("%c ",temp->data);
        if(temp->RChildren != NULL){
            stack[++top] = temp->RChildren;
        }
        if(temp->LChildren != NULL){
            stack[++top] = temp->LChildren;
        }
    }
}
中序遍历
-
递归思路:将一整棵数分为左孩子、根节点、右孩子,中序遍历先将访问左孩子,再访问根节点,最后右孩子,所以根节点在访问左子树之后打印输出。
-
非递归思路:
-
对于任意节点其左孩子不为空,则将P入栈并将P的左孩子置为当前的P,然后对当前节点P再进行相同的处理
-
若其左孩子为空,则取栈顶元素并进行出栈并访问,然后将当前的P置为栈顶节点的右孩子
-
直到P为NULL并且栈为空则遍历结束
-
/*--------------------------中序遍历二叉树--------------------------*/
//递归
void Mediumorder(Node *root){
    if(root != NULL){
        Mediumorder(root->LChildren);
        printf("%c ",root->data);
        Mediumorder(root->RChildren);
    }
}
//非递归
void N_Mediumorder(Node *root){
    Node* stack[10];
    int top=-1;
    Node *P = root;
    while(P||top>-1){
        while(P){
            stack[++top] = P;
            P = P->LChildren;
        }
        if(top>-1){
            P = stack[top--];
            printf("%c ",P->data);
            P = P->RChildren;
        }
    }
}
后序遍历
-
递归思路:将一整棵数分为左孩子、根节点、右孩子,中序遍历先将访问左孩子,再访问右孩子,最后根节点,所以根节点在访问右子树之后打印输出。
-
非递归思路:
-
一直往左孩子遍历,遍历过程中保存遍历的节点
-
当左孩子为空时,我们访问右孩子
-
当左右孩子都为空时,我们访问这个节点内容,并返回到父节点(栈顶便是其父节点)
-
每当从孩子节点返回父节点时,需要判断是从左孩子返回的还是从右孩子返回的,若是从左孩子返回的,我们需要继续访问右孩子,而若是从右孩子返回的,我们则访问当前节点,并返回到其父节点。
-
判断一次返回是否是从右孩子返回,我们可以使用一个变量 t,当一个节点返回时,我们使用 t 记录这个节点,在父节点处判断 t 是否与这个节点的右孩子相等,若相等,则说明是从右孩子返回的,否则就是从左孩子返回的。
-
/*--------------------------后序遍历二叉树--------------------------*/
//递归
void Postorder(Node *root){
    if(root != NULL){
        Postorder(root->LChildren);
        Postorder(root->RChildren);
        printf("%c ",root->data);
    }
}
//非递归
void N_Postorder(Node *root){
    Node* stack[10];
    int top=-1;
    Node *P = root;
    Node *r;                // r 为辅助节点,用于判断当节点返回时,是从哪个方向返回到父节点的。

    while (P || top>-1) {
        // 先从左走到底
        if (P) {
            stack[++top] = P;
            P = P->LChildren;
        } else {
            P = stack[top--];
            // 若右孩子还未遍历,遍历右孩子
            if (P->RChildren && P->RChildren != r) {
                top++;          //如果该节点还有右孩子未访问,则其还未访问,所以暂不出栈,top加回来
                P = P->RChildren;
            } else {
                printf("%c ",P->data);
                r = P;
                P = NULL;
            }
        }
    }
}
层次遍历
-
思路:使用队列实现,访问根节点时,依次将左右孩子节点放入队列。
/*--------------------------层次遍历二叉树--------------------------*/
void level(Node *root){
    Node* queue[10];
    int head=-1, end=0;
    queue[0] = root;
    Node *P;
    while(end > head){
        P = queue[++head];
        printf("%c ",P->data);
        if(P->LChildren != NULL)
            queue[++end] = P->LChildren;
        if(P->RChildren != NULL)
            queue[++end] = P->RChildren;
    }
}
线索二叉树
定义
在二叉链表中, 具有 n 个结点的二叉链表有 n + 1 个空指针域. 由此, 可以利用这些空指针域来存放结点的直接前驱和直接后继的信息
结点的存储结构
| lchild | ltag | data | rtag | rchild |
|---|---|---|---|---|
| 左孩子结点 | 前驱结点标志域 | 数据域 | 后继结点标志域 | 右孩子结点 |
当 ltag = 0 时, lchild 指向结点的左孩子; 当 ltag = 1 时, lchild 指向结点的直接前驱; 当 rtag = 0 时, rchild 指向结点的右孩子; 当 rtag = 1 时, rchild 指向结点的直接后继
线索化图解

结构体定义
//定义一个线索二叉树
typedef struct Node {
    char data;
    struct Node* lchild;
    struct Node* rchild;
    int ltag;   //当 ltag = 0 时, lchild 指向结点的左孩子;当 ltag = 1 时, lchild 指向结点的直接前驱
    int rtag;   //当 rtag = 0 时, rchild 指向结点的右孩子;当 rtag = 1 时, rchild 指向结点的直接后继
}BitNode, *BiTree;
线索化相关代码:(24条消息) 线索二叉树-C语言实现_Saoke的博客-CSDN博客线索二叉树c语言
-
线索二叉树的插入
-
线索二叉树的删除
注:掌握过程,应该不会考代码
哈夫曼树
构建
当用 n 个结点(都做叶子结点且都有各自的权值)试图构建一棵树时,如果构建的这棵树的带权路径长度最小,称这棵树为“最优二叉树”,有时也叫“赫夫曼树”或者“哈夫曼树”。
在构建哈弗曼树时,要使树的带权路径长度最小,只需要遵循一个原则,那就是:权重越大的结点离树根越近。在图 1 中,因为结点 a 的权值最大,所以理应直接作为根结点的孩子结点。
对于给定的有各自权值的 n 个结点,构建哈夫曼树有一个行之有效的办法:
-
在 n 个权值中选出两个最小的权值,对应的两个结点组成一个新的二叉树,且新二叉树的根结点的权值为左右孩子权值的和;
-
在原有的 n 个权值中删除那两个最小的权值,同时将新的权值加入到 n–2 个权值的行列中,以此类推;
-
重复 1 和 2 ,直到所以的结点构建成了一棵二叉树为止,这棵树就是哈夫曼树。
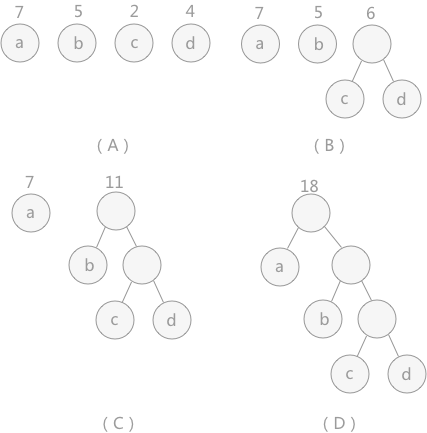
(A)给定了四个结点a,b,c,d,权值分别为7,5,2,4;第一步如(B)所示,找出现有权值中最小的两个,2 和 4 ,相应的结点 c 和 d 构建一个新的二叉树,树根的权值为 2 + 4 = 6,同时将原有权值中的 2 和 4 删掉,将新的权值 6 加入;进入(C),重复之前的步骤。直到(D)中,所有的结点构建成了一个全新的二叉树,这就是哈夫曼树。
哈夫曼编码
将字符使用次数当作节点权值,构造哈夫曼树,出现频率高的节点靠近根节点。
若对某一字符集进行不等长编码,则要求字符集中任一字符的编码都不能是其他字符编码的前缀,符合此要求的编码叫做前缀编码。
每个结点分别对应一个字符,对T中的边做标记,把左分支记为“0”,右分支标记为“1”。定义字符的编码是从根结点到该字符所对
应的叶子结点的路径上,各条边上的标记所组成的序列就是哈夫曼编码。
逆波兰表达式
定义
在通常的表达式中,二元运算符总是置于与之相关的两个运算对象之间(如:1+1),所以这种表示法也称为中缀表示。波兰逻辑学家J.Lukasiewicz于1929年提出了另一种表示表达式的方法,称为逆波兰记法,在逆波兰记法中,所有操作符置于操作数的后面,因此也被称为后缀表示法。示例如下:
| 中缀表示 | 逆波兰式 |
|---|---|
| a+b | a,b,+ |
| a+(b-c) | a,b,c,-,+ |
| a+(b-c)*d | a,b,c,-,d,*,+ |
| a+d*(b-c) | a,d,b,c,-,*,+ |
| a=1+3 | a=1,3 + |
逆波兰表达式是一种十分有用的表达式,它将复杂表达式转换为可以依靠简单的操作得到计算结果的表达式。它的优势在于只用两种简单操作,入栈和出栈就可以搞定任何普通表达式的运算。
中缀表达式转换为逆波兰式
将一个普通的中序表达式转换为逆波兰表达式的一般算法是:
1、首先构造一个运算符栈,此运算符在栈内遵循越往栈顶优先级越高的原则。
2、读入一个中缀表达式,为了方便起见,可在其最右端追加一个最低优先级运算符(如:#号)。(这样做的目的是,最后读入#号运算符时将运算符栈中所有运算符都输出)。
3、从左至右扫描该中缀表达式,如果当前字符是数字,则分析到该数字串的结束(例如三位数324,要循环获取数字直到遇到运算符,这样才可以将324取出,一般题目都说明是个位数),并将该数字串直接输出。
4、如果不是数字,该字符则是运算符,此时需比较该运算符与运算符栈顶运算符的优先关系:
(1)、若该运算符优先级高于栈顶运算符优先级别(或栈为空或栈顶是‘(’),则直接将该运算符压入运算符栈中;
(2)、若该运算符优先级小于或等于此运算符栈顶的运算符,则弹出栈顶运算符并输出,重复比较、输出,直到栈为空或该运算符优先级高于栈顶运算符,然后将该运算符入栈。
注:若遇到‘ )‘,则将栈中运算符依次弹出并输出,直到栈顶元素为’(‘,注意’(‘弹出并不输出。
5、重复上述操作(3)-(4)直至扫描完整个简单算术表达式,确定所有字符都得到正确处理,输出结果便是中缀表达式转化为逆波兰表示的简单算术表达式。
利用逆波兰式计算结果
-
从左到右顺序访问逆波兰式;
-
若遇到数字则直接存入栈S中;
-
若遇到运算符则将栈S依次出栈两个元素,先出栈的作为运算符后的数字,后出栈的作为运算符前的数字;
-
按照
后出栈元素运算符后出栈元素计算出结果,并入栈S。 -
如此执行,直到逆波兰式被访问完全,最终S栈中的元素就是计算结果。
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)