
pandas 常用操作
·
pandas 常用操作
1.pandas属性操作
- 获取行列数
players.shape - 显示前n行
employees.head(n)
2.pandas列属性操作
- 修改列名
data=data.rename(columns={'Dest':'iata_code','index':'from'}) students.columns=['student_id','first_name','last_name','age_in_years'] - 修改列索引名
data.rename_axis('index',inplace=True) - 修改列属性数据类型
data['country']=data['country'].astype('int') - 重新设置列索引范围
data.index = np.arange(1, len(data)+1) - 重置列索引,重新排序
data=data.reset_index(drop=True) - 去除不必要的列
data=data.drop(labels=['cmte_id','cand_id','file_num'],axis=1) - 将某列值设置为列索引
people=pd.read_csv('./data/people.csv',header=0) # append是否将列追加到现有索引。 people.set_index('people_id',drop=True,append=False) - 创建DataFrame对象设置列名
data=pd.DataFrame(student_data,columns=['student_id','age'])
3. pandas填充值
data['ID']=data['ID'].fillna(method='ffill') #向后填充
data['ID']=data['ID'].fillna(method='bfill') #向前填充
4. pandas重复值操作
- 查看重复值的个数
data.duplicated().sum() - 删除重复值,保存第一个值
data.drop_duplicates(keep='first',inplace=True)
data.drop_duplicates(subset=['col_name'],,keep='first',inplace=True)
5. pandas 空值(缺失值)操作
- 删除空值数据
# axis=0代表行 students.dropna(subset=['name'],how='any', axis=0,inplace = False) - 填充缺失值
products['quantity'].fillna(0,inplace=True)
   # products.replace({'quantity':{
    # None:0
    # }},inplace=True)
6. pandas根据值排序
data.sort_values(by='date',inplace=True,ascending=False)
  # inplace=True:将排序后的数据重新赋值给data
  # ascending=False,降序,默认升序
  # ignore_index=True重新排序
- 根据某一列的值排序rank
dense相同值的项将获得连续排名ascending指定排名的顺序,默认值为 True,升序
scores['rank']=scores['score'].rank(method = 'dense',ascending = False)
7. pandas列值操作
- 获取列不同值属性
data['country'].unique() - 获取列不同值并转为列表
list(set(data["Country/Region"].values.tolist())) - 计算前后2值之差
data['price'].diff() - 列值累加
data.cumsum() #默认按照列 - 计算前后2值之差变化率
data['price'].pct_change() - 查找列值是否存在列表中
dat.loc[df['country'].isin(['中国','美国','英国','日本','巴西'])] - 查找列值是否存在某个字符
data.loc[df['country'].str.contains('国')] - 获取列不同值属性个数
data['country'].nunique() - 获取列各个元素出现的次数
data['date'].value_counts().reset_index() - 获取最大值
data['date'].max() - 值移位
- 将列值向下移动一位
data['shift']=data['id'].shift(1,axis=0) - 将行值向右移动一位
data=data.shift(1,axis=1)
- 将列值向下移动一位
- 查看每列最大值的索引
data.iloc[:,:].idxmax() - 将列值float类型,保留小数点后2位
data['a']=data['mean'].round(decimals=2) - 将某列的值切割并添加新列
- 根据空格切割
data['name_new']=data['name'].map(lambda x: x.split(' ')[0])
- 根据空格切割
- 数值区间划分
bins=[i*8-20 for i in range(11)] # 划分区间 df,_=pd.cut(x=data['列名'],bins=bins,right=True,retbins=True) - 分箱
# float('inf') 正无穷 bins=[0,20000,50001,float('inf')] labels=['Low Salary', 'Average Salary', 'High Salary'] accounts['category']=pd.cut(accounts['income'],bins=bins,labels=labels,right=False) - 查看每列的值是否有空值
data.isnull().any(axis=0) - 列值修改相关操作
data['name']=data['name'].apply(lambda x :'d' if x not in lis else x) data['name']=data['name'].apply(lambda x :x.split('-')[0]) # 切割取值 data['name']=data['name'].apply(lambda x :x.replace('_','-')) # 替换字符 - 创建新列
- 处理数据的时候,根据已知列得到新的列,可以考虑使用
pandas.DataFrame.assign()函数# 根据原有的列,进行数值计算,常见多个新列 employees=employees.assign( add_time = employees.out_time+employees.in_time, sub_time=employees.out_time-employees.in_time ) - 使用assign函数不会改变原数据,而是返回一个新的DataFrame对象,包含所有现有列和新生成的列
- 注意:assign和apply函数的主要区别在于前者不改变原数据,apply函数是在原数据的基础上添加新列
employees['bonus']=employees['salary'].apply(lambda x:x*2)
employees=employees.assign(bonus=employees.salary*2)
employees['bonus']=employees['salary']*2
- 处理数据的时候,根据已知列得到新的列,可以考虑使用
8. pandas日期操作
- 字符串转为日期
data['date']=pd.to_datetime(data['date'],"%Y%m%d") - 生成指定范围日期
pd.date_range('1/1/2021','9/11/2021',freq='D') pd.date_range('2015-07-03', periods=8, freq='H') #periods:生成时间个数,freq:时间间隔 - 查看日期的星期,月份,天数,小时
data['week']=data['date'].dayofweek data['month']=data['date'].month data['day']=data['date'].day data['hour']=data['date'].dt.hour - 将日期列转为天数格式
data['date']=(data[‘date’]-np.datetime64('1970-01-01'))/np.timedelta64(1,'D') - resample获取数据
# 注意:data的列索引是日期
monthly = data.resample('M').first()#数据的重新取样
df_yearly = data.resample('A').last()
9. pandas 均线值
- 获取5日均线
md5=df['close'].rolling(5).mean()
10. pandas 数据统计
- 查看相关系数
data.corr() - 绘制相关系数热力图
data.corr().style.background_gradient(cmap='coolwarm').set_precision(2) - 查看列的众数
data['总分'].mode() - 查看列的中位数
data['总分'].median()
11. groupby分组
- 重复数据按照某列合并
data.groupby(data_repeat.columns.to_list()).agg(number=('people_number','sum')).reset_index() - 分组后进行多种数值统计
employees=employees.groupby(['event_day','emp_id']).agg( total_add=('total_time','sum'), total_mean=('total_time','mean') ).reset_index() - 分组获取最大值,且改列名
# 获取最小值的列名为first_login activity=activity.groupby('player_id').agg(first_login=('event_date','min')).reset_index() - 分组获取不同值个数,且改列名
# 获取的列名为cnt
teacher.drop_duplicates(['teacher_id','subject_id'],inplace=True)
teacher=teacher.groupby('teacher_id').agg(cnt=('subject_id','count')).reset_index()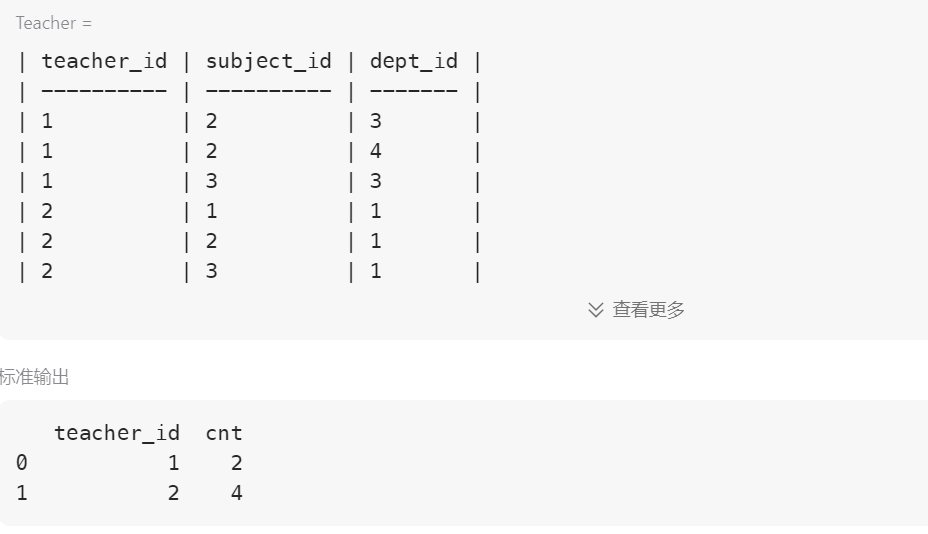
- 分组+自定义函数
# 方法一
def get_join(x):
    # "一组的字符串根据,拼接"
    x_list=sorted(list(set(x)))
    return ','.join(x_list)
def get_count(x):
    # 计算一组数据不同值的个数
    x_list=set(x)
    return len(x_list)
activities=activities.groupby(['sell_date']).agg(num_sold=('product',get_count),products=('product',get_join)).reset_index()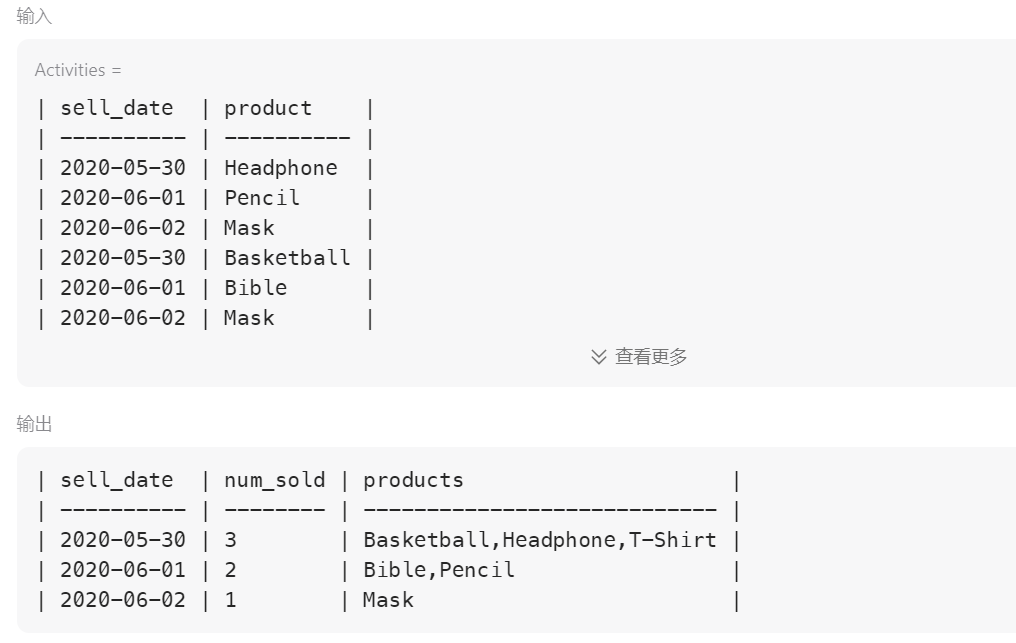
- 分组加+lambda函数统计
daily_sales=daily_sales.groupby(['date_id','make_name']).agg(
    unique_leads=('lead_id',lambda x:len(set(x))),
    unique_partners=('partner_id',lambda x:len(set(x)))
    ).reset_index()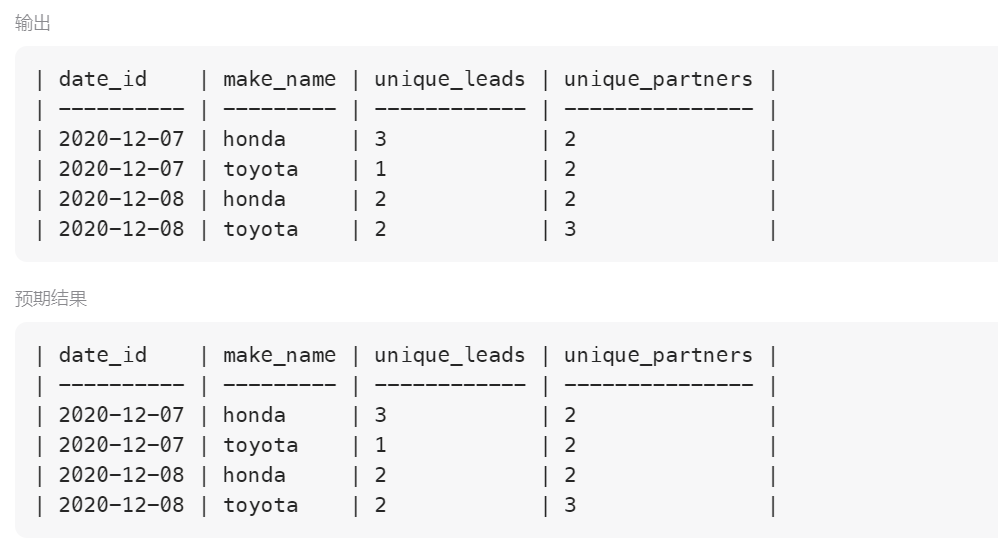
12. query查询操作
- 查询status列值为0的行
data_new.query('`status`=="0"') - 查看值是在列表中的行
data.query('`status` in ["<",">"]') - 查看值是否在列表中
lis=[1,2,3,4,5] data.query(f'`name_1` in {lis} & `name_2` in {lis}') # &2列同时满足 - 或操作
data.query('`name_1`!="1" | `name_2`!="2"') - 与操作
data.query('`name_1`!="1" & `name_2`!="2"')
13. 条件查询行
- 长度条件查询
data[data['novel_path'].str.len()>15] - 包含内容条件查询
data[data['path'].str.contains('home')] - 正则表达式条件筛选
# index的值为True或False 的索引 index=users['mail'].str.contains("^[a-zA-Z][0-9a-zA-Z\\.\\_\\/\\-]*@leetcode.com$",regex=True) - 条件数据选取值
students.loc[students['student_id']==101,['name','age']] students[students['student_id']==101][['name','age']] students.query('`student_id`==101')[['name','age']] - 条件查询及排序
animals[animals['weight'] > 100].sort_values(by='weight', ascending=False) - 两列值相等对比
new_views=views[views['author_id']==views['viewer_id']]
14. dataframe合并
- 数据上下合并
df1._append(df2) # pd.concat([df1,df2],axis=0) - 两表合并,左表为主表
data=pd.merge(employees,employee_uni,on='id',how='left')
print(data) # 标准输出
data=data[['unique_id','name']]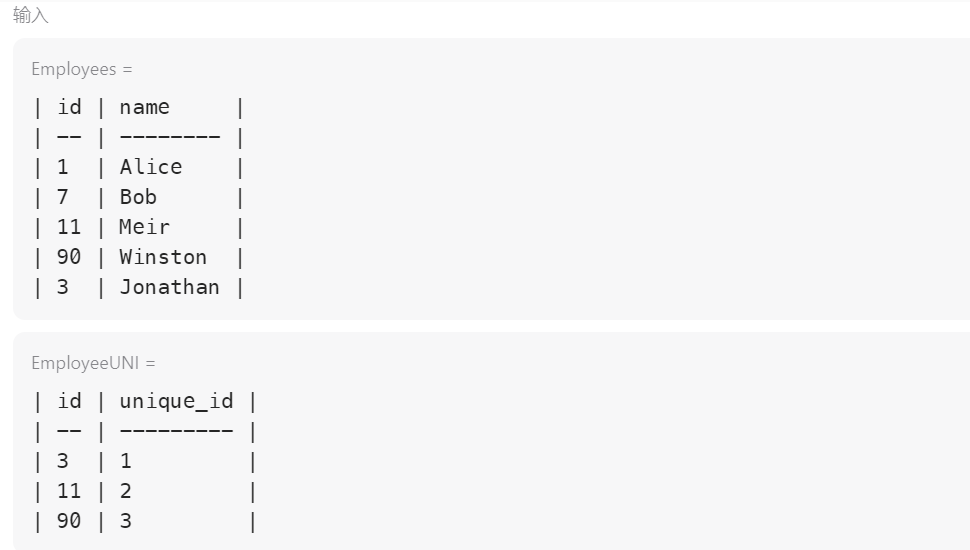
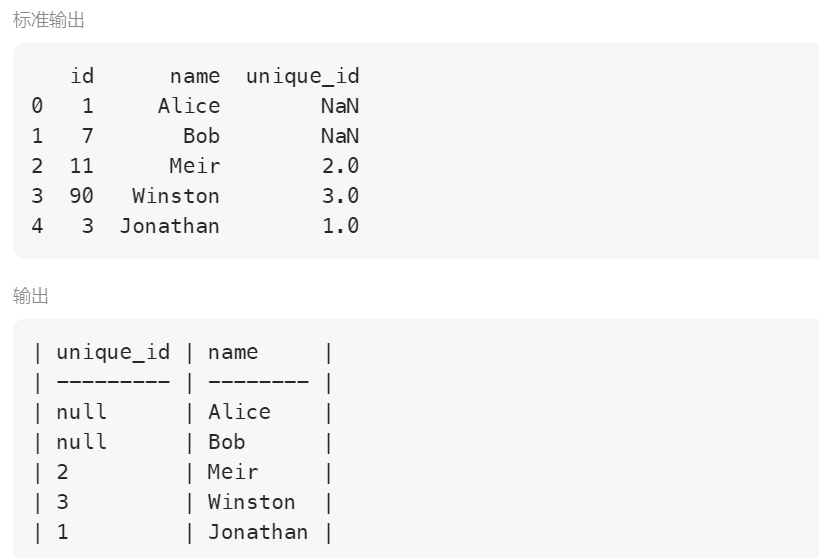
- 交叉合并
df = pd.merge(students,subjects,how='cross')
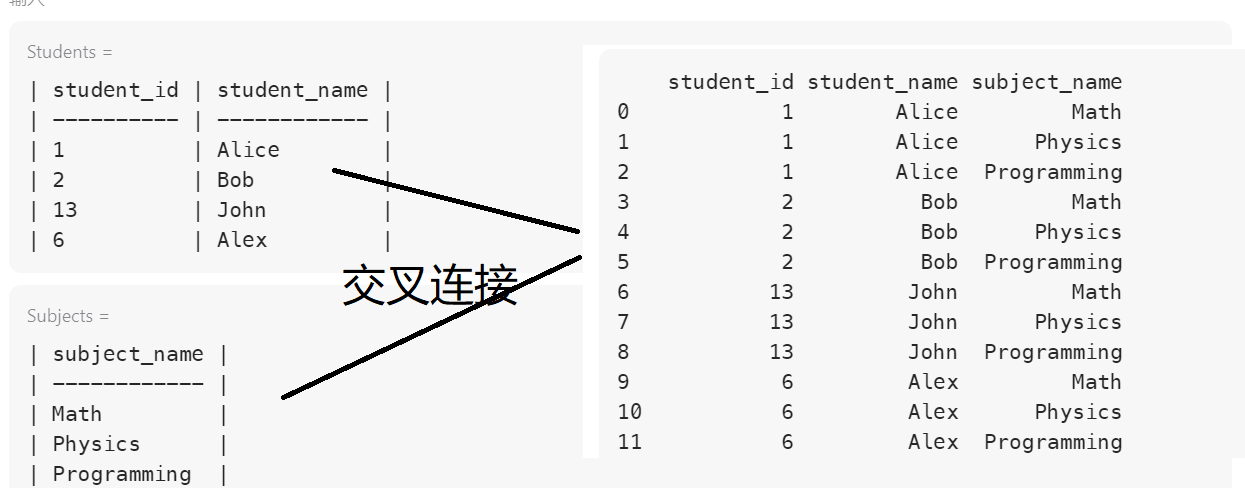
- 多文件合并
data=pd.DataFrame(columns=['path','name']) # 创建空的DataFrame
for home, dirs, files in os.walk(root_path):
    for filename in files:
        if filename.split('.')[-1].lower()=='txt':
            dic={'path':[home],'name':[filename]}
            df = pd.DataFrame(dic)# 创建一条数据的DataFrame
            data=data.append(df) # 合并
15.行数据操作
- 删除行数据
全为空的行data=data.dropna(axis=0, how='all') - 删除行数据
存在空的行data=data.dropna(axis=0, how='any')
16.映射相关操作
- apply映射操作
- 参数是一列(axis=0)或一行(axis=1)的数据
# a为一行数据 employees['bonus']=employees.apply(lambda a: a[2] if(a[0]%2==1 and a[1][0]!='M') else 0,axis=1) - 单列映射
users['name'].map(lambda x: x[0].upper()+x[1:].lower())
17 透视表相关操作
- df.pivot() 将长数据集转换成宽数据集,df.melt() 则是将宽数据集变成长数据集
- pivot_table透视表的使用
weather.pivot_table(index='month',values='temperature',columns='city',aggfunc='sum') - melt透视表的使用
pd.melt(report,id_vars['product'],var_name='quarter',value_name='sales')
18. dataframe创建
- 根据列表创建
id_lis=[1,2,3]
name_lis=['a','b','c']
data=pd.DataFrame({'id':id_lis,"name":name_lis})
更多推荐

 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)