
数据结构与算法(十五)——哈夫曼树
·
哈夫曼树
概述
- 给定n个权值作为n个叶子节点构造一棵二叉树,若该树的带权路径长度(wpl)最小,这样的二叉树为最优二叉树,也称赫夫曼树、哈夫曼树、霍夫曼树
- 赫夫曼树是带权路径最短的树,其中权值大的节点离根较近
重要概念
- 路径和路径长度:在一棵树中,从一个节点往下可以达到孩子或孙子节点之间的通路,称为路径。通路中分支的数目称为路径长度。若规定根节点的层数为1,则从根节点到第L层的路径长度为L-1
- 结点的权与带权路径长度:若将树种的结点赋予一个某种含义的数值,这个数值就成为结点的权。结点的带权路径长度为:从根节点到该结点之间的路径长度与该结点的权的乘积
- 树的带权路径长度:树的带权路径长度规定为所有叶子结点的带权路径长度之和,记为WPL。权值越大的结点离根节点越近的二叉树才是最优二叉树
- WPL最小的就是赫夫曼树
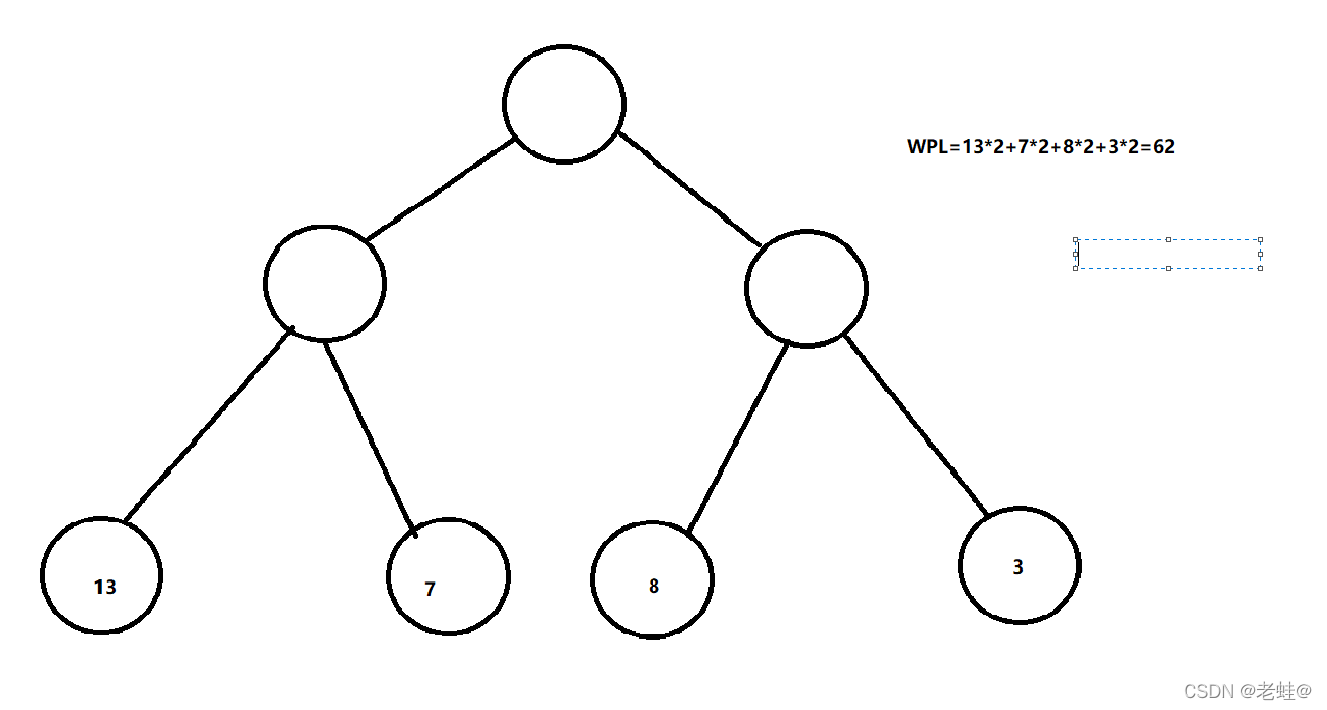
改成哈夫曼树则为:

构建哈夫曼树
- 将结点从小到大进行排序,每一个数据都是一个结点,每个节点都可以看成一颗二叉树
- 取出根节点权值最小的两颗二叉树
- 组成新的二叉树,该新的二叉树的根节点的权值是前面两颗树根节点权值之和
- 将这个新的二叉树再放入原序列中,再次构建,直到所有结点都构建完成
代码实现
/***
 * 哈夫曼树
 * @author laowa
 *
 */
public class HuffmanTree {

	public static void main(String[] args) {
		int[] arr = { 13, 7, 8, 3, 29, 6, 1 };
		createHuffmanTree(arr).preOrder();
	}

	/**
	 * 构建哈夫曼树
	 * @param arr 待构建的数组,数组中的值表示结点的权值
	 * @return 哈夫曼树的根节点
	 */
	public static Node createHuffmanTree(int arr[]) {
		// 将数组中的元素构建成node,存入arrayList中,方便排序
		List<Node> list = new ArrayList<>();
		for (int i = 0; i < arr.length; i++) {
			list.add(new Node(arr[i]));
		}
		//一直循环组成新树,直到集合中只有一个结点,这个结点就是哈夫曼树的根节点
		while (list.size() > 1) {
			// 排序
			Collections.sort(list);
			// 取权值最小的子树作左子树
			Node left = list.get(0);
			// 取权值次小的子树作右子树
			Node right = list.get(1);
			// 两个子树合并,得到新树
			Node parent = new Node(left.value + right.value);
			parent.left = left;
			parent.right = right;

			// 从list中删除两个旧结点,添加一个新结点
			list.remove(0);
			list.remove(0);
			list.add(parent);
		}

		return list.get(0);
	}

}

/***
 * 结点,为了Node能够排序,实现Comparable接口,通过Collection.sort进行排序
 *
 * @author laowa
 *
 */
class Node implements Comparable<Node> {
	/**
	 * 结点权值
	 */
	int value;
	/**
	 * 左子节点
	 */
	Node left;
	/**
	 * 右子节点
	 */
	Node right;

	public Node(int value) {
		this.value = value;
	}

	@Override
	public String toString() {
		return "value=" + value;
	}

	@Override
	public int compareTo(Node o) {
		// 从小到大进行排序
		return this.value - o.value;
	}

	/**
	 * 前序遍历
	 */
	public void preOrder() {
		System.out.println(this);
		if(this.left!=null) {
			this.left.preOrder();
		}
		if(this.right!=null) {
			this.right.preOrder();
		}
	}
}
哈夫曼编码
概述
- 哈夫曼编码也译作赫夫曼编码、霍夫曼编码;是一种编码方式,属于一种程序算法
- 赫夫曼编码是赫夫曼树再电讯通信中的经典应用之一
- 赫夫曼编码广泛的用于数据文件压缩,其压缩率通常在20%~90%之间
- 赫夫曼编码是可变 字长编码的一种吗,称之为最佳编码
原理
-
传输的字符串:i like like like java do you like java
-
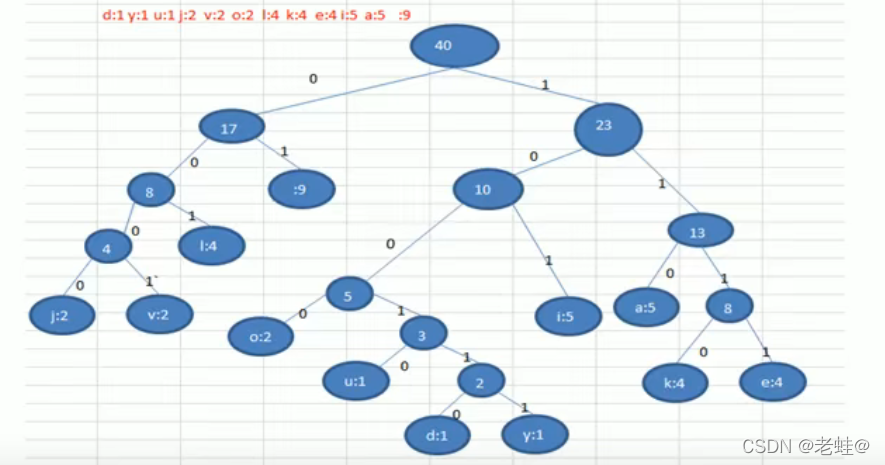
d:1,y:1,u:1,j:2,v:2,o:2,l:4,e:4,i:5,a:5, :9——各个字符对应的个数
-
按照上方字符出现的次数作为权值,构建一颗哈夫曼树
-
根据哈夫曼树,给各个字符规定编码,从根节点沿着路径知道奥 ,向左为0向右为1,得到每个结点的编码——o:1000,u:10010,d:100110,y:100111,i:101,a:110,k:1110,e:1111,j:0000,v:0001,l:001, :01
-
按照上面的哈夫曼编码,原字符串可以转换成一串01串

-
注意:哈夫曼树根据排序方法的不同,得到最后的哈夫曼编码也不完全一样,但是他们的wpl一样
代码实现(包括压缩文件应用)
/***
 * 哈夫曼编码
 *
 * @author laowa
 *
 */
public class HuffmanCode {

	public static void main(String[] args) {
		// String str = "i like like like java do you like a java";
		// byte[] bytes = huffmanZipStr(str);
		// System.out.println("原字符串:" + str);
		// System.out.println("原长度:" + str.length());
		// System.out.println("压缩之后的数据:" + Arrays.toString(bytes));
		// System.out.println("压缩之后的长度:" + bytes.length);
		// double percent = (str.length() - bytes.length) * 1.0 / str.length() * 100;
		// System.out.println("压缩率:" + percent);
		//
		// // 获取每个字节对应的结点
		// List<Node> nodes = getNodes(str.getBytes());
		// // 创建赫夫曼树
		// Node root = createHuffmanTree(nodes);
		// // 获取赫夫曼编码
		// Map<Byte, String> huffmanCodes = getHuffmanCodes(root);
		// byte[] source = decode(bytes, huffmanCodes);
		// System.out.println(new String(source));

		huffmanZipFile("C:\\Users\\lenovo\\Desktop\\favicon.ico", "C:\\Users\\lenovo\\Desktop\\a.zip");
		huffmanUnzipFile("C:\\Users\\lenovo\\Desktop\\a.zip","C:\\Users\\lenovo\\Desktop\\b.ico");
	}

	/**
	 * 压缩文件
	 *
	 * @param src
	 *            需要压缩的文件路径
	 * @param target
	 *            压缩后的压缩文件存储的目标目录
	 */
	public static void huffmanZipFile(String src, String target) {
		// 创建文件输入流
		FileInputStream in = null;
		OutputStream op = null;
		ObjectOutputStream out = null;
		try {
			// 初始化输入输出流
			in = new FileInputStream(src);
			op = new FileOutputStream(target);
			out = new ObjectOutputStream(op);
			// 读取文件
			byte source[] = new byte[in.available()];
			in.read(source);
			// 获取每个字节对应的结点
			List<Node> nodes = getNodes(source);
			// 创建赫夫曼树
			Node root = createHuffmanTree(nodes);
			// 获取赫夫曼编码
			Map<Byte, String> huffmanCodes = getHuffmanCodes(root);
			byte[] codes = huffmanZipBytes(source);
			//将编码写入
			out.writeObject(codes);
			//将哈夫曼编码表写入
			out.writeObject(huffmanCodes);
		} catch (Exception e) {
			e.printStackTrace();
		} finally {
			try {
				if(in!=null) {
					in.close();
					in = null;
				}
				if(out!=null) {
					out.close();
					out = null;
				}
				if(op!=null) {
					op.close();
					op = null;
				}
			} catch (IOException e) {
				e.printStackTrace();
			}
		}
	}

	/**
	 * 解压缩文件
	 *
	 * @param src
	 *            压缩文件的路径
	 * @param target
	 *            解压后文件存储的目标路径
	 */
	public static void huffmanUnzipFile(String src, String target) {
		// 创建文件输入流
		InputStream is = null;
		FileOutputStream out = null;
		ObjectInputStream in = null;
		try {
			// 初始化输入输出流
			is = new FileInputStream(src);
			out = new FileOutputStream(target);
			in = new ObjectInputStream(is);
			// 读取哈夫曼压缩编码
			byte codes[] = (byte[]) in.readObject();
			//读取哈夫曼编码表
			Map<Byte,String> huffmanCodes = (HashMap<Byte,String>) in.readObject();
			// 进行哈夫曼编码
			byte res[] = decode(codes,huffmanCodes);
			// 写入目标目录
			out.write(res);
		} catch (Exception e) {
			e.printStackTrace();
		} finally {
			try {
				if(in!=null) {
					in.close();
					in = null;
				}
				if(out!=null) {
					out.close();
					out = null;
				}
				if(is!=null) {
					is.close();
					is = null;
				}
			} catch (IOException e) {
				e.printStackTrace();
			}
		}
	}

	/**
	 * 哈夫曼压缩字符串(编码)
	 *
	 * @param str
	 *            需要压缩的字符串
	 * @return 压缩之后的字节数组
	 */
	public static byte[] huffmanZipStr(String str) {
		return huffmanZipBytes(str.getBytes());
	}

	/**
	 * 哈夫曼压缩字节数组(编码)
	 *
	 * @param bytes
	 *            需要压缩的字节数组
	 * @return 压缩之后的字节数组
	 */
	public static byte[] huffmanZipBytes(byte[] bytes) {
		// 获取每个字节对应的结点
		List<Node> nodes = getNodes(bytes);
		// 创建赫夫曼树
		Node root = createHuffmanTree(nodes);
		// 获取赫夫曼编码
		Map<Byte, String> huffmanCodes = getHuffmanCodes(root);
		// 根据赫夫曼编码将原字节数组进行压缩
		return zip(bytes, huffmanCodes);
	}

	/**
	 * 将字节转成二进制字符串
	 *
	 * @param flag
	 *            标志量,true表示需要补高位,false表示不需要补高位,经过Integer.toBinaryString转换后的二进制字符串可能不足8位,对于需要满足8位的字节就传入true来表示要在前面补0
	 * @param b
	 *            需要转成二进制的字节
	 * @return 二进制字符串
	 */
	private static String byteToBinaryString(boolean flag, byte b) {
		int temp = b;
		if (flag) {
			// 按位或运算,256的二进制码为1 0000 0000 temp与b进行按位或运算之后得到的结果为1+后面是在temp前面补零后的temp
			temp |= 256;
		}
		String str = Integer.toBinaryString(temp);
		// 取得后8位,256的1就丢弃了,这样得到的就是temp补满前缀0后的结果
		if (flag) {
			return str.substring(str.length() - 8);
		}
		return str;

	}

	/**
	 * 解码
	 *
	 * @param huffmanBytes
	 *            哈夫曼编码后的字节数组
	 * @param huffmanCodes
	 *            哈夫曼编码表
	 * @return 原来的字符串对应的字节数组
	 */
	private static byte[] decode(byte[] huffmanBytes, Map<Byte, String> huffmanCodes) {
		StringBuilder sb = new StringBuilder();
		// 将字节数组转换成二进制字符串并拼接,除了最后一个元素,前面的都需要满足8位,所以都需要补8位
		for (int i = 0; i < huffmanBytes.length - 1; i++) {
			sb.append(byteToBinaryString(true, huffmanBytes[i]));
		}
		// 最后一个元素不需要补位
		sb.append(byteToBinaryString(false, huffmanBytes[huffmanBytes.length - 1]));
		// 将赫夫曼编码反转,通过编码获取原字节
		Map<String, Byte> map = new HashMap<>();
		for (Map.Entry<Byte, String> entry : huffmanCodes.entrySet()) {
			map.put(entry.getValue(), entry.getKey());
		}
		// 存储经过解码后的字节
		List<Byte> list = new ArrayList<>();
		// 开始遍历二进制字符串
		for (int i = 0; i < sb.length(); i++) {
			// 表示当前扫描的个数
			int count = 1;
			// 标志量,表示是否找到了某个字节
			boolean flag = true;
			// 存储找到的字节
			Byte b = null;
			while (flag) {
				// 从i开始向后找count个,看是否存在与哈夫曼编码表中
				b = map.get(sb.subSequence(i, i + count));
				// 如果找到了就退出循环,没有找到就count++向后再找一位
				if (b == null) {
					count++;
				} else {
					flag = false;
				}
			}
			// 退出循环后,将找到的结果添加到集合中
			list.add(b);
			// 将i直接移动到i+count的位置,接下来从count+i开始找(每次循环还会经历一次i++,所以这里是加上count-1)
			i += count - 1;
		}
		// 将集合中的内容存到字节数组中
		byte[] res = new byte[list.size()];
		for (int i = 0; i < res.length; i++) {
			res[i] = list.get(i);
		}
		return res;
	}

	/**
	 * 获取赫夫曼编码
	 *
	 * @param node
	 *            赫夫曼树的根节点
	 */
	private static Map<Byte, String> getHuffmanCodes(Node node) {
		Map<Byte, String> huffmanCodes = new HashMap<>();
		if (node == null) {
			System.out.println("树为空");
			return huffmanCodes;
		}
		StringBuilder sb = new StringBuilder();
		getHuffmanCodes(node, "", sb, huffmanCodes);
		return huffmanCodes;
	}

	/**
	 * 将原始字符串根据赫夫曼编码表进行编码
	 *
	 * @param str
	 *            原始字符串
	 * @param huffmanCodes
	 *            赫夫曼编码表
	 * @return 编码之后的字节数组
	 */
	private static byte[] zip(byte[] bytes, Map<Byte, String> huffmanCodes) {
		// 创建一个stringbuilder拼接哈夫曼编码
		StringBuilder sb = new StringBuilder();
		for (byte b : bytes) {
			sb.append(huffmanCodes.get(b));
		}
		// 获得编码之后字节数组的长度,一个字节8位,如果哈夫曼编码的长度不整除8则除8以后剩下部分前面补0补齐8位
		int length;
		if (sb.length() % 8 == 0) {
			length = sb.length() / 8;
		} else {
			length = sb.length() / 8 + 1;
		}
		// 创建存储压缩后的数据的byte数组
		byte huffmanCodeBytes[] = new byte[length];
		// 记录当前huffmanCodeBytes存到了第几个字节
		int index = 0;
		String strByte;
		// 开始循环获取每个字节,每8位一个字节,所以步长为8
		for (int i = 0; i < sb.length(); i += 8) {
			// 如果后面不足8位则截取后面全部,否则向后截取8位
			if (i + 8 > sb.length()) {
				strByte = sb.substring(i);
			} else {
				strByte = sb.substring(i, i + 8);
			}
			// 将2进制字符串转化为十进制的数,在强转为字节
			// 二进制字符在计算机中以补码方式存储,该方法会将二进制码转换位十进制的数字
			huffmanCodeBytes[index] = (byte) Integer.parseInt(strByte, 2);
			index++;
		}
		return huffmanCodeBytes;
	}

	/**
	 * 获取霍夫曼编码,将传入的结点的所有叶子结点的霍夫曼编码获取到存入map中
	 *
	 * @param node
	 *            结点
	 * @param code
	 *            路径,左子节点路径为0,右子节点路径为1
	 * @param stringBuilder
	 *            用于拼接路径
	 * @param huffmanCodes
	 *            存储赫夫曼编码表的map集合
	 */
	private static void getHuffmanCodes(Node node, String code, StringBuilder stringBuilder,
			Map<Byte, String> huffmanCodes) {
		// 存储当前的stringBuilder,因为左右结点编码不同,每次经过一轮编码左右分为两个stringBuilder向下递归
		StringBuilder stringBuilder2 = new StringBuilder(stringBuilder);
		// 追加当前路径编码
		stringBuilder2.append(code);
		// 如果node.data==null表示当前不是叶子结点,向左右递归
		if (node.data == null) {
			// 向左递归编码
			getHuffmanCodes(node.left, "0", stringBuilder2, huffmanCodes);
			// 向右递归编码
			getHuffmanCodes(node.right, "1", stringBuilder2, huffmanCodes);
		} else {
			// 如果node.data不为空表示已经到了叶子结点,将当前的编码存入map中
			huffmanCodes.put(node.data, stringBuilder2.toString());
		}
	}

	/**
	 * 前序遍历
	 *
	 * @param root
	 *            树的根节点
	 */
	private static void preOrder(Node root) {
		if (root == null) {
			System.out.println("树为空");
		} else {
			root.preOrder();
		}
	}

	/**
	 * 构建哈夫曼树
	 *
	 * @param nodes
	 *            结点集合
	 * @return 哈夫曼树的根节点
	 */
	private static Node createHuffmanTree(List<Node> nodes) {
		while (nodes.size() > 1) {
			Collections.sort(nodes);
			Node left = nodes.get(0);
			Node right = nodes.get(1);
			Node parent = new Node(left.weight + right.weight);

			parent.left = left;
			parent.right = right;

			nodes.remove(0);
			nodes.remove(0);
			nodes.add(parent);
		}
		return nodes.get(0);
	}

	/**
	 * 获取结点集合
	 *
	 * @param bytes待编码的字节数组
	 * @return 结点集合
	 */
	private static List<Node> getNodes(byte[] bytes) {
		List<Node> nodes = new ArrayList<>(bytes.length);
		Map<Byte, Integer> map = new HashMap<>();
		// 遍历字节数组,将各个字符的个数存入map中
		for (int i = 0; i < bytes.length; i++) {
			if (map.get(bytes[i]) == null) {
				map.put(bytes[i], 1);
			} else {
				map.put(bytes[i], map.get(bytes[i]) + 1);
			}
		}
		// 将map中的元素转成结点存入list中
		for (Entry<Byte, Integer> entry : map.entrySet()) {
			nodes.add(new Node(entry.getKey(), entry.getValue()));
		}
		return nodes;
	}

}

/***
 * 结点
 *
 * @author laowa
 *
 */
class Node implements Comparable<Node> {
	/**
	 * 结点表示的字符,对应字符的ascii码
	 */
	Byte data;
	/**
	 * 结点的权值
	 */
	int weight;
	/**
	 * 左子节点
	 */
	Node left;
	/**
	 * 右子节点
	 */
	Node right;

	public Node(byte data, int weight) {
		this.data = data;
		this.weight = weight;
	}

	public Node(int weight) {
		this.data = null;
		this.weight = weight;
	}

	/**
	 * 前序遍历
	 */
	public void preOrder() {
		System.out.println(this);
		if (left != null) {
			left.preOrder();
		}
		if (right != null) {
			right.preOrder();
		}
	}

	@Override
	public String toString() {
		return "[data=" + data + "\tweight=" + weight + "]";
	}

	@Override
	public int compareTo(Node o) {
		// TODO Auto-generated method stub
		return this.weight - o.weight;
	}
}
更多推荐



 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)