
性能测试&工作总结--JAVA应用性能测试分析与定位
JAVA应用性能测试分析与定位
1. 术语解释
1. 响应时间
- 网络角度
RT=从应用系统发出请求开始, 到客户端收到最后一个字节数据为止所消耗的时间 - CPU角度
RT=Thread CPU Time(CPU执行的时间) + Thread Wait Time(线程等待时间, 包含IO等待, Sleep和Wait) + 网络传输的时间 - 业务角度
每个事物完成实际所需时间和 / 事物处理数目
2. 吞吐率
单位时间内服务器返回客户端的数据量的大小, 用于衡量被测系统的处理能力, 列: 字节数/秒, 请求数/秒, 页面数/秒, 查询数/秒, 事务数/秒等, 故吞吐率可以用TPS表示
3. 吞吐量
指一段时间内服务器返回客户端的数据量的大小, 用于衡量被测系统的处理能力, 吞吐量=吞吐率 * 单位时间
4. TPS
指每秒系统能够处理的事务的数量, 即: TPS=总事务数(成功 + 失败) / 运行时长, **提醒:**对于多并发访问的系统, TPS与响应时间(RT)不成反比关系, 即不一定成线性关系
5. Load
指系统进程队列的长度, 这里的进程队列长度是指已使用的CPU的Processor(逻辑处理单元)数量, 而不是技术层面理解的thread(进程)数.
如果想了解CPU有多少个逻辑单元, 可使用命令cat /proc/cpuinfo | grep ‘processor’ | sort | uniq进行查看
当Load >= CPU的Processors总数 + 1, 则意味着系统已经满负荷运行, 可以通过命令: w或uptime 或top查看系统Load情况(分别为1分钟, 5分钟, 15分钟平均进程数)
6. GC
垃圾回收, 即JVM内存回收, 但会导致程序运行中断, 影响系统稳定运行
- 重点掌握什么情况下会产生和触发GC(YGC, FullGC, CMSGC)
- 重点掌握GC优化策略, 内存如何优化以及GC算法选择
- 有时Java应用产生GC不是在运行时发生的, 而是在启动时已经发生, 所以程序启动运行完成时建议预先监控下GC的情况
2. GC算法
1. -XX: +UseSeria1GC
年轻代GC方式: Serial 串行GC
老年代&持久代GC方式: Serial 01d(MSC(Mark Sweep Compact)) 串行GC
特点: 系统高停顿(暂停用户线程)
适用范围和场景: 单核处理, 对响应时间无要求, 使用串行收集器
2. -XX: +UseParNewGC
年轻代GC方式: ParNew并行GC
老年代&持久代GC方式: Serial 01d(MSC(Mark Sweep Compact)) 串行GC
特点: 系统高停顿(暂停用户线程)
适用范围和场景: 单核处理, 对响应时间无要求, 使用串行收集器
3. -XX: + UseParallelGC
年轻代GC方式: Parallel Scavenge并行回收GC
老年代&持久代GC方式: Serial 01d(MSC(Mark Sweep Compact)) 串行GC
特点: 系统高停顿(暂停用户线程)
适用范围和场景: 单核处理, 对响应时间无要求, 使用串行收集器
4. -XX: + UseParallel01GC
年轻代GC方式: Parallel Scavenge并行回收GC
老年代&持久代GC方式: Parallel 01d并行GC
特点: 系统高停顿(暂停用户线程)
适用范围和场景: 多核处理, 对响应无时间要求, 对吞吐量有较高要求, 使用并行收集器
5. -XX: + UseConcMarkSweepGC
年轻代GC方式: ParNew 并行GC
老年代&持久代GC方式: CMS(Concurrent Mark Sweep) 并发GC, 当出现"Concurrent Mode Failure"时采用Serial 01d 串行GC
特点: 系统低停顿(并发标记与并发清除过程不暂停用户线程, 仅重新标记过程暂停用户线程, 该暂停时间可忽略)
适用范围和场景: 多核处理, 对响应时间有高要求, 对吞吐量无要求, 使用并发收集器
6. -XX: + UseConcMarkSweepGC -XX: + UseParNewGC
年轻代GC方式: Serial 串行GC
老年代&持久代GC方式: CMS(Concurrent Mark Sweep) 并发GC, 当出现"Concurrent Mode Failure"时采用Serial 01d 串行GC
特点: 系统低停顿(并发标记与并发清除过程不暂停用户线程, 仅重新标记过程暂停用户线程, 该暂停时间可忽略)
适用范围和场景: 多核处理, 对响应时间有高要求, 对吞吐量无要求, 使用并发收集器
7. 不支持的组合方式
- -XX: +UseParNewGC -XX: +UseParallel01dGC
- -XX: +UseParNewGC -XX: +UseSerialGC
3. 问题分类
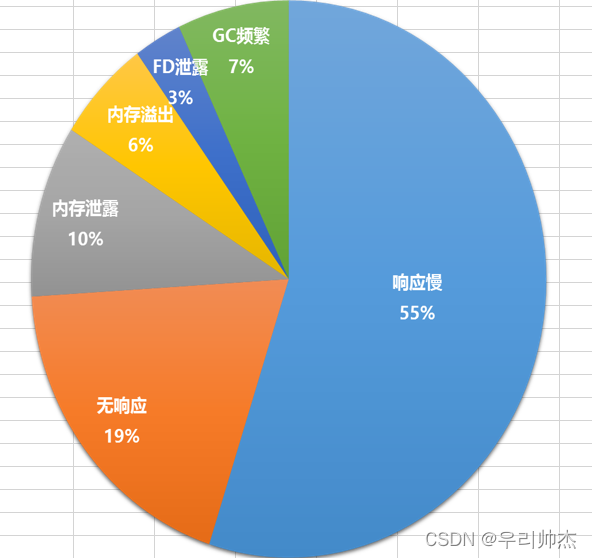
4. 问题分析
4.1. 响应慢
4.1.1. 进程占用CPU突然飙升或达到100%(CPU高, Load高)
- 问题原因: 一般由CPU密集型操作导致(例: 序列化/反序列化, 编/解码, 死循环, FullGC等)
- 分析方法:
- 通过工具jconsole或命令jstat -gcutil <pid>查看是否存在大量GC
- 使用jvisualvm通过jmx连接上被测应用, 通过cpu抽样器查看占比最高的热点方法
- (1)打线程dump: jstack <pid> >> thread.dump
(2)找到导致CPU高的线程: top -H -p <pid>
(3)将十进制pid转换成十六进制
(4)找到对应的线程: 打开thread.dump文件, 查找: 按十六进制值找到对应线程, 把相关方法找出来, 可以精确到代码的行号
备注: 方法3可能存在无法捕获当前CPU高线程的dump信息, 这种情况下, 建议直接使用方法4 - 通过命令查看: jstack <pid> | grep <线程pid相对应的十六进制的值> -C 15
- 解决建议:
- 减少或优化序列化/反序列化(例: gson改为fastjson), 编/解码等操作
- 避免死循环(递归, 循环语句等)
- 避免发生FullGC
- 使用线程池减少网络的重复连接和断开
- 使用对象池减少大对象的重复创建和销毁
4.1.2. Load高, CPU低
- 问题原因: 内存不足, IO(磁盘IO, 网络IO)处理慢, 线程池满, 导致IO请求排队长
- 分析方法:
- 确认是否为磁盘IO导致
(1)判断是不是因磁盘成为瓶颈导致
通过命令iostat -x查看%util(一秒中有百分之多少的CPU时间用于 I/O 操作),如果 %util 接近 100%,说明产生的I/O请求太多,I/O系统已经满负荷,磁盘成为瓶颈。再查看svctm(平均每次设备I/O操作的服务时间)、await(平均每次设备I/O操作的等待时间),如果await远大于svctm,说明I/O请求排队太长。
(2)判断是不是因内存成为瓶颈导致
通过命令vmstat查看swap、bi/bo(块设备每秒发送/接收的块数量),如果swap、bi/bo一直大于0,说明IO操作(swap)过于频繁,内存成为瓶颈。再查看b参数(等待资源的进程数)和wa参数(IO等待所占用的CPU时间的百分比)过高,说明I/O请求排队太长。 - 确认是否为网络IO处理慢导致
(1)判断是不是依赖组件响应慢导致,可通过日志查看。
(2)判断是不是依赖中间件响应慢导致,如DB是否存在慢查询等。 - 确认是否为线程池满导致
通过命令jstack >> thread.dump或工具使用jvisualvm打线程dump,然后通过工具IBM ThreadAnalyzer ( jca457.jar )或jvisualvm查看线程状态。
(1)如果
线程状态为“waiting on condition”,说明线程正在等待网络/磁盘读写,导致IO排队。
(2)如果线程在执行c3p0建立连接方法时处于“BLOCKED”状态,说明数据库连接池满,导致IO排队。 - 如果希望直接从代码层面定位耗时较长代码段,则可以通过工具tProfiler或iProfiler加载Class方法,分析调用次数最多或平均执行时间最高的方法(热点方法)
- 确认是否为磁盘IO导致
- 解决建议:
- 关闭虚拟内存或减少内存的使用
- 使用BufferedInputStream, BufferedOutputStream 代替 FileInputStream, FileOutputStream, 提高磁盘的读写效率
- 设置合理的超时机制或提高网络IO处理效率(例: 压缩传输包大小或减少慢查询等)
- 调大连池或及时释放连接
4.2. 无响应
4.2.1. 瞬间大量调用失败(CPU低, Load低)
- 问题原因: 出现非线性安全问题(如: 多线程IO死锁), 数据库死锁等导致功能不可用
- 分析方法:
1. 通过命令jstack <pid> >> thread.dump 或工具使用jvisualvm打线程dump, 然后通过工具IBM ThreadAnalyzer(jca457.jar)或jvisualvm查看线程状态, 如果两个线程状态为"waiting to lock", 说明线程各持有一个锁, 又在等待另一个锁, 故造成死锁
2. 通过命令show engine innodb ststus\G查看Mysql死锁情况 - 解决建议:
- 保证锁的顺序一致
4.3. TPS上不去
4.3.1. 响应较快, 但TPS较低(CPU高, Load低)
- 问题原因:
- 负载机压力上不去(表现为CPU过高或端口不够用导致上行失败或超时)
- 目标机压力受理不过来(表现为CPU过高或端口不够用导致上行失败或超时)
- 分析方法:
- 查看负载机或目标机(被测服务器)CPU是都很高
- 查看请求端口是否被占满(可以通过netstat查看)
(1)Windows服务器: nestat -ano|findstr 端口号 > temp.txt
(2)Linux服务器: netstat -n | grep tcp | grep 端口号 > temp.txt
- 解决建议:
- 优化负载策略, 或使用多机负载方式(将压测工具部署或分发至多台服务器)(详见《高性能可扩展性能测试框架》----后续更新)
- 若端口不够用, 则优化系统网络参数(详见《Windows&Linux系统内核参数调优》----后续更新), 使得TCP端口能够快速回收
- 采用IO复用的方式, 设置成长连接, 减少连接建立或释放时CPU及端口的使用
- 其他建议同4.1.1
4.4. 内存泄漏
4.4.1 偶发性内存泄漏(应用运行内存忽然上涨)
- 问题原因: 发生内存泄漏的代码只有在某些特定环境或操作过程下才会发生
4.4.2 一次性内存泄漏(应用启动时内存一直上涨)
- 问题原因: 发生内存泄漏的代码只会被执行一次, 或者由于算法上的缺陷, 导致总会有一块仅且有一块内存发生泄漏
4.4.3 隐式内存泄漏(应用启动时内存一直上涨)
- 问题原因: 程序在运行过程中不停的分配内存, 但是直到结束时候才释放内存
分析方法
- 在JVM参数后添加-XX:+HeapDumpOnOutOfMemoryError,即在内存溢出时自动生成堆dump文件
- 通过工具jvisualvm或命令jmap -dump:format=b,file=heap.dump <pid>打堆内存dump
- 通过方法2,间隔一段时间,连续数次打堆内存dump,然后通过工具jvisualvm或JProfiler对比分析新增对象(堆内存占比最高的对象类型)
- 通过命令jmap -histo:live <pid> | more查看是否存在大对象(堆内存占比最高的对象类型)
- 通过工具MAT (Memory Analyzer Tool)、IBM HeapAnalyzer (ha456.jar)查看上述新增或大对象的代码引用路径
解决建议
- 尽早释放无用对象的引用, 即使用临时变量时, 让引用变量在退出活动域后, 自动设置为NULL
- 程序里不了避免大量使用字符串处理, 避免使用String尽量使用StringBuffer
- 尽量少使用静态变量, 因为静态变量是全局的, GC不会进行回收
- 避免集中创建对象尤其是大对象, JVM突然需要大量内存, 这时必然会触发GC优化系统内存环境
- 尽量运用对象池技术以提高系统性能, 因为生命周期长的对象拥有生命周期短的对象时易发生内存泄漏
- 资源对象(PreparedStatement、ResultSet、File、Buffer、Socket等)使用完要及时关闭。
- 集合容器对象(例:ArrayList)使用完要及时清理。
4.5 内存溢出
4.5.1 java.lang.OutOfMemoryError: PermGen space
- 问题原因:
- 重载第三方jar, 其大小超过XX: PermSize默认值和设定值
- 加载大量的第三方jar, 其大小超过XX: PermSize默认值或设定值
- 分析方法:
- 查看web容器(tomcat)或java应用日志
- 解决建议:
- 将相同的第三方jar文件移植到tomcat/shared/lib目录下, 可以减少jar包重复占用内存
- 持久代(PerSize, MaxPerSize)内存调大
4.5.2 java.lang.OutOfMemoryError: Java heap spasc
- 问题原因: Xms超过了Xmx值, 或者堆最大值和非堆最大值的总和超过了物理内存或者操作系统的最大限制
- Web文件上传过大
- 开启大型文件
- 从数据库第一次读取太多数据
- 分析方法:
- 查看web容器(tomcat)或java应用日志
- 解决建议:
- 减少一次性堆内存加载或适当将整个堆(Xms, Xmx)内存比例调大
4.6. FD(文件描述符)泄漏
4.6.1 java.net.SocketException: Too many open files
- 问题原因: 网络IO打开未关闭
- 分析方法:
- 通过lsof -n|awk ‘{print $2}’|sort|uniq -c |sort -nr|grep <pid>查看当前进程打开的文件描述符数
- 通过losf -p 查看新增FD的TYPE类型(FIFO、IPv4)以及Node Name
- 解决建议:
- 释放网络连接
4.6.2 java.io.FileNotFoundException: Too many open files
- 问题原因: 磁盘IO打开未关闭
- 分析方法:
- 通过lsof -n|awk ‘{print $2}’|sort|uniq -c |sort -nr|grep <pid>查看当前进程打开的文件描述符数
- 通过losf -p 查看新增FD的TYPE类型(FIFO、IPv4)以及Node Name
- 解决建议:
- 关闭文件流
4.7. GC频繁
4.7.1 YGC频繁
- 问题原因:
- Eden区设置过小
- 使用大量大对象, 比如长字符串, byte[]数组等, 导致Eden区快速填满
- Eden区大部分对象不被回收, 导致可用空间比较小
- 分析方法:
- 打印GC日志:在JVM参数后添加-XX:+PrintGCDetails -Xloggc:…/logs/gc.log -XX:+PrintGCTimeStamps或-verbose:gc -XX:+PrintGCDetails -XX:+PrintGCTimeStamps
- 查看日志了解Eden(年轻代)/Old(老年代)/Perm(永久代)对象内存分配与回收情况以及异常信息
- 若怀疑内存泄露,则使用工具IBM GCAnalyzer (ga439.jar )加载gc.log,查看UsedNew(after)|Used Tenured(after)|Used Perm(after)趋势图。若一直上涨,说明由于内存泄露引起GC频繁
- 解决建议:
- 年轻代(-Xms)及整个堆(-Xms, -Xmx)内存比例调大
- 减少大对象使用比例
- 怀疑内存泄漏, 排查解决
4.7.2 FGC频繁
- 问题原因:
- 取消了Survivor区或存活周期设置较短, 导致Eden区对象直接或快速进入01d区
- 使用了Java反射机制且不断进行ClassLoad操作,导致Perm区快速填满
- 代码中显示调用System.gc()
- Old大部分对象不被回收,导致可用空间较小
- 由于并发收集器产生大量碎片导致无连续空间存放对象,进而导致CMSGC时出现Concurrent Mode Failure错误
- 并发收集器回收速度跟不上分配的速度,进而导致CMSGC时出现Concurrent Mode Failure错误
- Minor GC后将无法回收对象放入存活区,但存活区空间不够用直接进入Old区发现空间不够用,导致CMSGC时时出现Promotion Failed错误
- 代码异常下不断Dump
- 分析方法:
- 打印GC日志:在JVM参数后添加-XX:+PrintGCDetails -Xloggc:…/logs/gc.log -XX:+PrintGCTimeStamps或-verbose:gc -XX:+PrintGCDetails -XX:+PrintGCTimeStamps
- 查看日志了解Eden(年轻代)/Old(老年代)/Perm(永久代)对象内存分配与回收情况以及异常信息
- 若怀疑内存泄露,则使用工具IBM GCAnalyzer (ga439.jar )加载gc.log,查看UsedNew(after)|Used Tenured(after)|Used Perm(after)趋势图。若一直上涨,说明由于内存泄露引起GC频繁
- 解决建议:
- 设置存活区且将存活周期(-XX:MaxTenuringThreshold)调大
- JDK1.7:持久代(-XX:PermSize、-XX:MaxPermSize)内存调大; JDK1.8:元空间(-XX:MetaspaceSize、-XX:MaxMetaspaceSize)内存调大
- 禁用显示调用(-XX:+DisableExplicitGC)或代码中屏蔽相关代码行
- 怀疑内存泄露,排查解决
- 提前压缩,减少内存碎片
- 调大老年代内存空间(将-Xmx调大)
- 提前触发CMSGC,回收Old区
- 调大存活区及存活周期,使得年轻代区对象进入老年区速度放缓
- 调大老年代内存空间(将-Xmx调大)
- 提前触发CMSGC,回收Old区
- 调大存活区及存活周期,使得年轻代区对象进入老年区速度放缓
- 捕获异常且控制Dump频率
4.7.3 CMSGC频繁
- 问题原因:
- Old区设置过小
- 大量大对象从Eden区进入Old区,导致Old区快速填满
- Old区或Perm区对象回收比例阀值较低
- Old区大部分对象不被回收,导致可用空间较小
- 代码中显示调用System.gc()
- 分析方法:
- 打印GC日志:在JVM参数后添加-XX:+PrintGCDetails -Xloggc:…/logs/gc.log -XX:+PrintGCTimeStamps或-verbose:gc -XX:+PrintGCDetails -XX:+PrintGCTimeStamps
- 查看日志了解Eden(年轻代)/Old(老年代)/Perm(永久代)对象内存分配与回收情况以及异常信息
- 若怀疑内存泄露,则使用工具IBM GCAnalyzer (ga439.jar )加载gc.log,查看UsedNew(after)|Used Tenured(after)|Used Perm(after)趋势图。若一直上涨,说明由于内存泄露引起GC频繁
- 解决建议:
- 调大老年代内存空间(将Xmx调大)
- 使用-XX:PretenureSizeThreshold参数限制进入老年代对象大小
- 提高回收比例阀值
- 怀疑内存泄露,排查解决
- 禁用显示调用或代码中屏蔽相关代码行
4.8. GC耗时长
4.8.1 FGC耗时较长
- 问题原因:
- 老年代较大且使用串|并行收集器
- 分析方法:
- 使用命令java -XX:+PrintFlagsFinal -version | grep :查看jdk默认使用的收集器
- 参照【2.GC算法】查看老年代垃圾收集器是否为串|并行收集器
- 解决建议:
- 将老年代垃圾收集器改为并发收集器,优化JVM参数如下:
-Xmx4096M -Xms4096M -Xmn1024M -XX:MetaspaceSize=512M -XX:MaxMetaspaceSize=512M -Xss256K -XX:+DisableExplicitGC -XX:SurvivorRatio=1 -XX:+UseConcMarkSweepGC -XX:+UseParNewGC -XX:+CMSParallelRemarkEnabled -XX:+UseCMSCompactAtFullCollection -XX:CMSFullGCsBeforeCompaction=0 -XX:+CMSClassUnloadingEnabled -XX:LargePageSizeInBytes=128M -XX:+UseFastAccessorMethods -XX:+UseCMSInitiatingOccupancyOnly -XX:CMSInitiatingOccupancyFraction=80 -XX:SoftRefLRUPolicyMSPerMB=0
若JDK为1.7版本,则将MetaspaceSize、MaxMetaspaceSize替换为PermSize、MaxPermSize
- 将老年代垃圾收集器改为并发收集器,优化JVM参数如下:
更多推荐



 1
 0
- 0


 已为社区贡献5条内容

所有评论(0)