
推荐系统之矩阵分解算法
·
一、前言
在开始之前我们先引入例题,User表示用户,Data表示不同物品所获得的打分分数,请补全该表格

在打分表格中,用户并不见得会对所有项目都进行打分(0表示未打分),那么如何预测并补全打分表格呢,我们引入矩阵分解的概念。
为了变量名的统一,此处我采用吴恩达机器学习中的符号表示,用m表示用户数量的多少,具体表示为m行;n表示待打分物品数量的多少,具体表示为n列。在本例中m=5,n=5。
二、矩阵分解。
首先我们需要知道,在矩阵乘法的过程中,
也就意味着我们的打分表格,可以被分解为两个表格甚至多个表格,这些被分解的表格受到某些特征的共同作用,这种特征可以有多个,我们定义为K个。本例中我们取 矩阵
表示m个User和K个特征之间的关系矩阵,矩阵
表示n个Item和K个特征之间的关系矩阵。
所以我们将问题进行了转移,把最终预测矩阵 转换为了两个关系矩阵的乘积,即
,而损失函数的定义即可转换为(为了后续操作的方便,在此对损失函数的表示形式我们采取平方的方式)
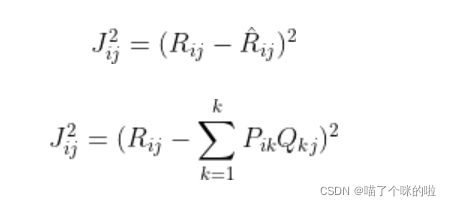
三、梯度下降求解。
- 首先我们对已经加上正则项的损失函数分别求
和
的偏导:
- 然后根据梯度的方向对变量
- 进行迭代,直到损失函数
小于提前规定的阈值。
四、 源代码。
import numpy as np
from math import pow        #主要用于求平方
import matplotlib as plt
import pandas as pd          #导入pandas库的作用主要是用于从csv文件中读取数据
def matrix_factorization(R,P,Q,K,steps=5000,alpha=0.0002,Lambda=0.02):
    result=[]                    #将每次迭代的损失函数值存到数组中,便于最后画图分析
    for step in range(steps):              #最大循环次数
        for i in range(len(R)):
            for j in range(len(R[i])):     #通过两层遍历的嵌套,完成对原矩阵每个元素的的遍历
                if R[i][j]>0:            #若此数据为0即未打分,则跳过,仅在有值时进行梯度下降
                    eij=R[i][j]-numpy.dot(P[i,:],Q[:,j]) # .dot(P,Q) 表示矩阵内积
                    for k in range(K):
                        P[i][k]=P[i][k]+alpha*(2*eij*Q[k][j]-Lambda*P[i][k])
                        Q[k][j]=Q[k][j]+alpha*(2*eij*P[i][k]-Lambda*Q[k][j])
        eR=numpy.dot(P,Q)     #完成梯度下降算法后,求出当前的预测矩阵,为下面求损失函数做准备
        e=0        #e即为损失函数
        for i in range(len(R)):
            for j in range(len(R[i])):
                if R[i][j]>0:
                    e=e+pow(R[i][j]-eR[i][j],2)    #只对已评分的元素求损失函数
        result.append(e)
        if e<0.001:            #若损失函数小于阈值,则跳出for循环,否则继续进行上述过程
            break
    return P,Q,result
if __name__ == '__main__':

    R=pd.read_csv("df.csv")    #用pandas库读取数据表格,若无csv表格可用代码手动输入

    #R=[
    #     [5,3,0,1,0],
    #     [4,0,0,1,2],
    #     [1,1,0,5,0],
    #     [1,0,0,4,5],
    #     [0,1,5,4,3]
    # ]

    R=numpy.array(R)            #将读取出来的数据元素转化为矩阵

    M=len(R)
    N=len(R[0])
    K=2

    P=numpy.random.rand(M,K) #随机生成一个 M行 K列的矩阵
    Q=numpy.random.rand(K,N) #随机生成一个 K行 N列的矩阵

    nP,nQ,result=matrix_factorization(R,P,Q,K)
    print("原始的评分矩阵R为:\n",R)
    R_MF=numpy.dot(nP,nQ)
    print("经过MF算法填充0处评分值后的评分矩阵R_MF为:\n",R_MF)


    n=len(result)
    x=range(n)
    plt.plot(x,result,color='r',linewidth=3)
    plt.title("Convergence curve")
    plt.xlabel("generation")
    plt.ylabel("loss")
    plt.show()
更多推荐


 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)