
[iceberg]3-spark调用iceberg入口分析
·
以sql调用来分析:
[hadoop@10 ~]$ spark-sql --master local \

--conf spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions \

--conf spark.sql.catalog.spark_catalog=org.apache.iceberg.spark.SparkSessionCatalog \

--conf spark.sql.catalog.spark_catalog.type=hadoop \

--conf spark.sql.catalog.spark_catalog.warehouse=hdfs://ns1/user/wanghongbing/db
流程如下:
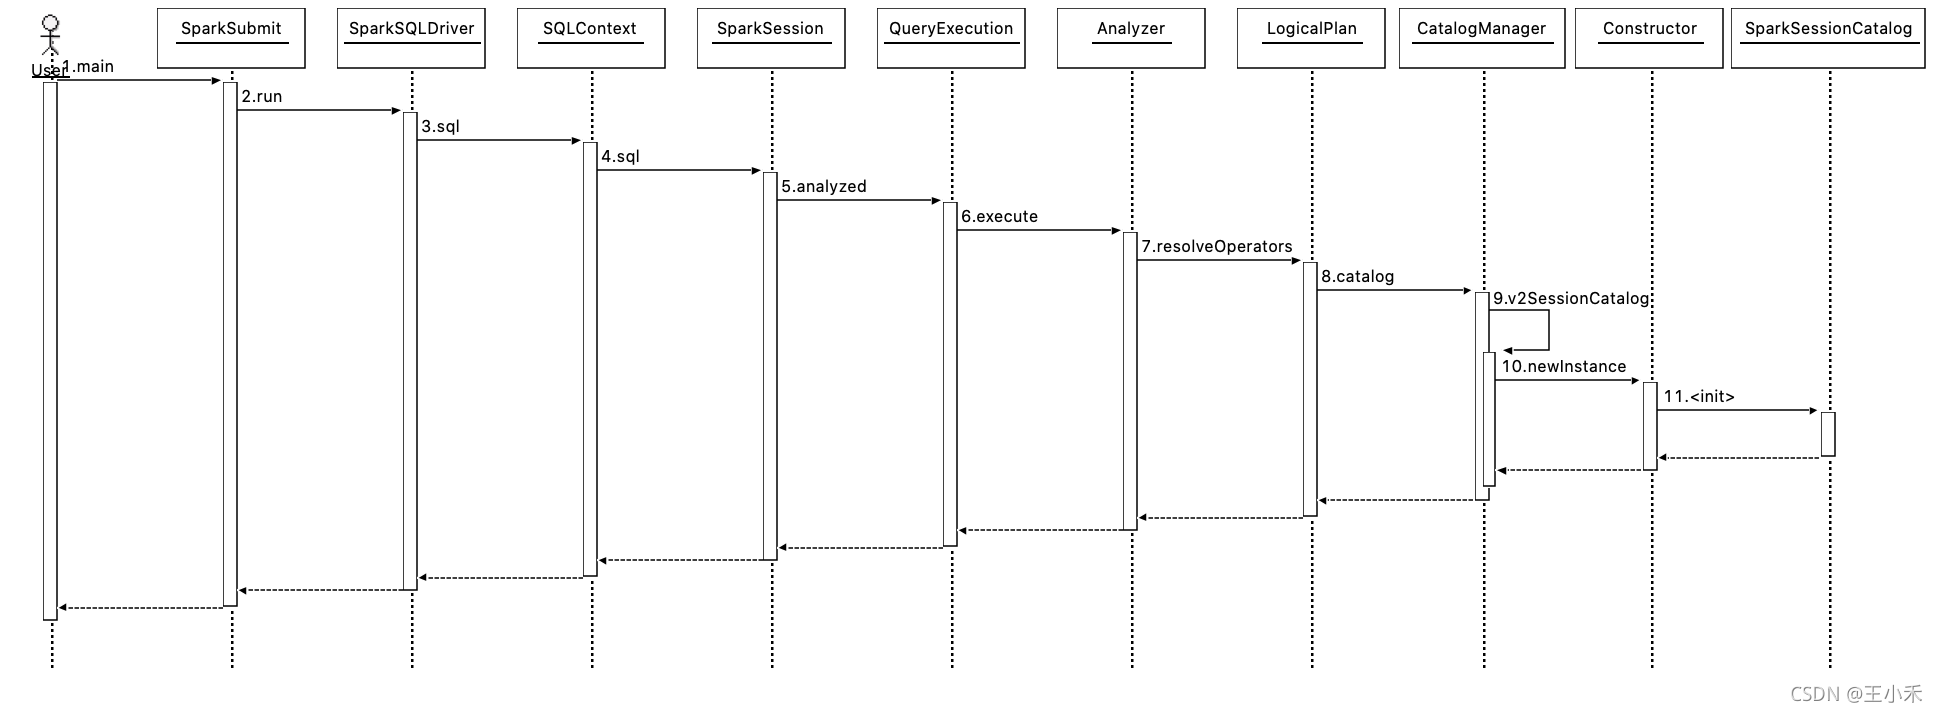
其中,spark包重要的类:
- org.apache.spark.sql.connector.catalog.CatalogManager
-
org.apache.spark.sql.connector.catalog.Catalogs
iceberg包对应的类:
- org.apache.iceberg.spark.SparkSessionCatalog
- org.apache.iceberg.spark.SparkCatalog

# CatalogManager

def catalog(name: String): CatalogPlugin = synchronized {

  if (name.equalsIgnoreCase(SESSION_CATALOG_NAME)) {

    v2SessionCatalog

  } else {

    catalogs.getOrElseUpdate(name, Catalogs.load(name, conf))

  }

}

private[sql] object CatalogManager {

  val SESSION_CATALOG_NAME: String = "spark_catalog"

}


# SparkSessionCatalog

/**

 * A Spark catalog that can also load non-Iceberg tables.

 *

 * @param <T> CatalogPlugin class to avoid casting to TableCatalog and SupportsNamespaces.

 */

public class SparkSessionCatalog<T extends TableCatalog & SupportsNamespaces>

    extends BaseCatalog implements CatalogExtension {
这里 org.apache.iceberg.spark.SparkSessionCatalog 实现了 org.apache.spark.sql.connector.catalog.CatalogExtension 和 CatalogPlugin
|
|

小结:Spark包中定义了Catalog的接口,iceberg用于实现。
更多推荐


 0
 0
- 0


 已为社区贡献4条内容

所有评论(0)