
spark几种集群管理器总结(超详细)
介绍
当前支持三种集群管理器:
- Spark独立集群管理器(Standalone),一种简单的Spark集群管理器,很容易建立集群,基于Spark自己的Master-Worker集群
- Apache Mesos,一种能够运行Haoop MapReduce和服务应用的集群管理器
- Hadoop YARN,Spark可以和Hadoop集成,利用Yarn进行资源调度
如果在集群中仅有Spark程序,那么可以使用Spark独立的集群管理器。如果有其他的mapreduce程序,那么需要使用Yarn或者Mesos管理器。其中基于Yarn有两种提交模式,一种是基于Yarn的yarn-cluster模式,一种是基于Yarn的yarn-client模式。
Spark独立集群模式
安装
要安装Spark Standalone模式,只需将Spark的编译版本放在集群的每个节点上
启用
要使用启动脚本启动Spark独立集群,应该在Spark目录中创建一个名为conf / slaves的文件,该文件必须包含要启动Spark Worker的所有计算机的主机名,每行一个。如果conf / slaves不存在,则启动脚本默认为单台计算机(localhost),这对于测试非常适用。
另外,主节点(master)通过ssh访问每个从节点(worker)。默认情况下,ssh是并行运行的,并且需要设置无密码(使用私钥)访问权限。如果没有无密码设置,则可以设置环境变量SPARK_SSH_FOREGROUND并为每个工作线程依次提供一个密码。
设置完此文件后,可以基于Hadoop的部署脚本,使用以下Shell脚本启动或停止集群,该脚本在SPARK_HOME/sbin
sbin/start-master.sh  #在执行脚本的计算机上启动主节点。
sbin/start-slaves.sh  #在conf/slaves文件中指定的每台计算机上都启动从节点。
sbin/start-slave.sh  #在执行脚本所在的计算机上启动从节点。
sbin/start-all.sh  #同时启动主节点和从节点。
sbin/stop-master.sh  #停止通过sbin/start-master.sh脚本启动的主节点。
sbin/stop-slave.sh  #停止所有执行脚本所在的计算机上的从节点。
sbin/stop-slaves.sh  #停止所有conf/slaves文件中指定计算机上的从节点。
sbin/stop-all.sh  #停止主节点和从节点。
使用
如果要使用独立的集群管理器仅需要在提交作业时指定提交的节点即可
##提交应用
bin/spark-submit --master spark://masternode:7077 yourapp

##启动spark-shell时指定master,所有运行程序都将提交到集群中。
bin/spark-shell --master spark://masternode:7077

##启动pyspark
bin/pyspark --master spark://masternode:7077
独立集群管理器主要管理cpu和内存两大资源:
- 执行器进程内存,可以通过spark-submit的–executor-memory参数来配置此项。每个应用在每个工作节点上最多拥有一个执行器进程1,因此这个设置项能够控制执行器节点占用工作节点的多少内存,默认值是1G。
- 占用核心总数的最大值,这是一个应用中所有执行器进程所占用的核心总数,默认值是无限;也就是说应用可以在集群所有可用节点上启动执行器进程。对于多用户的工作负载来说应该要求用户限制他们的用量,可以通过spark-submit的–total-executorcores参数设置这个值。
独立群集模式当前仅支持跨应用程序的简单FIFO调度程序。如果要允许多个并发用户,需要控制每个应用程序将使用的最大资源数量。默认情况下,它将获取群集中的所有内核,这种情况下一次只运行一个应用程序时才有意义。可以通过spark.cores.max在SparkConf进行设置来限制内核数量。
Apache Mesos
Apache Mesos是一个集群管理器,可为跨分布式应用程序或框架提供有效的资源隔离和共享。它位于应用程序层和操作系统之间,可以更加轻松地在大规模集群环境中更有效地部署和管理应用程序。它可以在动态共享节点池上运行许多应用程序
Apache Mesos将CPU,内存,存储和其他计算资源从机器(物理或虚拟)中抽象出来,使容错和弹性分布式系统能够轻松构建并有效运行。
总体架构
Apache Mesos由四个组件组成,分别是Mesos-master,mesos-slave,framework和executor。
Mesos-master是整个系统的核心,负责管理接入mesos的各个framework(由frameworks_manager管理)和slave(由slaves_manager管理),并将slave上的资源按照某种策略分配给framework(由独立插拔模块Allocator管理)。
Mesos-slave负责接收并执行来自mesos-master的命令、管理节点上的mesos-task,并为各个task分配资源。mesos-slave将自己的资源量发送给mesos-master,由mesos-master中的Allocator模块决定将资源分配给哪个framework,当前考虑的资源有CPU和内存两种,也就是说,mesos-slave会将CPU个数和内存量发送给mesos-master,而用户提交作业时,需要指定每个任务需要的CPU个数和内存量,这样,当任务运行时,mesos-slave会将任务放到包含固定资源的linux container中运行,以达到资源隔离的效果。很明显,master存在单点故障问题,为此,mesos采用了zookeeper解决该问题。
Framework是指外部的计算框架,如Hadoop,Mesos等,这些计算框架可通过注册的方式接入mesos,以便mesos进行统一管理和资源分配。Mesos要求可接入的框架必须有一个调度器模块,该调度器负责框架内部的任务调度。当一个framework想要接入mesos时,需要修改自己的调度器,以便向mesos注册,并获取mesos分配给自己的资源, 这样再由自己的调度器将这些资源分配给框架中的任务,也就是说,整个mesos系统采用了双层调度框架:第一层,由mesos将资源分配给框架;第二层,框架自己的调度器将资源分配给自己内部的任务。当前Mesos支持三种语言编写的调度器,分别是C++,java和python,为了向各种调度器提供统一的接入方式,Mesos内部采用C++实现了一个MesosSchedulerDriver(调度器驱动器),framework的调度器可调用该driver中的接口与Mesos-master交互,完成一系列功能(如注册,资源分配等)。
Executor主要用于启动框架内部的task。由于不同的框架,启动task的接口或者方式不同,当一个新的框架要接入mesos时,需要编写一个executor,告诉mesos如何启动该框架中的task。为了向各种框架提供统一的执行器编写方式,Mesos内部采用C++实现了一个MesosExecutorDiver(执行器驱动器),framework可通过该驱动器的相关接口告诉mesos启动task的方法。
Hadoop YARN
Yarn是hadoop自带的集群管理器,默认情况下不用手动启动。与Spark支持的其他集群管理器(其中在–master 参数中指定了主服务器的地址)不同,在YARN模式下,ResourceManager的地址是从Hadoop配置中提取的。因此,–master参数为yarn。另外Spark on YARN又分为client模式和cluster模式。
yarn-cluster模式
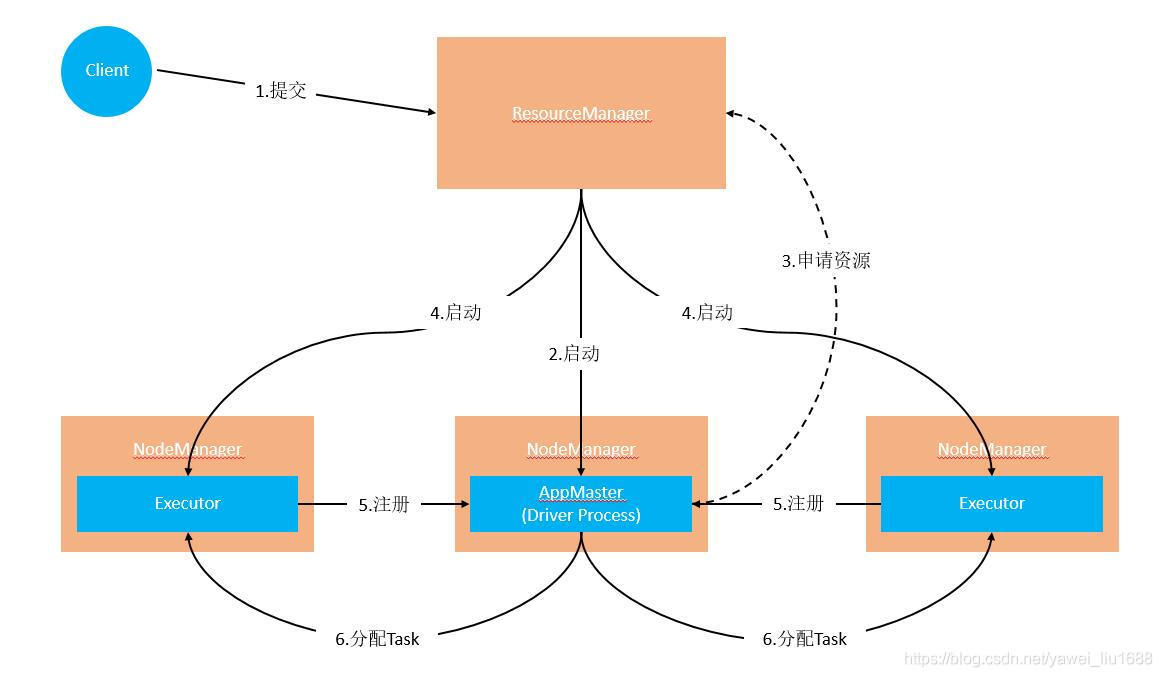
流程
- 任务提交后首先它会和ResourceManager通信,发送请求给ResourceManager,请求启动ApplicationMaster;
- ResourceManager接收到请求之后,会给它分配一个Container,然后在某个NodeManager上启动ApplicationMaster, 此时的ApplicationMaster就是Driver;
- Driver启动后会和ResourceManager通信,ApplicationMaster(AM)就相当于Master。AM找RM请求container,RM会给它分配一批Container,在合适的NodeManager上用于启动 Executor进程;
- Executor进程启动后会向AM反向注册;
- Executor全部注册完成后Driver开始执行main函数,之后执行到Action算子时,触发一个 job,并根据宽依赖开始划分stage,每个stage生成对应的taskSet,之后将task分发到各个 Executor上执行;
cluster mode
./bin/spark-submit --class org.apache.spark.examples.SparkPi \
    --master yarn \
    --deploy-mode cluster \
    --driver-memory 4g \
    --executor-memory 2g \
    --executor-cores 1 \
    --queue thequeue \
    examples/jars/spark-examples*.jar \
    10
yarn-client模式
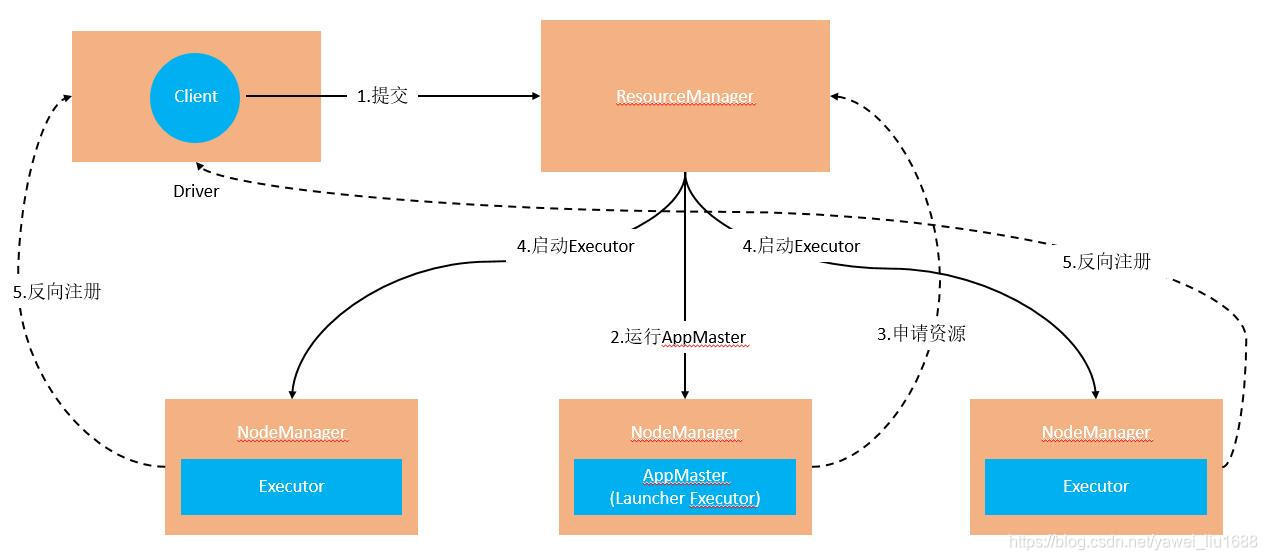
流程
- Driver在任务提交的本地机器上运行,Driver启动后会和ResourceManager通讯并发送请求给ResourceManager,请求启动ApplicationMaster;
- 随后ResourceManager分配Container,在合适的NodeManager上启动ApplicationMaster, 此时的ApplicationMaster的功能相当于一个ExecutorLaucher,只负责向ResourceManager申请Executor内存;
- ResourceManager接到ApplicationMaster的资源申请后会分配Container,然后 ApplicationMaster在资源分配指定的NodeManager上启动Executor进程;
- Executor进程启动后会向Driver反向注册,但是此时Executor并不像cluster模式那样去向AM反向注册。client模式提交的时候还是会在本地启动Driver进程,在NM上启动的Executor会反向注册到本地的Driver上,所以区别就在此。Executor全部注册完成后Driver开始执行main 函数;
- 之后执行到Action算子时,触发一个Job,并根据宽依赖开始划分Stage,每个Stage生成对应的TaskSet,之后将Task分发到各个Executor上执行。
client mode
./bin/spark-submit --class org.apache.spark.examples.SparkPi \
    --master yarn \
    --deploy-mode client \
    --driver-memory 4g \
    --executor-memory 2g \
    --executor-cores 1 \
    --queue thequeue \
    examples/jars/spark-examples*.jar \
    10
对比
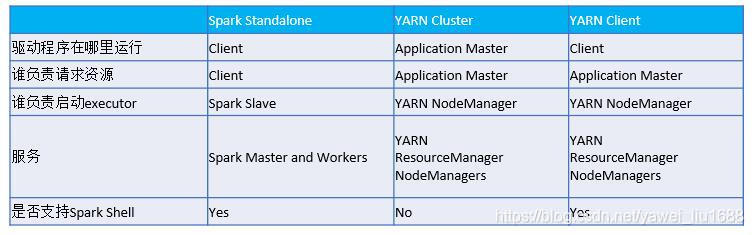
对比这两种模式,最关键的是Spark Application运行时Driver所在的节点不同,yarn-cluster的Driver相当于在NodeManager上的ApplicationMaster,yarn-client提交模式还是在本地启动Driver进程,在NodeManager上启动的ApplicationMaster其实只是一个ExecutorLauncher,它只会向ResourceManager申请container资源,然后用container资源去连接其他NM,然后去启动Executor,Executor启动之后会反向注册到本地Driver客户端
- yarn-client用于学习及测试,开发不用,因为driver运行在本地客户端,负责调度application,会与yarn集群产生大量的网络通信,从而导致网卡流量激增。好处在于,应用程序运行结果会在客户端显示,直接执行时,本地可以看到所有的log,方便调试。
- yarn-cluster用于生产环境,因为driver运行在YARN集群NodeManager中,没有网卡流量激增的问题,缺点在于调试不方便,本地用spark-submit提交之后,看不到log,应用的运行结果也不能在客户端显示,只能通过yarn application -logs application_id 这种命令来查看,不方便。
几种集群模式的比较
参考:
Spark on Yarn两种模式剖析
YARN Client 模式与YARN Cluster 模式流程详解附图
Spark架构
Apache Mesos总体架构
更多推荐



 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)