
一篇文章带你弄懂Yolov1目标检测算法原理
一、yolov1背景
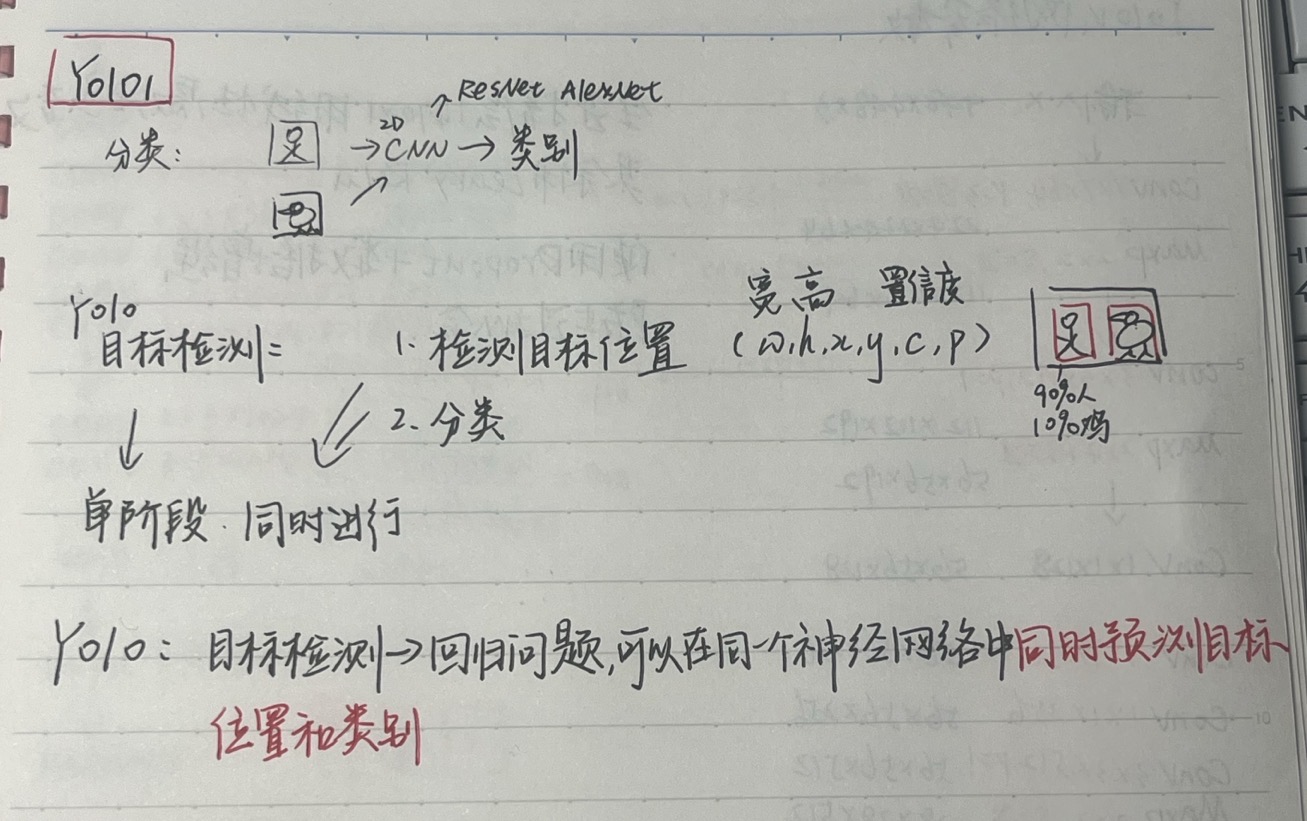
在传统的分类任务中,我们输入图像,经过CNN,输出类别
在目标检测中,我们需要进行目标位置的检测,并输出分类结果
yolo作为一个单阶段的目标检测算法,将位置的检测与分类同时进行,即同时输出x,y,w,h,c,p
同时,yolo算法将目标检测问题看成一个回归问题,可以在同一个神经网络中同时预测目标的位置和类别。
二、yolov1网络结构
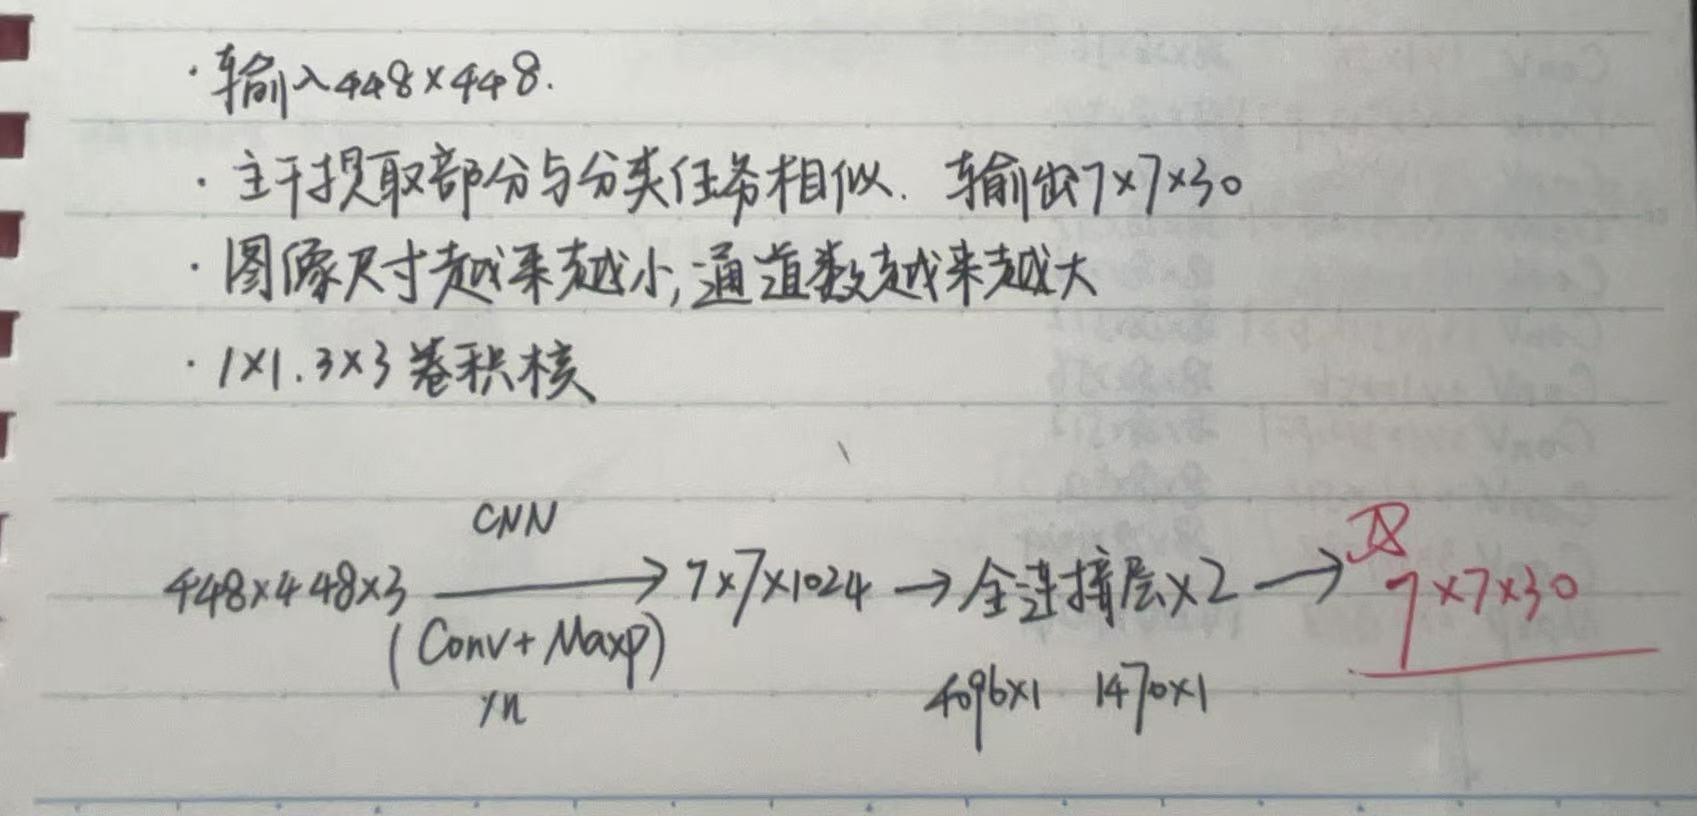
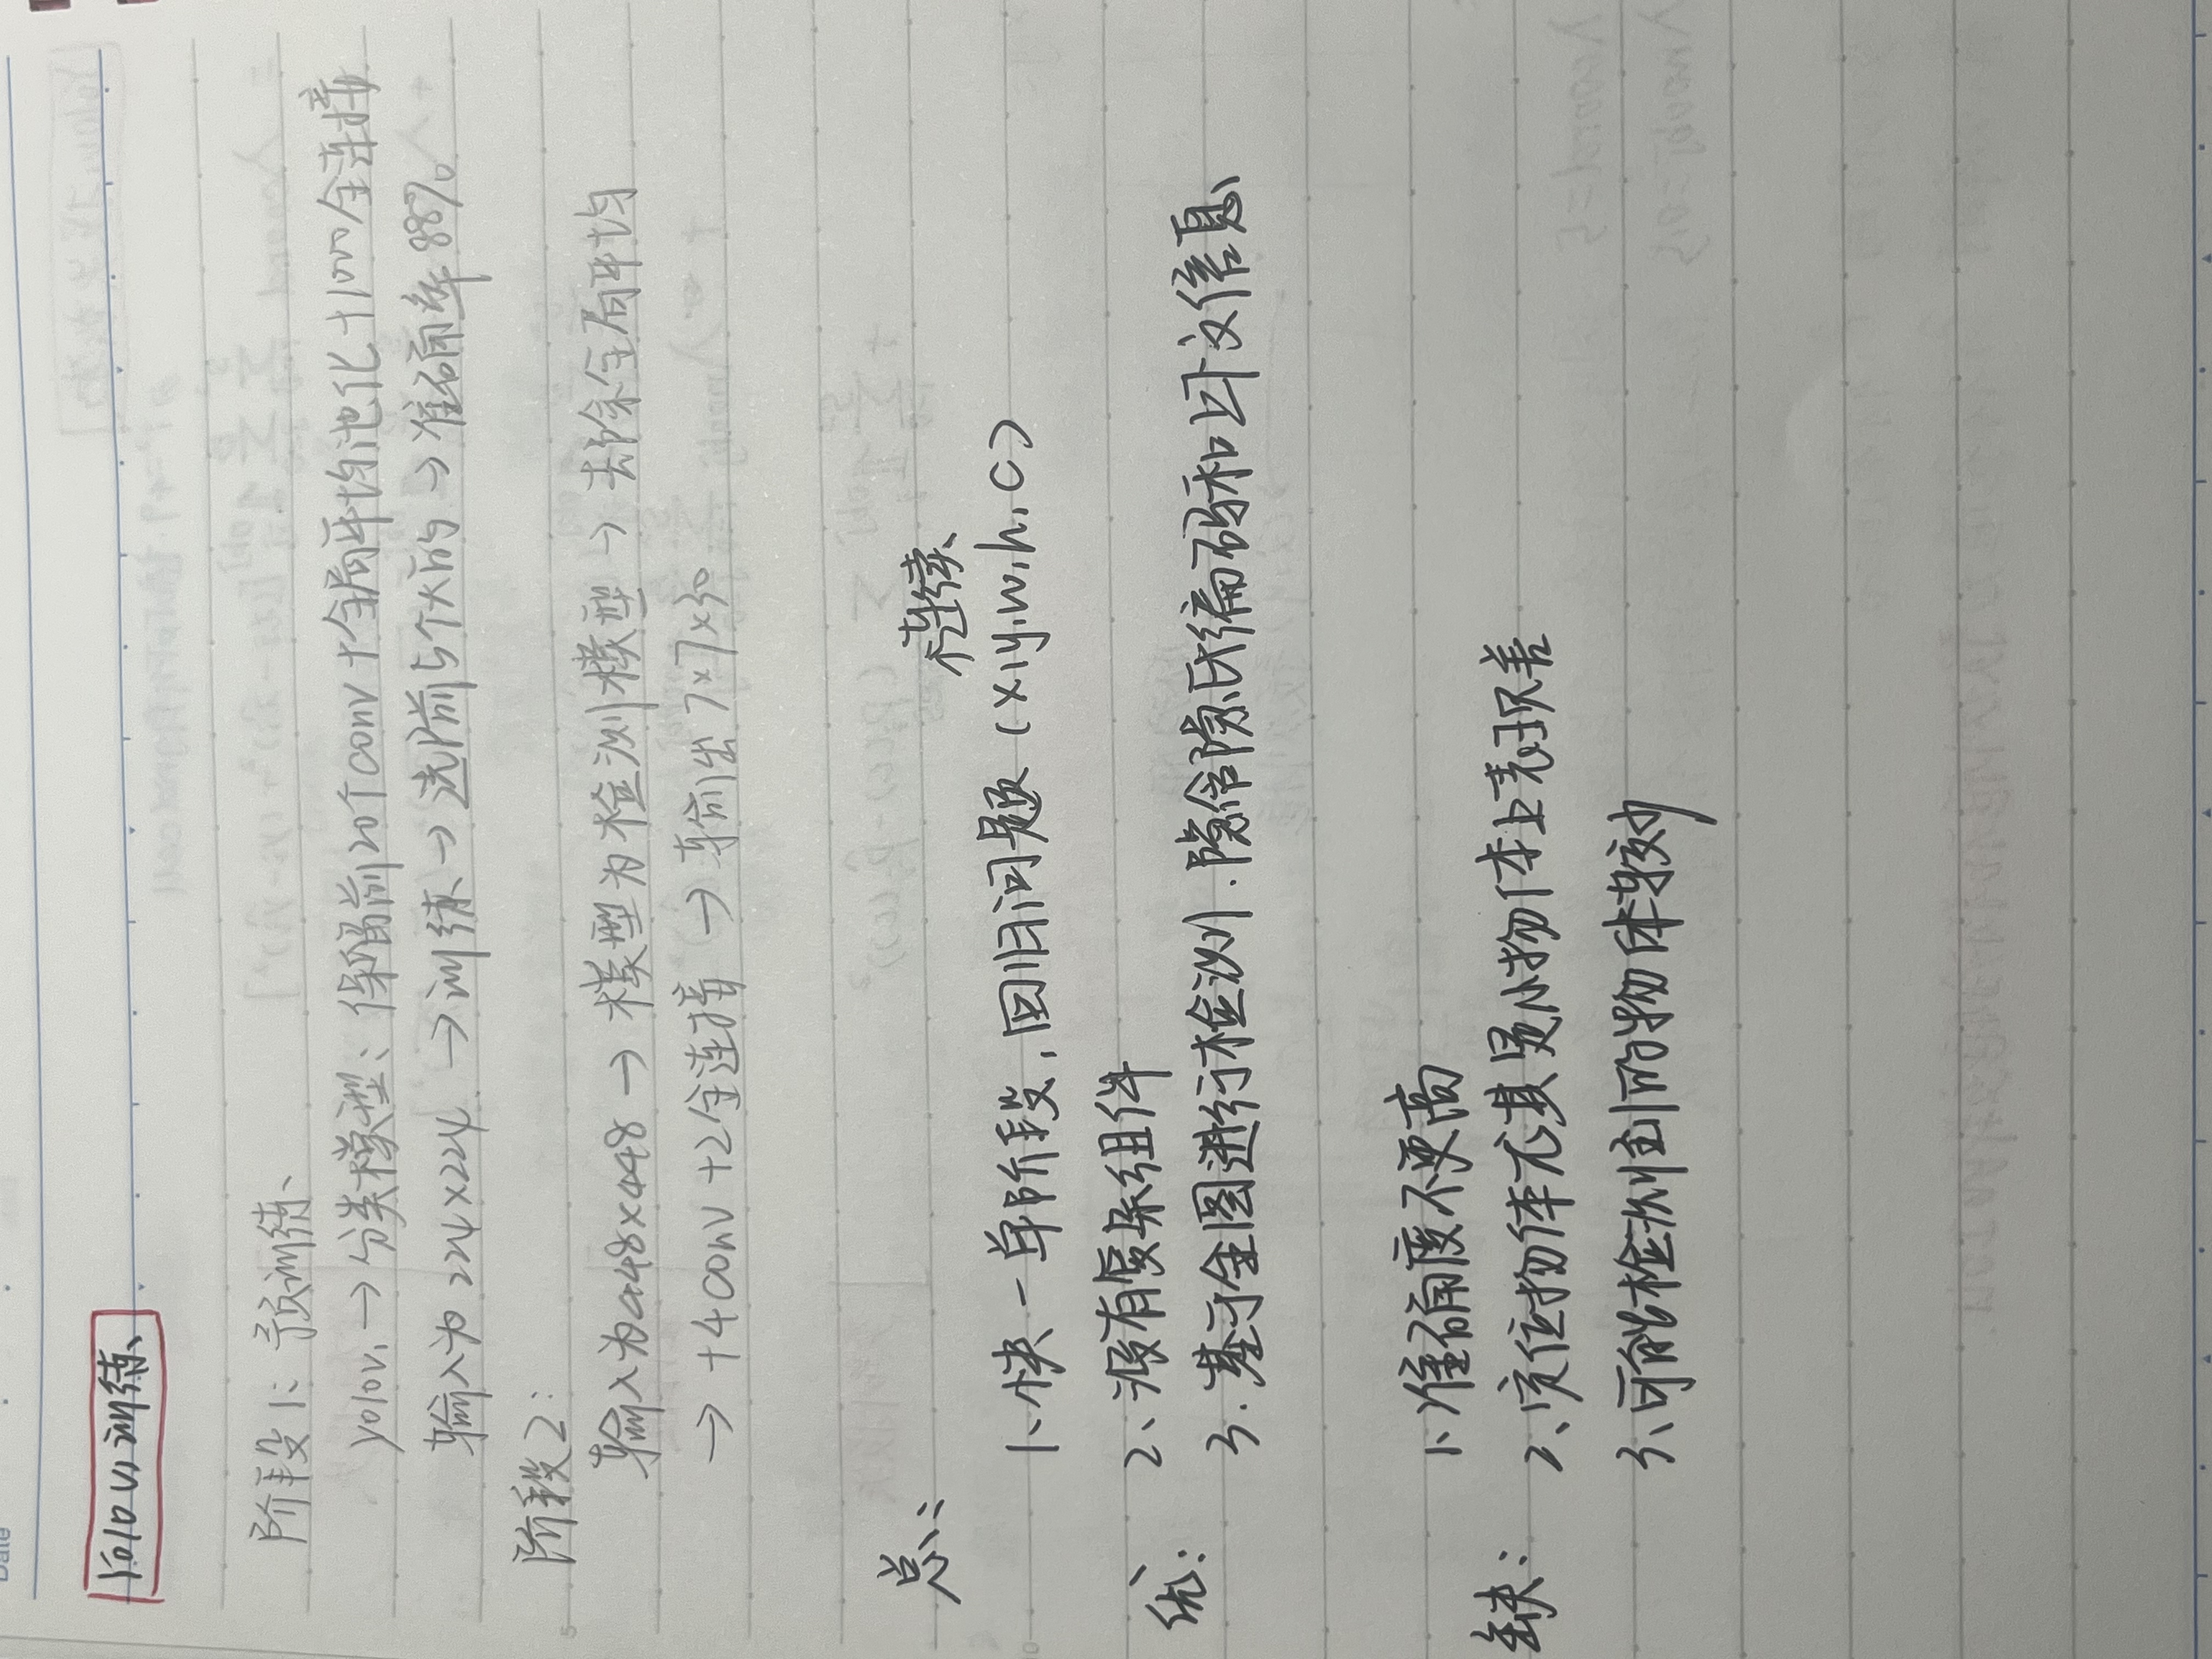
yolov1的输入图片尺寸为448*448
其中他的主干提取部分与分类任务相似,主要区别为最终输出为7*7*30
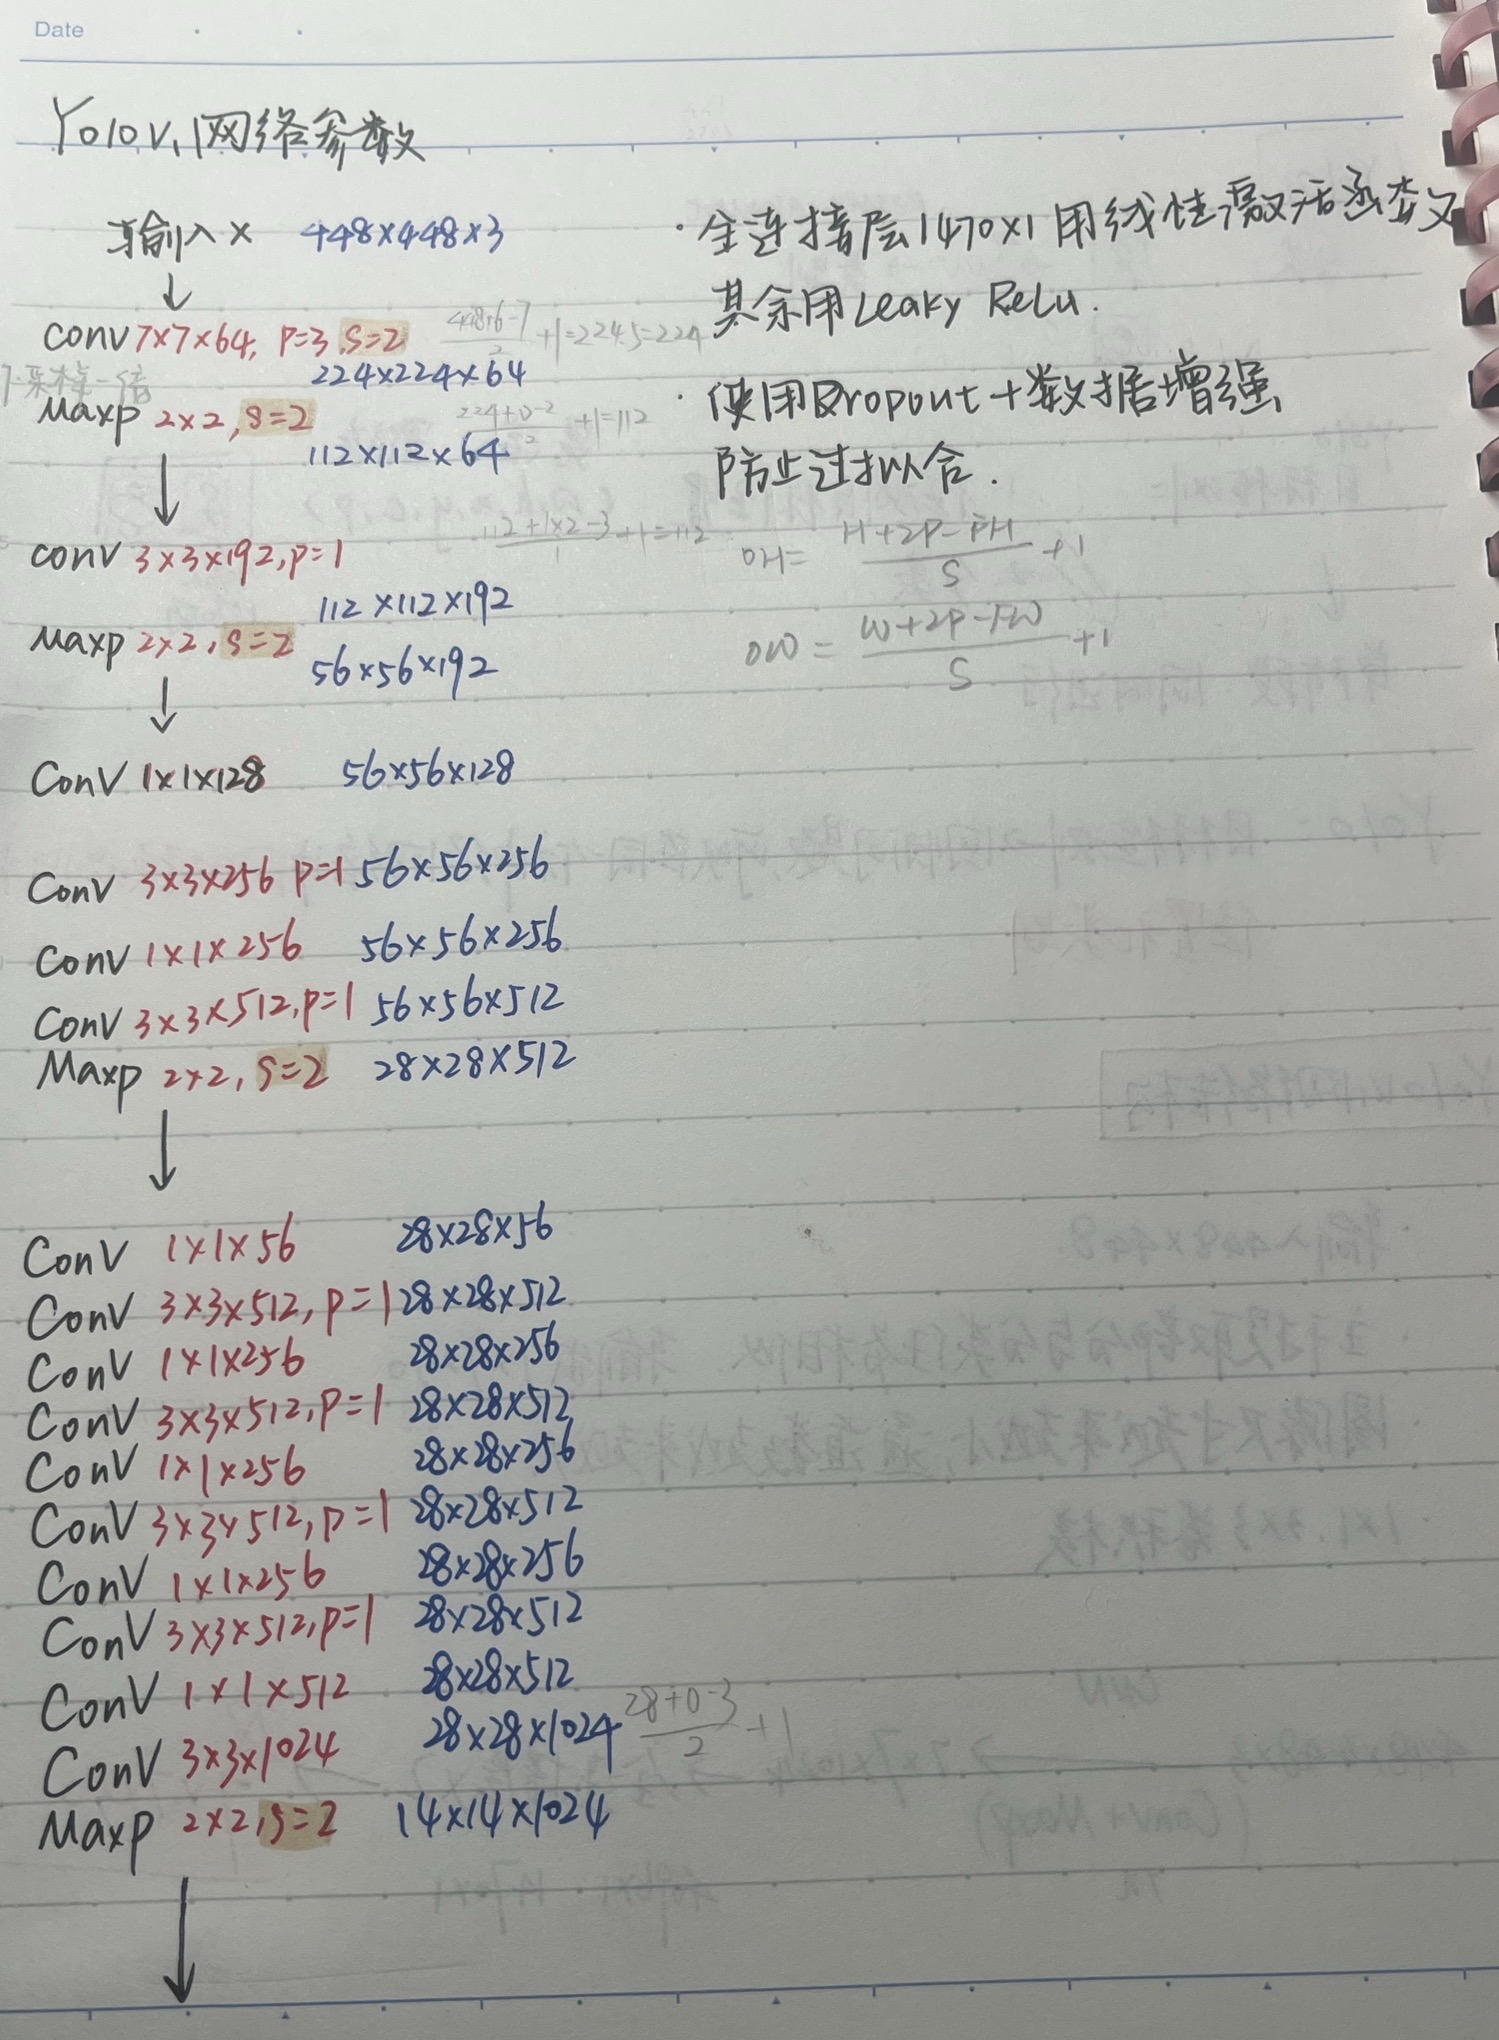
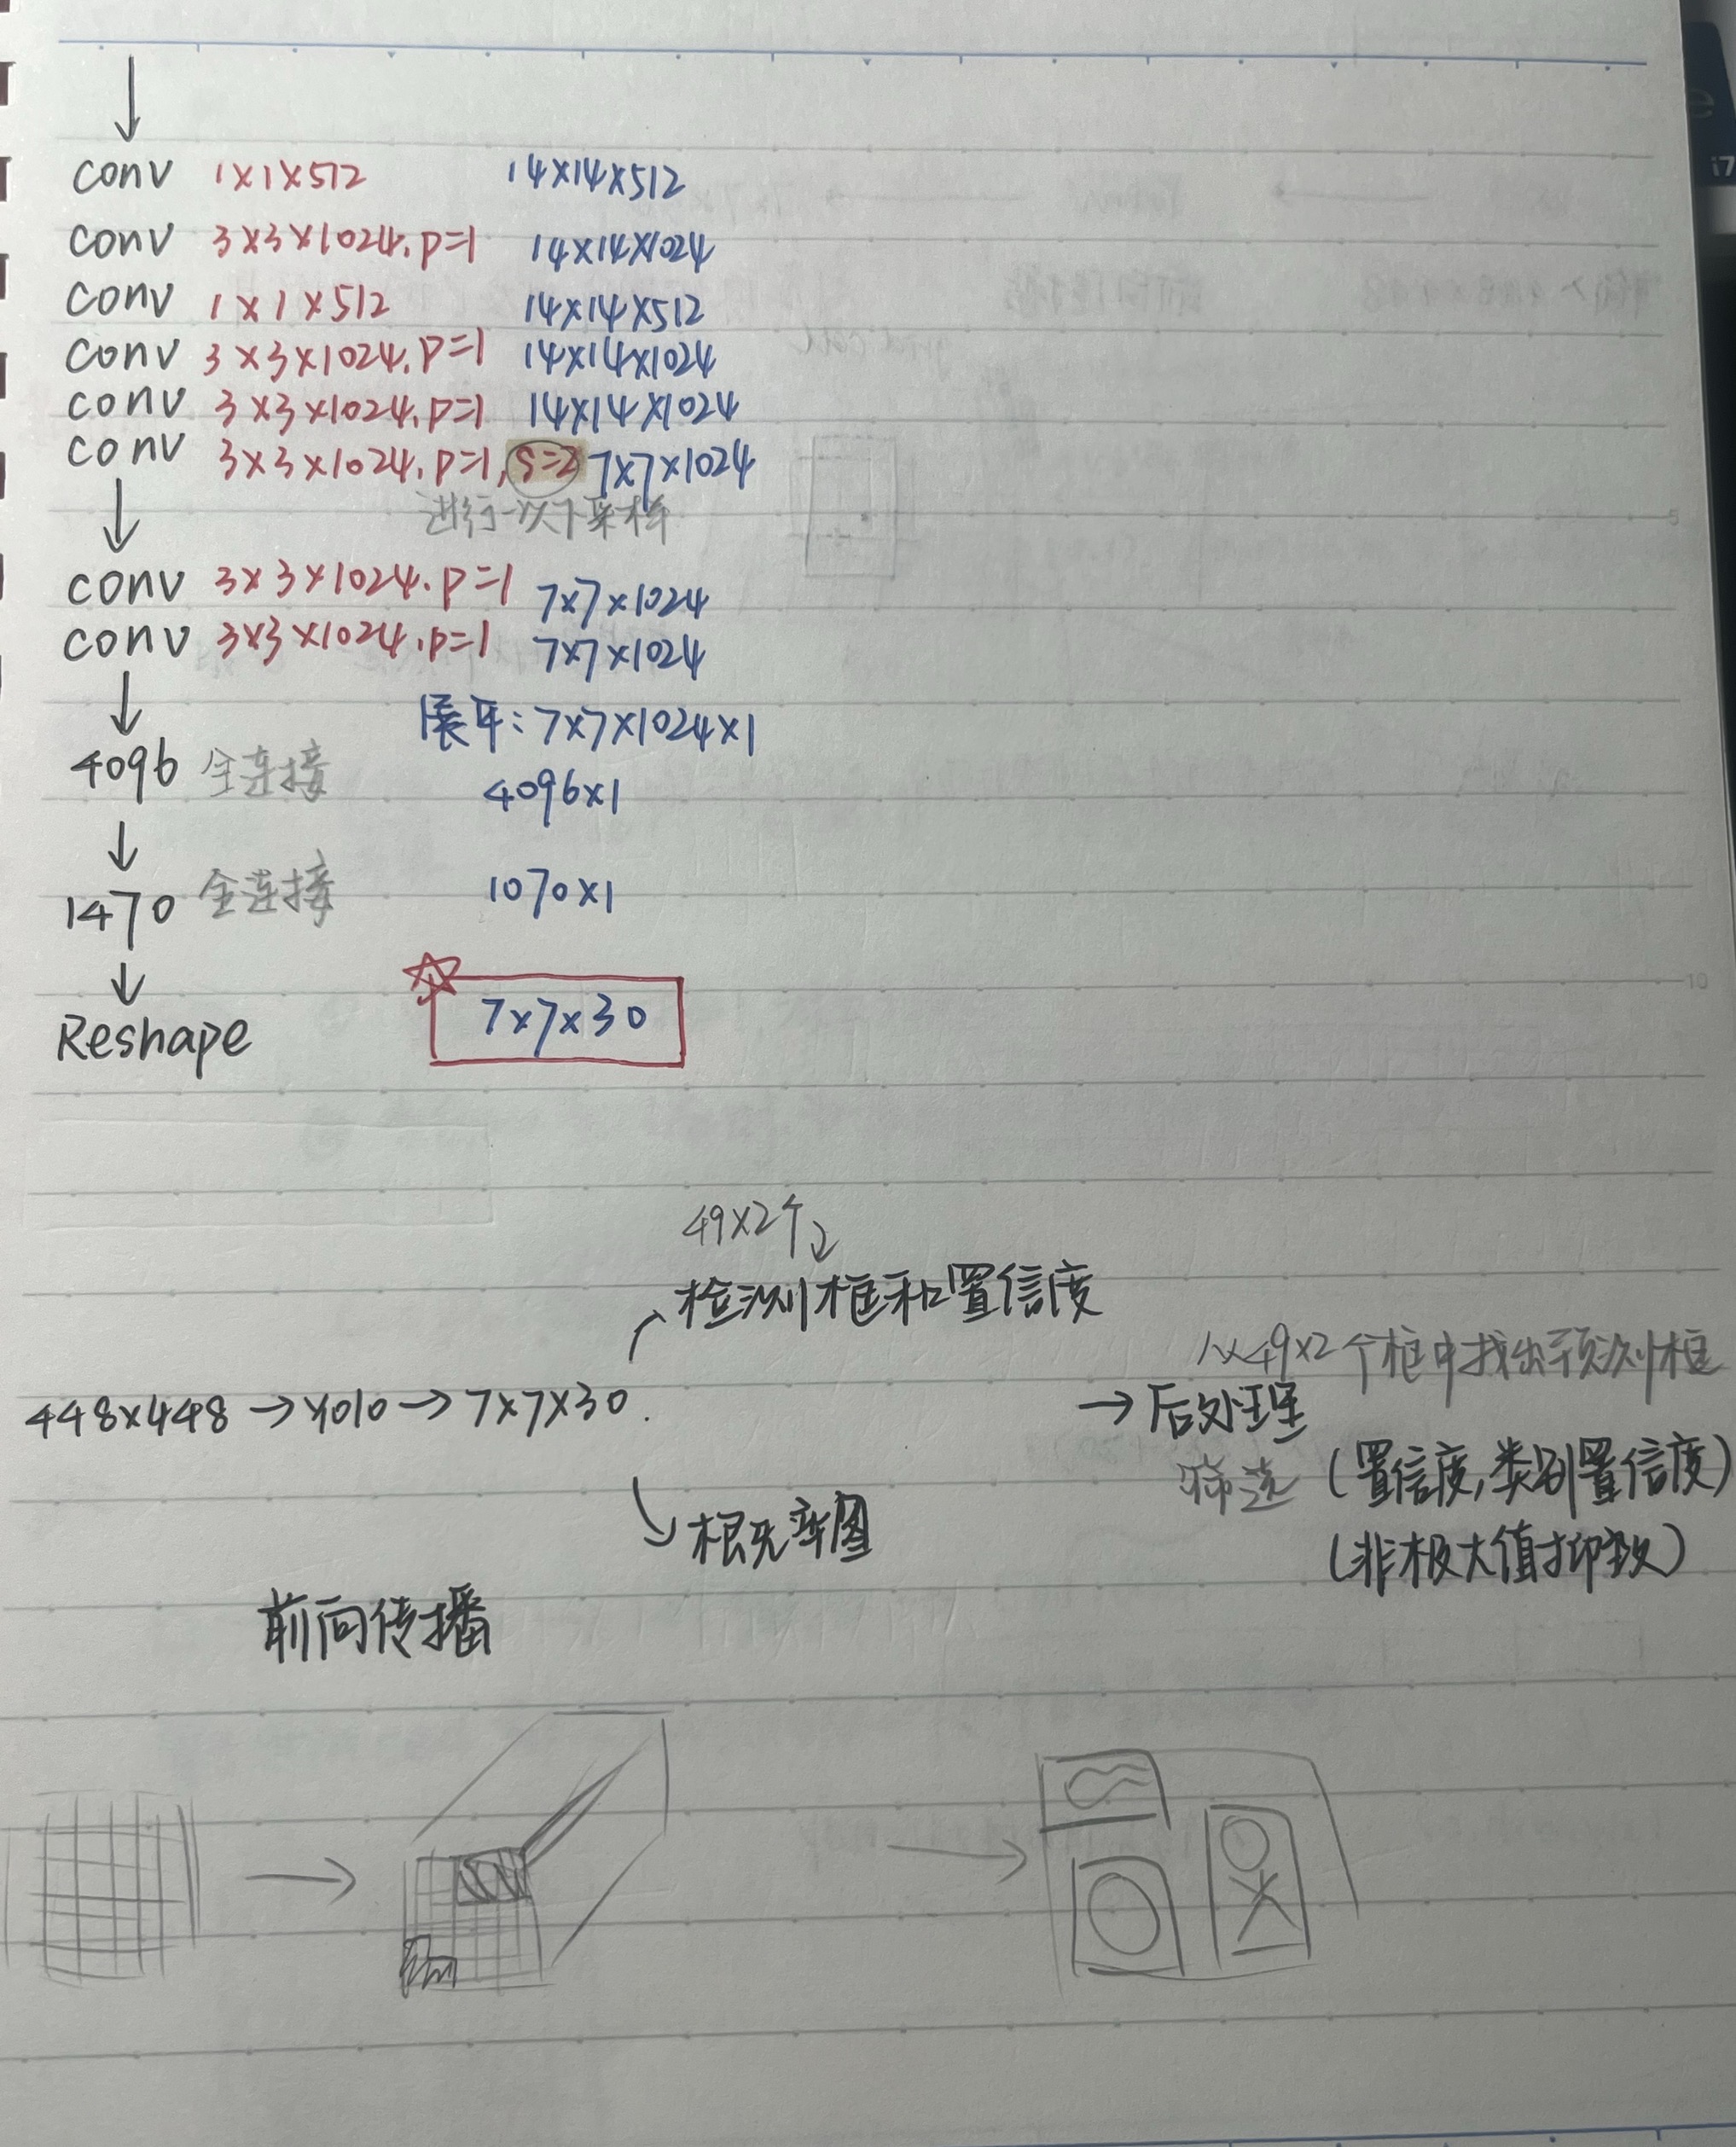
以下是yolov1的具体网络结构和参数:
三、yolov1中的reshape
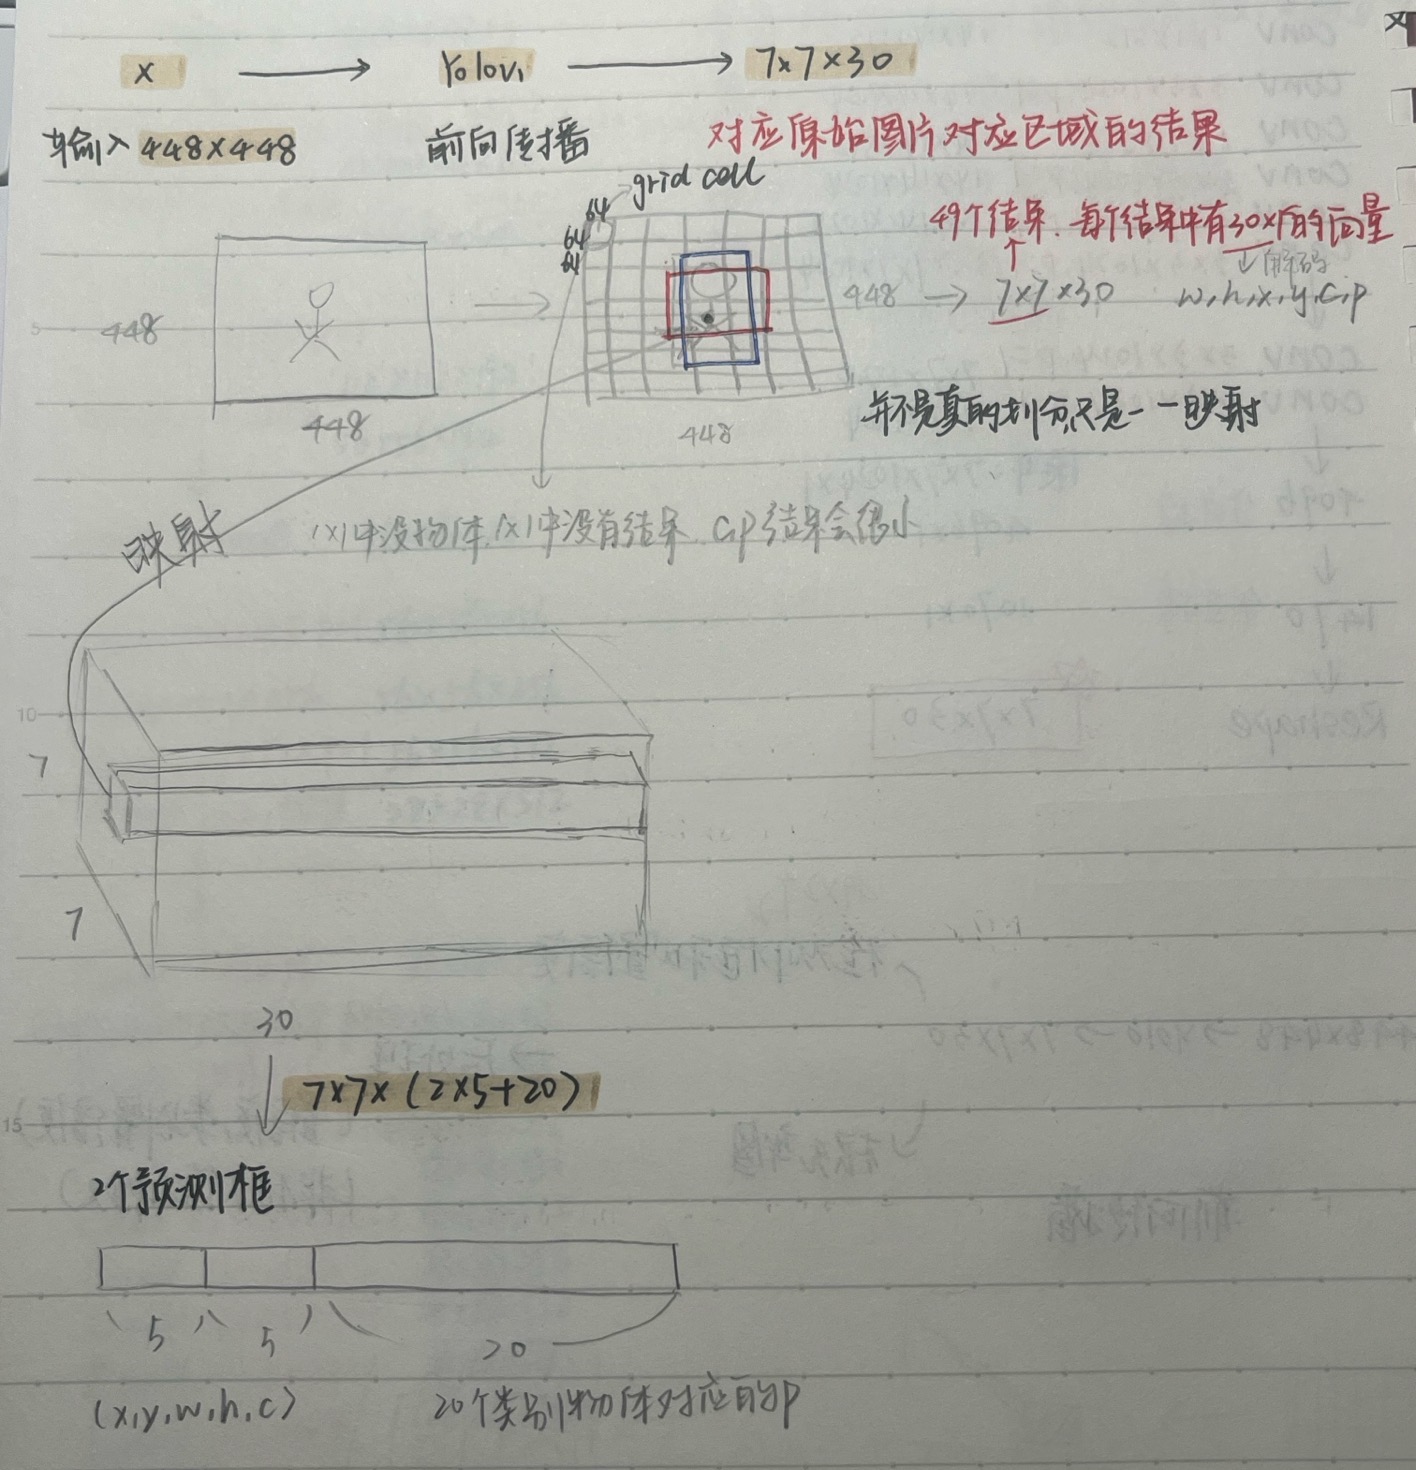
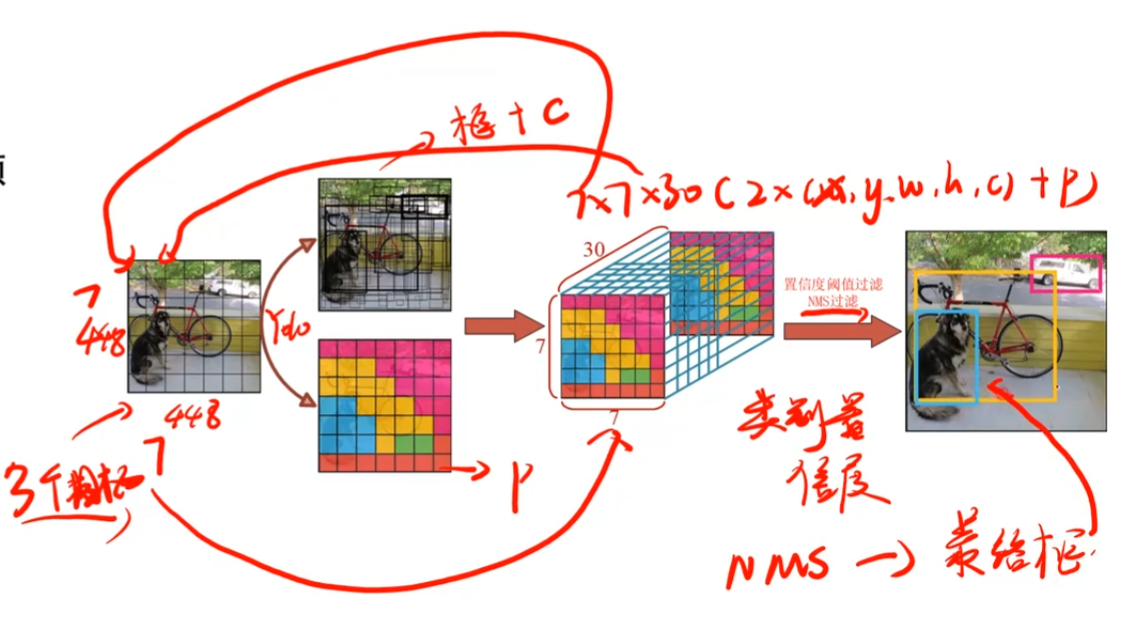
在yolov1网络中,我们输入448*448的图片,经过网络结构中的前向传播,得到最终7*7*30的输出,同时这个输出中包含我们目标检测的结果x、y、w、h、c及p。
对于7*7*30这个输出,我们有7*7=49个结果,每个结果呈现为一个30*1的向量,其中每个结果中包含两个目标预测框。
7*7与原始图片448*448属于相互对应的结果,但这并不是真正的将原始图片进行划分分区域进行特征提取,7*7中的每一块方格为一个grid cell,一一映射至原输入图像。
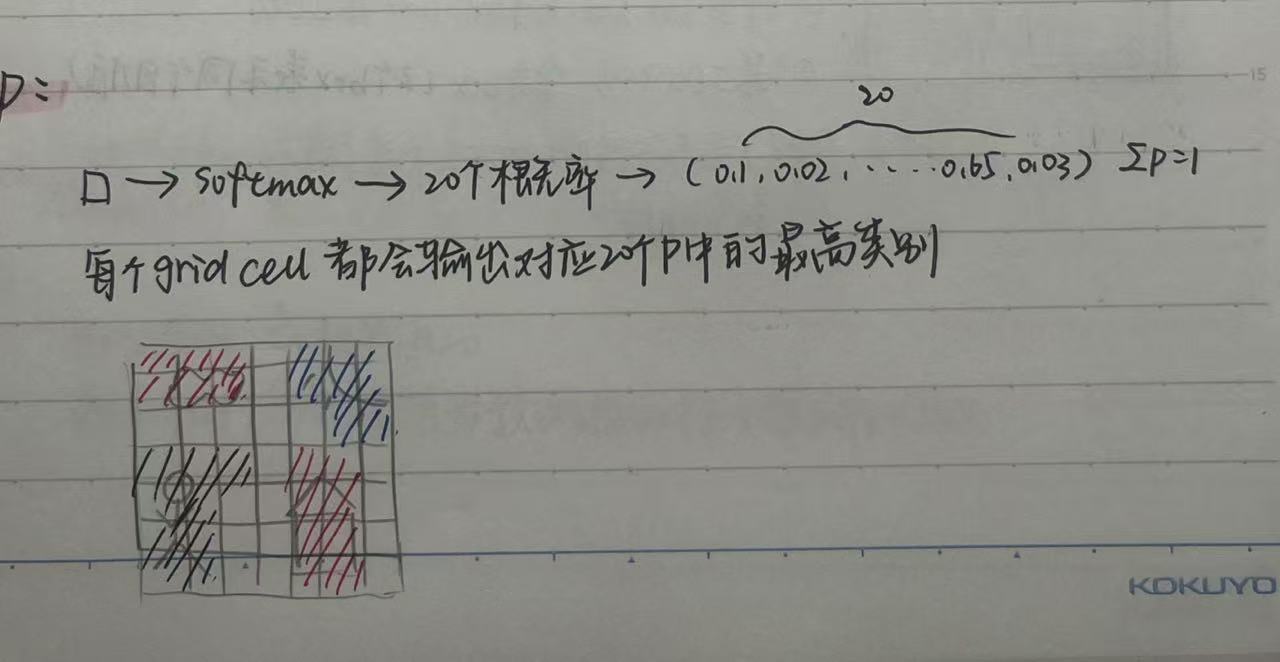
在一个grid cell中,我没有一个1*30的向量,实则为1*(2*5+20)的向量,2*5中包含了两个预测框的参数,20即为输出20个类别物体对应的概率(v1中设置为20)
四、Reshape中的参数详解
(一)x、y、w、h
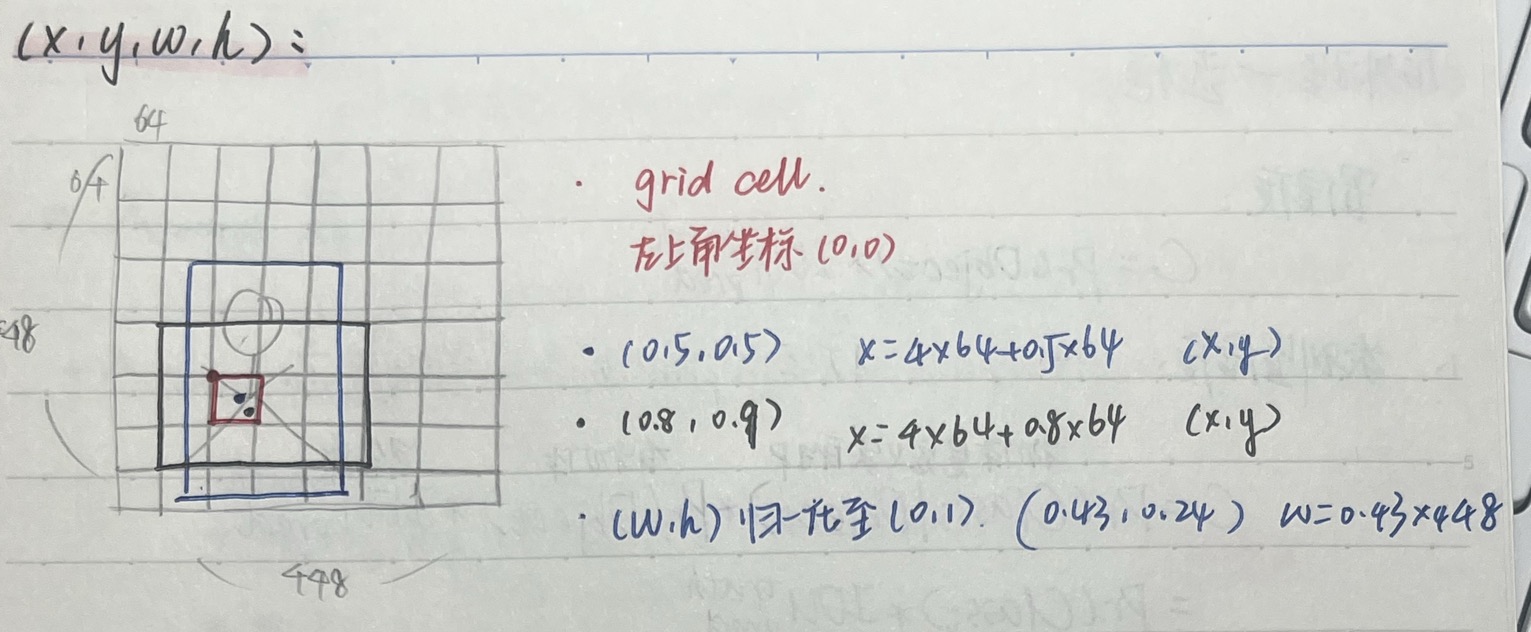
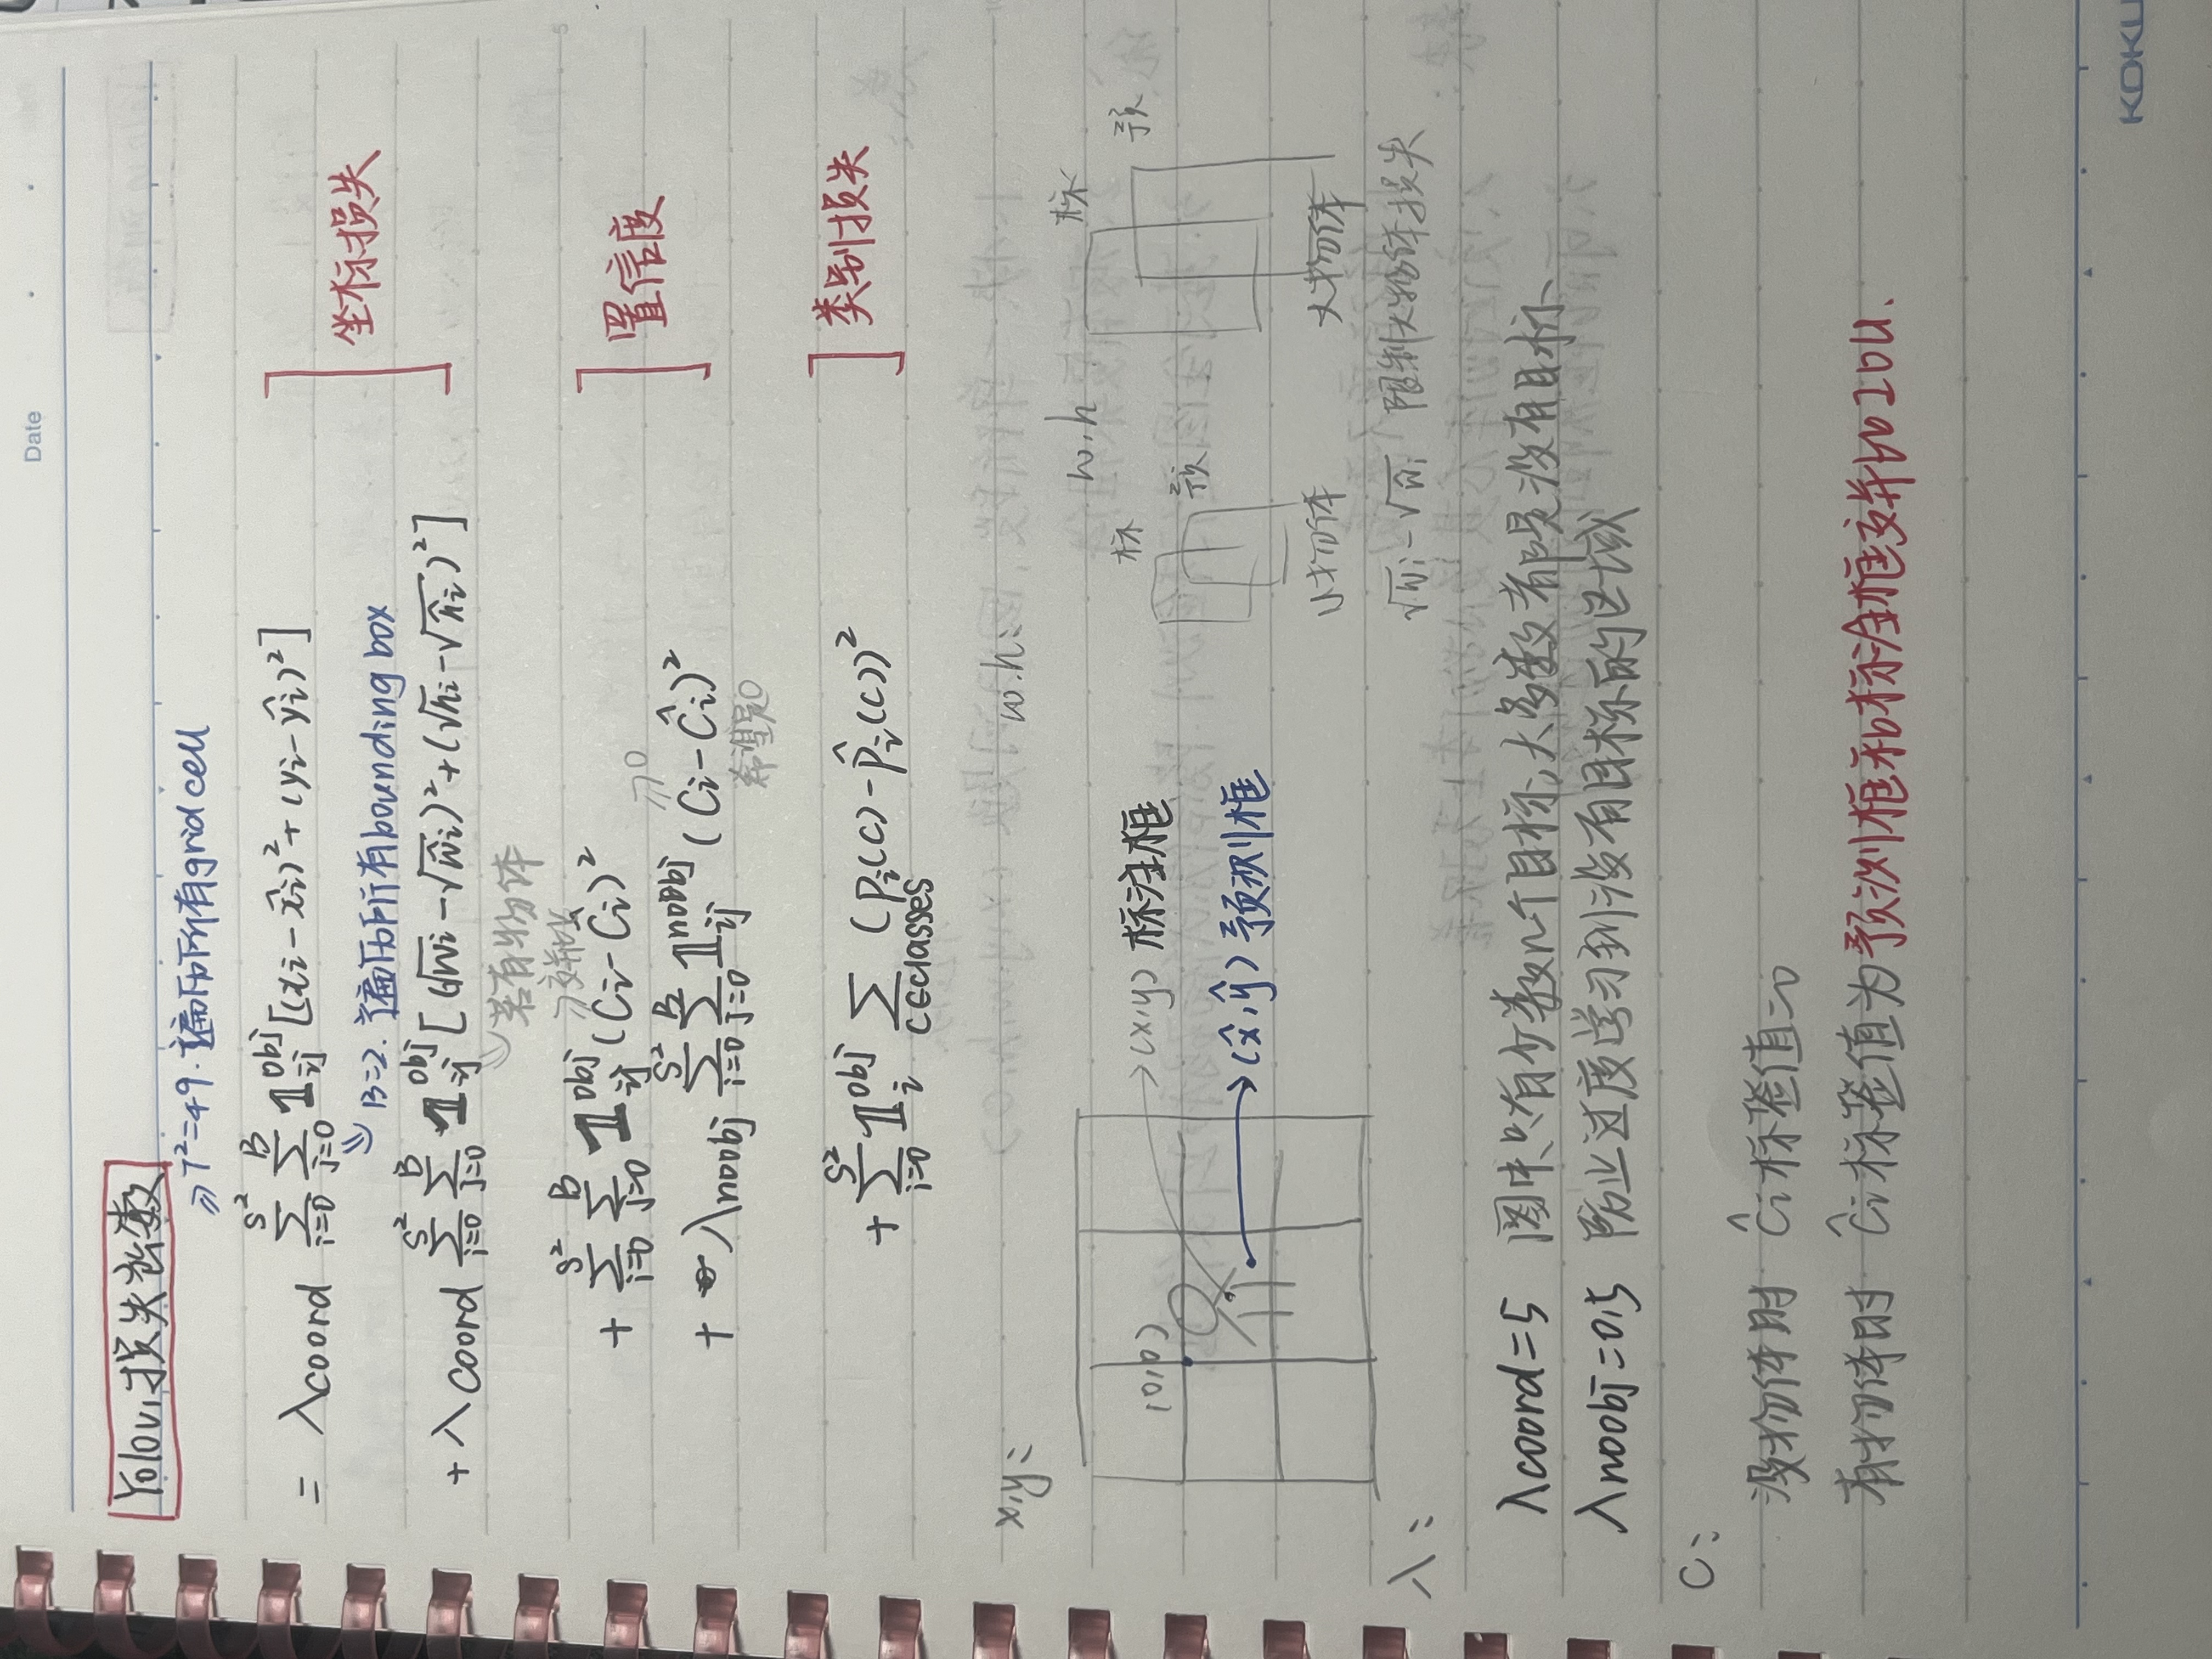
在检测到物体的grid cell中,预测狂有蓝色与黑色两个,grid cell左上角定为(0,0)坐标
蓝色预测框中心为(0.5,0.5),则可以计算出蓝色框中点的x与y
w与h相同,在yolo算法中,w与h被归一化至0-1区间,因此对其乘以原图像尺寸448为目标值
(二) c
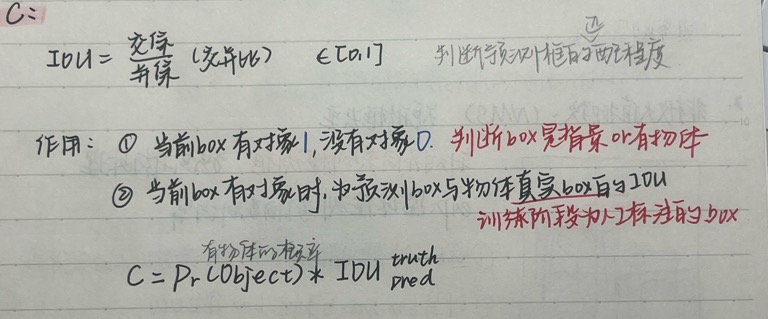
我们引入置信度来判断预测框与真实值的匹配程度
因此我们利用交并比IOU表示匹配程度
(三)p
五、后处理
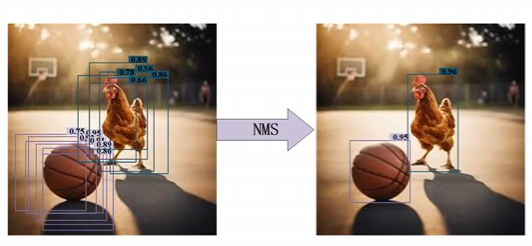
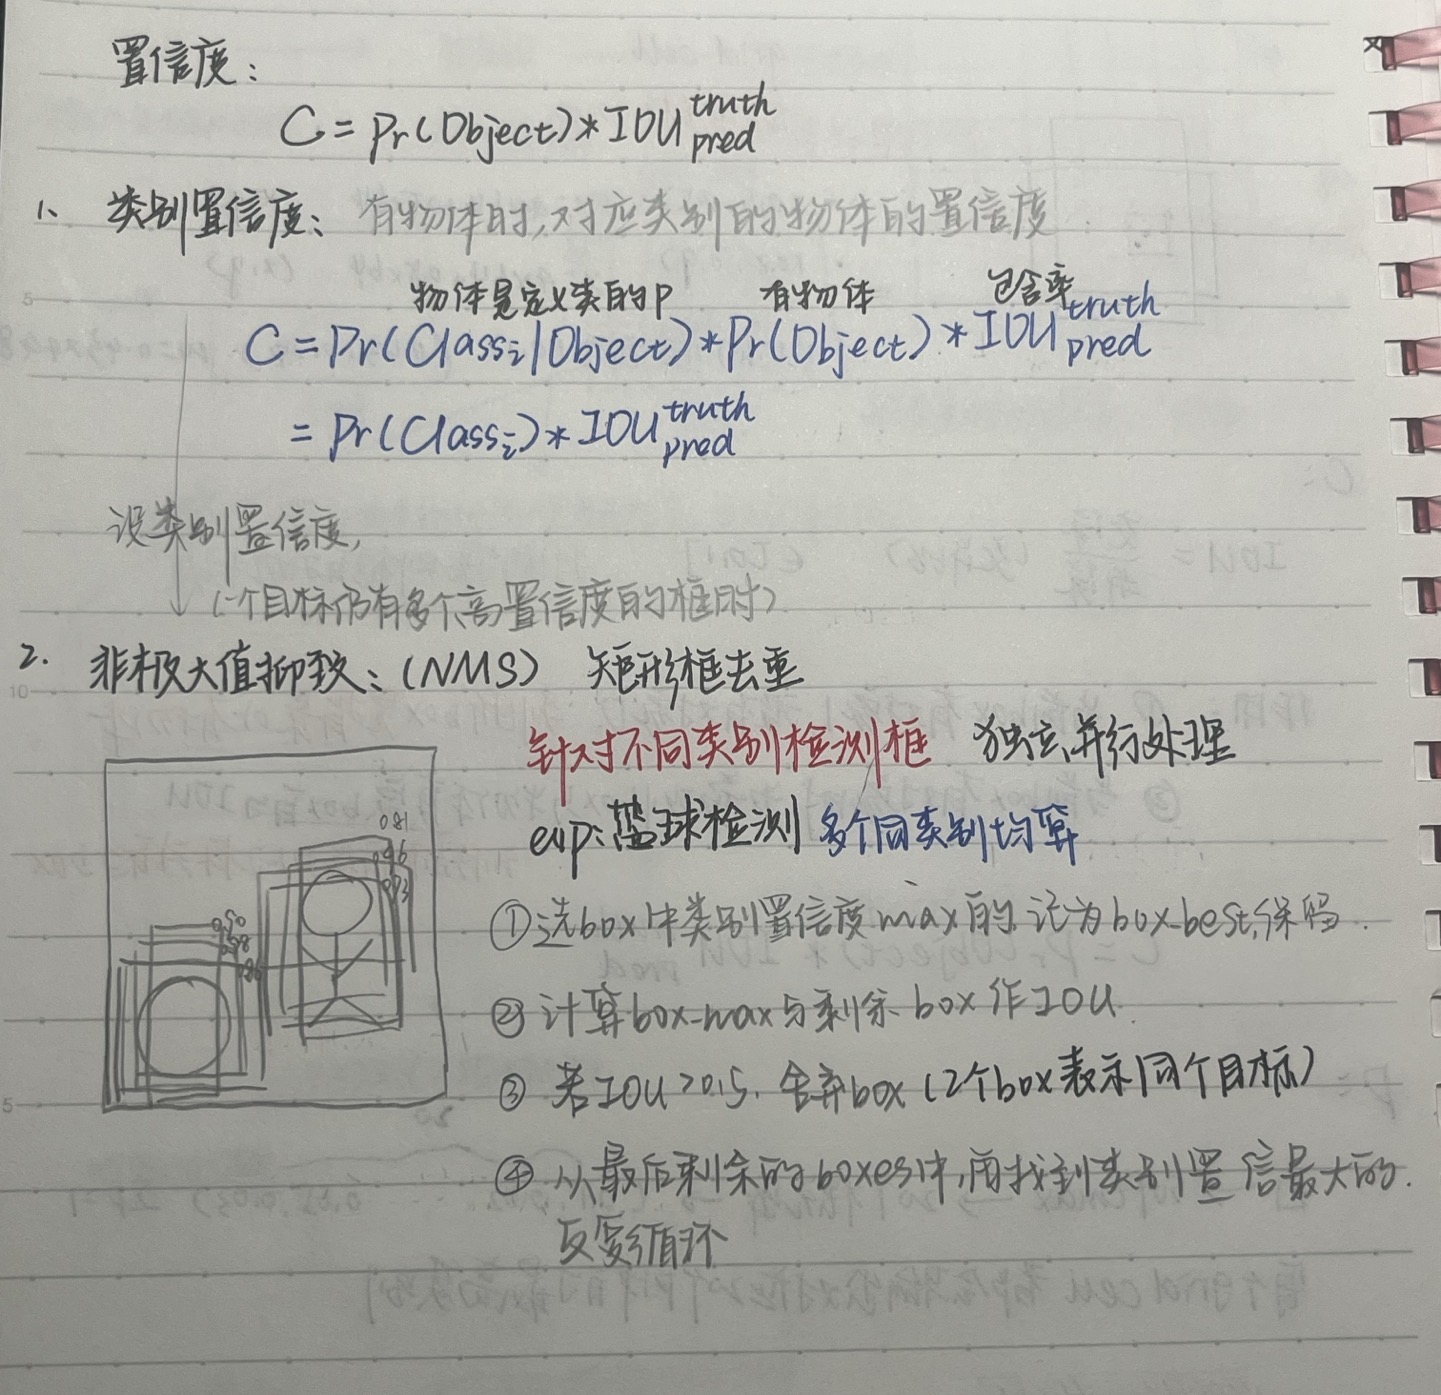
在yolo目标检测输出预测框之后,我们输出了7*7*2=98个预测框,因此我们需要对这些box进行进一步的筛选。下面用到了类别置信度和非极大值抑制NMS的方法
六、yolov1损失函数
七、yolov1训练
八、总结
更多推荐

 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)