
【多目标优化】多目标Alpha进化算法
1.Alpha进化算法原理
Alpha算子
通过定义候选解集合为候选矩阵𝐗,并从中抽取一个子集作为进化矩阵𝐄,研究描述了候选解的进化过程。这一过程不是直接对每个解进行进化,而是通过带替换的抽样从候选矩阵中获取进化矩阵,进一步进行解的进化:
E
→
N
X
,
E
⊆
X
\mathbf{E}\overset{N}{\operatorname*{\operatorname*{\to}}}\mathbf{X},\mathbf{E}\subseteq\mathbf{X}
E→NX,E⊆X
对于优化算法,搜索操作符在迭代过程中的作用至关重要,因为它直接影响到算法的性能和能够发现的解决方案的质量。本研究提出的算法通过一个高效的搜索操作符——alpha操作符,区别于其他算法,它集成了提取和利用进化信息的多个步骤,这些步骤在单一操作符中同时进行:
E
i
t
+
1
=
P
+
α
Δ
r
i
+
θ
⋅
(
W
i
+
E
i
t
−
P
−
L
i
)
E_i^{t+1}=P+\alpha\Delta r_i+\theta\cdot\begin{pmatrix}W_i+E_i^t-P-L_i\end{pmatrix}
Eit+1=P+αΔri+θ⋅(Wi+Eit−P−Li)
自适应基向量在解的更新中起着至关重要的作用,因为它决定了进化起点:
P
=
{
diagonal
(
A
)
,
i
f
rand
(
0
,
1
)
<
0.5
ω
B
,
o
t
h
e
r
w
i
s
e
P=\begin{cases}\text{diagonal}\left(\mathbf{A}\right),&if\text{rand}(0,1)<0.5\\\omega\mathbf{B},&otherwise&\end{cases}
P={diagonal(A),ωB,ifrand(0,1)<0.5otherwise
ω
i
:
k
\omega_{i:k}
ωi:k为B矩阵第
i
i
i个解权重:
ω
i
:
K
=
f
(
X
i
:
K
)
∑
i
=
1
K
f
(
X
i
:
K
)
\omega_{i:K}=\frac{f(X_{i:K})}{\sum_{i=1}^Kf(X_{i:K})}
ωi:K=∑i=1Kf(Xi:K)f(Xi:K)
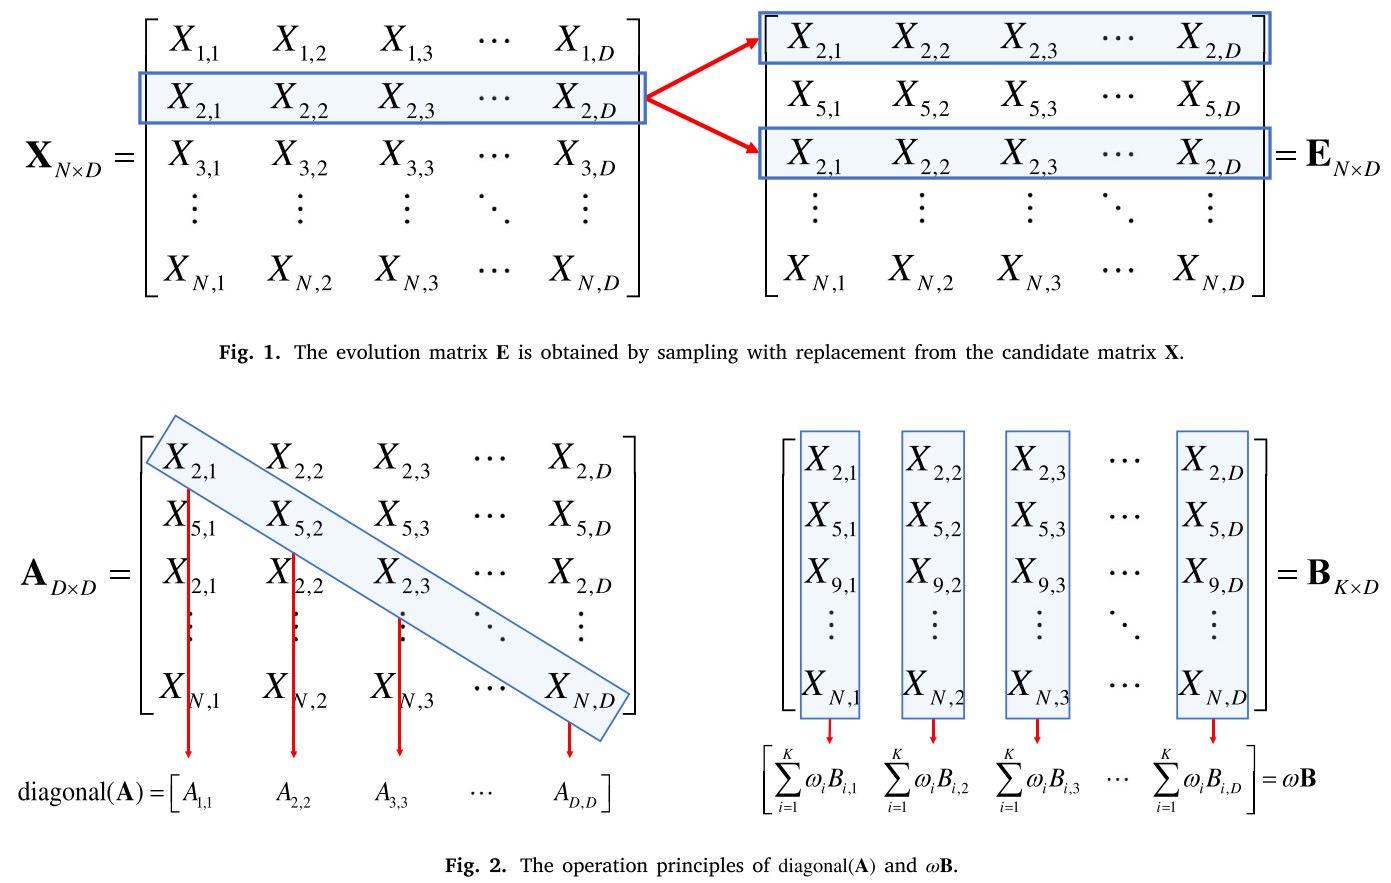
为了强化连续迭代步骤之间的关联,引入了进化路径概念,分别为
A
,
B
A,B
A,B生成的
P
P
P设立两条独立的进化路径
P
a
,
P
b
P_a,P_b
Pa,Pb:
P
=
{
c
a
P
a
t
+
(
1
−
c
a
)
×
d
i
a
g
o
n
a
l
(
A
)
=
P
a
t
+
1
,
i
f
r
a
n
d
(
0
,
1
)
<
0.5
c
b
P
b
t
+
(
1
−
c
b
)
×
ω
B
=
P
b
t
+
1
,
o
t
h
e
r
w
i
s
e
\left.P=\begin{cases}c_aP_a^t+\left(1-c_a\right)\times\mathrm{diagonal}\left(\mathbf{A}\right)=P_a^{t+1},&if \mathrm{rand}(0,1)<0.5\\ c_bP_b^t+\left(1-c_b\right)\times\omega\mathbf{B}=P_b^{t+1},&otherwise\end{cases}\right.
P={caPat+(1−ca)×diagonal(A)=Pat+1,cbPbt+(1−cb)×ωB=Pbt+1,ifrand(0,1)<0.5otherwise
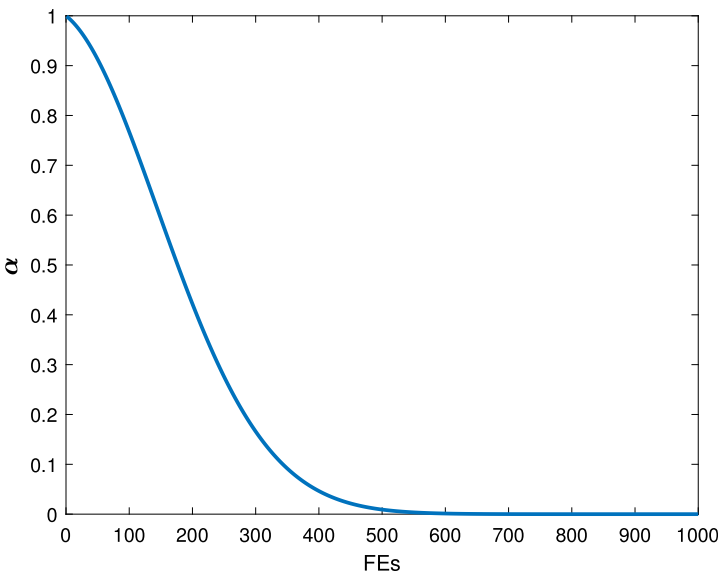
对于随机步长
α
Δ
r
i
\alpha\Delta r_i
αΔri,该组件提供了一个全局探索功能。参数表述为:
α
=
e
(
ln
(
M
a
x
F
E
s
−
F
E
s
M
a
x
F
E
s
)
−
(
4
F
E
s
M
a
x
F
E
s
)
2
)
\alpha=e^{\left(\ln\left(\frac{MaxFEs-FEs}{MaxFEs}\right)-\left(\frac{4FEs}{MaxFEs}\right)^2\right)}
α=e(ln(MaxFEsMaxFEs−FEs)−(MaxFEs4FEs)2)
Δ
r
=
(
u
b
−
l
b
)
⋅
(
2
R
1
⋅
R
2
−
R
2
)
⋅
S
\Delta\mathbf{r}=(ub-lb)\cdot\left(2\mathbf{R}_1\cdot\mathbf{R}_2-\mathbf{R}_2\right)\cdot\mathbf{S}
Δr=(ub−lb)⋅(2R1⋅R2−R2)⋅S
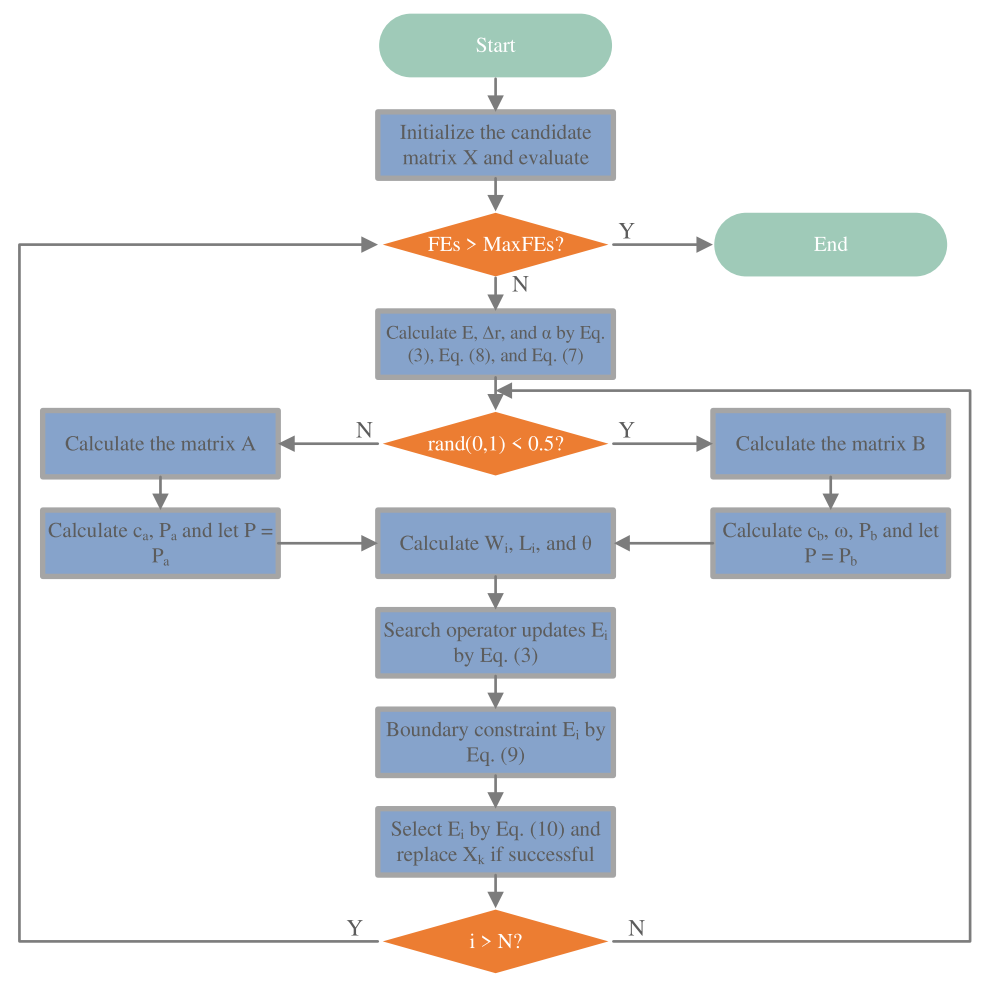
流程图
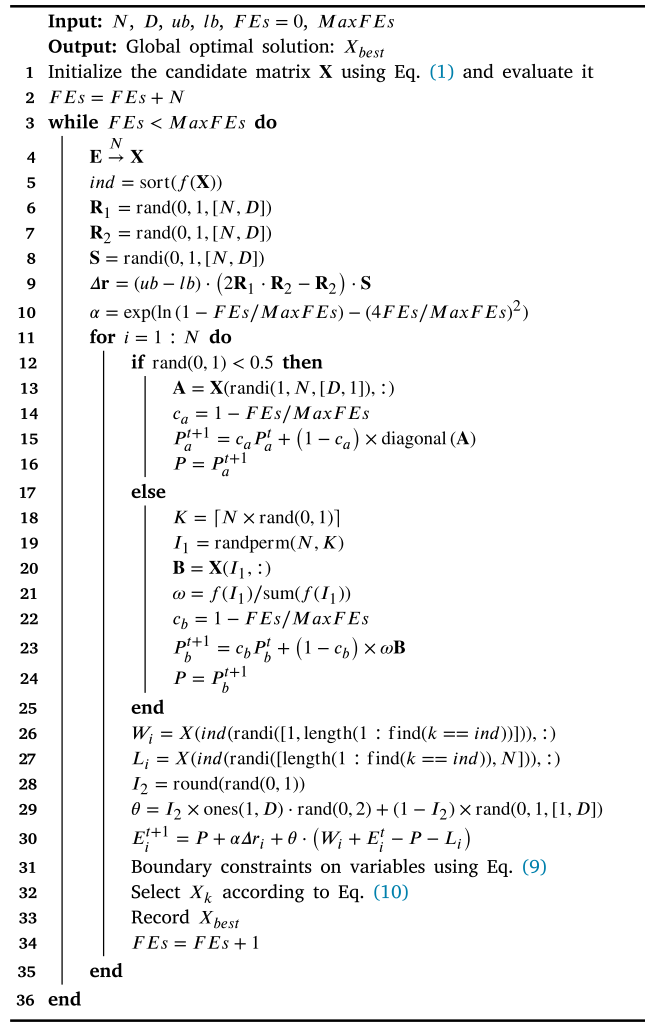
伪代码
2.NSGAII 组件
2.1 非支配排序方法
非支配排序方法通过比较种群中个体之间的支配关系,将个体分为不同的前沿层次。
a.初始化,对每个个体初始化支配集合和被支配计数;
b.计算支配关系,通过双重循环比较每对个体,更新其支配关系。如果一个个体支配另一个个体,就将其添加到支配集合中,并增加被支配计数;
c.构建第一层前沿,识遍历种群,找出被支配计数为0的个体(即不被其他任何个体支配的个体),将这些个体加入第一层前沿;
d.迭代构建后续前沿,初始化一个空的集合 Q 用于存储下一个层次的个体。对当前前沿层中的每个个体,更新其支配的个体的被支配计数。如果某个被支配个体的被支配计数减为0,则将其加入集合 Q 并赋予新的层次排名。重复此过程,直到没有更多个体可以加入新的层次;
e.终止条件,当没有新的个体可以被加入到下一个层次时,算法结束。
% 非支配排序方法
function [pop, F] = NonDominatedSorting(pop)

    % 获取种群的大小
    nPop = numel(pop);

    % 初始化每个个体的支配集合和被支配计数
    for i = 1:nPop
        pop(i).DominationSet = [];  % 支配集合初始化为空
        pop(i).DominatedCount = 0;   % 被支配计数初始化为0
    end

    F{1} = [];  % 初始化第一层前沿

    % 计算每个个体之间的支配关系
    for i = 1:nPop
        for j = i + 1:nPop
            p = pop(i);  % 当前个体p
            q = pop(j);  % 另一个体q

            if Dominates(p, q)  % 如果p支配q
                p.DominationSet = [p.DominationSet j];  % 将j加入p的支配集合
                q.DominatedCount = q.DominatedCount + 1;  % q的被支配计数加1
            end

            if Dominates(q.Cost, p.Cost)  % 如果q支配p
                q.DominationSet = [q.DominationSet i];  % 将i加入q的支配集合
                p.DominatedCount = p.DominatedCount + 1;  % p的被支配计数加1
            end

            pop(i) = p;  % 更新个体p
            pop(j) = q;  % 更新个体q
        end

        % 将不被支配的个体加入第一层前沿
        if pop(i).DominatedCount == 0
            F{1} = [F{1} i];  % 将i加入第一层前沿
            pop(i).Rank = 1;  % 赋予个体rank为1
        end
    end

    k = 1;  % 初始化前沿层次

    while true

        Q = [];  % 初始化下一个层次的集合

        % 遍历当前层次的个体
        for i = F{k}
            p = pop(i);  % 当前个体p

            % 更新其支配的个体
            for j = p.DominationSet
                q = pop(j);  % 被支配的个体q

                q.DominatedCount = q.DominatedCount - 1;  % 被支配计数减1

                % 如果q现在不被任何个体支配,加入下一个层次
                if q.DominatedCount == 0
                    Q = [Q j]; %#ok
                    q.Rank = k + 1;  % 赋予个体rank为k+1
                end

                pop(j) = q;  % 更新个体q
            end
        end

        % 如果没有更多个体加入下一个层次,结束循环
        if isempty(Q)
            break;
        end

        F{k + 1} = Q; %#ok  % 将下一个层次的个体加入前沿
        k = k + 1;  % 层次加1

    end
end
2.2 计算拥挤度
拥挤度是用于评估个体在目标空间中的“拥挤程度”,其目的是在选择过程中保持种群的多样性。在多目标优化中,拥挤度越高的个体被认为在目标空间中更具代表性,因为它们在目标值上分布得更广泛。通过计算个体在目标空间中的距离,可以有效避免选择相似的个体,从而增强解的多样性。
% 计算拥挤度
function pop = CalcCrowdingDistance(pop, F)

    % 获取前沿层的数量
    nF = numel(F);

    % 遍历每一层前沿
    for k = 1:nF

        % 获取当前前沿中个体的成本值
        Costs = [pop(F{k}).Cost];

        % 获取目标数量
        nObj = size(Costs, 1);

        % 获取当前前沿个体数量
        n = numel(F{k});

        % 初始化距离矩阵
        d = zeros(n, nObj);

        % 计算每个目标的拥挤距离
        for j = 1:nObj

            % 对成本值进行排序
            [cj, so] = sort(Costs(j, :));

            % 设定最小和最大个体的拥挤距离为无穷大
            d(so(1), j) = inf;

            % 计算中间个体的拥挤距离
            for i = 2:n-1

                d(so(i), j) = abs(cj(i + 1) - cj(i - 1)) / abs(cj(1) - cj(end));

            end

            % 设定最后一个个体的拥挤距离为无穷大
            d(so(end), j) = inf;

        end

        % 将计算的拥挤距离存储回个体中
        for i = 1:n

            pop(F{k}(i)).CrowdingDistance = sum(d(i, :));  % 汇总所有目标的拥挤距离

        end
    end
end
2.3 种群排序
NSGA-II首先将种群按拥挤距离降序排列,以保持种群的多样性;然后再按非支配排名排序,确保优先选择非支配个体。
function [pop, F] = SortPopulation(pop)
    % 按照拥挤距离降序排序种群
    [~, CDSO] = sort([pop.CrowdingDistance], 'descend');
    pop = pop(CDSO);

    % 按照排名(非支配等级)对种群进行排序
    [~, RSO] = sort([pop.Rank]);
    pop = pop(RSO);

    % 更新前沿
    Ranks = [pop.Rank];
    MaxRank = max(Ranks);
    F = cell(MaxRank, 1);
    for r = 1:MaxRank
        F{r} = find(Ranks == r); % 找到当前排名中个体的索引
    end
end
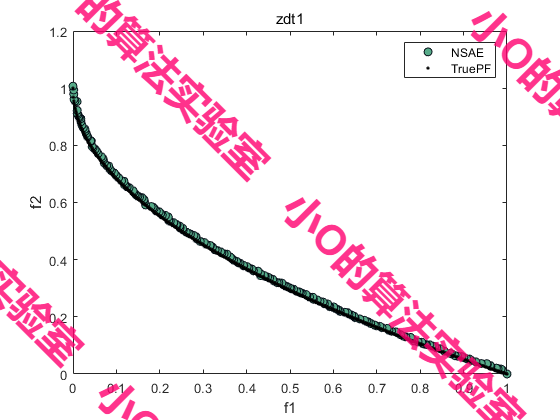
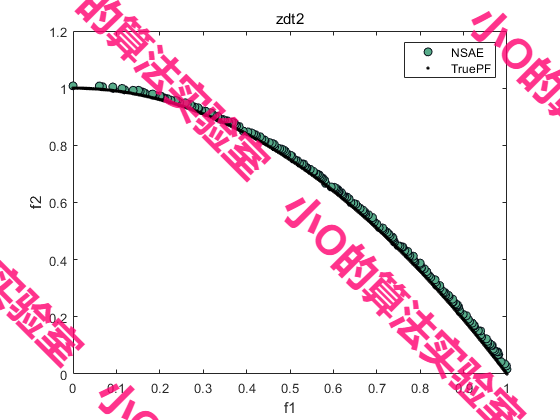
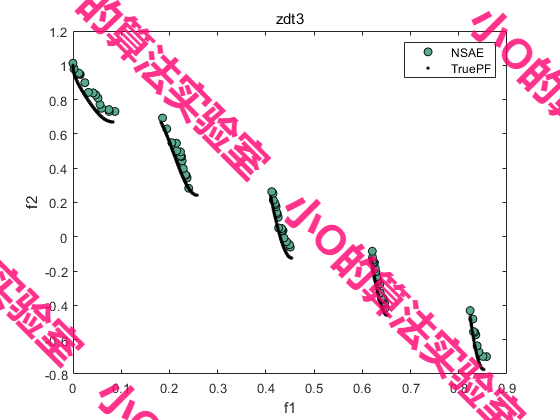
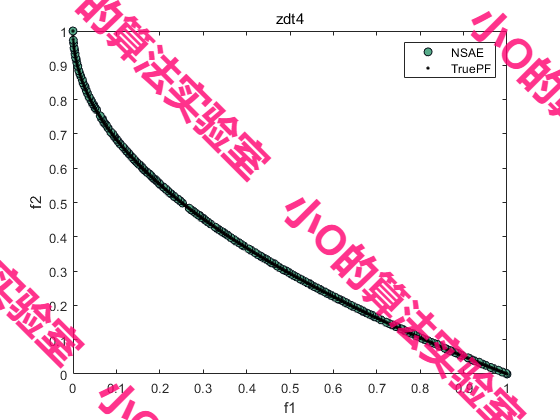
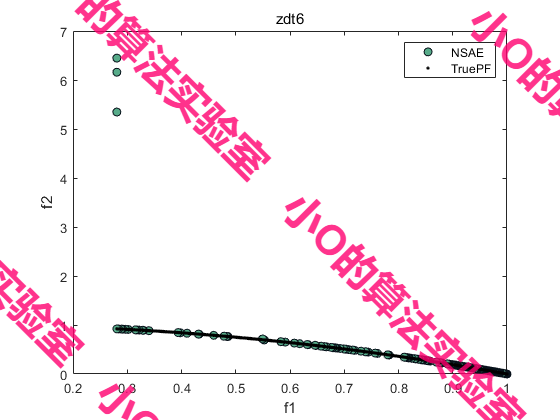
3.结果展示
4.参考文献
[1] Gao H, Zhang Q. Alpha evolution: An efficient evolutionary algorithm with evolution path adaptation and matrix generation[J]. Engineering Applications of Artificial Intelligence, 2024, 137: 109202.
[2] Deb K, Pratap A, Agarwal S, et al. A fast and elitist multiobjective genetic algorithm: NSGA-II[J]. IEEE transactions on evolutionary computation, 2002, 6(2): 182-197.
5.代码获取
更多推荐

 23
 0
- 0


 已为社区贡献15条内容

所有评论(0)