
4D成像雷达:技术方案和感知算法
1. 前言
本专栏之前的文章,介绍了传统的3D毫米波雷达,包括其信号处理的原理,以及基于点云和原始数据的感知算法。
在自动驾驶的感知系统中,相对于摄像头和激光雷达,毫米波雷达的优势在于可以全天候的工作,不受光照条件和恶劣天气的影响。因此,毫米波雷达可以提供可靠的安全冗余保障,这一点对于高阶自动驾驶系统来说非常重要。
但是,毫米波雷达的问题也很明显。传统的3D毫米波雷达,其主要的缺点在于:
-
角度分辨率非常低,尤其是高度方向,几乎没有分辨能力。
-
点云非常稀疏,提供的信息量太少,很难与别的传感器进行融合。
既然毫米波雷达的优缺点都非常明显,那么有没有方案能够取长补短呢?是的,这个答案就是本文要介绍的4D成像雷达。4D成像雷达,有的时候也被叫做4D毫米波雷达,或者简称4D雷达。
1.1 什么是4D成像雷达
在介绍更多内容之前,我们先来解释一下毫米波,4D,成像这些概念之间的关系。首先,我们这里探讨的4D成像雷达,它也是一种毫米波雷达。其次,传统的毫米波雷达只能感知3个维度(距离、速度、水平角度),因此它是一种3D雷达。当然,一些传统的毫米波雷达增加了高度方向上的天线排布,也可以在一定程度上感知高度信息,但是分辨率非常低。理论上说,只要能感知高度信息,这个雷达就可以被称为4D雷达(距离,速度、水平角度,垂直角度)。
最后,再说一下成像这个概念。传统的毫米波雷达,无论是3D还是4D,角度分辨率都比较低。一般来说,水平角度分辨率在3°到5°左右,垂直角度分辨率都大于10°。这样的雷达,其产生的点云也是非常稀疏的,完全无法描述物体的轮廓和场景的细节。成像雷达之所以叫做成像,就是因为它的角度分辨率非常高,可以产生稠密的点云来精细的描述周围的场景,就像是给场景拍照了一样。从这个意义上说,激光雷达也可以被认为是一种成像雷达。
所以,总结一下,一般大家说的4D成像雷达就是指,在水平和高度方向上都具备很高的分辨率,可以生成稠密点云的毫米波雷达。目前,市场上主流的4D成像雷达,其角度分辨率都在0.5°到1°左右。当然,这个角度分辨率跟激光雷达相比,还是有一定差距。128线的激光雷达,其角度分辨率可以做到接近0.1°。
1.2 为什么需要4D成像雷达
在自动驾驶系统中,我们有很多种传感器可以选择,各种组合的方案也有很多。从目前发展的趋势来看,视觉传感器肯定是要用的。特斯拉引领的纯视觉技术路线,在端到端大模型的加持下,看起来像是自动驾驶的终极答案了。但是,自动驾驶毕竟是一个对安全性有着极高要求的系统,单靠一种传感器和一种算法,从可靠性上来说是不够的。况且,人工智能虽然在快速发展,但是跟人类的视觉感知水平相比,差距还是不小的。
激光雷达和毫米波雷达在感知系统的作用,简单来说有两个方面:
-
在视觉系统能力并不完善的情况下,提供额外的感知能力。毕竟,雷达是可以直接测距的,对于判断障碍物位置来说具有天然的优势。
-
对于高阶自动驾驶系统来说,系统必须具有冗余性。当视觉感知失效的时候,雷达可以保证系统的安全下限。
那么,接下来的问题就是:激光雷达和毫米波雷达是否都需要,还是只用其中一种?从安全性的角度来看,当然是都用最好。但是,采用更多的传感器会导致系统复杂度和成本上升,从商业角度考虑是不友好的。那么,如果只能选其中一种,又该怎么选呢?
目前,激光雷达无论是从空间分辨率上,还是从点云质量上都要碾压毫米波雷达。但它也有两个致命的缺点,一个是生产成本依然很高(千美元级别),一个是受恶劣天气(比如大雨大雾天气)影响较大。当然,近些年来,激光雷达的成本也在不断降低,目前已经有百美元级别的产品出现。
文章开头提到了,毫米波雷达的优势在于可以全天候工作,对于整个自动驾驶系统的安全性来说非常重要。但是它的缺点在于空间分辨率较低,点云非常稀疏。4D成像雷达正是针对这两个缺点进行了改进,所以它同时具备了毫米波雷达和激光雷达的优点。4D成像雷达的成本一般只有激光雷达的1/10,空间分辨率和点云质量却比毫米波雷达高很多。从这个角度上来说,4D成像雷达可以被认为是介于激光雷达和传统毫米波雷达之间的一种传感器。如果找准定位,相信4D成像雷达会在未来自动驾驶感知系统中占有一席之地。
2. 技术方案
相比于传统的毫米波雷达,4D成像雷达的主要优点就在于具有较高的角度分辨率。那么,这是如何实现的呢?
2.1 天线设计和角度分辨率的关系
专栏之前的一篇文章(毫米波雷达:信号处理)介绍了,通过增加接收天线的个数可以提高毫米波雷达的角度分辨率。在下图的例子中,发射天线只有一个,接收天线按照一定的空间距离顺序排列。这种组合机制称之为单发多收(SIMO)。按照文章中介绍的角度分辨率计算公式,如果只有4个接收天线,那么角度分辨率是28°。如果接收天线个数增加到8个,那么角度分辨率可以提高到14°。在这个例子中,接收天线完全是水平排布,因此无法计算目标在垂直方向的角度,也就是说完全没有高度信息。因此,具有这种天线排布的就是一个纯粹的3D雷达。
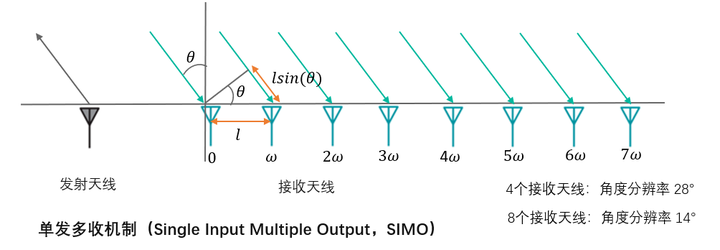
在SIMO机制中,想要提高角度分辨率,就必须增加接收天线的个数,而且这种变化是线性的。增加接收天线的个数对芯片设计和成本都会带来负面的影响。首先,天线个数增多,芯片的面积就要增大,这对于车载芯片来说是很不友好的。另外,每一个接收天线都要附加单独的信号处理链路,芯片的设计复杂度和成本都会增加。
因此,在毫米波雷达的设计中,更常用的是多发多收机制(MIMO)。在这种设计中,发射和接收天线都有多个,它们互相进行组合,可以形成多个虚拟的接收天线。比如,在下图的例子中,有2个发射天线和4个接收天线,它们之间的间距都是固定的。左边的发射天线和4个接收天线组合,可以形成4个虚拟天线。同理,右边的发射天线也可以形成4个虚拟天线。所以,这种2发4收的天线配置可以等效为SIMO机制中的8个虚拟天线。对比一下,SIMO中想要获得8个接收天线,需要1个发射8个接收共计9个天线;而MIMO只需要2个发射4个接收共计6个天线,对物理天线的利用效率显然提高了很多。这里有一个问题,那就是不同发射天线发射的信号如何区分呢?一般来说有两种方式,要么它们间隔发射,要么它们发射不同波形的信号,这样就可以帮助接收天线区分来自不同发射天线的信号。
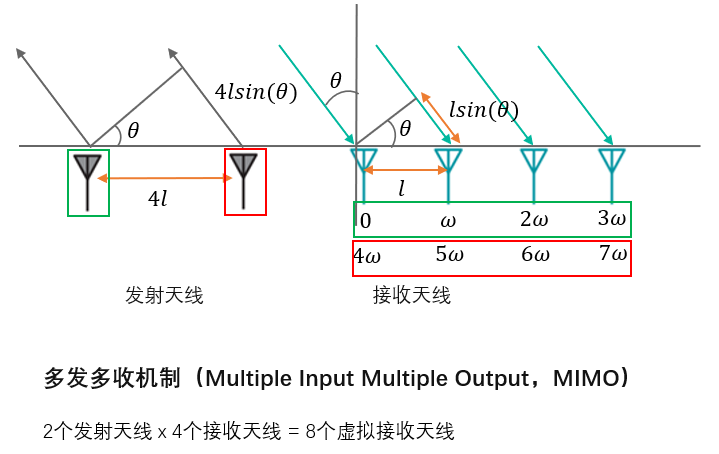
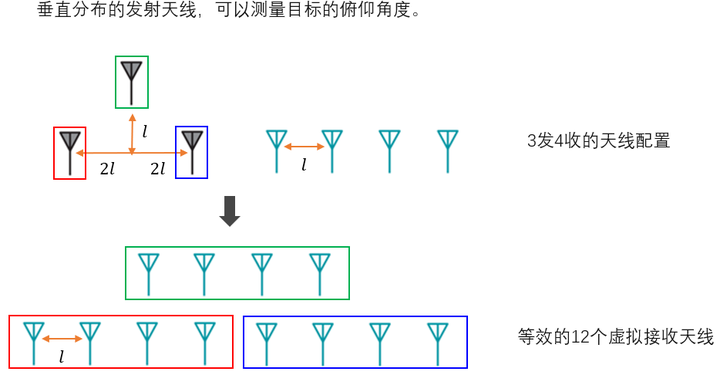
MIMO机制可以高效利用物理天线,增加虚拟接收天线的个数,从而提高角度分辨率。但是,上面例子中的天线是在水平方向上分布的,因此无法获得垂直(俯仰)角度信息。为了能够在垂直方向上也具有一定的分辨率,毫米波雷达经常采用如下图所示的3发4收配置。与2发4收相比,多出来的那个发射天线分布在垂直方向上,所以12个虚拟接收天线就有了垂直方向的分布。但是,由于在垂直方向上只相当于有2个虚拟天线,理论上说垂直角度分辨率只有56°。这么低的角度分辨率在实际应用中能起到的作用是非常有限的。这就是为什么人们常说,毫米波雷达无法获得高度信息。
2.2 如何增加天线个数
了解了角度分辨率和天线个数的关系以后,我们可以知道,要想提高毫米波雷达的水平和垂直角度分辨率,让其可以称之为成像雷达,最关键的就是要增加天线的个数。为了达到这个目的,4D成像雷达生产商采用了不同的技术方案,下面我们就来详细介绍一下。
方案1:芯片级联
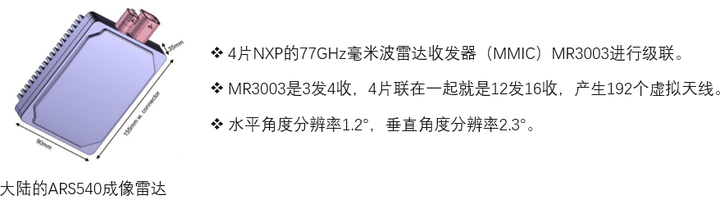
MIMO机制通过虚拟天线来增加天线个数,但是普通的雷达芯片上能够排布的物理天线个数是有限的。但是,我们还可以把多个雷达芯片连接到一起,用来扩展天线数量。比如,3发4收的芯片具有12个虚拟天线,如果我们把4片这种芯片级联到一起,那就是12发16收,一共192个虚拟天线。这种方式的好处是可以利用现有的量产雷达芯片,快速的扩展天线数量。采用这种方案的生厂商有很多,比较有代表性的是大陆和华为。
方案2:专用芯片
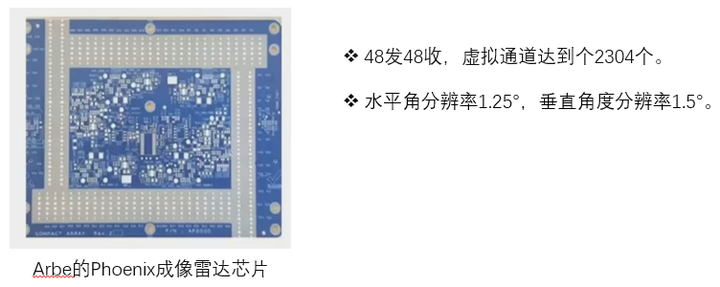
传统雷达芯片的可扩展性有限,因此有些生产商,尤其是一些初创公司,开始设计专用的4D成像雷达芯片。这类公司的代表有Arbe,Vayyar,Uhnder,另外还有ADAS的传统巨头Mobileye。这些芯片上集成了多个发射和接收天线,比如Arbe的Phoenix成像雷达芯片,是48发48收的配置,虚拟通道达到2304个。虽然都是集成的专用芯片,这些公司采用的方案并不是完全相同的。目前主流的是Arbe等公司采用的FMCW模拟电路方式,而Uhnder采用的则是数字编码调制(DCM)的方式。
方案3:标准芯片+软件提升
这种方案基于标准的雷达芯片,但是采用软件和AI的方法来提高雷达的角度分辨率。这里比较有代表性的是傲酷的“虚拟孔径成像”技术。传统FMCW雷达重复单一的发射波形,相位差来自于多根实体接收天线,而傲酷虚拟孔径成像雷达波形可以对发射波进行调频,调相、调幅,也就是说每根接收天线在不同时间产生不同的相位,形成“虚拟天线孔径”。而且这种调整是可以根据当前环境进行自适应的,也就是说根据上一帧的检测结果来调整当前帧的波形。这种方案也可以和多片级联方案结合,进一步的提高角度分辨率。

3. 感知算法
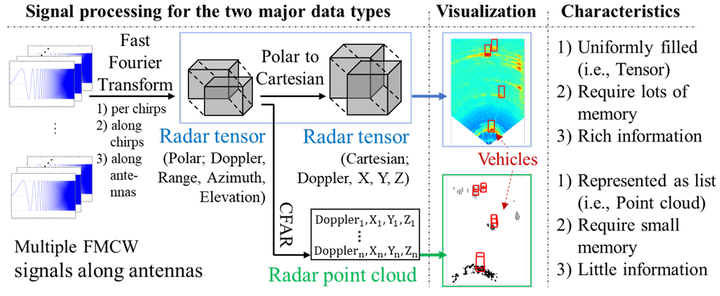
专栏之前的文章(链接见上文),主要列举了基于传统3D毫米波雷达的感知算法,主要涉及的是物体检测和语义分割这两个自动驾驶中常见的任务。这些感知算法可以按照不同的输入数据源分成两类:一类是基于点云数据,一类是基于底层数据(或者说pre-CFAR数据)。4D成像雷达的信号处理链路与传统的3D毫米波相比,并没有本质的区别,只是在解析角度的时候多了一个垂直角度(elevation)的维度。因此,4D成像的感知算法也可以按照输入数据的不同形式来区分。下图描述了4D成像雷达的数据处理流程。关于如何从原始频谱数据中利用FFT解析出距离、速度和角度,可以参考专栏之前的文章 毫米波雷达:信号处理。
3.1 基于点云数据的方法
传统3D毫米波雷达的点云非常稀疏,通常每帧数据只有64或者128个点。在这种稀疏的点云上,直接应用激光点云的感知算法是不太合适的。在之前的介绍中也可以看到,3D毫米波雷达的点云通常都是用一些比较传统和简单的方法来处理,比如基于DBSCAN的聚类算法。或者利用一些小规模的神经网络,比如PointNet。
与3D毫米波雷达相比,4D成像雷达的点云更加稠密,位置更加准确,更接近于激光雷达点云的质量。因此,激光雷达感知领域的一些常见方法(比如PointPillar)就可以被用来处理4D成像雷达的点云。下面就介绍其中几个典型的工作。
Multi-class Road User Detection with 3+1D Radar in the View-of-Delft Dataset (2021)
在自动驾驶领域,对于任何研究工作来说,数据都是非常重要的。4D成像雷达近几年发展迅速,研究人员也迫切的需要大规模高质量的数据来实验各种想法。在这篇文章中,来自荷兰代尔夫特理工大学的研究者们介绍了他们建立的一个4D成像雷达数据库,叫做 View-of-Delft (VoD)。
VoD是第一个较大规模的4D成像雷达数据库,一共有8693帧数据,每帧数据中都包含时间和空间对齐的64线激光雷达、双目相机和4D成像雷达数据,这些数据也都是在复杂的城市交通道路环境下采集的。数据中有超过120万个物体标注,类别包括行人,车辆和骑车的人。
作者采用了激光雷达感知中常用的PointPillars网络,把它直接应用到4D成像雷达的点云上,并且实验了各种不同的参数配置。
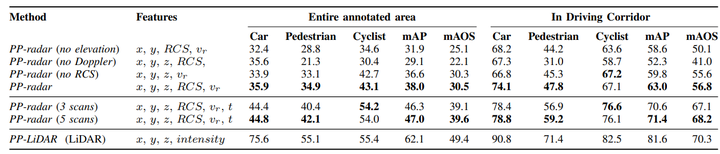
4D成像雷达的点云的特征有5个维度,分别是空间位置( x,y,z ),径向速度( vr )和反射强度( RCS )。这里需要说明一下,RCS 准确的说并不是反射强度,而且反映了物体反射截面的性质。但是,这里为了跟激光雷达里的反射强度( intensity )类比,就用了这个表述。从上图的实验结果可以看到,高度和径向速度这两个特征起的作用很大。相比之下,RCS起到的作用小一些。与3D毫米波雷达类似,多帧数据的叠加可以极大的提升感知性能。最后,与单帧64线的激光点云相比,4D成像雷达即使叠加了多帧的数据,在感知性能上还是有较大的差距。
3D Object Detection for Multiframe 4D Automotive Millimeter-Wave Radar Point Cloud (2023)
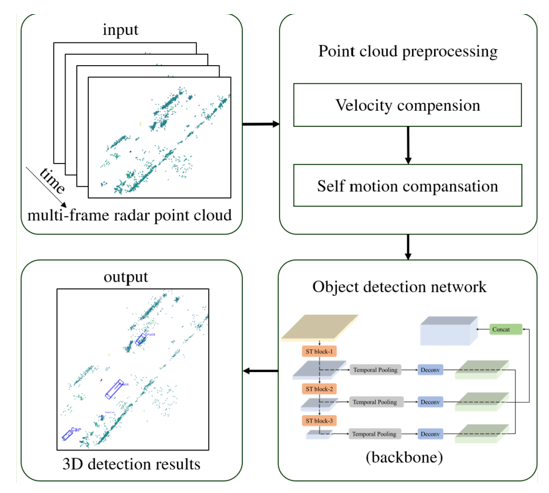
4D雷达点云中的速度是径向相对速度,因此这个信息中掺杂了雷达自身的运动(或者说自车运动)和目标的运动。对于感知任务来说,目标的绝对速度更有意义,因为这个信息可以帮助区分动态和静态的目标。因此,在4D雷达的点云处理中,很重要的一个步骤就是对相对速度做运动补偿。
在点云运动补偿中,最重要的是获得雷达的运动速度。这个可以通过车载的定位传感器(比如GPS/IMU等)计算自车速度,然后再根据雷达的外参矩阵(安装位置和朝向)来获取雷达速度。在这篇文章里,作者采用了另外一种方式,也就是用静止物体上的点云来推算雷达的速度。具体的推导过程可以参考原文,这里就不展开介绍了。获得了雷达速度以后,就可以计算出点云的绝对径向速度。
在毫米波雷达的感知算法中,通常都需要用到多帧数据的融合。当自车在移动时,每帧数据所处的坐标系都是不一样的。为了在空间上对齐多帧的数据,我们需要根据自车的运动信息,把不同帧的点云进行平移和旋转,最终对齐到一个统一的坐标系下(通常是当前帧的坐标系)。
经过运动补偿和空间对齐以后,多帧的点云数据被转换成“伪图像”,然后送入一个类似U-Net的神经网络进行处理。网络的结构没有太多新的东西,大家参考文章中的结构图就可以了。
最后需要提一下,这篇文章的作者也构建了一个4D雷达的数据库,叫做TJ4DRadSet。这个数据库包含了7757帧同步的激光雷达,摄像头和4D雷达点云数据。
MVFAN: Multi-View Feature Assisted Network for 4D Radar Object Detection (2023)
这个工作主要有两个特点:一个是采用不同的视图来增强点云特征提取,另一个是用附加的损失函数来付出区分前景和背景点。
在激光雷达感知中,点云数据可以采用不同的视图来表示,比如点视图(PointView)、前视图(FrontView或者RangeView)和俯视图(Bird's Eye View,BEV)。利用不同的视图表示,算法可以提取不同的邻域特征(或者叫上下文特征),这些特征可以直接用于感知任务,也可以附加到原始点云之上作为点云特征的增强。本文采用的是后一种方式。
作者还提出采用位置信息编码(每个点周围邻域点的位置信息),来区分前景和背景点。这个分支有一个额外附加的损失函数,通过前景和背景的真值信息来学习一个位置特征图。这个特征图反映的就是属于前景的置信度,用来对前面多视图的点特征进行加权。
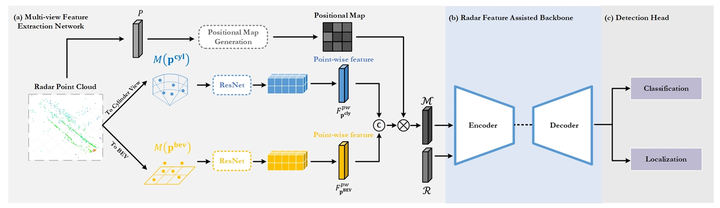
类似的,在SMIFormer (2023) 这篇文章中,作者也提出采用三种不同的视图来编码点云特征,并进一步用自注意力和交叉注意力机制对三种特征进行增强和融合。
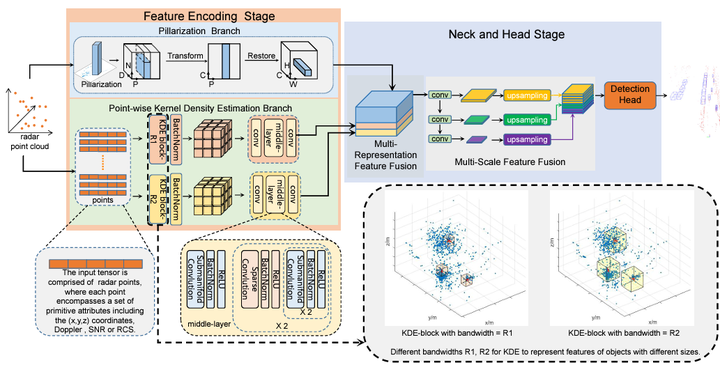
SMURF: Spatial Multi-Representation Fusion for 3D Object Detection with 4D Imaging Radar (2023)
这个工作的重点也在于特征提取。除了常用的Pillars特征以外,作者还提出采用KDE(Kernel Density Estimation)来估计每个点的密度特征。这个特征反映了每个点周围有没有其他点存在,以及存在的密度有多大。该设计背后隐含的思路是:对于真实目标,点云密度较大;而对于噪声点来说,其邻域内存在其他点的概率较低,因此密度也较小。这样一来,密度特征就可以被用来去除噪声。同时,作者还提出在KDE中采用不同的邻域半径,以适应不同大小的目标。
其实,CNN网络的卷积操作也可以起到类似的作用。但是,卷积操作无法直接用于点云特征(需要更复杂的操作,比如Graph Conv)。因此,直接以非参数的方式提取密度特征也不失为一种好的方法。
RadarPillars: Efficient Object Detection from 4D Radar Point Clouds (2024)
直接照搬激光点云的感知算法当然是一种思路,但是并没有充分考虑到4D成像雷达点云的特点,比如点云的稀疏性。举例来说,在上面介绍的VoD数据库中,每一帧4D雷达数据平均包含216个点,而64线激光雷达则包含超过2万个点。此外,4D点云中的速度信息通常只是被当作一个额外的特征来使用,并没有去深入研究如何更好的利用其中隐含的有用信息。
基于以上分析,来自德国曼海姆大学的研究者提出了RadarPillar方法。首先,4D雷达点云中的速度是径向速度,也就是点和雷达连线方向的速度。作者提出将这个速度在X和Y方向上进行分解,同时在Pillar特征的计算中,offset部分除了使用x和y,径向速度和XY分解的速度也被纳入进来。这样做可以“人为”的生成更多的速度特征,方便神经网络从中学习有用的信息。当然,关于径向速度如何利用,还有很多可以探讨的空间。比如,我们可以尝试猜测目标的真实运动方向,进而通过径向速度恢复目标真实的速度。在神经网络的实现里,我们可以假设多个可能的运动方向,让网络从数据中去学习如何更好的猜测目标的运动方向。
至于4D雷达点云的稀疏性,在利用PointPillar方法时,会有很多的Pillar是空的状态,这个空的比例要比使用激光雷达点云时高的多。这就会导致神经网络的前面几层,由于感受野较小,很难提取邻域的特征。通常来说,为了扩大感受野,我们可以使用大的卷积核或者对特征图进行下采样,但是这么样要么会显著增加计算量,要么会损失大量信息。考虑到pillar的稀疏性,本文作者提出利用自注意力机制来解决感受野的问题。思路其实很简单,每个pillar可以看作一个token,利用自注意力机制就可以获得全局的感受野。因为pillar的个数很少,所以自注意力的计算量也并不高。具体的实现细节,包括空间信息的编码,请参考原文,这里就不做详细介绍了。
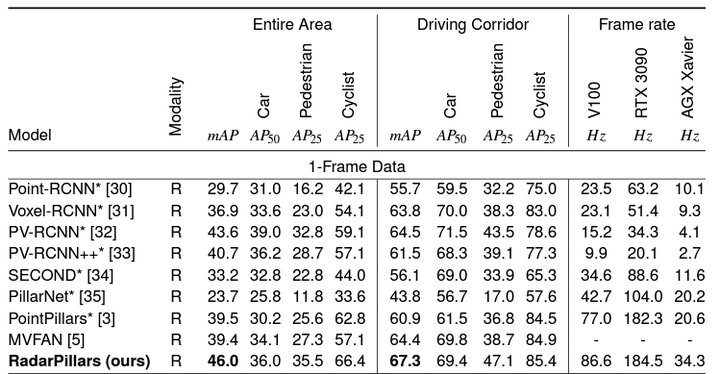
除了PointPillars,作者还尝试了多种来自LiDAR感知中的方法,比如Point-RCNN、Voxel-RCNN、PV-RCNN、SECOND等等,并在VoD数据库上与RadarPillars进行了对比。实验结果证明,采用更丰富的速度特征和全局自注意力编码后,RadarPillars的感知性能有了非常大的提升。
另外一篇较早的文章 RPFA-Net: A 4D RaDAR Pillar Feature Attention Network (2021),在提取Pillar特征的时候,也采用了类似的思路,用自注意力机制来扩大感受野,从而提取更多的上下文特征。
***总结一下***,在基于点云的方法中,主要的工作都集中在如何增强点云特征的提取。从激光点云处理中移植过来的Pillars特征是一种常用的方法。在此基础上,研究者们提出了一些改进方案,包括多视图特征、注意力特征和密度特征等。此外,如何有效的利用多普勒特征和时序信息,也是研究的热点方向。
3.2 基于Pre-CFAR数据的方法
毫米波雷达的原始数据是稠密的,在生成点云之前需要进行稀疏化处理,而CFAR就是其中最常用的方法。因此,以CFAR操作为分界线,CFAR之后是稀疏的点云特征,CFAR之前是稠密的原始特征(也就是Pre-CFAR特征)。Pre-CFAR特征包括有很多种形式,可能是ADC之后的原始频谱特征,也可能是做完FFT处理之后的RAD特征,或者两者之间的某种形态。
CFAR的稀疏化操作,大大降低了数据量,这对于数据传输和后续计算来说都是非常有利的。但是,这个操作也不可避免的带来了信息损失。随着车载计算和数据平台的升级,人们关注的重点也从降低数据量逐渐转移到提高信息量上来。在深度学习的时代,工程师们不再需要费尽心力的选择该使用哪些信息,这个工作交给神经网络来做就好了。神经网络采用端到端的方式,从海量的数据中学习到该保留哪些信息,提取何种特征,以更好的适应后续的感知任务。
专栏之前的文章介绍了深度学习对3D毫米波雷达原始数据的处理。下面我们就来扩展一下,看看在4D成像雷达的领域,Pre-CFAR特征如何跟深度学习进行结合。
K-Radar: 4D Radar Object Detection for Autonomous Driving in Various Weather Conditions (2022)
前面我们介绍的两个大规模4D雷达数据库,VoD和TJ4DRadSet,都只包含了点云的数据。为了研究Pre-CFAR数据的优势,来自韩国科学技术院(KAIST)的研究者构建了K-Radar数据库,其中包含了35K帧不同场景下的4D成像雷达、激光雷达和图像的数据。这里的4D雷达数据不仅包含点云,更重要是还有在CFAR操作之前的4DTensor数据,4个维度分别是range,Doppler,azimuth和elevation。

基于4DTensor数据,作者提出了两个Baseline方法:RTNH和RTN。RTNH将4DTensor进行一定程度的稀疏化(取能量在前10%的点,Doppler维度取最大值),从而生成了3D点云,并采用稀疏3D卷积进行特征提取。RTN没有进行稀疏化处理,而是直接把高度维度进行压缩,从而得到BEV特征图,并在此基础上进行后续处理。
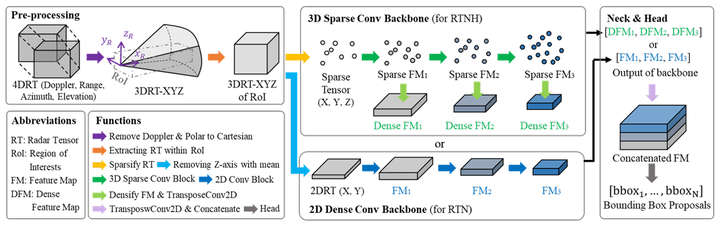
实验结果表明,采用Pre-CFAR数据可以显著提升感知算法的准确率。以BEV视角下的物体检测为例,RTNH和RTN的AP分别可以达到58.4%和50.7%,而基于激光雷达点云的PointPillars方法只有49.3%。还记得吗,在VoD数据库上,同样是采用PointPillars,基于4D雷达点云的方法其准确率远低于激光雷达。当然,在本文的实验中,为了公平,其实也应该在稀疏化后的4D雷达点云上采用PointPillars方法进行实验。
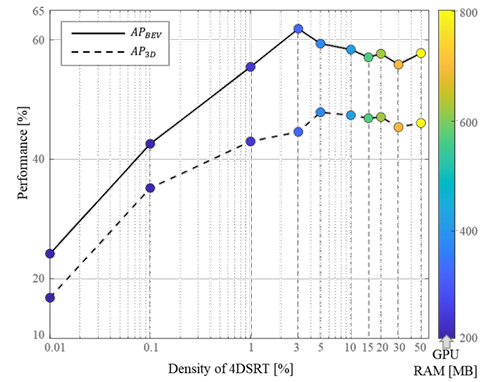
在RTNH中,有一个参数非常重要,那就是稀疏化的采样率。在Enhanced K-Radar这篇文章中,作者进一步研究了该参数对内存消耗以及最终感知准确率的影响。如下图所示,采样率在3%-5%左右时,感知的准确率达到峰值。保留更多的点会带来更多噪声,造成准确率下降,并且增加内存和计算资源的消耗。另外,值得一提的是,K-Radar的原始数据有12TB,这么大的数据量下载和处理都非常困难。只保留5%左右的数据,就可以显著降低数据量,方便数据库的共享。
DenserRadar: A 4D millimeter-wave radar point cloud detector based on dense LiDAR point clouds (2024)
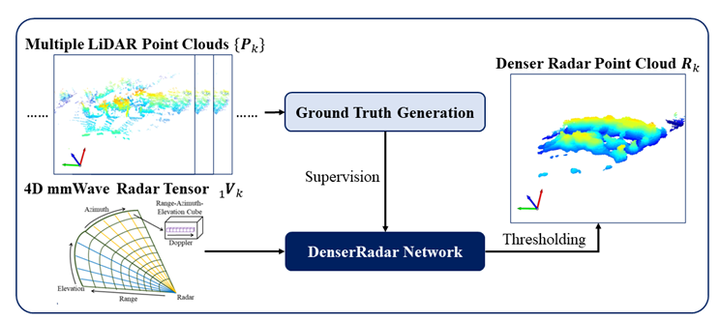
K-Radar方法中选取按照能量值对4DTensor中的数据进行排序,选取一定百分比的数据(比如5%)生成相对稀疏的点云。这种方式与CFAR类似,都是基于规则的。显然,这种基于规则的方式并不是最优的,会不可避免的丢失有效信息。这里有一个问题,那就是什么才是“有效”信息。雷达的数据最终要被用于完成各种任务,比如目标检测,语义分割,甚至SLAM。所以,“有效”信息也是针对不同的任务来说的,我们需要找到对某一个任务最有效,或者说最优的特征。
激光雷达,尤其是高线束的机械式激光雷达,其距离和角度分辨率都非常高,噪声也很少,因此经常被用来生成真值。考虑到这一点,DenserRadar这篇文章提出以模拟激光雷达的点云为目标,来生成4D成像雷达的点云。按照这种方式生成的点云,比CFAR方法生成的点云更加接近激光雷达,因此也可以认为具有更好的质量。但遗憾的是,文章中并没有在不同的感知任务上对比不同方法生成的点云,而这应该才是我们关注的重点。
ADCNet: Learning from Raw Radar Data via Distillation (2023)
不管是K-Radar还是DenserRadar中的方法,都是以RAD数据为起点,也就是在ADC数据上用FFT做完距离、速度和角度解析之后的输出。FFT其实就是一种线性操作,可以很容易的用神经网络中的全连接层来模拟。另外,FFT只是一种快速的处理方法,并不一定是最优的。
尤其是在角度解析中,有很多高分辨率的算法比如IAA,MUSIC,ESPRIT等,可以提供更好的解析精度。这些方法计算量比较大,在对实时性要求较高的系统中很难被使用。但是,它们可以作为“真值”,也就是神经网络学习和模拟的目标。因此,来自Motional公司的研究者提出以高精度方法解析的RAD数据为真值,设计神经网络模块从ADC原始数据来学习如何进行解析。这个神经网络的参数初值可以设置为FFT的系数,之后再通过下游的任务进行微调(FineTuning)。这个过程类似于神经网络中常用的知识蒸馏,也就是用离线大模型生成的结果作为真值,指导在线小模型的学习。
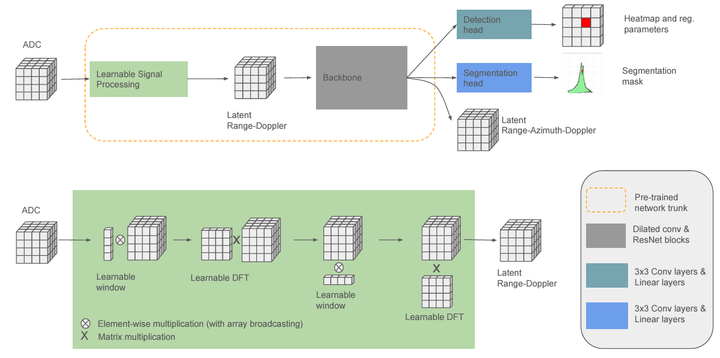
类似的方法还有T-FFTRadNet (2023),也是以ADC数据为输入,利用线性神经网络来模拟FFT操作,从而解析出RAD数据。与ADCNet不同的是,T-FFTRadNet用FFT的系数作为初始化后,就直接接入下游任务进行端到端的训练,而没有采用pre-training。从实际的效果来看,对解析RAD的神经网络模块进行预训练,尤其是利用高分辨率的角度解析结果作为真值,会得到更好的效果。
***总结一下***,对于Pre-CFAR数据使用的研究,主要有两个方向。一种是利用FFT解析过后的RAD数据。由于4D成像雷达的数据量巨大,所以RAD数据需要进行稀疏化处理。这个操作可是用人工定义的筛选规则(CFAR也是其中一种),更好一点是用机器学习和数据驱动的方式来自动进行。另外一种是直接输入ADC原始数据,用神经网络来模拟FFT的解析操作,并且与下游任务一起进行端对端训练。在这种方法中,同样的,我们也需要考虑数据里的问题。在神经网络解析完之后,或者在解析的过程中,数据需要进行一定程度的稀疏化。
更多推荐
 34
 0
- 0


 已为社区贡献2条内容

所有评论(0)