
DBSCAN算法改进方案与应用毕业论文【附代码+数据】
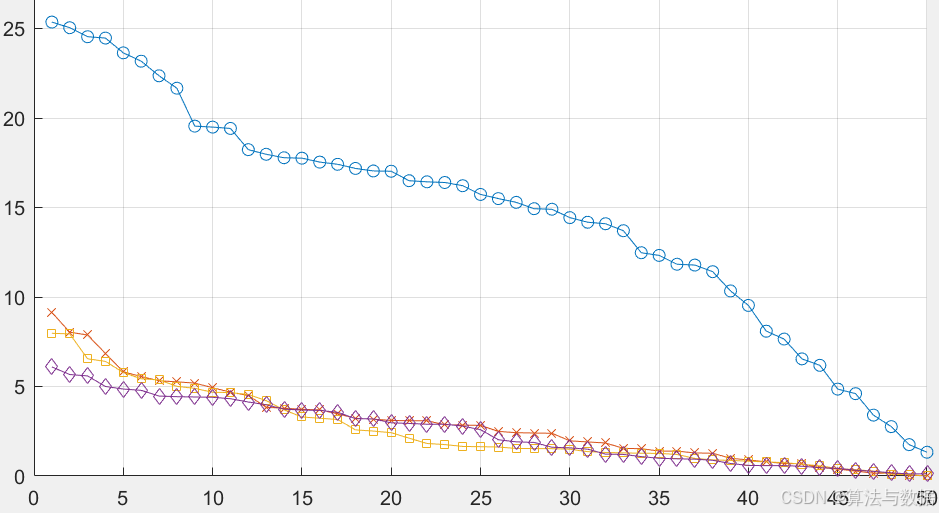
(1)基于K-dist图的自适应参数改进的DBSCAN算法的研究与应用,旨在解决经典DBSCAN算法中Eps和MinPts参数手动设置导致聚类效果不稳定、准确度不高的问题。DBSCAN算法作为一种基于密度的聚类算法,广泛应用于各种数据挖掘任务中,但由于其参数的选取依赖于人为设定,容易受到数据集自身特点的影响,导致聚类结果不佳。为了解决这一问题,本研究提出了一种基于K-dist图的自适应确定参数的DBSCAN算法,简称X-DBSCAN。该算法通过最小二乘多项式曲线拟合方法对K-dist图中的曲线进行拟合,生成候选Eps参数列表。具体而言,K-dist图展示了每个数据点与其第k个最近邻的距离,通过拟合这些距离的分布曲线,可以找到合适的Eps值。同时,采用数学期望法和降噪阈值生成相应的MinPts参数列表。通过综合考虑Eps和MinPts参数列表中各组参数的聚类结果,找到簇数变化的稳定范围,并选取稳定范围内最大K值对应的MinPts和Eps作为最优算法参数。此外,利用轮廓系数验证了自适应选取的参数的最优性。轮廓系数是一种评估聚类效果的指标,值越大表示聚类结果越好。实验结果表明,通过自适应参数选择,X-DBSCAN算法在聚类准确性和稳定性方面均有显著提升。
(2)为了验证X-DBSCAN算法的有效性,本研究在人工数据集和UCI真实数据集上进行了多角度的实验设计。首先,使用人工数据集进行初步验证,这些数据集包括不同形状、大小和密度的簇,能够全面评估算法的性能。实验结果表明,X-DBSCAN在人工数据集上的聚类准确度比经典DBSCAN算法提高了21.83%。接着,使用UCI真实数据集进行进一步验证,这些数据集涵盖了多个领域的实际应用场景,能够更真实地反映算法的实际性能。实验结果表明,X-DBSCAN在UCI真实数据集上的聚类准确度比经典DBSCAN算法提高了15.52%。通过对各种聚类指标的综合评价和分析,如轮廓系数、Davies-Bouldin指数和Calinski-Harabasz指数,X-DBSCAN算法在多个指标上均优于其他四种对比算法,包括K-means、Agglomerative Clustering、Spectral Clustering和OPTICS。这些结果验证了X-DBSCAN算法在不同数据集上的聚类准确性和鲁棒性。
(3)为了进一步验证X-DBSCAN算法在实际应用中的有效性,本研究将其应用于客户细分领域。客户细分是企业进行市场分析和营销策略制定的重要手段,通过对客户进行细分,企业可以更精准地了解客户需求,提供个性化的服务,从而提高客户满意度和忠诚度。本研究介绍了客户细分的概念定义、目的与意义,以及客户细分的价值和目前所采用的分析方法。具体而言,客户细分可以帮助企业识别不同类型的客户群体,制定针对性的营销策略,优化资源配置,提高市场竞争力。为了验证X-DBSCAN算法在客户细分中的应用效果,本研究使用了实际的商城客户数据进行实验。实验结果表明,X-DBSCAN算法在客户细分任务中表现优异,能够有效识别出不同类型的客户群体,聚类结果的准确性和稳定性均优于经典DBSCAN算法。通过与DBSCAN算法的对比,X-DBSCAN算法在客户细分中的应用性能得到了充分验证。
% X-DBSCAN算法实现
function [clusters, eps, minPts] = x_dbscan(data, k)
    % data: 输入数据
    % k: K-dist图中的k值

    % 计算K-dist图
    k_dist = calculate_k_dist(data, k);

    % 使用最小二乘多项式曲线拟合方法生成候选Eps参数列表
    eps_list = fit_k_dist(k_dist);

    % 生成候选MinPts参数列表
    minPts_list = generate_minPts_list(k_dist);

    % 评估不同参数组合的聚类结果
    best_score = -inf;
    best_eps = 0;
    best_minPts = 0;
    for i = 1:length(eps_list)
        eps = eps_list(i);
        minPts = minPts_list(i);
        clusters = dbscan(data, eps, minPts);
        score = silhouette_score(data, clusters);
        if score > best_score
            best_score = score;
            best_eps = eps;
            best_minPts = minPts;
        end
    end

    % 返回最优参数和聚类结果
    clusters = dbscan(data, best_eps, best_minPts);
    eps = best_eps;
    minPts = best_minPts;
end

% 计算K-dist图
function [k_dist] = calculate_k_dist(data, k)
    n = size(data, 1);
    k_dist = zeros(n, 1);
    for i = 1:n
        distances = pdist2(data(i, :), data);
        sorted_distances = sort(distances);
        k_dist(i) = sorted_distances(k);
    end
end

% 使用最小二乘多项式曲线拟合方法生成候选Eps参数列表
function [eps_list] = fit_k_dist(k_dist)
    % 拟合K-dist图的曲线
    p = polyfit(1:length(k_dist), k_dist, 3);
    fitted_k_dist = polyval(p, 1:length(k_dist));

    % 生成候选Eps参数列表
    eps_list = unique(fitted_k_dist);
end

% 生成候选MinPts参数列表
function [minPts_list] = generate_minPts_list(k_dist)
    % 计算数学期望
    expected_value = mean(k_dist);

    % 生成候选MinPts参数列表
    minPts_list = round(expected_value * (1:0.1:2));
end

% DBSCAN算法实现
function [clusters] = dbscan(data, eps, minPts)
    n = size(data, 1);
    clusters = zeros(n, 1);
    cluster_id = 1;

    for i = 1:n
        if clusters(i) == 0
            neighbors = region_query(data, i, eps);
            if length(neighbors) < minPts
                clusters(i) = -1; % 噪声点
            else
                expand_cluster(data, clusters, i, neighbors, eps, minPts, cluster_id);
                cluster_id = cluster_id + 1;
            end
        end
    end
end

% 区域查询
function [neighbors] = region_query(data, point_id, eps)
    distances = pdist2(data(point_id, :), data);
    neighbors = find(distances <= eps);
end

% 扩展聚类
function [] = expand_cluster(data, clusters, point_id, neighbors, eps, minPts, cluster_id)
    clusters(point_id) = cluster_id;
    i = 1;
    while i <= length(neighbors)
        next_point = neighbors(i);
        if clusters(next_point) == -1
            clusters(next_point) = cluster_id;
        elseif clusters(next_point) == 0
            clusters(next_point) = cluster_id;
            next_neighbors = region_query(data, next_point, eps);
            if length(next_neighbors) >= minPts
                neighbors = [neighbors, next_neighbors];
            end
        end
        i = i + 1;
    end
end

% 计算轮廓系数
function [score] = silhouette_score(data, clusters)
    n = size(data, 1);
    a = zeros(n, 1);
    b = inf * ones(n, 1);

    for i = 1:n
        cluster_points = data(clusters == clusters(i), :);
        a(i) = mean(pdist2(data(i, :), cluster_points));

        for j = 1:max(clusters)
            if j ~= clusters(i)
                other_cluster_points = data(clusters == j, :);
                d = mean(pdist2(data(i, :), other_cluster_points));
                if d < b(i)
                    b(i) = d;
                end
            end
        end
    end

    s = (b - a) ./ max(a, b);
    score = mean(s);
end

% 示例调用
data = load('example_data.mat'); % 加载示例数据
k = 5; % 设置K-dist图中的k值

% 进行X-DBSCAN聚类
[clusters, eps, minPts] = x_dbscan(data, k);

% 显示聚类结果
disp('Clusters:');
disp(clusters);
disp('Optimal Eps:');
disp(eps);
disp('Optimal MinPts:');
disp(minPts);
更多推荐
 5
 0
- 0


 已为社区贡献2条内容

所有评论(0)