
图检索算法(NSW、HNSW、NSG、SSG)论文阅读
一、图检索算法概述
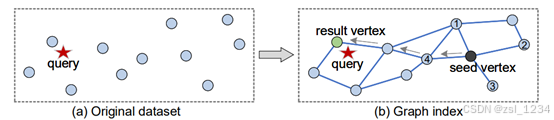
图中点表示原始数据集的一个向量,边连接的顶点称为邻点,表示和该向量距离相近的点。
图检索过程通常从一个入口点开始,遍历其邻点,计算其和query的距离。如果邻点中点r距离query距离更近,则从点r开始重复上述过程,直到出现所有邻点到query距离大于该点到query的距离。
二、Greedy_search(NSW、HNSW、NSG、SSG)
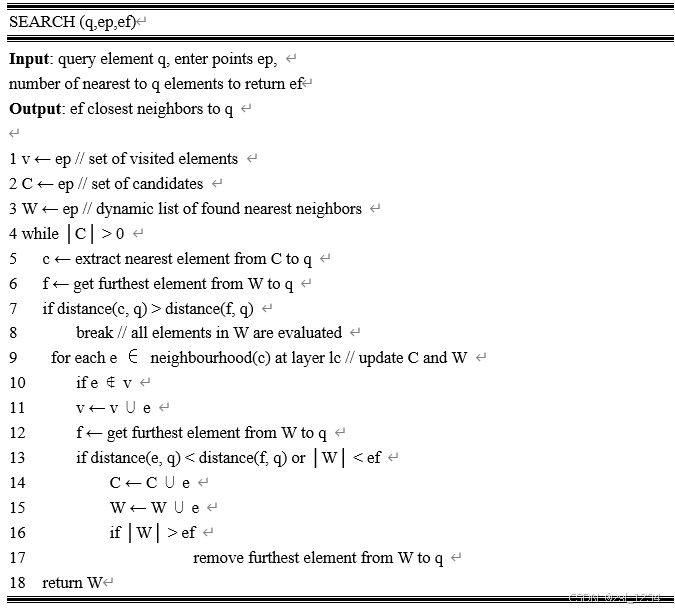
算法解释:
输入是query,entry_point,以及ef,输出是ef个相似向量。
V用来标记已经计算过的点,C是Candidant用来存储候选点,W存储results。
C不为空,获取C中距离Q最近点和W中距离Q最远的点,计算距离,如果大于,算法终止。否则,遍历邻居节点,如果访问过,continue,否则,标记为访问。如果W.size()小于Ef或者对于其中一个友点e,距离小于W中到q最远点f的距离,则更新W,C,重复上面的过程。
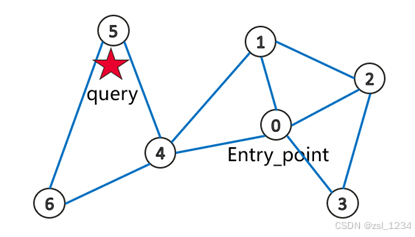
下面举一个简单的搜索的例子,Ef为2。
|
Action |
C |
W |
|
从entry_point点0开始,加入到C、W。 |
0 |
0 |
|
从C中取出点0,比较dis(0,q)等于W中furthest点dis(0,q),遍历邻点 |
0 | |
|
首先是邻点1.此时W.size()小于Ef,更新C、W、V |
1 |
0、1 |
|
接着是邻点2,此时W.size()等于Ef,并且dis(2)>dis(1)不更新C、W,标记V |
1 |
0、1 |
|
接着是邻点3,此时W.size()等于Ef,并且dis(3)>dis(1)不更新C、W,标记V |
1 |
0、1 |
|
接着是邻点4,此时W.size()等于Ef,但是dis(4)<dis(0),更新C、W,标记V |
1、4 |
1、4 |
|
接着从C中取出点1,但是其邻居节点在已经访问过,不更新。 |
4 |
1、4 |
|
从C中取出点0,比较dis(4,q)小于W中furthest点dis(1,q),遍历邻点 |
1、4 | |
|
首先是邻点6,此时W.size()等于Ef,但是dis(6)<dis(1),不更新 |
1、4 | |
|
接着是邻点5,此时W.size()等于Ef,但是dis(5)<dis(1),更新 |
5 |
5、4 |
|
从C中取出点5,但是其邻居节点在已经访问过,不更新 |
5、4 | |
|
返回W |
5、4 |
三、HNSW算法
1. 图构建
HNSW的构建是一个向量一个向量构建的。在构建Index之前会先初始化一个概率数组prob,数组长度为Layer层数,数组元素对应于该点插入到该层的概率。
一个向量被插入时,会由uniform(0,1)产生一个随机数,依次和上面的概率数组比较,大于则插入。

设置M=32,level=6时,概率数组设置如下:
([0.96875, 0.030273437499999986, 0.0009460449218749991, 2.956390380859371e-05, 9.23871994018553e-07, 2.887099981307982e-08],)
层级0的插入概率远高于其他层级,意味着更高层级更为稀疏,这有助于减少搜索过程中陷入局部最小值的风险,并确保搜索从长距离遍历开始。引入了高速公路机制。
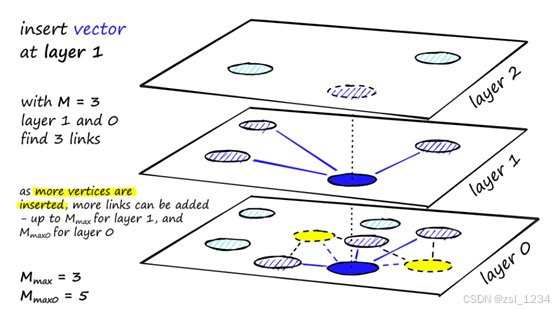
构建第一阶段:
图构建从顶部层开始,进入图后,算法贪心地遍历边,找到插入向量q的最近邻居。
找到局部最小值后,它移动到下一层,这个过程重复直到达到选择的插入层。
构建第二阶段:
ef值增加到efConstruction(设置的一个参数),执行SEARCH算法,返回更多的最近邻居(W)。这些最近邻居是候选链接到新插入元素q以及下一层的入口点。从这些候选者中选择M个邻居作为链接——最直接的选取标准是选择最接近的向量。
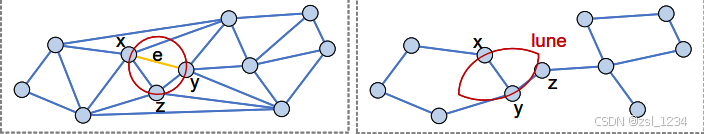
构建图时不仅要考虑点的距离,还要考虑邻点的周围分布,尽可能均匀分布。
HNSW采用RNG的选边策略,定义如下
In Euclidean space 𝐸 𝑑 , the RNG 𝐺(𝑉 , 𝐸) built on dataset 𝑆 has the following property:
For 𝑥, 𝑦 ∈ 𝑉 , if 𝑥 and 𝑦 are connected by edge 𝑒 ∈ 𝐸, then ∀𝑧 ∈ 𝑉 , with 𝛿 (𝑥, 𝑦) < 𝛿 (𝑥, 𝑧), or 𝛿 (𝑥, 𝑦) < 𝛿 (𝑧, 𝑦)
2. 图搜索
搜索过程:
图构建从顶部层开始,进入图后,算法贪心地遍历边,找到查询向量q的最近邻居。
找到局部最小值后,它移动到下一层。
到达最后一层后Layer0后执行SEARCH算法。
四、NSG
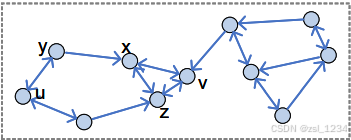
KNNG:有向图,每个点有K个邻点
NSG构图基于构建好的KNNG图,在此基础上中重构图,选用了和HNSW类似RNG的monotonic RNG (called MRNG)的选边策略。
NSG论文中有大量数学定义,下面是我对其一些总结:
- 单调路径(Monotonic Path). :贪心搜索可以保证不回溯,每一步都会更近
- 单调网络(Monotonic Search Network) (MSNET):图内任意两点之间存在单调路径
- MRNG:任意p,q两点之间的区域中不包括集合S中任何点,或者r在该区域中,但是pr不属于MRNG
- MRNG和RNG选边的差异性体现在,对于MRNG来说条件任意p,q两点之间的区域中不包括集合S中任何点不是必须的。
并且MRNG∈MSNET
NSG搜索算法采用上文Greedy_Search
五、SSG
NSG存在的问题:
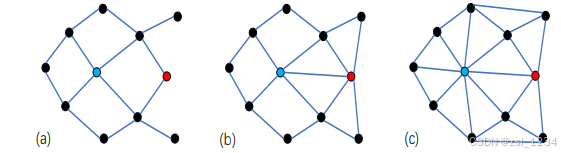
MSNET过于稀疏,导致搜索性能差
如图所示,合适的出度可能是最佳的。(过大或者过小都会导致搜索性能变差)
为此,作者提出了新的选边策略:

简单来说,在高维空间中,p点为圆心,pq为半径形成的球体,和p点为圆心2α为直径角形成的相交的空间内部没有属于SSG的边。
图构建算法流程如下:
- 首先建立KNN,选择该点邻居节点以及邻居的邻居。
- 应用SSG的选边策略,同时设置最大度
- 确保图的连通性。随机选择m个导航点,进行DFS,连接没有连接的顶点
六、参考论文列表
- A Comprehensive Survey and Experimental Comparison of Graph-Based Approximate Nearest Neighbor Search
- NSW:Yury Malkov, Alexander Ponomarenko, Andrey Logvinov, and Vladimir Krylov. 2014. Approximate nearest neighbor algorithm based on navigable small world graphs.
- HNSW:Yury A Malkov and Dmitry A Yashunin. 2018. Efficient and robust approximate nearest neighbor search using hierarchical navigable small world graphs
- NSG:Cong Fu, Chao Xiang, Changxu Wang, and Deng Cai. 2019. Fast Approximate Nearest Neighbor Search With The Navigating Spreading-out Graph
- SSG: Cong Fu, Changxu Wang, and Deng Cai. 2021. High Dimensional Similarity Search with Satellite System Graph: Efficiency, Scalability, and Unindexed Query Compatibility
更多推荐


 15
 0
- 0


 已为社区贡献1条内容

所有评论(0)