
支持向量回归算法原理及Python实践
支持向量回归(Support Vector Regression, SVR)是一种基于支持向量机(Support Vector Machine, SVM)的回归算法,其核心思想是通过寻找支持向量来构建一个分离超平面,从而实现对不确定的函数关系的建模。以下是SVR算法原理的详细解释:
1. 基本概念
- 支持向量机(SVM):最初是用于分类问题的一种强大学习算法,通过寻找最小化支持向量的数量和超平面的距离的线性分类模型,实现对线性可分问题的解决。
- 支持向量回归(SVR):将SVM扩展到回归问题,通过构建一个分离超平面来实现对非线性关系的建模。SVR在处理小样本量和高维数据时具有较好的泛化能力。
2. 核心原理
SVR的核心原理主要包括以下几个方面:
- 非线性映射:通过将原始的输入空间映射到一个高维的特征空间,使得原本的非线性关系在高维空间中可能变得线性可分。
- 构建分离超平面:在高维特征空间中,SVR寻找一个最优的超平面来拟合训练数据。这个超平面不仅与训练数据之间的间隔尽可能大,而且使得训练数据的损失最小。
- 松弛变量和误差容忍度:SVR引入了一个松弛变量来允许训练样本与超平面之间存在一定的误差,同时设置了一个误差容忍度(即间隔带的宽度ϵ),对于落在间隔带内的样本不计算损失。
- 惩罚项:为了限制超平面的泛化能力,防止过拟合,SVR采用了惩罚项的概念。通过设置一个正则化参数C,对超出间隔带的数据点进行惩罚。
3. 数学模型
SVR的数学模型可以表示为:
y(x)=w⋅ϕ(x)+b y(x) = w \cdot \phi(x) + b y(x)=w⋅ϕ(x)+b
其中,y(x)y(x)y(x)是输出变量的预测值,xxx是输入变量,www是权重向量,ϕ(x)\phi(x)ϕ(x)是输入变量xxx映射到高维空间的函数,bbb是偏置项。
SVR的目标是最小化支持向量的数量和超平面的距离,这可以表示为优化问题:
minw,b12w2+C∑i=1n(ξi+ξi∗) \min_{w,b} \frac{1}{2}w^2 + C\sum_{i=1}^{n}(\xi_i + \xi_i^*) w,bmin21w2+Ci=1∑n(ξi+ξi∗)
其中,CCC是正则化参数,ξi\xi_iξi和ξi∗\xi_i^*ξi∗是松弛变量,用于控制支持向量的数量。
4. 求解过程
SVR的求解过程通常转化为一个凸优化问题,通过构建拉格朗日函数,将原始问题转化为等价的对偶问题,再通过优化算法求解对偶问题。求解对偶问题得到的最优解即为SVR的权重向量和偏置项。
5. 核函数
SVR可以通过选择不同的核函数来实现非线性映射。常用的核函数有线性核、多项式核、高斯核(RBF)等。核函数的选择和参数的调节对SVR的性能有重要影响。
6. 优点与应用
SVR具有较好的泛化能力和鲁棒性,对于小样本、高维数据以及存在噪声的数据具有较好的适应能力。它在机器学习和统计学中得到了广泛的应用,特别是在回归问题中取得了良好的效果,如预测、分类、聚类等任务。
综上所述,支持向量回归算法通过在高维空间中寻找一个最优的超平面来拟合数据,同时引入松弛变量和误差容忍度来处理非线性关系和噪声数据,从而实现对不确定函数关系的建模。
7. Python实践
支持向量回归(SVR)算法在Python中可以通过scikit-learn库轻松实现。以下是一个使用scikit-learn中的SVR模块进行Python实践的简单例子。
首先,你需要安装scikit-learn库(如果你还没有安装的话):
pip install scikit-learn
然后,你可以使用以下代码来实践SVR算法:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.svm import SVR

# 生成模拟数据
np.random.seed(0)
X = np.sort(5 * np.random.rand(40, 1), axis=0)
y = np.sin(X).ravel()

# 添加噪声
y[::5] += 3 * (0.5 - np.random.rand(8))

# 划分训练集和测试集(可选,但在这个例子中我们使用全部数据)
# X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 实例化SVR模型
# 使用RBF(高斯)核,这是处理非线性关系的常用选择
# C是正则化参数,epsilon是误差容忍度
svr_rbf = SVR(kernel='rbf', C=100, gamma=0.1, epsilon=.1)

# 拟合模型
svr_rbf.fit(X, y)

# 预测
X_predict = np.linspace(0, 5, 100).reshape(-1, 1)
y_pred = svr_rbf.predict(X_predict)

# 可视化结果
plt.scatter(X, y, color='darkorange', label='data')
plt.plot(X_predict, y_pred, color='navy', lw=2, label='RBF model')
plt.xlabel('data')
plt.ylabel('target')
plt.title('Support Vector Regression')
plt.legend()
plt.show()
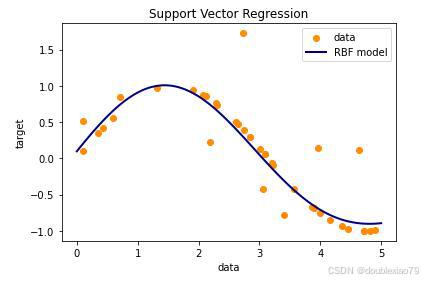
在这个例子中,我们首先生成了一些模拟数据,这些数据是sin函数的值加上一些随机噪声。然后,我们实例化了一个SVR对象,指定使用RBF(高斯)核,并设置了正则化参数C和误差容忍度epsilon。接着,我们使用全部数据来拟合模型,并在一个连续的范围内预测了目标变量的值。最后,我们使用matplotlib库将原始数据和预测结果可视化出来。
请注意,SVR的性能很大程度上取决于核函数的选择、正则化参数C和误差容忍度epsilon的调节。在实际应用中,你可能需要通过交叉验证等方法来找到最佳的参数组合。
此外,虽然在这个例子中我们没有划分训练集和测试集,但在实际应用中,为了评估模型的泛化能力,你应该将数据集划分为训练集和测试集,并在测试集上评估模型的性能。
更多推荐



 21
 0
- 0


 已为社区贡献4条内容

所有评论(0)