
第J7周:对于ResNeXt-50算法的思考
- 本文为🔗365天深度学习训练营 中的学习记录博客
- 原作者:K同学啊
需要解决的疑问:这个代码是否有错?对错与否都给出思考
要求:查找相关资料、逐步推理模型、详细写下思考过程
一、下面是TnesorFlow复现ResNext-50模型的代码,参考《第J6周:ResNeXt-50实战解析》的内容,思考“二、问题”
import numpy as np
from tensorflow.keras.preprocessing.image import ImageDataGenerator
from tensorflow.keras.utils import to_categorical
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Input, Dense, Dropout, Conv2D, MaxPool2D, Flatten, GlobalAvgPool2D, concatenate, \
BatchNormalization, Activation, Add, ZeroPadding2D, Lambda
from tensorflow.keras.layers import ReLU
from tensorflow.keras.optimizers import Adam
import matplotlib.pyplot as plt
from tensorflow.keras.callbacks import LearningRateScheduler
from tensorflow.keras.models import Model
- 分组卷积模块
# 定义分组卷积
def grouped_convolution_block(init_x, strides, groups, g_channels):
    group_list = []
    # 分组进行卷积
    for c in range(groups):
        # 分组取出数据
        x = Lambda(lambda x: x[:, :, :, c * g_channels:(c + 1) * g_channels])(init_x)
        # 分组进行卷积
        x = Conv2D(filters=g_channels, kernel_size=(3, 3),strides=strides, padding='same', use_bias=False)(x)
        # 存入list
        group_list.append(x)
    # 合并list中的数据
    group_merage = concatenate(group_list, axis=3)
    x = BatchNormalization(epsilon=1.001e-5)(group_merage)
    x = ReLU()(x)
    return x
- 定义残差单元
# 定义残差单元
def block(x, filters, strides=1, groups=32, conv_shortcut=True):

    if conv_shortcut:
        shortcut = Conv2D(filters * 2, kernel_size=(1, 1), strides=strides, padding='same', use_bias=False)(x)
        # epsilon为BN公式中防止分母为零的值
        shortcut = BatchNormalization(epsilon=1.001e-5)(shortcut)
    else:
        # identity_shortcut
        shortcut = x

    # 三层卷积层
    x = Conv2D(filters=filters, kernel_size=(1, 1), strides=1, padding='same', use_bias=False)(x)
    x = BatchNormalization(epsilon=1.001e-5)(x)
    x = ReLU()(x)
    # 计算每组的通道数
    g_channels = int(filters / groups)
    # 进行分组卷积
    x = grouped_convolution_block(x, strides, groups, g_channels)

    x = Conv2D(filters=filters * 2, kernel_size=(1, 1), strides=1, padding='same', use_bias=False)(x)
    x = BatchNormalization(epsilon=1.001e-5)(x)
    x = Add()([x, shortcut])
    x = ReLU()(x)
    return x
- 堆叠残差单元
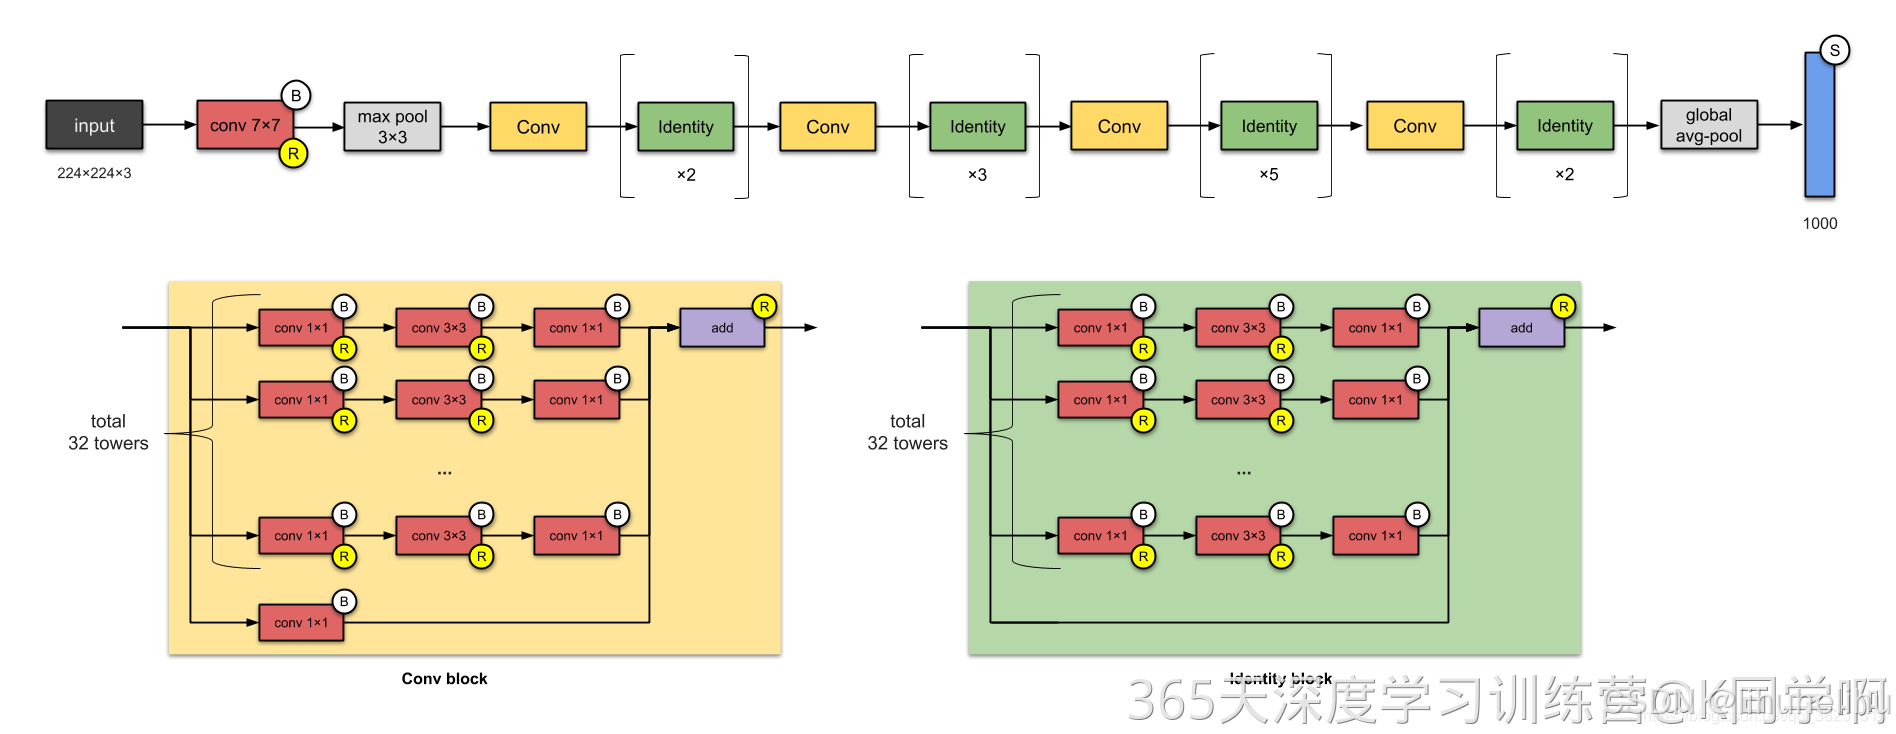
每个stack的第一个block的输入和输出的shape是不一致的,所以残差连接都需要使用1*1卷积升维后才能进行Add操作。
而其他block的输入和输出的shape是一致的,所以可以直接执行Add操作。
# 堆叠残差单元
def stack(x, filters, blocks, strides, groups=32):
    # 每个stack的第一个block的残差连接都需要使用1*1卷积升维
    x = block(x, filters, strides=strides, groups=groups)
    for i in range(blocks):
        x = block(x, filters, groups=groups, conv_shortcut=False)
    return x
- 搭建 ResNext-50 网络
# 定义ResNext50(32*4d)网络
def ResNext50(input_shape, num_classes):
    inputs = Input(shape=input_shape)
    # 填充3圈0,[224,224,3]->[230,230,3]
    x = ZeroPadding2D((3, 3))(inputs)
    x = Conv2D(filters=64, kernel_size=(7, 7), strides=2, padding='valid')(x)
    x = BatchNormalization(epsilon=1.001e-5)(x)
    x = ReLU()(x)
    # 填充1圈0
    x = ZeroPadding2D((1, 1))(x)
    x = MaxPool2D(pool_size=(3, 3), strides=2, padding='valid')(x)
    # 堆叠残差结构
    x = stack(x, filters=128, blocks=2, strides=1)
    x = stack(x, filters=256, blocks=3, strides=2)
    x = stack(x, filters=512, blocks=5, strides=2)
    x = stack(x, filters=1024, blocks=2, strides=2)
    # 根据特征图大小进行全局平均池化
    x = GlobalAvgPool2D()(x)
    x = Dense(num_classes, activation='softmax')(x)
    # 定义模型
    model = Model(inputs=inputs, outputs=x)
    return model
上面不使用ZeroPadding2D也是可以的,令第一个卷积和池化的padding='same’即可。
- 查看模型摘要
model=ResNext50(input_shape=(224,224,3),num_classes=1000)
model.summary()
二、问题

问题:
如果conv_shortcut=False,那么执行“x=Add()…”语句时,通道数不一致的,为什么不会报错?
思考分析:
通过对比查看网络结构和代码后,搞清楚了原因,根本原因就在stack的设计,即一个conv_shortcut=True的block+n个conv_shortcut=False的堆叠残差单元。
下面以filters=128,blocks=2的入参来说明原因。
(1)1个block(conv_shortcut=True):conv_shortcut=True,结合代码可知,在进行Add操作时,是将进行了Conv+BN操作的特征图(filters=2128),与后续[(Conv+BN+ReLU)+ 分组卷积 + (Conv+BN) ]的一系列操作后得出的特征图(filters=2128)进行Add操作,此时Add的两部分的通道数均是2*128,即256,之后再进行ReLU操作;
(2)2个block(conv_shortcut=False):conv_shortcut=False,结合代码可知,在进行Add操作时,是直接对输入的x与后续的[(Conv+BN+ReLU)+ 分组卷积 + (Conv+BN) ]的一系列操作后得出的特征图(filters=2128)进行Add操作。这里为什么add的其中一部分是输入x,是因为此时的输入x,是已经通过上面的1个block操作了,此时x的通道数原本就是2128,即256。因此在进行Add操作时,与后续得出的特征图(filters=2*128)在通道数上完美匹配。
其他filters=256、512、1024则是类似的操作。
更多推荐


 17
 0
- 0


 已为社区贡献1条内容

所有评论(0)