
ID3算法的简单示例
ID3(Iterative Dichotomiser 3)是一种自上而下、贪心、基于信息增益的决策树生成算法。它由J. Ross Quinlan在1986年提出,用于解决分类问题。ID3算法通过构建一棵决策树来进行学习,树的结构取决于数据集中的特征。在构建过程中,ID3选择能够最好地将数据集进行分类的特征作为节点的判断标准。
ID3算法的主要步骤:
- 计算信息增益:对于数据集D和特征A,计算A对D的信息增益,信息增益高的特征具有更好的分类能力。
- 选择最优特征:从当前的特征集合中选择信息增益最高的特征作为决策树的节点。
- 递归构建决策树:基于最优特征将数据集分割成子集,对每个子集递归地调用以上步骤,直到满足停止条件(如信息增益小于阈值、数据集属于同一类别等)。
- 生成决策树:最终生成的树形结构就是决策树,每个内部节点代表一个特征,每个叶节点代表一个类别标签。
信息增益的计算:
信息增益是ID3算法中选择特征的关键指标,它衡量的是特征能够为分类带来的信息量。信息增益的计算依赖于熵(Entropy)和条件熵(Conditional Entropy)。
- 熵:表示随机变量不确定性的度量。
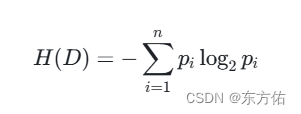
其中,(p_i) 是数据集D中第i类别的概率。
- 条件熵:在已知特征A的条件下,数据集D的熵。
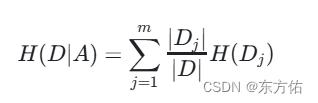
其中,(D_j) 是特征A取值为(j)时的数据子集。
- 信息增益:特征A对数据集D的信息增益。
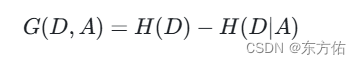
ID3算法的优缺点:
-
优点:易于理解和实现,能够处理不同类型的特征。
-
缺点:可能会产生过拟合,对噪声和离群点敏感,倾向于选择具有大量值的特征。
ID3算法的应用:
ID3算法广泛应用于分类问题,尤其是在需要理解数据中特征关系时。例如,在医疗诊断、信用评分、垃圾邮件检测等领域,ID3算法可以帮助分析特征与目标变量之间的关系。
在实际应用中,ID3算法已经逐渐被其他更先进的算法(如C4.5、CART)所取代,因为它们能够处理更复杂的数据类型,并且具有更好的泛化能力。但ID3算法仍然是数据挖掘和机器学习领域中一个重要的里程碑,对于理解决策树的基本原理非常有帮助。
下面是一个使用Python实现ID3算法的简单示例。这个示例使用了pandas库来处理数据,并计算信息增益以选择最优特征。
首先,确保你已经安装了pandas库。如果没有安装,可以使用pip命令安装:
pip install pandas
然后,你可以使用以下代码来实现ID3算法:
import pandas as pd
import numpy as np
# 计算熵
def entropy(s):
    # 熵是信息的期望值
    p = s.value_counts(normalize=True)  # 计算每个类别的概率
    return -np.sum(p * np.log2(p))  # 计算熵
# 计算信息增益
def information_gain(data, feature, target):
    # 总熵
    total_entropy = entropy(data[target])

    # 特征的条件熵
    values = data[feature].unique()
    conditional_entropy = 0.0
    for value in values:
        subset = data[data[feature] == value]
        prob = len(subset) / len(data)
        conditional_entropy += prob * entropy(subset[target])

    # 信息增益
    return total_entropy - conditional_entropy
# ID3算法
def id3(data, features, target):
    # 如果所有目标变量都相同,返回这个目标变量
    if len(data[target].unique()) == 1:
        return data[target].unique()[0]

    # 如果没有特征可分,返回最普遍的目标变量
    if len(features) == 0:
        return data[target].mode()[0]

    # 计算所有特征的信息增益
    gains = [information_gain(data, feature, target) for feature in features]

    # 选择具有最高信息增益的特征
    best_feature = features[np.argmax(gains)]

    # 创建子树
    tree = {best_feature: {}}
    for value in data[best_feature].unique():
        sub_data = data[data[best_feature] == value]
        sub_features = features.copy()
        sub_features.remove(best_feature)
        subtree = id3(sub_data, sub_features, target)
        tree[best_feature][value] = subtree

    return tree
# 示例数据
data = pd.DataFrame({
    'Outlook': ['Sunny', 'Sunny', 'Overcast', 'Rain', 'Rain', 'Rain', 'Overcast', 'Sunny', 'Sunny', 'Rain', 'Sunny', 'Overcast', 'Overcast'],
    'Temperature': ['Hot', 'Hot', 'Hot', 'Mild', 'Cool', 'Cool', 'Cool', 'Mild', 'Cool', 'Mild', 'Mild', 'Mild', 'Hot'],
    'Humidity': ['High', 'High', 'High', 'High', 'Normal', 'Normal', 'Normal', 'High', 'Normal', 'Normal', 'Normal', 'High', 'Normal'],
    'Wind': ['Weak', 'Strong', 'Weak', 'Weak', 'Weak', 'Strong', 'Strong', 'Weak', 'Weak', 'Weak', 'Strong', 'Strong', 'Weak'],
    'Play': ['No', 'No', 'Yes', 'Yes', 'Yes', 'No', 'Yes', 'No', 'Yes', 'Yes', 'Yes', 'Yes', 'No']
})
# 特征和目标变量
features = ['Outlook', 'Temperature', 'Humidity', 'Wind']
target = 'Play'
# 构建决策树
tree = id3(data, features, target)
print(tree)
这个示例使用了著名的天气预报数据集,其中Play是目标变量,表示是否去打网球。其他特征包括Outlook(天气)、Temperature(温度)、Humidity(湿度)和Wind(风速)。
运行这段代码,你将得到一个决策树,它可以根据输入的特征来判断是否去打网球。这个决策树是基于信息增益来构建的,每次选择具有最高信息增益的特征作为树的节点。
更多推荐



 22
 0
- 0


 已为社区贡献10条内容

所有评论(0)