
【pytorch框架学习】2.手写数字识别问题
一.手写数字分类问题的引入
1.和上节课的关联
这次的手写数字分类问题,是给出一张二维的图片,看看它属于哪一类
二维的图片可以看成一个矩阵,把这个矩阵当成x输入,我们能否找出一个函数y=wx+b,把x带入之后得到y,这个y能对应上它的标签(0~9),再训练一下这个模型,使得每次输出的y与他实际的标签的差值最小,这样我们就可以认为输出的y就是它的标签。
上次的回归问题输出的x是个一维的点,可以用一层线性函数把他表示出来,这次输出的二维矩阵显然不能仅仅用一层线性函数接收。
可以把二维矩阵[28*28]压缩成一维[1*784],这样更好计算。
2.这个问题的函数是什么
这里直接给出了手写数字分类的函数:实际上它是由三层线性函数嵌套而成的
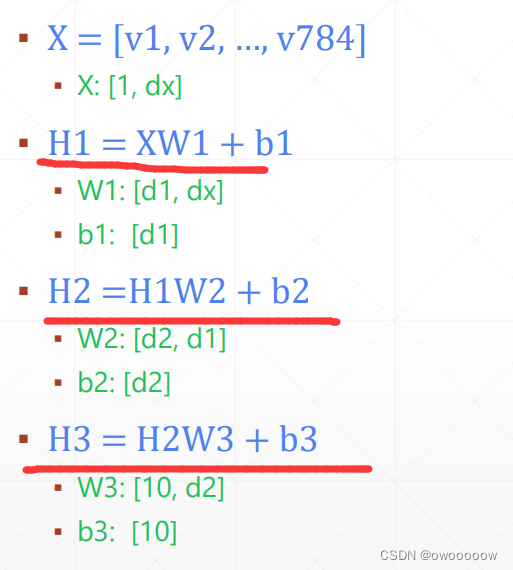
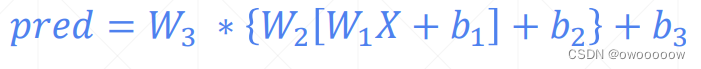
得到了这个函数,那么就像上一个问题一样,写出他的损失函数,利用梯度下降算法迭代求出loss值最小的时候的权值为多少
当得到一个较为准确的权值时,这个模型便训练完成,可以用于手写字体的分类了。
3.这个问题的输出的是什么
只不过,这里的w1,w2,w3和b1,b2,b3为了配合矩阵X的运算,都不再是一个单纯的数字,而是一个矩阵。
最终,输出的H3(pred)也是一个矩阵,H3的维度计算过程如下图所示:
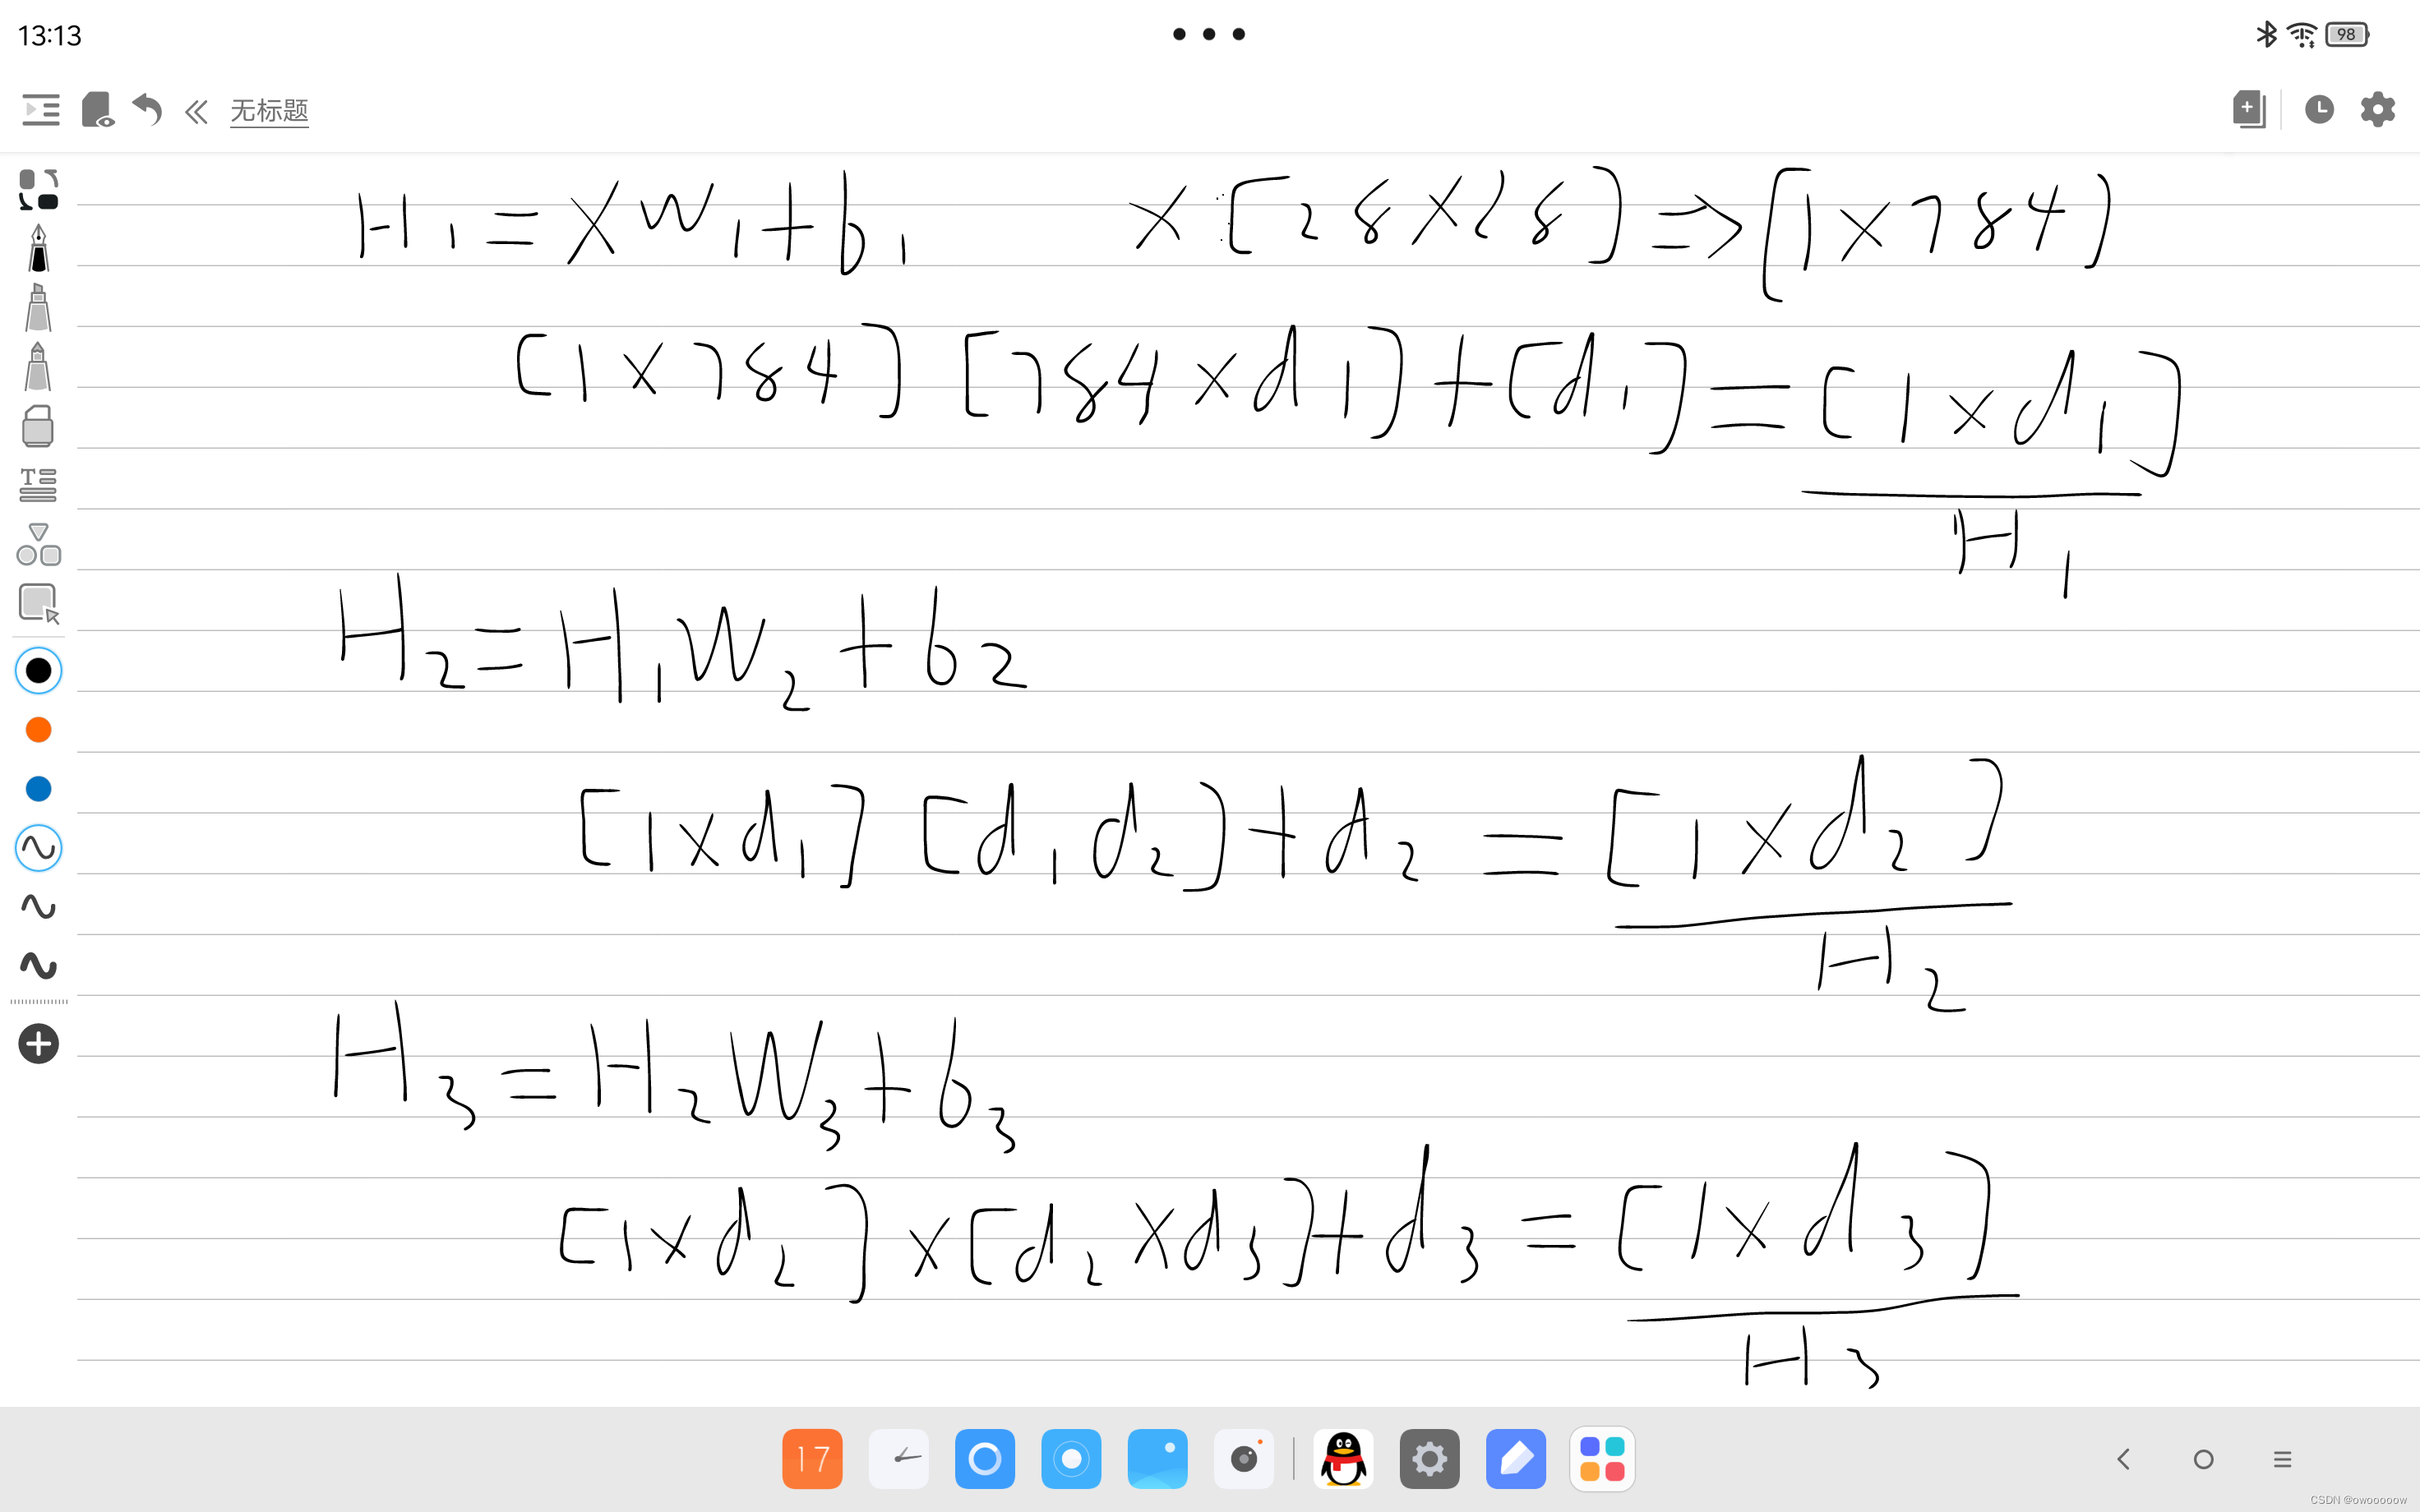
可以看到,经过这个函数,输入一个[1x784]的矩阵X,得到一个[1Xd3]的矩阵H3,这里的d3是由我们的权值w3和b3的维度决定的。
由于函数的权值的维度是灵活的,不妨让d3=10,这样输出的就是一个[1X10]的矩阵,这10位数刚好能代表0~9这十个数字,如下图所示

上图输出的H3代表这个图片是0的概率为0.1,是1的概率为0.8...以此类推。
我们对这个矩阵进行argmax操作,也就是取这个矩阵中最大值的下标,取出来的是1,作为输出,代表这个输入图片经过神经网络的计算,判断出这个数字大概率为1。
4.激活函数
由于实际问题是非线性的,而我们用的都是线性方程,所以需要用激活函数把线程方程变成非线性方程,这里使用较为简单的Relu方程
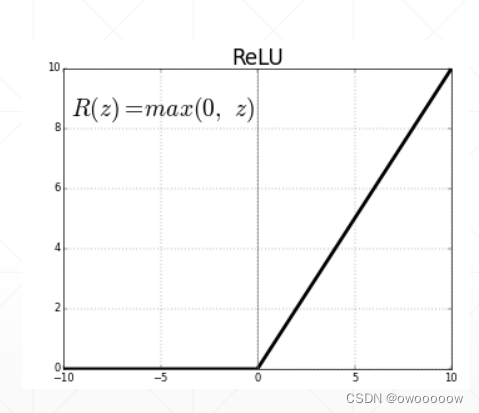
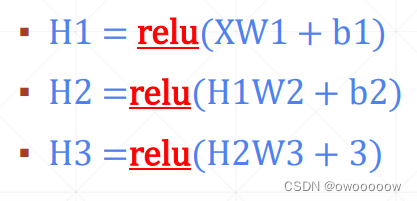
把函数的每一步都加上relu激活函数,这样函数就变成非线性的了。
二.手写字识别问题实战
写在utils.py里面的代码,里面是一些图片输入输出的辅助函数:
import  torch
from    matplotlib import pyplot as plt


def plot_curve(data):
    fig = plt.figure()
    plt.plot(range(len(data)), data, color='blue')
    plt.legend(['value'], loc='upper right')
    plt.xlabel('step')
    plt.ylabel('value')
    plt.show()


def plot_image(img, label, name):#把图片和对应的标签显示出来

    fig = plt.figure()
    for i in range(6):
        plt.subplot(2, 3, i + 1)
        plt.tight_layout()
        plt.imshow(img[i][0]*0.3081+0.1307, cmap='gray', interpolation='none')
        plt.title("{}: {}".format(name, label[i].item()))
        plt.xticks([])
        plt.yticks([])
    plt.show()


def one_hot(label, depth=10):
    out = torch.zeros(label.size(0), depth)
    idx = torch.LongTensor(label).view(-1, 1)
    out.scatter_(dim=1, index=idx, value=1)
    return out
第一步:下载数据集并且取数据集
import  torch
from    torch import nn
from    torch.nn import functional as F
from    torch import optim

import  torchvision
from    matplotlib import pyplot as plt

from    utils import plot_image, plot_curve, one_hot #另一个包里的文件
batch_size = 512 #一次取512张图片
#第一步,取数据
train_loader = torch.utils.data.DataLoader(#获取训练集的数据
    torchvision.datasets.MNIST('mnist_data',train=True,download=True,#三个参数分别为 路径,是否为训练集,是否从网上下载
                                transform=torchvision.transforms.Compose([
                                    torchvision.transforms.ToTensor(),#下载完为numpy格式,把他转化成tensor格式
                                    torchvision.transforms.Normalize(
                                        #为了提高效率,一般要把数据限制在0的左右两侧,但是灰度值图片的数据不是0就是1,
                                        #都在图片的右侧,所以进行normalize操作,让数据均匀分布在0的左右两侧
                                        #这一步也可以不写,但是效率会下降百分之七十
                                        (0.1307,),(0.3081,))
                                ])),
    batch_size=batch_size,shuffle=True)#一次取多少张图片,是否要打乱顺序
test_loader = torch.utils.data.DataLoader(
    torchvision.datasets.MNIST('mnist_data/',train=False,download=True,
                               transform=torchvision.transforms.Compose([
                                   torchvision.transforms.ToTensor(),
                                   torchvision.transforms.Normalize(
                                       (0.1307,),(0.3081,))
                               ])),
    batch_size=batch_size,shuffle=False)
#取出来数据看看是什么样的
x,y = next(iter(train_loader))#把train_loader里面的数据提取出来
print(x.shape,y.shape,x.min(),x.max())#x.shape为[512,1,28,28],表示有512张单通道28*28的图片,y为512个标签
#x的最大值和最小值分别大于小于0,这是取数据时normalize的结果
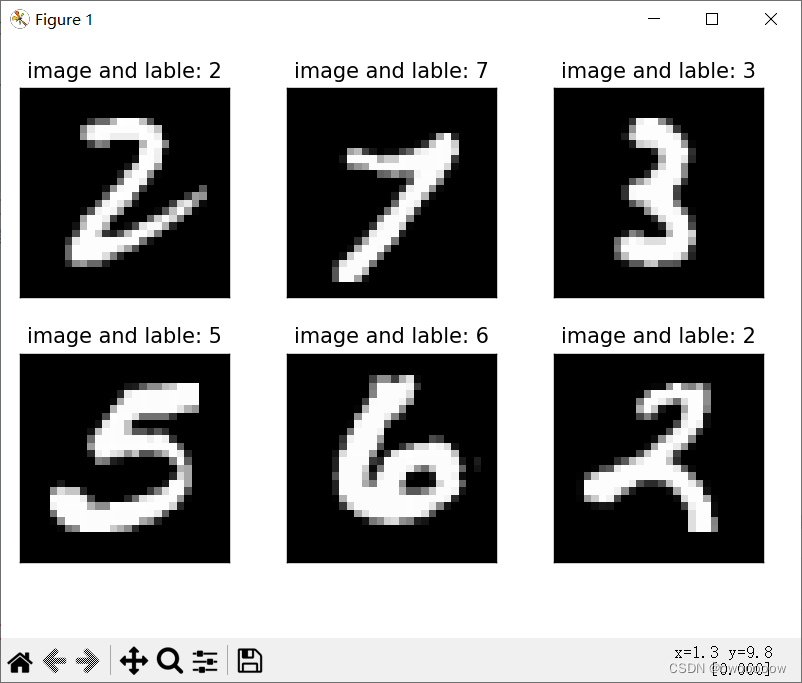
plot_image(x,y,'image and lable')#把这些图片和标签利用plot打印出来,直观的观察
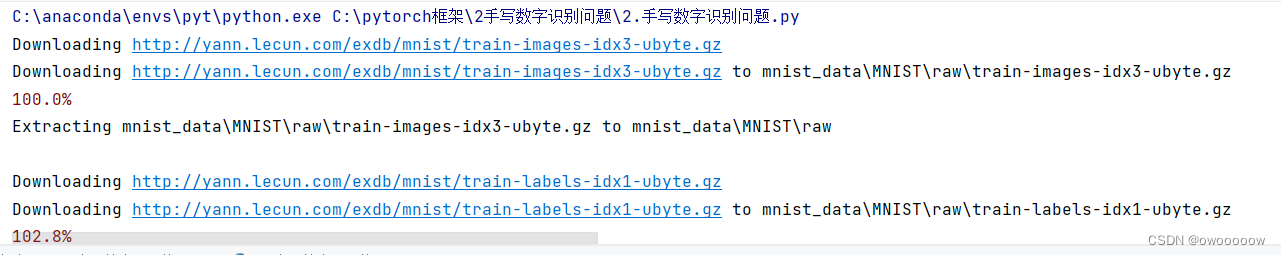
这一部分写完运行后,如果是第一次运行,会自动从网络上下载MNIST数据集,如下图所示
在实践中发现我这个环境下plot不能输出中文,中文会变成“□”
第二步,搭建神经网络
class Net(nn.Module):
    def __init__(self):
        super(Net,self).__init__()
        #神经网络的结构为三层线性网络,第一个参数代表输入的格式,第二个参数代表输出的格式,比如fc1就是输出28*28的矩阵,输出1*256矩阵
        self.fc1 = nn.Linear(28*28,256)#一般除了输入的28*28和最终输出的10,其他的参数都是按照经验自己来设置的
        self.fc2 = nn.Linear(256,64)#一般都是每一层从大到小递减
        self.fc3 = nn.Linear(64,10)
    def forward(self,x):#输入一张图片x,并进行三层运算
        # x: [b, 1, 28, 28]
        # h1 = relu(xw1+b1)
        x = F.relu(self.fc1(x))
        # h2 = relu(h1w2+b2)
        x = F.relu(self.fc2(x))
        # h3 = h2w3+b3
        x = self.fc3(x)
        return x
第三步,训练神经网络
net = Net()
optimizer = optim.SGD(net.parameters(),lr=0.01,momentum=0.9)#梯度下降优化器
train_loss = []#保存每次训练的loss值,便于以后可视化把它画出来
for epoch in range(3):#总共迭代三次
    for batch_idx,(x,y) in enumerate(train_loader):#每次迭代把训练集中的图片跑一遍
        x = x.view(x.size(0),28*28)#把x铺平,便于net接收
        out = net(x)
        y_onehot = one_hot(y)#one_hot操作,把标签y转换成和out格式相同的【b,10】
        loss = F.mse_loss(out,y_onehot)#计算输出和y之间的平方差,也就是loss值
        optimizer.zero_grad()#梯度清零
        loss.backward()#计算梯度
        optimizer.step()#更新梯度
        train_loss.append(loss.item())
        if batch_idx%10==0:#每隔10次训练,打印一下loss,看看是否会下降
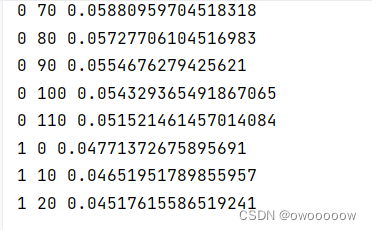
            print(epoch,batch_idx,loss.item())
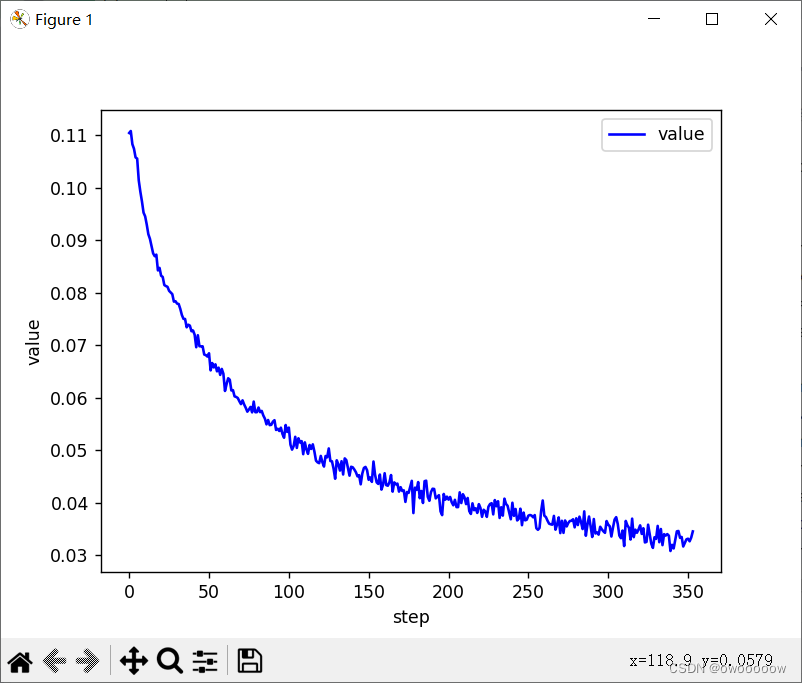
plot_curve(train_loss)#把loss变化的曲线打印出来
每隔10次训练,都会打印出当前的loss值,发现每一次都在稳定下降
第四步,测试神经网络
total_correct = 0
for x,y in test_loader:
    x  = x.view(x.size(0), 28*28)
    out = net(x)
    # out: [b, 10] => pred: [b]
    pred = out.argmax(dim=1)
    correct = pred.eq(y).sum().float().item()#.item是把tensor转换成数据类型
    total_correct += correct#计算正确的数据的数量

total_num = len(test_loader.dataset)
acc = total_correct / total_num
print('test acc:', acc)#打印正确率

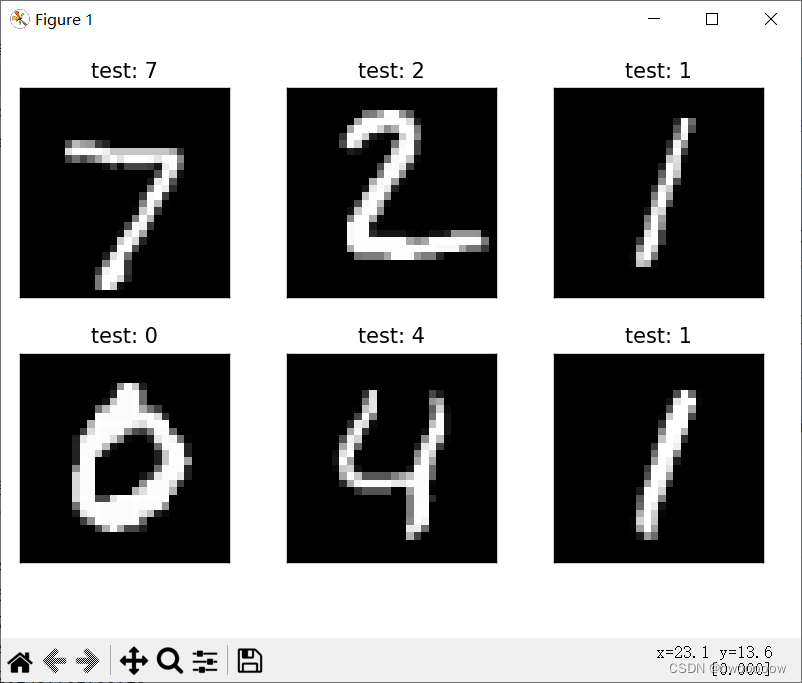
x, y = next(iter(test_loader))
out = net(x.view(x.size(0), 28*28))
pred = out.argmax(dim=1)
plot_image(x, pred, 'test')
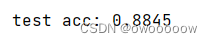
五,拓展
六,完整的代码
import  torch
from    torch import nn
from    torch.nn import functional as F
from    torch import optim

import  torchvision
from    matplotlib import pyplot as plt

from    utils import plot_image, plot_curve, one_hot #另一个包里的文件
batch_size = 512 #一次取512张图片
#第一步,取数据
train_loader = torch.utils.data.DataLoader(#获取训练集的数据
    torchvision.datasets.MNIST('mnist_data',train=True,download=True,#三个参数分别为 路径,是否为训练集,是否从网上下载
                                transform=torchvision.transforms.Compose([
                                    torchvision.transforms.ToTensor(),#下载完为numpy格式,把他转化成tensor格式
                                    torchvision.transforms.Normalize(
                                        #为了提高效率,一般要把数据限制在0的左右两侧,但是灰度值图片的数据不是0就是1,
                                        #都在图片的右侧,所以进行normalize操作,让数据均匀分布在0的左右两侧
                                        #这一步也可以不写,但是效率会下降百分之七十
                                        (0.1307,),(0.3081,))
                                ])),
    batch_size=batch_size,shuffle=True)#一次取多少张图片,是否要打乱顺序
test_loader = torch.utils.data.DataLoader(
    torchvision.datasets.MNIST('mnist_data/',train=False,download=True,
                               transform=torchvision.transforms.Compose([
                                   torchvision.transforms.ToTensor(),
                                   torchvision.transforms.Normalize(
                                       (0.1307,),(0.3081,))
                               ])),
    batch_size=batch_size,shuffle=False)
#取出来数据看看是什么样的
x,y = next(iter(train_loader))#把train_loader里面的数据提取出来
print(x.shape,y.shape,x.min(),x.max())#x.shape为[512,1,28,28],表示有512张单通道28*28的图片,y为512个标签
#x的最大值和最小值分别大于小于0,这是取数据时normalize的结果
plot_image(x,y,'image and lable')#把这些图片和标签利用plot打印出来,直观的观察

#第二部,搭建神经网络
class Net(nn.Module):
    def __init__(self):
        super(Net,self).__init__()
        #神经网络的结构为三层线性网络,第一个参数代表输入的格式,第二个参数代表输出的格式,比如fc1就是输出28*28的矩阵,输出1*256矩阵
        self.fc1 = nn.Linear(28*28,256)#一般除了输入的28*28和最终输出的10,其他的参数都是按照经验自己来设置的
        self.fc2 = nn.Linear(256,64)#一般都是每一层从大到小递减
        self.fc3 = nn.Linear(64,10)
    def forward(self,x):#输入一张图片x,并进行三层运算
        # x: [b, 1, 28, 28]
        # h1 = relu(xw1+b1)
        x = F.relu(self.fc1(x))
        # h2 = relu(h1w2+b2)
        x = F.relu(self.fc2(x))
        # h3 = h2w3+b3
        x = self.fc3(x)
        return x

#第三步,训练神经网络
net = Net()
optimizer = optim.SGD(net.parameters(),lr=0.01,momentum=0.9)#梯度下降优化器
train_loss = []#保存每次训练的loss值,便于以后可视化把它画出来
for epoch in range(6):#总共迭代三次
    for batch_idx,(x,y) in enumerate(train_loader):#每次迭代把训练集中的图片跑一遍
        x = x.view(x.size(0),28*28)#把x铺平,便于net接收
        out = net(x)
        y_onehot = one_hot(y)#one_hot操作,把标签y转换成和out格式相同的【b,10】
        loss = F.mse_loss(out,y_onehot)#计算输出和y之间的平方差,也就是loss值
        optimizer.zero_grad()#梯度清零
        loss.backward()#计算梯度
        optimizer.step()#更新梯度
        train_loss.append(loss.item())
        if batch_idx%10==0:#每隔10次训练,打印一下loss,看看是否会下降
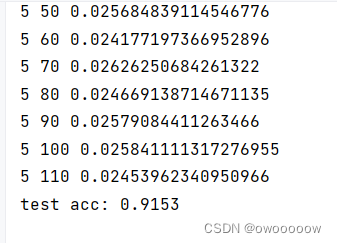
            print(epoch,batch_idx,loss.item())
plot_curve(train_loss)#把loss变化的曲线打印出来

#第四步,测试神经网络
total_correct = 0
for x,y in test_loader:
    x  = x.view(x.size(0), 28*28)
    out = net(x)
    # out: [b, 10] => pred: [b]
    pred = out.argmax(dim=1)
    correct = pred.eq(y).sum().float().item()#.item是把tensor转换成数据类型
    total_correct += correct#计算正确的数据的数量

total_num = len(test_loader.dataset)
acc = total_correct / total_num
print('test acc:', acc)#打印正确率

x, y = next(iter(test_loader))
out = net(x.view(x.size(0), 28*28))
pred = out.argmax(dim=1)
plot_image(x, pred, 'test')
更多推荐

 17
 0
- 0


 已为社区贡献3条内容

所有评论(0)