
KNN算法实战,对糖尿病进行预测
·
算法原理:
KNN的输入是测试数据和训练样本数据集,输出是测试样本的类别。KNN没有显示的训练过程,在测试时,计算测试样本和所有训练样本的距离,根据最近的K个训练样本的类别,通过多数投票的方式进行预测。
数据集:
对Pima印第安人的糖尿病进行预测,数据来源于Kaggle,糖尿病数据集

对数据集的处理:
首先使用pandas加载数据集,并输出形状以及前五行吗,以及阳性和阴性的样本数量
data = pd.read_csv("diabetes.csv")
print("Data shape: {}".format(data.shape))
print(data.head(5))
print(data.groupby("Outcome").size())
输出结果如下:

阴性样本为500例,阳性样本268例。接着,需要对数据集进行简单的处理,把8个特征值分离出来,作为训练数据集,把Outcome列分离出来作为目标值。然后,把数据集划分为训练集和测试集
X = data.iloc[:, 0:8]
y = data.iloc[:, 8]
print("Shape of X: {}, Shape of Y: {}".format(X.shape, y.shape))

from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)
knn拟合数据集:
使用knn算法对数据进行拟合,并进行评分
knn_clf = KNeighborsClassifier(n_neighbors=2)
knn_clf.fit(X_train, y_train)
train_score = knn_clf.score(X_train, y_train)
test_score = knn_clf.score(X_test, y_test)
print("train score=", train_score, "test score=", test_score)
输出结果如下

由于训练样本和测试样本是随机分配的,不同的训练样本和测试样本的组合可能导致最后计算出来的算法准确性存在差异,所以多次随机分配训练集和验证集,然后求模型准确性评分的平均值。我们可以利用scikit-learn提供的KFold和cross_val_score()函数来解决此问题:
kfold = KFold(n_splits=10)
cv_result = cross_val_score(knn_clf, X, y, cv=kfold)
print("cross val score=", cv_result.mean())
输出结果如下:

我们可以进一步画出学习曲线以供更好的观察模型:
def plot_learning_curve(estimator, title, X, y,
			ylim=None, cv=None,n_jobs=None,
			train_sizes=np.linspace(.1, 1.0, 5)):
    plt.figure()
    plt.title(title)
    if ylim is not None:
        plt.ylim(*ylim)
    plt.xlabel("Training examples")
    plt.ylabel("Score")
    train_sizes, train_scores, test_scores = learning_curve(estimator, X, y,
    							cv=cv, n_jobs=n_jobs,
    							train_sizes=train_sizes)
    train_scores_mean = np.mean(train_scores, axis=1)
    train_scores_std = np.std(train_scores, axis=1)
    test_scores_mean = np.mean(test_scores, axis=1)
    test_scores_std = np.std(test_scores, axis=1)
    plt.grid()

    plt.fill_between(train_sizes, train_scores_mean - train_scores_std,
                     train_scores_mean + train_scores_std,
                     alpha=0.1, color="r")
    plt.fill_between(train_sizes, test_scores_mean - test_scores_std,
                     test_scores_mean + test_scores_std,
                     alpha=0.1, color="g")
    plt.plot(train_sizes, train_scores_mean, 'o-', color="r",
    		label="Training score")
    plt.plot(train_sizes, test_scores_mean, 'o-', color="g",
    		label="Cross-validation score")

    plt.legend(loc="best")
    return plt

knn_clf = KNeighborsClassifier(n_neighbors=2)
cv = ShuffleSplit(n_splits=10, test_size=0.2, random_state=0)
plot_learning_curve(knn_clf, "Learning Curve for KNN Diabetes",
                    X, y, (0.0, 1.01), cv=cv)
plt.show()

更多实验:
更换不同的neighbors观察结果:
neighbors = 1时:

可以观察到训练时预测精度很高,但是测试时就很低,是非常典型的过拟合现象。
neighbors = 3 时:

neighbors = 5时:
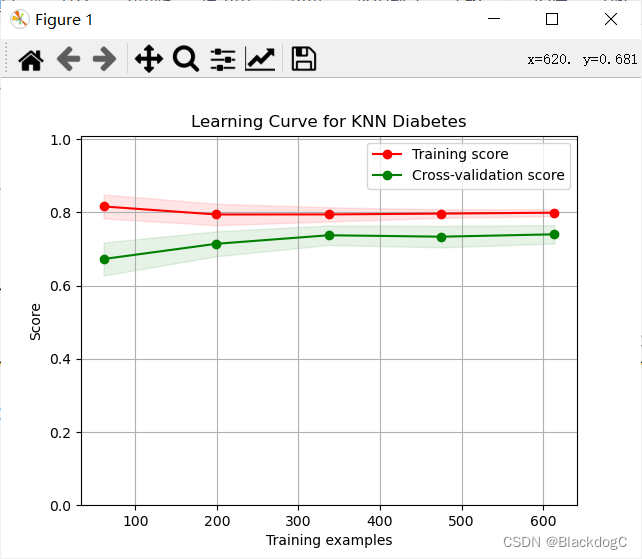
可以观察到当neighbors的值取得较高时,训练精度也欠佳,测试精度也不好,是非常典型都的欠拟合现象。
由于算法的局限性,knn并没有很好的措施能够解决上述两种问题。
更多推荐


 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)