
MobiSys 2023 | mm3DFace: Nonintrusive 3D Facial Reconstruction Leveraging mmWave Signals
MobiSys 2023 | mm3DFace: Nonintrusive 3D Facial Reconstruction Leveraging mmWave Signals
无线感知论文阅读笔记 | MobiSys 2023 mm3DFace: Nonintrusive 3D Facial Reconstruction Leveraging mmWave Signals

Abstract
-
动机
-
Recent emergence of 3D facial reconstruction
🚩 支持许多面部驱动的场景,包括虚拟现实(VR)模型、人机交互和情感计算应用
-
然而,Mainstream vision-based methods 可能会面临隐私问题,并受到障碍场景和光照条件差的影响
-
-
Proposed method
-
mmWave radar-based mm3DFace system ⇒ \Rightarrow ⇒ 非侵入性的3D人脸重建系统mm3DFace,利用毫米波雷达重建连续表现面部表情的3D人脸
🚩 保护隐私 + 不受光照影响
-
step 1 : 基于预处理后的毫米波信号,mm3DFace首先通过ConvNeXt模型和三重损失嵌入提取捕捉面部表情细微变化的面部几何特征
-
step 2 : 然后,mm3DFace使用区域划分仿射变换推导距离加方向稳定的面部形状,具有68个面部标记点
-
step 3 : mm3DFace下一步通过设计的区域放大方法重构面部表情
-
step 4 : 最后通过FLAME模型生成连续表达面部表情的3D面部头像
-
-
Experimental validation
- 15名参与者 + 现实环境
- mm3DFace可以精确跟踪68个面部标记点
- 标准化平均误差为3.94%,平均绝对误差为2.30mm,3D平均绝对误差为4.10mm
1 Introduction
-
3D face reconstruction importance
- 作为人类情感表达和人际交往的主要手段
- 市场范围扩展到人机交互、健康监测、虚拟现实(VR)建模等
-
Challenges of existing solutions
- 视觉方法:可能暴露隐私;光照和非视线(NLOS)情况效果较差
- 可穿戴设备:需要主动佩戴;侵入性;昂贵
- 无法无意识重建人脸
-
Proposed mm3DFace system

-
利用毫米波信号非侵入性重建3D人脸
-
贡献点
🚩 首个基于射频信号的3D面部重建解决方案
🚩 ConvNeXt模型和三重损失嵌入:提取面部表情细微变化特征
🚩 仿射变换和区域放大方法:重建距离和朝向稳定的面部表情;生成连续面部表情3D头像
🚩 实验结果:有效重建不同面部表情;3.94%标准化平均误差;2.30mm平均绝对误差;4.10mm 3D平均绝对误差
-
2 SYSTEM OVERVIEW

- 1 mmWave signal collection and preprocessing
- 2 Facial feature extraction via ConvNeXt model with triple loss embedding
- 通过ConvNeXt模型和三重损失嵌入提取面部特征
- 提取面部几何特征;捕捉面部表情细微变化
- 3 Facial shape reconstruction using affine transformations of different facial regions
- 使用面部不同区域的仿射变换重建面部形状
- 68个面部标记点;距离和朝向稳定
- 4 Facial expression reconstruction via regional amplification method
- 通过区域放大方法重构面部表情
- 放大面部细微变化;重构细节
- 5 3D facial avatar generation through FLAME model
- 基于形状和表情
- 生成连续3D面部头像
下面分别介绍
3 MMWAVE SIGNAL PRE-PROCESSING

- 3.1 mmWave signal transmission and collection
- FMCW
- 3.2 混频 + IF signal
- 3.3 range FFT and AOA
- 3.4 3D facial feature capturing in Range-Angle-Spectrums
- 表示为三维矩阵
- 剥离弱成分;形成3D数据立方体
- 该信号用于后续特征提取
4 FACIAL FEATURE EXTRACTION

4.1 Facial feature representation extraction via ConvNeXt model
-
从范围-角度谱中提取面部特征表示
-
包含四个隐藏层
-
可视化中间特征映射显示面部空间位置和组件关系:

4.2 Facial expression distinguishability investigation
面部表情区分 可行性分析
- 主成分分析面部特征表示分布
- 相同表情聚类;不同表情分离
- 结论:毫米波信号可捕捉面部活动
- 但面部特征表示不能直接揭示面部表情细微差异
- 分辨率限制和易误性
- 解决方案:下文的triple loss

4.3 Facial geometric feature extraction via triple loss embedding
-
在特征级放大不同面部表情;克服分辨率限制
- 投影相同表情到一个嵌入空间;不同表情到不同嵌入空间
- 减小相似表情距离;增加不同表情距离 : ∥ V i a − V i p ∥ 2 2 + γ < ∥ V i a − V i n ∥ 2 2 , ∀ ( V i a , V i p , V i n ) ∈ T \left\|V_i^a-V_i^p\right\|_2^2+\gamma<\left\|V_i^a-V_i^n\right\|_2^2, \forall\left(V_i^a, V_i^p, V_i^n\right) \in \mathcal{T} ∥Via−Vip∥22+γ<∥Via−Vin∥22,∀(Via,Vip,Vin)∈T,
-
三重损失嵌入损失函数
arg min F L = ∑ i N [ max ( ∥ F ( V i a ) − F ( V i p ) ∥ 2 2 − ∥ F ( V i a ) − F ( V i n ) ∥ 2 2 + γ , 0 ) ] , \begin{aligned} \underset{F}{\arg \min } L= & \sum_i^N\left[\max \left(\left\|F\left(V_i^a\right)-F\left(V_i^p\right)\right\|_2^2\right.\right. \\ & \left.\left.-\left\|F\left(V_i^a\right)-F\left(V_i^n\right)\right\|_2^2+\gamma, 0\right)\right],\end{aligned} FargminL=i∑N[max(∥F(Via)−F(Vip)∥22−∥F(Via)−F(Vin)∥22+γ,0)],
- 三元组(正对和负对) ( V a , V p , V n ) \left(V^a, V^p, V^n\right) (Va,Vp,Vn)
- 产生在分辨率有限的毫米波信号下揭示面部表情细微变化的面部几何特征
-
对比PCA:
- 不同表情边界清晰;相同表情紧密聚类
- 毫米波信号捕捉的不同表情在特征级更可分离
5 3D FACIAL RECONSTRUCTION
基于提取的面部几何特征,mm3DFace进一步重建面部形状和面部表情,最后生成3D面部头像
5.1 Facial shape reconstruction via affine transformations
获得68个面部特征点,表示一个人脸
-
Facial shape reconstruction
- 68 facial landmarks represent shape and position
- 直接回归会导致不准确和变形
- 需要 考虑距离和方向
-
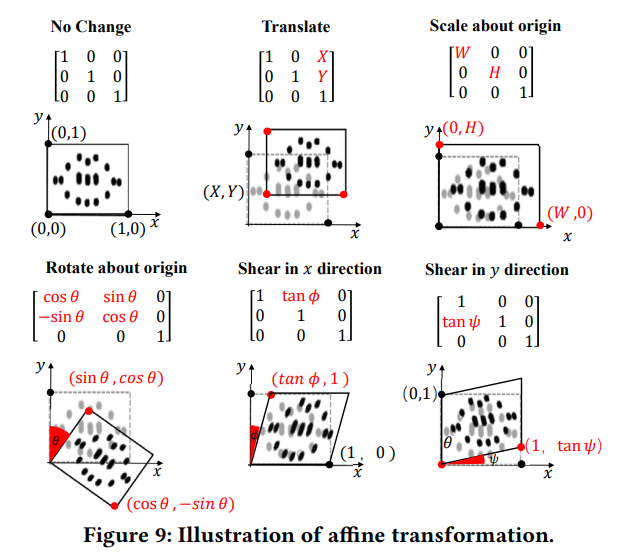
Affine transformation - 仿射变换
-
缩放、旋转、平移和扭曲 ⇒ \Rightarrow ⇒ 内部几何关系
[ x ~ i y ~ i 1 ] = M ⋅ [ x i y i 1 ] = [ m 11 m 12 m 13 m 21 m 22 m 23 0 0 1 ] ⋅ [ x i y i 1 ] \left[\begin{array}{c}\tilde{x}_i \\ \tilde{y}_i \\ 1\end{array}\right]=\mathbf{M} \cdot\left[\begin{array}{c}x_i \\ y_i \\ 1\end{array}\right]=\left[\begin{array}{ccc}m_{11} & m_{12} & m_{13} \\ m_{21} & m_{22} & m_{23} \\ 0 & 0 & 1\end{array}\right] \cdot\left[\begin{array}{c}x_i \\ y_i \\ 1\end{array}\right] x~iy~i1 =M⋅ xiyi1 = m11m210m12m220m13m231 ⋅ xiyi1 ,
-
四个区域:左眼和眉毛、右眼和眉毛、鼻子和轮廓、嘴巴
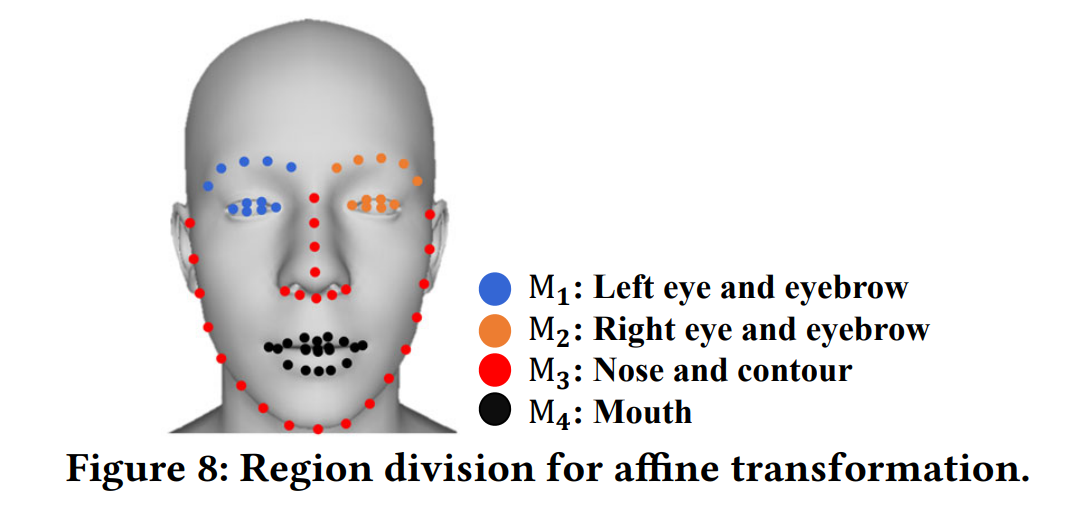
-
线性映射得到四个仿射矩阵
✅ M ^ 1 , M ^ 2 , M ^ 3 , M ^ 4 = G ( F C ( F ( V ) , Θ ′ ) ) \hat{\mathbf{M}}_1, \hat{\mathbf{M}}_2, \hat{\mathbf{M}}_3, \hat{\mathbf{M}}_4=G\left(F C\left(F(V), \Theta^{\prime}\right)\right) M^1,M^2,M^3,M^4=G(FC(F(V),Θ′)) ⇒ \Rightarrow ⇒ 四个区域的affine matrix
✅ the facial shapes of 68 landmarks, T ^ \hat{T} T^, can be expressed as T ^ = Q ( R 1 ( M ^ 1 ) , R 2 ( M ^ 2 ) , R 3 ( M ^ 3 ) , R 4 ( M ^ 4 ) ) \hat{T}=Q\left(R_1\left(\hat{\mathbf{M}}_1\right), R_2\left(\hat{\mathbf{M}}_2\right), R_3\left(\hat{\mathbf{M}}_3\right), R_4\left(\hat{\mathbf{M}}_4\right)\right) T^=Q(R1(M^1),R2(M^2),R3(M^3),R4(M^4))
-
-
Loss function design
-
根据预测仿射矩阵和真值特征点距离设计
-
平滑L1损失
L P ( M ^ i ) = { ( M i − M ^ i ) 2 2 δ ∣ M i − M ^ i ∣ ≤ δ ∣ M i − M ^ i ∣ − 1 2 δ ∣ M i − M ^ i ∣ > δ L_P\left(\hat{\mathbf{M}}_i\right)=\left\{\begin{array}{ll}\frac{\left(\mathbf{M}_i-\hat{\mathbf{M}}_i\right)^2}{2 \delta} & \left|\mathbf{M}_i-\hat{\mathbf{M}}_i\right| \leq \delta \\ \left|\mathbf{M}_i-\hat{\mathbf{M}}_i\right|-\frac{1}{2} \delta & \left|\mathbf{M}_i-\hat{\mathbf{M}}_i\right|>\delta\end{array}\right. LP(M^i)=⎩ ⎨ ⎧2δ(Mi−M^i)2 Mi−M^i −21δ Mi−M^i ≤δ Mi−M^i >δ,
-
离群点阈值δ用于离群点参数检测
-
求四个仿射矩阵的损失函数 L o = ∑ i = 1 4 L P ( M ^ i ) L_{\boldsymbol{o}}=\sum_{i=1}^4 L_P\left(\hat{\mathbf{M}}_i\right) Lo=∑i=14LP(M^i)
-
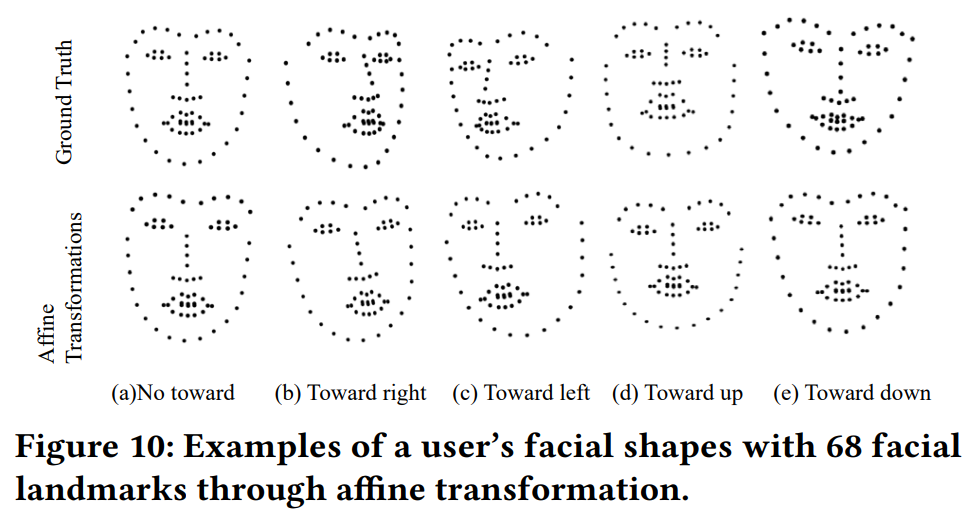
仿射矩阵示例
- 嘴巴区域仿射变换
- m13和m23平移;m11,m12,m21和m22旋转
- 特征点变化;不同形状表达
- 面部不同方向特征点位置准确相似
5.2 Facial expression reconstruction via regional amplification
-
5.2.1 Regional amplification method
- 利用mmWave信号特征划分空间和提取特征
- 原因:提供详细特征;放大分辨率有限下的细微变化
- 定位左眼、右眼和嘴巴范围;设置子段定位其他区域
- 圆确定中心坐标和半径
-
5.2.2 Spatial scope determination - 空间范围确定
- 中心坐标从仿射矩阵参数映射
- 半径从幅度变化在信号级别确定
- 幅度变化阈值 ε \varepsilon ε: r ^ i = max r i , j s.t. ∥ E m ( y i , z i , r i , j ) − E m ( y i , z i , r i , j − 1 ) ∥ ≤ ε , r i , j = r i , j − 1 + Δ r , i = 1 , 2 , 4 ; j = 1 , 2 , 3 … , \begin{aligned} & \hat{r}_i=\max r_{i, j} \\ & \text { s.t. }\left\|E_m\left(y_i, z_i, r_{i, j}\right)-E_m\left(y_i, z_i, r_{i, j-1}\right)\right\| \leq \varepsilon, \\ & r_{i, j}=r_{i, j-1}+\Delta r, i=1,2,4 ; j=1,2,3 \ldots,\end{aligned} r^i=maxri,j s.t. ∥Em(yi,zi,ri,j)−Em(yi,zi,ri,j−1)∥≤ε,ri,j=ri,j−1+Δr,i=1,2,4;j=1,2,3…,
-
5.2.3 mmWave signal representation
-
提取器U(·)提取范围内mmWave信号
-
νi第i个区域mmWave信号幅度;ν:整个面部
-
ν3 = ν −ν1 −ν2 −ν4
✅ v i = U ( y i , z i , r ^ i ) , i = 1 , 2 , 4 , v = v 1 ∪ v 2 ∪ v 3 ∪ v 4 v_i=\mathrm{U}\left(y_i, z_i, \hat{r}_i\right), i=1,2,4, v=v_1 \cup v_2 \cup v_3 \cup v_4 vi=U(yi,zi,r^i),i=1,2,4,v=v1∪v2∪v3∪v4
-
-
5.2.4 Regional feature extraction
- 专注于特定区域;排除其他区域
- 填充零掩蔽其他区域;目标区域mmWave信号输入网络
- 面部几何特征Si: S i = F ( G ′ ( v i ) ) , i = 1 , 2 , 3 , 4 S_i=F\left(G^{\prime}\left(v_i\right)\right), i=1,2,3,4 Si=F(G′(vi)),i=1,2,3,4
-
5.2.5 Facial expression reconstruction
-
Hi每个区域外观与特征点: H i = F C i ( S i ) , i = 1 , 2 , 3 , 4 H_i=F C_i\left(S_i\right), i=1,2,3,4 Hi=FCi(Si),i=1,2,3,4,
-
结合不同区域外观得到68个表情特征点T’: T ′ = G ˉ ( H 1 , H 2 , H 3 , H 4 ) T^{\prime}=\bar{G}\left(H_1, H_2, H_3, H_4\right) T′=Gˉ(H1,H2,H3,H4)
-
T = T ^ + T ′ \hat{T} + T' T^+T′; T ^ \hat{T} T^形状;T’表情
-
生成表情损失Ld:
L d = { ( T − T ~ ) 2 2 δ ∣ T − T ~ ∣ ≤ δ ∣ T − T ~ ∣ − 1 2 δ ∣ T − T ~ ∣ > δ L_d=\left\{\begin{array}{ll}\frac{(T-\tilde{T})^2}{2 \delta} & |T-\tilde{T}| \leq \delta \\ |T-\tilde{T}|-\frac{1}{2} \delta & |T-\tilde{T}|>\delta\end{array}\right. Ld={2δ(T−T~)2∣T−T~∣−21δ∣T−T~∣≤δ∣T−T~∣>δ,
-
全局损失 L g = L o + α ( t ) L d L_g=L_o+\alpha(t) L_d Lg=Lo+α(t)Ld
-
α(t)训练进度百分比;平衡形状和表情损失
-
5.3 3D facial avatar generation
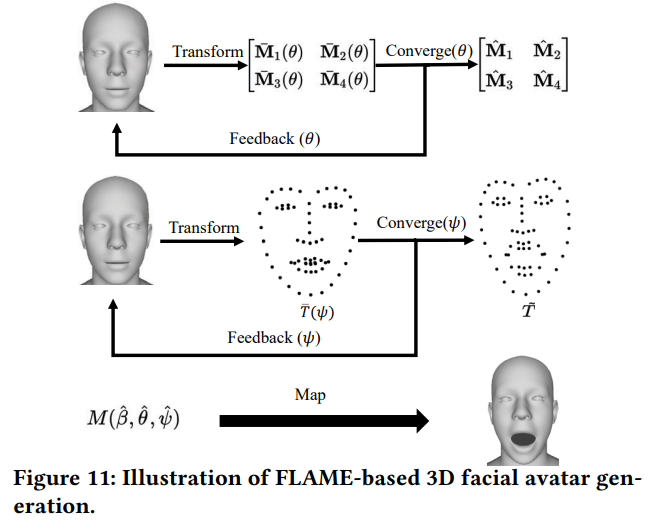
-
5.1 FLAME model - FLAME模型
- 5023顶点,4关节,混合形态
- 显式生成头部姿势和表情3D模型
- 4部分:模板网格,形状混合形态,姿势混合形态,表情混合形态
- M ( β , θ , Ψ ) : R ∣ β ∣ × ∣ θ ∣ × ∣ Ψ ∣ → R 3 N M(\beta,\theta,\Psi):R|\beta|×|\theta|×|\Psi|→R3N M(β,θ,Ψ):R∣β∣×∣θ∣×∣Ψ∣→R3N
-
5.2 Parameter obtainment - 参数获取
-
由于专注于连续表情重建,采用固定形状参数 β \beta β
-
Pose parameter θ \theta θ
✅ 四个仿射矩阵最小化3D通用面部模型矩阵与面部形状矩阵距离
✅ 连续调整 θ \theta θ,模型矩阵收敛到面部形状矩阵: θ ^ = arg min θ ∑ i = 1 4 ∥ M ‾ i ( θ ) − M ^ i ∥ 2 2 \hat{\theta}=\underset{\theta}{\arg \min } \sum_{i=1}^4\left\|\overline{\mathbf{M}}_i(\theta)-\hat{\mathbf{M}}_i\right\|_2^2 θ^=θargmin∑i=14 Mi(θ)−M^i 22
-
expression parameter Ψ \Psi Ψ
✅ 68个特征点最小化3D面部模型生成特征点与面部表情生成特征点距离
✅ 连续调整ψ,模型生成特征点收敛到表情生成特征点: ψ ^ = arg min ψ ∥ T ˉ ( ψ ) − T ~ ∥ 2 2 \hat{\psi}=\underset{\psi}{\arg \min }\|\bar{T}(\psi)-\tilde{T}\|_2^2 ψ^=ψargmin∥Tˉ(ψ)−T~∥22
-
-
5.3 3D avatar generation
- 将优化参数 β , θ \beta,\theta β,θ和 Ψ \Psi Ψ映射到3D面部模型顶点
- 生成连续表达表情的3D面部头像
6 EVALUATION
6.1 Evaluation Setup
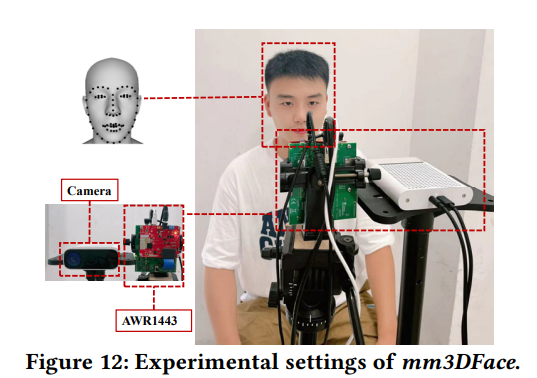
- Experimental setup
- TI AWR 1443 + DCA1000EVM
- 三发射天线;四接收天线;77-81GHz线性调频信号;128脉冲/50ms;512采样/脉冲
- 后端PORSER W-2150B;深度摄像头真值;Dlib生成2D/3D真值特征点
- 实验室,会议室,走廊;15志愿者;自然连续面部活动
- 5折交叉验证;4子数据集训练;1子数据集+剩余20%测试
- 学习率0.0005;批大小32;周期数500
- Evaluation metrics
- MAE:预测与真值特征点距离均方误差
- 3D-MAE:3D头像生成3D特征点与3D真值特征点距离均方误差
- NME:预测与真值特征点误差除以双眼距离归一化误差
- F score:精确度与召回率调和平均值
6.2 Overall Performance
-
Overall performance evaluation
-
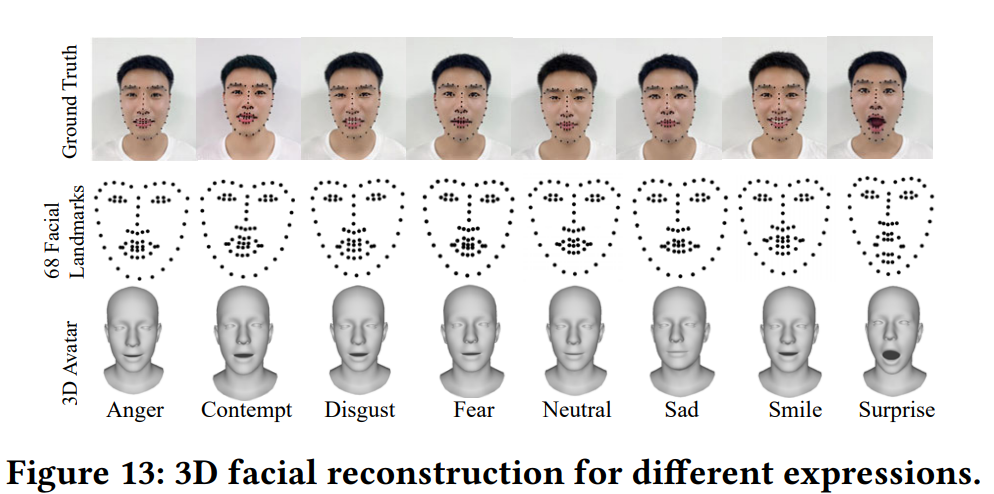
重建不同表情3D人脸;准确定位68特征点;精确3D形象
-
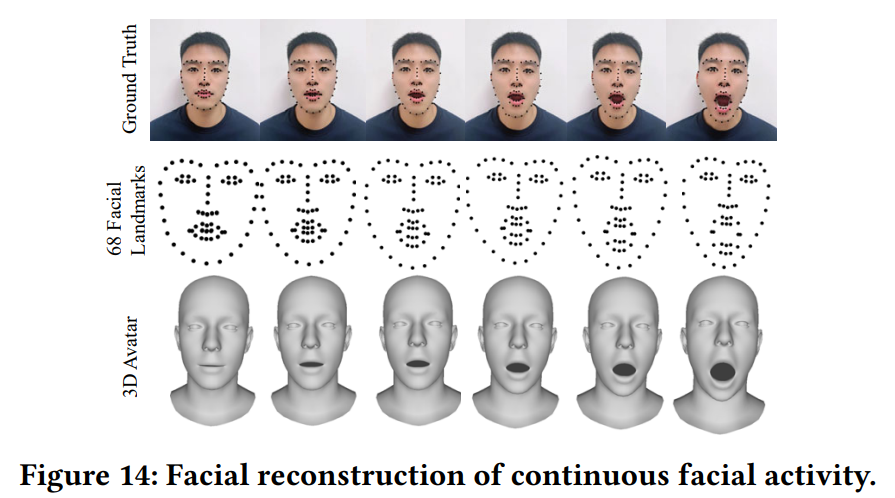
重建连续面部活动;处理微妙面部变化
-
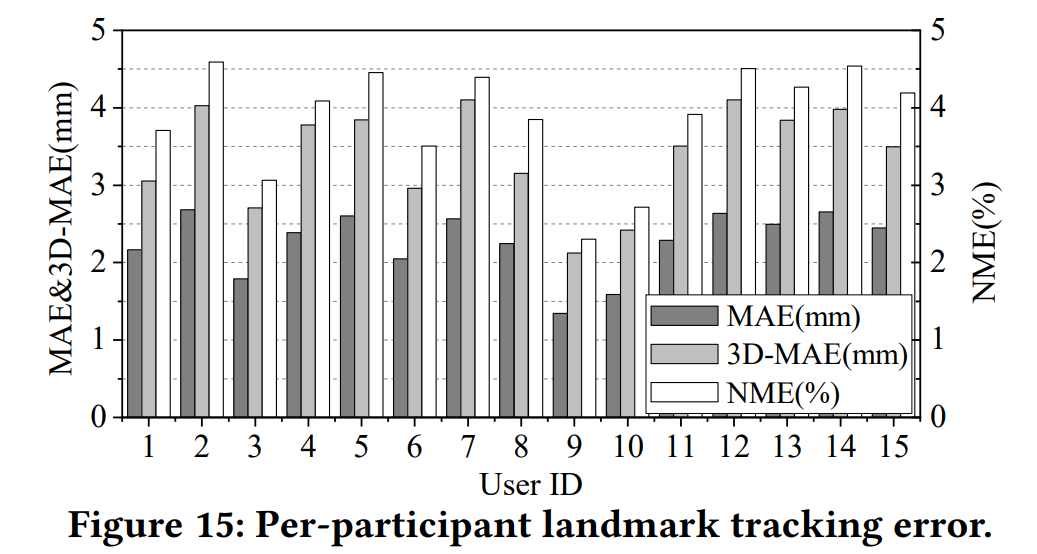
平均MAE 2.30mm;3D-MAE 4.10mm;NME 3.94%
-
不同用户MAE、3D-MAE、NME差异小;有效性和稳定性
-
-
Facial region performance - 面部区域性能
-
不同区域特征点跟踪性能差异小
-
嘴巴和眼睛MAE/3D-MAE较高;面部活动主要表达部位
-
80%嘴巴MAE<3.48mm;3D-MAE<5.91mm
-
80%眼睛MAE<2.96mm;3D-MAE<5.91mm
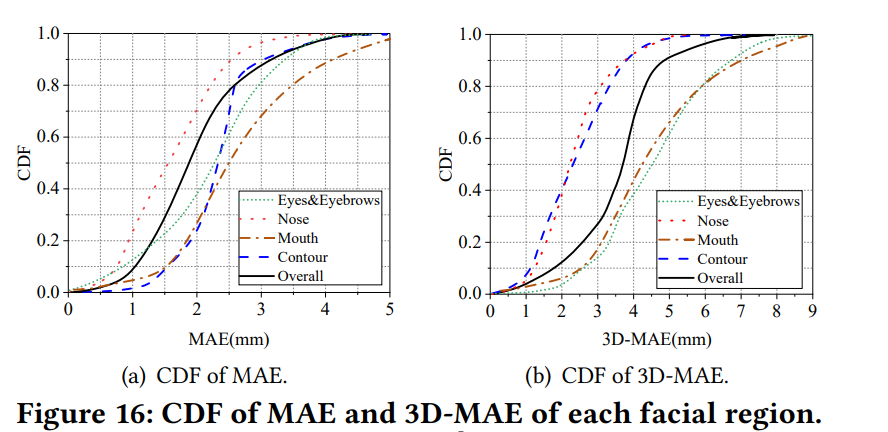
-
-
Trained and untrained user performance
-
5折交叉验证;4子数据集训练;1测试
-
训练与未训练3D-MAE差异小;平均差异0.08mm;最大差异0.10mm
-
不同交叉验证轮次变化小
-
泛化能力
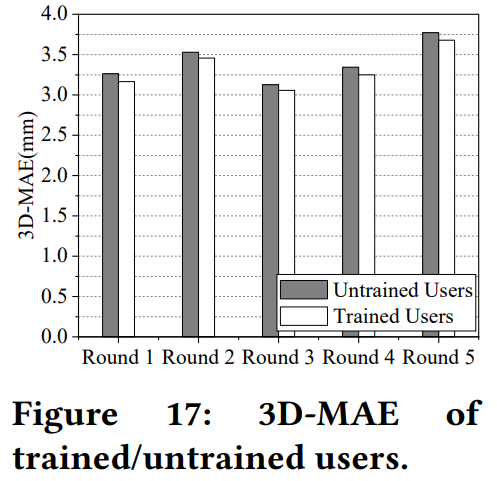
-
6.3 Comparison with Existing Methods
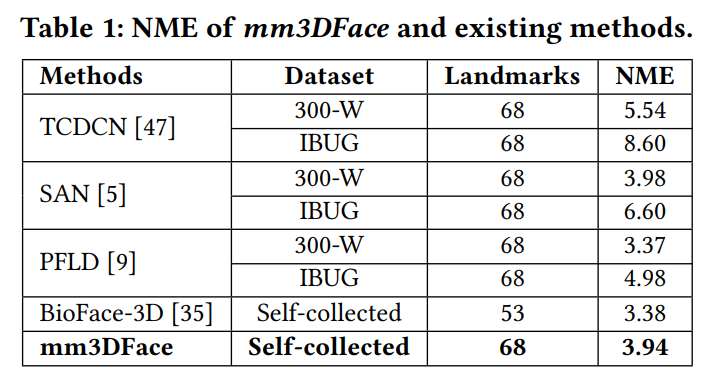
-
ESR、TCDCN和SAN 基于视觉
-
BioFace-3D 基于可穿戴传感器
-
68特征点,与视觉方法性能相当
- 证明mmWave信号方法与视觉方法可比
6.4 Facial expression recognition
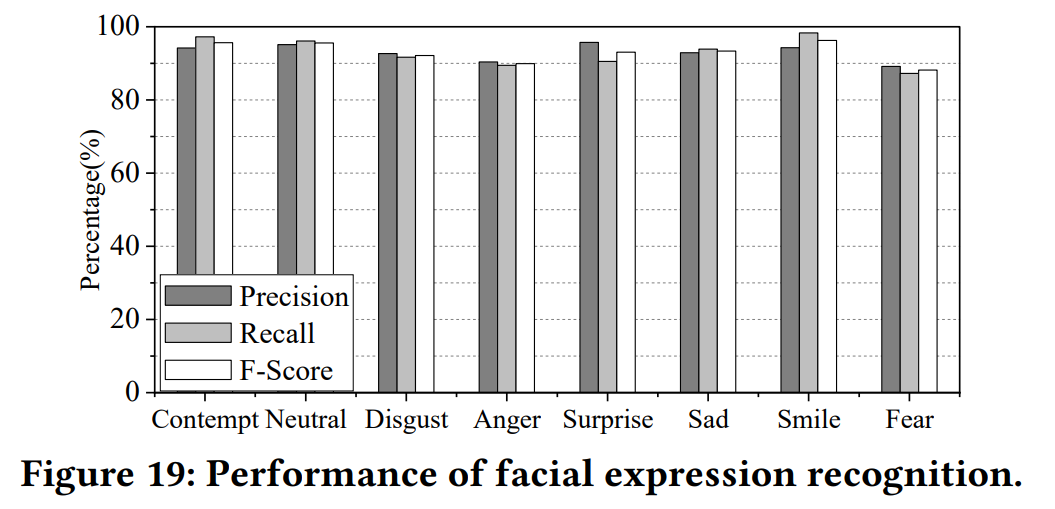
- 添加线性层和softmax层;冻结层;交叉熵损失
- 8种面部表情;连续采集评估
- 93.04%精度;93.06%召回率;93.03%F-score;证明有效
- 不同表情准确度差异: 愤怒、恐惧较低
其他实验
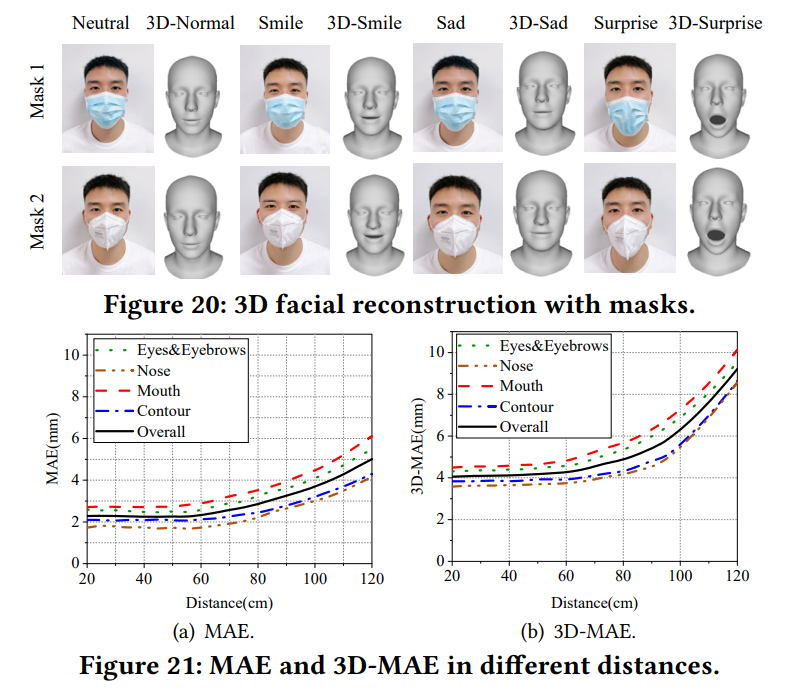
- Impact of mask
- 评估NLOS;手术口罩、N95口罩
- 重建戴口罩3D人脸;准确
- 带/不带口罩MAE/3D-MAE差异小;穿透障碍物,捕获障碍物后信息
- Impact of distance
- 距离20-120cm;手动标注评估
- 20-60cm MAE/3D-MAE稳定,较低误差;60-120cm逐渐增加
- 120cm,MAE 5.01mm,3D-MAE 9.21mm;表达面部表情
-
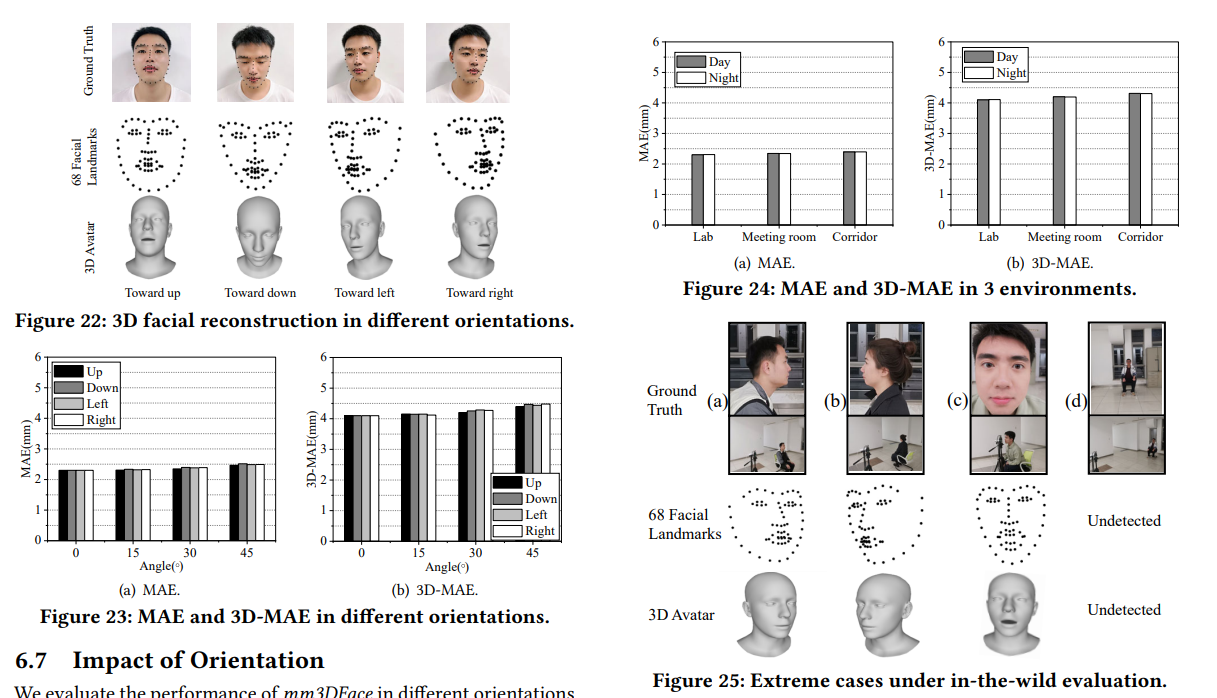
Impact of orientation
- 0-45°,15°步长,四个方向;60cm距离
- 不同方向跟踪误差差异小;MAE 2.50mm,3D-MAE 4.45mm
- 仿射变换有效旋转特征点到实际方向
-
Impact of background
- 空实验室、会议室、走廊;日间/夜间
- 夜间完全黑暗,额外照明真值
- 不同光照条件/背景环境稳健
- 环境MAE/3D-MAE差异小;0.09mm和0.20mm;定位空间位置,捕获特征
-
In-the-wild evaluation
- 不受位置限制的自然面部活动
- MAE 4.31mm,3D-MAE 7.69mm,NME 7.38%
- 极端情况下失败;面部左/右,0.05/3m距离
- 格式约束,表达部分结构面部,难以表达方向/表情
-
Time Consumption
- 平均 178 ms
- 90% 小于 225 ms
7 RELATED WORK
- 人脸重建
- 视觉方法(3DMM,深度学习)
- 可穿戴设备(电容、磁、压电、EMG/EEG)
- 单设备,侵入,限制应用
- mmWave sensing
- 通信、汽车、工业;
- 行为识别、生命体征、声音、人体识别、定位;
- 面部认证,身份分类
- 人体重建
- mmMesh,m3Track,M4esh
- 参数估计,难表达微妙表情
8 DISCUSSION
- Multi-user 3D facial reconstruction
- mmWave信号捕获多个物体;分离特征文件,单独重建
- 3用户,MAE 3.87mm,3D-MAE 6.73mm
- 3D facial shape parameters estimation
- 重建连续表情,忽略形状参数
- 3D头像表达表情,不表达用户特征
- 更多样本,回归个性化形状参数,重建个性化3D头像
9 CONCLUSION
- 非侵入性3D面部重建系统 mm3DFace
mmWave雷达跟踪特征点,重建3D人脸
- ConvNeXt+三重损失提取几何特征
- 区域仿射变换重建距离/方向鲁棒面部形状
- 区域放大法重建表情;连续面部头像
- 真实环境实验证明效果
更多推荐


 0
 0
- 0


 已为社区贡献4条内容

所有评论(0)