
推荐算法论文:Deep Neural Networks for YouTube Recommendations
·
吹牛逼
按照经典的信息检索方式讲推荐系统划分为两部分
- 深度候选生成模型
- 深度排序模型
1. 介绍
youtube推荐系统面临的三个问题
- 规模:当前的推荐算法可以很好的解决数据量较小的问题,但是针对YouTube这种量级的用户和物料,必须使用专业的分布式训练平台。
- 新鲜度:youtube每天会产生非常多的新内容,推荐系统需要有足够的相应能力来处理新内容,做好新物料的探索和应用
- 噪声:由于稀疏性和各种不可观察的外部因素,YouTube 上的历史用户行为本质上难以预测。并且没有用户的显示反馈,所以需要进行隐式建模,这就要求算法有一定的鲁棒性。
- 反正就是,神经网络已经被应用在各种推荐之中,但是我知道他们都没有我牛逼
系统回顾
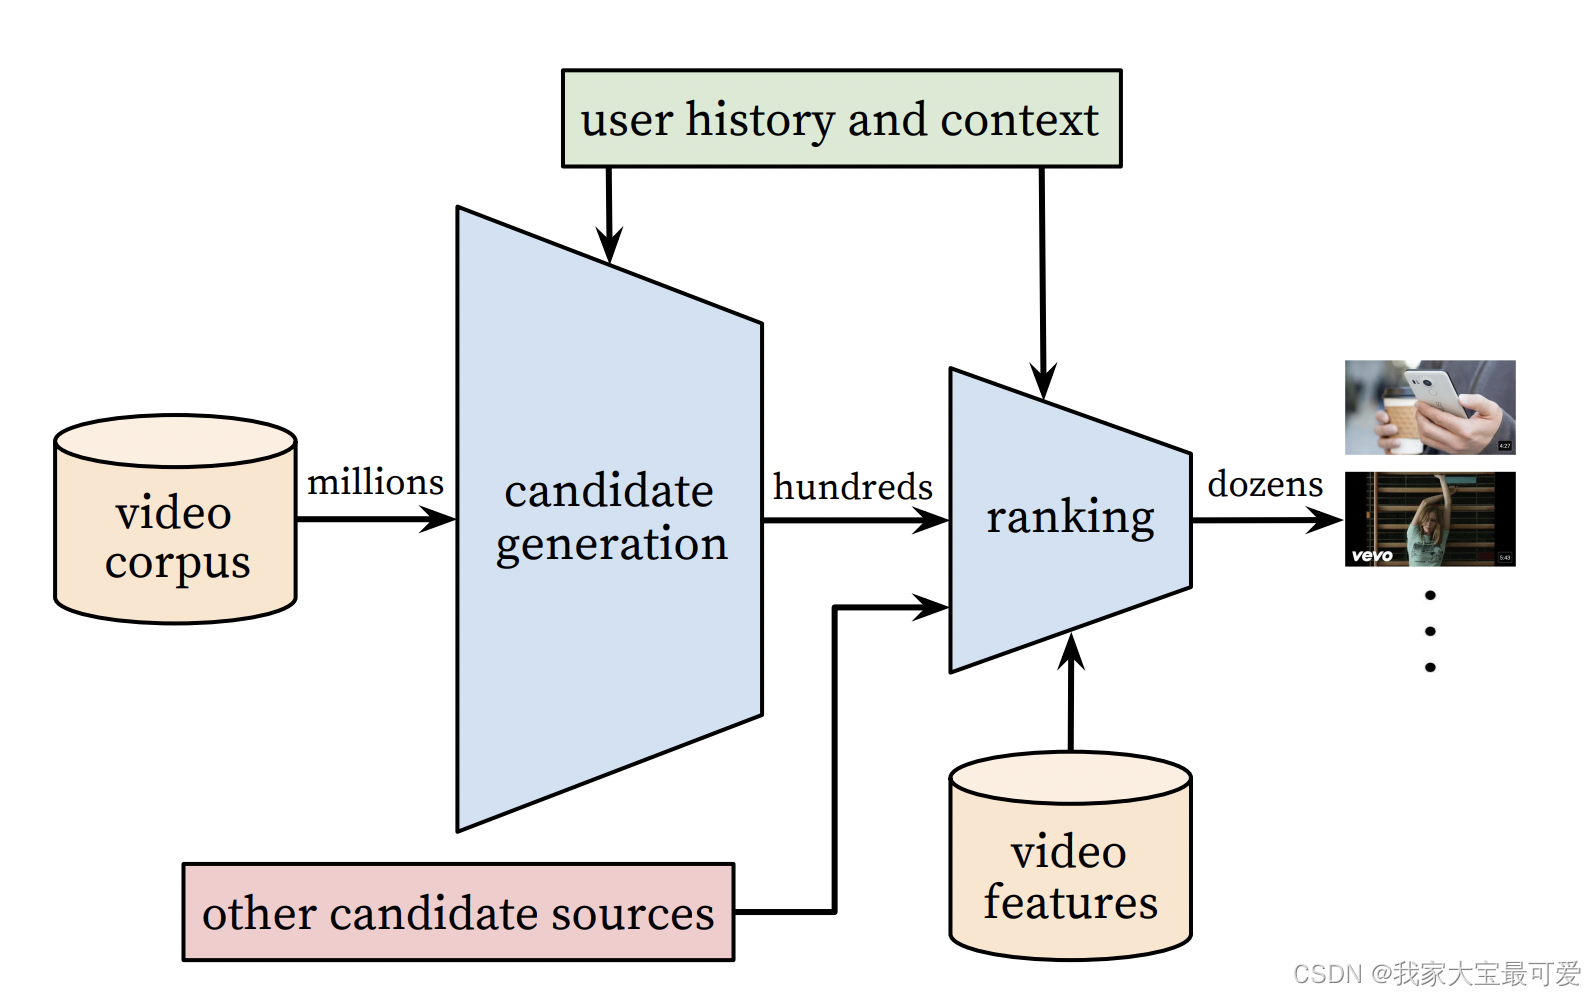
整个系统分为两个部分
- 候选网络。输入用户之前的行为,然后从百万级的物料中召回几百个与用户兴趣相关的物料,候选网络仅仅使用协同过滤来提供个性化召回。用户之间的相似性则使用粗略的特征来表示,例如之前看过的视频ID,一些用户维度的统计特征等;
- 排序网络。召回的物料已经有了一些区分,但是需要更多丰富的特征来对用户和物料进行建模,然后按照打分的顺序给用户推荐。
- 这种设计方式可以从大量的物料中筛选中用户感兴趣的商品,依然可以保证个性化,并且很容易增加其他方式的召回源。
- 离线评估指标主要有准召,logloss,auc这些,这些指标可以指导模型的迭代,但是为了确定模型的有效性,我们需要上线AB实验。线上可以观测到点击率,观看时长和其他衡量指标,AB实验可以直接观测模型带来的增量,但是很多时候离线指标好,并不一定与线上AB一致。
3 候选网络(召回)
候选网络可以在海量的物料中筛选出与用户相关的商品,候选网络使用基于MF的方法,但这里做了非线性优化。
3.1 推荐
- 将推荐看作多分类任务,预测问题转化为多分类的问题,即给定用户U和上下文C,预测物料集合中某个商品的分数
P(wt=i∣U,C)=eviu∑j∈VevjuP(w_t=i|U,C)=\frac{e^{v_iu}}{\sum_{j \in V}e^{v_ju} }P(wt=i∣U,C)=∑j∈Vevjueviu
其中,uuu表示用户的embedding向量,viv_ivi表示商品i的embedding向量,V为物料库的大小。神经网络主通过用户历史行为和上下文特征学习uuu的embedding。 - 显示反馈(点赞,问卷等)极其稀疏,使用隐式反馈可以大大增加数据量,更好的提供推荐。
- 为了有效的训练这种数百万类别的模型,使用了负采样的方法,然后通过重要性加权来纠正。实践中会采样几千个负样本,这会导致训练很慢,一种简单的方法是使用分层softmax,但在使用分层softmax中,遍历树中的节点通常是与用户偏好不相关的累,这使得分类问题变的更加困难并且会降低性能。
- 线上服务时,需要计算出排分最高的N个视频,但是RT时线性增长的,数百万个物料打分的时间是不可想象的。因此,YouTube之前使用的方法是散列,并且由于softmax打分不需要使用准确的分数,直接比较点积的大小即可,因此转化为点积空间中最近邻搜索,而且线上AB实验表明最近邻搜索并不会影响效果。
3.2 模型结构
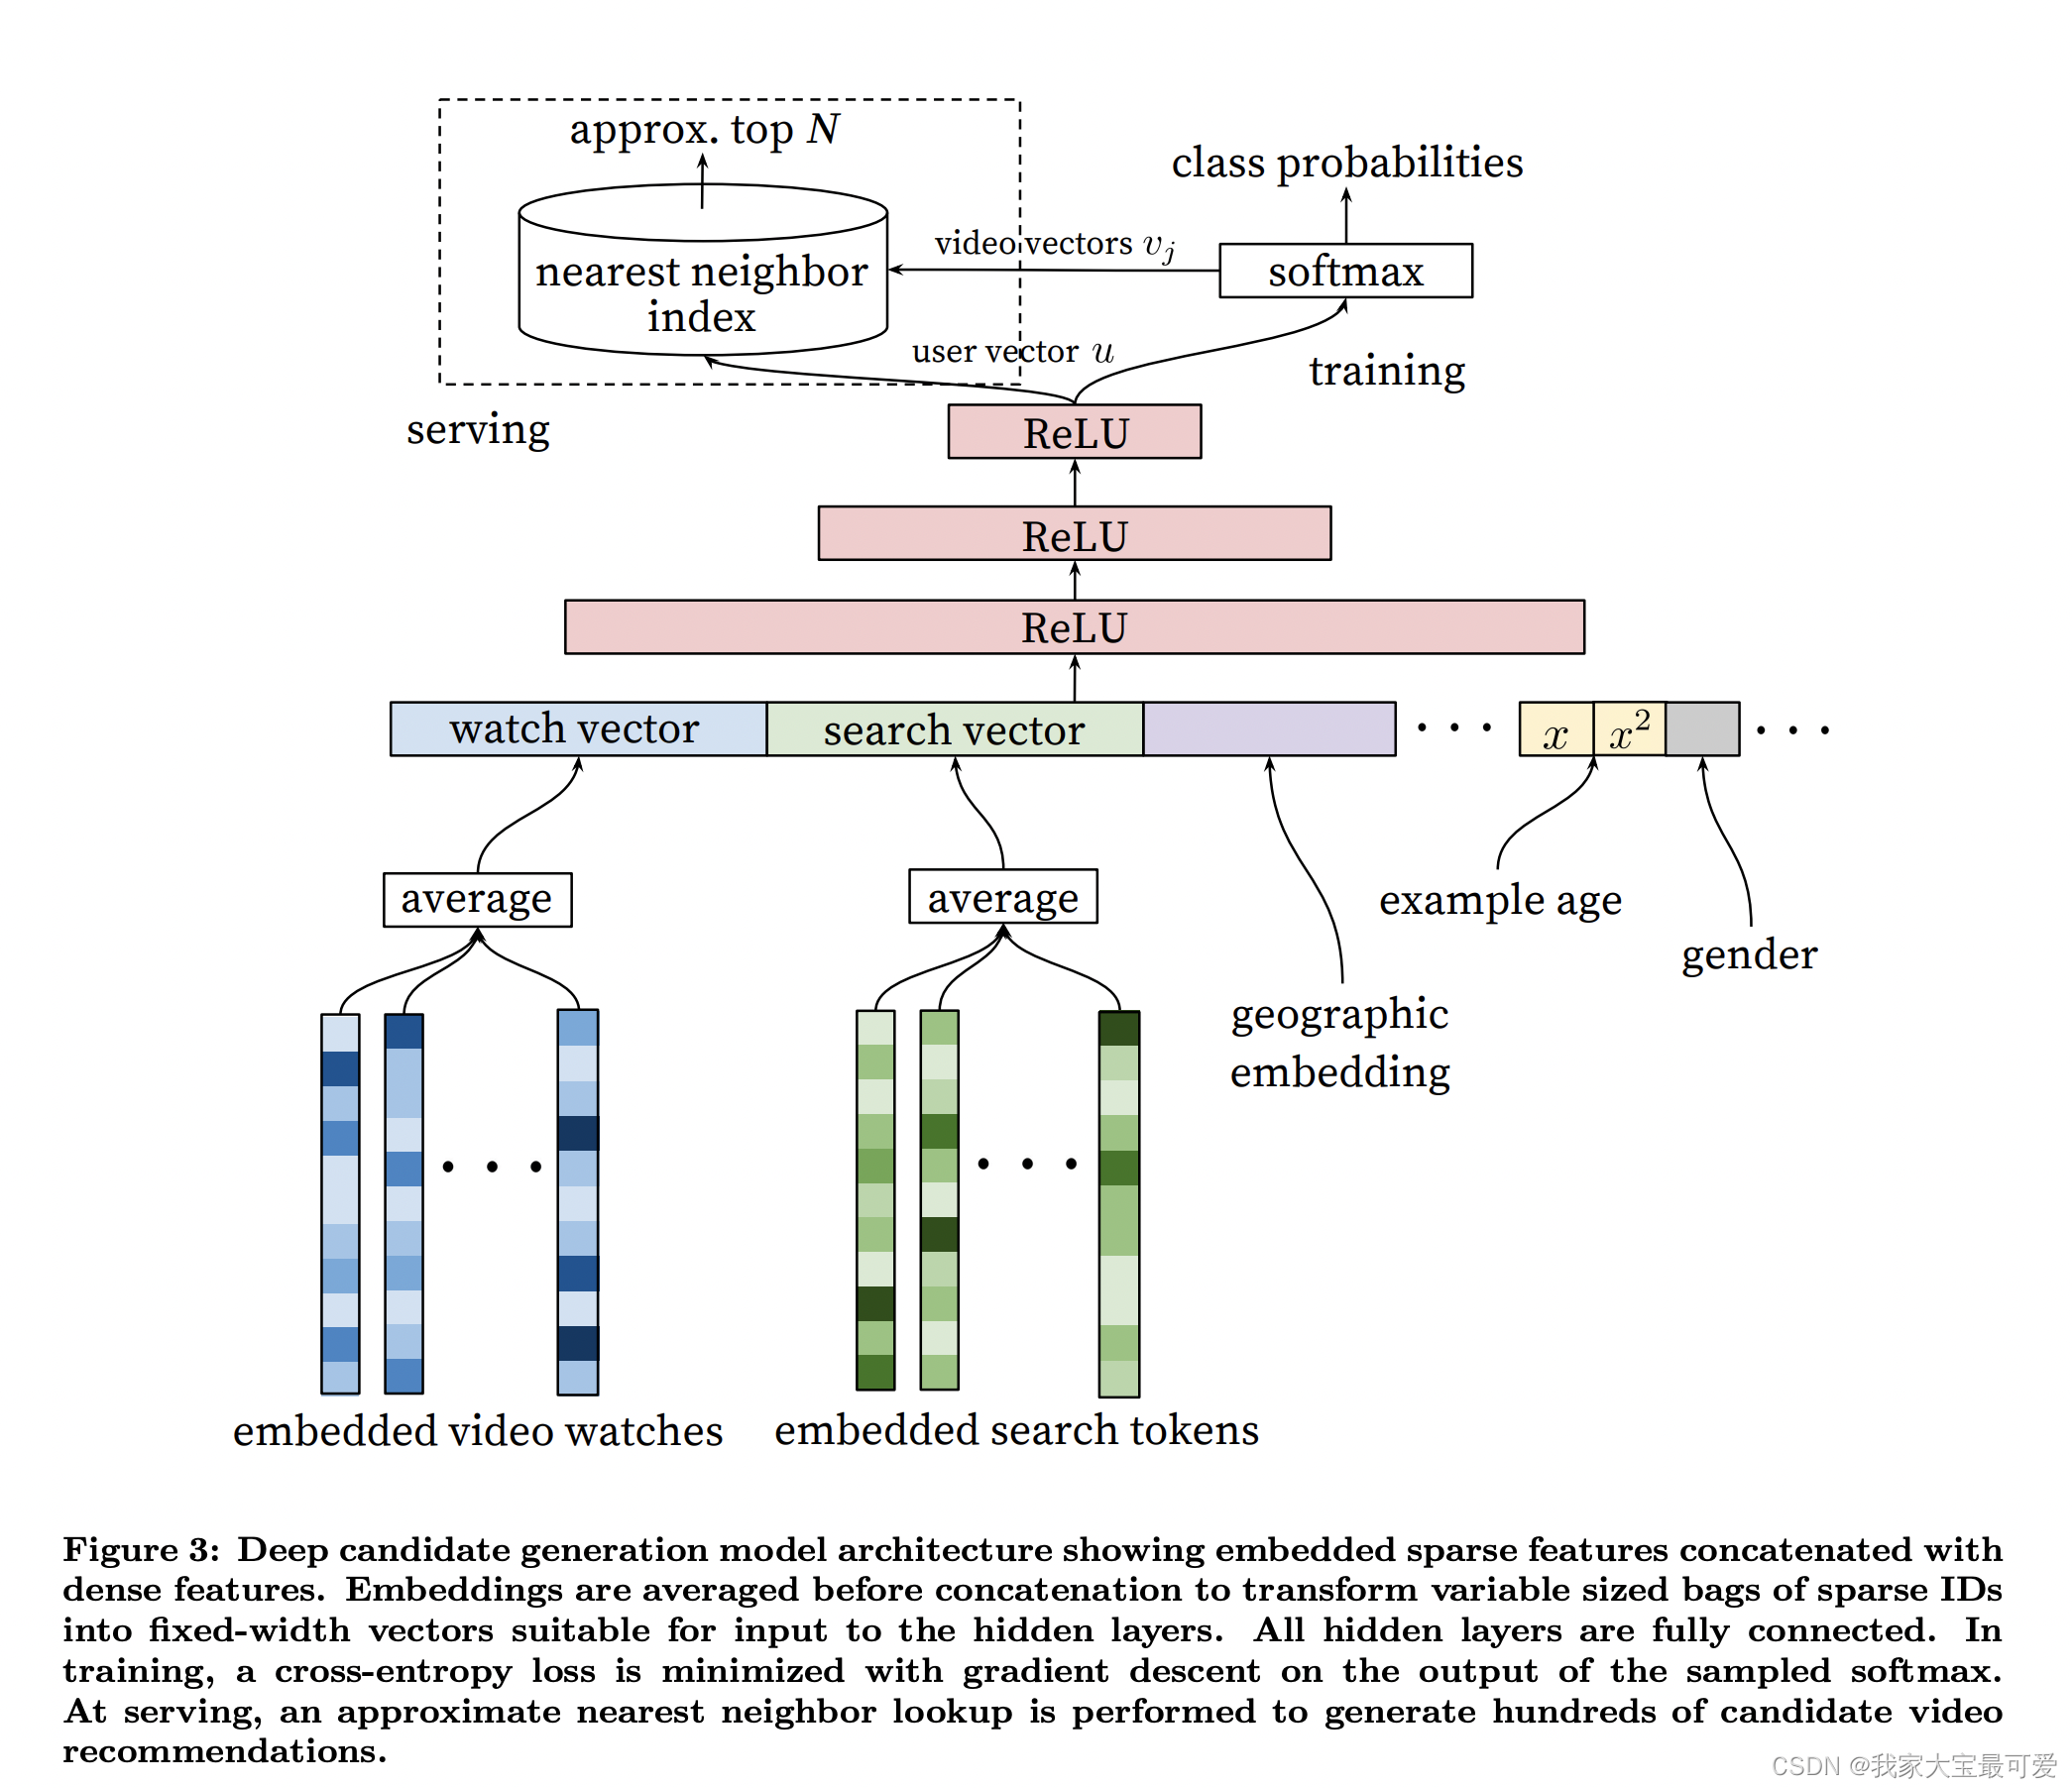
- 借鉴word2vec,将视频训练后得到emebdding。用户观看历史由稀疏视频ID的可变长序列表示,这个稀疏序列可以映射到密集向量。网络要求固定输入长度的输入,对比的几种策略中,对embedding求平均效果最好。
我猜当时肯定没有尝试加权,重要的是,embedding可以通过梯度下降法与其他网络参数一起学习。
3.3 异构数据
- 使用神经网络作为矩阵分解的一个优势是可以输入连续特征和离散特征,搜索也可以这么干,把每一饿query当作一个id,然后训练一个embedding。
这样的话,网络除了输入用户观看视频的embedding,还可以输入用户搜素的embedding - 用户统计特征是非常重要的,一方面是重要的先验知识,另一方面,可以对新用户进行推荐,
新用户历史行为非常稀少,所以embedding基本为0,但是可以获取用户其他的特征,输入到网络后依然可以获取一个embedding - 新上传的视频对YouTube来说是非常重要的,除了直接给用户推荐相关的新视频,还会有一个二次现象是引导和传播。
- 机器学习通常会产生偏差,因为推荐通常是根据用户的历史观看记录来预测下一个视频。以下是我YY的内容,不会翻译了。
用户对未来视频的偏好是不可预知的,但是我们训练的推荐系统使用的用户过去几周的观看记录,并且embedding的时候还是求平均,因此预测的结果就历史观看记录的平均可能性。这意味着给用户推荐的视频肯定都是上传已久的老视频。为了解决这个偏差问题(这个偏差应该就是视频上传新老的偏差),在训练期间添加了一个example age特征,这个example age我理解就是当前时间减去视频上传时间。训练的时候每个视频都会有age值,表示这个视频是新视频还是老视频,但是预测的时候,就把这个特征设置为0,即都是新视频。这样推荐系统在预测的时候就会统一对待新老视频了,将他们拉至同一水平线上,即减少了偏差,这样就不会只推荐老视频,新视频也会推荐了。我感觉这个真的是牛逼,相对于使用了因果推断来解决流行度偏差。我现在猜测,是不是位置偏差也可以这么解决,训练的时候输入位置特征poistion,预测的时候poistion的值统一设置为0.
3.4 标签转换
- 推荐一般转化为ctr预估的问题,即假设,准确的预测ctr可以有效的推荐商品,但实际中,这个假设对推荐系统的性能有着很大的影响,并且很难用离线实验衡量。
推荐系统的ctr预测准确不代表推荐就会好,在推荐系统最后还有一个重排层,影响用户点击的除了ctr的单点预估,还需要考虑商品的排序,个人觉得,当前的推荐相当于只有一个坑位时给用户推荐什么,那肯定是ctr最高的商品,但是实际feed流中,商品时非常多的,除了单个商品的ctr会有影响,商品的组合顺序也会产生影响 - 召回训练的时候,不能只考虑给用户推荐的商品,这就导致推荐系统高度倾向于利用历史数据,而不会给用户推荐新商品。用户看到的商品肯定是我们推荐的,但是我们推荐的并不一定就是用户想看的,那该怎么办呢?所以用户如果从其他地方看了视频,xxxx看不懂了。
还有一种就是每个用户我们用固定长度的行为序列,这样整个系统就不会被高活用户带偏了。 - 如果我们只使用用户最近的一条信息去训练,很容易造成过拟合。例如,如果用户搜索了一个关键词taylor swift,我们的目标时预测用户下一个观看视频是什么,其中最为相关的就是与taylor swift相关的视频,但是如果我们丢弃了用户的历史序列,转而只使用这个关键词,就会非常容易过拟合。
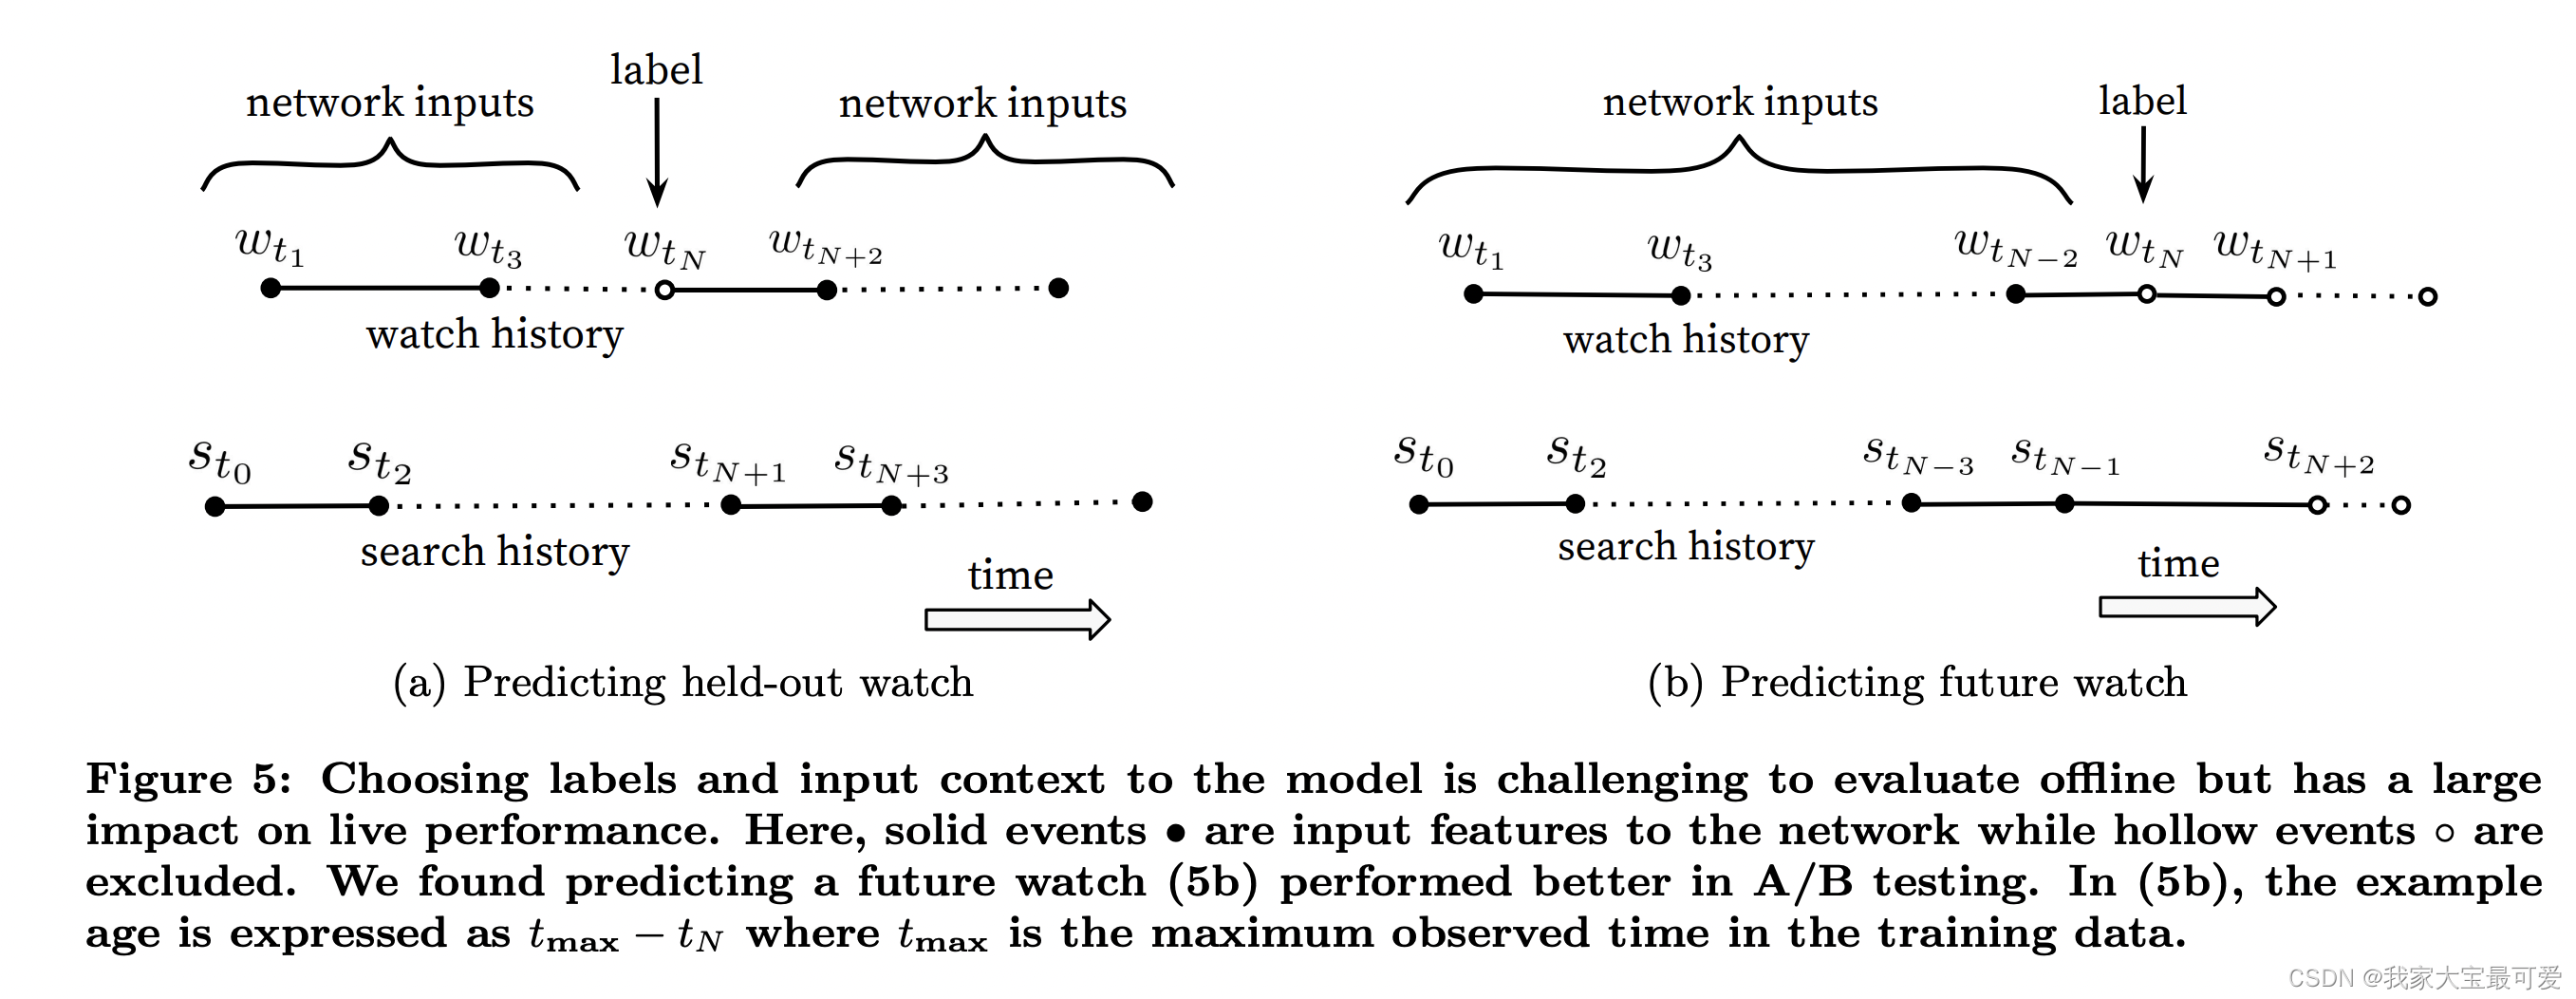
我觉得这本质就是长期兴趣和短期意图的关系,最近的一次搜索代表用户的短期意图,如果只用短期意图来做的话,每次都不一样,推荐系统就很难训练。破案了,原来当时google还没有很好的掌握rnn,所以效果很差,才说不要使用时序模型,现在他们已经很好的应用了RNN - 一开始没有看明白,其实就是说,评估的时候,预测用户观看序列的话需要使用观看前推荐的视频做为输入。左侧图a)是吧用户观看前后的vido都做为了输入,而右侧的图b)则是使用了观看之前的信息做特征。线上AB实验发现是b)更好。
我觉得这本质就是特征穿越了,预测label的时候使用之后的数据,导致存在穿越问题,上线后的效果肯定不好,但是使用MF的时候,其实都是使用的是图a)的方式,因为矩阵分解根本就没有考虑序列的问题,从这里可以看出,google使用的是session推荐
3.5 特征和深度的实验
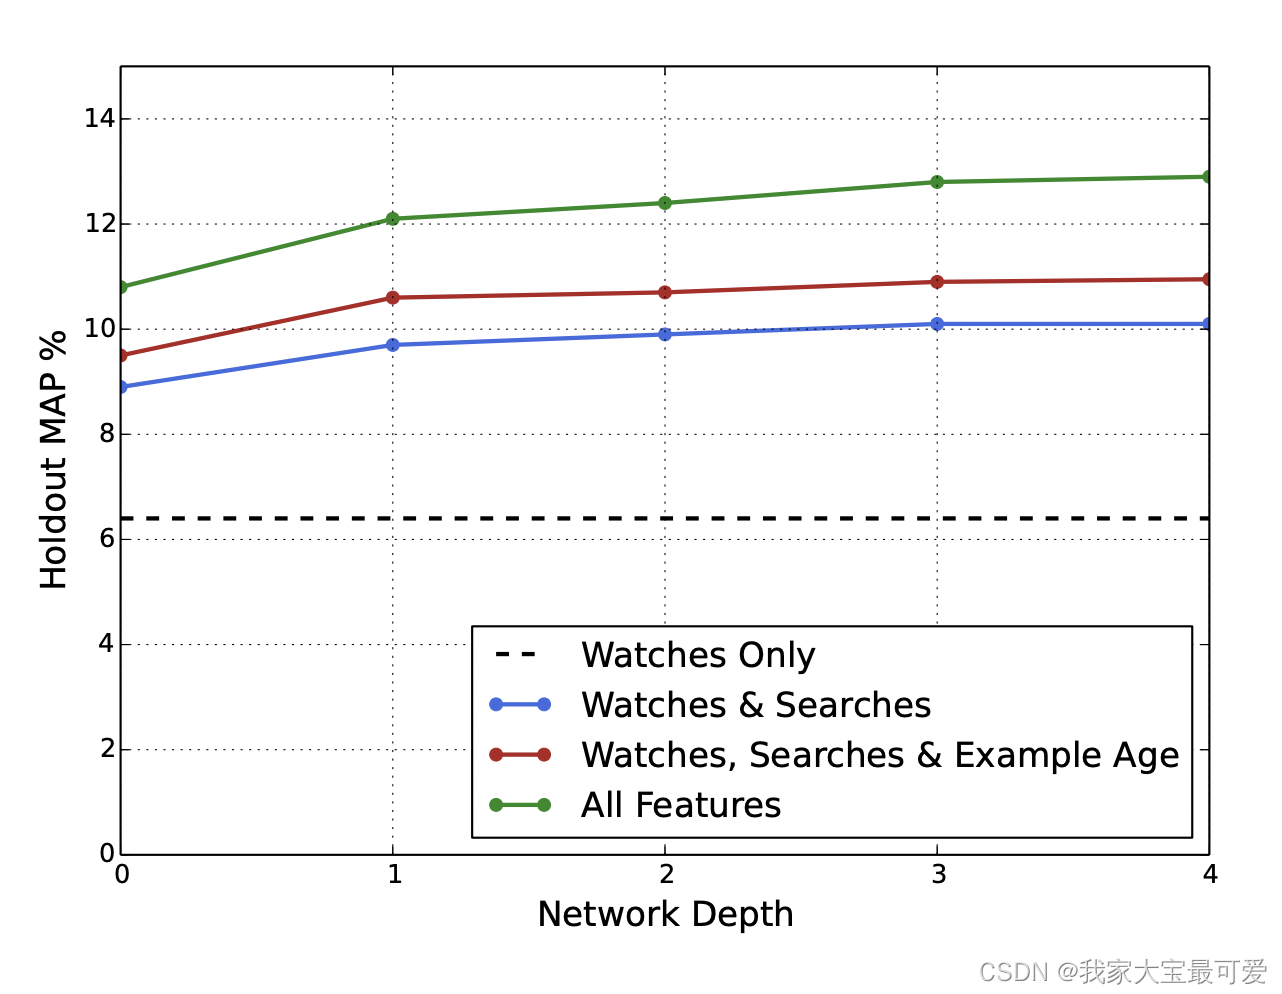
- 添加特征和网络深度有助于模型的提升,虚线是只使用用户的观看序列特征,蓝线是使用观看序列和搜索序列的特征,红色的线是使用了,观看,搜索和example age特征,可以看到MAP的只一次增加。同样的随着网络深度的增加,MAP也不断增加。
4. 排序
- 精排的阶段只有几百个视频,因此可以使用更多的交互特征去校准用户的点击率。例如,如果推荐的某个视频用户有很高的点击率,但是由于缩略图选择不好,可能会导致用户不点击,因此可以把缩略图的信息也加入到精排模型中。此外,召回阶段通常会使用多种召回源,导致召回商品的分数无法直接比较,使用精排统一打分,使得可以进行比较。
- 精排的架构与召回相似,顶层使用sigmod函数转化为点击概率。但是,目标并不是优化ctr,而是优化观看时长,单纯优化ctr可能会推荐出一些引诱型视频,诱导用户点击,使用观看时长可以更好的衡量用户的参与度。
4.1 特征表达
- 特征分为连续特征和离散特征,离散的又分为onehot和mulhot两种。排序模型使用了几百个特征,并且连续特征和离散特征差不多一半一半。深度网络极大的减轻了特征工程的负担,但是如果直接把原始数据,例如vido ID这种特征,输入的话依然不容易收敛。最大的问题是,如何构建与ctr相关的特征。
- 经过观测,最主要的还是交叉特征,例如用户与channel的交叉,在不同频道观看的视频数,最后观看的视频是什么种类的,这些描述用户历史交互的连续特征非常有用,因为可以很好的概括用户的偏好。而且召回网络的特征也可以输入到精排中,这些特征也非常的有效,例如有几路召回源提名了这个视频,召回分是多少。
召回层的特征应该属于实时特征。针对商品相当于是统计用户在不同类目上的ctr,点击次数,购买次数等信息 - 要做曝光过滤,推过且没点的商品就不要重复推荐了。这就要靠工程了
更多推荐


 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)